
Nota do autor: este artigo parte do post de pesquisa oficial em que múltiplos agentes do Claude Fable 5.2 concluíram dois problemas de física de buracos negros, para organizar práticas aplicáveis em tarefas pesadas com agentes — escolha de modelo, divisão de papéis e definição de linhas de parada.
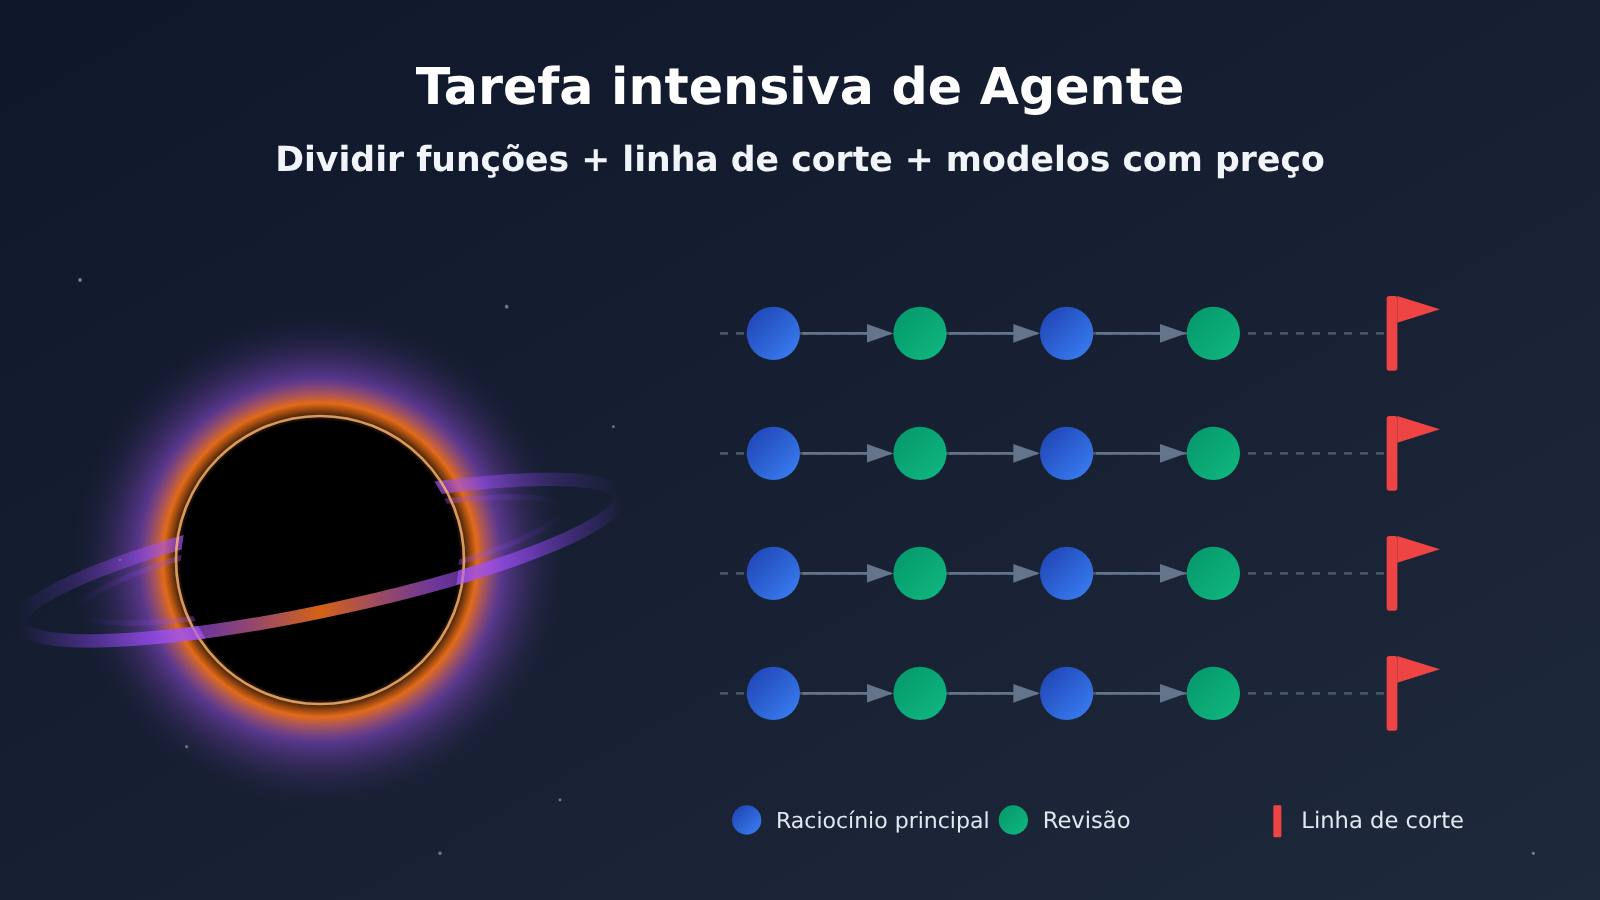
Em 17 de novembro de 2026, a Anthropic publicou um post de pesquisa: várias cópias do Claude Fable 5.2 rodaram em segundo plano por cerca de seis semanas e concluíram dois problemas de física de buracos negros. Para quem desenvolve tarefas longas com múltiplos agentes, o que vale a pena observar aqui não é a física em si, mas o modo de trabalho que ele mostra: longo, paralelo em várias frentes e com verificação cruzada.
Este não é um artigo de divulgação científica, nem vai decidir por você qual API é mais estável. O texto faz só uma coisa: pegar os sinais de engenharia que dá para aproveitar do post e transformá-los em passos que você possa seguir ao executar suas próprias tarefas pesadas com agentes.
Valor central: depois de ler, você vai saber como separar o raciocínio principal e a revisão em papéis distintos, escrever uma linha de parada clara para cada agente e escolher apenas entre modelos com preço explícito na tabela de modelos — assim, o custo de tarefas longas fica previsível e com teto definido.
O que o post de pesquisa do Claude Fable 5.2 revela sobre as tarefas de Agent de alta intensidade
Primeiro vale contextualizar em um ou dois parágrafos. O post de pesquisa é um relato oficial da própria Anthropic, e os dois artigos envolvidos são atualmente preprints, não papers já revisados por pares. Ambos os problemas são de física teórica, não descrevem o universo em que vivemos e não têm uso prático — então o valor está principalmente no “método”, não em “quão importantes são as conclusões”.
Segundo o post, em agosto de 2026 o pesquisador Hongbin Chen pediu ao Claude para listar questões abertas nas frentes de buracos negros e bootstrap, e algumas horas depois obteve 22 delas. Ele atribuiu um agente separado a cada questão, com os agentes podendo ler o progresso uns dos outros, e então tudo rodou em segundo plano por cerca de seis semanas. As palavras exatas do post são “nenhuma configuração especial”, mas essa é a descrição oficial de como a coisa foi montada — o que não equivale a custo zero, e o post também não apresenta uma conta de custos.
| Fato do post de pesquisa | Lição para tarefas de Agent pesadas | O que você pode fazer |
|---|---|---|
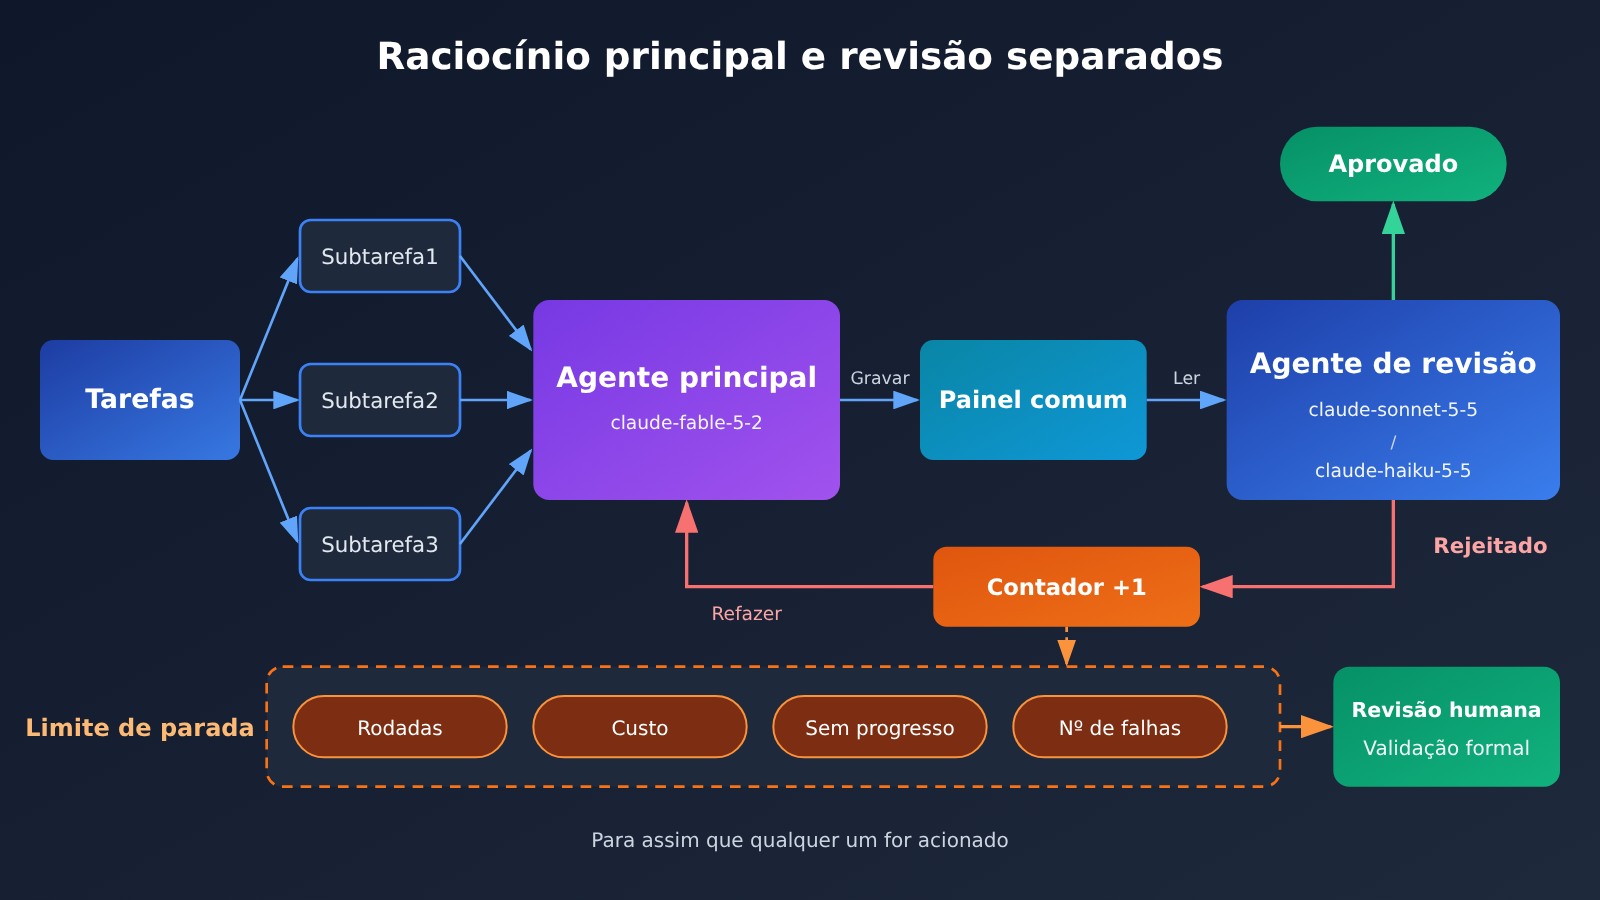
| Um agente por questão, com agentes podendo ler o progresso uns dos outros | A granularidade da divisão de tarefas precisa ser clara, e o estado compartilhado precisa ser legível | Um agente independente por subtarefa, com o progresso gravado em armazenamento compartilhado |
| Quase cada passo foi feito de forma independente por dois agentes e depois conferido com a literatura | Etapas críticas exigem revisão independente | Separar a inferência principal e a revisão em dois papéis |
| Nas primeiras rodadas, os agentes tentaram em paralelo 61 vezes sem conseguir concluir | Falhas são a norma, mas precisam de um limite | Deixar claro, em cada caminho, o número máximo de falhas e o orçamento |
| Resultados verificados formalmente com Lean e checados por físicos | Resultados de máquina, no fim, precisam de validação externa | Reservar uma etapa de verificação humana ou por ferramentas |
| Rodou em segundo plano por cerca de seis semanas | O custo de tarefas longas se acumula | Estimar com base na tabela de preços por modelo e definir um teto de gastos |
O que os dois problemas de tarefas pesadas de Agent demonstram, respectivamente
O primeiro problema é o cálculo da transição de fase Hawking-Page, proposto em 2003 e nunca concluído até hoje. O post conta que quase cada etapa foi realizada duas vezes de forma independente por dois agentes, e depois comparada com a literatura; a conclusão é que, no acoplamento fraco, a transição continua sendo abrupta. Outro físico chegou de forma independente à mesma resposta usando um método diferente, criando uma verificação cruzada. Para a prática de engenharia, este problema ilustra a abordagem de revisão baseada em “repetição independente + comparação externa”.
O segundo problema é a questão do limite superior da versão mais simples do bootstrap modal. Um grupo anterior de agentes Claude tentou 61 vezes em paralelo sem conseguir; os agentes posteriores perceberam um padrão nos resultados numéricos, pegaram emprestado o método de outro problema de empacotamento de esferas e provaram que o limite superior para a massa do buraco negro mais leve é aproximadamente c/9.1266, além de indicar que esse método não consegue reduzir mais o limite. Em setembro de 2026, esse resultado foi verificado formalmente com Lean, o artigo foi escrito pelo Claude e os físicos revisaram os principais resultados. A lição para a engenharia que este problema traz é: um grande número de tentativas fracassadas faz parte do processo, então cada caminho precisa ter orçamento e condições de parada.
Vale esclarecer um ponto importante: a abordagem do post é “múltiplas cópias do mesmo modelo se verificando mutuamente”, e não “planejar com um modelo caro e revisar com um modelo barato”. O esquema de divisão de papéis para economizar descrito abaixo é uma prática de engenharia que os leitores podem experimentar, e não uma conclusão já validada por este estudo.
Como dividir papéis em tarefas pesadas de Agent: separar a inferência principal da revisão
Em tarefas pesadas de Agent, o mais caro costuma ser o caminho que exige raciocínio profundo, enquanto as ações mais frequentes são as de revisão, como checagem, comparação e validação de formato. Se todas as chamadas passarem pelo mesmo modelo mais caro, o custo cresce de forma linear ou até superlinear com o número de rodadas. Dividir “pensar” e “verificar” em dois papéis é a forma mais direta de controlar o custo.
O princípio da divisão pode ser resumido assim: etapas que exigem raciocínio aberto e planejamento de cadeia longa ficam com o papel de inferência principal; já as verificações com critérios claros — como julgar “se esta etapa está consistente com a anterior”, “se o formato da saída está em conformidade” ou “se a conclusão entra em conflito com a literatura conhecida” — ficam com o papel de revisão. O papel de revisão deve entregar um julgamento estruturado, não refazer toda a dedução.
| Papel | Responsabilidade | IDs de modelos candidatos | Requisito de saída |
|---|---|---|---|
| Inferência principal | Dedução aberta, geração de planos, etapas-chave | claude-fable-5-2, claude-fable-5-2-thinking |
Processo de raciocínio completo e conclusões intermediárias |
| Revisão de primeiro nível | Consistência lógica, confronto de etapas, verificação de citações | claude-sonnet-5-5 |
PASS / FAIL com justificativa |
| Validação leve | Checagem de formato, integridade de campos, comparação simples | claude-haiku-5-5 |
Resultado em JSON estruturado |
| Validação externa | Prova formal, verificação numérica, revisão humana | Ferramenta ou humano | Confirmação final |
Com essa divisão, todos os papéis podem usar o mesmo ponto de entrada de chamadas. No APIYI apiyi.com, uma única chave API já permite alternar entre os modelos da tabela acima; a interface é compatível com OpenAI, então a inferência principal e a revisão só precisam mudar o parâmetro model, sem manter vários SDKs e múltiplos conjuntos de chaves. Para tarefas longas que exigem execução paralela em vários caminhos, um ponto de entrada unificado também concentra as estatísticas de uso em um único lugar, o que facilita a conciliação.
Vale um alerta, porém: um modelo de revisão mais barato não significa que ele seja mais confiável. Se o papel de revisão vai dar conta do recado depende de quão explícitos são os critérios de julgamento que você fornece a ele. A recomendação é rodar primeiro um pequeno lote de amostras com respostas conhecidas, confirmar que os veredictos de aprovação e devolução do modelo de revisão estão basicamente dentro do esperado, e só então colocá-lo em tarefas longas.
Como escolher a API para tarefas pesadas de Agent: preço e ID do modelo
O controle de orçamento em tarefas longas parte de uma premissa: o preço unitário de cada chamada é conhecido. A recomendação é seguir um princípio: chamar apenas modelos que têm preço explícito na tabela de modelos e fixar no código o ID do modelo junto com o preço unitário correspondente, em vez de trocar de modelo em tempo de execução.
Segundo a página oficial de modelos da Anthropic, o Claude Fable 5.2 foi lançado em 9 de novembro de 2026, o ID do modelo é claude-fable-5-2, a janela de contexto é de 1 milhão de tokens, a saída máxima é de 128 mil tokens e o pensamento vem ativado por padrão. A tabela abaixo mostra os preços dos modelos relevantes para este artigo na tabela geral de modelos do APIYI apiyi.com, na data de verificação (2026-11-19), em dólares por milhão de tokens.
| ID do modelo | Entrada | Leitura de cache | Saída | Papel sugerido neste artigo |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | Raciocínio principal |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | Raciocínio principal (versão com pensamento) |
claude-fable-5-1 |
10 | 0.25 | 50 | Versão vizinha, para comparação |
claude-sonnet-5-5 |
2 | 0.1 | 10 | Revisão de primeiro nível |
claude-haiku-5-5 |
0.1 | 0.01 | 0.5 | Validação leve |
Dá para tirar da tabela algumas informações que são decisivas para tarefas longas. Primeiro, o preço de claude-fable-5-2 é menor que o da versão vizinha claude-fable-5-1; se o seu raciocínio principal ainda roda na versão antiga, vale a pena avaliar a migração. Segundo, o preço de leitura de cache é só 2.5% do preço de entrada; em tarefas longas, o agente relê várias vezes o progresso compartilhado, o system prompt e os documentos de contexto, e se essa parte conseguir acertar o cache a diferença de custo aparece na hora — acertar ou não depende da forma de chamada e das regras da plataforma, e vale o que estiver documentado. Terceiro, a diferença de preço unitário entre o modelo de revisão e o de raciocínio principal é de ordem de magnitude.
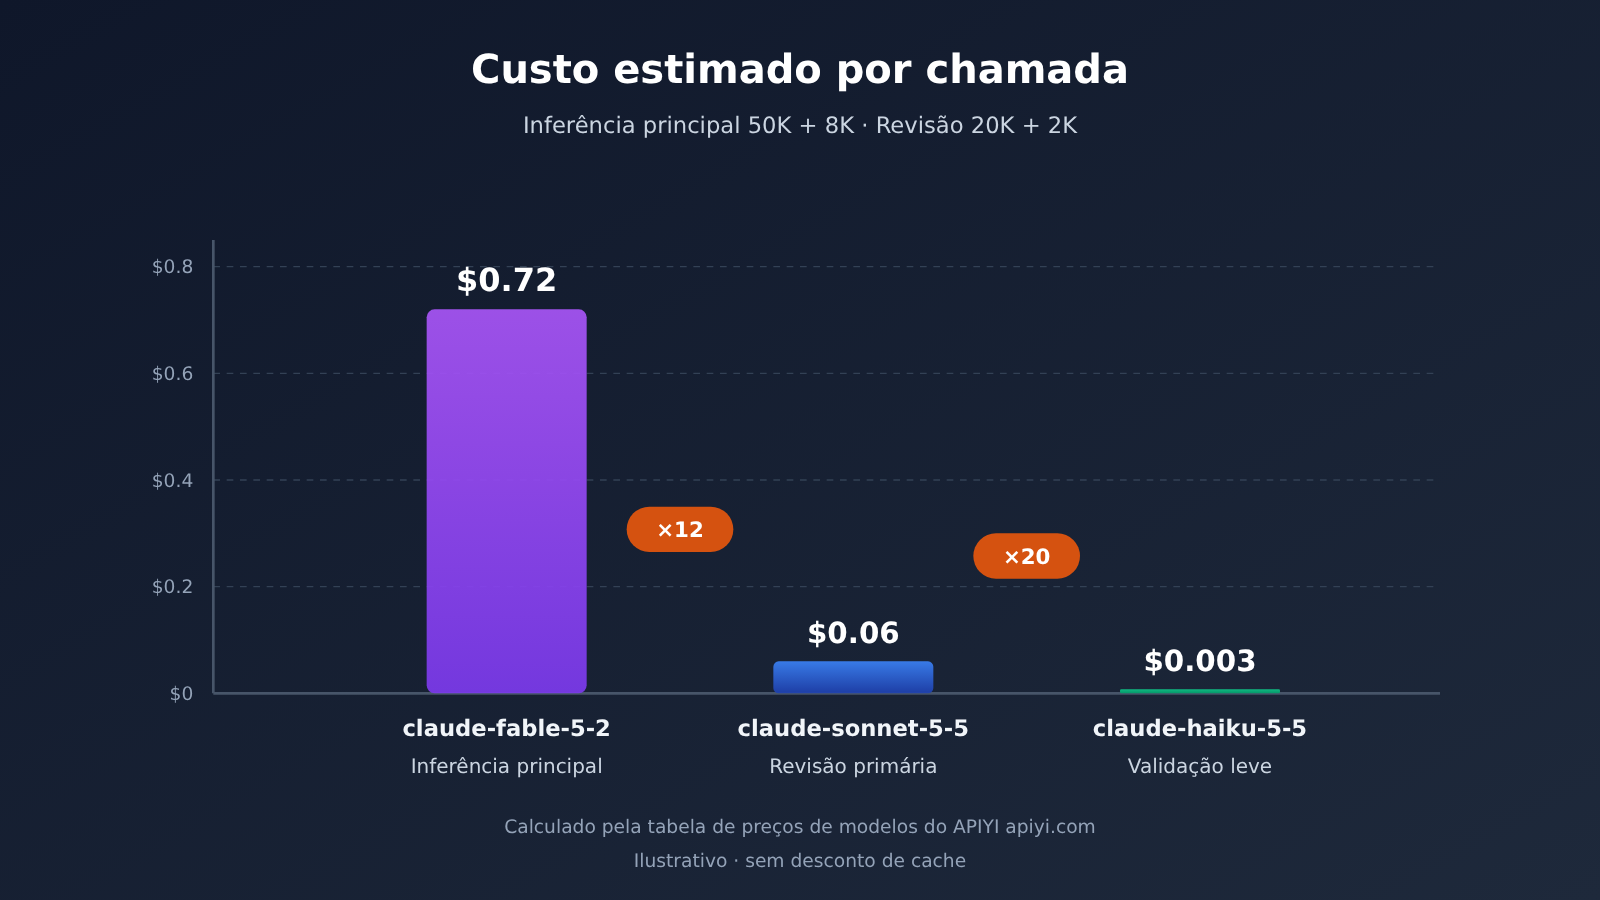
Vamos sentir na prática com alguns números hipotéticos: uma chamada de raciocínio principal com 50 mil tokens de entrada e 8 mil de saída custa, em claude-fable-5-2, cerca de 0.4 + 0.32 = 0.72 dólar; uma revisão com 20 mil de entrada e 2 mil de saída custa, em claude-sonnet-5-5, cerca de 0.04 + 0.02 = 0.06 dólar, e em claude-haiku-5-5, por volta de 0.003 dólar. Se a revisão também usar o modelo de raciocínio principal, essa mesma chamada de revisão sai por cerca de 0.16 + 0.08 = 0.24 dólar. Isso é só aritmética ilustrativa; o número real de tokens depende da sua tarefa.
Além disso, na página oficial de modelos o Opus 5.5 aparece com preço de entrada 4 e saída 20, o Sonnet 5.5 com 2 e 10, e o Haiku 5.5 a partir de 0.10 e 0.50 — dá para usar como referência da progressão de preços oficial. Na hora da chamada real, o modelo e o preço valem conforme a lista de modelos da plataforma; a linha claude-fable-5-2 do APIYI suporta os endpoints chat e messages, com entrada unificada em https://api.apiyi.com/v1.
Início rápido para tarefas intensivas de Agente: código de orquestração com linha de interrupção
Exemplo mínimo
Primeiro, confirme que o modelo principal de inferência pode ser chamado normalmente e que o campo usage está disponível. Essa é a base para a contabilização de custos mais adiante:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Para contagem de tokens e estimativa de custos
Defina um limite de parada claro para cada agente
No post de pesquisa, as primeiras tentativas paralelas dos agentes somaram 61 execuções sem sucesso. Isso serve de alerta: tarefas intensivas com Agent certamente terão muitas tentativas falhas, e as falhas também custam dinheiro. O papel do limite de parada é fazer cada agente parar automaticamente antes de perder o controle, deixando a decisão para uma pessoa ou para uma ferramenta.
| Limite de parada | Significado | Valor inicial sugerido (ajustar conforme a tarefa) |
|---|---|---|
| Número máximo de rodadas | Limite de idas e voltas entre o raciocínio principal e a revisão | 10 a 30 rodadas |
| Teto de custo | Limite do custo estimado acumulado por agente | Definir conforme o orçamento por questão |
| Ausência de progresso consecutiva | A revisão rejeita repetidamente sem novas conclusões | 3 a 5 vezes |
| Número máximo de falhas | Total de vezes que a revisão rejeitou | Cerca de metade do número de rodadas |
| Comprimento da saída | Limite de tokens por saída única | Muito abaixo do máximo de saída de 128 mil tokens |
Ver o código completo de implementação
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Ponto de entrada unificado da APIYI, compartilhado entre inferência principal e revisão
)

# Preço unitário: USD / milhão de tokens, fixado na tabela de modelos da plataforma; atualize manualmente quando houver mudança
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Estimativa pelo preço de tabela, sem desconto de cache; o resultado fica conservador."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
Este código tem três escolhas de design intencionais. Primeiro, a tabela de preços unitários está fixada no código; qualquer pessoa que troque o modelo precisa atualizar o preço junto, evitando que “trocar por um modelo sem preço tabelado” distorça o orçamento. Segundo, o papel de revisor é instruído a produzir apenas PASS ou FAIL seguido de justificativa, sem refazer a derivação, o que limita o tamanho da saída da revisão. Terceiro, ao parar, ele retorna o progresso atual e o custo acumulado, facilitando a assunção manual em vez de deixar o agente tentar indefinidamente.
🚀 Início rápido: sugerimos começar no APIYI apiyi.com usando o crédito gratuito de teste para novos usuários. Pegue uma questão pequena cuja resposta você já conhece e execute o fluxo acima de ponta a ponta para confirmar se as decisões da etapa de revisão e a estimativa de custos estão conforme o esperado. Depois, aumente aos poucos o número de caminhos paralelos e de rodadas.
Perguntas frequentes sobre como escolher uma API para tarefas de Agent pesadas
Q1: Dá para confiar na história do Claude Fable 5.2 resolvendo problemas de física de buracos negros?
Trata-se de uma declaração oficial da própria Anthropic, em um post de pesquisa de 17 de novembro de 2026. Os dois artigos relacionados são preprints e ainda não passaram por revisão por pares. O resultado do segundo problema foi verificado formalmente com Lean em setembro de 2026, e o primeiro problema teve o mesmo resultado obtido por outro físico usando um método diferente. Ao ler, entenda tudo isso no nível de “declaração oficial + preprint”.
Q2: O post de pesquisa diz “sem configuração especial” — isso significa que sai barato?
Não. “Sem configuração especial” descreve a forma de montagem; o post não apresenta uma conta de custos. São 22 problemas, um agente por problema, rodando em segundo plano por cerca de seis semanas — o volume de invocações, por si só, já não é pequeno. Ao rodar tarefas de escala parecida por conta própria, estime os gastos com base nos preços da tabela de modelos e defina um teto de custo.
Q3: Usar um modelo barato para revisar é uma prática já validada pelo post de pesquisa?
Não. A abordagem do post é fazer várias cópias do mesmo modelo refazerem a tarefa de forma independente e se conferirem mutuamente. “Inferência principal com modelo caro, revisão com modelo barato” é a prática de engenharia que este artigo sugere que você experimente — o efeito precisa ser validado nas suas próprias tarefas. Para etapas com exigência de correção altíssima, você também pode manter o esquema de “duas inferências principais refazendo a tarefa de forma independente”.
Q4: Como escolher entre `claude-fable-5-2` e `claude-fable-5-2-thinking`?
Os dois têm o mesmo preço na tabela de modelos da APIYI: entrada a US$ 8, leitura de cache a US$ 0,2 e saída a US$ 40 por milhão de tokens. A página oficial do modelo informa que o modo de pensamento do Fable 5.2 vem ativado por padrão. As diferenças concretas de comportamento de invocação entre os dois IDs devem ser conferidas na descrição do modelo na plataforma; a recomendação é rodar a mesma tarefa algumas vezes com cada um, comparar o comprimento da saída e o `usage`, e só então decidir qual usar na inferência principal.
Q5: Como chamar a inferência principal e o modelo de revisão por um único endpoint?
Depois de se registrar na APIYI (apiyi.com) e obter uma API Key, defina o `base_url` do SDK como `https://api.apiyi.com/v1`. Para a inferência principal e a revisão, basta alternar o parâmetro `model`, por exemplo entre `claude-fable-5-2` e `claude-sonnet-5-5`. Novos usuários têm crédito gratuito de teste, o que é ótimo para validar primeiro os critérios de parada e a lógica de revisão.
Q6: Em tarefas longas, qual é a relevância do preço de leitura de cache?
O preço de leitura de cache do Fable 5.2 é 2,5% do preço de entrada, ou seja, US$ 0,2 por milhão de tokens. Tarefas longas com múltiplos agentes leem repetidamente o comando de sistema, os materiais de contexto e o progresso compartilhado; manter esse conteúdo estável e posicionado no início do comando aumenta a chance de acertar o cache. Se o cache é acertado e como a cobrança é feita devem ser conferidos na documentação da plataforma.
Q7: Que valor faz sentido para os critérios de parada?
Não existe um número universal. A sugestão é começar com valores conservadores: de 10 a 30 rodadas, de 3 a 5 ocorrências consecutivas sem progresso, e um teto de custo por caminho definido conforme o valor do problema. Depois de rodar um lote, olhe a distribuição dos motivos de parada: se a maioria for “teto de custo atingido” mas o trabalho já estiver perto de terminar, relaxe um pouco; se a maioria for “sem progresso consecutivo”, isso indica que a tarefa não foi dividida em partes suficientemente pequenas.
P8: Quais são as limitações dessa abordagem?
Primeiro, o modelo de revisão pode deixar passar erros ou fazer julgamentos equivocados, então é preciso calibrá-lo com amostras de respostas já conhecidas. Segundo, a estimativa de custo se baseia no preço de tabela e não considera descontos de cache nem a variação causada por novas tentativas após falhas. Terceiro, como no post sobre a pesquisa, a conclusão final ainda precisa de validação externa — por exemplo, prova formal ou revisão por especialistas do domínio; o fato de os agentes aprovarem uns aos outros não significa que o resultado esteja correto.
Principais pontos para escolher a API em tarefas pesadas de Agent
- Natureza da origem: a pesquisa sobre buracos negros do Fable 5.2 é um relato oficial, e o paper é um preprint — olhe para o método, não para a conclusão
- Separe os papéis: raciocínio aberto fica com o modelo principal de raciocínio; verificações com critérios bem definidos ficam com o modelo de revisão
- A revisão precisa ser independente: o revisor apenas julga, não refaz o raciocínio; a saída é PASS / FAIL com justificativa
- As linhas de parada precisam estar escritas: número de rodadas, custo, ausência contínua de progresso e número de falhas — nenhuma dessas quatro pode faltar
- Use apenas modelos com preço de tabela: o ID do modelo e o preço unitário ficam fixos no código; trocar de modelo exige atualizar o preço junto
- Aproveite a leitura de cache: contexto estável e progresso vão nas primeiras posições; a leitura de cache custa apenas 2,5% do preço de entrada
- Comece por um ponto de entrada único: com uma única chave da APIYI, alterne entre o modelo principal de raciocínio e o de revisão; comece rodando tarefas pequenas com a cota gratuita
Resumo
Partindo do caso em que o Claude Fable 5.2 resolveu problemas de física de buracos negros, os três pontos mais valiosos para tarefas pesadas de Agent são:
- Separe a inferência principal da revisão: o post de pesquisa usou várias cópias do mesmo modelo para se verificarem mutuamente; você pode ir além e escolher modelos de faixas de preço diferentes por papel, validando a qualidade da revisão com amostras.
- Defina claramente a linha de parada de cada via: as 61 tentativas fracassadas mostram que o fracasso é a norma; número de rodadas, custo, ausência de progresso e número de falhas precisam todos ter limites superiores.
- Ajuste apenas modelos com preço na tabela: escreva no código os IDs e preços unitários de modelos como
claude-fable-5-2,claude-sonnet-5-5,claude-haiku-5-5, para que o custo seja estimável e limitável.
O sucesso de tarefas longas muitas vezes não depende de quão inteligente é uma única chamada, mas de se o fluxo como um todo consegue avançar continuamente dentro de um orçamento controlável e deixar resultados verificáveis. Recomendo usar os créditos de teste gratuitos do APIYI apiyi.com para primeiro rodar um problema pequeno de ponta a ponta e, depois, ajustar os parâmetros gradualmente e ampliar a escala conforme os motivos de parada.
📚 Referências
-
Post de pesquisa da Anthropic: relato oficial do Claude Fable 5.2 multiagente concluindo dois problemas de física de buracos negros
- Link:
anthropic.com/research/claude-black-hole-physics - Descrição: descrição em primeira mão da divisão de trabalho dos agentes, duração e forma de revisão
- Link:
-
Artigo preprint um: preprint associado ao post de pesquisa, sem revisão por pares
- Link:
hexagonmath.org/2611.00175v1 - Descrição: indicado para leitores que querem ver o texto original dos resultados
- Link:
-
Artigo preprint dois: outro preprint associado ao post de pesquisa, sem revisão por pares
- Link:
hexagonmath.org/2611.00174v1 - Descrição: para ler em comparação com o anterior
- Link:
-
Página oficial do modelo Claude Fable 5.2: ID do modelo, contexto, saída máxima e preço oficial
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: conferir as especificações do modelo e a escala de preços oficial
- Link:
Autor: equipe técnica do APIYI
Contato técnico: fale conosco pela página inicial do site do APIYI; descrições de modelos e preços estão no centro de documentação docs.apiyi.com


