
Nota do autor: um panorama dos novos modelos de IA de novembro de 2026 — Gemini 4 Carbon, Claude Fable 5.2 e FastFrames, da Apple — para ajudar você a separar o que já dá para chamar por API hoje do que é apenas artigo científico e pesos de pesquisa.
Novembro de 2026 concentrou os novos modelos de IA em duas semanas: o Google liberou o Gemini 4 Carbon para desenvolvedores com plano pago em 10 de novembro; a Anthropic lançou o Claude Fable 5.2 em 9 de novembro; e a Apple publicou em 17 de novembro o artigo e os pesos do FastFrames, sua pesquisa em vídeo. São muitos nomes, mas, para quem quer começar a mexer agora, a pergunta que realmente importa é: o que já dá para chamar por API hoje e o que é apenas artigo e pesos de pesquisa.
Isto não é um ranking geral de “quem está em primeiro”. O texto reúne apenas informações que batem entre o material oficial, o que os próprios artigos declaram e as páginas de modelo das plataformas; não traz conclusões de testes práticos nem trata a capacidade “máxima” declarada oficialmente como um número já medido.
O valor central: ao terminar a leitura, você terá uma tabela comparativa. Para tarefas de texto, dá para alternar entre Gemini 4 Carbon e Claude Fable 5.2 conforme a necessidade; na área de vídeo, é preciso primeiro deixar claro que o FastFrames é um conjunto de pesos de pesquisa, não uma API que pode ser chamada.
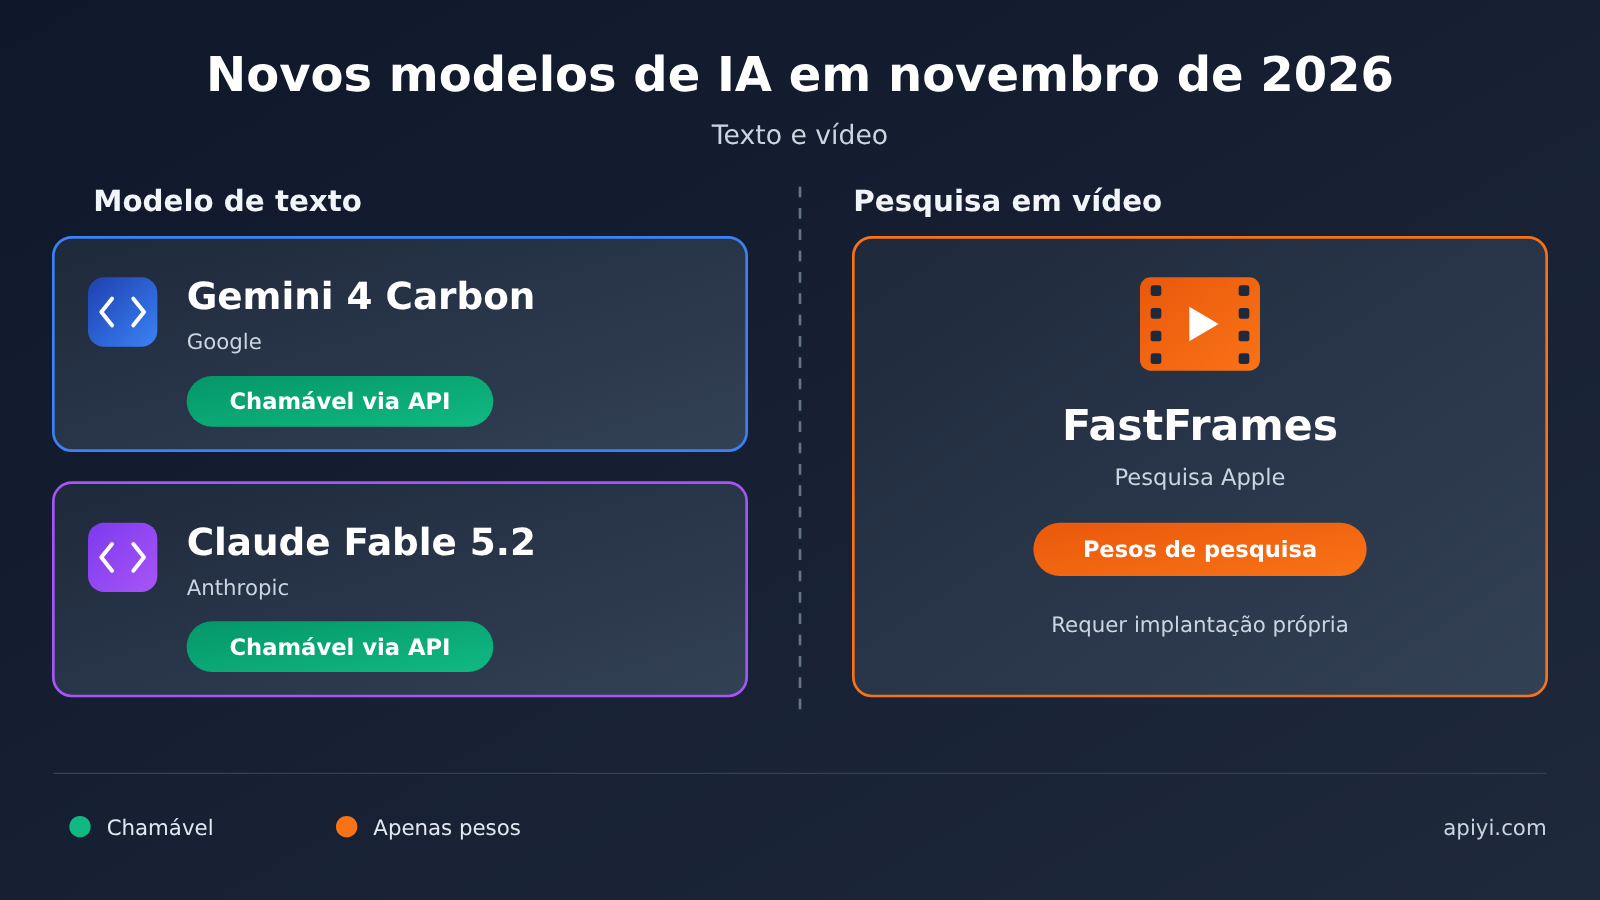
Visão rápida das informações essenciais dos novos modelos de IA de novembro de 2026
A tabela abaixo responde primeiro às perguntas mais importantes: que tipo de modelo é cada um, quem o lançou e se já dá para invocá-lo via API hoje. As datas seguem os anúncios oficiais ou a data da versão do paper.
| Modelo | Lançado por | Tipo | Data-chave | Dá para invocar via API hoje? |
|---|---|---|---|---|
| Gemini 4 Carbon | Modelo de Linguagem Grande de texto | 28 de outubro, primeiro para defensores de segurança cibernética (Fairwind); 10 de novembro, aberto a desenvolvedores pagos e empresas | Sim, ID do modelo gemini-4-carbon |
|
| Claude Fable 5.2 | Anthropic | Modelo de Linguagem Grande de texto | Lançado em 9 de novembro | Sim, ID do modelo claude-fable-5-2 |
| FastFrames | Apple Research | Pesquisa em geração de vídeo | Data da v1 do paper: 17 de novembro | Não é API, é um paper com pesos abertos |
Os dois modelos de texto já aparecem na lista de modelos da plataforma APIYI e podem ser invocados diretamente no formato compatível com OpenAI. Os modelos e preços seguem a lista de modelos em APIYI apiyi.com; a data de verificação dos dados de preço deste artigo é 2026-11-19.
A situação do FastFrames é completamente diferente. Trata-se de um paper mais um conjunto de arquivos de pesos no Hugging Face. Para usá-lo, você precisa preparar sua própria GPU e fazer o deploy da inferência; não existe um preço de chamada por uso, e isso será explicado em separado mais adiante.
Novo modelo de texto de novembro de 2026: análise do Gemini 4 Carbon
O ritmo de lançamento do Gemini 4 Carbon é um tanto incomum. O Google primeiro o liberou em 28 de outubro para equipes de defesa cibernética e, depois, em 10 de novembro, o abriu para desenvolvedores em planos pagos e empresas. O preço introdutório informado oficialmente é o mesmo do Gemini 4 Argon: US$ 2 de entrada e US$ 10 de saída por milhão de tokens.
O que o Google diz x o que a página do modelo na plataforma mostra sobre o Gemini 4 Carbon
Há duas versões para a saída máxima do Carbon, e é preciso analisá-las separadamente. A página de explicação do Google AI Studio diz que uma única resposta pode passar de 64K, chegando no máximo a 1 milhão menos o comprimento da entrada. Já a página do modelo na APIYI indica a saída máxima como 65.536 tokens.
| Item | Texto oficial (Google) | Página do modelo na APIYI |
|---|---|---|
| ID do modelo | Gemini 4 Carbon | gemini-4-carbon |
| Data de disponibilização | 10 de novembro, aberto a desenvolvedores em planos pagos | 2026-11-11 |
| Comprimento do contexto | Cerca de 1 milhão | 1.048.576 tokens |
| Saída máxima | Pode passar de 64K, até 1 milhão menos a entrada | 65.536 tokens |
| Preço de entrada | US$ 2 / milhão de tokens | US$ 2 / milhão de tokens |
| Leitura de cache | — | US$ 0,1 / milhão de tokens |
| Preço de saída | US$ 10 / milhão de tokens | US$ 10 / milhão de tokens |
| Endpoints compatíveis | — | dois: chat e gemini |
Na prática, a conclusão é direta: ao chamar gemini-4-carbon pela APIYI, planeje o limite de saída por chamada conforme os 65.536 tokens da página do modelo. A saída ultralonga oficial é outra versão, válida para o ambiente nativo do Google; não misture os dois números. A página do modelo também traz uma passagem original da documentação: “texto longo de 199 mil tokens passou”. Esse é um registro da documentação, não uma conclusão de teste deste artigo.
No Gemini 4 Carbon, preço unitário igual não significa o mesmo custo por tarefa
Muita gente, ao ver que Carbon e Argon têm o mesmo preço unitário, assume que o custo de uso também será igual. Há um detalhe fácil de passar despercebido aqui. O texto do Google afirma claramente que o Carbon usa mais tokens que o Argon para fazer verificação. Ou seja, ao entregar a mesma pergunta ao Carbon, o consumo de tokens na saída ou no raciocínio pode ser maior.
Portanto, o preço unitário igual só indica que a cobrança por milhão de tokens é a mesma; não significa que a conta de uma única tarefa será igual. O Google não informa exatamente quanto a mais é usado, e este artigo também não estima um multiplicador. Se custo é uma preocupação para você, o caminho mais seguro é rodar cada modelo algumas vezes com suas próprias tarefas reais e comparar o consumo de tokens na fatura.
Na mesma família há uma opção mais barata, gemini-4-hydrogen, listada na tabela geral da APIYI com preço de entrada de US$ 1,5, leitura de cache de US$ 0,075 e saída de US$ 7,5 por milhão de tokens. Ela é indicada para cenários em que a profundidade de verificação não é exigente e o volume de chamadas é alto.
Novo modelo de texto de novembro de 2026: entendendo o Claude Fable 5.2
O Claude Fable 5.2 foi lançado pela Anthropic em 9 de novembro, e o ID do modelo informado na documentação oficial é claude-fable-5-2. Os parâmetros oficiais são contexto de 1 milhão de tokens e saída máxima de 128 mil tokens; o preço é 8 dólares na entrada e 40 dólares na saída, por milhão de tokens.
Comparação de preços entre o Claude Fable 5.2 e a geração anterior
A tabela geral do APIYI lista ao mesmo tempo os dois modelos claude-fable-5-2 e claude-fable-5-2-thinking, com o mesmo preço. A documentação oficial diz que a leitura de cache do Fable 5.2 custa 2.5% do preço de entrada — 2.5% de 8 dólares dá exatamente 0.2 dólar, o que bate com a tabela geral da plataforma.
| ID do modelo | Entrada (USD/milhão) | Leitura de cache (USD/milhão) | Saída (USD/milhão) |
|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 |
claude-fable-5-2-thinking |
8 | 0.2 | 40 |
claude-fable-5-1 (geração anterior) |
10 | 0.25 | 50 |
Dá para ver na tabela que os três preços unitários do Fable 5.2 são mais baixos que os do Fable 5.1. Se o seu projeto hoje roda no 5.1, migrar para o 5.2 representa, pelo menos no nível do preço unitário, uma redução direta — mas ainda vale a pena validar as diferenças reais de resultado com as suas próprias tarefas.
Vale notar que a tabela geral do APIYI não traz uma página de detalhes separada para o Fable 5.2, então os dados de contexto e de saída máxima aqui vêm da documentação oficial da Anthropic. Na hora da chamada, se você precisar de saídas bem longas, use a especificação oficial como referência e defina max_tokens explicitamente na requisição.
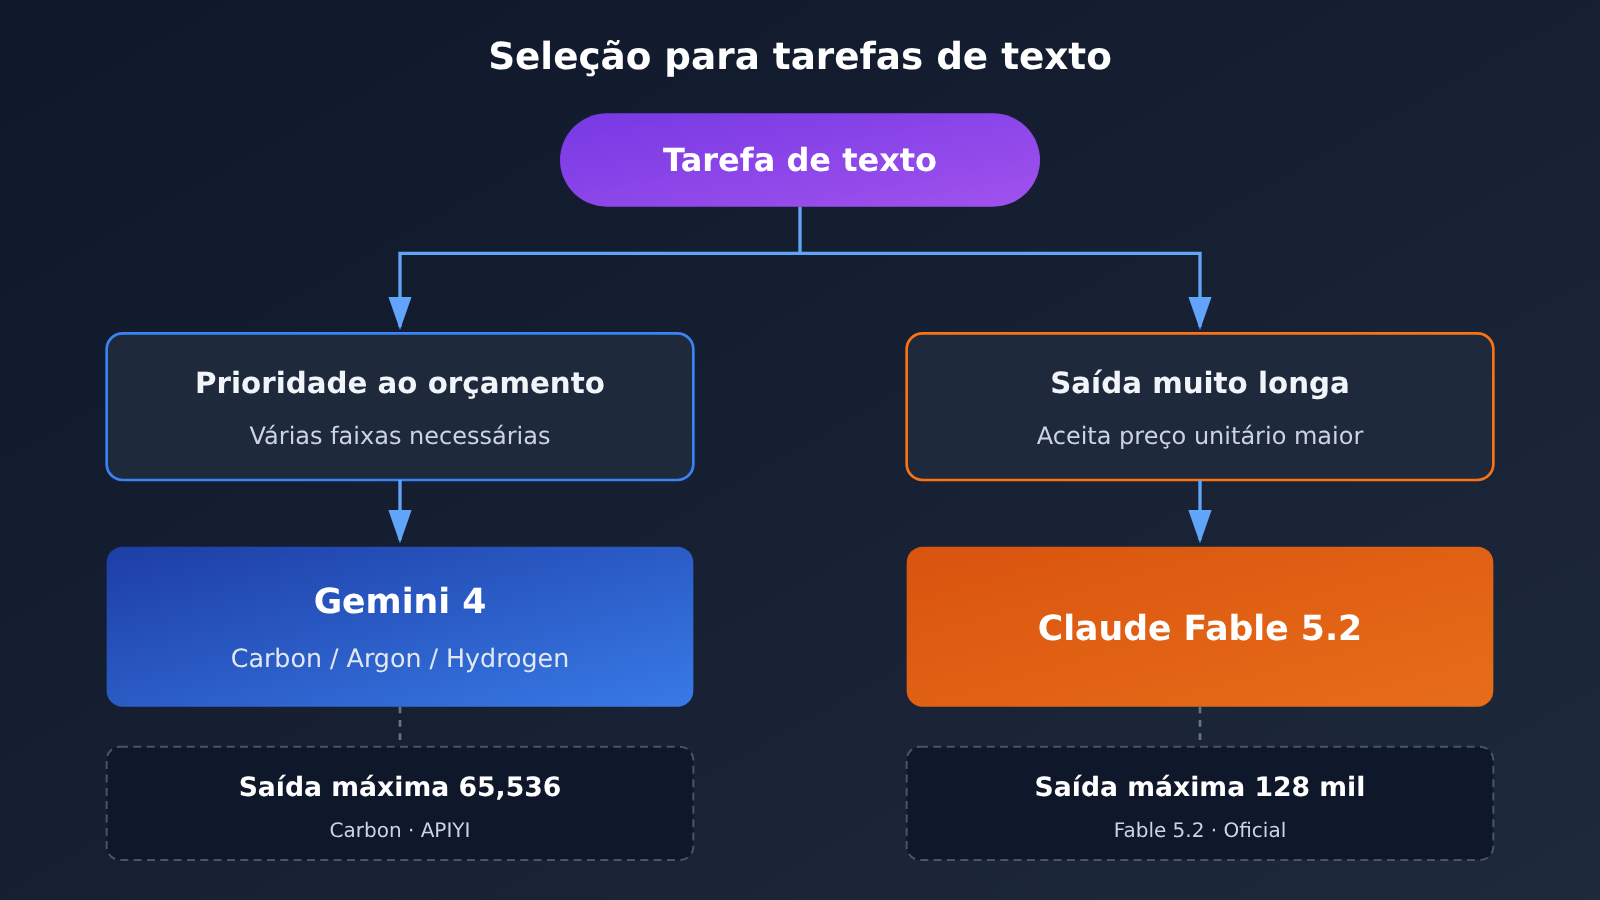
Comparação de preços e formas de invocação dos novos modelos de IA de novembro de 2026
Colocando os dois novos modelos de texto e seus modelos vizinhos lado a lado, a diferença de preço fica bem mais clara. Os preços unitários abaixo estão em dólares por milhão de tokens e vêm da tabela geral de modelos do APIYI do mesmo dia.
| ID do modelo | Entrada | Leitura de cache | Saída | Plataformas disponíveis |
|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | APIYI apiyi.com, Google oficial |
gemini-4-argon |
2 | 0.1 | 10 | APIYI, Google oficial |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | APIYI, Google oficial |
claude-fable-5-2 |
8 | 0.2 | 40 | APIYI, Anthropic oficial |
claude-fable-5-1 |
10 | 0.25 | 50 | APIYI, Anthropic oficial |
Vamos fazer as contas com um cenário hipotético: uma tarefa com 100 mil tokens de entrada e 10 mil tokens de saída. Calculando pelos preços unitários, o Carbon fica em cerca de 0.2 + 0.1 = 0.3 dólar, e o Fable 5.2 em cerca de 0.8 + 0.4 = 1.2 dólar. Isso é apenas uma ilustração aritmética com base nos preços unitários; na prática o Carbon pode sair mais caro por consumir mais tokens na verificação, então o gasto real deve ser conferido na fatura.
Quanto à forma de invocação, os dois modelos podem ser acessados pela interface compatível com OpenAI do APIYI, com o base_url sempre preenchido como https://api.apiyi.com/v1; para trocar de modelo, basta alterar o campo model. Uma única chave API já dá para invocar gemini-4-carbon e claude-fable-5-2 ao mesmo tempo, o que facilita fazer uma comparação A/B dentro do mesmo código.
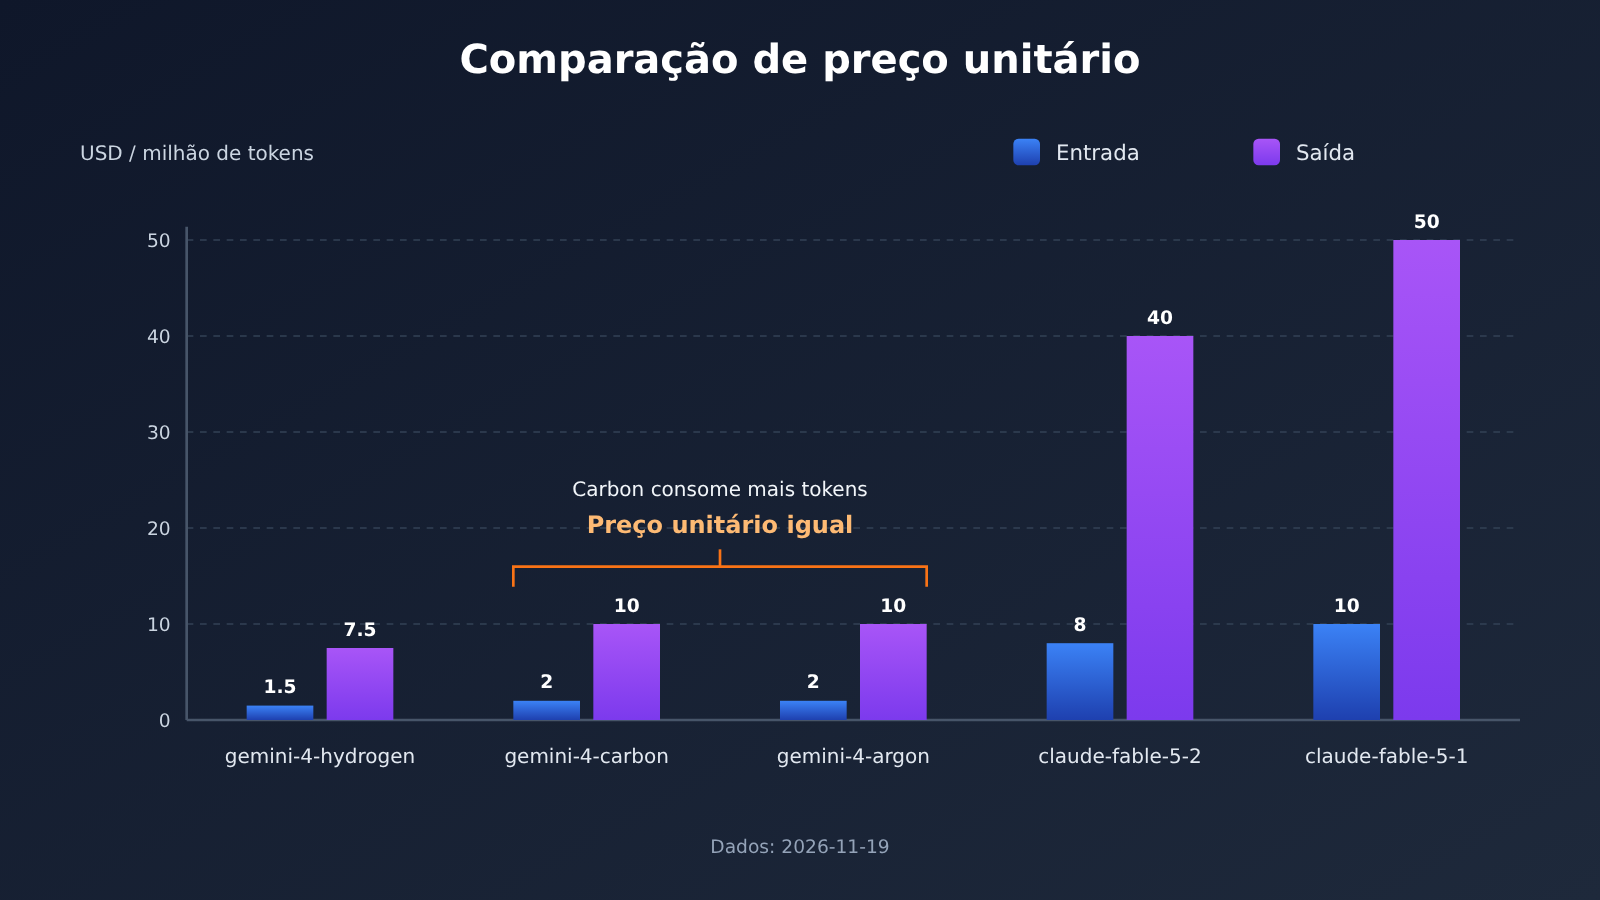
Nota do gráfico: os preços unitários mostrados no gráfico vêm da tabela geral de modelos do APIYI apiyi.com de 2026-11-19. As barras de Carbon e Argon terem a mesma altura significa apenas que o preço unitário é igual; o custo de uma tarefa precisa ser avaliado em conjunto com o consumo real de tokens.
Invocação rápida de Gemini 4 Carbon e Claude Fable 5.2 pela API
A seguir está a forma mais simples de chamada. Basta alterar o campo model para alternar entre os dois novos modelos:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

response = client.chat.completions.create(
    model="gemini-4-carbon",  # Troque para "claude-fable-5-2" para alternar
    messages=[{"role": "user", "content": "用三句话解释零信任架构"}]
)
print(response.choices[0].message.content)
Ver o código completo de chamada para comparação
import openai
from typing import Optional

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Ao usar a APIYI, a saída máxima do Carbon é planejada em 65,536 conforme a página do modelo
MAX_OUTPUT = {
    "gemini-4-carbon": 65536,
    "claude-fable-5-2": 8192,  # Ajuste conforme necessário; a saída máxima oficial é 128 mil
}

def ask(model: str, prompt: str, system: Optional[str] = None) -> dict:
    messages = []
    if system:
        messages.append({"role": "system", "content": system})
    messages.append({"role": "user", "content": prompt})

    resp = client.chat.completions.create(
        model=model,
        messages=messages,
        max_tokens=min(MAX_OUTPUT.get(model, 4096), 8192),
    )
    return {
        "model": model,
        "text": resp.choices[0].message.content,
        "prompt_tokens": resp.usage.prompt_tokens,
        "completion_tokens": resp.usage.completion_tokens,
    }

if __name__ == "__main__":
    task = "审查下面这段代码的安全隐患,并给出修复建议:..."
    for m in ["gemini-4-carbon", "claude-fable-5-2"]:
        r = ask(m, task, system="你是资深安全工程师")
        print(m, r["prompt_tokens"], r["completion_tokens"])
        print(r["text"][:300], "\n---")
O código completo imprime os tokens de entrada e saída de cada chamada, o que ajuda a verificar o ponto mencionado acima: “preço unitário igual, custo por chamada diferente”. Execute a mesma tarefa algumas vezes em cada modelo e compare completion_tokens; isso é mais confiável do que apenas olhar a tabela de preços.
🚀 Dica para começar rápido: se quiser comparar esses dois novos modelos nas suas próprias tarefas, registre-se primeiro na APIYI apiyi.com para obter créditos gratuitos de teste, rode o código acima uma vez em cada modelo e depois decida qual será o modelo principal com base no consumo de tokens e na qualidade da saída.
Novo modelo de vídeo de novembro de 2026: FastFrames é um conjunto de pesos de pesquisa
O FastFrames vem da equipe de pesquisa da Apple, com o artigo de número arXiv:2611.23226 e versão v1 datada de 2026-11-17. O projeto também tem uma página de projeto no GitHub Pages e disponibilizou no Hugging Face dois conjuntos de pesos: FastFrames-S e FastFrames-L.
Dados declarados no próprio artigo do FastFrames
Todos os números abaixo são declarados pelo próprio artigo, não são um ranking final de avaliação de terceiros e muito menos o preço por chamada de qualquer API.
| Versão | Parâmetros | Hardware declarado no artigo | Velocidade declarada no artigo | Resolução |
|---|---|---|---|---|
| FastFrames-S | 1,3 bilhão | uma única B200 | cerca de 36 ms por quadro | 480p |
| FastFrames-L | 14 bilhões | 8 placas B200 | cerca de 45 ms por quadro | 480p |
Nesta tabela dá para entender o posicionamento do FastFrames: ele demonstra um método de pesquisa para gerar vídeo rapidamente quadro a quadro em GPUs de alto desempenho. Para reproduzir essas velocidades, você precisa providenciar por conta própria hardware no nível de uma B200 e concluir a implantação — algo bem diferente de “preencher uma API Key e chamar o modelo”.
O FastFrames também é apenas uma pesquisa na área de vídeo, não um modelo generalista que processa texto e vídeo ao mesmo tempo. Se o seu objetivo é gerar vídeo no produto hoje, vale conferir na tabela geral de modelos da APIYI os modelos de vídeo já precificados por segundo; não coloque a velocidade por quadro dos pesos de pesquisa e o preço por segundo de uma interface na mesma comparação.
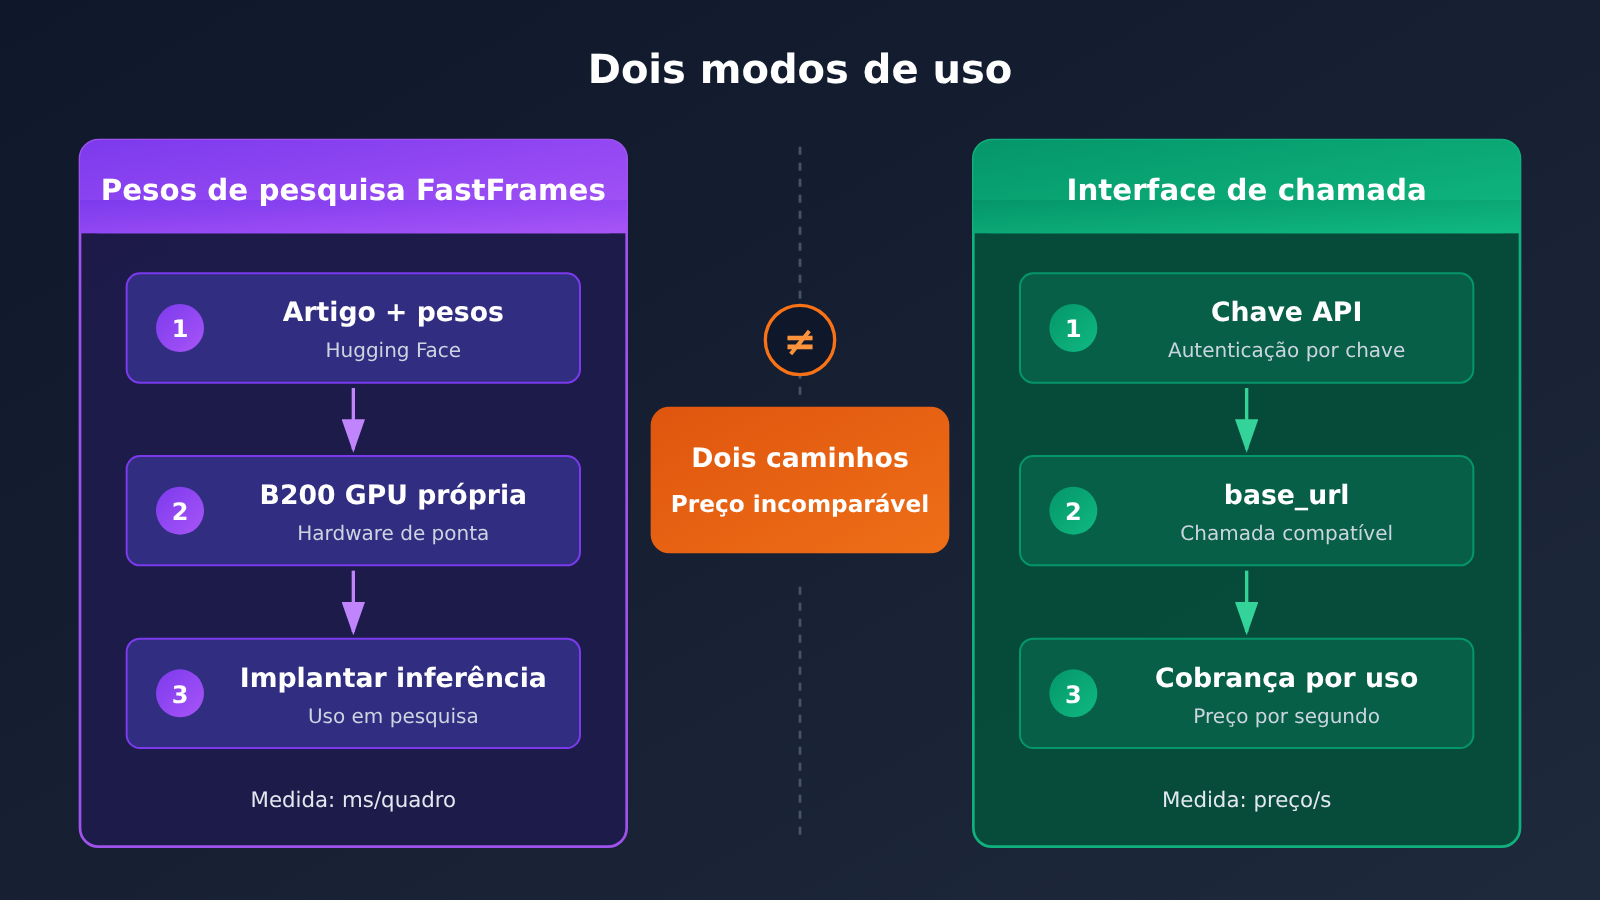
Análise de impacto dos novos modelos de IA de novembro de 2026
Impacto para desenvolvedores
- Mais opções de modelos de texto, custo de troca menor: Carbon e Fable 5.2 já suportam invocação compatível com OpenAI. Basta mudar um ID de modelo no mesmo código para comparar — ideal para rotear por tarefa em vez de apostar em um único modelo.
- A avaliação de custo deve considerar o consumo de tokens, não só o preço unitário: Carbon e Argon têm o mesmo preço unitário, mas a documentação oficial informa que Carbon usa mais tokens para verificação. O orçamento deve se basear na fatura real.
- O limite de saída precisa ser confirmado conforme o canal de invocação: a saída longa oficial do Carbon e os 65.536 da página do modelo na plataforma são duas referências distintas. Ao escrever o código, configure
max_tokensde acordo com o canal real. - Na área de vídeo, primeiro é preciso distinguir pesquisa de API: o FastFrames é adequado para equipes com recursos de GPU que querem pesquisar geração de vídeo em tempo real, e não para usar diretamente como API de vídeo em produtos online.
Impacto para o setor
- Abrir primeiro para cenários de segurança virou uma forma de lançamento: o Carbon foi liberado primeiro para defensores de segurança cibernética e só depois para desenvolvedores pagantes, mostrando que os fabricantes começaram a liberar novos modelos em fases por cenário.
- O preço unitário dos modelos de ponta está caindo: os três preços unitários do Fable 5.2 estão todos abaixo do Fable 5.1. A tendência de redução de preço na iteração de modelos do mesmo nível continua.
- A geração de vídeo busca tempo real: o artigo do FastFrames tem como meta velocidade de geração de quadro único na casa dos milissegundos. O foco da pesquisa está passando de “conseguir gerar” para “gerar rápido”.
Perguntas frequentes (FAQ)
Q1: Quais novos modelos de IA podem ser chamados diretamente via API em novembro de 2026?
Na área de texto, o Gemini 4 Carbon (`gemini-4-carbon`) e o Claude Fable 5.2 (`claude-fable-5-2`, `claude-fable-5-2-thinking`) podem ser chamados diretamente. Na área de vídeo, o FastFrames é um artigo científico com pesos de pesquisa, não uma interface chamável.
Q2: O Gemini 4 Carbon e o Gemini 4 Argon custam o mesmo — qual escolher?
O preço unitário dos dois é o mesmo: entrada a 2, leitura de cache a 0,1 e saída a 10 dólares por milhão de tokens. Só que o texto original do Google explica que o Carbon consome mais tokens para fazer verificação do que o Argon, então o custo por tarefa pode acabar maior. A sugestão é rodar cada um algumas vezes com tarefas reais e comparar o consumo de tokens e a qualidade dos resultados antes de decidir.
Q3: Afinal, qual é o limite máximo de saída do Gemini 4 Carbon?
Depende do canal. Ao chamar pela APIYI, planeje com base nos 65.536 tokens indicados na página do modelo. A documentação oficial do Google AI Studio diz que uma única resposta pode passar de 64K, chegando a até 1 milhão menos a entrada — essa é outra medida, referente ao ambiente nativo oficial.
Q4: Dá para usar o FastFrames para geração de vídeo em produtos?
O FastFrames é um resultado de pesquisa da Apple, que disponibiliza o artigo e os pesos no Hugging Face; a velocidade relatada no artigo depende de GPUs do nível B200. Para gerar vídeos direto por interface, escolha na tabela geral de modelos da APIYI um modelo de vídeo com preço por segundo, em vez de usar pesos de pesquisa para comparar preços.
Q5: Como chamar rapidamente o Gemini 4 Carbon e o Claude Fable 5.2?
Recomendamos testar os dois de forma unificada por uma plataforma de agregação de API:
1. Acesse a APIYI em apiyi.com e cadastre uma conta
2. Obtenha a chave API e a cota gratuita de teste para novos usuários
3. Use o código deste artigo, preenchendo `base_url` com `https://api.apiyi.com/v1` e `model` com `gemini-4-carbon` e `claude-fable-5-2`, respectivamente
Com uma única chave você chama os dois modelos ao mesmo tempo, o que facilita a comparação e a troca entre eles.
Q6: Quais restrições precisam de atenção nesses novos modelos?
O preço unitário do Carbon é igual ao do Argon, mas o consumo real de tokens pode ser maior, então o custo precisa ser confirmado na prática. O preço do Fable 5.2 é quatro vezes o do Carbon, e em cenários de saída longa o gasto cresce bastante. Todos os números de velocidade do FastFrames são auto-relatados no artigo e exigem uma GPU de alto desempenho própria — não dá para equipará-los ao desempenho de uma interface.
Principais pontos dos novos modelos de IA de novembro de 2026
- Dois modelos de texto já disponíveis para chamada:
gemini-4-carboneclaude-fable-5-2já podem ser chamados pela interface compatível com OpenAI. - O Carbon tem o mesmo preço unitário do Argon: ambos cobram 2 de entrada e 10 de saída em dólares por milhão de tokens, mas a documentação oficial diz que o Carbon consome mais tokens.
- O output do Carbon tem duas versões: pela plataforma, o planejamento é de 65,536; o número oficial para saída longa é outra informação.
- O Fable 5.2 está mais barato que o 5.1: entrada 8, leitura de cache 0.2, saída 40 — os três preços unitários ficaram abaixo da geração anterior.
- O FastFrames são pesos de pesquisa: paper da Apple mais pesos no Hugging Face; a velocidade é a declarada no paper, não um preço de API.
- Como começar: no APIYI, troque o ID do modelo usando a mesma chave e compare os dois novos modelos de texto.
Resumo
Os principais pontos dos novos modelos de IA de novembro de 2026:
- Na área de texto há duas novas opções: o Gemini 4 Carbon tem preço unitário baixo e várias faixas dentro da mesma família; o Claude Fable 5.2 tem limite oficial de saída maior e preço unitário menor que a geração anterior.
- O custo depende do consumo real: preço unitário igual não significa mesmo preço por chamada — a verificação extra do Carbon aparece no uso de tokens.
- Na área de vídeo, primeiro entenda a natureza de cada coisa: o FastFrames são pesos de pesquisa, adequados a equipes com recursos de GPU; para integrar em produto, escolha os modelos de vídeo cobrados por segundo.
Para quem quer colocar a mão na massa agora, o mais prático é dividir por tarefa: entregue o mesmo lote de tarefas reais ao Carbon e ao Fable 5.2, e decida com base na fatura e na qualidade da saída, em vez de confiar em qualquer ranking agregado. A recomendação é fazer essa rodada de comparação rapidamente pelo APIYI apiyi.com, com uma única chave; modelos e preços valem conforme a lista de modelos da plataforma.
📚 Materiais de referência
-
Blog oficial do Google – Anúncio de lançamento do Gemini 4 Carbon: data de disponibilidade e preço de introdução oficial
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/ - Descrição: inclui a declaração oficial de que o preço é o mesmo do Argon e a verificação do uso de mais tokens
- Link:
-
Google AI Studio – Notas de atualização do Gemini 4 Carbon: posição oficial sobre saídas longas
- Link:
aistudio.google.com/docs/whats-new-gemini-4-carbon - Descrição: fonte do texto oficial que afirma que uma única resposta pode passar de 64K
- Link:
-
Documentação oficial da Anthropic – Visão geral do Claude Fable 5.2: ID do modelo, contexto e preço
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: origem do dado de saída máxima de 128 mil e de leitura de cache a 2,5%
- Link:
-
Apple Research – Página do projeto FastFrames: artigo e descrição da pesquisa
- Link:
apple-aiml-research.github.io/ml-fastframes/ - Descrição: artigo arXiv:2611.23226, data da v1: 2026-11-17
- Link:
-
Hugging Face – Pesos do FastFrames: duas versões, S e L
- Link:
huggingface.co/apple/FastFrames-S - Descrição: ponto de download dos pesos de pesquisa; é preciso implantar a inferência por conta própria
- Link:
Autor: equipe técnica da APIYI
Contato técnico: fale conosco pela página inicial do site da APIYI; detalhes dos modelos e a documentação de invocação estão disponíveis na central de documentação docs.apiyi.com


