
Cache de comandos da OpenAI: quantas reutilizações valem a pena? Entenda o ponto de equilíbrio para 2 e 3 reutilizações
img-20bab36c8ddd95489ea169bc

Resposta direta: em condições ideais, o cache de prompt padrão de 30 minutos da OpenAI já fica mais barato a partir do segundo uso; o cache de 12 horas só começa a compensar no terceiro uso. Essas condições ideais significam: o mesmo prefixo fixo é gravado por inteiro no cache uma única vez, todas as … Ler mais
Calcule o custo de API de um artigo de IA: comparação de preços de entrada e saída de 7 modelos

img-e5e8ba271039af9097af631b

Conclusão: o custo de API de um artigo de IA — primeiro calcule a chamada, depois o produto final Segundo o snapshot de preços deste artigo, com entrada de 10 mil tokens e saída de 3.000 tokens, o custo teórico de uma geração fica em torno de 0.0066~0.10 dólares. Para chegar a um artigo publicável, … Ler mais

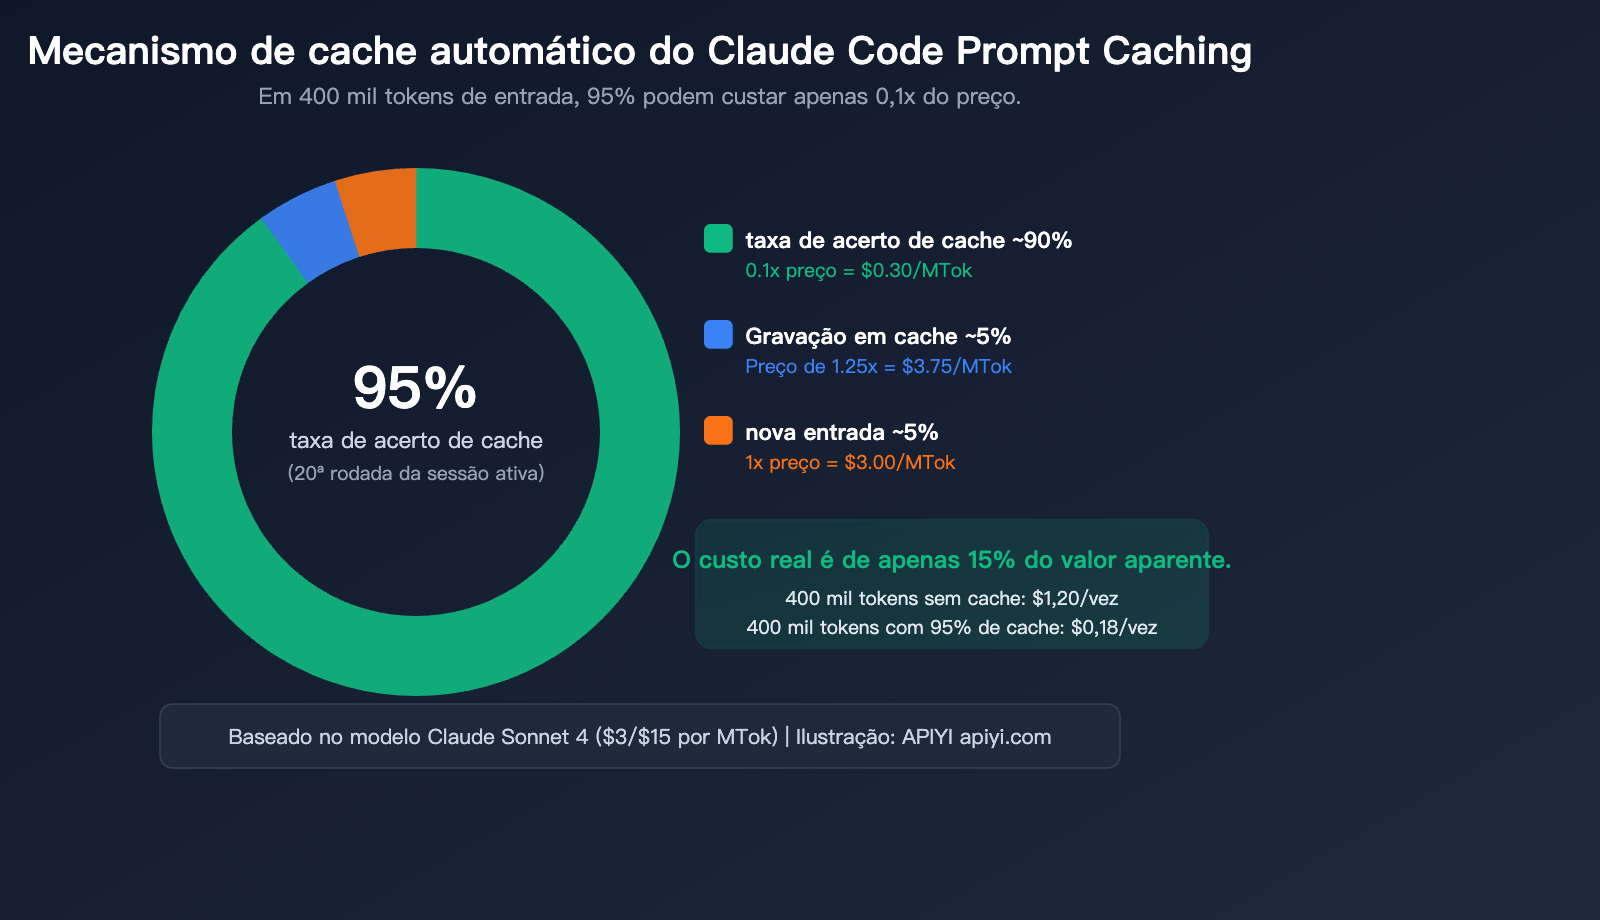
Taxa de acerto de cache do Claude Code elevada para 95%: 6 dicas práticas para reduzir 400 mil tokens de entrada para 50 mil

claude code prompt caching token optimization reduce input cost guide pt pt image 0 图示

"Por que meu Claude Code consome 400 mil tokens de entrada a cada solicitação? Por que a fatura está tão alta?" — essa é a reação imediata de muitos usuários do Claude Code ao conferir as estatísticas de uso. Na verdade, a grande maioria desses 400 mil tokens provavelmente já foi processada com sucesso pelo … Ler mais