
Dá para economizar, mas com condições. Segundo os dois exemplos hipotéticos que a documentação oficial do Google apresenta, num cenário com 200 ferramentas e contexto base de 2.000 Tokens, o input de Tokens do Gemini Tool Retrieval cai de 164.000 para 23.650, uma redução de cerca de 85,6%. Já num cenário com 10 ferramentas e contexto base de 30.000 Tokens, o input sobe de 68.000 para 92.830, um aumento de aproximadamente 36,5%. Se compensa ou não depende de uma pergunta: o Schema completo de ferramentas que você deixa de enviar cobre o custo extra de contexto gerado pela busca no servidor?
O que você vai aprender lendo este artigo?
- Qual parte dos Tokens o Tool Retrieval economiza e qual parte ele acrescenta.
- Os pressupostos completos e a decomposição item a item dos dois exemplos oficiais: o de 200 ferramentas e o de 10 ferramentas.
- A fórmula do ponto de equilíbrio derivada dos parâmetros oficiais e o método para julgar “a partir de quantas ferramentas vale a pena ativar o recurso”.
- Como usar o campo
interaction.usagee as regras de cache para calcular o custo real de uma tarefa de Agent.
Índice: começamos com uma tabela de conceitos e um resumo rápido dos impactos, para alinhar a terminologia e ajudar você a identificar a que tipo de leitor pertence. A parte de “Fatos objetivos” explica o mecanismo divulgado pelo Google, as regras de cobrança e os critérios originais dos dois exemplos. A parte de “Análise e julgamento” traz o ponto crítico derivado dos parâmetros oficiais, a diferença entre três tipos de “economia”, a fórmula da fatura de uma única tarefa e a tabela de decisão para ativar o recurso.
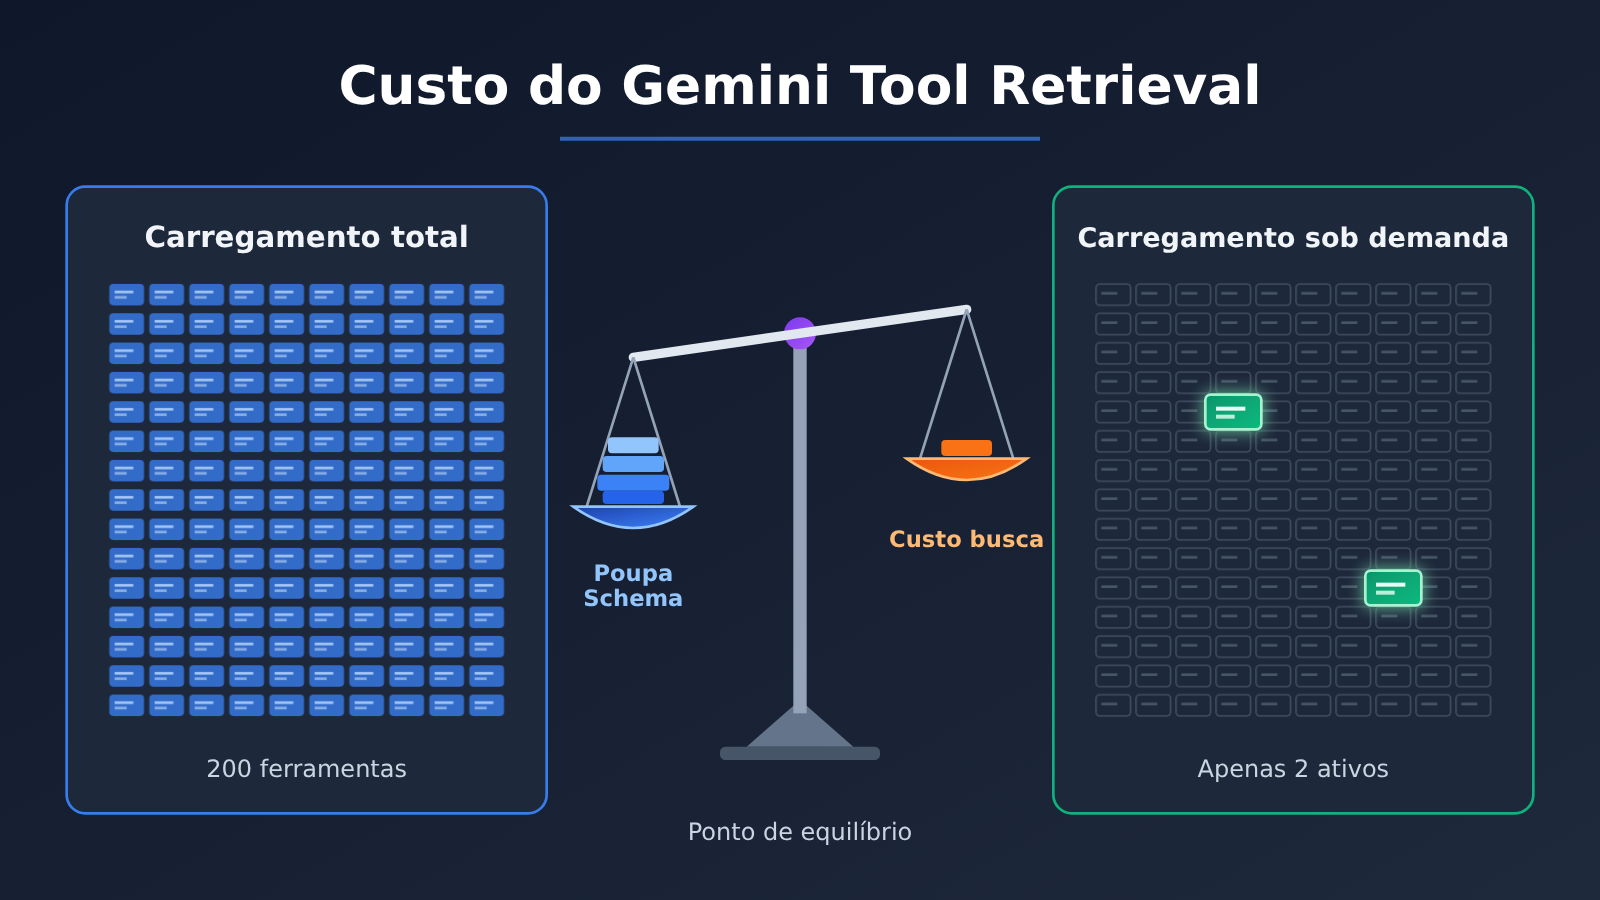
Análise de custos do Gemini Tool Retrieval To Know: explicação dos conceitos
| Conceito | Explicação resumida |
|---|---|
| Tokens de entrada | Unidade de medida do texto, contexto histórico e declarações de ferramentas enviados ao modelo para processamento |
| Schema da ferramenta | Definição completa dos parâmetros que o modelo usa para gerar chamadas de função; no exemplo de cálculo, cada uma tem cerca de 400 tokens |
| Lista de ferramentas adiada | Com defer_loading: true, o modelo inicialmente vê apenas o nome e a descrição breve de cada ferramenta; nos primeiros testes oficiais, cada item tinha cerca de 26 tokens |
| Contexto base B | Informações históricas e da tarefa que cada invocação do modelo já processaria normalmente no exemplo de cálculo |
| Raciocínio após busca | Uma nova invocação do modelo executada depois que o servidor recupera a ferramenta, levando o contexto atual e o schema recém-adicionado |
total_tool_use_tokens |
Dentro da mesma requisição, o volume extra de entrada das invocações do modelo provocado por ferramentas do servidor e por buscas |
total_cached_tokens |
A parte do uso de entrada processada por cache e cobrada pela tarifa de cache |
| Ponto de equilíbrio | Sob o mesmo conjunto de hipóteses, a fronteira em que o custo de entrada do carregamento estático e o do carregamento sob demanda se igualam |
| Custo por tarefa bem-sucedida | A soma dos custos de cada rodada de invocação do modelo e das ferramentas necessárias para concluir um objetivo de negócio |
Gemini Tool Retrieval: visão rápida dos impactos
- Desenvolvedores de Agent que conectam grandes bibliotecas de ferramentas: quando há muitas ferramentas e cada tarefa usa apenas algumas, existe a oportunidade de reduzir bastante o custo de schema repetido na entrada. Esse é o cenário do exemplo oficial com 200 ferramentas.
- Desenvolvedores de aplicações com poucas ferramentas e contextos longos: cada busca no servidor exige uma inferência extra do modelo e um novo processamento do contexto longo, então ativar o recurso pode sair mais caro. O exemplo oficial com 10 ferramentas é justamente o contraexemplo.
- Engenheiros e pessoal de FinOps responsáveis pela apuração de custos: olhar apenas o
total_input_tokensda primeira requisição subestima o custo; é preciso incluir tambémtotal_tool_use_tokens, os acertos de cache e os tokens de saída. - Equipes de plataforma que mantêm o catálogo corporativo de ferramentas: o modo de recuperação no cliente permite combinar filtragem própria de permissões e ferramentas dinâmicas, mas cada busca adiciona uma ida e volta à API, e a base de cálculo de custo precisa ser avaliada separadamente.
Fatos objetivos: lançamento e mecânica de cobrança do Gemini Tool Retrieval
O que é o Gemini Tool Retrieval e quando foi lançado
Em 19 de novembro de 2026, o Google anunciou no blog oficial a abertura do recurso Tool Retrieval em fase de pré-visualização (Preview) na Gemini Interactions API. O recurso está em Preview e exige a versão v1beta da API — o método antigo generateContent não é compatível. Para habilitar o modo servidor, basta incluir {"type": "tool_search"} no array tools e definir defer_loading: true nas function ou mcp_server que você quer carregar sob demanda.
Até 20 de novembro de 2026, a documentação para desenvolvedores lista explicitamente quatro IDs de modelo compatíveis: gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash e gemini-3.6-flash. A menção no anúncio a “modelos Gemini 3.6 e mais recentes” é mais abrangente, mas modelos que não aparecem na documentação precisam ser verificados por conta própria; definir defer_loading em um modelo não suportado retorna HTTP 400.
Vale destacar um ponto que costuma ser mal interpretado: no modo servidor, o desenvolvedor continua precisando enviar o array tools completo a cada requisição, incluindo todos os parâmetros das ferramentas adiadas — mesmo quando usa previous_interaction_id. O que o Tool Retrieval muda é o momento em que o Schema completo entra na janela de contexto do modelo, e não o fato de essas definições deixarem de ser enviadas no corpo da requisição.
De onde vêm os custos do carregamento estático e do Gemini Tool Retrieval
No carregamento estático, toda invocação do modelo precisa ler o Schema completo de todas as ferramentas, mesmo que nesta rodada só seja usada uma função de reembolso. O Tool Retrieval substitui essas definições completas por uma lista curta de ferramentas; quando o modelo precisa, ele emite um tool_search_call, o servidor devolve um tool_search_result contendo o Schema completo, e o modelo então gera o function_call com base nisso.
O Google afirma explicitamente que o Tool Retrieval não tem taxa de funcionalidade independente, mas os itens abaixo continuam sendo cobrados conforme a tarifa do modelo escolhido:
- Todos os itens curtos da lista de ferramentas adiadas.
- As instruções de busca fixas adicionadas ao ativar o
tool_search. - A inferência extra do modelo disparada a cada recuperação no servidor, que reprocessa todo o contexto e o Schema recém-carregado.
- O Schema completo das ferramentas carregadas, bem como sua ocupação contínua nas rodadas seguintes (a documentação atual não oferece mecanismo de descarregamento).
- Os Tokens normais de saída, de Thinking e relacionados aos resultados de execução das ferramentas.
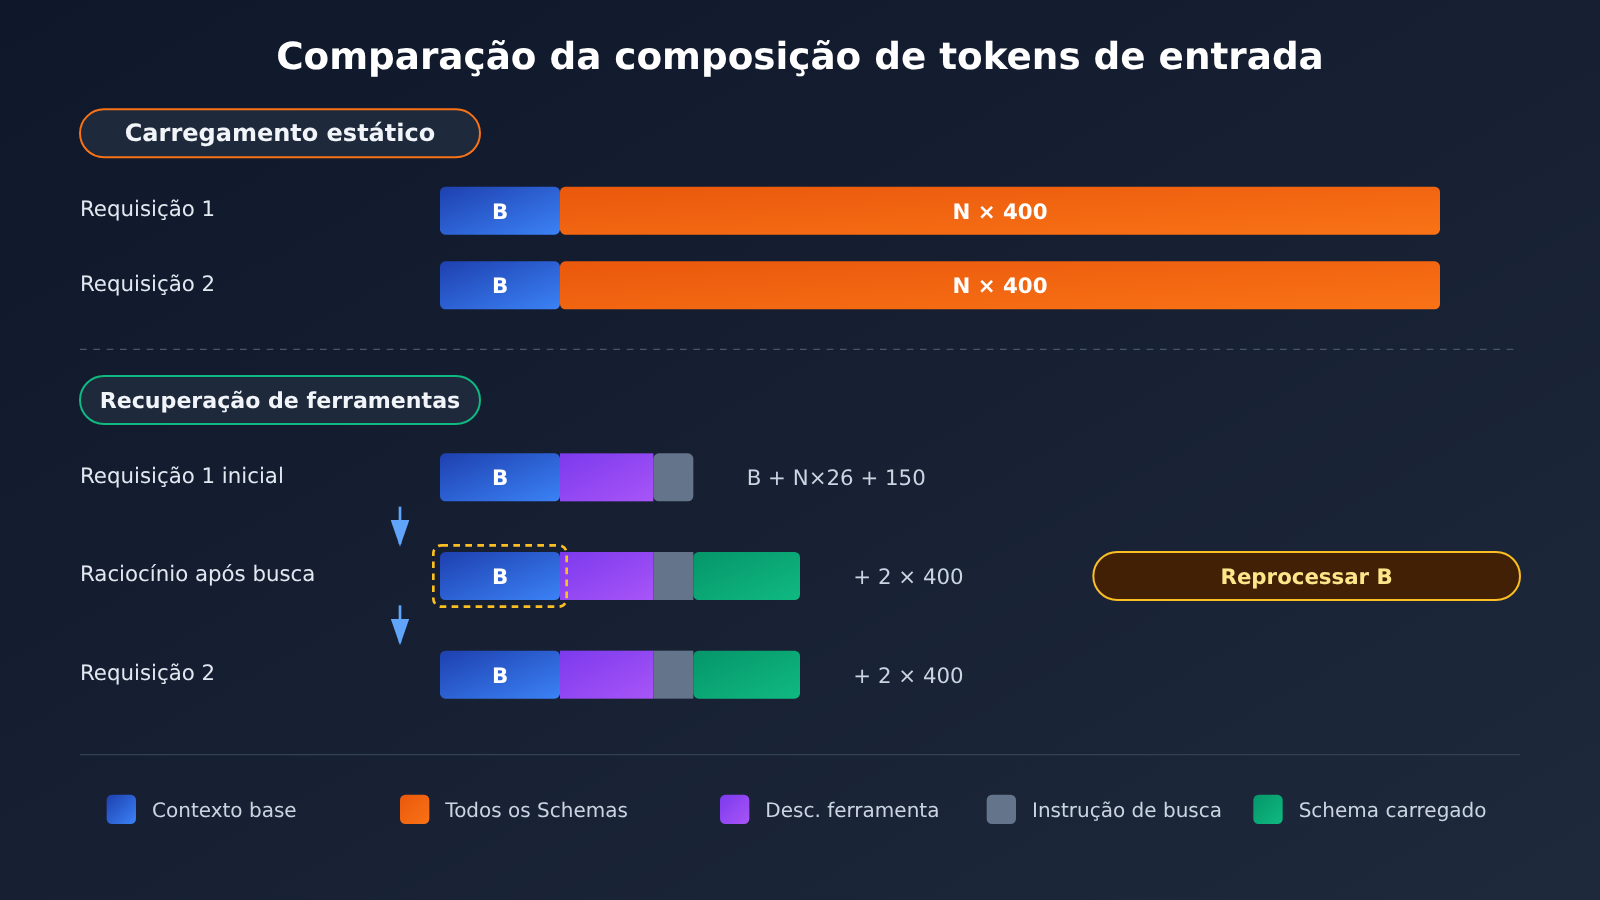
Os dois conjuntos de exemplos vêm da documentação do Tool Retrieval do Google. São cálculos hipotéticos explicitamente marcados como oficiais, não benchmarks de ambiente de produção, e ambos ignoram os tokens de saída e os ganhos de cache. O critério unificado é: cada Schema completo com 400 tokens, cada descrição resumida de ferramenta carregada sob demanda com cerca de 26 tokens, instrução de busca com 150 tokens, uma tarefa com 2 requisições externas, 1 busca no servidor concluída na primeira requisição e 2 ferramentas carregadas no total.
| Item de cálculo | 200 ferramentas, B=2,000 | 10 ferramentas, B=30,000 |
|---|---|---|
| Carregamento estático: 2 × (B + N × 400) | 164,000 | 68,000 |
| Entrada inicial da requisição 1 (B + N × 26 + 150) | 7,350 | 30,410 |
| Inferência após a busca na requisição 1 (mais 2 Schemas) | 8,150 | 31,210 |
| Entrada da requisição 2 | 8,150 | 31,210 |
| Total do Tool Retrieval | 23,650 | 92,830 |
| Variação | -140,350 | +24,830 |
| Magnitude da variação (recalculada a partir dos números oficiais) | cerca de -85.6% | cerca de +36.5% |
O cenário com 200 ferramentas economiza de forma evidente porque o esquema estático carrega 80,000 tokens de definições de ferramentas em toda requisição, enquanto o contexto base tem apenas 2,000; o custo de rodar a inferência mais uma vez na busca é pequeno. O cenário com 10 ferramentas é justamente o contrário: as definições somam apenas 4,000 tokens, então a margem de economia é limitada, e a inferência após a busca precisa reprocessar todo o contexto longo de 30,000 tokens, fazendo a sobrecarga nova superar direto a economia.
Campos usage, preços e regras de cache do Tool Retrieval do Gemini
O Google disponibiliza no interaction.usage os campos necessários para analisar o custo do Tool Retrieval:
| Campo | Significado | Papel na análise de custo |
|---|---|---|
total_input_tokens |
Entrada da primeira invocação do modelo dentro da solicitação | Reflete apenas “quanto o contexto inicial encurtou” |
total_tool_use_tokens |
Entrada de invocações extras do modelo causadas por ferramentas do servidor e busca | Principal fonte do custo de busca, e a mais fácil de passar despercebida |
total_cached_tokens |
Parte já incluída na entrada e processada pelo cache | Cobrada pela tarifa de cache; não deve ser somada novamente |
total_output_tokens |
Saída gerada pelo modelo | Cobrada pela tarifa de saída |
total_thought_tokens |
Tokens gerados durante o processo de raciocínio | Cobrados pela tarifa de saída do modelo escolhido |
Em relação aos preços, na tabela Standard da página de preços do Google, o Gemini 4 Hydrogen tem entrada de US$ 1,50 por milhão de tokens, saída (incluindo Thinking) de US$ 7,50 e entrada em cache de US$ 0,075. Se usarmos apenas esse preço unitário de entrada para fazer uma conversão aritmética do exemplo oficial, o cenário com 200 ferramentas fica em cerca de US$ 0,246 contra US$ 0,0355, e o cenário com 10 ferramentas fica em cerca de US$ 0,102 contra US$ 0,139. Isso é apenas multiplicar contagens hipotéticas de tokens pelas tarifas oficiais; não se trata de nenhuma fatura real.
Há dois limites nas regras de cache que precisam ser entendidos separadamente. Primeiro, a Interactions API só oferece cache implícito; até 20 de novembro de 2026, a escala mínima de entrada para cache implícito nas séries Gemini 4, Gemini 3.8 Flash e Gemini 3.6 Flash é de 4.096 tokens. Segundo, no diálogo multiturno e no Agent Loop do Gemini 4, a nova solicitação precisa acrescentar pelo menos 2.050 tokens para que o sistema faça cache da solicitação anterior completa; se ficar abaixo disso, os últimos 2.050 tokens da solicitação anterior serão cobrados novamente pela tarifa padrão de entrada, e a saída do modelo, o Thinking e os resultados de funções entram nesse incremento.
Até a data de verificação das informações, o Google não divulgou a proporção de tokens economizados pelo Tool Retrieval em conjuntos de tarefas reais, a melhoria de latência nem o aumento da precisão na seleção de ferramentas, e também não há testes de produção de desenvolvedores independentes suficientemente verificáveis.
Análise: quando o Gemini Tool Retrieval realmente economiza tokens
O ponto de equilíbrio do Gemini Tool Retrieval: com quantas ferramentas vale a pena ativar
A seguir estão exemplos estendidos derivados dos parâmetros do exemplo oficial, e não um limite universal publicado pelo Google. Seja N o número total de ferramentas e B o contexto base, mantendo S=400, D=26, H=150, K=2 e a premissa de “duas requisições, uma busca”:
- Carregamento estático: T_static = 2 × (B + 400N)
- Carregamento sob demanda: T_retrieval = 3 × (B + 26N + 150) + 2 × 2 × 400
Essa fórmula reproduz integralmente os dois resultados oficiais. Fazendo T_retrieval < T_static, chegamos a 722N > B + 2050, ou seja, N > (B + 2050) / 722. O 2050 aqui vem de 3 × 150 + 1600 e é apenas um resultado algébrico; não tem nenhuma relação com a condição de acréscimo de 2,050 tokens do cache multirrodada do Gemini 4 no documento de cache. Não misture as duas coisas.
| Contexto base B | Número de ferramentas N | Carregamento estático | Tool Retrieval | Mudança | Percentual | Tipo de dado |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | Exemplo oficial |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | Exemplo oficial |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | Derivação estendida |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | Derivação estendida |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | Derivação estendida |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | Derivação estendida |
Com B=30,000, o ponto crítico é N > 44.39 — ou seja, a partir da 45ª ferramenta o carregamento sob demanda passa a ter uma leve vantagem, e perto do ponto de equilíbrio a economia é quase desprezível. Com a mesma fórmula, se B=2,000, o valor crítico fica em torno de 5.6, ou seja, 6 ferramentas já fazem a balança virar. Daí dá para ver que quanto maior o contexto base, mais ferramentas são necessárias para diluir o custo de reprocessar o contexto durante a busca.
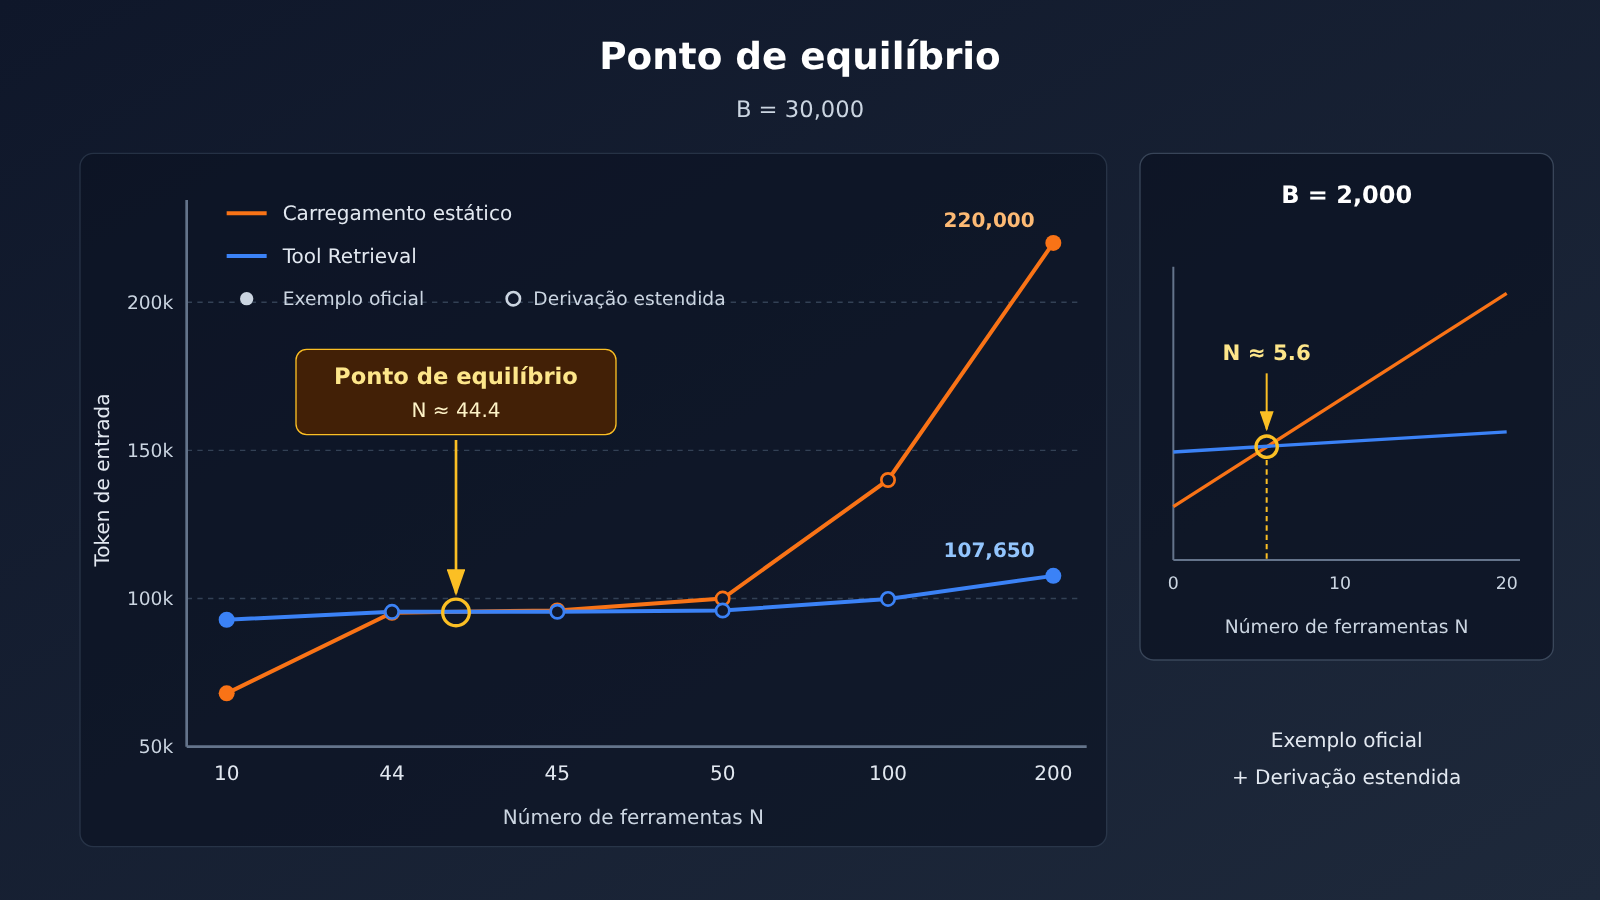
Legenda: as duas primeiras linhas de dados são exemplos oficiais do Google; o restante é derivação com o mesmo critério. Em tarefas reais, o número de buscas e a quantidade carregada vão mudar a curva. Vale a pena testar de novo com suas próprias requisições de negócio — dá para usar a interface unificada da APIYI apiyi.com para montar rapidamente uma linha de base de carregamento estático de vários modelos e comparar.
Tarefas do mundo real raramente seguem à risca esse conjunto de suposições; as variáveis abaixo deslocam o ponto de equilíbrio:
- Número de buscas: cada busca adicional no servidor adiciona uma entrada do modelo próxima do tamanho “B + lista de ferramentas + Schema já carregado”; em cenários de contexto longo, equivale a pagar B novamente a cada busca.
- Quantidade efetivamente carregada K: quanto mais ferramentas carregadas, menor a economia; um Schema já carregado não pode ser descarregado e continua se acumulando em sessões longas.
- Tamanho de um único Schema S: ferramentas com parâmetros complexos e descrições longas têm maior ganho com carregamento sob demanda; quando o Schema é muito curto, o ganho acaba sendo consumido pelos itens da lista e pelas instruções de busca.
- Número de turnos da conversa: na abordagem estática, todos os Schemas precisam ser repetidos a cada turno; quanto mais turnos e quanto menos novas buscas forem disparadas, mais evidente fica a vantagem do carregamento sob demanda.
Menos tokens de entrada, cobrança total menor e respostas mais rápidas: as três “economias” do Gemini Tool Retrieval
Essas três coisas costumam ser confundidas, mas não são equivalentes. A redução de tokens de entrada é a mais intuitiva, mas, se você olhar apenas para total_input_tokens, vai deixar de fora a inferência após a busca registrada em total_tool_use_tokens, superestimando assim a economia.
A queda na cobrança total também depende do cache e do preço unitário. O carregamento sob demanda encurta o prompt inicial; se antes você só ultrapassava o limiar de 4,096 tokens do cache implícito por causa de uma grande quantidade de Schemas, ao ativar o recurso pode acabar perdendo o cache. Se o ciclo curto de chamada de função e retorno de resultado adicionar menos de 2,050 tokens, o Gemini 4 também não consegue obter o cache completo da requisição anterior. Ou seja: menos tokens, mas a estrutura de preços unitários pode piorar.
Respostas mais rápidas ainda não têm qualquer respaldo em dados oficiais ou independentes. A busca no servidor não aumenta as idas e voltas do cliente, mas a requisição realmente executa mais inferência de modelo internamente; já a recuperação no cliente adiciona uma ida e volta de API a cada busca. Se a latência melhora ou piora, só o seu próprio teste de ponta a ponta pode responder.
Como calcular a fatura real de uma tarefa do Gemini Tool Retrieval Agent
Com base na semântica oficial de Usage, partindo do pressuposto de cobrança padrão, tokens de cache já incluídos na entrada e nenhuma outra ferramenta com cobrança por uso, um único request pode ser estimado assim:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1.000.000
Onde I, U, C, O e T correspondem, na ordem, aos cinco campos da tabela acima. Uma tarefa de Agent normalmente abrange vários requests, então é preciso somar o Usage de cada request antes de fazer o cálculo e, por fim, usar “custo total ÷ número de tarefas concluídas com sucesso” para chegar ao custo por tarefa bem-sucedida.
Antes de ativar o Tool Retrieval, o mais confiável é medir primeiro a linha de base de carregamento estático. Abaixo, rodamos um Function Calling estático pela interface compatível com OpenAI e registramos o Usage da linha de base:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unificada da APIYI, usada para rodar a linha de base de carregamento estático
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # Nome do modelo conforme a lista de modelos da plataforma
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # Registra os tokens de entrada e saída no carregamento estático completo
Vale esclarecer que o próprio Tool Retrieval depende da versão v1beta da Google Interactions API. O exemplo acima serve apenas para obter os dados de comparação do carregamento estático; do lado do carregamento sob demanda, use o método de chamada compatível com a Interactions API e depois coloque o Usage dos dois lados na mesma fórmula de custo para comparar.
Ver o código completo da implementação: cálculo do ponto de equilíbrio + estimativa da fatura de Usage
import openai

# ---------- 1. Cálculo teórico conforme os critérios do exemplo oficial (exemplo estendido, não são limiares oficiais) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # válido apenas quando S=400, D=26, H=150, K=2

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("Número crítico de ferramentas com B=30000:", round(breakeven_tools(30000), 2))

# ---------- 2. Estimar o custo por requisição (em dólares) a partir do campo Usage ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T correspondem a total_input / tool_use / cached / output / thought tokens"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# Exemplo: preço padrão do Gemini 4 Hydrogen 1.50 / 0.075 / 7.50 (por milhão de tokens)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. Baseline de carregamento estático (interface compatível com OpenAI) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # ao agregar tarefas de várias rodadas, some requisição por requisição
🚀 Início rápido: a sugestão é primeiro rodar o baseline de carregamento estático no APIYI apiyi.com com uma única chave, registrar o número de tokens e a taxa de conclusão do conjunto real de tarefas de negócio, e só então decidir se vale migrar o Agent para carregamento sob demanda — evitando alterar a arquitetura com base apenas nos números ilustrativos oficiais.
Decisão de ativação do Gemini Tool Retrieval: sua biblioteca de ferramentas está qualificada?
Combinando as recomendações oficiais de engenharia com a derivação acima, dá para fazer uma avaliação inicial com a tabela a seguir, mas o veredito final ainda deve se basear no custo por tarefa bem-sucedida e na taxa de conclusão em tarefas reais:
| Característica da carga de trabalho | Estratégia recomendada | Motivo |
|---|---|---|
| Menos de cerca de 20 ferramentas estáveis, a maioria usada em toda rodada | Continuar com carregamento estático | Recomendação oficial; a economia de Schema é pequena, e a sobrecarga de busca ocupa uma proporção alta |
| Poucas ferramentas, mas contexto base muito longo | Carregamento estático, ou postergar apenas algumas ferramentas com Schema grande | Cada busca reprocessa o contexto longo; o exemplo com 10 ferramentas já é um contraexemplo |
| Dezenas a centenas de ferramentas, usando apenas poucas por vez | Priorizar a avaliação da recuperação no servidor | Bibliotecas grandes com cauda longa de ferramentas correspondem ao cenário do exemplo oficial de 200 ferramentas |
| Mistura de ferramentas de alta frequência + muitas ferramentas especializadas de baixa frequência | Carregar diretamente as de alta frequência e usar defer_loading nas de baixa frequência |
Uso híbrido recomendado oficialmente, evita que tarefas simples também façam busca primeiro |
| Multi-inquilino, ferramentas dinâmicas, necessidade de filtragem por permissão do usuário | Avaliar a recuperação no cliente | Pode integrar a um registro próprio, mas cada busca adiciona uma ida e volta |
| Ferramentas frequentemente citadas nas instruções do sistema | Manter o carregamento direto | A recomendação oficial alerta que ferramentas postergadas citadas podem ser chamadas diretamente, ignorando a busca, e causar erros |
💡 Sugestão de escolha: rode a mesma bateria de tarefas com os dois esquemas, estático e sob demanda, mantendo consistentes o modelo, a biblioteca de ferramentas, o comprimento do contexto e as condições de cache. Através do APIYI apiyi.com é possível alternar entre diferentes Gemini e outros modelos mainstream sob uma interface unificada para comparação de linha de base, o que facilita atribuir a diferença de custo à própria estratégia de carregamento de ferramentas.
Há ainda alguns detalhes de engenharia que afetam diretamente a fatura: ao usar store=false e gerenciar o histórico por conta própria, é obrigatório preservar exatamente tool_search_call, tool_search_result e seus signature, caso contrário as requisições subsequentes podem retornar HTTP 400; não se pode omitir os parameters de ferramentas postergadas para reduzir o corpo da requisição; ao depurar, é preciso verificar os function_call em interaction.steps, e não apenas o interaction.status. Uma vez que esses problemas disparem novas tentativas, os tokens das requisições repetidas também entram no custo.
No fim das contas, Tool Retrieval é uma ferramenta de custo que parte do pressuposto de que “poucas ferramentas são usadas com frequência e a maioria fica ociosa por muito tempo”. Os dois exemplos oficiais com direções opostas já deixam claro o limite: quanto maior a biblioteca de ferramentas, mais curto o contexto e menos buscas, maior a chance de economizar; caso contrário, pode gastar mais. O que realmente deve ser otimizado não é o número de tokens da primeira requisição, mas a conta total por tarefa bem-sucedida.
Como escreveu Chen Danran, da dinastia Qing, em 《寤言·迁都建藩议》: “Quem não planeja o todo não é capaz de planejar uma parte.”
Materiais de referência
- Anúncio oficial do Google: Introducing Tool Retrieval in the Gemini API (2026-11-19)
- Link:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Link:
- Documentação técnica do Tool Retrieval do Google: configuração, cobrança, exemplos oficiais e limitações
- Link:
aistudio.google.com/docs/tool-retrieval
- Link:
- Documentação de Context caching do Google: limite do cache implícito e regras de cache multi-turn do Gemini 4
- Link:
aistudio.google.com/docs/caching
- Link:
- Preços da Gemini Developer API do Google: tarifas de entrada, saída e cache dos modelos
- Link:
aistudio.google.com/docs/pricing
- Link:
Autor: Equipe técnica da APIYI
Contato técnico: Se você quiser comparar o custo de tokens de vários modelos (como o Gemini) em cenários de Agent, acesse APIYI apiyi.com para obter créditos de teste. Mais instruções de integração estão no centro de documentação docs.apiyi.com


