
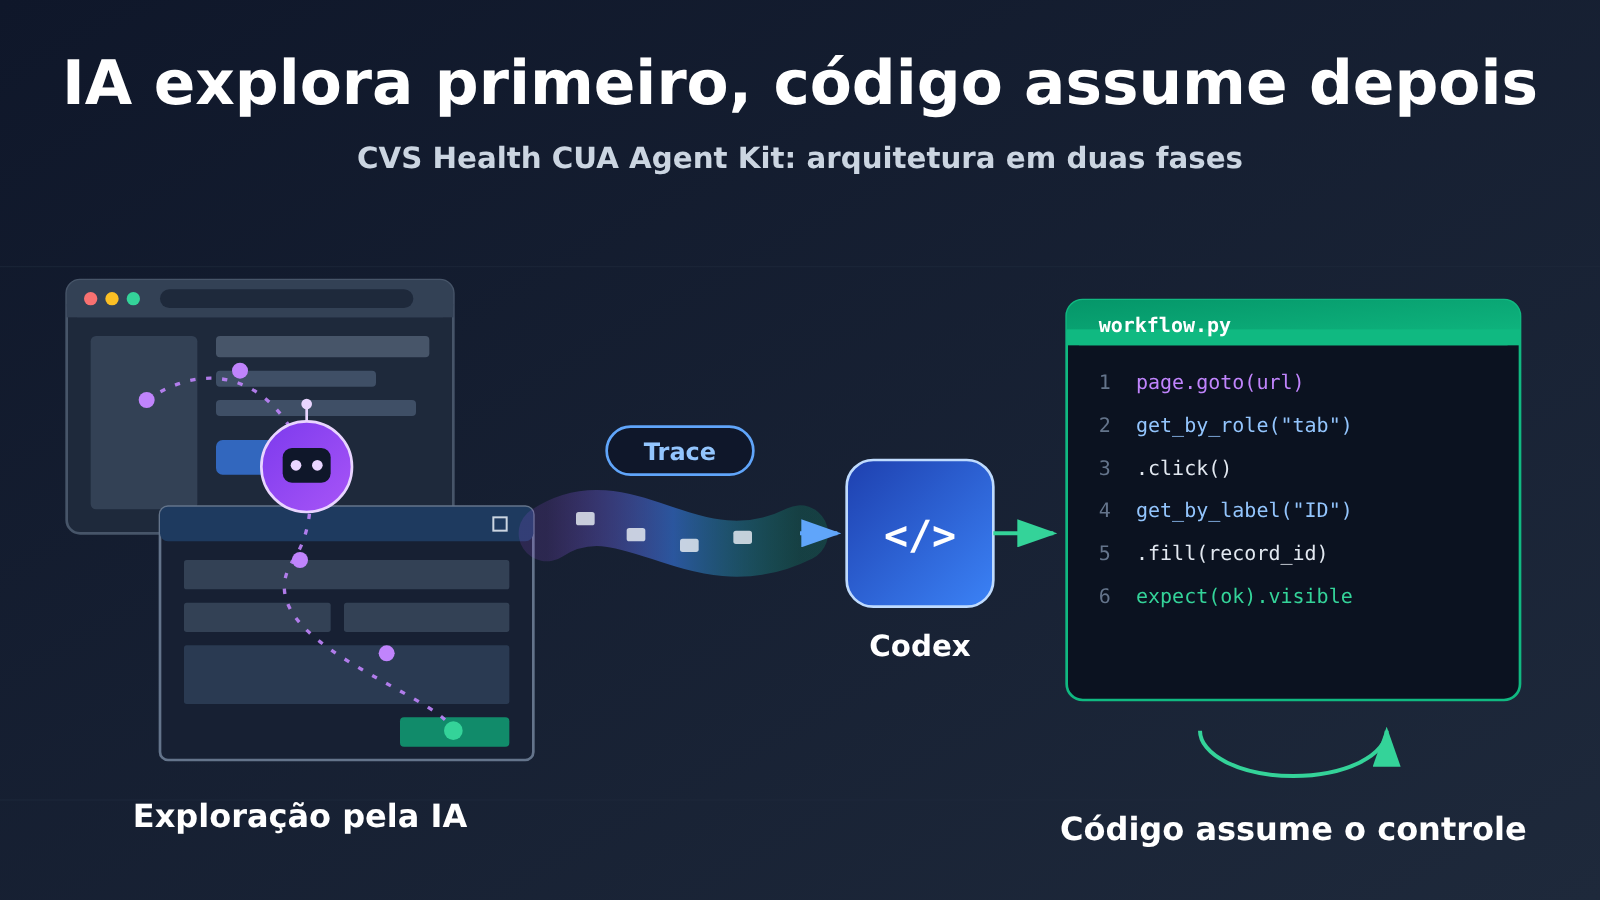
Agentes corporativos não precisam invocar novamente um Modelo de Linguagem Grande a cada tarefa repetida. O CUA Agent Kit, de código aberto pela CVS Health, oferece um caminho de engenharia mais econômico: primeiro, deixar o Computer-use Agent explorar processos de negócio desconhecidos e registrar o processo bem-sucedido em capturas de tela, eventos e Trace; depois, o Codex converte essas evidências em código determinístico que pode ser inspecionado, mantido e executado repetidamente.
A abordagem combina a capacidade de exploração flexível da IA com a execução estável da automação tradicional, formando uma arquitetura híbrida de “exploração por IA, consolidação em código e manutenção contínua”. A proposta não é o Agent substituir scripts, mas sim escrever e corrigir scripts.
O que você vai aprender ao ler este artigo?
- Como o CUA Agent Kit da CVS Health executa o fluxo em duas fases, da exploração por IA à consolidação em código
- Qual é o papel de capturas de tela, events.jsonl, Trace e localizadores semânticos na etapa de consolidação
- Como o fluxo fixo funciona sem chamar um Modelo de Linguagem Grande e como fazer sua manutenção quando surgem anomalias
A parte factual a seguir apresenta, em sequência: como funciona o CUA Agent Kit; o que acontece entre a operação por IA e o código Playwright; quais trabalhos de manutenção o Agent ainda assume depois da consolidação; quais são os fundamentos de pesquisa para a diferença entre essa arquitetura e o RPA tradicional; e como os desenvolvedores podem reutilizá-la na prática. A parte de análise e julgamento discute duas questões: por que é um desperdício o Agent pensar do zero toda vez, e quais tarefas são adequadas a essa arquitetura híbrida e quais devem manter revisão humana.
Para Saber: 7 conceitos para entender o caminho de automação do CVS Agent
| Conceito | Explicação breve |
|---|---|
| Computer Use | Capacidade de concluir tarefas observando a interface do software e executando cliques, digitação e outras operações |
| EHR | Sistema de registro eletrônico de saúde, o software central onde as instituições de saúde armazenam e processam os prontuários dos pacientes |
| MCP | Protocolo padrão para descobrir e invocar ferramentas externas |
| RPA | Forma de automação que executa processos repetitivos por meio de regras ou programas pré-configurados |
| Rubric points | Pontos de avaliação divididos conforme as regras de avaliação, que medem o cumprimento de cada parte dos requisitos |
| Taxa de sucesso ponta a ponta | Proporção de tarefas completas que atendem a todas as condições de sucesso |
| Trace | Evidência de trajetória que registra o processo de execução, as operações e os estados das páginas |
Visão rápida dos impactos: quem é afetado pelo caminho de automação do CVS Agent
- Desenvolvedores e líderes técnicos: o ponto central não é “usar ou não usar Agent”, mas dividir o mecanismo de execução conforme a tarefa. É preciso validar separadamente a taxa de conclusão da fase de exploração, a estabilidade do código consolidado e o custo total, incluindo manutenção — em vez de olhar apenas o preço de uma única invocação do modelo.
- Instituições de saúde e responsáveis por fluxos de trabalho: é preciso diferenciar demonstrações sintéticas, avaliações de fornecedores, casos públicos de empresas e pilotos próprios, pois cada tipo de evidência tem peso diferente. Nas etapas que envolvem dados de pacientes e mudanças de estado, a aprovação humana, o privilégio mínimo e o registro das operações devem ser definidos com antecedência.
Fato objetivo: a rota de duas etapas do CUA Agent Kit da CVS Health
Vamos começar pelo contexto. Em 16 de novembro de 2026, a OpenAI divulgou avanços do Computer-use Agent voltado a equipes de saúde, publicou resultados de avaliação em tarefas clínicas e de administração médica, além de práticas de colaboração com instituições como CVS Health, Cigna Healthcare, Abridge e Ambience. A CVS Health apresentou ali um caso em ambiente de produção e abriu o código do CUA Agent Kit sob licença Apache-2.0.
Os resultados de produção divulgados pela CVS Health incluem: em um determinado fluxo de trabalho produtivo, o Agent limpou, ao longo de um fim de semana, uma fila de envio de documentos que estava represada havia meses; outro Agent processa diariamente dezenas de milhares de passos de operação em sistemas durante consultas com especialistas. O sistema conta com verificações de validação e supervisão humana, e confere a operação real e o estado da aplicação por meio de capturas de tela e registros de ações. Vale observar que esses são dados divulgados pelas próprias empresas. “Dezenas de milhares” se refere a passos de operação em sistemas relacionados às consultas, e não significa que dezenas de milhares de decisões clínicas foram tomadas de forma independente pela IA. O material público também não esclarece se esses Agents de produção foram construídos inteiramente com base na versão open source do Agent Kit, e as duas coisas não devem ser tratadas como equivalentes.
Fonte: openai.com/index/advancing-computer-use-for-healthcare-teams/
Como funciona o CUA Agent Kit da CVS Health?
O README do projeto é bem direto quanto à sua proposta: é um kit inicial para automatizar fluxos de trabalho no navegador e no Windows, que usa IA para descobrir os passos e depois usa código para repeti-los. O projeto faz questão de destacar que “descobrir como a tarefa é feita” e “repeti-la de forma estável ao longo do tempo” são dois problemas distintos, que devem ser resolvidos com meios distintos.
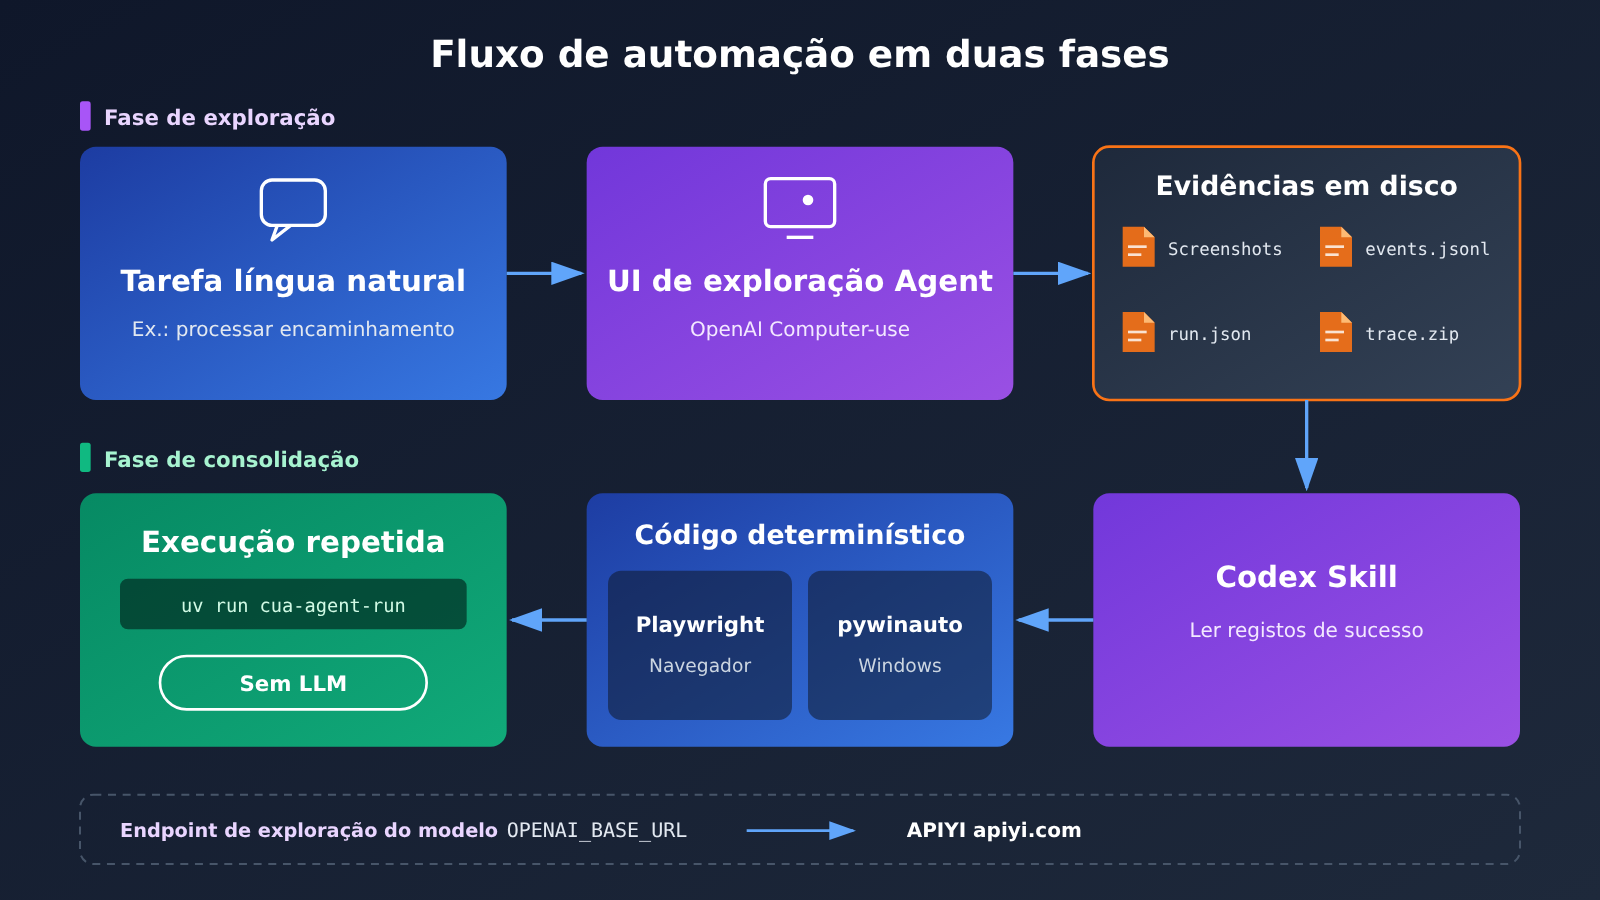
Todo o fluxo é dividido em duas etapas:
- Etapa de exploração: o Computer-use Agent da OpenAI recebe uma tarefa descrita em linguagem natural, por exemplo “encontrar um determinado registro e tratar um encaminhamento”, e explora, executa e valida essa tarefa na interface real. Durante o processo, ele salva capturas de tela, ações executadas, alvos das ações e a trajetória de execução.
- Etapa de consolidação: o Codex Skill lê os registros de exploração que deram certo e gera ou atualiza o código determinístico do fluxo de trabalho. Depois disso, a repetição do mesmo processo fica a cargo de código comum, sem exigir que o Modelo de Linguagem Grande re-raciocine a cada execução.
As evidências deixadas pela etapa de exploração são arquivos gravados em disco, e não um processo de raciocínio que permanece dentro do modelo. O README divulga os seguintes tipos de registro:
| Registro | Uso principal | Valor na etapa de consolidação |
|---|---|---|
| Screenshots | Registram o estado da interface em cada passo | Permitem que engenheiros e o Codex confiram como a página realmente é |
| events.jsonl | Registram os eventos de operação linha a linha | Reconstroem “o que foi feito e em que ordem” |
| run.json | Registra informações desta execução | Distinguem execuções diferentes e ajudam a determinar se houve sucesso |
| trace.zip | Trajetória de execução do Playwright | Fornece detalhes de elementos, rede e temporização, usados para gerar e diagnosticar código |
Fonte: github.com/cvs-health/cua-agent-kit
De operações de IA a código Playwright: o que o CVS Agent Kit faz?
Um dos detalhes mais importantes da fase de consolidação é que o que se gera não é uma “reprodução de coordenadas do mouse”. Ao gerar fluxos de trabalho de navegador, o projeto CVS usa Localizadores Semânticos (Semantic Locators) para produzir código Playwright, localizando o alvo por características semânticas do elemento, como papel e nome, em vez de memorizar uma coordenada de tela.
A diferença fica mais evidente na manutenção. A reprodução por coordenadas é afetada por resolução, tamanho da janela e pequenos ajustes de layout; se o botão se deslocar alguns pixels, o clique pode errar o alvo, e, quando algo dá errado, é difícil descobrir, a partir de uma sequência de coordenadas, o que se pretendia clicar. Já o código escrito com localizadores semânticos se parece com algo como “clicar no botão chamado ‘Enviar’”: a intenção fica expressa no código, o engenheiro pode revisar diretamente e é menos provável que quebre com pequenos ajustes na página. Claro que, se o botão for renomeado ou o fluxo for reformulado, os localizadores semânticos também falham; a diferença é que a falha é mais fácil de localizar.
A divisão de ferramentas do projeto é a seguinte:
- Playwright: responsável pela execução determinística de fluxos de trabalho no navegador e por gerar trajetórias reproduzíveis, como o arquivo trace.zip.
- pywinauto: responsável pela automação de aplicativos desktop Windows, cobrindo sistemas legados sem interface web.
- Codex Skill: lê trajetórias de exploração bem-sucedidas e gera ou atualiza os dois tipos de código acima.
Essa abordagem está alinhada com a direção da documentação oficial da OpenAI. O guia Computer Use da OpenAI apresenta dois caminhos: um em que o modelo retorna ações estruturadas de mouse e teclado, executadas pelo aplicativo; outro em que o modelo gera código e opera a interface com ferramentas como Playwright. A documentação recomenda a execução de código para o GPT-6 Astra, enquanto Computer Tool continua como opção. ComputerToolset, BrowserToolset e o ponto de entrada de navegador gerenciado são explicados separadamente no guia oficial.
Fonte: developers.openai.com/api/docs/guides/tools-computer-use
Depois da consolidação, o que os Agentes do CVS Agent Kit ainda precisam fazer?
Depois que o fluxo é consolidado, a execução determinística roda com o comando indicado no README:
uv run cua-agent-run
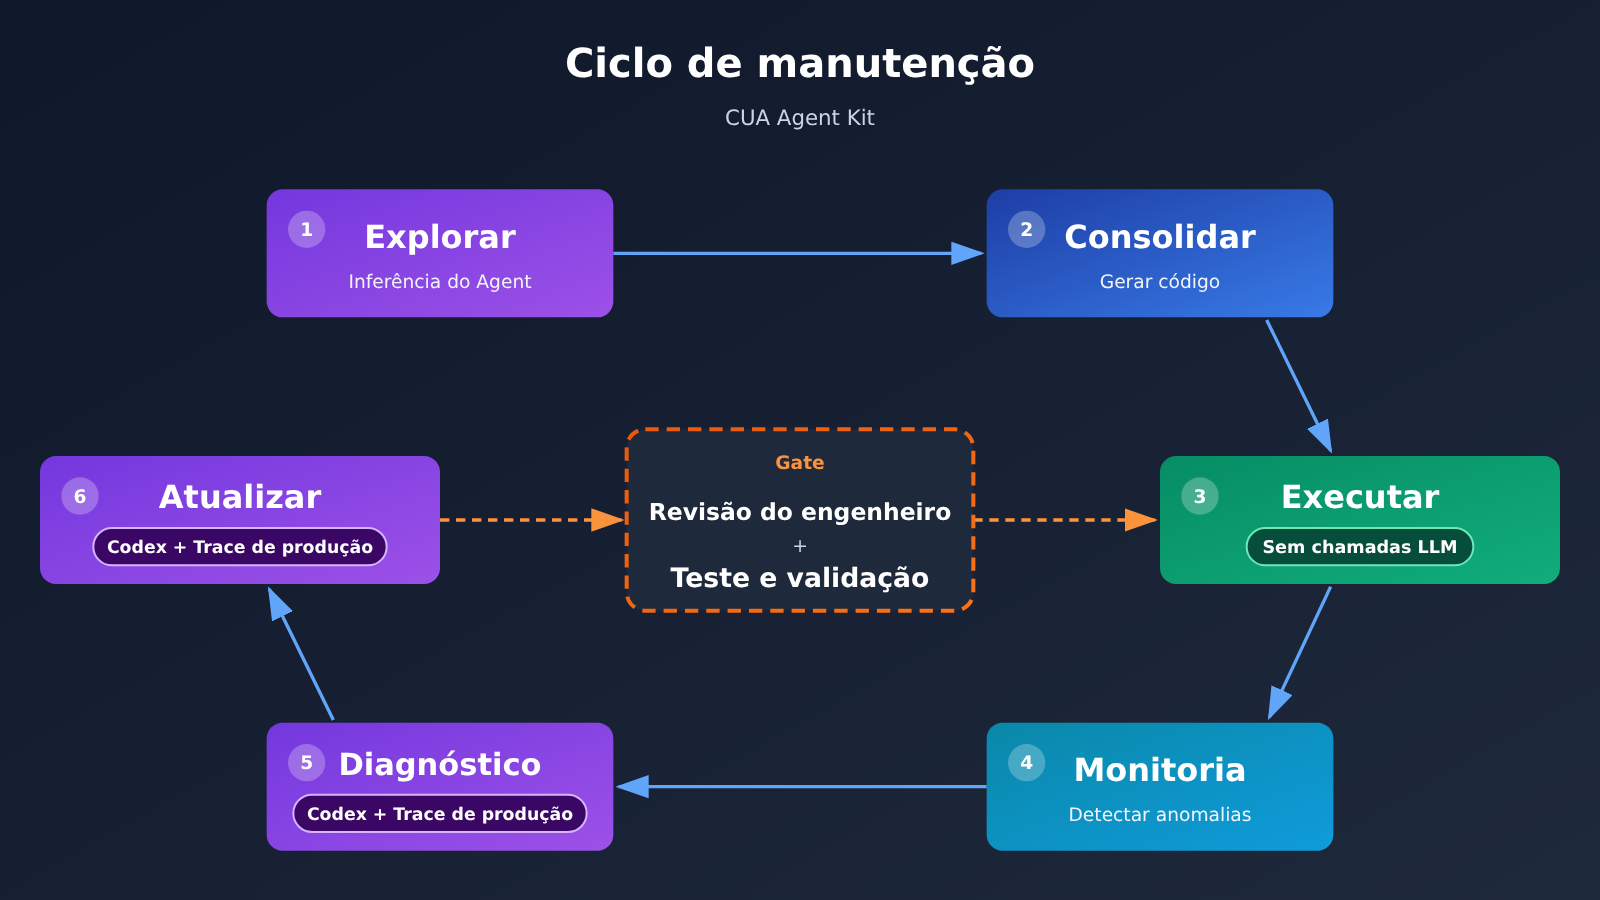
Nessa etapa, não é preciso chamar um Modelo de Linguagem Grande a cada execução, nem usar uma chave API. Mas o projeto não trata a consolidação como algo resolvido de uma vez por todas. O mecanismo de manutenção descrito no README é um ciclo fechado:
- O fluxo de trabalho fixo é executado conforme o planejado;
- Anomalias são detectadas no Trace de produção;
- O Codex usa o Trace para diagnosticar o problema;
- O código determinístico é atualizado;
- Um engenheiro revisa as alterações;
- Depois de passar por testes e validação, o fluxo volta a ser executado de forma repetida.
Em outras palavras, o papel do Agente muda: de “fazer o trabalho pessoalmente a cada vez” para “ficar fora do dia a dia e entrar em cena para corrigir o código quando surgirem problemas”. O código vai falhar e as interfaces vão mudar — o próprio projeto já assume isso — e é justamente por isso que existem as etapas de diagnóstico e revisão.
Qual é a diferença entre a automação híbrida com agente do CVS e o RPA tradicional?
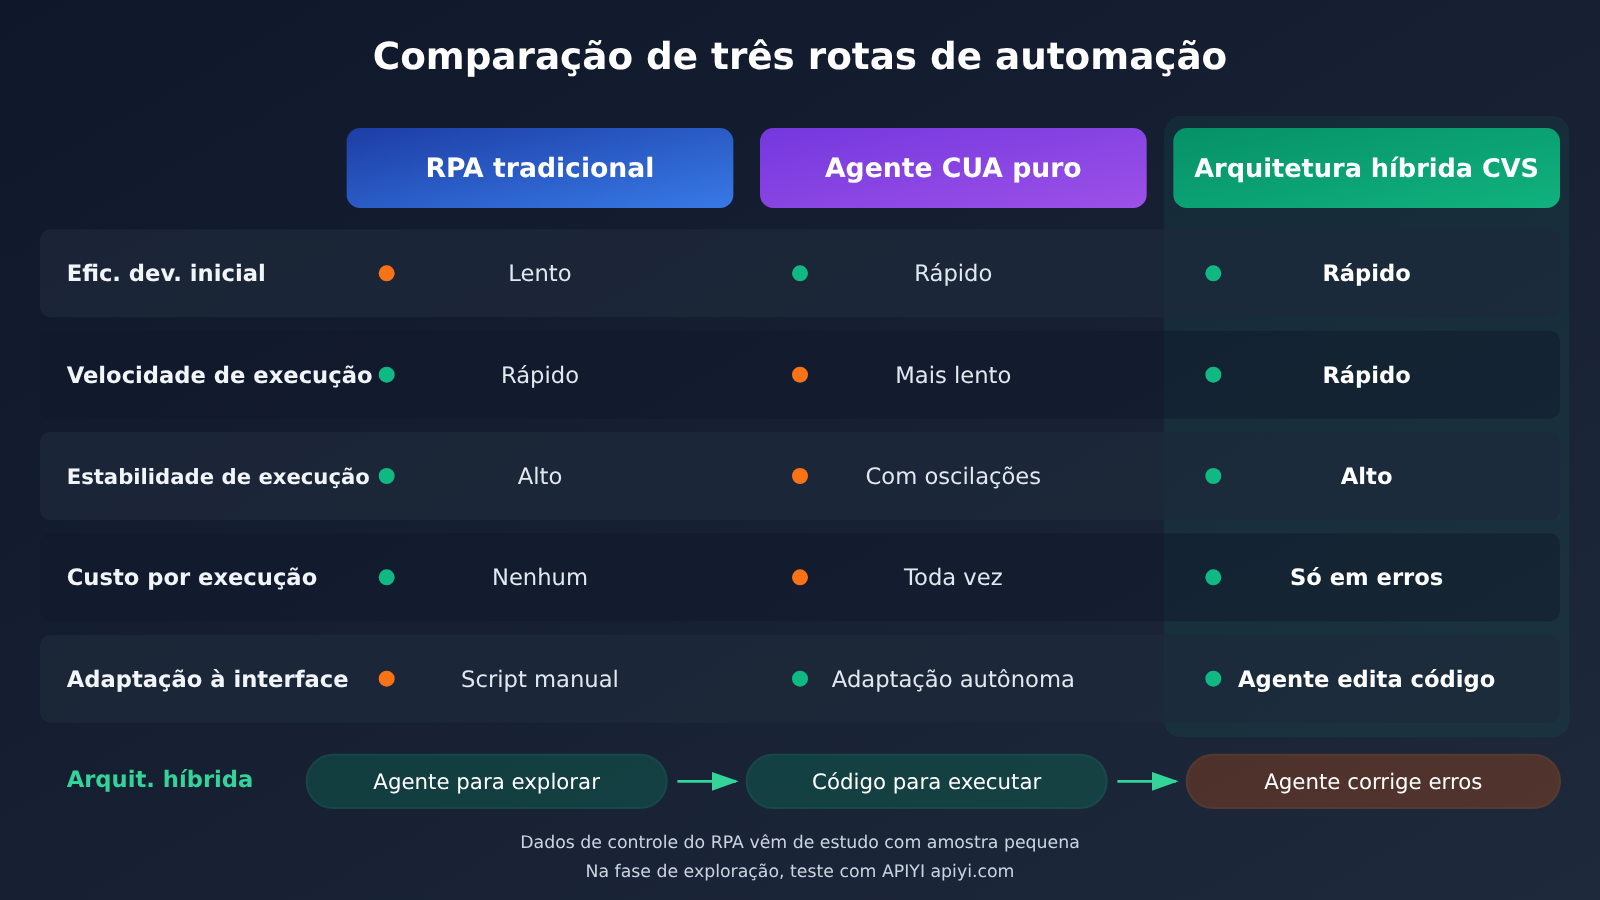
O RPA tradicional depende de etapas previamente configuradas e de localização de interface; é rápido na execução e tem resultados estáveis, mas o desenvolvimento e a manutenção quando a interface muda exigem trabalho humano. Um agente puro consegue entender linguagem natural e se adaptar a mudanças de interface, mas cada nova inferência traz custo e variação nos resultados. A posição do CUA Agent Kit fica entre os dois: o agente substitui a etapa de “gravar e escrever o fluxo manualmente”, enquanto a fase de execução volta para código determinístico.
Para uma comparação direta entre os dois, vale consultar um estudo publicado em 2026: Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks (DOI: 10.1080/23311975.2026.2724760). O estudo foi conduzido entre maio e junho de 2025 e comparou o UiPath Studio 2023.4.0 com o Anthropic Computer Use Agent, cobrindo três tipos de tarefas padronizadas: entrada de dados, monitoramento e extração de documentos.
| Tarefa | Taxa de sucesso do RPA | Taxa de sucesso do agente | Tempo inicial de desenvolvimento (observação de um único desenvolvedor) |
|---|---|---|---|
| P1 | Não incluído na estatística comparativa | O agente executou apenas 1 vez e falhou; não entrou nas estatísticas subsequentes | Não divulgado |
| P2 | 100% (10 execuções) | 90% (10 execuções) | Agente: cerca de 10 minutos; RPA: cerca de 38 minutos |
| P3 | 100% (10 execuções) | 60% (10 execuções) | Agente: cerca de 15 minutos; RPA: cerca de 240 minutos |
O estudo também constatou que o RPA foi significativamente mais rápido na execução em P2 e P3; os problemas do agente incluíram principalmente falhas em operações de interface, perda de contexto e erros de julgamento; o agente tem uma vantagem potencial na adaptação a interfaces dinâmicas.
É preciso deixar claros os limites deste estudo:
- A amostra é muito pequena: em P2 e P3 foram 10 execuções por tecnologia; P1 não corresponde a “10 execuções por tecnologia”, então não dá para generalizar de forma ampla.
- O tempo de desenvolvimento é apenas uma observação inicial: veio de um único desenvolvedor, não tem representatividade estatística e não pode ser tratado como média do setor.
- As versões das ferramentas são antigas: o estudo usou uma configuração de agente de 2025, que não representa o desempenho dos novos modelos de 2026.
Ainda assim, a direção das conclusões converge com o design do CVS: o agente é bom para explorar rápido e lidar com flexibilidade, enquanto a execução determinística no estilo RPA continua tendo vantagem em repetição estável.
Fonte: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
Como os desenvolvedores podem reutilizar a abordagem do CVS CUA Agent Kit?
O README lista poucos requisitos de ambiente:
- Python 3.12 ou superior;
- uv (ferramenta de gerenciamento de pacotes e projetos Python);
- um site ou aplicativo desktop acessível;
- na fase de descoberta,
OPENAI_API_KEY; - possibilidade de configurar um endpoint de API personalizado via
OPENAI_BASE_URL.
O uso corresponde a três fases: descoberta (o agente explora e registra evidências), consolidação (o Codex gera código) e execução (execução determinística). Para os comandos e parâmetros específicos das fases de descoberta e consolidação, consulte o README do repositório. A fase de execução corresponde ao uv run cua-agent-run mencionado acima.
Vale prestar atenção no design do OPENAI_BASE_URL. Isso significa que o ponto de entrada do modelo na fase de descoberta pode apontar para a API oficial, para um gateway interno da empresa ou para outro serviço compatível com a interface OpenAI, o que facilita a autenticação, a cobrança e a auditoria unificadas. As variáveis de ambiente da fase de descoberta podem ser configuradas assim:
# Fase de descoberta: requer API de modelo
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # usa a interface unificada da APIYI, ou troque pelo seu gateway

# Fase de execução: execução determinística, não precisa de chave API
uv run cua-agent-run
É preciso destacar um ponto: o Computer Use depende de recursos específicos da Responses API e de tipos de ferramentas. Antes de trocar para qualquer endpoint personalizado, confirme se esse endpoint oferece suporte aos modelos e às ferramentas necessários na fase de descoberta. Valide com um fluxo simples antes de expandir.
Depois da consolidação, a tarefa mais comum na manutenção diária é ler o Trace e os logs de eventos. A seguir há um exemplo de script auxiliar: entregar o events.jsonl de uma execução a um Modelo de Linguagem Grande generalista para que ele organize uma lista de etapas e possíveis pontos de falha, servindo de referência para a revisão dos engenheiros. Os campos exatos do events.jsonl dependem da saída real do projeto; aqui apenas lemos o arquivo linha a linha. Se houver informações sensíveis, como dados de pacientes, é imprescindível anonimizar antes ou processar apenas em um ambiente em conformidade.
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatível com OpenAI da APIYI
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """Lê o events.jsonl já anonimizado e gera uma lista de etapas e possíveis pontos de falha"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # limita o comprimento do contexto
    prompt = (
        "以下是一次界面自动化运行的事件日志。"
        "请按顺序列出操作步骤,并指出最可能导致失败的步骤及原因,"
        "只基于日志内容,不要臆测。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # substitua pelo modelo realmente disponível na sua plataforma
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
Este script serve apenas como apoio à leitura. Não substitui o diagnóstico de problemas feito pelo Codex com base no Trace completo, nem a revisão e os testes dos engenheiros.
🚀 Sugestão de início rápido: ao reutilizar essa abordagem, comece validando de ponta a ponta o fluxo “descoberta → consolidação → execução” com um processo de baixo risco em um site interno de testes. Na fase de descoberta, é preciso chamar o modelo repetidamente para comparar resultados. Você pode obter créditos de teste gratuitos via APIYI apiyi.com, usar a mesma chave API para alternar entre diferentes modelos em tarefas auxiliares, como análise de logs, e só então decidir qual modelo usar no ambiente de produção.
Análise e julgamento: os trade-offs da rota de automação do CVS Agent
O conteúdo a seguir é uma interpretação baseada nos fatos anteriores, e não uma conclusão do projeto ou da OpenAI.
Por que é um desperdício o Agent pensar do zero toda vez?
A automação de processos de negócio com múltiplas etapas tem uma característica: uma vez que o fluxo funciona, a grande maioria das execuções seguintes percorre o mesmo caminho. Se a cada vez deixarmos o Computer-use Agent tirar novas capturas de tela, entender a interface e planejar o próximo passo, o modelo está, na prática, pagando repetidamente por um problema cuja resposta já conhece. Essa inferência repetida traz três tipos de custo ao mesmo tempo.
O primeiro é o custo. O Computer Use envolve chamadas em múltiplas rodadas, e as capturas de tela após cada etapa de operação entram como entrada de imagem, acumulando Tokens continuamente. Tomando como exemplo os preços Standard de contexto curto divulgados pela OpenAI em 17 de novembro de 2026, o GPT-6 Astra tem entrada, saída e entrada em cache de 10, 50 e 1 dólar por milhão de Tokens, enquanto o GPT-6 Luna tem 0.10, 0.50 e 0.01 dólar. Na avaliação HealthAdminBench, o custo por tarefa do Luna é de 0.085 dólar, 98% menor que o do Astra; extrapolando nessa proporção, o Astra ficaria em torno de 4.25 dólares por tarefa, mas isso é apenas uma estimativa e refere-se a custos em condições de benchmark, não devendo ser tomado como preço de produção.
O segundo é a latência. É preciso esperar o retorno do modelo a cada etapa; quanto mais longo o fluxo, maior a espera. Na pesquisa anterior, a velocidade de execução do RPA em P2 e P3 foi significativamente maior que a do Agent, e a razão é justamente essa.
O terceiro é a variabilidade. Ao executar a mesma tarefa várias vezes, o Agent pode seguir caminhos diferentes; no estudo, a taxa de sucesso do Agent em P3 foi de apenas 60%. Para operações que exigem previsibilidade e auditabilidade, essa incerteza é mais difícil de aceitar do que o custo.
Por isso, as estruturas de custo das duas fases devem ser contabilizadas separadamente:
| Item de custo | Fase de exploração (Agent) | Fase de execução (código determinístico) |
|---|---|---|
| Tokens do modelo | Contabilizar separadamente a entrada visual e de texto e a saída faturada a cada rodada; Tokens de retentativa já incluídos no total não são somados novamente | Zero em operação normal |
| Ferramentas e ambiente de execução | Serviços efetivamente usados, como navegador, ambiente de desktop e contêineres | Máquina e ambiente de navegador que executam o código |
| Esforço de engenharia | Escrever a descrição da tarefa, verificar evidências, revisar o código gerado | Monitoramento, diagnóstico de anomalias, atualização e teste de código |
| Frequência | Quando um novo fluxo entra em produção ou passa por grande mudança | A cada execução de negócio |
| Prática recomendada | Selecionar modelos em camadas conforme a complexidade: modelos fortes para fluxos difíceis, modelos de baixo custo para fluxos estruturados | Evitar ao máximo chamar o modelo; recorrer ao Agent apenas em caso de anomalia para reparo |
A economia da arquitetura híbrida vem exatamente desta tabela: as chamadas caras de modelo concentram-se nas fases de baixa frequência — exploração e reparo —, enquanto a fase de execução de alta frequência volta para o código, com custo marginal de modelo próximo de zero. O balanço real ainda precisa incluir o esforço de manutenção: quanto mais frequentes as atualizações de interface, mais vezes se retorna à fase de exploração e menor é a economia.
💰 Dica de custo: para a seleção de modelos em camadas na fase de exploração, o melhor é testar com seus próprios fluxos reais, em vez de copiar os números do benchmark. Com o APIYI (apiyi.com), é possível alternar modelos sob o mesmo conjunto de interfaces compatíveis com OpenAI, com cobrança por uso, o que facilita comparar o consumo real de Tokens de diferentes modelos nas etapas de exploração e diagnóstico de logs.
Há ainda uma questão de critério de avaliação que costuma passar despercebida. Os resultados do HealthAdminBench divulgados pela OpenAI são Astra 94,3% e Luna 91,8%, ambos correspondentes à proporção de rubric points na intensidade máxima de raciocínio, e não à taxa de sucesso ponta a ponta. A versão 2604.09937v1 do paper da equipe de Stanford contém 135 tarefas e 1698 subtarefas (das quais 1177 com pontuação determinística e 521 avaliadas por um modelo juiz), e reporta a melhor taxa de sucesso em tarefas completas de 36,3% (Claude Opus 4.6 CUA) e a melhor taxa de sucesso em subtarefas de 82,8% (GPT-5.4 CUA); as 70 tarefas e 947 pontos de avaliação divulgados anteriormente em uma página web pertencem a outra versão pública e servem apenas como referência histórica. Esses números vêm de modelos, datas, condições de execução e métricas diferentes, portanto não podem ser alinhados em um mesmo ranking.
Para a abordagem de “explorar primeiro, depois consolidar”, a taxa de sucesso ponta a ponta é mais crítica do que a pontuação parcial. O Codex precisa de uma trajetória completa de sucesso: se a fase de exploração acerta 90% dos subpassos mas trava no último passo de submissão, o Trace que fica registrado ainda não pode ser consolidado diretamente. Na hora de escolher um modelo, você deve medir a taxa de sucesso em tarefas completas usando o seu próprio fluxo.
Quais tarefas se encaixam em uma arquitetura de Agent híbrido no estilo CVS?
Juntando os fatos anteriores, dá para montar uma tabela aproximada de divisão de tarefas:
| Características da tarefa | Forma de execução recomendada | Exemplo típico | Intervenção humana |
|---|---|---|---|
| Processo desconhecido, documentação escassa, interface complexa | O Agent explora e deixa evidências | Primeiro mapeamento do caminho de operação de um sistema legado | Revisar os resultados da exploração e o código gerado |
| Processo estável, repetição de alta frequência, validação de estado viável | Solidificar em código determinístico | Envio de arquivos entre sistemas, transferência de campos fixos | Amostragem de resultados, monitoramento de anomalias |
| Já existe cobertura de API | Priorizar a chamada de API | Escrita de dados estruturados | Gestão conforme as permissões normais |
| Interface com mudanças frequentes | Reforçar o monitoramento após a solidificação e reservar orçamento para voltar à exploração | Portais de terceiros | Toda atualização de código precisa de revisão |
| Alteração de estados de negócio de alto risco | O código ou o Agent vai apenas até o rascunho / aguardando aprovação | Enviar solicitação, enviar mensagem, modificar registro | Aprovação humana obrigatória |
No cenário médico, a abordagem de outros parceiros também serve de referência. A solução apresentada pela Ambience faz o Agent parar e perguntar ao médico quando há ambiguidade no prontuário, aguardando aprovação antes do envio; já o caso da Assort usa a API para as partes que ela consegue cobrir, e o Computer Use apenas para completar as etapas de interface que a API não cobre. A combinação “API + Computer Use + código determinístico + aprovação humana” é mais realista do que apostar em uma única tecnologia.
É preciso deixar claro que código determinístico apenas torna a execução previsível, não garante que o resultado esteja correto. Se o que foi solidificado na fase de exploração for um caminho defeituoso, o código vai repetir esse defeito de forma consistente; em operações entre sistemas, um erro ainda pode ser replicado para vários sistemas downstream. Por isso, verificação de estado antes da operação, validação do resultado depois da operação, permissão mínima e rastreabilidade completa não podem ser dispensadas nem depois da solidificação. Este artigo discute arquitetura de engenharia e não traz nenhuma recomendação de diagnóstico ou tratamento para pacientes.
Para equipes que querem colocar a mão na massa, um caminho mais seguro é: primeiro, em um ambiente que não seja de produção, escolher um processo de baixo risco e alta repetição, percorrer por completo a exploração, a solidificação, a execução e uma mudança de interface provocada de propósito, registrando o custo de invocação do modelo, as horas de manutenção do código e o tempo de recuperação de falhas. Esses três números explicam melhor se essa arquitetura compensa no seu cenário do que qualquer pontuação de benchmark. Para os testes comparativos entre vários modelos na fase de exploração, você pode começar com a cota gratuita do APIYI apiyi.com e depois, com base nos resultados reais, decidir o modelo e a forma de acesso para a implantação definitiva.
O esquema da CVS merece atenção não porque afirma que o Agent é inteligente, mas porque reconhece as limitações do Agent e usa a inteligência onde ela é mais necessária: explorar uma vez, solidificar em código e consertar quando quebrar. Se essa abordagem vai se sustentar em mais empresas depende, no fim, dos dados reais medidos em cada processo em ambientes reais.
The proof of the pudding is in the eating.(Se o pudim é bom, só se sabe provando: o efeito real precisa ser verificado na prática.)
Autor: Equipe Técnica da APIYI
Contato técnico: Fique à vontade para nos contatar pela página inicial do site APIYI apiyi.com; mais materiais de integração estão disponíveis no centro de documentação docs.apiyi.com


