
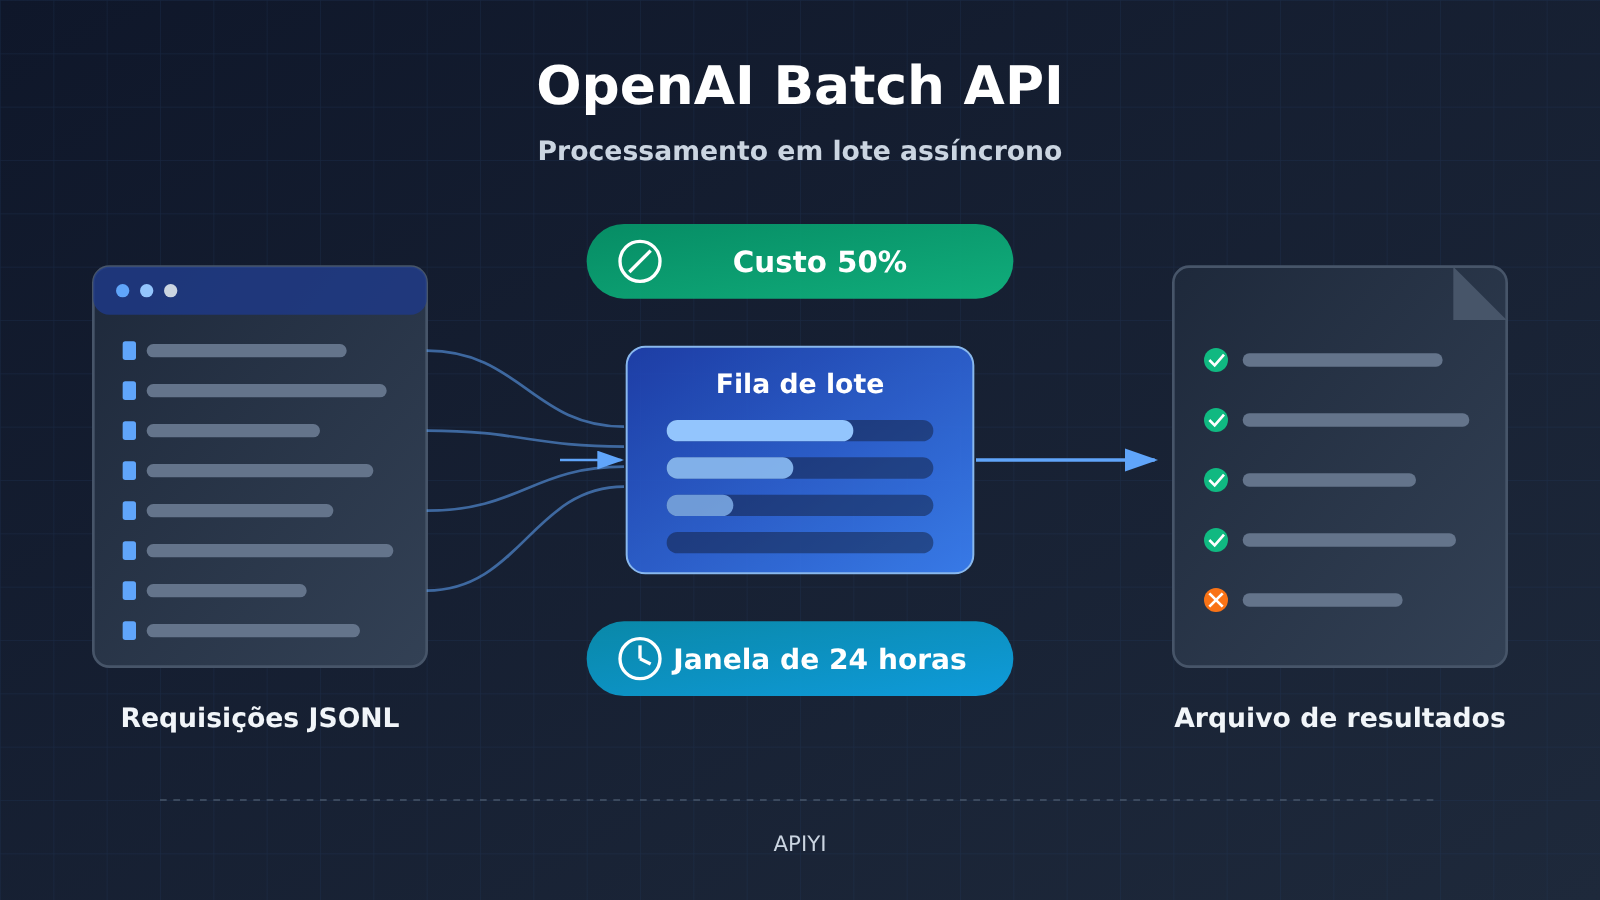
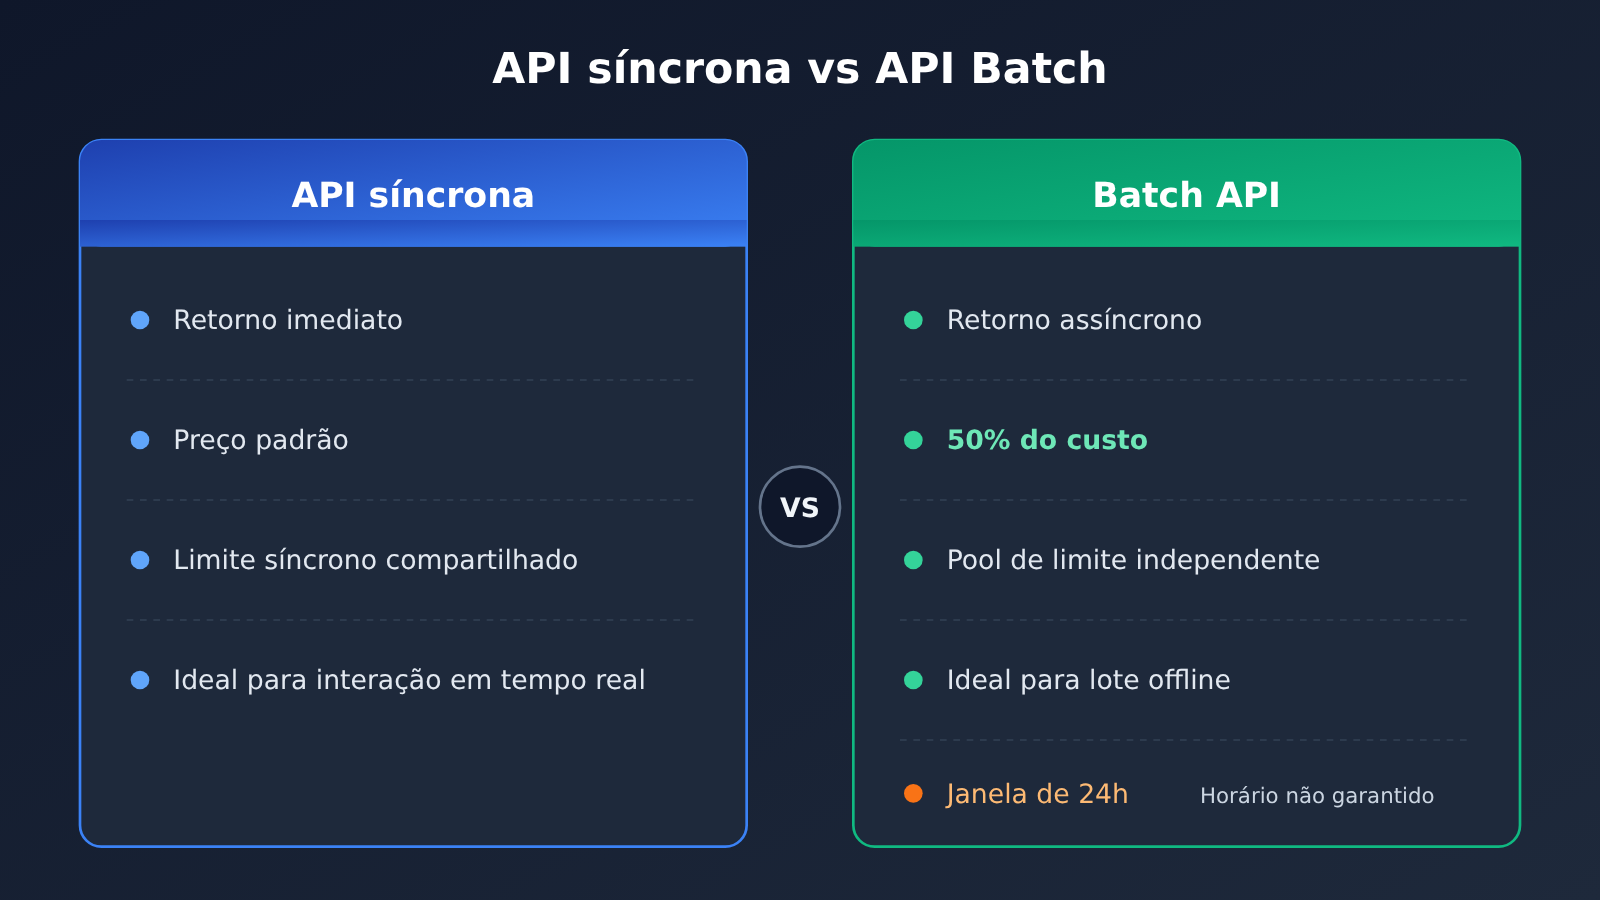
Resposta direta: a OpenAI Batch API é adequada para tarefas com resultados que podem chegar mais tarde, que são independentes entre si e que envolvem lotes grandes. O preço é metade do da API síncrona e ela usa um pool de limites de taxa separado. A restrição é uma janela de processamento de 24 horas, e essa janela não garante a entrega do resultado em um momento específico. Trabalhos offline como classificação baseada em regras predefinidas, processamento de base de conhecimento e avaliação de modelos podem priorizar o Batch. Atendimento ao cliente em tempo real, interações que exigem resposta imediata e fluxos dependentes em que o resultado da etapa anterior determina o conteúdo da próxima não devem ser entregues ao Batch API.
O que você poderá entender ao terminar de ler este artigo?
- As regras centrais da OpenAI Batch API: desconto, limites de taxa, janela, formato de arquivo e limites de quantidade.
- A diferença entre envio bem-sucedido, geração bem-sucedida e entrega no prazo.
- Como a cobrança funciona depois que um lote expira e como executar novamente apenas as solicitações com falha.
- Que parte do custo o desconto de 50% realmente reduz e quais custos não caem pela metade.
- Um método prático para determinar se uma tarefa é adequada para o Batch.
Índice: Antes do texto principal, uma tabela conceitual e um resumo de impacto ajudam a estabelecer o conhecimento básico. A seção “Fatos objetivos” organiza, item por item, as regras da documentação oficial; a seção “Análise e julgamento” discute o que essas regras significam para a seleção de tarefas, a estimativa de custos e o design de engenharia, além de apresentar os tipos de tarefa adequados e inadequados.
Vale esclarecer que este artigo se baseia no guia do Batch da OpenAI, mantido continuamente pela própria OpenAI, e foi verificado em 2026-11-17. Esse documento não tem uma data de publicação inicial explícita, então este artigo não o trata como um novo recurso lançado naquele dia, mas como uma interpretação das regras de uma capacidade existente.
Para saber: entendendo os conceitos-chave da OpenAI Batch API
| Conceito | Explicação resumida |
|---|---|
| API síncrona | O jeito convencional de chamar: você envia a requisição, espera e recebe o resultado na hora |
| Batch API | Interface em que você envia muitas requisições de uma vez, elas são processadas de forma assíncrona e você busca os resultados depois |
| JSONL | Formato de texto em que cada linha é um objeto JSON independente; no Batch, cada linha corresponde a uma requisição |
| custom_id | Identificador único que você define para cada requisição, usado para casar o resultado com a requisição original |
| Pool de limite de taxa independente | Os limites de taxa das requisições Batch são contados separadamente das requisições síncronas, sem disputar espaço entre si |
| Janela de processamento de 24 horas | Prazo de processamento do lote; requisições não concluídas dentro desse prazo são canceladas |
| Lote expirado | Lote que passou da janela de processamento e ainda não foi totalmente concluído |
Um panorama rápido dos impactos da OpenAI Batch API
- Desenvolvedores: dá para estimar o custo de API de tarefas em lote offline pela metade do preço da chamada síncrona, e sem consumir a cota de limite de taxa do serviço online. Em compensação, você precisa implementar por conta própria o pareamento via custom_id, o reenvio de falhas e a validação dos resultados.
- Equipes de conteúdo e dados: classificação, resumo e limpeza de bases de conhecimento em grande volume saem bem mais em conta. O preço é abrir mão do “resultado na hora” e deixar uma folga no prazo de entrega.
- Avaliação e pesquisa: rodar conjuntos de teste em larga escala é um caso perfeito para o Batch. Só lembre que cada arquivo aceita apenas um modelo; para comparar vários modelos, é preciso dividir em vários arquivos.
- Produtos e operações: não interprete “24 horas” como “entrego amanhã de manhã com certeza”. Ao prometer prazos externamente, trate o Batch como um canal de melhor esforço.
Fatos objetivos sobre a OpenAI Batch API
Regras de cobrança e de limite de taxa da Batch API
Segundo o guia oficial da Batch (documentação oficial da OpenAI: developers.openai.com/api/docs/guides/batch), a Batch API tem três características centrais:
- Desconto de custo: oferece 50% de desconto em comparação com a API síncrona.
- Limite de taxa independente: usa um pool de limites próprio, que não compartilha cota com as requisições síncronas.
- Janela de processamento: os lotes são concluídos dentro de uma janela de 24 horas.
Quais modelos e endpoints são suportados segue a lista do documento oficial. Hoje não dá para afirmar, de forma genérica, que “todos os modelos suportam Batch”.
Formato de arquivo e limite de quantidade da Batch API
| Item da regra | Exigência oficial | O que isso significa na prática |
|---|---|---|
| Formato do arquivo | JSONL, uma requisição por linha | Cada linha é uma tarefa independente |
| Identificador da requisição | Cada requisição tem um custom_id único |
É por ele que os resultados são recuperados e combinados |
| Restrição de modelo | Um único arquivo pode conter apenas um modelo | Tarefas com vários modelos precisam ser divididas em vários arquivos |
| Limite de quantidade | No máximo 50.000 requisições por lote | Acima do limite é preciso enviar em lotes separados |
| Limite de tamanho | Arquivo do lote com no máximo 200MB | Tarefas de contexto longo podem esbarrar primeiro no limite de tamanho |
| Ordem da saída | Não há garantia de que a saída siga a ordem da entrada | Não dá para casar os resultados pelo número da linha |
Abaixo está um exemplo da estrutura de uma linha de requisição, só para mostrar onde fica o custom_id. Os endpoints e parâmetros específicos devem seguir a lista de suporte da documentação oficial:
{"custom_id": "article-001", "method": "POST", "url": "/v1/chat/completions", "body": {"model": "MODEL_NAME", "messages": [{"role": "user", "content": "为以下主题写一段摘要:..."}]}}
Regras de expiração e de cobrança da Batch API
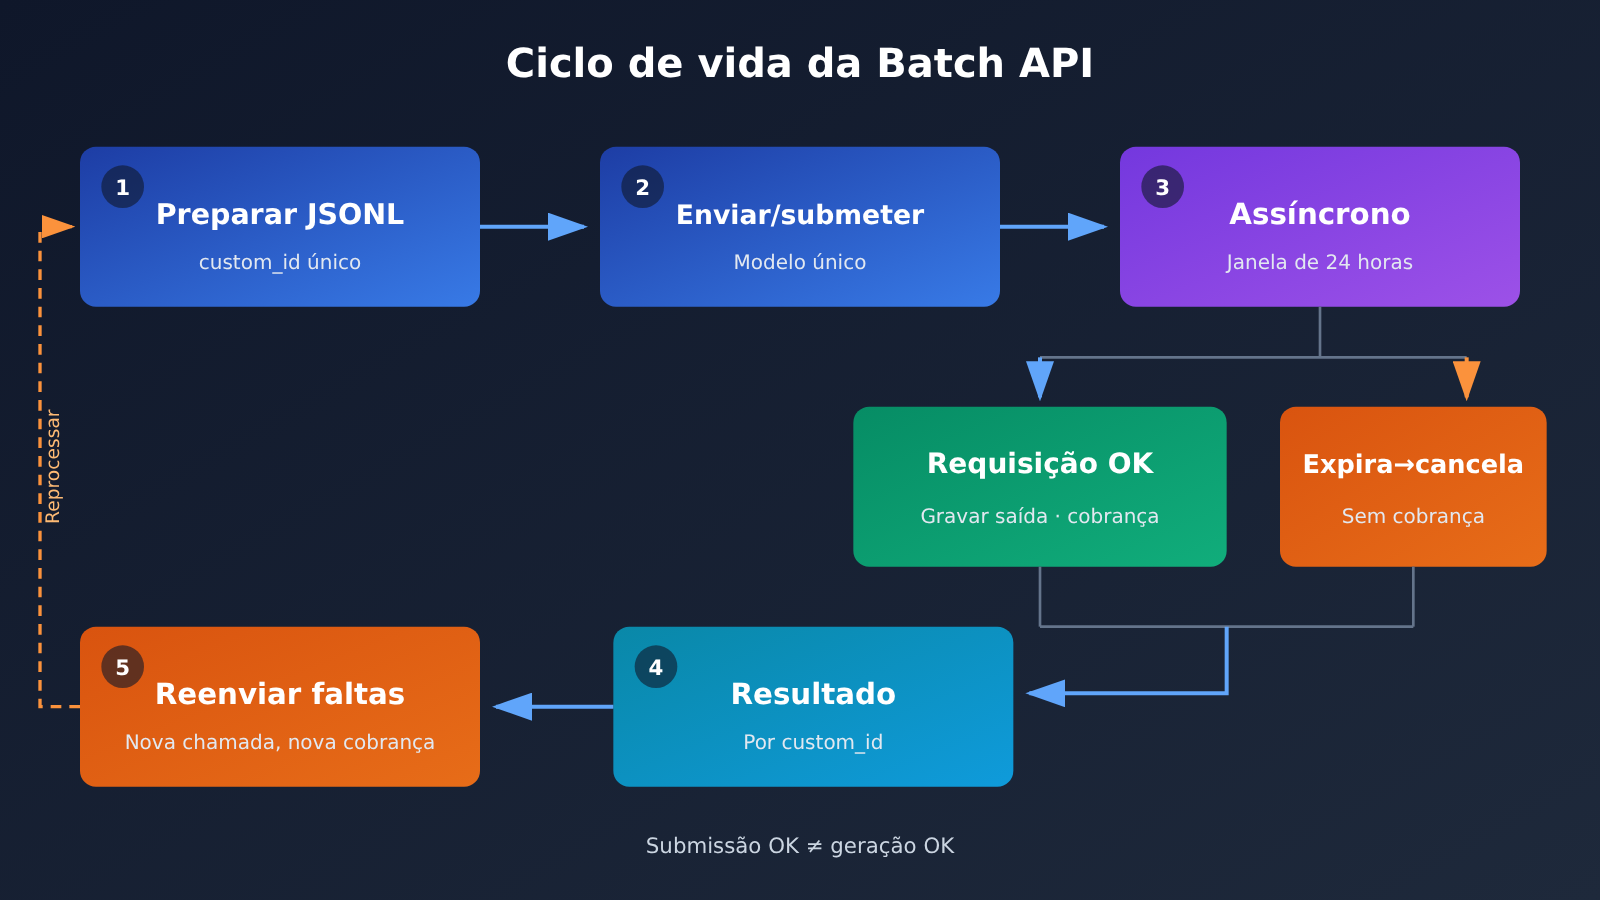
Se o lote ultrapassar a janela de processamento, as requisições ainda não concluídas nele são canceladas. Os resultados já obtidos com sucesso continuam disponíveis para download, e a cobrança recai apenas sobre as requisições bem-sucedidas.
A documentação também faz um lembrete: enviar com sucesso não é o mesmo que gerar com sucesso. O lote ser aceito significa apenas que ele entrou no fluxo de processamento, não que cada linha vai produzir um resultado. A janela de 24 horas também não é a promessa de “entrega amanhã cedo em algum horário”.
Análise e considerações sobre a OpenAI Batch API
Em qual parte o desconto de 50% realmente economiza
O “desconto de 50%” se aplica ao custo de invocação do modelo no processamento em lote (Batch). A seguir, uso um exemplo ilustrativo; os números não são dados reais de medição.
Suponha que uma tarefa custe 100 yuans em requisições síncronas. Se o mesmo pedido for enviado via Batch, o custo indicativo seria 50 yuans. O custo total do projeto, porém, não necessariamente cai pela metade, porque alguns tipos de custo não recebem desconto automático:
| Item de custo | Recebe desconto de 50% com Batch? | Descrição |
|---|---|---|
| Custo de invocação do modelo nas requisições em lote | Sim | Indicativo: 100 yuans no síncrono correspondem a 50 yuans no Batch |
| Chamadas de ferramentas para pesquisa prévia | Não | Por exemplo, pesquisar e investigar antes de definir o que escrever |
| Revisão humana | Não | O custo de mão de obra independe do modelo de cobrança |
| Novas tentativas extras | Não; precisam ser calculadas à parte | Execuções de recuperação após falha ou expiração geram novas chamadas |
| Desenvolvimento e manutenção de engenharia | Não | Geração de arquivos, correspondência de resultados e lógica de reenvio exigem investimento |
Portanto, ao montar o orçamento, aplique o desconto de 50% apenas à “parte das chamadas que pode ser processada em lote”, sem simplesmente cortar pela metade o orçamento total do projeto. Se um projeto tiver uma proporção alta de pesquisa e revisão, a economia geral trazida pelo Batch será bem menor que 50%.
Como entender a janela de 24 horas
A janela de 24 horas descreve um prazo de processamento, não uma promessa de entrega. A abordagem mais segura é tratar os resultados do Batch como uma saída “provavelmente disponível dentro da janela, mas que pode ter partes faltando” e reservar tempo no cronograma para reexecuções.
Se a área de negócio exigir “todos os resultados obrigatoriamente antes das 9h de amanhã”, depender de um único envio em Batch é arriscado. Para tarefas com exigência rígida de prazo, dá para enviar antes, reservar uma janela para reexecuções ou migrar a parte crítica para requisições síncronas.
O custom_id é o núcleo do design de engenharia do Batch
Como a saída não tem ordem garantida, a coleta dos resultados precisa depender totalmente do custom_id. Isso exige que o custom_id já tenha significado de negócio na fase de design e seja globalmente único, por exemplo, “tipo de tarefa-número do lote-sequência”.
O exemplo de design abaixo também não é um teste real: para gerar 20 artigos independentes com o mesmo modelo, dá para escrever 20 linhas de JSONL. Se, no fim, 18 artigos forem concluídos e 2 forem cancelados por expiração, basta usar o custom_id para localizar os 2 ausentes e reenviá-los, sem precisar reexecutar os 20. Os 18 concluídos são cobrados como requisições bem-sucedidas; os 2 cancelados não são cobrados.
Os pontos-chave desse fluxo podem ser resumidos assim:
- Antes do envio, valide se o custom_id de cada linha é único.
- Depois de coletar os resultados, subtraia o conjunto de custom_id de saída do conjunto de custom_id de entrada para obter a lista de ausentes.
- Gere um novo JSONL apenas para a lista de ausentes e envie novamente.
- As reexecuções geram novos custos de invocação e precisam entrar no orçamento.
Múltiplos modelos e fluxos com dependências precisam ser tratados separadamente
Um único arquivo só pode usar um modelo. Se o mesmo projeto quiser que o modelo A faça classificação e o modelo B faça resumo, será preciso preparar dois arquivos separados, cada um submetido e recuperado individualmente.
Vale destacar ainda mais as relações de dependência. Se o fluxo for “primeiro pesquisar materiais, depois decidir o que escrever com base nas conclusões da pesquisa”, o segundo passo depende da saída do primeiro, e o Batch não vai orquestrar automaticamente esses dois passos por você. Você precisa, após recuperar os resultados do primeiro lote, gerar as requisições do segundo lote no seu próprio programa e então submetê-las. Isso também significa que o tempo total da cadeia inteira pode acumular múltiplas janelas de processamento.
Quais tarefas são adequadas para a OpenAI Batch API
| Tipo de tarefa | Adequado para Batch? | Motivo |
|---|---|---|
| Classificação em lote seguindo regras predefinidas | Adequado | Regras fixas, itens independentes, sem necessidade de retorno em tempo real |
| Processamento de base de conhecimento (resumo, limpeza, estruturação) | Adequado | Grande volume de dados, pode ser feito offline |
| Avaliação de modelos, inferência em lote de conjuntos de teste | Adequado | Naturalmente em lote, insensível a prazos |
| Geração em lote de conteúdo independente com o mesmo modelo | Adequado | Cada linha é independente, falhas podem ser reexecutadas por custom_id |
| Atendimento em tempo real, interação conversacional | Não adequado | O usuário precisa de resposta imediata, deve usar chamadas síncronas ou outros métodos |
| Tarefas com prazo de entrega rígido | Cuidado | A janela de 24 horas não garante um horário específico |
| Fluxos de múltiplos passos: primeiro pesquisar, depois decidir o conteúdo | Requer orquestração própria | O Batch não trata automaticamente dependências entre passos |
Uma forma simples de decidir é fazer três perguntas em sequência: o resultado pode ser obtido mais tarde? Cada requisição é independente das outras? O volume é grande o suficiente para valer a pena escrever arquivos e lógica de recuperação? Se as três respostas forem “sim”, o Batch geralmente é a escolha mais vantajosa. Se alguma resposta for “não”, primeiro divida a tarefa ou mantenha chamadas síncronas.
Mudanças que vale a pena acompanhar no futuro
Como este é um documento oficial mantido de forma contínua, os modelos e endpoints suportados, além dos limites de quantidade e volume, podem sofrer ajustes. As considerações a seguir são previsões: conforme mais modelos e endpoints forem incluídos no Batch, fluxos de trabalho de avaliação offline e de processamento de dados passarão a adotar o processamento em lote como padrão com mais frequência. Na integração real, ainda vale seguir as regras listadas na documentação daquele momento — não simplesmente reaproveitar os números da data de verificação deste artigo.
O valor da Batch API está em nos fazer pensar com clareza sobre o que pode esperar. As tarefas que podem esperar ganham metade do preço e uma cota de limite de taxa sem interrupções; já as tarefas que precisam de resposta imediata continuam sendo enviadas como requisições síncronas.
“Não queira ser rápido, não veja pequenos lucros. Querer ser rápido leva a não chegar; ver pequenos lucros leva a não realizar grandes coisas.” — Analectos de Confúcio · Zi Lu


