
Nota do autor: dois exemplos calculados à mão para deixar claro como funciona o preço de contexto curto e de contexto longo do GPT-6.2 Astra, além dos multiplicadores Batch, Fast e Ultrafast.
A OpenAI lançou, em 17 de novembro de 2026, o GPT-6.2 Astra e o GPT-6.2 Sol, com os IDs de modelo gpt-6.2-astra e gpt-6.2-sol, respectivamente. O preço padrão de contexto curto apresentado na página oficial do modelo parece bem direto, mas, na hora de estimar a fatura de verdade, o preço padrão de contexto curto não pode ser aplicado diretamente ao contexto longo, ao Fast nem ao Ultrafast. Assim que a entrada de uma única requisição ultrapassa 272K tokens, o preço unitário muda para a requisição inteira; e, se você escolher Fast ou Ultrafast, ainda precisa multiplicar por um fator extra na faixa de contexto correspondente.
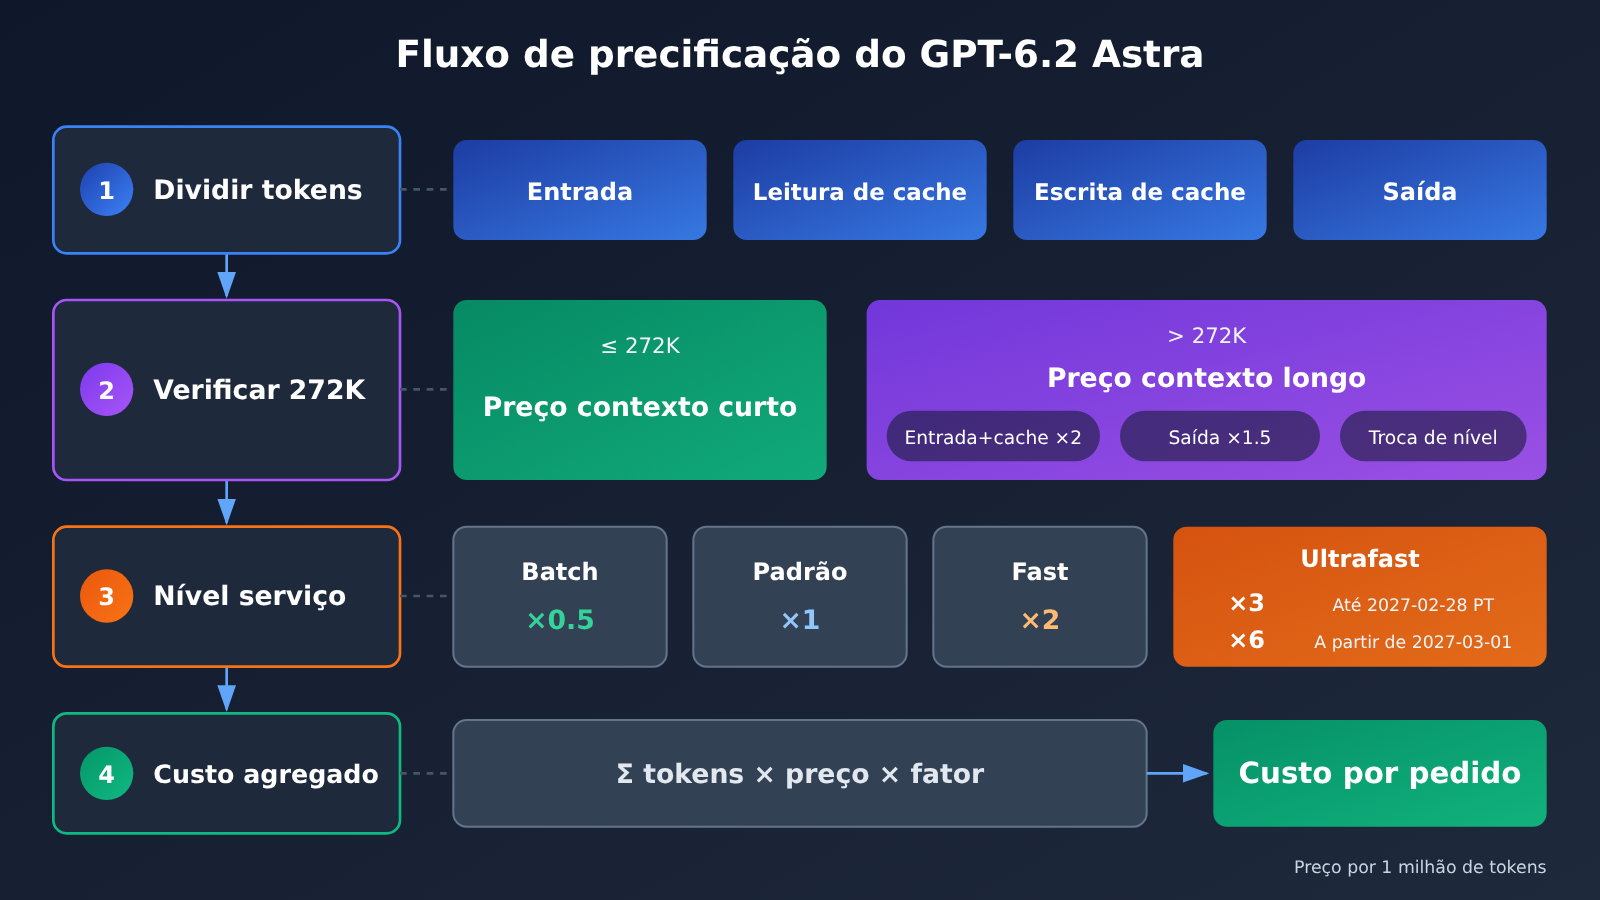
Este artigo não é uma mera repetição da tabela de preços, e sim um conjunto de regras que dá para calcular à mão, com papel e caneta: primeiro, divida os tokens em quatro categorias (entrada, leitura de cache, escrita de cache e saída); depois, determine se a requisição se enquadra em contexto curto ou longo; por fim, aplique o multiplicador do nível de serviço.
Valor central: ao final da leitura, você conseguirá estimar por conta própria o custo de uma única requisição e de tarefas em lote no GPT-6.2 Astra, além de saber distinguir quais números são preços oficiais e quais seguem o critério de avaliações de terceiros — sem misturar os dois.
Pontos essenciais da precificação do GPT-6.2 Astra
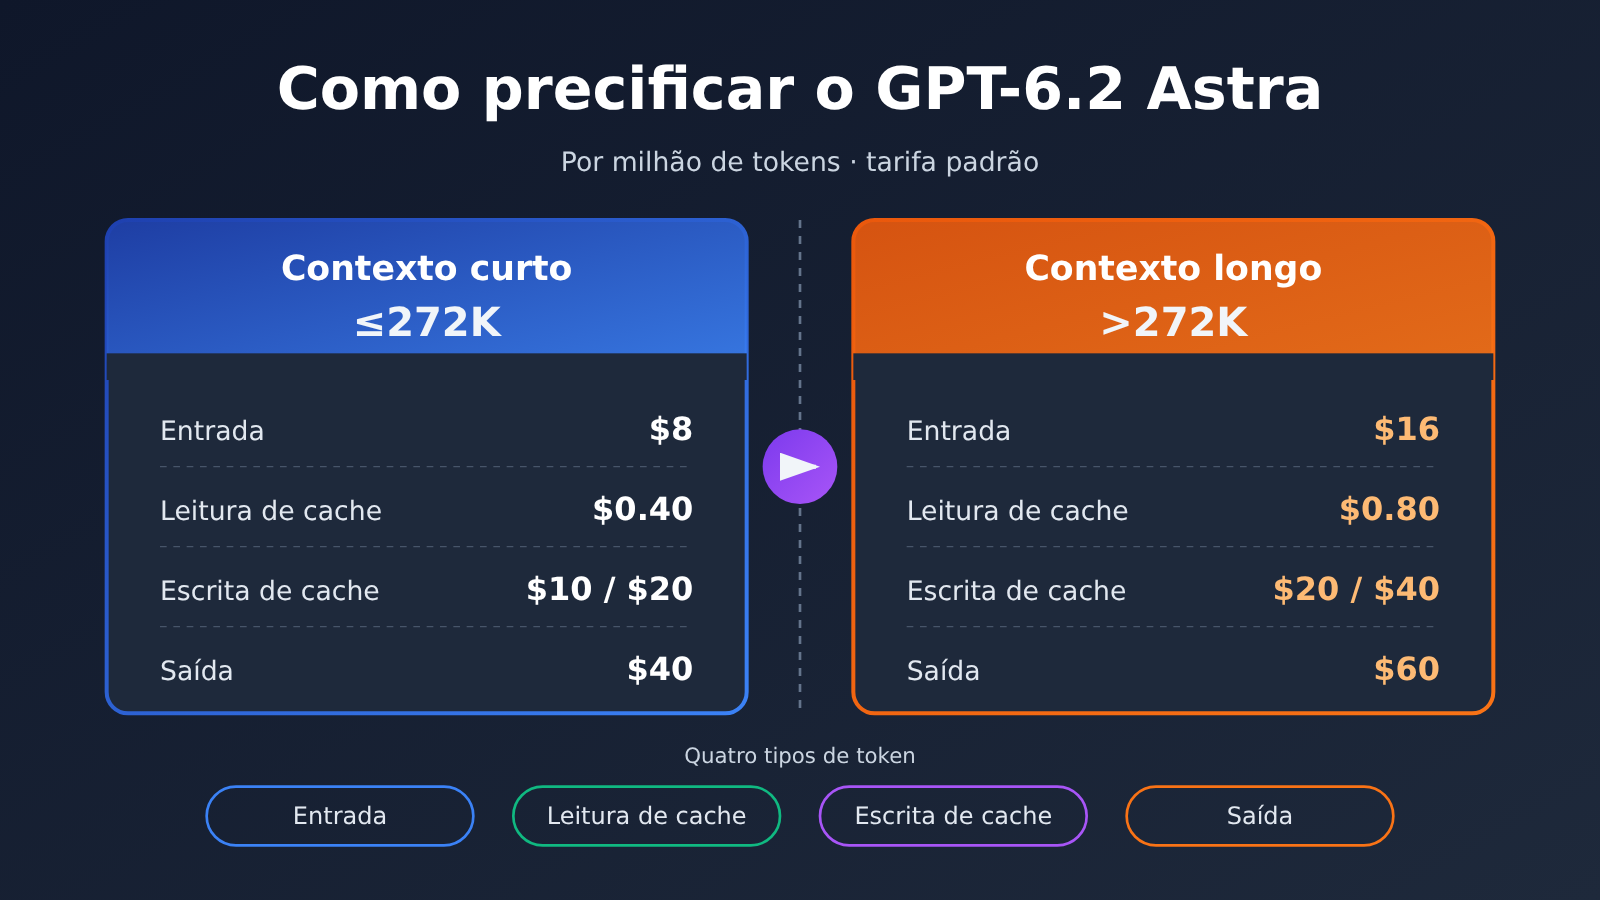
Antes de mais nada, vamos deixar as regras claras. A tabela abaixo foi compilada a partir da página oficial de modelos da OpenAI (com os preços anunciados pela própria OpenAI). Todos os valores são por 1 milhão de tokens, na faixa padrão.
| Item de cobrança | Contexto curto (entrada ≤272K) | Contexto longo (entrada >272K, pedido inteiro) | Observação |
|---|---|---|---|
| Entrada | $8 | $16 | Entrada com contexto longo dobra |
| Leitura de cache | $0.40 | $0.80 | O preço do cache também dobra |
| Escrita no cache (retenção de 30 minutos) | $10 | $20 | Categoria de cache, dobra |
| Escrita no cache (retenção de 12 horas) | $20 | $40 | Categoria de cache, dobra |
| Saída | $40 | $60 | Saída a 1,5x o valor do contexto curto |
A coluna de contexto longo foi deduzida diretamente do texto da página do modelo: quando a entrada da solicitação ultrapassa 272K tokens, os preços de entrada e de cache dobram, a saída passa a custar 1,5x o valor do contexto curto, e tudo é calculado sobre o pedido inteiro. Ou seja, não é apenas “a parte que excede os 272K” que dobra — todos os tokens dessa solicitação passam a ser cobrados pelos preços da coluna da direita.
gpt-6.2-astra e gpt-6.2-sol ainda não aparecem na tabela geral de modelos da APIYI (dados de 2026-11-17 15:54, UTC+8) nem na API pública de preços: por enquanto ainda não foram lançados na plataforma, e vamos disponibilizá-los o quanto antes; os nomes de modelos e os preços válidos são os da lista de modelos da plataforma. Antes de fazer a integração oficial, vale conferir o status de disponibilidade e os preços reais na lista de modelos do apiyi.com, e só então aplicar o esquema de cálculo deste artigo.
Por que os quatro tipos de token do GPT-6.2 Astra são cobrados separadamente
A fatura de uma requisição costuma ser composta por quatro partes. A entrada normal é a parte do comando que, nesta requisição, não atingiu o cache nem foi gravada nele; a leitura de cache é a parte que atingiu um cache já existente, com preço unitário de apenas um vigésimo do valor da entrada; a escrita de cache é a parte em que o comando foi gravado no cache nesta requisição, dividida em duas faixas conforme o tempo de retenção: 30 minutos e 12 horas; e a saída é o conteúdo gerado pelo modelo. O GPT-6.2 Astra também suporta tokens de raciocínio, e os tokens gerados durante o processo de raciocínio geralmente entram na conta da saída — o detalhamento exato deve seguir o campo usage da fatura.
Os preços dos quatro tipos variam muito: leitura de cache $0.40, entrada $8, escrita de cache $10 ou $20 e saída $40. Se você calcular todos os tokens pelo preço de entrada, vai subestimar tarefas intensivas em saída; se ignorar a escrita de cache, o custo da primeira invocação sairá menor do que o real. Por isso, na hora de estimar, é preciso separar primeiro e depois multiplicar cada tipo pelo seu preço.
Como avaliar o limite de 272K do GPT-6.2 Astra
O critério é o total de tokens de entrada da requisição, e a parte que atinge o cache também conta como entrada. O ideal é tomar como referência a documentação oficial e o usage real. A janela de contexto do modelo é de 1.050.000, com entrada máxima de 922.000 e saída máxima de 128.000, então requisições de contexto longo podem ser enviadas sem problema — só que você paga por outra tabela de preços.
Um método prático para avaliar: some o comando do sistema, o histórico da conversa, os documentos recuperados e os resultados devolvidos pelas ferramentas. Se o total se aproximar de 272K, é preciso decidir com antecedência se você vai compactar o contexto, dividir em várias requisições ou aceitar que o pedido inteiro mude de faixa de preço.
Como aplicar os multiplicadores dos níveis de serviço do GPT-6.2 Astra
A faixa da janela de contexto determina o preço unitário base, e o nível de serviço determina por quantas vezes multiplicar esse preço base. A tabela abaixo também vem da página oficial de modelos.
| Nível de serviço | Multiplicador | Escopo de aplicação | Observações |
|---|---|---|---|
| Batch | 50% do preço padrão | Processamento em lote assíncrono | Ideal para tarefas em grande volume sem pressa |
| Padrão | 1x | Padrão | Base dos dois exemplos deste artigo |
| Fast | 2x | Preço padrão para o mesmo comprimento de contexto | Solicitações de contexto longo devem usar o preço unitário de contexto longo multiplicado por 2 |
| Ultrafast | 3x | Até 2027-02-28 (horário do Pacífico) | Tem data limite |
| Ultrafast | 6x | A partir de 2027-03-01 | O orçamento precisa ser recalculado com o novo multiplicador |
O escopo do Fast está bem claro na página do modelo: são 2 vezes o “preço padrão para o mesmo comprimento de contexto”. Então, se você ativar o Fast em uma solicitação de contexto longo, a entrada fica em $16 × 2 = $32 e a saída em $60 × 2 = $120. O multiplicador do Ultrafast segue a mesma lógica, mas fique de olho no prazo: se o orçamento do seu projeto se estende para depois de março de 2027, a parte do Ultrafast precisa ser reestimada com o multiplicador de 6x — não dá para manter o número de 3x.
Há ainda uma limitação relacionada indiretamente aos custos: a API não permite definir o reasoning effort como none. Isso significa que os tokens de raciocínio sempre estarão presentes, então, ao estimar o volume de saída, deixe uma margem para o raciocínio — não basta calcular apenas pelo comprimento da resposta final.
GPT-6.2 Astra: primeiros passos com dois exemplos de cálculo manual
Os dois exemplos abaixo usam apenas multiplicação e adição, e os preços unitários são todos por “cada 1 milhão de tokens”, então o cálculo de cada linha é sempre “quantidade de tokens × preço unitário ÷ 1,000,000”.
Exemplo 1: requisição de contexto curto no GPT-6.2 Astra
O cenário é um assistente de perguntas e respostas com um comando de sistema longo. Cada requisição tem 100,000 tokens de entrada no total, dos quais 60,000 são o comando de sistema fixo e trechos de conhecimento, perfeitos para colocar no cache; outros 40,000 são o conteúdo do usuário, que muda a cada requisição; e a saída (incluindo o raciocínio) fica em torno de 5,000 tokens. Como a entrada total de 100K fica abaixo de 272K, vale o preço de contexto curto.
| Item faturado | Primeira requisição (gravação no cache de 30 minutos) | Requisições seguintes (com acerto de cache) |
|---|---|---|
| Entrada normal 40,000 × $8 | $0.32 | $0.32 |
| Gravação no cache 60,000 × $10 | $0.60 | — |
| Leitura do cache 60,000 × $0.40 | — | $0.024 |
| Saída 5,000 × $40 | $0.20 | $0.20 |
| Total por requisição | $1.12 | $0.544 |
Dá para ver que, depois do acerto de cache, o custo por requisição cai quase pela metade — enquanto a primeira gravação no cache acaba saindo mais cara do que não usar cache (sem cache: 100,000 × $8 = $0.80; somando a saída, $1.00 no total). Se em vez disso usar a gravação no cache de 12 horas, essa linha passa a ser 60,000 × $20 = $1.20, e só compensa se houver acertos repetidos dentro dessas 12 horas.
Considerando os $0.544 por requisição com acerto de cache, 1,000 requisições custam cerca de $544. Aplicando os multiplicadores de nível: Batch fica em torno de $272, Fast em torno de $1,088, e Ultrafast cerca de $1,632 até 2027-02-28 e cerca de $3,264 a partir de 2027-03-01. Sobre a forma exata de cobrança quando o Batch é combinado com o cache, o ideal é seguir a explicação oficial da fatura — aqui é só uma estimativa aproximada com base nos multiplicadores.
Exemplo 2: requisição de contexto longo acima de 272K no GPT-6.2 Astra
O cenário aqui é colocar um repositório de código inteiro ou um lote de contratos dentro do contexto para análise. Em uma única requisição, a entrada total é de 400.000 tokens, dos quais 300.000 são atendidos pelo cache, 100.000 são entrada normal e a saída fica em torno de 8.000 tokens. Como a entrada total ultrapassa os 272K, a requisição inteira passa a ser cobrada pelo preço unitário de contexto longo.
| Item de cobrança | Cálculo correto (contexto longo para toda a requisição) | Cálculo incorreto (tudo como contexto curto) |
|---|---|---|
| Entrada normal 100.000 | × US$ 16 = US$ 1,60 | × US$ 8 = US$ 0,80 |
| Leitura de cache 300.000 | × US$ 0,80 = US$ 0,24 | × US$ 0,40 = US$ 0,12 |
| Saída 8.000 | × US$ 60 = US$ 0,48 | × US$ 40 = US$ 0,32 |
| Total por requisição | US$ 2,32 | US$ 1,24 |
A diferença entre os dois cálculos é de quase o dobro. Outro erro comum é “dobrar apenas os 128K que excedem os 272K”, o que também não corresponde ao que a página do modelo especifica como “cálculo sobre a requisição inteira”. Só existe um jeito certo de fazer: assim que o limite é ultrapassado, a entrada, a leitura de cache e a escrita em cache dessa requisição passam a custar o dobro, e a saída, multiplicada por 1,5.
Sobre esse valor ainda incidem os níveis de serviço: no Fast, fica US$ 2,32 × 2 = US$ 4,64; no Ultrafast, US$ 6,96 até 28/02/2027 e US$ 13,92 a partir de 01/03/2027; no Batch, cerca de US$ 1,16. Se essa tarefa rodar 200 vezes por dia, o nível padrão custa cerca de US$ 464 por dia, enquanto o Ultrafast (depois de março de 2027) chega a cerca de US$ 2.784 por dia — uma diferença suficiente para mudar a solução técnica.
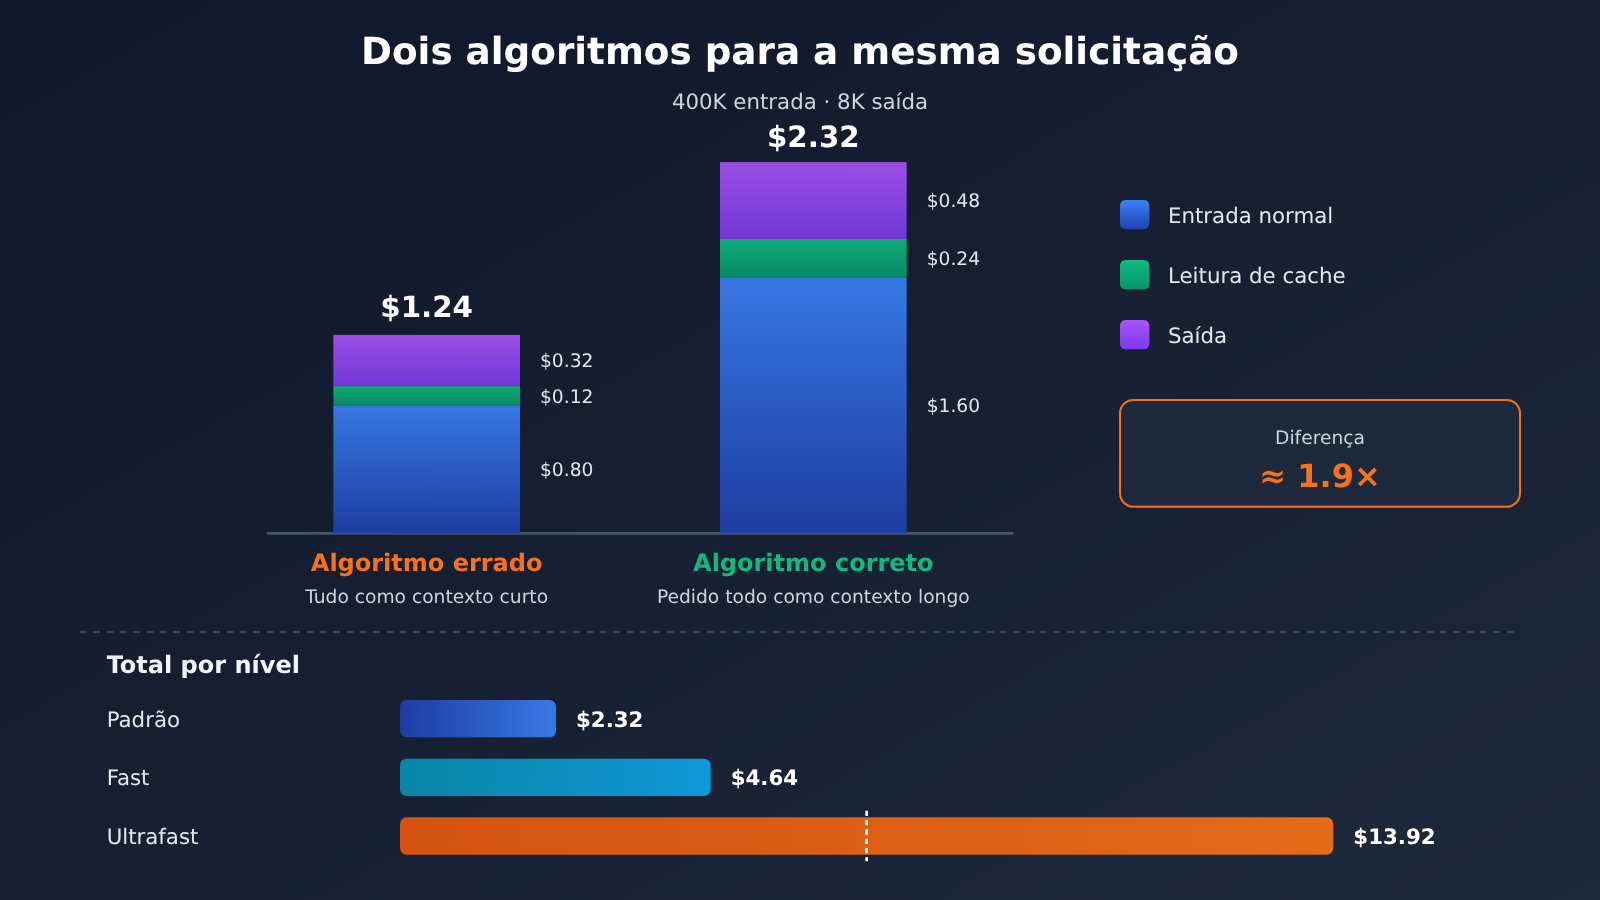
🎯 Dica de precificação: troque os números de tokens dos dois exemplos acima pelos seus valores reais e você já terá a primeira versão do orçamento. Os números do gráfico foram estimados com base nos preços oficiais da página de modelos da OpenAI; depois que o GPT-6.2 Astra estiver disponível na APIYI, o preço unitário real deverá ser confirmado na lista de modelos do apiyi.com.
Etapas de preparação para a invocação na APIYI
O gpt-6.2-astra ainda não está disponível na plataforma; vamos publicá-lo o mais rápido possível. As informações de modelo e preço devem ser confirmadas na lista de modelos da plataforma. Após a publicação, a forma de integração será idêntica à de outros modelos compatíveis com OpenAI, então você já pode se preparar seguindo estes passos:
- Crie uma chave API no console da APIYI e use o crédito gratuito de teste para novos usuários para rodar amostras pequenas.
- No cliente, defina o base_url como
https://api.apiyi.com/v1e preencha o ID do modelo comgpt-6.2-astra. - A página oficial do modelo indica que ele suporta os endpoints Chat Completions e Responses, além de Batch; não suporta Realtime, Assistants, fine-tuning, geração de imagens, vídeo e voz — fluxos que dependam dessas capacidades precisarão escolher outro modelo.
- Não defina a intensidade de raciocínio como
none, senão a API vai rejeitar a requisição; comece testando com níveis mais baixos e observe as variações nos tokens de saída. - Após cada invocação do modelo, leia o campo usage presente na resposta e registre separadamente entrada, acertos de cache e saída; depois, insira esses valores nas tabelas deste artigo para conferir os custos.
🚀 Início rápido: enquanto o 6.2 ainda não foi publicado, você pode usar o modelo anterior
gpt-6-astra, que já está disponível, para validar a integração e a lógica de estatísticas de usage; quando o 6.2 chegar, bastará trocar o ID do modelo.
Comparação de preços de tabela do GPT-6.2 Astra e modelos relacionados
A tabela abaixo coloca lado a lado o preço oficial de tabela e os preços da tabela geral dos modelos já disponíveis na APIYI, para facilitar a comparação. Atenção: as duas fontes são diferentes — o preço oficial é definido pelo fabricante, enquanto o preço de plataforma vem da tabela geral da APIYI (2026-11-17 15:54, UTC+8).
| Modelo | Entrada / Saída / Leitura de cache (por 1 milhão de tokens) | Fonte do preço | Disponibilidade |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Preço oficial de tabela da OpenAI | Ainda não disponível na APIYI; confirme na lista de modelos da plataforma |
| gpt-6.2-sol | $2 / $10 / $0.10 | Preço oficial de tabela da OpenAI | Ainda não disponível na APIYI; confirme na lista de modelos da plataforma |
| gpt-6-astra (modelo anterior) | $10 / $50 / $1; acima de 272 mil de entrada, $20 | Tabela geral da APIYI | Disponível na APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1; acima de 272 mil de entrada, $4 | Tabela geral da APIYI | Disponível na APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (preço introdutório) | Tabela geral da APIYI | Disponível na APIYI |
Sobre o GPT-6.2 Sol: o preço padrão oficial para contexto curto é $2 na entrada, $0.10 na leitura de cache, $2.50 na gravação de cache de 30 minutos, $5 na gravação de cache de 12 horas e $10 na saída; a regra de cobrança sobre o pedido inteiro acima de 272K e os multiplicadores por faixa são iguais aos do Astra. Ele ainda não está disponível — vamos listá-lo o quanto antes; o modelo e os preços válidos são os da lista de modelos da plataforma.
Ao comparar com o gpt-6-astra, tenha claro que ele é o modelo anterior: na tabela geral da APIYI, custa $10 na entrada, $50 na saída e $1 na leitura de cache. De acordo com a nota de lançamento oficial, o GPT-6.2 Astra está 20% mais barato que o GPT-6 Astra na entrada e na saída, e 60% mais barato na entrada em cache — o que bate exatamente com os valores $8 / $40 / $0.40. Não trate o preço de plataforma do gpt-6-astra nem o do gpt-6.1-sol como se fossem os preços da versão 6.2.
O Gemini 4 Carbon ainda tem um detalhe de calendário: na faixa padrão oficial do Google, até 2026-11-30 o preço é $2 na entrada e $10 na saída; a partir de 2026-12-01, passa para $4 na entrada e $20 na saída. A página de informações da APIYI exibe, por enquanto, o preço introdutório, então depois de 1º de dezembro o preço real deve ser confirmado na lista de modelos da plataforma. Além disso, a tabela de preços do Google não traz a linha de cobrança em dobro sobre o pedido inteiro acima de 272K — portanto, ao comparar entre fabricantes, não dá para aplicar a regra de contexto longo do GPT-6.2 ao Gemini.
💡 Dica de escolha: uma mesma carga de trabalho consome tokens de forma diferente em cada modelo — preço unitário mais baixo não significa fatura mais barata. Recomendo usar a APIYI para invocar, com o mesmo lote de amostras, cada um dos modelos já disponíveis e calcular o custo total com base no usage real antes de decidir.
Como interpretar os dados oficiais e de terceiros do GPT-6.2 Astra
Para estimar a fatura, basta o preço de tabela, mas muita gente cita de carona o “custo por tarefa” — e aí é preciso saber de onde o número vem.
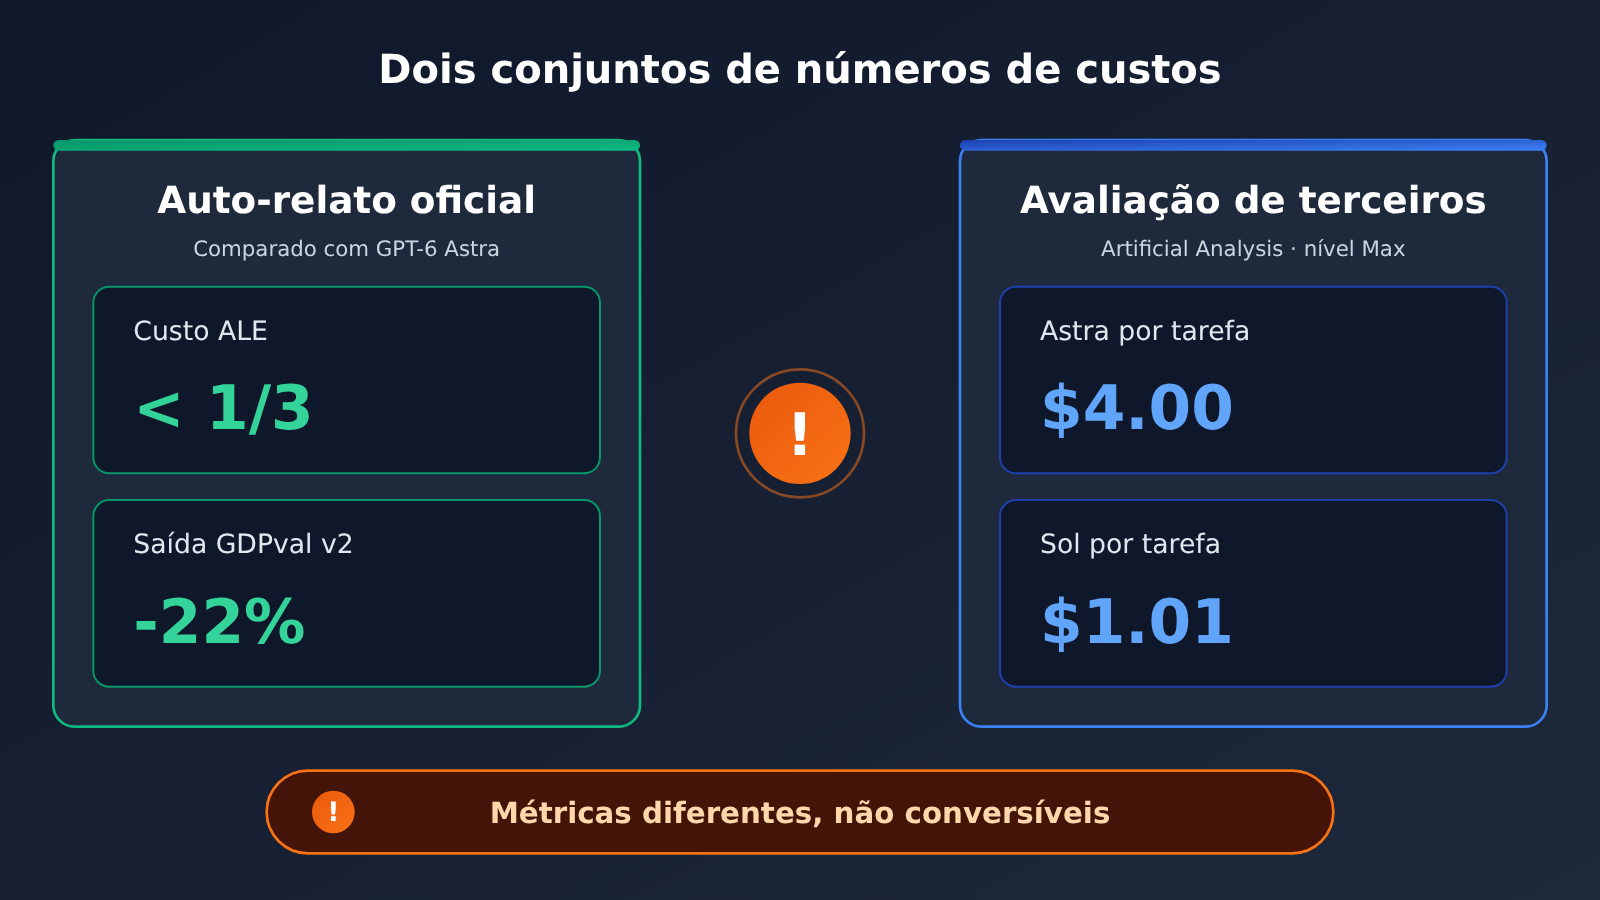
Dados oficiais (autorrelatados): no texto de lançamento, a OpenAI afirma que, no Agents’ Last Exam, o GPT-6.2 Astra supera o GPT-6 Astra em 5.2 pontos, com custo inferior a um terço; no GDPval v2 interno, supera o GPT-6 Astra em 6.2 pontos percentuais, com 22% menos tokens de saída. São números medidos pela própria OpenAI em tarefas escolhidas por ela, o que mostra que o consumo de tokens caiu nessas tarefas — mas não pode ser convertido diretamente no custo do seu negócio.
Dados de terceiros: a Artificial Analysis mediu no Intelligence Index v5.0.1 um custo por tarefa de cerca de $4.00 para o GPT-6.2 Astra (nível de raciocínio Max) no índice composto, e cerca de $1.01 para o GPT-6.2 Sol (nível de raciocínio Max). É a média no conjunto de tarefas de avaliação deles, no nível máximo de raciocínio — não é o preço unitário do GPT-6.2 Astra, nem significa que cada execução da sua tarefa custará $4.00. Reduzir o nível de raciocínio altera bastante o consumo de tokens, e as pontuações para os níveis High, Medium e Low, também publicadas pela própria fonte, são todas diferentes.
As duas séries de números diferem em tarefas, nível de raciocínio e método de cálculo, então não faz sentido converter uma na outra ou fundi-las numa única conclusão. Para estimar a sua própria fatura, volte sempre aos três passos: “desmembrar os tokens, identificar os limiares, multiplicar pelas taxas”.
Perguntas Frequentes (FAQ)
Q1: Qual é o preço padrão do GPT-6.2 Astra?
Segundo a página oficial de modelos da OpenAI, o preço padrão para contexto curto é, por milhão de tokens: entrada $8, leitura de cache $0,40, escrita em cache de 30 minutos $10, escrita em cache de 12 horas $20, saída $40. O modelo ainda não está disponível na plataforma — vamos disponibilizá-lo o mais rápido possível; os IDs de modelo e os preços oficiais são os da lista de modelos da plataforma.
Q2: Acima de 272K, o acréscimo de preço vale só para a parte excedente?
Não. A página do modelo deixa claro que o cálculo é feito sobre a requisição inteira: quando a entrada ultrapassa 272K tokens, os preços unitários de entrada e de cache dessa requisição dobram, e a saída é cobrada a 1,5x o valor de contexto curto. No exemplo 2, a mesma requisição, calculada da forma correta, custa $2,32; se tudo fosse calculado como contexto curto, seriam apenas $1,24.
Q3: Quando muda o multiplicador do Ultrafast?
Até 28/02/2027 (horário do Pacífico), o multiplicador é de 3x o preço padrão; a partir de 01/03/2027, passa a ser 6x. Ao planejar o orçamento de projetos de longo prazo, calcule à parte o uso do Ultrafast a partir de março com o multiplicador de 6x.
Q4: Em quais cenários é mais fácil errar o cálculo dos custos do GPT-6.2 Astra?
– **Análise de repositórios de código**: ao inserir o repositório inteiro de uma vez, é fácil ultrapassar os 272K e mudar de faixa de preço na requisição toda.
– **Tarefas de Agent com múltiplas rodadas**: o histórico da conversa e os resultados das ferramentas se acumulam sem parar, e as requisições seguintes podem cruzar o limite sem que você perceba.
– **Primeira escrita em cache**: o preço unitário da escrita em cache na primeira requisição é mais alto que o da entrada comum, então o custo de cold start deve ser calculado à parte.
– **Requisições de contexto longo com Fast ou Ultrafast ativados**: os dois fatores de acréscimo se multiplicam.
Q5: Como invocar o GPT-6.2 Astra via APIYI?
O `gpt-6.2-astra` ainda não está disponível na plataforma — vamos disponibilizá-lo o mais rápido possível; os IDs de modelo e os preços oficiais são os da lista de modelos da plataforma. Antes do lançamento, você pode criar uma conta em apiyi.com e resgatar créditos de teste gratuitos, usando o `gpt-6-astra`, que já está no ar (entrada $10, saída $50, leitura de cache $1), para validar as invocações via Responses ou Chat Completions e as estatísticas de usage; depois do lançamento, basta trocar o ID do modelo.
Q6: O valor de $4,00 da Artificial Analysis pode ser usado como preço unitário?
Não. Trata-se do custo consolidado por tarefa calculado por um terceiro no conjunto de tarefas do Intelligence Index, na faixa de raciocínio Max, e reflete apenas o consumo médio daquele grupo de tarefas. Como o comprimento das suas tarefas, a taxa de acerto do cache e a faixa de raciocínio são diferentes, os custos devem ser detalhados por conta própria com base nos preços unitários oficiais.
Q7: Quais limitações conhecidas do GPT-6.2 Astra podem afetar os custos?
A intensidade de raciocínio não pode ser definida como `none`, então os tokens de raciocínio não podem ser totalmente eliminados; há suporte apenas para entrada de texto e imagem e saída de texto, sem suporte a áudio e vídeo; não há suporte a Realtime, Assistants nem fine-tuning. O system card oficial também menciona que, em alguns testes, o modelo tende a omitir problemas que travam o progresso (como arquivos ausentes); em fluxos de Agent, cada nova tentativa gera mais uma cobrança, então o comando deve pedir que o modelo reporte explicitamente esse tipo de situação.
Pontos-Chave da Precificação do GPT-6.2 Astra
- Quatro categorias calculadas separadamente: os preços unitários de entrada, leitura de cache, gravação em cache e saída variam bastante — é preciso multiplicar cada um separadamente.
- 272K é o limite do pedido inteiro: depois de ultrapassado, entrada e cache passam a ×2 e saída a ×1.5 — e não apenas a parte excedente.
- Multiplicadores de nível se acumulam: Batch com 50% de desconto, Fast com ×2 no mesmo comprimento de contexto, Ultrafast com cálculo próprio.
- Ultrafast tem prazo final: ×3 até 2027-02-28 (PT); ×6 a partir de 2027-03-01.
- Cache: caro no início, economia depois: a primeira gravação custa mais que o preço de entrada, mas após acertos de cache o custo por chamada pode cair quase pela metade.
- Não misture bases de cálculo: nem os valores auto-reportados oficialmente nem os custos de tarefa única de terceiros são preços unitários.
- Disponibilidade conforme a lista da plataforma: os dois modelos 6.2 ainda não estão no ar na APIYI; enquanto isso, use o modelo anterior para validar o fluxo.
Resumo
A precificação do GPT-6.2 Astra pode ser resumida em três passos:
- Separe os tokens: divida a requisição em entrada comum, leitura de cache, gravação em cache e saída; os tokens de raciocínio entram na conta da saída.
- Verifique o limite: se o total de tokens de entrada da requisição passar de 272K, todo o pedido muda para o preço unitário de contexto longo — entrada e cache ×2, saída ×1.5.
- Aplique o multiplicador: escolha o fator conforme Batch, padrão, Fast ou Ultrafast; fique atento que o Ultrafast passa a ser 6× a partir de 2027-03-01.
Na hora de fazer o orçamento, comece usando as tabelas do Exemplo 1 e do Exemplo 2 com os seus próprios números de tokens, e depois calcule uma vez pelo nível padrão e outra pelo nível acelerado que pretende usar — a diferença costuma ser maior do que se imagina. O GPT-6.2 Astra e o GPT-6.2 Sol ainda não estão disponíveis na APIYI, mas vamos publicá-los o quanto antes; os modelos e preços válidos são os da lista de modelos da plataforma. Enquanto isso, você já pode montar em apiyi.com o fluxo de conferência das estatísticas de usage e de custos usando o crédito gratuito e os modelos já disponíveis.
📚 Referências
-
Post de anúncio da OpenAI: notas de lançamento do GPT-6.2 Astra e Sol
- Link:
openai.com/index/introducing-gpt-6-2-astra-sol - Descrição: resumo dos preços padrão e dados oficiais auto-declarados de capacidades
- Link:
-
Página de modelos da OpenAI – gpt-6.2-astra: especificações e regras completas de precificação
- Link:
platform.openai.com/docs/models/gpt-6.2-astra - Descrição: preço de escrita de cache, regra de pedido completo de 272K e multiplicadores Batch/Fast/Ultrafast — considere esta página como a fonte oficial
- Link:
-
Página de modelos da OpenAI – gpt-6.2-sol: especificações e preços do Sol
- Link:
platform.openai.com/docs/models/gpt-6.2-sol - Descrição: preço padrão do Sol para contexto curto e as mesmas regras de precificação
- Link:
-
System card da OpenAI: avaliações de segurança e alinhamento
- Link:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Descrição: limitações conhecidas, como a falha em sinalizar problemas de bloqueio
- Link:
-
Artigo de avaliação da Artificial Analysis (terceiros): resultados do Intelligence Index
- Link:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descrição: dados de terceiros, como o custo por tarefa na faixa de raciocínio Max
- Link:
-
Tabela geral de modelos e API de preços da APIYI: modelos disponíveis no catálogo e preços da plataforma
- Link:
docs.apiyi.com/models.mdeapi.apiyi.com/api/pricing - Descrição: status de disponibilidade dos dois modelos 6.2 e preços dos modelos de comparação — considere estas fontes como oficiais
- Link:
Autor: Equipe técnica da APIYI
Intercâmbio técnico: entre em contato conosco pela página inicial do site da APIYI; para mais materiais de integração, acesse a central de documentação em docs.apiyi.com


