Gemini 4 Carbon vs Gemini 4 Argon: 어떤 것을 선택할까? 4가지 기존 파라미터와 3가지 시나리오
img-874a170b6f0c0bb80d5e0d10

작성자 노트: 이미 gemini-4-argon을 쓰고 있는데 gemini-4-carbon으로 바꿔야 할까요? 이 글은 Google 개발자 가이드와 모델 카드를 바탕으로 두 모델의 공통점과 차이점, 마이그레이션할 때 정리해야 할 이전 파라미터 4가지, 그리고 바꾸지 말아야 할 때를 정리했어요. 먼저 결론부터 말씀드릴게요. Gemini 4 Carbon과 Gemini 4 Argon은 기본 단가가 같지만, 일상적인 기능 개발 때문에 Argon을 통째로 Carbon으로 바꿀 필요는 … 더 읽기
Muse Ember, 소형 모델 전쟁에서 승리했나: 하위 작업에 Haiku 5.5와 GPT-6 Luna 중 무엇을 먼저 쓸지에 대한 4가지 판단

img-7d06a2361da4fad25fcfa810

작성자 주석: Muse Ember는 11월 9일 출시됐지만 APIYI 모델 목록에는 아직 없어요. 이 글에서는 먼저 공식 정가와 서드파티 리더보드의 “작업당 비용”이 각각 무엇을 뜻하는지 정리하고, 오늘 하위 작업에 Haiku 5.5와 GPT-6 Luna 중 무엇을 써야 하는지 설명해요. Meta는 2026년 11월 9일 Muse Ember를 출시했어요. Muse 시리즈에서 가장 작은 모델로, 도구 호출, 코딩 하위 작업, 라우팅, … 더 읽기

VEO 3.1 공식 중계 중단: 구글 비디오 현재 채널 없음, 3가지 대체 모델을 Seedance, Wan, HappyHorse로 어떻게 전환할까

img-8424d8b7f6a36d1574a166a8

작성자 주석: APIYI가 2026-11-09에 VEO 3.1 공식 중계 종료 소식을 게시했으며, 현재 Google 비디오의 공식 중계와 공식 역방향 채널 모두 사용할 수 없습니다. 이 글은 /v1/videos의 veo 요청을 중단하고, model을 가격 목록 API에 실제로 존재하는 Seedance, Wan, HappyHorse 모델 ID로 변경하는 방법을 설명해요. 서비스가 아직 /v1/videos로 Veo 3.1 작업을 제출하고 있다면 지금 멈춰야 해요. APIYI가 … 더 읽기

Claude Fable 5.2와 GPT-6 Astra 비교: 어떻게 선택할까

img-af56ebe6fdf1ff9ed365eec5

작성자 주: 이 글에서는 공식 사양, 짧은 컨텍스트 가격, 272K 긴 컨텍스트 추가 요금, 캐시 읽기 가격, Anthropic 발표문에 공개된 비교 성적을 바탕으로 Claude Fable 5.2와 GPT-6 Astra를 비교하고, 2026-11-10 기준으로 어떤 모델을 바로 호출할 수 있는지 설명해요. Claude Fable 5.2와 GPT-6 Astra 중 어디에 예산을 배정할지 결정하려면 보통 세 가지 질문에 먼저 답해야 해요. … 더 읽기

프로덕션 환경에서 AI API 중계·통합 서비스 선택하기: 반드시 확인해야 할 신뢰성 지표 10가지와 7일 검증 절차

img-57f02286343a9f0bc663b403

작성자 주: 프로덕션 환경에서 AI API 중계 서비스나 애그리게이션 서비스를 선택할 때 어떤 신뢰성 지표를 확인해야 할까요? 이 글에서는 핵심 지표 10가지와 7일 검증 절차, 평가표를 소개해요. 많은 팀이 AI API 중계 서비스나 애그리게이션 서비스를 선택할 때 “호출이 되고 가격도 저렴하다”는 점부터 살펴봐요. 하지만 프로덕션 환경에 들어가면 문제가 서서히 드러나요. 피크 시간대에 429 오류가 늘고, … 더 읽기

원신 5.5 Flash Base 오픈소스 공개 후 어떤 방식을 선택할까: 기반 모델 자체 배포와 필요에 따른 API 호출을 비교하는 5가지 기준

img-fd819cb0687efe3e7582ce5e

작성자 주: 文心5.5 Flash Base의 오픈소스 가중치를 다운로드할 수 있어요. 이 글에서는 아키텍처와 파라미터, 하드웨어 요구사항, 사용 목적, 비용을 살펴보고 베이스 모델을 직접 배포할지, 필요할 때 API를 호출할지 판단해 볼게요. 2026년 11월 5일, 바이두가 文心5.5 Flash Base(ERNIE-5.5-Flash-Base)를 공식 출시하고 오픈소스로 공개했어요. 총 280B 파라미터 중 토큰마다 14B를 활성화하는 희소 MoE 베이스 모델로, 여러 벤치마크에서 동급 … 더 읽기

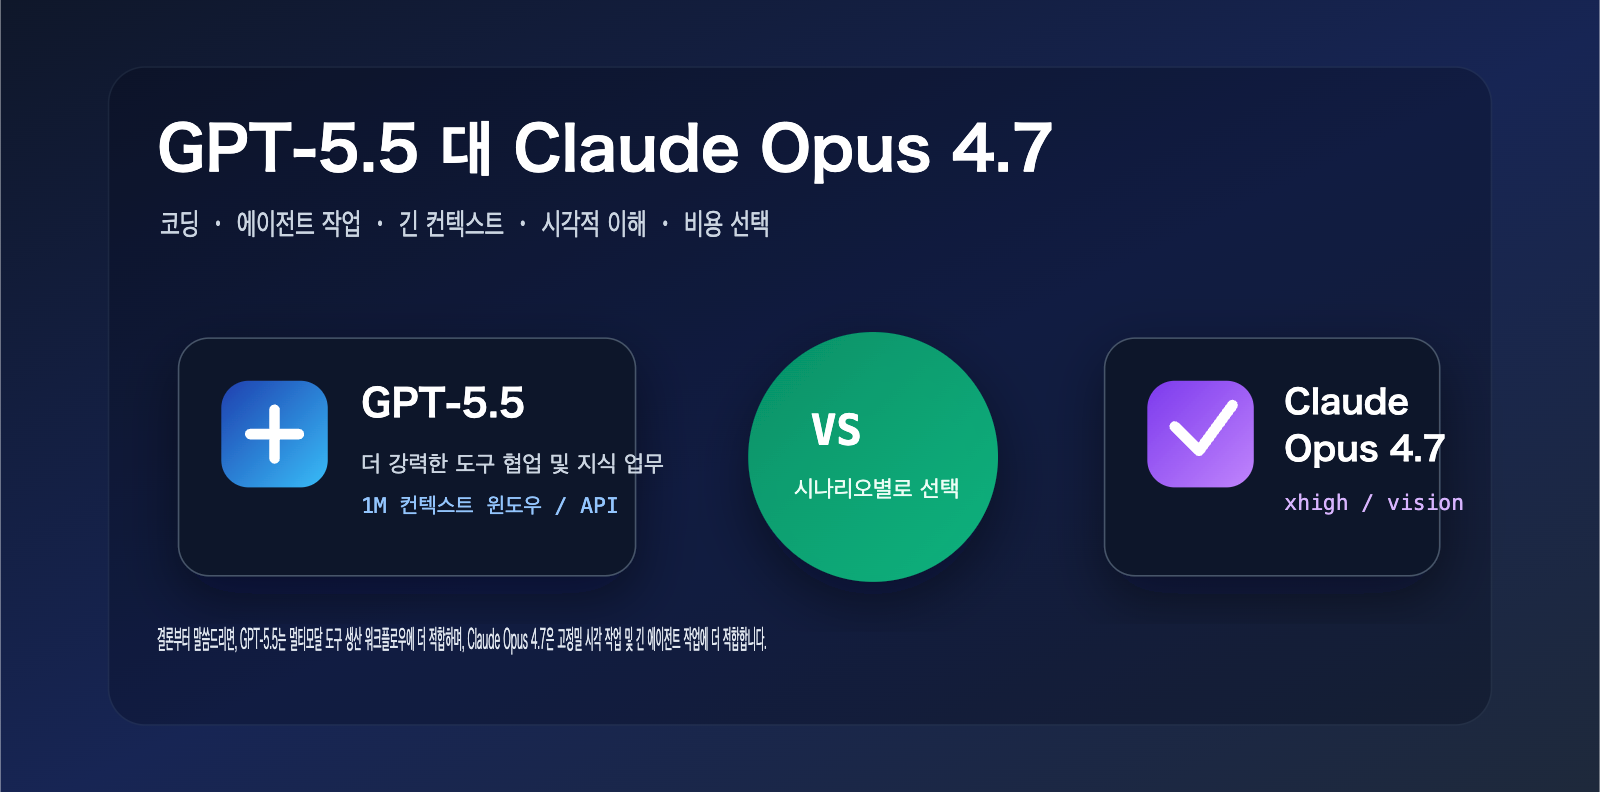
GPT-5.5 대 Claude Opus 4.7의 7가지 핵심 차이점 비교: 코딩, 긴 컨텍스트 및 API 선택 가이드

gpt 5 5 vs claude opus 4 7 comparison ko image 0 图示

GPT-5.5와 Claude Opus 4.7은 2026년 상반기 개발자들이 가장 주목하는 플래그십 모델 대결 중 하나입니다. 두 모델 모두 단순한 챗봇이 아닙니다. GPT-5.5는 에이전트 기반 코딩(agentic coding), 컴퓨터 사용, 지식 업무 및 과학 연구 분석에 더 중점을 둡니다. 반면, Claude Opus 4.7은 복잡한 추론, 장기 에이전트 작업, 고해상도 시각적 이해, 기억력, 그리고 더욱 엄격한 지시사항 준수에 초점을 … 더 읽기

GPT-Image-2와 Nano Banana 2 중 무엇이 더 강력한가? 텍스트-이미지 변환 및 이미지 편집 8가지 차원에서의 우위 비교

gpt image 2 vs nano banana 2 text to image editing comparison ko image 0 图示

2026년 2분기, AI 이미지 생성 시장은 전례 없는 "쌍둥이 별(Twin Stars)" 구도를 맞이했습니다. Nano Banana 2 (Gemini 3.1 Flash Image): 2월 26일 출시. Flash급 속도로 Pro급 화질에 도전하며 1~2초 만에 이미지 생성 가능. GPT-Image-2: 4월 21일 등장. Arena Elo 점수 1512점, 텍스트 정확도 99% 이상을 기록하며 업계의 천장을 다시 썼습니다. 두 모델은 **텍스트-이미지 변환(Text-to-Image)**과 **이미지 … 더 읽기

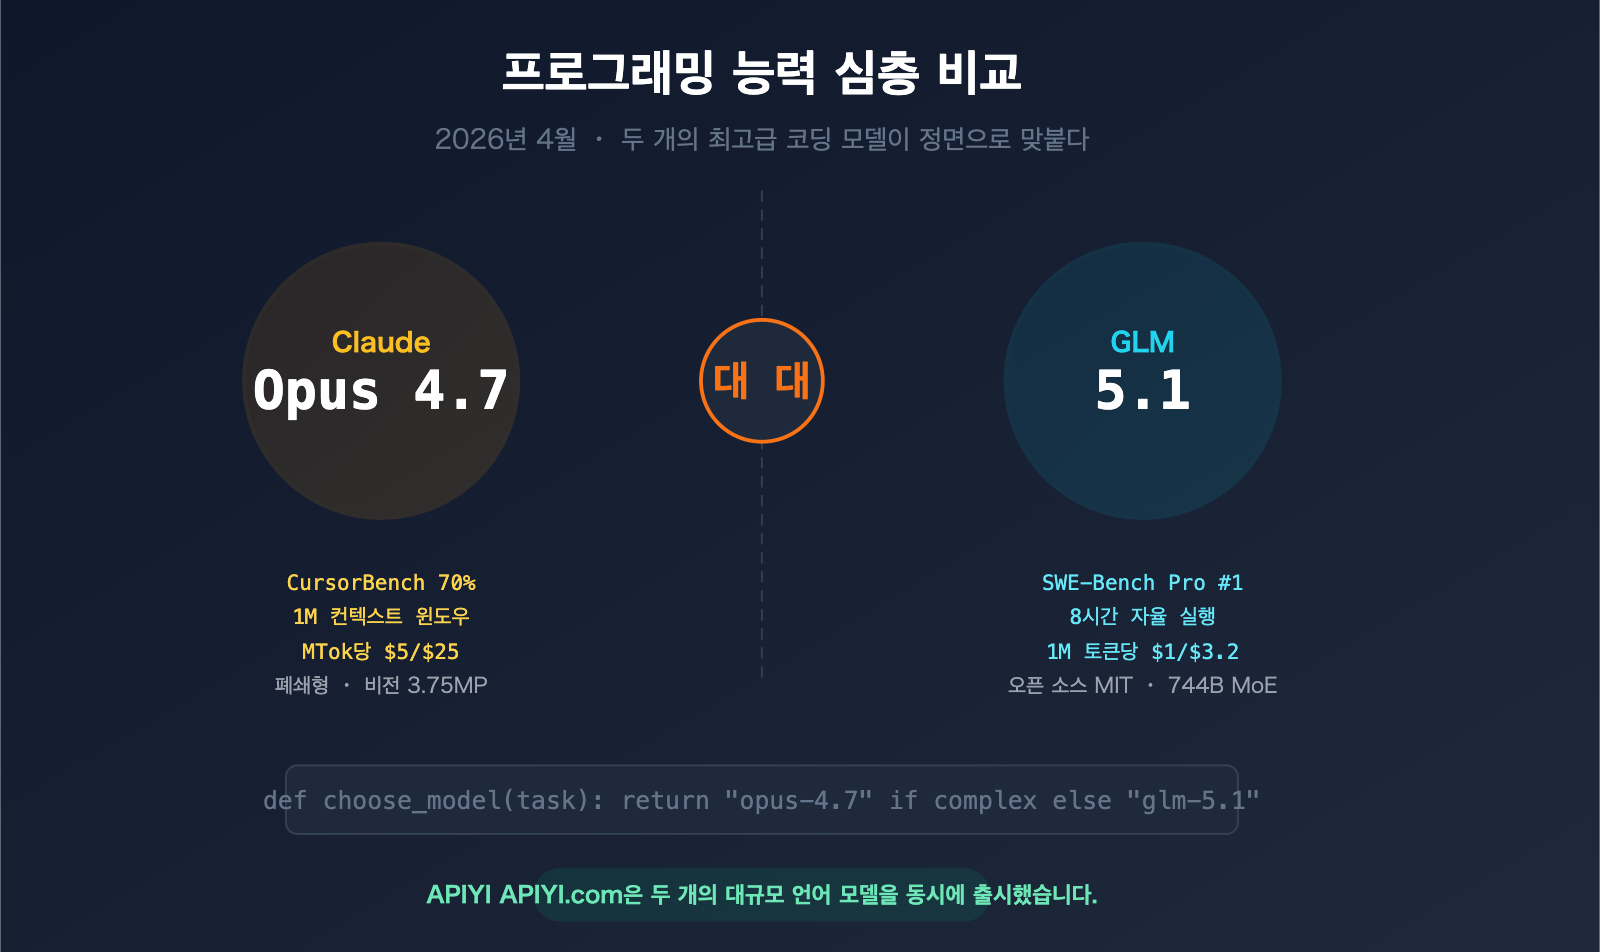
Claude Opus 4.7 대 GLM-5.1 프로그래밍 능력 심층 비교: 2026년 최강 코딩 모델은 누구인가 (API 호출 가이드 포함)

claude opus 4 7 vs glm 5 1 coding comparison guide ko image 0 图示

작성자 주: 프로그래밍 분야에서 Claude Opus 4.7과 GLM-5.1의 성능 차이를 심층 분석합니다. SWE-Bench, CursorBench 등 벤치마크 결과부터 장기 자율 코딩, API 가격까지 다루며, 개발자가 최적의 코딩 모델을 선택할 수 있도록 돕습니다. 2026년 4월, AI 코딩 분야에서 두 거물급 모델이 정면으로 맞붙었습니다. 4월 7일, 즈푸 AI(Z.ai)가 오픈소스 모델인 GLM-5.1을 출시하며 SWE-Bench Pro에서 58.4점을 기록해 세계 1위에 … 더 읽기

GPT-5.4 vs GPT-5.3 Codex 프로그래밍 능력 실측 비교: 6가지 벤치마크 테스트로 밝혀낸 최강 프로그래밍 모델

gpt 5 4 vs gpt 5 3 codex coding comparison benchmark guide ko image 0 图示

작가의 말: GPT-5.4와 GPT-5.3 Codex의 코딩 능력을 깊이 비교하고, SWE-Bench, Terminal-Bench 등 6가지 벤치마크 테스트 데이터를 통해 가장 적합한 코딩 모델을 선택하는 데 도움을 드립니다. GPT-5.4가 막 출시되었는데, 많은 개발자들의 첫 번째 질문은 이겁니다: 저는 아직도 GPT-5.3 Codex를 사용해야 할까요? 결국 GPT-5.4는 "프로그래밍, 추론, 컴퓨터 제어 능력을 융합한 최초의 통합 모델"이라고 주장하는 반면, GPT-5.3 Codex는 … 더 읽기