
2026년 11월 9일, Anthropic은 Claude Fable 5.2를 발표하며 내부 실험 한 가지를 공개했어요. 빈 폴더에서 시작한 실험에서 Fable 5.2는 1,000명이 넘는 하위 에이전트를 조율해 8일 동안 연속으로 작업했고, 마침내 노트북에서 실행할 수 있는 운영체제 프로토타입을 만들었어요.
핵심 가치: 이 글에서는 홍보 내용을 되풀이하는 대신, Anthropic이 공개한 멀티 에이전트 엔지니어링 자료를 바탕으로 오케스트레이터, 하위 에이전트, 어드바이저, 워크플로의 역할을 살펴보고, 작업을 어떻게 나눠야 하는지, 비용이 왜 증가하는지, 신뢰성을 어떻게 설계해야 하는지 설명해요. 마지막에는 개발자가 바로 적용할 수 있는 실천 목록도 제시해요.
Claude Fable 5.2 운영체제 실험 핵심 정보 한눈에 보기
먼저 확인된 사실과 아직 공개되지 않은 내용을 구분해 볼게요. 그래야 멀티 에이전트 협업의 진입 장벽을 제대로 이해할 수 있어요.
| 항목 | 세부 정보 |
|---|---|
| 발표일 | 2026년 11월 9일, Claude Fable 5.2와 함께 공개 |
| 발표 주체 | Anthropic |
| 실험 시작점 | 빈 폴더. 목표는 운영체제 프로토타입을 설계하고 구현하는 것 |
| 실행 규모 | 1,000명이 넘는 하위 에이전트가 8일 동안 연속으로 코드를 작성하고, 테스트하고, 검토하고, 수정 |
| 최종 결과물 | 커널, 디스크·키보드·네트워크 드라이버, 영구 파일 저장소, 윈도 시스템, 로그인 화면, 설치 프로그램, 내장 Claude 기능을 갖춘 프로토타입 시스템. 실제 노트북에서 부팅할 수 있어요 |
| 미공개 정보 | 에이전트 분업 구조, 하네스, 통신 프로토콜, 코드 규모, 프로그래밍 언어, 총 토큰 사용량, 실험 비용, 제3자 보안 감사 |
Anthropic은 이를 ‘작동하는 운영체제 프로토타입(working prototype operating system)’이라고 표현했어요. 즉, 상용 운영체제 수준으로 완성된 제품은 아니에요. 또 같은 시기에 공개된 다른 실험과 혼동하지 않도록 주의해야 해요. 예를 들어 페르마의 마지막 정리와 관련된 실험에서는 ‘리드 1명 + 도우미 999명’ 구조가 공개됐지만, 이는 별개의 실험이므로 운영체제 프로젝트에 그대로 적용할 수는 없어요.
이 실험에서 주목할 점은 코드가 얼마나 많이 작성됐느냐가 아니에요. 모델이 8일 동안 장기 소프트웨어 엔지니어링 프로젝트를 조직할 수 있었다는 점이 중요해요. 작업을 나누고, 병렬로 진행하고, 결과를 취합하고, 오류를 찾아 수정 작업을 배정했죠. 여기서 이 글의 핵심 질문이 나와요. 에이전트 1,000개를 운영할 때 진짜 어려운 건 조직과 조율이에요.
멀티 Agent 협업은 어떻게 작동할까: Claude Fable 5.2의 역할 분담
“멀티 Agent가 필요한가?”를 논하기 전에, 혼동하기 쉬운 몇 가지 개념부터 짚고 넘어가야 해요. 아래 표는 Anthropic Managed Agents 문서를 바탕으로 정리한 내용이에요.
| 개념 | 역할 | 대표적인 예 |
|---|---|---|
| Agent | 작업을 수행하고 도구를 호출하는 지능형 에이전트 | 코드를 읽고 테스트를 실행하는 프로그래밍 도우미 |
| Orchestrator | 작업을 분배하고 결과를 통합하는 조정자 | “블로그 시스템 만들기”를 여러 모듈로 나누고 결과를 취합 |
| Subagent | 위임받은 하위 작업을 수행하며 독립적인 컨텍스트를 갖는 에이전트 | 댓글 모듈을 구현하고 테스트까지 작성 |
| Advisor | 직접 작업하지 않고, 중요한 시점에 전문적인 조언을 제공 | 메인 Agent가 막혔을 때 더 강력한 모델에 해결책 문의 |
| Workflow | 작업 순서와 병렬 처리, 결과 전달을 구성하는 실행 흐름 | “조사→구현→검토→승인되지 않으면 재작업”으로 이어지는 다단계 절차 |
| Harness | 모델과 도구를 호출하고 실행을 관리하는 외부 시스템 | 직접 작성한 스케줄링 코드 또는 호스팅 Agent 플랫폼 |
멀티 Agent의 세 가지 협업 방식
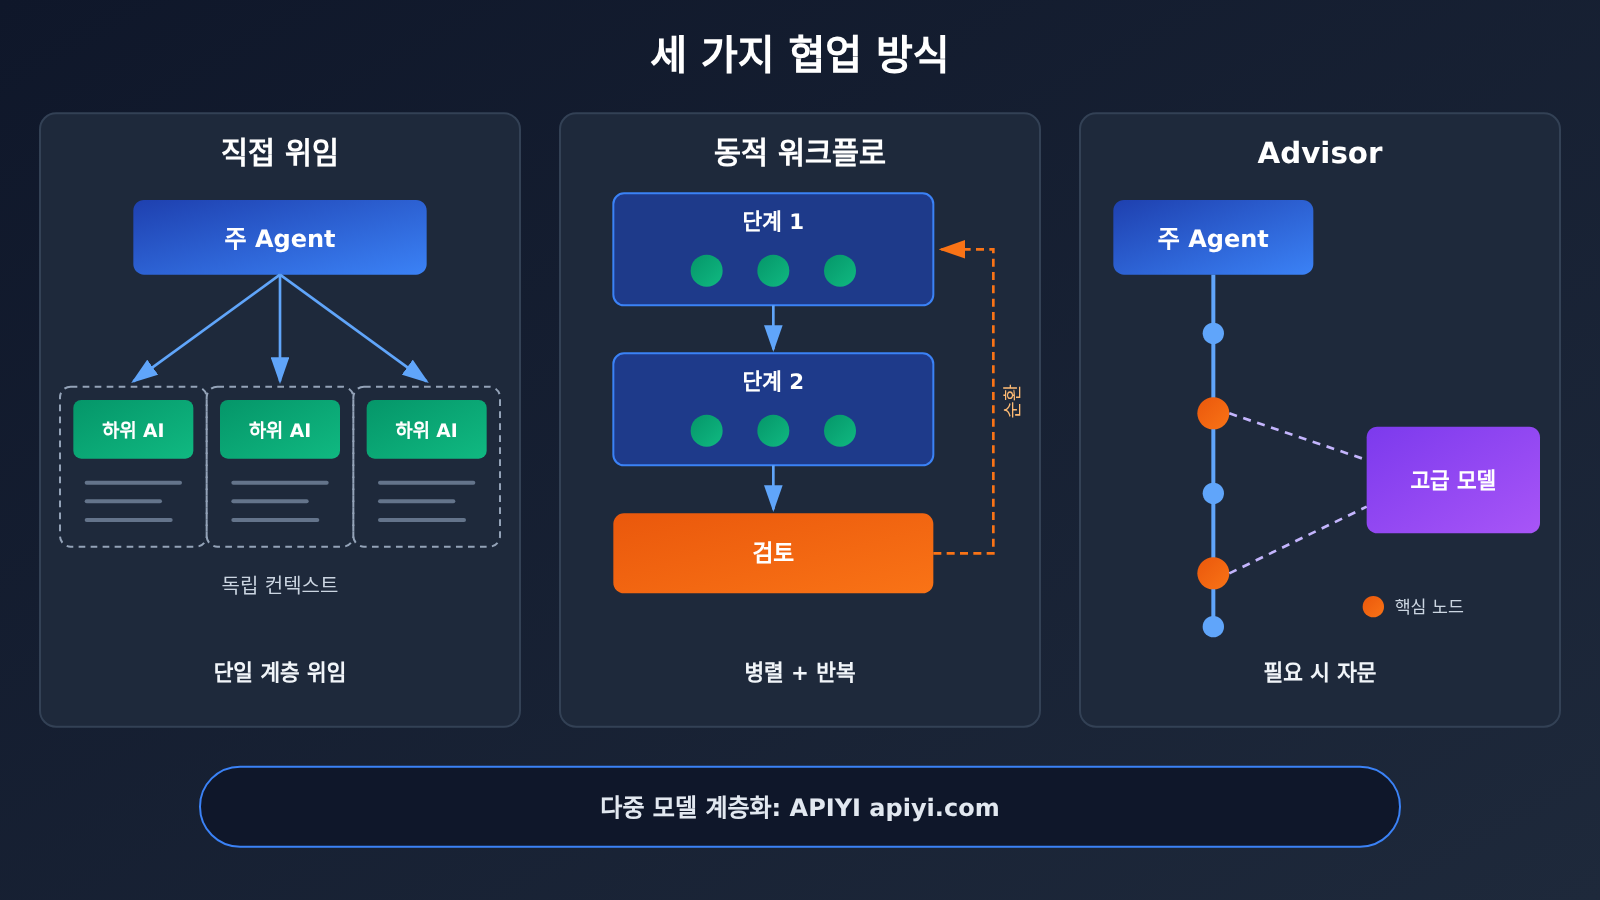
Anthropic의 Managed Agents 문서는 멀티 Agent 협업을 세 가지 방식으로 구분해요. 각 방식은 적합한 상황이 서로 달라요.
- Subagents 직접 위임: 메인 Agent가 어떤 하위 Agent를 만들지, 어떤 작업을 맡길지, 언제 결과를 확인할지, 추가 질문을 할지 직접 결정해요. 각 Subagent는 독립적인 Session Thread를 갖지만, 위임은 한 단계로 제한되며 Session 하나당 직접 연결되는 하위 스레드는 최대 25개예요. 지속적으로 진행 상황을 확인해야 하는 소수의 전문 작업에 적합해요.
- Dynamic Workflows 동적 워크플로: 메인 Agent가 하위 Agent를 하나씩 관리하는 대신 워크플로 프로그램을 생성해요. 이 프로그램은 단계를 나누고 여러 Agent를 병렬로 실행하며, 결과를 전달하고, 결과에 따라 다음 단계를 선택할 수 있어요. 검토를 통과하지 못하면 최대 반복 횟수에 도달할 때까지 다시 실행할 수도 있어요. 대규모 파일 검토나 여러 모듈을 다루는 코드 마이그레이션에 적합해요.
- Advisor 고문 방식: 메인 Agent가 직접 작업을 계속 수행하면서, 어렵거나 중요한 시점에만 더 강력한 모델에 조언을 구해요. 작업을 잘게 나눌 필요가 없어 조정 비용이 가장 적다는 장점이 있어요.
세 방식의 차이는 구체적인 예를 들면 쉽게 이해할 수 있어요. 전자상거래 백엔드를 Python에서 Go로 마이그레이션한다고 가정해 볼게요. 결제와 재고 두 모듈만 옮긴다면 직접 위임으로 충분해요. 서로 독립적인 인터페이스 200개를 마이그레이션하고 하나씩 검토해야 한다면 동적 워크플로가 적합해요. 엔지니어 수준의 Agent 하나가 작업하면서 가끔 데이터베이스 트랜잭션 설계에 대해 상급 모델의 검토를 받는다면 Advisor 방식이 가장 효율적이에요.
에이전트를 언제 늘려야 할까요? 멀티 에이전트 작업을 올바르게 분할하는 방법
Anthropic은 2026년 1월 23일에 발표한 「Building multi-agent systems: When and how to use them」에서 실제로 있었던 일을 소개했어요. 한 팀이 복잡한 멀티 에이전트 시스템을 구축하는 데 몇 달을 쏟았지만, 결국 단일 에이전트의 프롬프트를 개선하는 것만으로 비슷한 효과를 얻을 수 있었다는 내용이에요. 따라서 가장 먼저 물어야 할 것은 언제나 “어떻게 나눌까?”가 아니라 “나눠야 할까?”예요.
멀티 에이전트가 실제로 가치를 발휘하는 세 가지 상황
이 글에 따르면 멀티 에이전트가 안정적으로 가치를 만들어 내는 상황은 크게 세 가지예요.
- 컨텍스트 격리: 예를 들어 고객 지원 에이전트가 주문 내역을 대량으로 확인한 뒤 기술 문제를 진단하면, 주문 데이터가 컨텍스트를 차지해 판단을 방해할 수 있어요. 주문 조회를 별도의 에이전트에 맡기고 필요한 요약만 전달하면, 주 에이전트가 중요한 정보에 집중할 수 있어요.
- 병렬 처리: 여러 지역의 시장을 각각 조사하거나, 여러 문서를 동시에 검토하거나, 서로 다른 코드 모듈을 병렬로 점검하는 경우예요. Anthropic은 이런 구조의 주요 가치가 전체 소요 시간을 줄이는 데 있기보다는 작업의 범위와 완성도를 높이는 데 있다고 강조해요.
- 전문 분야별 분업: 에이전트마다 시스템 프롬프트, 도구, MCP Server, Skills, 모델을 다르게 구성해 단일 에이전트에 지나치게 많은 역할이 몰리지 않도록 해요.
역할이 아니라 컨텍스트 경계를 기준으로 나누기
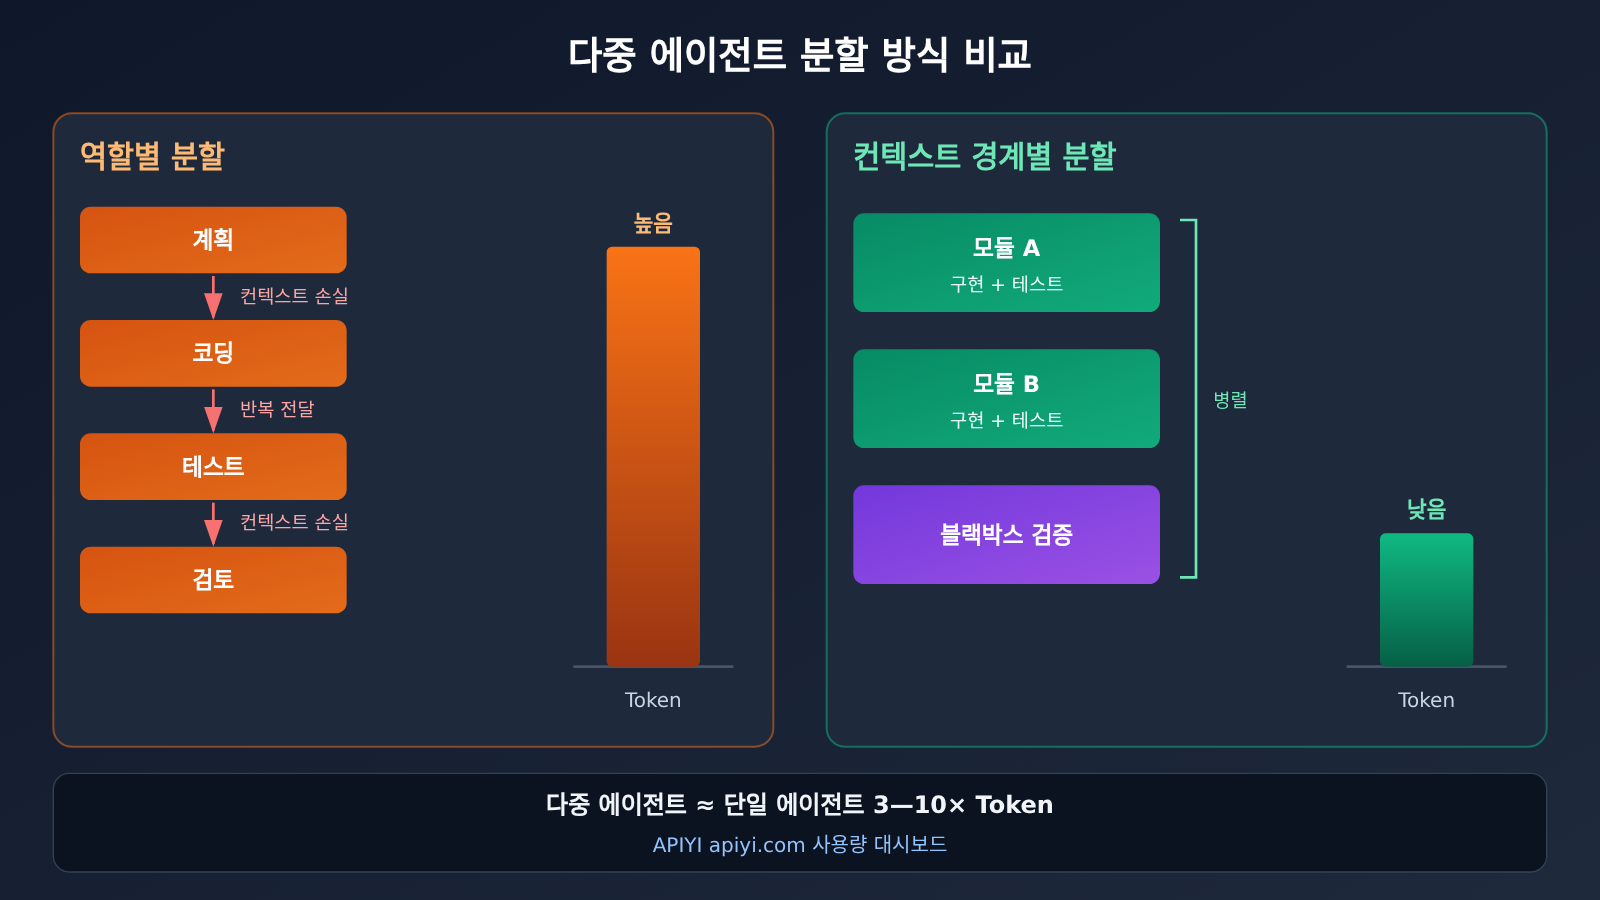
Anthropic이 제시한 설계 원칙은 컨텍스트 중심 분해(Context-centric decomposition)예요. 작업 단계를 기계적으로 나누기보다 컨텍스트 경계를 기준으로 분할해야 한다는 뜻이에요. 많은 팀이 처음에는 “기획 에이전트 + 코딩 에이전트 + 테스트 에이전트 + 리뷰 에이전트”처럼 나누려고 해요. 명확하게 역할을 분담한 개발팀처럼 보이지만, 실제로는 문제가 많아요.
테스트 에이전트는 코드가 왜 그렇게 설계됐는지 모르고, 리뷰 에이전트는 앞서 진행된 탐색 과정을 이해하지 못해요. 에이전트 간에 정보를 반복해서 전달하다 보면 ‘전화로 말을 전하는 놀이’처럼 내용이 왜곡되기 쉬워요. 더 나은 방법은 에이전트 하나가 구현과 해당 테스트를 포함해 하나의 기능 모듈 전체를 맡도록 하는 거예요. 다른 에이전트는 독립적인 인터페이스가 있는 모듈을 맡고, 세 번째 에이전트는 블랙박스 검증만 담당해요. 이때 검증 에이전트에는 검증할 결과물과 명확한 합격 기준, 테스트 도구만 전달하면 돼요.
| 작업 유형 | 멀티 에이전트 적합성 | 이유 |
|---|---|---|
| 여러 지역의 독립적인 시장 조사 | 높음 | 하위 작업 간 정보 공유가 거의 필요하지 않음 |
| 대량의 문서 병렬 검토 | 높음 | 각 문서를 독립적으로 처리한 뒤 결과를 취합할 수 있음 |
| 서로 다른 모듈의 독립적인 개발 | 높음 | 인터페이스가 명확하면 컨텍스트 경계가 자연스럽게 생김 |
| 독립적인 테스트 및 검증 | 높음 | 블랙박스 검증에는 결과물과 기준만 있으면 됨 |
| 긴밀하게 결합된 코드 수정 | 낮음 | 한 곳을 바꾸면 여러 곳에 영향이 생겨 인수인계 비용이 큼 |
| 대량의 실시간 상태를 공유해야 하는 작업 | 낮음 | 상태 동기화 비용이 병렬 처리의 이점보다 클 수 있음 |
| 간단한 사실 확인 | 대개 불필요 | 단일 에이전트가 한 번 호출되는 것으로 충분함 |
운영체제 실험을 다시 살펴보면 커널, 드라이버, 파일 시스템, 윈도우 시스템 사이에는 비교적 명확한 모듈 경계가 있어요. 이 점이 복잡한 업무 시스템을 대규모로 리팩터링하는 경우보다 운영체제 실험이 대규모 병렬 작업에 더 적합한 이유 중 하나예요. 물론 Anthropic은 구체적인 업무 분담 방식을 공개하지 않았으므로, 이는 합리적인 추정으로 볼 수는 있어도 사실로 단정할 수는 없어요.
멀티 에이전트 비용이 더 높은 이유: Claude Fable 5.2 시대의 토큰 장부
많은 사람은 작업을 더 많은 에이전트에 나눠 병렬로 처리하면 비용을 분산할 수 있다고 생각해요. 하지만 실제로는 반대인 경우가 많습니다. Anthropic은 2026년 1월에 공개한 글에서 같은 작업을 처리할 때 멀티 에이전트 아키텍처는 일반적으로 단일 에이전트보다 토큰을 3~10배 더 사용한다고 명확히 밝혔어요.
추가 토큰은 주로 다섯 가지 원인에서 발생합니다. 각 에이전트가 자체 컨텍스트를 구성해야 하고, 에이전트끼리 작업 설명과 결과를 주고받아야 해요. 메인 에이전트는 여러 하위 에이전트의 출력을 읽고 요약해야 하며, 작업을 분해하는 과정에서도 추가 호출이 발생합니다. 또 여러 에이전트가 같은 작업을 중복 수행할 수도 있어요.
두 가지 비용 데이터, 서로 다른 기준
멀티 에이전트 비용을 논할 때 서로 다른 출처의 데이터를 뒤섞는 경우가 많아요. 아래 표에서 각각의 기준을 구분해 볼게요.
| 데이터 출처 | 지표 | 비교 기준 |
|---|---|---|
| 2026년 1월 《Building multi-agent systems》 | 멀티 에이전트의 토큰 사용량은 단일 에이전트의 3~10배 | 같은 작업을 수행하는 단일 에이전트 |
| 2025년 6월 Anthropic Research 시스템 | 토큰 사용량은 일반 채팅의 약 15배 | 일반 채팅 |
| 2025년 6월 Anthropic Research 시스템 | 내부 Research Eval에서 단일 에이전트 Opus 4보다 90.2% 높은 성능 | 단일 에이전트 Opus 4, 특정 내부 평가 |
| 2025년 6월 Anthropic Research 시스템 | 복잡한 질의의 조사 시간을 최대 약 90% 단축. 초기에는 일반적으로 서브에이전트 3~5개를 병렬로 사용 | 같은 시스템의 단일 스레드 조사 |
90.2%와 15배라는 두 수치는 모두 2025년 Research 시스템에서 나온 값이라는 점에 유의해야 해요. 전자는 특정 내부 평가에서의 상대적인 성능일 뿐, 모든 작업의 정확도가 90.2% 향상된다는 뜻은 아닙니다. 이 수치들은 2026년 운영체제 실험과 무관하며, 3~10배와 직접 비교할 수도 없어요.
총 연산량, 실행 시간, 작업 범위는 서로 다른 지표예요
멀티 에이전트 비용을 이해하려면 세 가지 지표를 구분해야 해요. 컨텍스트가 복사되고 결과를 반복해서 읽기 때문에 총 연산량은 대체로 증가합니다. 하위 작업들이 실제로 서로 독립적이라면 실행 시간은 줄어들 수 있어요. 여러 에이전트가 다양한 방향을 동시에 탐색할 수 있으므로 작업 범위는 넓어지는 경우가 많습니다.
공식 API 가격을 기준으로 추정하면 Fable 5.2 일반 모드의 입력은 백만 토큰당 8달러, 출력은 백만 토큰당 40달러예요. Batch API는 50% 할인을 제공하고, 캐시 읽기 비용은 MTok당 0.20달러입니다. 단일 에이전트 작업에도 상당한 토큰이 든다면, 사용량이 3~10배로 늘었을 때 비용 차이는 매우 커질 수 있어요. Anthropic은 운영체제 실험의 실제 청구 금액을 공개하지 않았으므로 “8일 동안 얼마를 썼다”는 식의 주장은 근거가 없습니다.
안정적인 멀티 Agent 시스템 설계하기: Claude Fable 5.2에서 배운 엔지니어링 방법
모델 계층화: 모든 Agent에 최고 성능 모델이 필요한 것은 아니에요
Managed Agents는 두 가지 방식으로 Agent를 정의할 수 있어요. Predefined Agent는 미리 설정해 두는 방식으로, 모델, System Prompt, 도구, MCP Server, Skills를 각각 지정할 수 있어요. Inline Agent는 실행 중에 동적으로 정의하며, 기본적으로 메인 Agent의 모델과 도구 설정을 그대로 사용해요.
이를 활용하면 비용과 성능을 계층화할 수 있어요. 코디네이터와 복잡한 검토에는 Fable 5.2 같은 강력한 모델을, 일반적인 자료 검색에는 Sonnet급 모델을, 간단한 분류에는 Haiku급 모델을 사용하는 식이에요. 이는 설계 예시일 뿐, Anthropic이 정한 고정 아키텍처는 아니에요. 실제 작업에 맞춰 테스트하고 조정해야 해요.
검증: 검토 Agent가 실제 검증을 대신할 수는 없어요
Anthropic은 Fable 5.2의 Prompting 문서에서 새로운 변화를 소개했어요. xhigh, max 같은 높은 Effort 설정에서는 Fable 5.2가 Subagent를 호출해 자신의 작업을 점검하지만, Fable 5.1은 같은 테스트 작업에서 이런 동작을 보이지 않았다고 해요. 이는 오케스트레이션 역량이 발전했다는 뜻이지만, 품질 보증으로 간주해서는 안 돼요.
검토 Agent 역시 본질적으로는 모델의 판단에 의존해요. 신뢰할 수 있는 검증을 위해서는 명확한 승인 기준, 실행 가능한 블랙박스 테스트, 코드와 외부 시스템 변경 사항에 대한 실제 점검이 필요해요. 예를 들어 테스트를 실제로 실행하고 서비스를 실제로 시작해야 하죠. 운영체제 실험에서 가장 설득력 있었던 점은 어떤 Agent가 “문제없어 보인다”고 말한 게 아니라, “실제 노트북에서 부팅된다”는 확실한 결과였어요.
과도한 위임과 규칙 누적 방지하기
Agent의 작업 위임 여부는 모델의 역량뿐 아니라 Harness와 도구 설명의 영향도 받아요. Anthropic의 테스트에 따르면 Subagent 도구 설명에 “각 하위 Agent의 추가 비용, 위임할 만한 작업과 그렇지 않은 작업, 작업 설명 방법”을 명시했을 때, 위임 이유만 강조한 버전보다 짧은 작업에서 모델의 위임 빈도가 약 3분의 1 줄었고, 작업 성공률은 그대로 유지됐어요.
또 쉽게 간과하는 문제가 규칙의 누적이에요. Fable 5.2는 컨텍스트에 쌓인 제한적 지시를 비교적 엄격하게 따르기 때문에, 과거 파일과 Reviewer 의견, System Prompt에 금지 사항이 계속 추가되면 원래 허용된 작업도 모델이 실행하지 못할 수 있어요. 따라서 Agent의 메모리와 규칙, 승인 요구 사항을 주기적으로 정리해야 해요.
런타임 제한: 공개 제품의 실제 한계
공개 제품에서도 “Agent 1000개”에는 명확한 한계가 있어요. 다음은 Managed Agents 문서에 명시된 제한이에요. 공개 제품에 적용되는 기준이며, 내부 운영체제 실험에서 같은 스케줄러를 사용했다는 뜻은 아니에요.
| 지표 | 제한 |
|---|---|
| 직접 Subagent 하위 스레드 | 최대 25개 |
| Dynamic Workflow 동시 작업 스레드 | 64개 |
| 단일 Workflow 수명 동안 시작할 수 있는 Agent | 1000개 |
| 기본 Workflow 수명 | 24시간 |
| 단일 Session에서 기본적으로 동시에 열 수 있는 Workflow | 10개 |
또한 Workflow 내 Agent는 중첩 Workflow를 만들 수 없어요. 예산에 도달하면 실행 중인 Workflow는 일시 중지되고, Agent가 실패하면 시스템은 보통 한 번 재시도해요. 다시 실패하면 Workflow가 후속 처리 방법을 결정하죠. 즉, Agent 1000개는 “수명 동안 누적해 시작할 수 있는 수”이고, 같은 시점에 실제로 실행되는 Agent는 그보다 훨씬 적어요.
장시간 실행에는 사용자 경험 측면의 문제도 있어요. Fable 5.2는 도구를 오래 호출하는 동안 사용자에게 보여 주는 텍스트를 거의 출력하지 않을 수 있어, 사용자가 작업이 멈췄다고 오해할 수 있어요. 공식 문서에서는 thinking.display: "updates"를 켜거나, 연속으로 여러 번 도구를 호출한 뒤 Harness가 모델에 진행 상황을 알리도록 권장해요. 공식 테스트에서는 진행 상황 알림을 추가한 뒤, 피드백 없이 이어지는 시간이 가장 길게는 약 절반으로 줄었어요.
멀티 에이전트 빠른 시작: Claude Fable 5.2로 최소 오케스트레이터 만들기
아래 예제에서는 호스팅 플랫폼에 의존하지 않고 OpenAI 호환 인터페이스를 사용해 가장 기본적인 작업을 살펴봐요. 조정 모델이 컨텍스트 경계에 따라 작업을 나눕니다.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 호환 인터페이스
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # 플랫폼 모델 목록에 표시된 실제 이름을 사용하세요
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
완성된 버전에는 모델 계층화, 병렬 실행, 토큰 예산, 실패 시 한 번 재시도, 블랙박스 검수가 포함되어 있어요. 구조는 앞서 설명한 엔지니어링 방법에 대응합니다.
전체 멀티 에이전트 오케스트레이션 예제 코드 보기
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 하나의 키로 여러 모델 호출
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # 조정 및 검수에 사용할 고성능 모델
WORKER_MODEL = "your-fast-model"          # 하위 작업에 사용할 더 빠르고 저렴한 모델. 필요에 따라 교체하세요
TOKEN_BUDGET = 200_000                     # 전체 작업의 토큰 예산
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # 각 하위 에이전트에는 필요한 컨텍스트만 전달하고, 실패하면 한 번 재시도합니다
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # 블랙박스 검수: 결과물과 기준만 제공하고 탐색 과정은 공유하지 않습니다
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # 동시 실행 수 제어
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
이 코드는 구조를 보여주기 위한 예제일 뿐이며, 검수 과정은 여전히 모델의 판단에 맡겨져 있어요. 프로덕션 환경에서는 review를 실제 테스트 실행으로 대체하거나 보완해야 합니다. 예를 들어 단위 테스트를 실행하거나 서비스를 시작해 API를 점검할 수 있어요.
🚀 빠른 시작 팁: 멀티 에이전트의 핵심은 역할마다 다른 모델을 사용하고 사용량을 수시로 비교할 수 있게 하는 거예요. APIYI apiyi.com에서 하나의 API 키로 Claude, OpenAI, Gemini 등의 모델을 연동해 보세요. 먼저 신규 사용자 무료 테스트 크레딧으로 단일 에이전트 기준선을 확인한 다음, 협업 계층을 단계적으로 추가하는 방법을 추천해요.
멀티 에이전트 협업이 개발자에게 미치는 영향 분석
개발자에게 미치는 영향
- 단일 에이전트부터 시작하세요: 먼저 단일 에이전트에 좋은 프롬프트를 적용해 기준선을 세우세요. 컨텍스트 오염, 하위 작업의 독립적인 병렬 처리, 전문화된 설정이 필요한 상황에서만 협업 계층을 추가하면 됩니다.
- 인프라를 핵심 요소로 다루세요: 모델 API, 도구 API, 예산 한도, 동시성 제어, 호출 로그가 멀티 에이전트 시스템의 안정적인 운영을 좌우합니다. 로그가 없으면 어떤 하위 에이전트가 같은 작업을 반복하는지 파악할 수 없습니다.
- 여러 모델을 역할별로 활용하는 방식이 보편화됩니다: 조정자, 실행자, 검토자가 서로 다른 모델을 사용하면 비용이 3~10배까지 늘어나는 상황을 억제할 수 있습니다.
업계에 미치는 영향
- AI의 역량 범위가 확장되고 있습니다: “프로그래밍 작업 하나를 완료하는 것”에서 “장기적인 소프트웨어 엔지니어링 프로젝트를 조직하는 것”으로 나아가고 있습니다. Vercel, Shopify, Datadog 등 초기 테스트 파트너들의 피드백도 이를 뒷받침합니다. 예를 들어 Datadog의 한 엔지니어는 이를 더 빠른 모델에 작업을 맡기는 “사고 지휘관”에 비유했습니다. 다만 이는 출시 당시 공개된 파트너들의 피드백이며, 독립적인 블라인드 테스트 결과는 아닙니다.
- 에이전트 수보다 오케스트레이션 역량이 중요합니다: 작업의 병렬 처리 가능성, 조정 비용, 공유 상태, 코드 충돌, 테스트 커버리지, 호출 비용이 모두 멀티 에이전트의 실제 효율성을 좌우합니다.
자주 묻는 질문 FAQ
Q1: Claude Fable 5.2의 에이전트 1,000개 실험은 어떤 결과를 냈나요?
Anthropic에 따르면 Fable 5.2는 빈 폴더에서 시작해 하위 에이전트 1,000개 이상을 조율하며 8일 연속 작업했고, 실제 노트북에서 부팅할 수 있는 운영체제 프로토타입을 만들었어요. 여기에는 커널, 드라이버, 파일 저장소, 윈도우 시스템, 로그인 화면, 설치 프로그램이 포함돼요. 공식적으로는 “작동하는 프로토타입”이라고 소개됐으며, 소스 코드와 코드 규모, 총 토큰 수, 비용은 공개되지 않았고 제3자 감사도 없었어요.
Q2: 멀티 에이전트가 단일 에이전트보다 항상 나은가요?
그렇지는 않아요. Anthropic은 멀티 에이전트가 단일 에이전트보다 항상 뛰어난 것은 아니라고 분명히 밝혔어요. 몇 달 동안 멀티 에이전트 시스템을 구축한 팀이 단일 에이전트의 프롬프트만 최적화해도 비슷한 성과를 얻을 수 있다는 사실을 발견한 사례도 있어요. 같은 작업에서 멀티 에이전트는 일반적으로 단일 에이전트보다 토큰을 3~10배 더 사용해요. 컨텍스트 격리, 병렬 처리, 전문화된 역할 분담이라는 세 가지 상황에서만 비교적 안정적인 이점을 얻을 수 있어요.
Q3: 90.2% 향상과 토큰 15배 수치를 Fable 5.2 평가에 사용할 수 있나요?
아니요. 이 두 수치는 2025년 6월에 공개된 Anthropic Research 시스템에서 나온 거예요. 90.2%는 특정 내부 Research Eval에서 단일 에이전트 Opus 4와 비교한 성능이고, 토큰 15배는 일반 채팅을 기준으로 한 수치예요. 2026년 Fable 5.2의 운영체제 실험과는 관련이 없으며, “같은 작업에서 3~10배”라는 수치와 혼용해서도 안 돼요.
Q4: API로 나만의 멀티 에이전트 프로토타입을 빠르게 만들려면 어떻게 해야 하나요?
다음 순서로 진행하는 것을 권장해요.
1. APIYI apiyi.com에 가입해 API 키와 무료 테스트 크레딧을 받으세요.
2. 이 글의 코드에서 `base_url`을 `https://api.apiyi.com/v1`로 설정하세요.
3. 먼저 단일 에이전트 기준선을 실행하고 토큰 사용량과 성공률을 기록하세요.
4. 그런 다음 조정자와 하위 에이전트에 서로 다른 모델을 배정하고 비용과 품질 변화를 비교하세요.
Q5: 멀티 에이전트 비용은 어떻게 관리하나요?
핵심은 네 가지예요. 컨텍스트 경계에 맞춰 작업을 나눠 정보 전달을 줄이세요. 하위 작업에는 더 빠르고 저렴한 모델을 사용하고, 계획 수립과 주요 검토에만 강력한 모델을 사용하세요. 도구 설명에 위임 비용과 위임할 가치가 없는 작업을 명시해 과도한 위임을 막으세요. 전체 토큰 예산과 동시 실행 한도를 설정하세요. 오프라인 일괄 작업에는 Batch API 할인을 고려할 수 있고, 일상적인 호출은 APIYI apiyi.com의 종량제와 사용량 통계를 활용해 세밀하게 관리할 수 있어요.
Q6: 멀티 에이전트 시스템에는 현재 어떤 한계가 있나요?
첫째는 비용이에요. 같은 작업에서도 토큰 사용량이 보통 3~10배로 늘어나요. 둘째는 조정 한도예요. 공개된 Managed Agents에서는 직접 하위 스레드를 최대 25개까지 만들 수 있고, Workflow에서는 작업 스레드 64개가 동시에 작동하며, 전체 수명 주기 동안 최대 1,000개를 시작할 수 있어요. 셋째는 검증 문제예요. 검토 에이전트가 있다고 해서 실제 테스트를 대신할 수는 없어요. 넷째는 규칙이 쌓이거나 오랫동안 피드백이 없는 등의 사용성 문제예요. 규칙을 정기적으로 정리하고 진행 상황 업데이트를 켜 두는 것이 좋아요.
Claude Fable 5.2 멀티 에이전트 협업 핵심 요점
- 에이전트 수가 많다고 효율이 높아지는 건 아니에요: 에이전트 1,000개의 가치는 숫자 자체가 아니라 조직 능력에 있어요.
- 역할을 명확히 나누세요: Orchestrator는 조율하고, Subagent는 실행하며, Advisor는 조언하고, Workflow는 절차를 관리해요.
- 컨텍스트 경계에 따라 나누세요: 하나의 에이전트가 모듈 전체와 테스트를 맡도록 하세요. 역할별로 나눠 서로 전달하게 하면 정보가 왜곡될 수 있어요.
- 비용을 꼼꼼히 계산하세요: 같은 작업을 멀티 에이전트로 수행하면 보통 단일 에이전트보다 Token이 3~10배 더 들어요.
- 검증을 실제로 수행하세요: 검토 에이전트만 둘 게 아니라, 인수 기준과 실제 테스트도 마련해야 해요.
- 단일 에이전트부터 시작하세요: 실제 병목이 생겼을 때 협업 계층을 추가하세요. APIYI apiyi.com을 통해 여러 모델을 연결해 단계별로 테스트할 수 있어요.
정리
Claude Fable 5.2의 운영 체제 실험에서 얻을 수 있는 시사점은 다음과 같아요.
- 오케스트레이션 능력이 새로운 기준이에요: Fable 5.2의 발전은 조율자 역할을 더 잘 수행한다는 데 있어요. 높은 Effort 설정에서 자신의 작업을 검토하도록 하위 에이전트를 능동적으로 호출하기도 해요.
- 멀티 에이전트에는 분명한 적용 범위가 있어요: 컨텍스트 격리, 병렬 처리, 전문화된 역할 분담은 나눌 가치가 있지만, 긴밀하게 결합된 작업이나 간단한 질의는 나눌 필요가 없어요.
- 비용, 동시성, 검증은 세 가지 핵심 제약이에요: Token 사용량 증가, 스케줄링 한도, 실제 테스트 여부가 시스템을 장기간 운영할 수 있는지를 결정해요.
대부분의 개발자에게 적합한 방법은 단일 에이전트로 기준선을 마련한 뒤, 실제 병목에 따라 Subagent, Workflow 또는 Advisor를 도입하는 거예요. 동시에 모델 API, 예산, 동시성, 로그도 탄탄하게 준비해야 해요. 멀티 에이전트 애플리케이션의 진짜 기반은 API 인프라예요.
APIYI apiyi.com을 통해 멀티 에이전트 구성을 빠르게 검증해 보세요. 플랫폼은 OpenAI 호환 통합 인터페이스와 신규 사용자 무료 테스트 한도를 제공해, 서로 다른 모델의 역할 분담을 비교하기 편리해요.
📚 참고 자료
- Anthropic 공식 발표: Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- 링크:
anthropic.com/claude-fable-and-mythos-5-2 -
설명: 운영체제 실험, 프로그래밍 평가, 가격에 관한 1차 출처
-
Building multi-agent systems: When and how to use them: 멀티 에이전트의 적합한 활용 사례와 비용(2026-01-23)
- 링크:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
설명: 토큰 사용량이 3~10배 늘어난다는 데이터와 컨텍스트 경계에 따라 분리하는 원칙
-
How we built our multi-agent research system: Anthropic 리서치 시스템(2025-06-13)
- 링크:
anthropic.com/research/multi-agent-research-system -
설명: Orchestrator-Worker 아키텍처, 내부 평가에서 90.2%를 기록한 결과, 토큰 사용량이 15배 늘어난다는 데이터
-
Managed Agents 멀티 에이전트 오케스트레이션 및 Workflow 문서: 협업 방식과 실행 제한
- 링크:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
설명: Subagents, Dynamic Workflows, Advisor의 정의와 동시 실행 한도
-
Prompting Claude Fable 5.2: 공식 프롬프트 엔지니어링 가이드
- 링크:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
설명: 자체 검토 동작, 과도한 위임 실험, 진행 상황 안내 권장 사항
-
Fable 5.2 모델 사양 문서: 컨텍스트, 출력 한도, 요금
- 링크:
platform.claude.com/docs/en/models/fable-5-2/overview - 설명: 1M 컨텍스트, 최대 128K 출력, API Model ID
작성자: APIYI 기술팀
기술 문의: APIYI(apiyi.com) 홈페이지에서 문의해 주세요. 멀티 에이전트 아키텍처와 멀티 모델 연동 사례를 함께 나눌 수 있어요.


