
9 November 2026, Anthropic merilis Claude Fable 5.2 dan mengungkap sebuah eksperimen internal. Eksperimen ini dimulai dari folder kosong. Fable 5.2 mengoordinasikan lebih dari 1.000 Subagent yang bekerja selama 8 hari berturut-turut, hingga menghasilkan prototipe sistem operasi yang dapat dijalankan di laptop.
Nilai utama: Artikel ini tidak sekadar mengulang klaim promosi. Dengan merujuk pada materi rekayasa multi-Agent yang dipublikasikan Anthropic, artikel ini menjelaskan peran Orchestrator, Subagent, Advisor, dan Workflow; cara memecah tugas; alasan biaya bisa meningkat; serta cara merancang keandalan. Di bagian akhir, tersedia daftar praktik yang bisa langsung diterapkan oleh developer.
Ringkasan informasi utama eksperimen sistem operasi Claude Fable 5.2
Pertama, kita perlu memisahkan fakta yang sudah dikonfirmasi dari hal-hal yang belum diungkapkan. Ini penting untuk memahami tantangan dalam kolaborasi multi-Agent.
| Informasi | Detail |
|---|---|
| Tanggal rilis | 9 November 2026, diumumkan bersamaan dengan Claude Fable 5.2 |
| Pihak yang merilis | Anthropic |
| Titik awal eksperimen | Folder kosong, dengan tugas merancang dan membuat prototipe sistem operasi |
| Skala pelaksanaan | Lebih dari 1.000 Subagent bekerja selama 8 hari berturut-turut, siang dan malam, untuk menulis, menguji, meninjau, dan merevisi kode |
| Hasil akhir | Sistem prototipe yang mencakup kernel, driver disk/keyboard/jaringan, penyimpanan file permanen, sistem jendela, antarmuka login, installer, serta fitur Claude bawaan; sistem ini dapat dijalankan di laptop sungguhan |
| Informasi yang belum diungkapkan | Struktur pembagian tugas Agent, Harness, protokol komunikasi, jumlah baris kode, bahasa pemrograman, total konsumsi Token, biaya eksperimen, dan audit keamanan pihak ketiga |
Anthropic menyebutnya working prototype operating system, atau “prototipe sistem operasi yang berfungsi”. Ini bukan sistem operasi komersial yang matang. Perlu diperhatikan juga bahwa pada waktu yang sama, Anthropic mengungkap eksperimen lain, termasuk eksperimen terkait Teorema Terakhir Fermat yang menggunakan struktur “1 Lead + 999 Helper”. Namun, itu eksperimen terpisah dan strukturnya tidak bisa langsung diterapkan pada proyek sistem operasi ini.
Hal yang paling menarik dari eksperimen ini bukanlah jumlah kode yang ditulis, melainkan kemampuan model untuk mengatur proyek rekayasa perangkat lunak jangka panjang selama 8 hari: memecah tugas, mengerjakan beberapa bagian secara paralel, menggabungkan hasil, menemukan kesalahan, dan menjadwalkan perbaikannya. Inilah inti persoalan yang dibahas dalam artikel ini: di balik 1.000 Agent, tantangan sebenarnya adalah koordinasi.
Cara Kerja Kolaborasi Multi-Agent: Pembagian Peran di Balik Claude Fable 5.2
Sebelum membahas “perlukah menggunakan banyak Agent?”, kita perlu menjelaskan beberapa konsep yang mudah tertukar. Tabel berikut merangkum konsep-konsep tersebut berdasarkan dokumentasi Anthropic Managed Agents.
| Konsep | Tanggung jawab | Contoh umum |
|---|---|---|
| Agent | Entitas cerdas yang dapat menjalankan tugas dan menggunakan alat | Asisten pemrograman yang bisa membaca kode dan menjalankan pengujian |
| Orchestrator | Koordinator yang membagikan tugas dan menggabungkan hasil | Memecah tugas “buat sistem blog” menjadi beberapa modul, lalu merangkum hasilnya |
| Subagent | Agent yang menerima delegasi untuk menyelesaikan tugas turunan dengan konteks mandiri | Agent khusus yang mengimplementasikan modul komentar sekaligus menulis pengujiannya |
| Advisor | Tidak mengerjakan tugas secara langsung, tetapi memberi saran khusus pada titik penting | Meminta model yang lebih kuat memberikan solusi saat Agent utama mengalami kebuntuan |
| Workflow | Alur eksekusi yang mengatur urutan tugas, proses paralel, dan serah terima hasil | Proses bertahap “riset → implementasi → tinjauan → kerjakan ulang jika belum lolos” |
| Harness | Sistem luar yang memanggil model dan alat serta mengelola eksekusi | Kode orkestrasi yang kamu tulis sendiri atau platform Agent terkelola |
Tiga Pola Kolaborasi Multi-Agent
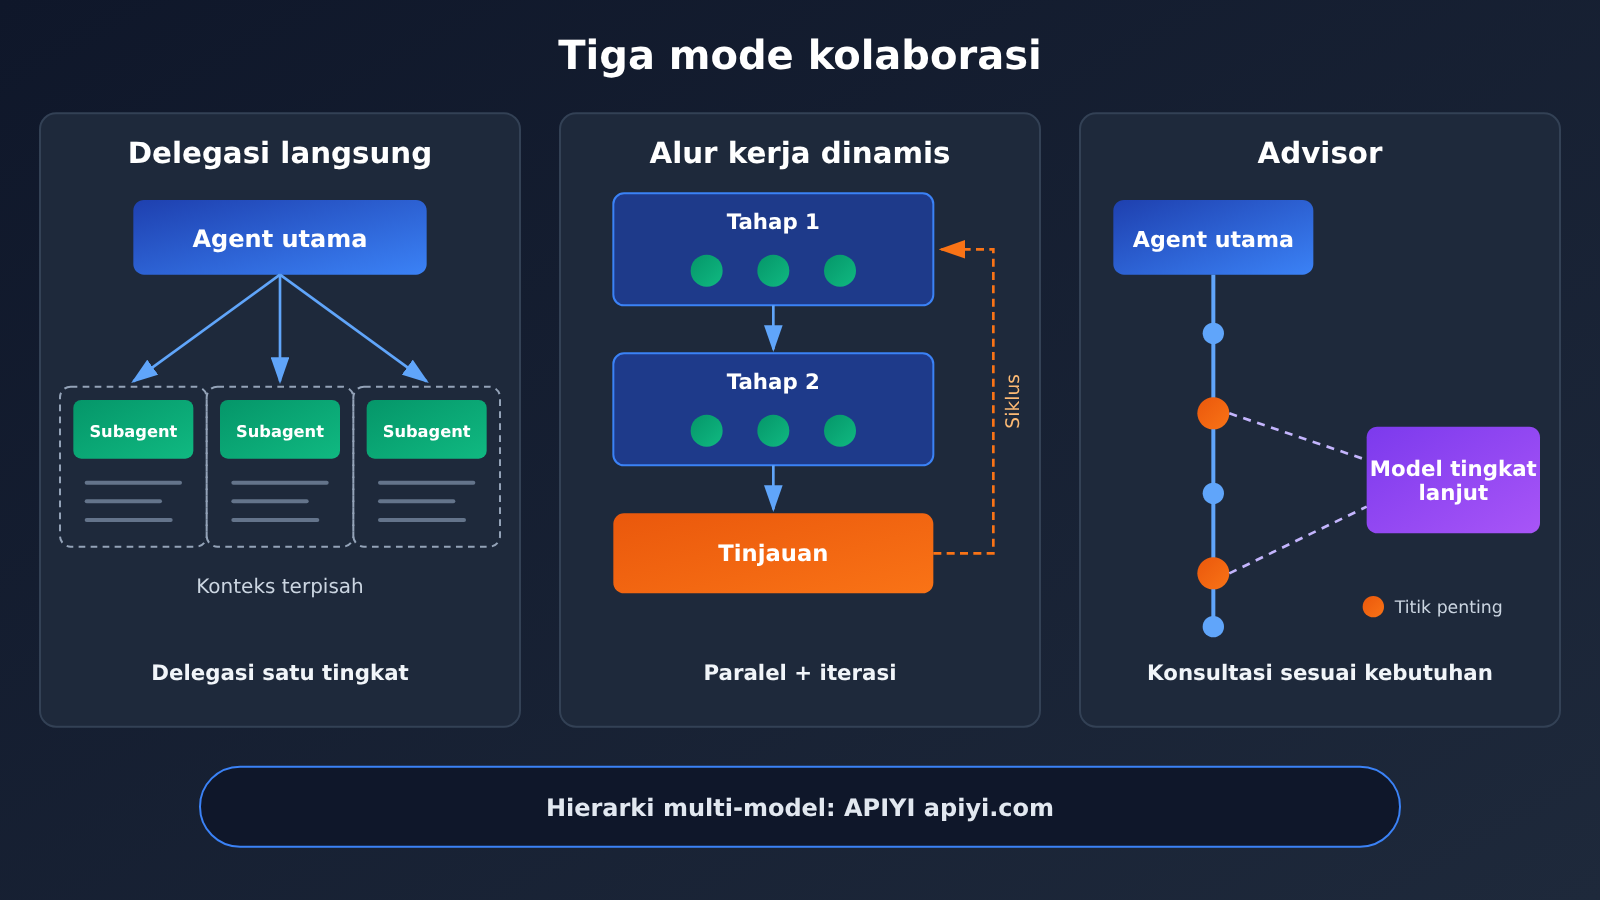
Dokumentasi Anthropic Managed Agents membagi kolaborasi Multi-Agent menjadi tiga pola, masing-masing dengan kegunaan yang berbeda.
- Delegasi langsung ke Subagent: Agent utama menentukan sendiri Subagent mana yang perlu dibuat, tugas apa yang diberikan, kapan hasilnya dibaca, dan apakah perlu meminta tindak lanjut. Setiap Subagent memiliki Session Thread sendiri, tetapi delegasi hanya berlangsung satu tingkat. Dalam satu Session, jumlah Subagent langsung dibatasi hingga 25. Pola ini cocok untuk sejumlah kecil tugas khusus yang perlu terus dipantau.
- Dynamic Workflows (alur kerja dinamis): Agent utama tidak lagi mengelola Subagent satu per satu, tetapi membuat program alur kerja. Program ini dapat membagi tugas ke beberapa tahap, menjalankan beberapa Agent secara paralel, meneruskan hasil, memilih tahap berikutnya berdasarkan hasil, dan mengulang proses jika hasil tinjauan belum lolos hingga mencapai batas jumlah putaran. Pola ini cocok untuk tugas seperti meninjau banyak file atau memigrasikan kode yang terdiri dari banyak modul.
- Advisor (mode penasihat): Agent utama tetap mengerjakan tugas secara langsung dan hanya berkonsultasi dengan model yang lebih kuat pada titik yang sulit atau penting. Keuntungannya, tugas tidak perlu dipecah-pecah sehingga biaya koordinasinya paling rendah.
Contoh konkret dapat membantu menjelaskan perbedaan ketiganya. Misalnya, kamu ingin memigrasikan sistem backend e-commerce dari Python ke Go. Jika hanya perlu memigrasikan modul pembayaran dan inventaris, delegasi langsung sudah cukup. Jika perlu memigrasikan 200 antarmuka independen dan meninjau setiap antarmuka satu per satu, alur kerja dinamis lebih cocok. Jika hanya ada satu Agent setingkat engineer yang mengerjakan tugas, tetapi sesekali perlu meminta model senior meninjau desain transaksi database, Advisor adalah pilihan paling efisien.
Kapan Perlu Menambahkan Agent: Cara yang Tepat Membagi Tugas Multi-Agent
Dalam artikel Building multi-agent systems: When and how to use them yang diterbitkan Anthropic pada 23 Januari 2026, disebutkan sebuah fenomena nyata: ada tim yang menghabiskan waktu berbulan-bulan untuk membangun sistem multi-Agent yang kompleks, tetapi akhirnya menyadari bahwa hasil serupa bisa dicapai hanya dengan menyempurnakan petunjuk untuk satu Agent. Jadi, pertanyaan pertama yang selalu perlu dijawab adalah “perlukah tugas ini dibagi?”, bukan “harus dibagi menjadi berapa bagian?”.
Tiga skenario saat multi-Agent benar-benar bermanfaat
Menurut artikel tersebut, ada tiga skenario utama saat multi-Agent dapat memberikan manfaat secara konsisten:
- Isolasi konteks: Misalnya, Agent layanan pelanggan membaca banyak riwayat pesanan sebelum mendiagnosis masalah teknis. Data pesanan dapat memenuhi jendela konteks dan mengganggu penilaian. Jika pencarian pesanan ditangani Agent terpisah dan hanya ringkasan yang diperlukan dikirimkan kembali, Agent utama dapat tetap fokus.
- Pemrosesan paralel: Meneliti pasar di berbagai wilayah, meninjau beberapa dokumen secara paralel, atau memeriksa modul kode yang berbeda secara bersamaan. Anthropic secara khusus menyebutkan bahwa nilai utama arsitektur ini sering kali terletak pada peningkatan cakupan dan kelengkapan tugas, bukan jaminan bahwa waktu pengerjaan total akan lebih singkat.
- Pembagian tugas berdasarkan spesialisasi: Setiap Agent dapat menggunakan System Prompt, alat, MCP Server, Skills, dan model yang berbeda. Dengan begitu, satu Agent tidak perlu menanggung terlalu banyak tanggung jawab sekaligus.
Membagi berdasarkan batas konteks, bukan berdasarkan peran
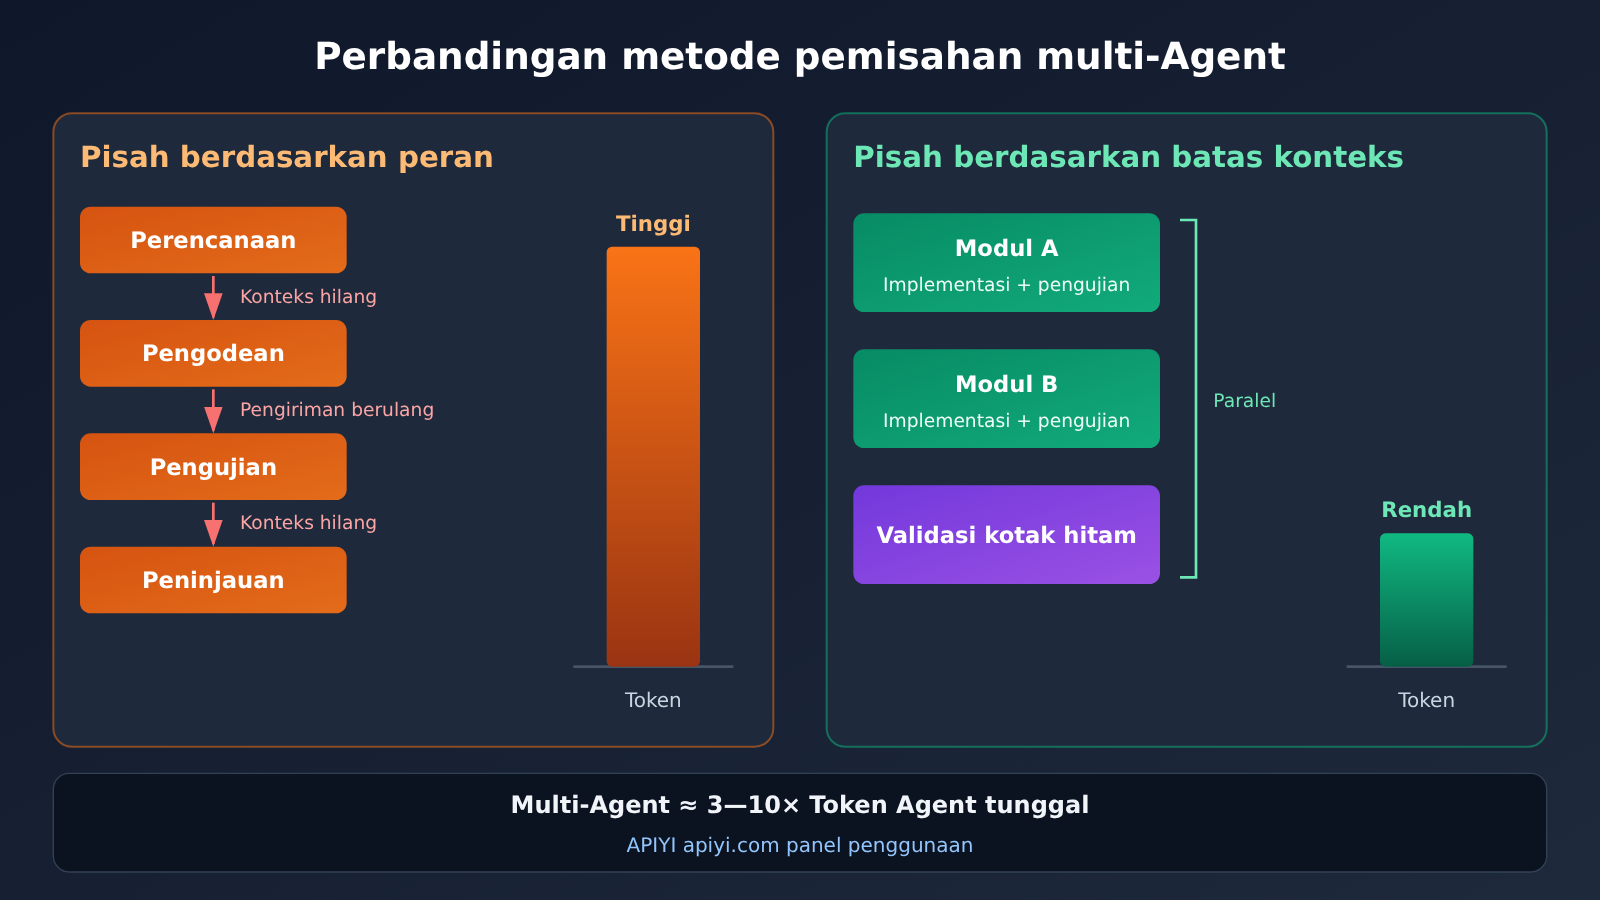
Prinsip desain yang diajukan Anthropic adalah Context-centric decomposition: membagi tugas berdasarkan batas konteks, bukan membaginya secara mekanis berdasarkan tahapan pekerjaan. Banyak tim pertama-tama berpikir untuk membuat “Agent perencana + Agent pengode + Agent penguji + Agent peninjau”. Sekilas, susunannya tampak seperti tim pengembangan dengan pembagian kerja yang jelas, tetapi dalam praktiknya ada banyak masalah.
Agent penguji tidak tahu alasan kode dirancang seperti itu, sedangkan Agent peninjau tidak memahami proses eksplorasi sebelumnya. Informasi harus diteruskan berulang kali antar-Agent sehingga rentan mengalami distorsi seperti dalam permainan telepon. Cara yang lebih masuk akal adalah menugaskan satu Agent untuk menangani satu modul fitur secara utuh, termasuk implementasi dan pengujian terkait; Agent lain menangani modul yang memiliki antarmuka independen; dan Agent ketiga hanya melakukan verifikasi kotak hitam dengan menerima hasil yang perlu diverifikasi, kriteria penerimaan yang jelas, serta alat pengujian.
| Jenis tugas | Kesesuaian untuk multi-Agent | Alasan |
|---|---|---|
| Riset pasar independen di berbagai wilayah | Tinggi | Hampir tidak ada informasi yang perlu dibagikan antar-subtugas |
| Peninjauan banyak dokumen secara paralel | Tinggi | Setiap dokumen dapat ditangani secara mandiri, lalu hasilnya dirangkum |
| Pengembangan modul yang berbeda secara mandiri | Tinggi | Jika antarmukanya jelas, batas konteks terbentuk secara alami |
| Pengujian dan verifikasi independen | Tinggi | Verifikasi kotak hitam hanya membutuhkan hasil dan kriteria |
| Perubahan kode yang saling berkaitan erat | Rendah | Perubahan di satu bagian dapat berdampak ke banyak bagian lain sehingga biaya serah terima tinggi |
| Tugas yang perlu berbagi banyak status secara real-time | Rendah | Biaya sinkronisasi status bisa melebihi manfaat pemrosesan paralel |
| Pencarian fakta sederhana | Biasanya tidak perlu | Satu kali pemanggilan oleh satu Agent sudah cukup |
Kembali ke eksperimen sistem operasi: kernel, driver, sistem berkas, dan sistem jendela memang memiliki batas modul yang relatif jelas. Inilah salah satu alasan eksperimen tersebut lebih cocok untuk dikerjakan secara paralel dalam skala besar daripada “refaktor besar-besaran pada satu sistem bisnis yang kompleks”. Tentu saja, Anthropic tidak mengungkapkan pembagian tugas secara spesifik. Jadi, hal ini hanya dapat dianggap sebagai dugaan yang masuk akal, bukan fakta.
Mengapa Biaya Multi-Agen Lebih Tinggi: Perhitungan Token di Era Claude Fable 5.2
Banyak orang beranggapan bahwa membagi tugas kepada lebih banyak Agen untuk dikerjakan secara paralel akan menekan biaya. Kenyataannya sering kali justru sebaliknya. Artikel Anthropic pada Januari 2026 menyatakan dengan jelas: untuk tugas yang sama, arsitektur multi-Agen biasanya menggunakan Token 3—10 kali lebih banyak daripada satu Agen.
Token tambahan terutama berasal dari lima hal: setiap Agen harus membangun konteksnya sendiri; para Agen perlu bertukar deskripsi tugas dan hasil; Agen utama harus membaca dan merangkum keluaran beberapa Agen bawahan; pemecahan tugas itu sendiri memerlukan pemanggilan tambahan; dan beberapa Agen mungkin mengerjakan bagian yang sama secara berulang.
Dua kelompok data biaya, dengan tolok ukur yang sama sekali berbeda
Saat membahas biaya multi-Agen, orang sering mencampur data dari sumber yang berbeda. Tabel berikut memisahkannya:
| Sumber data | Metrik | Tolok ukur |
|---|---|---|
| “Building multi-agent systems”, Januari 2026 | Konsumsi Token multi-Agen sebesar 3—10 kali konsumsi satu Agen | Satu Agen untuk tugas yang sama |
| Sistem Anthropic Research, Juni 2025 | Konsumsi Token sekitar 15 kali percakapan biasa | Percakapan biasa |
| Sistem Anthropic Research, Juni 2025 | Skor internal Research Eval 90.2% lebih tinggi daripada Opus 4 satu Agen | Opus 4 satu Agen, evaluasi internal tertentu |
| Sistem Anthropic Research, Juni 2025 | Waktu riset untuk kueri kompleks berkurang hingga sekitar 90%; pola paralel yang umum pada tahap awal melibatkan 3—5 Subagent | Riset satu jalur pada sistem yang sama |
Perlu ditegaskan bahwa angka 90.2% dan 15 kali sama-sama berasal dari sistem Research tahun 2025. Angka pertama hanya menunjukkan performa relatif pada evaluasi internal tertentu, bukan berarti akurasi semua tugas meningkat 90.2%. Angka-angka tersebut tidak berkaitan dengan eksperimen sistem operasi tahun 2026 dan juga tidak bisa dibandingkan langsung dengan angka 3—10 kali.
Total komputasi, waktu eksekusi, dan cakupan adalah tiga hal berbeda
Untuk memahami biaya multi-Agen, kita perlu membedakan tiga metrik. Total komputasi biasanya meningkat karena konteks disalin dan hasil dibaca berulang kali. Waktu eksekusi bisa lebih singkat, asalkan subtugas benar-benar independen. Cakupan tugas biasanya meningkat karena beberapa Agen dapat menjelajahi lebih banyak arah secara bersamaan.
Berdasarkan perkiraan harga resmi API, mode standar Fable 5.2 dikenai biaya 8 dolar per sejuta Token input dan 40 dolar per sejuta Token output. Batch API memberikan diskon 50%, sedangkan pembacaan cache dikenai biaya 0,20 dolar/MTok. Jika tugas satu Agen saja sudah mengonsumsi Token dalam jumlah besar, peningkatan menjadi 3—10 kali akan membuat selisih biayanya sangat terasa. Anthropic tidak memublikasikan tagihan aktual untuk eksperimen sistem operasi tersebut, jadi klaim tentang “berapa biaya selama 8 hari” tidak memiliki dasar.
Cara Merancang Sistem Multi-Agent yang Andal: Metode Rekayasa dari Claude Fable 5.2
Pembagian model: tidak semua Agent membutuhkan model terkuat
Managed Agents mendukung dua cara untuk mendefinisikan Agent. Predefined Agent dikonfigurasi sebelumnya dan dapat memiliki model, System Prompt, alat, MCP Server, serta Skills sendiri. Inline Agent didefinisikan secara dinamis saat dijalankan dan secara default mengikuti konfigurasi model dan alat Agent utama.
Artinya, Anda bisa membagi biaya dan kemampuan: gunakan model kuat seperti Fable 5.2 untuk koordinator dan peninjauan yang kompleks, model setingkat Sonnet untuk pencarian informasi biasa, dan model setingkat Haiku untuk klasifikasi sederhana. Ini hanya contoh desain, bukan arsitektur baku yang ditetapkan Anthropic. Sesuaikan melalui pengujian berdasarkan kebutuhan tugas yang sebenarnya.
Validasi: Agent peninjau bukan pengganti validasi nyata
Dalam dokumentasi Prompting untuk Fable 5.2, Anthropic menyebutkan perubahan baru: pada pengaturan Effort yang lebih tinggi, seperti xhigh dan max, Fable 5.2 akan secara proaktif memanggil Subagent untuk memeriksa hasil kerjanya sendiri. Fable 5.1 tidak menunjukkan perilaku ini pada tugas pengujian yang sama. Ini merupakan kemajuan dalam kemampuan orkestrasi, tetapi bukan jaminan kualitas.
Pada dasarnya, Agent peninjau tetap mengandalkan penilaian model. Validasi yang benar-benar andal membutuhkan tiga hal: kriteria penerimaan yang jelas, pengujian black-box yang bisa dijalankan, serta pemeriksaan nyata terhadap kode dan perubahan pada sistem eksternal—misalnya benar-benar menjalankan pengujian dan memulai layanan. Pelajaran paling meyakinkan dari eksperimen sistem operasi adalah hasil konkret bahwa sistem “bisa dimulai di laptop sungguhan”, bukan sekadar pernyataan Agent bahwa “sepertinya tidak ada masalah”.
Mencegah pendelegasian berlebihan dan penumpukan aturan
Keputusan Agent untuk mendelegasikan tugas tidak hanya bergantung pada kemampuan model, tetapi juga dipengaruhi oleh Harness dan deskripsi alat. Dalam pengujiannya, Anthropic menemukan bahwa ketika deskripsi alat Subagent menjelaskan “biaya tambahan untuk setiap Subagent, tugas mana yang layak atau tidak layak didelegasikan, serta cara menguraikan tugas”, frekuensi pendelegasian model untuk tugas singkat turun sekitar sepertiga dibandingkan versi yang hanya menekankan alasan untuk mendelegasikan. Tingkat keberhasilan tugas tetap sama.
Masalah lain yang mudah terlewat adalah penumpukan aturan. Fable 5.2 cukup ketat dalam mengikuti instruksi yang membatasi dan menumpuk di konteks. Jika file historis, masukan Reviewer, dan System Prompt terus menambahkan larangan, model bisa menjadi ragu menjalankan tindakan yang sebenarnya diizinkan dalam pekerjaan sehari-hari. Karena itu, memori, aturan, dan persyaratan persetujuan Agent perlu dibersihkan secara berkala.
Batas runtime: batas nyata pada produk publik
“1000 Agent” juga memiliki batas yang jelas dalam produk publik. Berikut batasan yang tercantum dalam dokumentasi Managed Agents. Batasan ini berlaku untuk produk publik dan tidak berarti eksperimen sistem operasi internal menggunakan penjadwal yang sama:
| Metrik | Batas |
|---|---|
| Thread anak Subagent langsung | Maksimal 25 |
| Thread kerja Dynamic Workflow secara bersamaan | 64 |
| Agent yang dimulai dalam satu siklus hidup Workflow | 1000 |
| Siklus hidup Workflow default | 24 jam |
| Workflow yang terbuka secara bersamaan per Session secara default | 10 |
Selain itu, Agent di dalam Workflow tidak dapat membuat Workflow bertingkat. Setelah anggaran tercapai, Workflow yang sedang berjalan akan dijeda. Jika sebuah Agent gagal, sistem biasanya akan mencoba sekali lagi; jika gagal lagi, Workflow akan menentukan cara menanganinya. Dengan kata lain, angka 1000 Agent berarti jumlah total Agent yang dimulai selama “siklus hidup”, bukan jumlah Agent yang berjalan secara bersamaan—jumlah yang benar-benar berjalan pada satu waktu jauh lebih sedikit.
Ada juga masalah pengalaman pengguna saat proses berjalan lama: selama pemanggilan alat yang berlangsung lama, Fable 5.2 mungkin hanya mengeluarkan sedikit teks untuk pengguna, sehingga mereka mengira tugasnya macet. Dokumentasi resmi menyarankan untuk mengaktifkan thinking.display: "updates" atau meminta Harness mengingatkan model agar melaporkan kemajuan setelah beberapa kali pemanggilan alat berturut-turut. Dalam pengujian resmi, pengingat kemajuan mengurangi durasi terlama tanpa kabar sekitar setengahnya.
Panduan Cepat Multi-Agent: Membuat Orkestrator Minimal dengan Claude Fable 5.2
Contoh berikut tidak bergantung pada platform terkelola apa pun. Dengan antarmuka yang kompatibel dengan OpenAI, kita akan menunjukkan langkah paling dasar: meminta model koordinator membagi tugas berdasarkan batas konteks.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka APIYI yang kompatibel dengan OpenAI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Gunakan nama yang tercantum di daftar model platform
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
Versi lengkapnya menambahkan pembagian model berdasarkan peran, eksekusi serentak, anggaran Token, satu kali percobaan ulang jika gagal, dan pemeriksaan black-box. Strukturnya mengikuti metode rekayasa yang dibahas sebelumnya:
Lihat kode lengkap contoh orkestrasi Multi-Agent
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Satu Key untuk memanggil berbagai model
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Model andal untuk koordinasi dan peninjauan
WORKER_MODEL = "your-fast-model"          # Model yang lebih cepat dan murah untuk sub-tugas, ganti sesuai kebutuhan
TOKEN_BUDGET = 200_000                     # Anggaran Token untuk seluruh tugas
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Setiap subagen hanya menerima konteks yang dibutuhkannya; jika gagal, coba sekali lagi
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Pemeriksaan black-box: hanya berikan hasil dan kriteria, tanpa proses eksplorasi
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Batasi eksekusi serentak
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Kode ini hanya menunjukkan strukturnya; proses peninjauan masih mengandalkan penilaian model. Di lingkungan produksi, review sebaiknya diganti atau dilengkapi dengan eksekusi pengujian nyata, misalnya menjalankan pengujian unit atau menyalakan layanan untuk memeriksa antarmuka.
🚀 Saran untuk mulai cepat: Kunci Multi-Agent adalah menggunakan model berbeda untuk peran yang berbeda, sekaligus bisa membandingkan konsumsi kapan saja. Sebaiknya gunakan APIYI apiyi.com untuk menghubungkan Claude, OpenAI, Gemini, dan model lainnya dengan satu kunci API. Jalankan dulu uji coba dasar Single-Agent menggunakan kuota gratis untuk pengguna baru, lalu tambahkan lapisan kolaborasi secara bertahap.
Analisis Dampak Kolaborasi Multi-Agen bagi Developer
Dampak bagi developer
- Mulai dari satu agen: Gunakan satu agen dengan petunjuk yang baik untuk menetapkan tolok ukur. Tambahkan lapisan kolaborasi hanya jika muncul salah satu dari tiga kendala berikut: konteks tercemar, subtugas dapat dikerjakan secara paralel dan mandiri, atau diperlukan konfigurasi khusus.
- Perlakukan infrastruktur sebagai komponen utama: API model, API alat, batas anggaran, kontrol konkurensi, dan log pemanggilan menentukan apakah sistem multi-agen dapat berjalan dengan stabil. Tanpa log, kita tidak bisa mengetahui agen mana yang mengulangi pekerjaan.
- Pembagian tugas lintas model akan menjadi hal biasa: Menggunakan model yang berbeda untuk koordinator, pelaksana, dan peninjau merupakan salah satu cara utama untuk mengendalikan kenaikan biaya hingga 3–10 kali lipat.
Dampak bagi industri
- Batas kemampuan AI terus meluas: AI beranjak dari “menyelesaikan satu tugas pemrograman” menuju “mengelola proyek rekayasa perangkat lunak jangka panjang”. Masukan dari mitra uji awal seperti Vercel, Shopify, dan Datadog juga mengarah ke hal ini. Misalnya, seorang engineer Datadog menggambarkannya sebagai “komandan insiden” yang dapat membagikan tugas kepada model yang lebih cepat. Perlu diingat, masukan ini berasal dari mitra yang diumumkan saat peluncuran, bukan dari uji buta independen.
- Kemampuan orkestrasi lebih penting daripada jumlah agen: Tingkat paralelisme tugas, biaya koordinasi, status bersama, konflik kode, cakupan pengujian, dan biaya pemanggilan bersama-sama menentukan efisiensi nyata sistem multi-agen.
FAQ
Q1: Apa yang berhasil dicapai dalam eksperimen 1000 Agent Claude Fable 5.2?
Anthropic mengungkapkan bahwa Fable 5.2 memulai dari folder kosong dan mengoordinasikan lebih dari 1000 sub-Agent yang bekerja terus-menerus selama 8 hari. Hasilnya adalah prototipe sistem operasi yang bisa dijalankan di laptop sungguhan, lengkap dengan kernel, driver, penyimpanan file, sistem jendela, antarmuka login, dan installer. Anthropic menyebutnya sebagai “prototipe yang berfungsi”. Kode sumber, jumlah baris kode, total Token, dan biayanya tidak dipublikasikan, serta belum diaudit pihak ketiga.
Q2: Apakah multi-Agent pasti lebih baik daripada satu Agent?
Belum tentu. Anthropic secara jelas menyatakan bahwa multi-Agent tidak selalu lebih unggul daripada satu Agent. Ada tim yang menghabiskan waktu berbulan-bulan membangun sistem multi-Agent, tetapi akhirnya menemukan bahwa mengoptimalkan petunjuk untuk satu Agent memberikan hasil yang hampir sama. Untuk tugas yang sama, multi-Agent biasanya menggunakan Token 3—10 kali lebih banyak daripada satu Agent. Manfaatnya relatif konsisten hanya dalam tiga situasi: isolasi konteks, pemrosesan paralel, dan pembagian tugas berdasarkan spesialisasi.
Q3: Bisakah peningkatan 90.2% dan penggunaan Token 15 kali lipat digunakan untuk mengevaluasi Fable 5.2?
Tidak. Kedua angka tersebut berasal dari sistem Research Anthropic yang dirilis pada Juni 2025. Angka 90.2% mengacu pada performa dalam Research Eval internal tertentu dibandingkan dengan satu Agent Opus 4, sedangkan pembanding untuk penggunaan Token 15 kali lipat adalah obrolan biasa. Angka-angka ini tidak berkaitan dengan eksperimen sistem operasi Fable 5.2 pada 2026 dan tidak boleh dicampur dengan data “3—10 kali untuk tugas yang sama”.
Q4: Bagaimana cara cepat membuat prototipe multi-Agent sendiri melalui API?
Ikuti langkah-langkah berikut:
1. Daftar di APIYI apiyi.com untuk mendapatkan kunci API dan kuota uji coba gratis.
2. Atur `base_url` dalam kode artikel ini menjadi `https://api.apiyi.com/v1`.
3. Jalankan pengujian dasar dengan satu Agent terlebih dahulu, lalu catat penggunaan Token dan tingkat keberhasilannya.
4. Setelah itu, berikan model yang berbeda kepada koordinator dan sub-Agent, lalu bandingkan perubahan biaya dan kualitas.
Q5: Bagaimana cara mengendalikan biaya multi-Agent?
Ada empat hal utama: bagi tugas berdasarkan batas konteks untuk mengurangi pertukaran informasi; gunakan model yang lebih cepat dan murah untuk sub-tugas, lalu gunakan model yang lebih kuat hanya untuk perencanaan dan peninjauan penting; jelaskan biaya delegasi dan tugas yang tidak layak didelegasikan dalam petunjuk alat agar tidak terjadi delegasi berlebihan; dan tetapkan anggaran Token global serta batas konkurensi. Untuk tugas batch offline, pertimbangkan diskon Batch API. Untuk pemanggilan sehari-hari, Anda juga bisa memanfaatkan penagihan sesuai pemakaian dan statistik penggunaan dari APIYI apiyi.com agar biaya dapat dihitung dengan lebih terperinci.
Q6: Apa saja keterbatasan sistem multi-Agent yang diketahui saat ini?
Pertama, biaya: penggunaan Token untuk tugas yang sama biasanya meningkat 3—10 kali lipat. Kedua, batas penjadwalan: pada Managed Agents yang dipublikasikan, jumlah maksimum thread turunan langsung adalah 25, sedangkan Workflow dapat menjalankan 64 thread kerja secara bersamaan dan memulai total hingga 1000 thread selama siklus hidupnya. Ketiga, validasi: Agent peninjau tidak sama dengan pengujian sungguhan. Keempat, penumpukan aturan dan tidak adanya umpan balik dalam waktu lama dapat mengganggu pengalaman penggunaan. Aturan perlu dibersihkan secara berkala dan pembaruan progres sebaiknya diaktifkan.
Poin Penting Kolaborasi Multi-Agent Claude Fable 5.2
- Jumlah bukan berarti efisiensi: Nilai 1.000 Agent terletak pada kemampuan mengorganisasikannya, bukan pada jumlahnya.
- Peran harus jelas: Orchestrator bertugas mengoordinasikan, Subagent mengeksekusi, Advisor memberi saran, dan Workflow mengatur alur kerja.
- Bagi tugas berdasarkan batas konteks: Satu Agent bertanggung jawab atas satu modul secara utuh, termasuk pengujiannya. Hindari meneruskan pesan berdasarkan peran karena informasi bisa berubah.
- Hitung biayanya dengan cermat: Untuk tugas yang sama, penggunaan banyak Agent biasanya menghabiskan Token 3–10 kali lebih banyak daripada satu Agent.
- Pastikan validasi benar-benar dilakukan: Selain Agent peninjau, harus ada kriteria penerimaan dan pengujian nyata.
- Mulai dari satu Agent: Tambahkan lapisan kolaborasi setelah menemukan hambatan yang nyata. Pengujian bertahap bisa dilakukan dengan mengakses beberapa model melalui APIYI apiyi.com.
Kesimpulan
Eksperimen sistem operasi Claude Fable 5.2 memberikan beberapa pelajaran:
- Kemampuan orkestrasi menjadi standar baru: Kemajuan Fable 5.2 terlihat dari kemampuannya menjalankan peran koordinator dengan lebih baik, termasuk memanggil sub-Agent secara proaktif untuk meninjau pekerjaannya sendiri saat menggunakan Effort tinggi.
- Multi-Agent memiliki batas penggunaan yang jelas: Tugas yang membutuhkan isolasi konteks, pemrosesan paralel, dan pembagian kerja spesialis layak dipecah. Tugas yang sangat saling bergantung dan pertanyaan sederhana tidak perlu dipecah.
- Biaya, konkurensi, dan validasi adalah tiga batasan utama: Penggunaan Token yang meningkat, batas penjadwalan, dan pengujian nyata menentukan apakah sistem bisa terus berjalan dalam jangka panjang.
Bagi kebanyakan developer, langkah yang tepat adalah menetapkan tolok ukur menggunakan satu Agent terlebih dahulu, lalu menambahkan Subagent, Workflow, atau Advisor berdasarkan hambatan yang benar-benar ditemukan. Pastikan juga API model, anggaran, konkurensi, dan pencatatan log ditangani dengan baik. Infrastruktur API adalah fondasi sebenarnya bagi aplikasi Multi-Agent.
Coba validasi solusi Multi-Agent Anda dengan cepat melalui APIYI apiyi.com. Platform ini menyediakan antarmuka terpadu yang kompatibel dengan OpenAI serta kuota uji coba gratis untuk pengguna baru, sehingga pembagian tugas di antara model yang berbeda bisa dibandingkan dengan mudah.
📚 Referensi
- Pengumuman resmi Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Tautan:
anthropic.com/claude-fable-and-mythos-5-2 -
Keterangan: Sumber utama tentang eksperimen sistem operasi, evaluasi pemrograman, dan harga
-
Building multi-agent systems: When and how to use them: Situasi yang cocok untuk multi-agen dan biayanya (2026-01-23)
- Tautan:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
Keterangan: Data penggunaan Token 3–10 kali lipat dan prinsip pemisahan berdasarkan batas konteks
-
How we built our multi-agent research system: Sistem riset Anthropic (2025-06-13)
- Tautan:
anthropic.com/research/multi-agent-research-system -
Keterangan: Arsitektur Orchestrator-Worker, hasil evaluasi internal 90,2%, dan data penggunaan Token hingga 15 kali lipat
-
Dokumentasi orkestrasi multi-agen dan Workflow Managed Agents: Pola kolaborasi dan batasan operasional
- Tautan:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Keterangan: Definisi Subagents, Dynamic Workflows, dan Advisor, serta batas maksimum konkurensi
-
Prompting Claude Fable 5.2: Panduan resmi rekayasa petunjuk
- Tautan:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Keterangan: Perilaku pemeriksaan mandiri, eksperimen delegasi berlebihan, dan saran umpan balik progres
-
Dokumentasi spesifikasi model Fable 5.2: Konteks, batas output, dan penagihan
- Tautan:
platform.claude.com/docs/en/models/fable-5-2/overview - Keterangan: Konteks 1M, output maksimum 128K, dan ID Model API
Penulis: Tim Teknis APIYI
Diskusi teknis: Kunjungi beranda APIYI di apiyi.com dan hubungi kami untuk berdiskusi tentang arsitektur multi-agen dan praktik integrasi multi-model.


