
في 9 نوفمبر 2026، أعلنت Anthropic عن Claude Fable 5.2، وكشفت عن تجربة داخلية. بدأت التجربة من مجلد فارغ، ونسّق Fable 5.2 عمل أكثر من 1000 وكيل فرعي على مدى 8 أيام متواصلة، لينتج في النهاية نموذجًا أوليًا لنظام تشغيل يمكن تشغيله على حاسوب محمول.
القيمة الأساسية: لا يعيد هذا المقال صياغة الدعاية، بل يستند إلى مواد Anthropic المنشورة عن هندسة الأنظمة متعددة الوكلاء، ليوضح أدوار المنسّق والوكيل الفرعي والمستشار وسير العمل، وكيفية تقسيم المهام، وأسباب ارتفاع التكلفة، وطرق تصميم الموثوقية. وفي الختام، يقدم قائمة عملية يمكن للمطورين تطبيقها مباشرة.
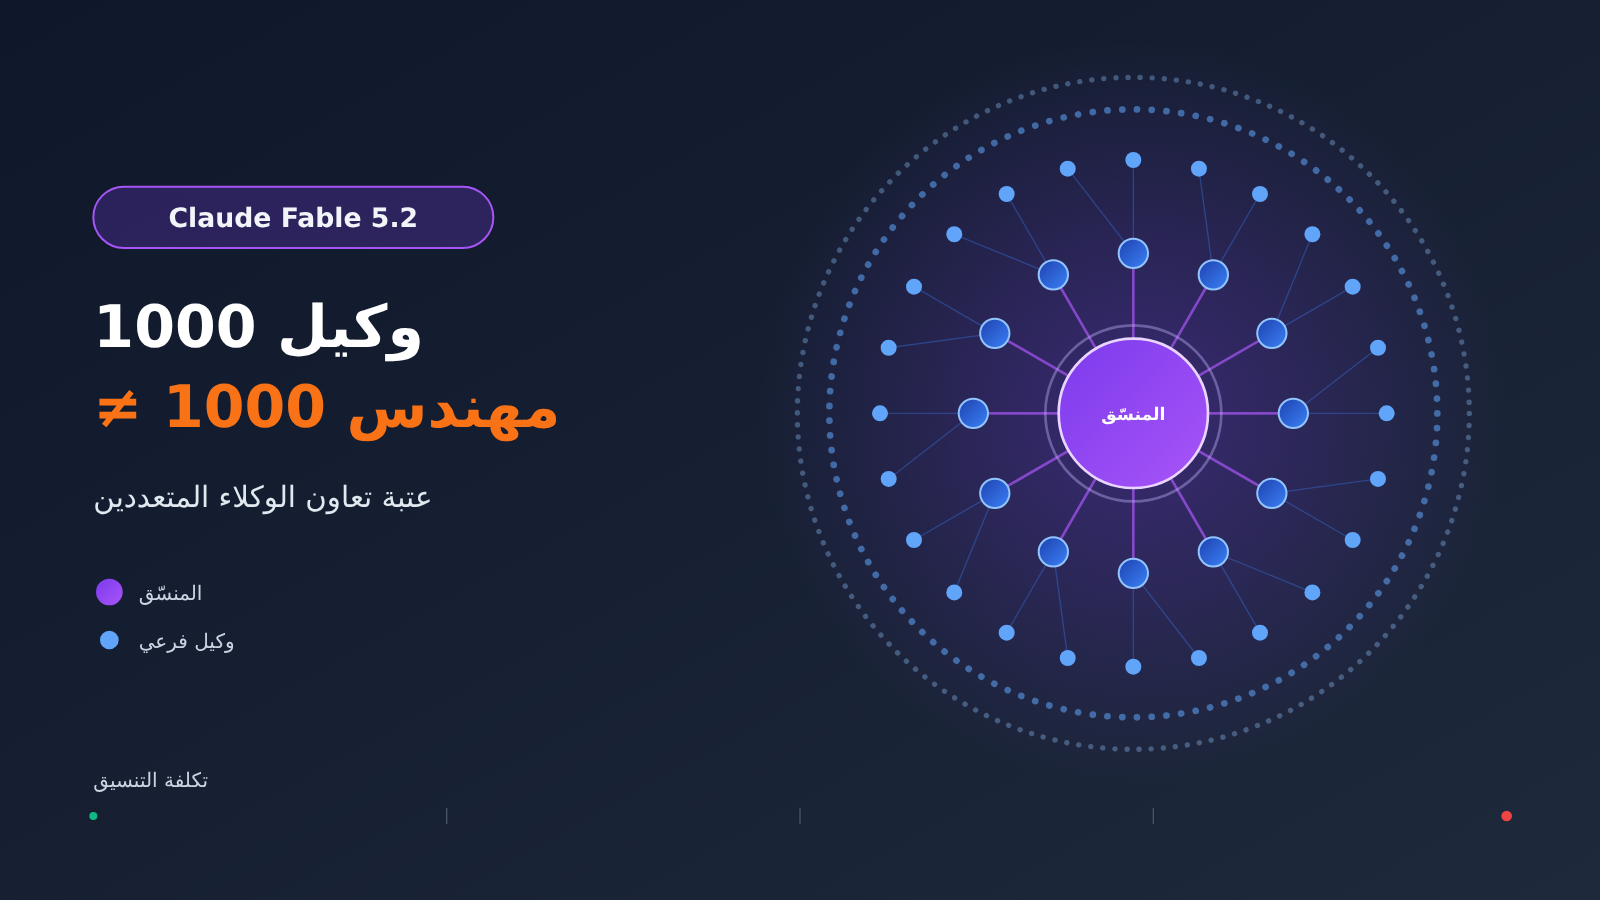
لمحة سريعة عن أبرز معلومات تجربة نظام التشغيل Claude Fable 5.2
لنبدأ بالفصل بين الحقائق المؤكدة والمعلومات التي لم يُكشف عنها بعد؛ فهذا شرط أساسي لفهم التحديات التي ينطوي عليها التعاون بين الوكلاء.
| البند | التفاصيل |
|---|---|
| تاريخ الإعلان | 9 نوفمبر 2026، بالتزامن مع الإعلان عن Claude Fable 5.2 |
| الجهة المعلنة | Anthropic |
| نقطة انطلاق التجربة | مجلد فارغ، والمهمة هي تصميم نموذج أولي لنظام تشغيل وتنفيذه |
| نطاق التنفيذ | أكثر من 1000 وكيل فرعي، عملوا على مدار 8 أيام متواصلة، على مدار الساعة، في كتابة الشيفرة البرمجية واختبارها ومراجعتها وتعديلها |
| الناتج النهائي | نظام أولي يضم نواة، وبرامج تشغيل للأقراص ولوحات المفاتيح والشبكات، وتخزينًا دائمًا للملفات، ونظام نوافذ، وواجهة تسجيل دخول، ومثبّتًا، وميزات Claude مدمجة. ويمكن تشغيله على حاسوب محمول فعلي |
| معلومات لم يُكشف عنها | هيكل توزيع المهام بين الوكلاء، وبيئة التشغيل (Harness)، وبروتوكول الاتصال، وحجم الشيفرة، ولغة البرمجة، وإجمالي استهلاك الرموز، وتكلفة التجربة، والتدقيق الأمني المستقل |
وصفت Anthropic الناتج بأنه working prototype operating system، أي «نموذج أولي لنظام تشغيل يعمل»، وليس نظام تشغيل تجاريًا ناضجًا. ومن المهم أيضًا الانتباه إلى أن Anthropic أجرت تجارب أخرى في الفترة نفسها؛ فعلى سبيل المثال، كشفت إحدى التجارب المرتبطة بمبرهنة فيرما الأخيرة عن هيكل يتكوّن من «قائد واحد + 999 مساعدًا». لكن تلك تجربة مستقلة، ولا يمكن افتراض انطباق هيكلها على مشروع نظام التشغيل.
لا تكمن أهمية هذه التجربة في حجم الشيفرة المكتوبة، بل في قدرة النموذج على تنظيم مشروع هندسي برمجي طويل الأمد على مدى 8 أيام: تقسيم المهام، ومتابعة العمل بالتوازي، وتجميع النتائج، واكتشاف الأخطاء، وتكليف الوكلاء بإصلاحها. وهذا يقودنا إلى السؤال المحوري في هذا المقال: التحدي الأكبر وراء 1000 وكيل هو التنظيم.
كيف يعمل التعاون بين الوكلاء المتعددين: توزيع الأدوار وراء Claude Fable 5.2
قبل أن نناقش «هل نحتاج إلى عدة وكلاء؟»، من المهم توضيح بعض المفاهيم التي يسهل الخلط بينها. يلخّص الجدول التالي هذه المفاهيم وفقًا لما ورد في وثائق Anthropic Managed Agents.
| المفهوم | المسؤولية | مثال شائع |
|---|---|---|
| الوكيل (Agent) | وكيل ذكي قادر على تنفيذ المهام واستخدام الأدوات | مساعد برمجي يستطيع قراءة الشيفرة وتشغيل الاختبارات |
| المنسّق (Orchestrator) | توزيع المهام ودمج النتائج | تقسيم مهمة «إنشاء نظام للمدونات» إلى وحدات متعددة ثم جمع النتائج |
| الوكيل الفرعي (Subagent) | وكيل ذكي يتولى مهمة فرعية مفوّضة، ويعمل ضمن سياق مستقل | تنفيذ وحدة التعليقات وكتابة اختباراتها |
| المستشار (Advisor) | لا ينفّذ العمل بنفسه، بل يقدّم مشورة متخصصة في مراحل حاسمة | طلب حل من نموذج أقوى عندما يتعثر الوكيل الرئيسي |
| سير العمل (Workflow) | تنظيم ترتيب المهام وتنفيذها بالتوازي وتسليم النتائج | عملية متعددة المراحل: «بحث ← تنفيذ ← مراجعة ← إعادة العمل عند عدم القبول» |
| بيئة التشغيل (Harness) | النظام المحيط الذي يستدعي النماذج والأدوات ويدير التنفيذ | شيفرة التنسيق التي تكتبها بنفسك أو منصة وكلاء مُدارة |
ثلاثة أنماط للتعاون بين الوكلاء
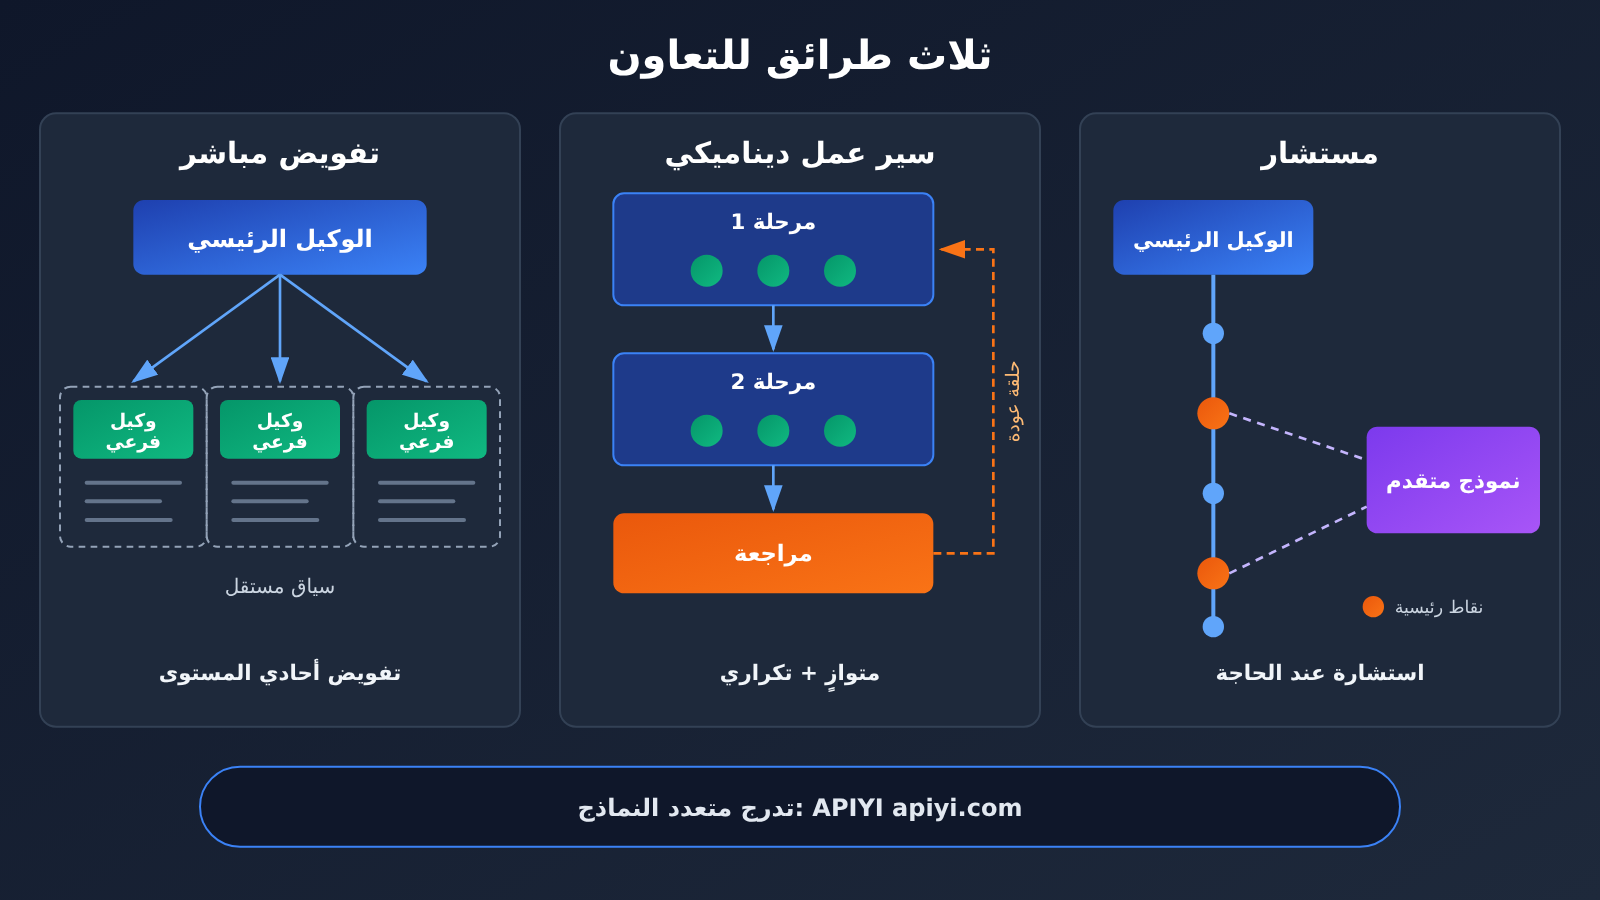
تقسّم وثائق Managed Agents من Anthropic التعاون بين عدة وكلاء إلى ثلاثة أنماط، لكل منها حالات استخدام مختلفة.
- التفويض المباشر إلى الوكلاء الفرعيين (Subagents): يقرر الوكيل الرئيسي بنفسه الوكلاء الفرعيين الذين سينشئهم، والمهام التي سيوكلها إليهم، وموعد الاطلاع على النتائج، وما إذا كان سيطلب توضيحات إضافية. لكل وكيل فرعي سلسلة جلسة (Session Thread) مستقلة، لكن التفويض يقتصر على مستوى واحد، وبحد أقصى 25 سلسلة فرعية مباشرة لكل جلسة. يناسب هذا النمط عددًا قليلًا من المهام التخصصية التي تتطلب متابعة مستمرة.
- سير العمل الديناميكي (Dynamic Workflows): بدلًا من إدارة الوكلاء الفرعيين واحدًا تلو الآخر، ينشئ الوكيل الرئيسي برنامجًا لسير العمل. ويمكن للبرنامج تقسيم المهمة إلى مراحل، وتشغيل عدة وكلاء بالتوازي، وتمرير النتائج بينهم، واختيار المرحلة التالية بناءً على النتائج، وإعادة التنفيذ عند عدم اجتياز المراجعة حتى بلوغ الحد الأقصى لعدد الجولات. يناسب هذا النمط مهامًا مثل مراجعة أعداد كبيرة من الملفات أو ترحيل الشفرة عبر وحدات متعددة.
- نمط المستشار (Advisor): يظل الوكيل الرئيسي مسؤولًا عن التنفيذ، لكنه يستشير نموذجًا أقوى عند مواجهة نقاط صعبة أو حاسمة. ويمتاز هذا النمط بعدم الحاجة إلى تقسيم المهمة، مع أقل قدر من أعباء التنسيق.
يمكن فهم الفرق بين الأنماط الثلاثة من خلال مثال عملي. لنفترض أنك تريد ترحيل نظام خلفي لمتجر إلكتروني من Python إلى Go: يكفي التفويض المباشر إذا كان الترحيل يقتصر على وحدتي الدفع والمخزون؛ أما إذا كان المطلوب ترحيل 200 واجهة مستقلة ومراجعة كل منها على حدة، فسير العمل الديناميكي هو الأنسب؛ وإذا كان وكيل بمستوى مهندس ينفذ المهمة وحده، ولا يحتاج إلا إلى استشارة نموذج متقدم بين الحين والآخر لمراجعة تصميم معاملات قاعدة البيانات، فسيكون نمط Advisor الأكثر جدوى.
متى نضيف وكلاء: الطريقة الصحيحة لتقسيم المهام بين عدة وكلاء
في مقالته «بناء أنظمة متعددة الوكلاء: متى وكيف نستخدمها»، المنشورة في 23 يناير 2026، أشار فريق Anthropic إلى ظاهرة حقيقية: أمضت بعض الفرق أشهرًا في بناء أنظمة معقدة متعددة الوكلاء، ثم اكتشفت أن تحسين موجه وكيل واحد يحقق نتائج مشابهة. لذلك، ينبغي أن يكون السؤال الأول دائمًا: «هل نحتاج إلى تقسيم المهمة؟» لا «إلى كم وكيلًا نقسمها؟».
ثلاث حالات تحقق فيها الأنظمة متعددة الوكلاء قيمة حقيقية
بحسب المقال، هناك ثلاث حالات رئيسية تحقق فيها الأنظمة متعددة الوكلاء قيمة ملموسة باستمرار:
- عزل السياق: قد يطّلع وكيل خدمة العملاء، مثلًا، على سجل طويل لطلبات العميل قبل تشخيص مشكلة تقنية. عندها، تستهلك بيانات الطلبات مساحة من السياق وقد تؤثر في دقة الحكم. وإذا أوكلنا الاستعلام عن الطلبات إلى وكيل مستقل، لا يعيد سوى ملخص ضروري، فسيتمكن الوكيل الرئيسي من التركيز على المهمة.
- المعالجة المتوازية: مثل إجراء أبحاث حول أسواق مناطق مختلفة، أو مراجعة ملفات متعددة بالتوازي، أو فحص وحدات برمجية مختلفة في الوقت نفسه. وتشير Anthropic إلى أن القيمة الأساسية لهذا النوع من البنى تتمثل غالبًا في توسيع نطاق المهام وتحسين شموليتها، لا في ضمان تقليل الوقت الإجمالي.
- تقسيم العمل حسب التخصص: يمكن تهيئة كل وكيل بموجه نظام وأدوات وخادم MCP ومهارات ونموذج مختلف، لتجنب تحميل وكيل واحد مسؤوليات كثيرة ومتنوعة.
التقسيم بحسب حدود السياق، لا بحسب الأدوار
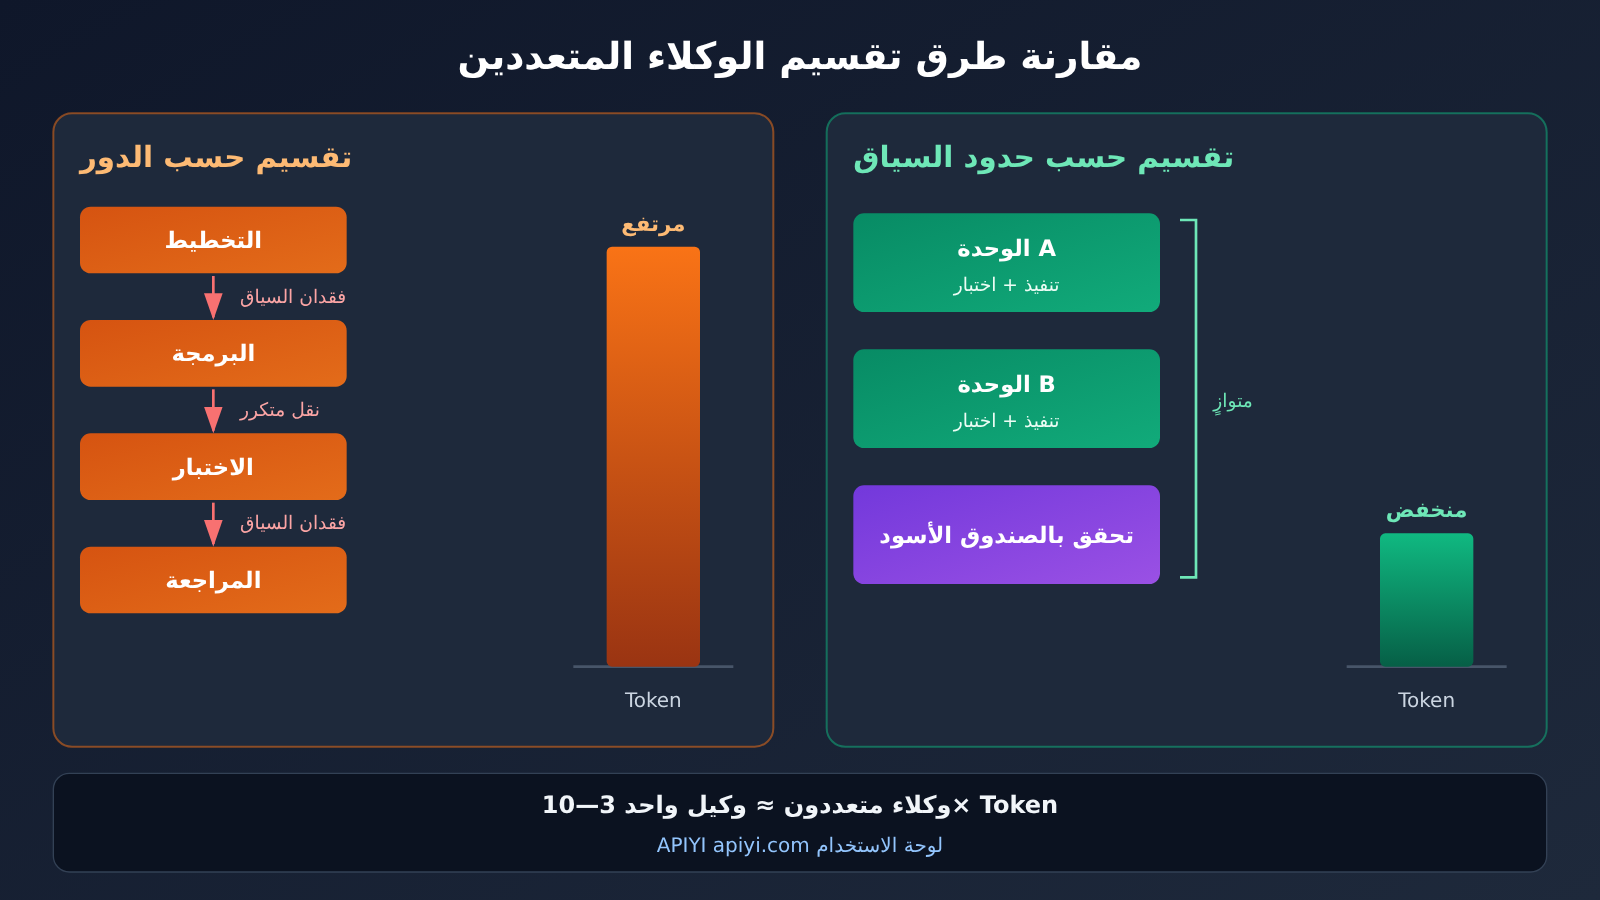
مبدأ التصميم الذي طرحته Anthropic هو التقسيم المتمحور حول السياق (Context-centric decomposition)، أي تقسيم العمل بحسب حدود السياق، لا بحسب مراحل المشكلة بطريقة آلية. وأول ما يتبادر إلى ذهن كثير من الفرق هو إنشاء «وكيل للتخطيط + وكيل للبرمجة + وكيل للاختبار + وكيل للمراجعة». قد يبدو ذلك كأنه فريق تطوير موزع بوضوح، لكنه يطرح مشكلات كبيرة في الواقع.
فوكيل الاختبار لا يعرف سبب تصميم الشفرة بهذه الطريقة، ووكيل المراجعة لا يفهم مسار الاستكشاف السابق. وهكذا تنتقل المعلومات مرارًا بين الوكلاء، ما يجعلها عرضة للتحريف، أشبه بلعبة «الهاتف». والأفضل أن يتولى وكيل واحد وحدة وظيفية كاملة، بما يشمل تنفيذها واختباراتها؛ ويتولى وكيل آخر وحدة ذات واجهة مستقلة؛ بينما يقتصر دور وكيل ثالث على التحقق بالصندوق الأسود، ويُزوَّد بالنتيجة المراد التحقق منها، ومعايير قبول واضحة، وأدوات للاختبار.
| نوع المهمة | مدى ملاءمتها لعدة وكلاء | السبب |
|---|---|---|
| أبحاث سوق مستقلة في مناطق متعددة | مرتفع | نادرًا ما تتبادل المهام الفرعية المعلومات |
| مراجعة عدد كبير من المستندات بالتوازي | مرتفع | يمكن معالجة كل مستند على حدة، ثم تجميع النتائج |
| تطوير وحدات مستقلة مختلفة | مرتفع | عند وضوح الواجهات، تكون حدود السياق موجودة بطبيعتها |
| الاختبار والتحقق المستقلان | مرتفع | لا يحتاج التحقق بالصندوق الأسود إلا إلى النتيجة والمعايير |
| تعديلات على شفرة مترابطة بشدة | أقل ملاءمة | قد يؤثر تعديل موضع واحد في مواضع كثيرة، ما يرفع تكلفة التسليم بين الوكلاء |
| مهام تتطلب مشاركة قدر كبير من الحالة الآنية | أقل ملاءمة | قد تتجاوز كلفة مزامنة الحالة مكاسب العمل المتوازي |
| الاستعلامات البسيطة عن الحقائق | لا حاجة عادةً | يستطيع وكيل واحد إنجازها باستدعاء واحد |
وبالعودة إلى تجارب أنظمة التشغيل، توجد بالفعل حدود واضحة نسبيًا بين النواة وبرامج التشغيل ونظام الملفات ونظام النوافذ. وهذا أحد الأسباب التي تجعلها أنسب للتوازي واسع النطاق من «إعادة هيكلة نظام أعمال معقد». وبالطبع، لم تكشف Anthropic عن طريقة توزيع العمل بالتحديد؛ لذا لا يمكن اعتبار ذلك سوى استنتاج معقول، لا حقيقة مؤكدة.
لماذا ترتفع تكلفة تعدد الوكلاء؟ حساب الرموز في عصر Claude Fable 5.2
يظن كثيرون intuitively أن توزيع المهمة على عدد أكبر من الوكلاء لمعالجتها بالتوازي يخفّض التكلفة. لكن الواقع غالبًا ما يكون عكس ذلك. فقد أشارت مقالة Anthropic الصادرة في يناير 2026 بوضوح إلى أن بنية تعدد الوكلاء تستهلك عادةً من 3 إلى 10 أضعاف عدد الرموز الذي يستهلكه وكيل واحد، عند تنفيذ المهمة نفسها.
تأتي الرموز الإضافية أساسًا من خمسة مصادر: يحتاج كل وكيل إلى إعداد سياقه الخاص؛ ويتبادل الوكلاء أوصاف المهام والنتائج؛ ويقرأ الوكيل الرئيسي مخرجات عدة وكلاء فرعيين ويلخّصها؛ كما أن تقسيم المهمة نفسه يتطلب استدعاءات إضافية؛ وقد يكرر عدة وكلاء العمل على الجزء نفسه.
مجموعتان من بيانات التكلفة، ولكل منهما معيار مقارنة مختلف
عند مناقشة تكلفة تعدد الوكلاء، يخلط البعض بين بيانات من مصادر مختلفة. يفصل الجدول التالي بينها:
| مصدر البيانات | المقياس | معيار المقارنة |
|---|---|---|
| «Building multi-agent systems»، يناير 2026 | استهلاك تعدد الوكلاء من الرموز يعادل 3 إلى 10 أضعاف استهلاك وكيل واحد | وكيل واحد ينفذ المهمة نفسها |
| نظام Anthropic Research، يونيو 2025 | استهلاك الرموز يعادل نحو 15 ضعفًا مقارنةً بالمحادثة العادية | محادثة عادية |
| نظام Anthropic Research، يونيو 2025 | نتيجة Research Eval الداخلية أعلى بنسبة 90.2% من نتيجة Opus 4 عند استخدام وكيل واحد | Opus 4 مع وكيل واحد، في تقييم داخلي محدد |
| نظام Anthropic Research، يونيو 2025 | تقليص وقت البحث في الاستعلامات المعقدة بنسبة تصل إلى نحو 90%، مع استخدام نموذجي مبكر من 3 إلى 5 وكلاء فرعيين بالتوازي | البحث بخيط تنفيذ واحد ضمن النظام نفسه |
من المهم التنبيه إلى أن رقمي 90.2% و15 ضعفًا يعودان كلاهما إلى نظام Research لعام 2025. فالرقم الأول يعبّر عن الأداء النسبي في تقييم داخلي محدد، ولا يعني أن الدقة تحسنت بنسبة 90.2% في جميع المهام. ولا يرتبط هذان الرقمان بتجارب نظام التشغيل لعام 2026، كما لا تجوز مقارنتهما مباشرةً بنسبة 3 إلى 10 أضعاف.
إجمالي الحوسبة ووقت التنفيذ ونطاق التغطية: ثلاثة أمور مختلفة
لفهم تكلفة تعدد الوكلاء، ينبغي التمييز بين ثلاثة مؤشرات. يزداد إجمالي الحوسبة عادةً بسبب نسخ السياق وإعادة قراءة النتائج مرارًا. وقد يقصر وقت التنفيذ، بشرط أن تكون المهام الفرعية مستقلة فعلًا. أما نطاق التغطية، فيتسع غالبًا لأن عدة وكلاء يستطيعون استكشاف مزيد من المسارات في الوقت نفسه.
بحسب الأسعار الرسمية لواجهة API، تبلغ تكلفة الإدخال في Fable 5.2 في الوضع العادي 8 دولارات لكل مليون Token، وتكلفة الإخراج 40 دولارًا لكل مليون Token. وتوفر Batch API خصمًا بنسبة 50%، بينما تبلغ تكلفة قراءة الذاكرة المؤقتة 0.20 دولار لكل MTok. إذا كانت المهمة التي ينفذها وكيل واحد تستهلك عددًا كبيرًا من Token أصلًا، فسيكون الفرق واضحًا جدًا عند زيادة الاستهلاك من 3 إلى 10 أضعاف. لم تنشر Anthropic الفاتورة الفعلية لتجربة نظام التشغيل، لذا لا يستند أي ادعاء عن «تكلفة 8 أيام» إلى معلومات موثوقة.
كيفية تصميم نظام موثوق متعدد الوكلاء: دروس هندسية مستفادة من Claude Fable 5.2
تقسيم النماذج إلى مستويات: ليس كل وكيل بحاجة إلى أقوى نموذج
تدعم Managed Agents طريقتين لتعريف الوكلاء. يمكن إعداد الوكيل المحدد مسبقًا (Predefined Agent) مسبقًا، مع نموذج وموجه نظام وأدوات وخادم MCP ومهارات خاصة به. أما الوكيل المضمّن (Inline Agent)، فيُعرَّف ديناميكيًا أثناء التنفيذ، ويستخدم افتراضيًا إعدادات النموذج والأدوات الخاصة بالوكيل الرئيسي.
يتيح ذلك توزيع المهام بحسب التكلفة والقدرات: استخدم نموذجًا قويًا مثل Fable 5.2 للمنسق ومهام المراجعة المعقدة، ونموذجًا بمستوى Sonnet للبحث العادي عن المعلومات، ونموذجًا بمستوى Haiku لمهام التصنيف البسيطة. هذا مجرد مثال على أحد أساليب التصميم، وليس بنية ثابتة تفرضها Anthropic؛ لذا اختبر الإعدادات وعدّلها وفقًا لمتطلبات مهامك الفعلية.
التحقق: مراجعة Agent لا تعني التحقق الفعلي
تشير Anthropic في وثائق Prompting الخاصة بـ Fable 5.2 إلى تغيير جديد: عند استخدام إعدادات Effort العالية مثل xhigh وmax، يستدعي Fable 5.2 تلقائيًا Subagent لمراجعة عمله، بينما لم يُظهر Fable 5.1 هذا السلوك في مهام الاختبار نفسها. هذا تطور في قدرات التنسيق، لكنه لا يُعد ضمانًا للجودة.
فمراجعة Agent تظل في جوهرها حكمًا يصدره نموذج. أما التحقق الموثوق فيتطلب ثلاثة أمور: معايير قبول واضحة، واختبارات فعلية يمكن تنفيذها، وفحصًا حقيقيًا للتغييرات التي أُجريت على الشفرة والأنظمة الخارجية (مثل تشغيل الاختبارات وبدء تشغيل الخدمة فعليًا). وأبرز ما يميز تجربة نظام التشغيل هو معيارها الحاسم: «إمكانية تشغيله على حاسوب محمول حقيقي»، لا مجرد قول أحد Agents إن «كل شيء يبدو سليمًا».
تجنّب الإفراط في التفويض وتراكم القواعد
لا يتوقف قرار Agent بتفويض المهام على قدرات النموذج وحدها، بل يتأثر أيضًا بـ Harness وتعليمات الأدوات. ووجدت اختبارات Anthropic أن توضيح تكلفة استخدام كل Subagent، والمهام التي تستحق التفويض وتلك التي لا تستحقه، وكيفية وصف المهمة، خفّض معدل التفويض في المهام القصيرة بنحو الثلث مقارنةً بنسخة تكتفي بالتأكيد على أسباب التفويض، مع بقاء معدل نجاح المهام دون تغيير.
ومن المشكلات التي يسهل إغفالها أيضًا تراكم القواعد. يلتزم Fable 5.2 بصرامة نسبية بالتعليمات التقييدية المتراكمة في السياق. فإذا ظلت الملفات السابقة وملاحظات Reviewer وموجه النظام تضيف محظورات جديدة، فقد يتردد النموذج في تنفيذ إجراءات مسموح بها أصلًا أثناء العمل اليومي. لذلك، ينبغي تنظيف ذاكرة Agent وقواعده ومتطلبات الموافقة بانتظام.
قيود وقت التشغيل: السقف الفعلي في المنتجات العامة
حتى عبارة «1000 وكيل» لها حدود واضحة في المنتجات العامة. يوضح الجدول أدناه القيود الواردة في وثائق Managed Agents. وهي تخص المنتجات العامة، ولا تعني أن تجارب أنظمة التشغيل الداخلية تستخدم أداة الجدولة نفسها:
| المقياس | الحد |
|---|---|
| سلاسل الوكلاء الفرعيين المباشرة (Subagent) | 25 كحد أقصى |
| سلاسل العمل المتزامنة في Dynamic Workflow | 64 |
| الوكلاء الذين يمكن تشغيلهم خلال دورة حياة Workflow واحد | 1000 |
| دورة الحياة الافتراضية لـ Workflow | 24 ساعة |
| عدد عمليات Workflow المفتوحة افتراضيًا في Session واحدة في الوقت نفسه | 10 |
إضافةً إلى ذلك، لا يستطيع الوكيل داخل Workflow إنشاء Workflow متداخل. وعند بلوغ الحد المخصص، يتوقف Workflow الجاري مؤقتًا. وإذا أخفق أحد الوكلاء، يعيد النظام المحاولة مرة واحدة عادةً؛ وإذا أخفق مجددًا، يقرر Workflow كيفية التعامل مع ذلك. بعبارة أخرى، يشير رقم 1000 وكيل إلى «إجمالي عدد الوكلاء الذين شُغّلوا خلال دورة الحياة»، وليس إلى عدد الوكلاء الذين يعملون فعليًا في اللحظة نفسها، وهو أقل بكثير.
وتظهر مشكلة أخرى في تجربة الاستخدام عند تشغيل المهام مدة طويلة: قد لا يُصدر Fable 5.2 سوى قدر قليل من النص الموجّه للمستخدم أثناء استدعاءات الأدوات الطويلة، ما قد يجعله يظن أن المهمة قد توقفت. توصي الوثائق الرسمية بتفعيل thinking.display: "updates"، أو بأن يطلب Harness من النموذج الإبلاغ عن التقدم بعد عدة استدعاءات متتالية للأدوات. وفي الاختبارات الرسمية، أدى تفعيل تذكيرات التقدم إلى تقليص أطول فترة متواصلة بلا تحديثات إلى النصف تقريبًا.
بداية سريعة مع وكلاء متعددين: إنشاء منسّق بسيط باستخدام Claude Fable 5.2
فيما يلي مثال لا يعتمد على أي منصة مُدارة، ويستخدم واجهة متوافقة مع OpenAI لعرض أبسط خطوة: جعل النموذج المنسّق يقسّم المهام وفق حدود السياق.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # واجهة APIYI المتوافقة مع OpenAI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # اعتمد الاسم الفعلي الظاهر في قائمة نماذج المنصة
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
يضيف الإصدار الكامل تقسيم النماذج، والتنفيذ المتوازي، وميزانية الرموز، وإعادة المحاولة مرة واحدة عند الفشل، والقبول بالصندوق الأسود. ويعكس تصميمه الأساليب الهندسية التي تناولناها سابقًا:
عرض الشفرة الكاملة لمثال تنسيق الوكلاء المتعددين
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # مفتاح واحد لاستدعاء نماذج من جهات متعددة
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # نموذج قوي للتنسيق والمراجعة
WORKER_MODEL = "your-fast-model"          # نموذج أسرع وأقل تكلفة للمهام الفرعية، استبدله حسب الحاجة
TOKEN_BUDGET = 200_000                     # ميزانية الرموز للمهمة كاملة
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # يحصل كل وكيل فرعي على السياق الذي يحتاج إليه فقط، وتُعاد المحاولة مرة واحدة عند الفشل
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # القبول بالصندوق الأسود: تُقدَّم النتيجة والمعايير فقط، من دون خطوات الاستكشاف
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # ضبط التنفيذ المتوازي
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
هذا المقطع يوضّح بنية العمل فحسب؛ فما زالت مرحلة المراجعة تعتمد على حكم النموذج. في بيئة الإنتاج، ينبغي استبدال review باختبارات فعلية أو إضافة هذه الاختبارات إليه، مثل تشغيل اختبارات الوحدات أو تشغيل الخدمة وفحص واجهاتها.
🚀 نصيحة للبدء السريع: يكمن سرّ التعاون بين الوكلاء في إسناد أدوار مختلفة إلى نماذج مختلفة، مع إمكانية مقارنة الاستهلاك في أي وقت. يُنصح باستخدام APIYI apiyi.com لربط نماذج مثل Claude وOpenAI وGemini بمفتاح API واحد. ابدأ بتجربة خط أساس لوكيل واحد باستخدام رصيد الاختبار المجاني للمستخدمين الجدد، ثم أضف طبقة التعاون تدريجيًا.
تحليل تأثير تعاون الوكلاء المتعددين في المطورين
التأثير في المطورين
- ابدأ بوكيل واحد: أنشئ خط أساس باستخدام وكيل واحد وموجه محسّن. لا تضف طبقة للتعاون إلا عند ظهور أحد هذه الاختناقات: تلوث السياق، أو إمكانية تنفيذ المهام الفرعية بشكل مستقل ومتوازٍ، أو الحاجة إلى إعدادات متخصصة.
- تعامل مع البنية التحتية بوصفها عنصرًا أساسيًا: تحدد واجهات API الخاصة بالنماذج والأدوات، وحدود الميزانية، والتحكم في التزامن، وسجلات الاستدعاءات، ما إذا كان نظام الوكلاء المتعددين قادرًا على العمل باستقرار. ومن دون السجلات، لن تتمكن من معرفة أي وكيل فرعي يكرر العمل.
- أصبح توزيع المهام بين نماذج متعددة أمرًا شائعًا: يُعد استخدام نماذج مختلفة للمنسّق والمنفّذ والمراجع من أبرز الوسائل للحد من تضخم التكلفة بمقدار يتراوح بين 3 و10 أضعاف.
التأثير في القطاع
- حدود قدرات الذكاء الاصطناعي آخذة في الاتساع: انتقل التركيز من «إنجاز مهمة برمجية واحدة» إلى «تنظيم مشروع هندسي برمجي طويل الأمد». وتشير ملاحظات شركاء الاختبار الأوائل، مثل Vercel وShopify وDatadog، إلى هذا التوجه أيضًا. فمثلًا، وصف مهندسو Datadog النظام بأنه «قائد حوادث» قادر على إسناد المهام إلى نماذج أسرع. لكن تجدر الإشارة إلى أن هذه الملاحظات صدرت عن شركاء عند إطلاق المنتج، وليست نتائج اختبارات عمياء مستقلة.
- قدرة التنسيق أهم من عدد الوكلاء: يتحدد الأداء الفعلي للوكلاء المتعددين بمجموع عوامل، منها مدى قابلية المهام للتنفيذ بالتوازي، وكلفة التنسيق، والحالة المشتركة، وتعارضات الشيفرة، وتغطية الاختبارات، وتكلفة الاستدعاءات.
الأسئلة الشائعة
س1: ما الذي أنجزته تجربة Claude Fable 5.2 التي شارك فيها 1000 وكيل؟
أفصحت Anthropic عن أن Fable 5.2 بدأ العمل من مجلد فارغ، ونسّق عمل أكثر من 1000 وكيل فرعي على مدار 8 أيام متواصلة، لينتج نموذجًا أوليًا لنظام تشغيل يمكن تشغيله على حاسوب محمول حقيقي. ويضم النموذج نواة النظام وبرامج تشغيل وتخزينًا للملفات ونظام نوافذ وشاشة تسجيل دخول ومثبّتًا. ووصفته الشركة بأنه «نموذج أولي يعمل»، لكنها لم تكشف عن الشفرة المصدرية أو حجم الشفرة أو إجمالي عدد الرموز أو التكلفة، كما لم يخضع لتدقيق من جهة خارجية.
س2: هل يتفوق تعدد الوكلاء دائمًا على الوكيل الواحد؟
ليس بالضرورة. توضح Anthropic أن تعدد الوكلاء لا يتفوق دائمًا على الوكيل الواحد؛ فقد أمضى بعض الفرق أشهرًا في بناء أنظمة متعددة الوكلاء، ثم اكتشفت أن تحسين موجه الوكيل الواحد يحقق نتيجة مقاربة. وعند تنفيذ المهمة نفسها، يستهلك تعدد الوكلاء عادةً من 3 إلى 10 أضعاف عدد الرموز مقارنةً بالوكيل الواحد. وتكون الفائدة أكثر ثباتًا في ثلاث حالات: عزل السياقات، والمعالجة المتوازية، وتقسيم العمل بحسب التخصص.
س3: هل يمكن استخدام تحسن بنسبة 90.2% واستهلاك 15 ضعفًا من الرموز لتقييم Fable 5.2؟
لا. هذان الرقمان وردا في نظام Research من Anthropic، الذي أُطلق في يونيو 2025: فالنسبة 90.2% تعكس أداءً في اختبار داخلي محدد باسم Research Eval مقارنةً بـ Opus 4 بوصفه وكيلًا واحدًا، أما المقارنة التي استند إليها رقم 15 ضعفًا فهي الدردشة العادية. ولا صلة لهذين الرقمين بتجربة نظام التشغيل Fable 5.2 في عام 2026، كما لا ينبغي الخلط بينهما وبين بيانات استهلاك 3 إلى 10 أضعاف في المهام المتطابقة.
س4: كيف أستخدم API لبناء نموذج أولي متعدد الوكلاء بسرعة؟
نوصي باتباع الخطوات التالية:
1. سجّل في APIYI عبر apiyi.com واحصل على مفتاح API ورصيد مجاني للاختبار.
2. اضبط قيمة `base_url` في الشفرة الواردة في هذا المقال على `https://api.apiyi.com/v1`
3. ابدأ بتشغيل خط أساس لوكيل واحد، وسجّل عدد الرموز ومعدل النجاح.
4. بعد ذلك، خصّص نماذج مختلفة للمنسّق والوكلاء الفرعيين، ثم قارن التكاليف وتغيّر جودة النتائج.
س5: كيف يمكن ضبط تكلفة نظام متعدد الوكلاء؟
هناك أربع نقاط أساسية: قسّم العمل وفق حدود السياق لتقليل تبادل المعلومات؛ واستخدم نماذج أسرع وأقل تكلفة للمهام الفرعية، مع الاستعانة بالنماذج الأقوى في التخطيط والمراجعة المهمة فقط؛ ووضّح في تعليمات الأدوات تكلفة التفويض والمهام التي لا تستحق التفويض، لتجنب الإفراط فيه؛ وحدّد ميزانية إجمالية للرموز وسقفًا للتنفيذ المتوازي. أما المهام المجمّعة التي تُنفّذ دون اتصال، فيمكن الاستفادة فيها من خصومات Batch API. ولضبط تكاليف الاستدعاءات اليومية بدقة، يمكن أيضًا الاستعانة بالفوترة حسب الاستخدام وإحصاءات الاستهلاك لدى APIYI عبر apiyi.com.
س6: ما القيود المعروفة لأنظمة تعدد الوكلاء حاليًا؟
أولًا، التكلفة: يستهلك تنفيذ المهمة نفسها عادةً عددًا من Tokens يزيد من 3 إلى 10 أضعاف. ثانيًا، حدود الجدولة: في خدمة Managed Agents العامة، الحد الأقصى لعدد العمليات الفرعية المباشرة هو 25، ولعدد سلاسل التنفيذ العاملة في الوقت نفسه ضمن Workflow هو 64، أما الحد الأقصى لإجمالي مرات التشغيل خلال دورة الحياة فهو 1000. ثالثًا، التحقق: وجود Agent للمراجعة لا يغني عن الاختبار الفعلي. رابعًا، مشكلات تجربة الاستخدام، مثل تراكم القواعد وطول فترات الانتظار بلا تحديثات؛ لذا ينبغي تنقيح القواعد دوريًا وتفعيل تحديثات التقدم.
النقاط الأساسية للتعاون بين عدة Agents في Claude Fable 5.2
- العدد لا يساوي الكفاءة: تكمن قيمة 1000 Agent في القدرة على تنظيمها، لا في العدد بحد ذاته.
- وضّح الأدوار: يتولى Orchestrator التنسيق، وينفّذ Subagent المهام، ويقدّم Advisor التوصيات، بينما يدير Workflow سير العمل.
- قسّم العمل وفق حدود السياق: خصّص Agent واحدًا لوحدة متكاملة تشمل الاختبارات، وتجنّب نقل الرسائل بين الأدوار بما قد يؤدي إلى تحريفها.
- احسب التكلفة بدقة: يتطلب تنفيذ المهمة نفسها باستخدام عدة Agents عادةً من 3 إلى 10 أضعاف عدد Tokens مقارنةً باستخدام Agent واحد.
- اجعل التحقق عمليًا: إلى جانب Agent المراجعة، لا بد من معايير قبول واختبارات فعلية.
- ابدأ بـ Agent واحد: أضف طبقة تعاون عند ظهور عنق زجاجة فعلي، ويمكنك إجراء اختبارات متعددة المستويات عبر إتاحة عدة نماذج من خلال APIYI apiyi.com.
الخلاصة
تكشف تجارب نظام التشغيل باستخدام Claude Fable 5.2 عن ثلاثة دروس:
- قدرة التنسيق هي المعيار الجديد: يتمثل تقدم Fable 5.2 في قدرته الأكبر على أداء دور المنسّق، بما في ذلك استدعاء الوكلاء الفرعيين لمراجعة عمله من تلقاء نفسه عند ضبط Effort على مستوى مرتفع.
- للعمل متعدد الوكلاء حدود واضحة: يستحق تقسيم المهام عندما يتطلب الأمر عزل السياقات أو المعالجة المتوازية أو توزيع العمل حسب التخصص، لكنه لا يستحق ذلك في المهام شديدة الترابط أو الاستفسارات البسيطة.
- التكلفة والتزامن والتحقق قيود أساسية: فتضخم استهلاك الرموز، وحدود الجدولة، والاختبارات الواقعية هي ما يحدد قدرة النظام على الاستمرار في العمل على المدى الطويل.
بالنسبة إلى معظم المطورين، المسار الأنسب هو البدء بوكيل واحد لتأسيس خط أساس، ثم إدخال Subagent أو Workflow أو Advisor بناءً على مواطن الاختناق الفعلية، مع إرساء أساس متين لواجهات API والميزانية والتزامن والسجلات. فالبنية التحتية لواجهات API هي الأساس الحقيقي لتطبيقات الوكلاء المتعددين.
ننصحك باستخدام APIYI على apiyi.com للتحقق سريعًا من خطتك لتعدد الوكلاء. توفر المنصة واجهة موحدة متوافقة مع OpenAI، إضافةً إلى رصيد مجاني للاختبار للمستخدمين الجدد، ما يسهّل مقارنة توزيع المهام بين النماذج المختلفة.
📚 المراجع
- إعلان Anthropic الرسمي: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- الرابط:
anthropic.com/claude-fable-and-mythos-5-2 -
توضيح: مصدر أولي لتجارب أنظمة التشغيل، واختبارات البرمجة، والأسعار
-
Building multi-agent systems: When and how to use them: حالات استخدام الأنظمة متعددة الوكلاء وتكاليفها (2026-01-23)
- الرابط:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
توضيح: بيانات استهلاك الرموز التي يتراوح بين 3 و10 أضعاف، ومبدأ تقسيم المهام عند حدود السياق
-
How we built our multi-agent research system: نظام Anthropic للأبحاث (2025-06-13)
- الرابط:
anthropic.com/research/multi-agent-research-system -
توضيح: بنية المنسّق والعامل (Orchestrator-Worker)، ونتيجة 90.2% في التقييم الداخلي، وبيانات استهلاك الرموز الذي يبلغ 15 ضعفًا
-
وثائق Managed Agents لتنسيق الوكلاء المتعددين وسير العمل: أنماط التعاون وقيود التشغيل
- الرابط:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
توضيح: تعريفات Subagents وDynamic Workflows وAdvisor، والحد الأقصى للتنفيذ المتزامن
-
Prompting Claude Fable 5.2: الدليل الرسمي لهندسة الموجهات
- الرابط:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
توضيح: سلوك المراجعة الذاتية، وتجارب التفويض المفرط، والتوصيات المتعلقة بتقديم تحديثات عن التقدم
-
وثائق مواصفات نموذج Fable 5.2: السياق، وحدود الإخراج، والفوترة
- الرابط:
platform.claude.com/docs/en/models/fable-5-2/overview - توضيح: سياق بسعة 1M، وحد أقصى للإخراج يبلغ 128K، ومعرّف نموذج API
الكاتب: فريق APIYI التقني
للتواصل التقني: تفضلوا بزيارة الصفحة الرئيسية لـ APIYI على apiyi.com للتواصل معنا وتبادل الخبرات حول بنية الأنظمة متعددة الوكلاء وطرق التكامل مع نماذج متعددة


