
Em 9 de novembro de 2026, a Anthropic lançou o Claude Fable 5.2 e revelou um experimento interno. Tudo começou com uma pasta vazia: o Fable 5.2 coordenou mais de 1.000 subagentes, trabalhou sem parar durante 8 dias e, no fim, criou um protótipo de sistema operacional que inicializa em um notebook.
Principal valor deste artigo: em vez de repetir o discurso promocional, vamos explicar, com base nos materiais públicos da Anthropic sobre engenharia multiagente, o papel de cada componente — Orchestrator, Subagent, Advisor e Workflow —, como dividir tarefas, por que os custos aumentam e como projetar a confiabilidade. No final, você encontra uma lista prática que desenvolvedores podem aplicar diretamente.
Resumo das principais informações sobre o experimento do sistema operacional Claude Fable 5.2
Primeiro, vamos separar os fatos confirmados do que ainda não foi divulgado. Isso é essencial para entender os desafios da colaboração entre vários agentes.
| Item | Detalhes |
|---|---|
| Data de lançamento | 9 de novembro de 2026, divulgado junto com o Claude Fable 5.2 |
| Organização responsável | Anthropic |
| Ponto de partida do experimento | Uma pasta vazia; a tarefa era projetar e implementar um protótipo de sistema operacional |
| Escala da execução | Mais de 1.000 subagentes trabalharam sem parar durante 8 dias para escrever, testar, revisar e modificar código |
| Resultado final | Um sistema protótipo, inicializável em um notebook de verdade, com kernel, drivers de disco, teclado e rede, armazenamento permanente de arquivos, sistema de janelas, tela de login, instalador e recursos Claude integrados |
| Informações não divulgadas | Estrutura de divisão de tarefas entre agentes, Harness, protocolo de comunicação, quantidade de código, linguagem de programação, consumo total de tokens, custo do experimento e auditoria de segurança independente |
A expressão usada oficialmente foi working prototype operating system, ou seja, “protótipo funcional de sistema operacional”. Não se trata de um sistema operacional comercial maduro. Também vale observar que, no mesmo período, a Anthropic divulgou outros experimentos. Um deles, relacionado ao último teorema de Fermat, mencionou uma estrutura com “1 Lead + 999 Helpers”. Mas esse foi um experimento separado, e não dá para presumir que a mesma estrutura tenha sido usada no projeto do sistema operacional.
O que realmente merece atenção nesse experimento não é a quantidade de código escrita, mas a capacidade do modelo de organizar um projeto de engenharia de software de longo prazo ao longo de 8 dias: dividir tarefas, avançar em paralelo, consolidar resultados, encontrar erros e planejar correções. É daí que surge a questão central deste artigo: por trás dos 1.000 agentes, o verdadeiro desafio é a organização.
Como funciona a colaboração entre múltiplos Agents: divisão de papéis por trás do Claude Fable 5.2
Antes de discutir se vale a pena usar vários Agents, é importante esclarecer alguns conceitos que costumam ser confundidos. A tabela abaixo resume as ideias da documentação do Anthropic Managed Agents.
| Conceito | Responsabilidade | Exemplo típico |
|---|---|---|
| Agent | Agente capaz de executar tarefas e chamar ferramentas | Um assistente de programação que consegue ler código e rodar testes |
| Orchestrator | Coordena a distribuição de tarefas e a integração dos resultados | Divide “criar um sistema de blog” em vários módulos e reúne os resultados |
| Subagent | Agente que recebe uma tarefa delegada e executa uma subtarefa em um contexto independente | Implementa especificamente o módulo de comentários e prepara os testes |
| Advisor | Não executa o trabalho diretamente; oferece recomendações especializadas em momentos importantes | Quando o Agent principal trava, consulta um modelo mais capaz para obter uma solução |
| Workflow | Fluxo de execução que organiza a sequência de tarefas, a concorrência e a entrega dos resultados | Um processo em várias etapas: “pesquisa → implementação → revisão → refazer se não for aprovado” |
| Harness | Sistema externo que chama modelos e ferramentas e gerencia a execução | Seu próprio código de orquestração ou uma plataforma gerenciada de Agents |
Três modos de colaboração entre múltiplos Agents
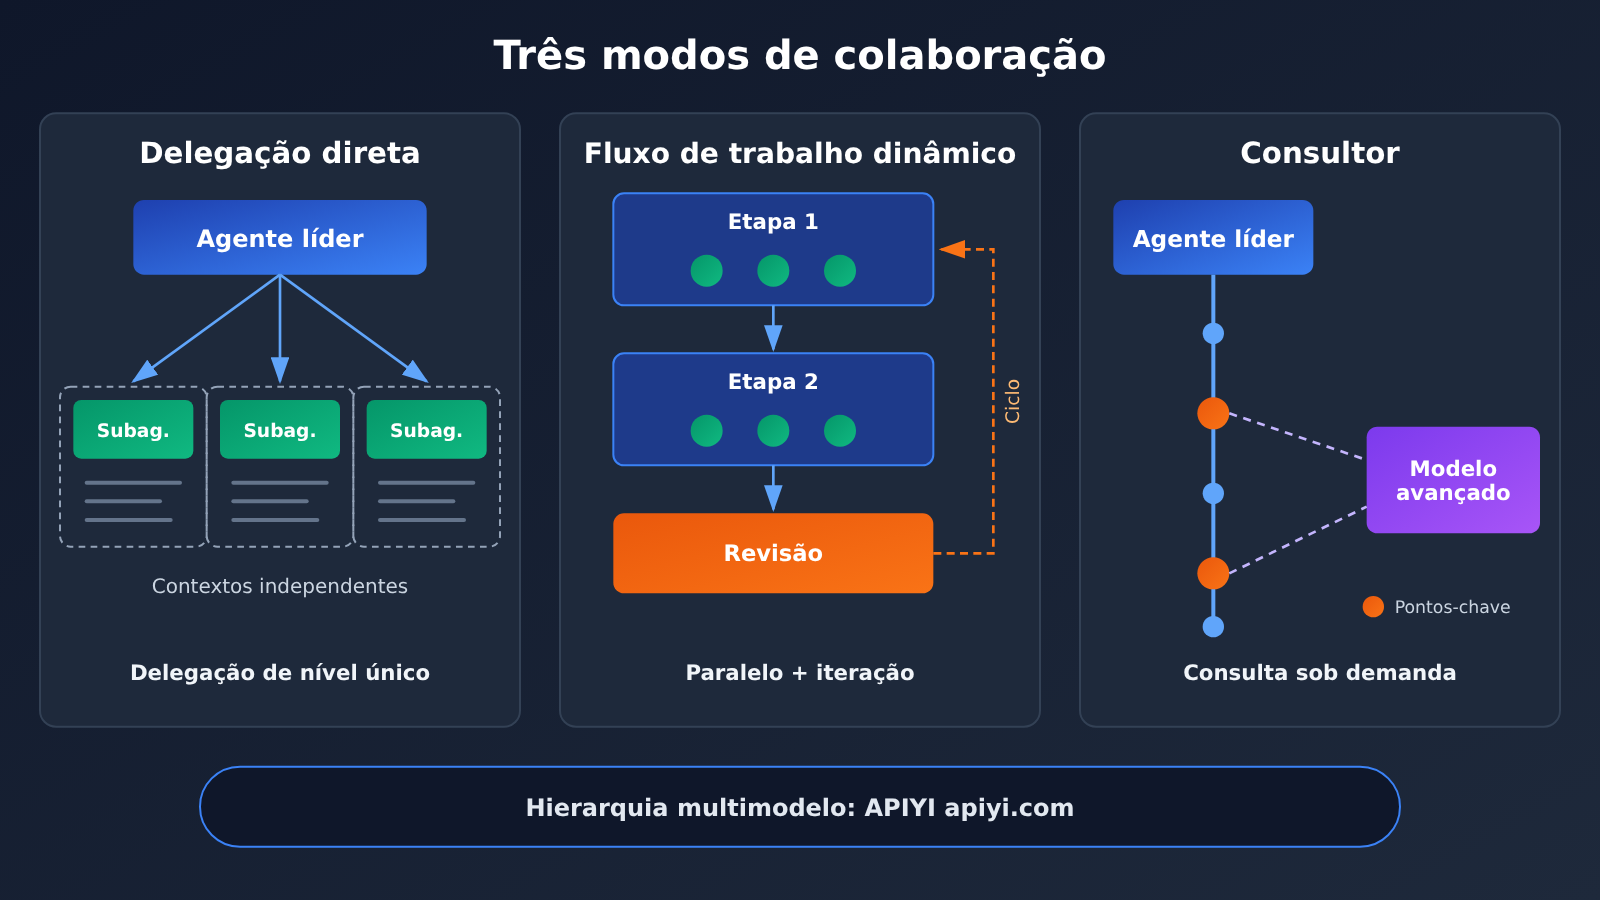
A documentação do Anthropic Managed Agents divide a colaboração entre múltiplos Agents em três modos, cada um adequado a diferentes cenários.
- Delegação direta a Subagents: o Agent principal decide quais Subagents criar, quais tarefas delegar, quando consultar os resultados e se precisa pedir esclarecimentos. Cada Subagent tem um Session Thread independente, mas a delegação só tem um nível: cada sessão pode ter até 25 threads filhos diretos. É uma boa opção para um número pequeno de tarefas especializadas que exigem acompanhamento contínuo.
- Dynamic Workflows (fluxos de trabalho dinâmicos): em vez de gerenciar os Subagents um por um, o Agent principal gera um programa de fluxo de trabalho. Esse programa pode dividir o trabalho em etapas, executar vários Agents em paralelo, repassar resultados, escolher a próxima etapa com base nos resultados e repetir a execução quando uma revisão não for aprovada, até atingir o limite de rodadas. É uma boa opção para tarefas como revisar um grande número de arquivos ou migrar código em vários módulos.
- Advisor (modo consultor): o Agent principal continua executando o trabalho e consulta um modelo mais capaz apenas em momentos difíceis ou decisivos. A vantagem é não precisar dividir a tarefa, o que reduz ao mínimo o custo de coordenação.
Um exemplo concreto ajuda a entender a diferença entre os três modos. Imagine que você precisa migrar um sistema de administração de e-commerce de Python para Go: para migrar apenas os módulos de pagamentos e estoque, a delegação direta é suficiente; para migrar 200 endpoints independentes e revisar cada um, o fluxo de trabalho dinâmico é mais adequado; se o trabalho está sendo feito por um Agent com capacidade de nível de engenharia e ele só precisa, de vez em quando, consultar um modelo mais avançado para revisar o projeto de transações no banco de dados, o Advisor é a opção mais eficiente.
Quando adicionar agentes: a maneira certa de dividir tarefas entre vários agentes
No artigo “Building multi-agent systems: When and how to use them”, publicado em 23 de janeiro de 2026, a Anthropic menciona uma situação real: algumas equipes passam meses desenvolvendo sistemas multiagentes complexos e, no fim, descobrem que melhorar o comando de um único agente produz resultados parecidos. Por isso, a primeira pergunta deve ser sempre “vale a pena dividir a tarefa?”, e não “em quantos agentes?”.
Três situações em que vários agentes realmente fazem diferença
Segundo o artigo, há três tipos de situação em que vários agentes podem gerar valor de forma consistente:
- Isolamento de contexto: por exemplo, um agente de atendimento ao cliente lê um longo histórico de pedidos antes de diagnosticar um problema técnico. Os dados dos pedidos ocupam espaço no contexto e podem atrapalhar a análise. Se a consulta aos pedidos ficar a cargo de um agente independente, que retorna apenas um resumo com as informações necessárias, o agente principal consegue se concentrar melhor.
- Processamento em paralelo: pesquisar mercados de diferentes regiões, revisar arquivos distintos em paralelo ou verificar vários módulos de código ao mesmo tempo. A Anthropic destaca que, nesse tipo de arquitetura, o principal benefício costuma ser ampliar a cobertura e a abrangência da tarefa, e não necessariamente reduzir o tempo total.
- Divisão por especialidade: configurar agentes diferentes com prompts do sistema, ferramentas, servidores MCP, Skills e modelos próprios, evitando sobrecarregar um único agente com responsabilidades demais.
Divida pelos limites de contexto, não pelos papéis
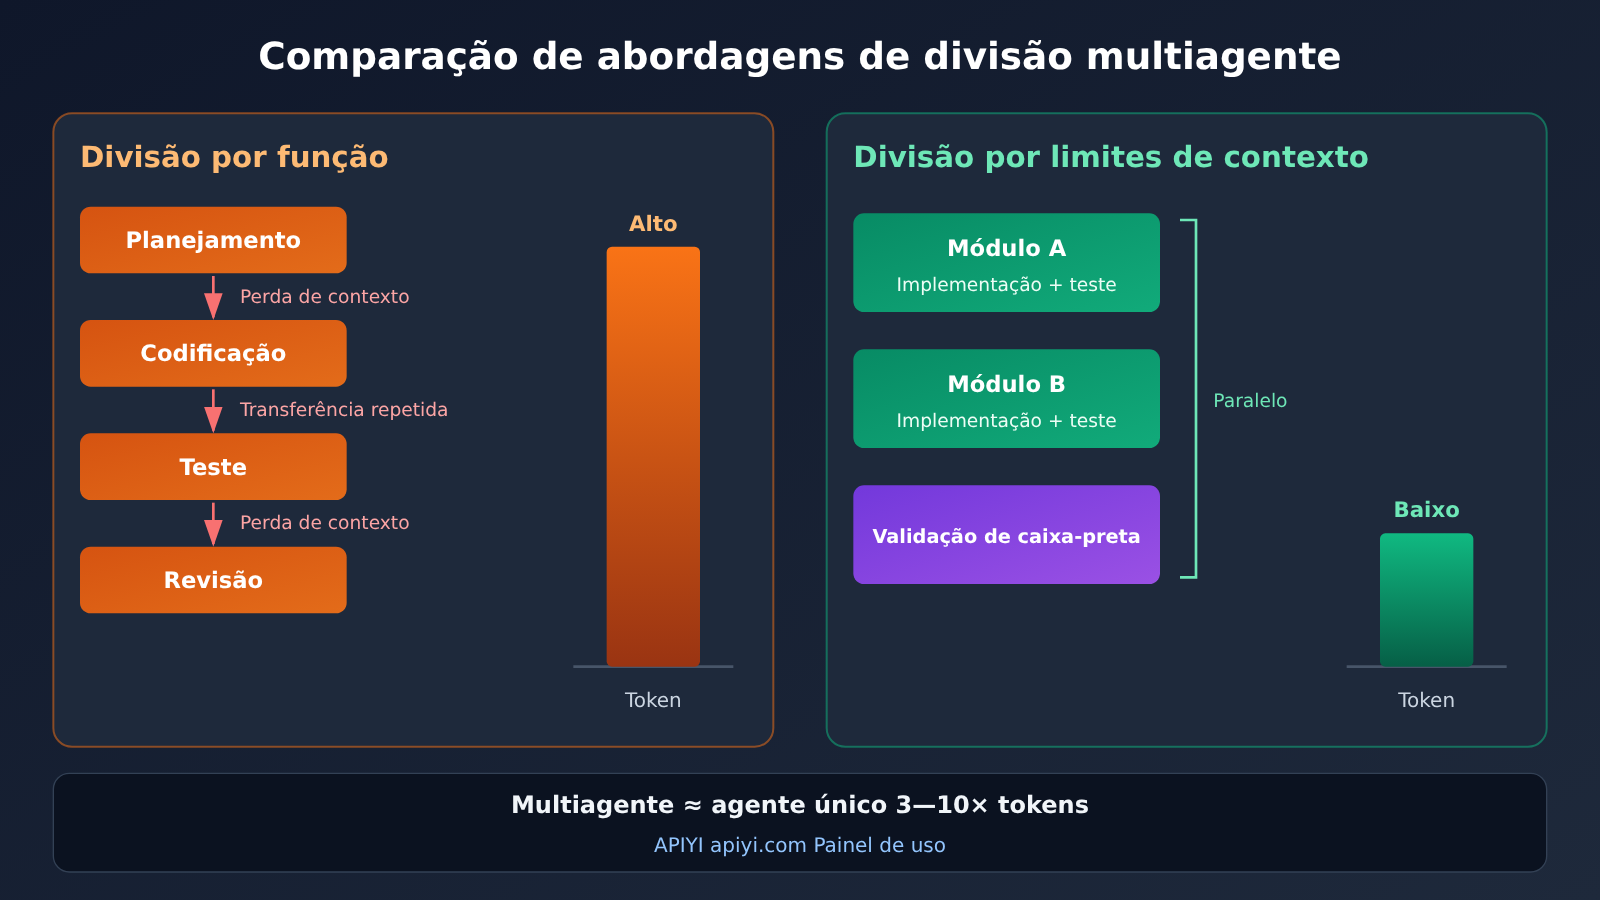
O princípio de design proposto pela Anthropic é a decomposição centrada no contexto (Context-centric decomposition): dividir o trabalho de acordo com os limites de contexto, em vez de separar mecanicamente cada etapa do problema. Muitas equipes começam pensando em “agente de planejamento + agente de programação + agente de testes + agente de revisão”. Parece uma equipe de desenvolvimento com funções bem definidas, mas, na prática, essa abordagem traz problemas.
O agente de testes não sabe por que o código foi projetado daquela forma, e o agente de revisão não conhece as explorações feitas anteriormente. As informações são repassadas várias vezes entre os agentes, o que pode causar distorções, como numa brincadeira de telefone sem fio. Uma abordagem melhor é deixar um agente responsável por um módulo funcional completo, incluindo a implementação e os testes correspondentes; outro, por um módulo com interface independente; e um terceiro apenas pela validação de caixa-preta, fornecendo a ele o resultado a verificar, critérios de aceitação claros e ferramentas de teste.
| Tipo de tarefa | Adequação a vários agentes | Motivo |
|---|---|---|
| Pesquisa de mercado independente em várias regiões | Alta | As subtarefas quase não compartilham informações |
| Revisão paralela de muitos documentos | Alta | Cada documento pode ser analisado de forma independente e, no fim, os resultados são consolidados |
| Desenvolvimento independente de módulos diferentes | Alta | Quando as interfaces são claras, os limites de contexto surgem naturalmente |
| Testes e validação independentes | Alta | A validação de caixa-preta precisa apenas do resultado e dos critérios |
| Alterações em código fortemente acoplado | Baixa | Uma mudança afeta várias outras partes, e o custo de coordenação é alto |
| Tarefas que exigem o compartilhamento de muito estado em tempo real | Baixa | O custo de sincronização pode superar os benefícios do paralelismo |
| Consultas simples sobre fatos | Geralmente desnecessário | Uma única chamada de um agente costuma resolver |
Voltando ao experimento com o sistema operacional, há limites de módulo relativamente claros entre kernel, drivers, sistema de arquivos e sistema de janelas. Esse é um dos motivos pelos quais ele é mais adequado para paralelização em larga escala do que uma “grande refatoração de um sistema de negócios complexo”. É importante lembrar, porém, que a Anthropic não divulgou como a divisão foi feita. Portanto, isso é apenas uma hipótese plausível, não um fato.
Por que o custo de múltiplos agentes é maior: a conta de tokens na era do Claude Fable 5.2
Muita gente imagina que dividir uma tarefa entre mais agentes, executados em paralelo, reduz os custos. Na prática, muitas vezes acontece o contrário. Um artigo da Anthropic, publicado em janeiro de 2026, afirma claramente: para a mesma tarefa, uma arquitetura multiagente costuma usar de 3 a 10 vezes mais tokens do que um agente único.
Os tokens extras vêm principalmente de cinco fontes: cada agente precisa construir seu próprio contexto; os agentes trocam descrições de tarefas e resultados; o agente principal precisa ler e resumir as saídas de vários subagentes; a própria decomposição da tarefa gera chamadas adicionais; e vários agentes podem acabar repetindo parte do trabalho.
Dois conjuntos de dados de custo, com bases de comparação diferentes
Ao discutir o custo de sistemas multiagentes, é comum misturar dados de fontes diferentes. A tabela abaixo os separa:
| Fonte dos dados | Métrica | Base de comparação |
|---|---|---|
| “Building multi-agent systems”, janeiro de 2026 | O consumo de tokens em sistemas multiagentes é de 3 a 10 vezes o de um agente único | Um agente único executando a mesma tarefa |
| Sistema Anthropic Research, junho de 2025 | Consumo de tokens cerca de 15 vezes maior do que em um chat comum | Chat comum |
| Sistema Anthropic Research, junho de 2025 | O Research Eval interno supera o Opus 4 de agente único em 90,2% no consumo de tokens | Opus 4 de agente único, em uma avaliação interna específica |
| Sistema Anthropic Research, junho de 2025 | O tempo de pesquisa de consultas complexas pode cair cerca de 90%; no início, o paralelismo típico era de 3 a 5 subagentes | Pesquisa sequencial no mesmo sistema |
Vale reforçar que os números de 90,2% e 15 vezes vêm ambos do sistema Research de 2025. O primeiro se refere apenas ao desempenho relativo em uma avaliação interna específica: não significa que a precisão tenha aumentado 90,2% em todas as tarefas. Esses números não têm relação com os experimentos de sistema operacional de 2026 e não podem ser comparados diretamente com o fator de 3 a 10 vezes.
Volume total de computação, tempo de execução e cobertura são coisas diferentes
Para entender o custo de sistemas multiagentes, é preciso separar três métricas. O volume total de computação geralmente aumenta, porque o contexto é copiado e os resultados são lidos várias vezes. O tempo de execução pode diminuir, desde que as subtarefas sejam realmente independentes. Já a cobertura das tarefas tende a aumentar, pois vários agentes conseguem explorar mais caminhos ao mesmo tempo.
Com base nos preços oficiais da API, o Fable 5.2 no modo padrão custa US$ 8 por milhão de tokens de entrada e US$ 40 por milhão de tokens de saída. A Batch API oferece 50% de desconto, e a leitura de tokens em cache custa US$ 0,20/MTok. Se uma tarefa executada por um único agente já consumir uma quantidade considerável de tokens, a diferença fica bem evidente quando esse consumo aumenta de 3 a 10 vezes. A Anthropic não divulgou a conta real dos experimentos de sistema operacional; por isso, qualquer afirmação sobre “quanto custaram oito dias” não tem fundamento.
Como projetar um sistema multiagente confiável: práticas de engenharia aprendidas com o Claude Fable 5.2
Hierarquia de modelos: nem todo agente precisa do modelo mais potente
O Managed Agents oferece duas formas de definir agentes. Um agente predefinido é configurado com antecedência e pode ter seu próprio modelo, prompt do sistema, ferramentas, servidor MCP e habilidades. Já um agente inline é definido dinamicamente durante a execução e, por padrão, usa o modelo e as configurações de ferramentas do agente principal.
Isso permite criar níveis de custo e capacidade: use um modelo potente, como o Fable 5.2, para o coordenador e para revisões complexas; um modelo da categoria Sonnet para pesquisas comuns; e um da categoria Haiku para classificações simples. Esse é apenas um exemplo de projeto, não uma arquitetura fixa definida pela Anthropic. Teste e ajuste de acordo com as tarefas reais.
Verificação: um Agent revisor não equivale a uma validação real
Na documentação de Prompting do Fable 5.2, a Anthropic menciona uma mudança recente: com configurações de Effort mais altas, como xhigh e max, o Fable 5.2 chama Subagents por iniciativa própria para revisar o próprio trabalho. O Fable 5.1 não fazia isso nas mesmas tarefas de teste. É um avanço na capacidade de orquestração, mas não deve ser tratado como garantia de qualidade.
Um Agent revisor ainda é, essencialmente, o julgamento de um modelo. Uma validação realmente confiável exige três coisas: critérios de aceitação bem definidos, testes de caixa-preta executáveis e uma verificação real das mudanças no código e nos sistemas externos — por exemplo, executar os testes e iniciar o serviço de verdade. O aspecto mais convincente dos experimentos com sistemas operacionais é justamente o resultado concreto de “conseguir iniciar em um notebook real”, e não um Agent dizendo que “parece tudo certo”.
Como evitar delegações excessivas e o acúmulo de regras
A decisão de um Agent de delegar tarefas depende não só da capacidade do modelo, mas também do Harness e das instruções das ferramentas. Em testes, a Anthropic observou que, quando as instruções da ferramenta Subagent explicavam “o custo adicional de cada sub-Agent, quais tarefas valem a pena delegar, quais não valem e como descrever as tarefas”, o modelo delegava cerca de um terço menos tarefas curtas do que na versão que apenas enfatizava os motivos para delegar, sem reduzir a taxa de sucesso das tarefas.
Outro problema fácil de ignorar é o acúmulo de regras. O Fable 5.2 segue com bastante rigor as instruções restritivas que se acumulam no contexto. Se arquivos antigos, comentários de Reviewers e o System Prompt continuarem adicionando proibições, o modelo pode ficar receoso de executar, no trabalho do dia a dia, ações que na verdade são permitidas. Por isso, é importante limpar periodicamente a memória, as regras e os requisitos de aprovação do Agent.
Limites de execução: o teto real dos produtos públicos
“1.000 agentes” também tem limites claros nos produtos públicos. A tabela abaixo mostra as restrições listadas na documentação do Managed Agents. Elas se aplicam aos produtos públicos e não significam que os experimentos com o sistema operacional interno usaram o mesmo escalonador:
| Métrica | Limite |
|---|---|
| Threads diretas de Subagent | Até 25 |
| Threads de trabalho simultâneas em um Dynamic Workflow | 64 |
| Agentes iniciados durante o ciclo de vida de um único Workflow | 1.000 |
| Ciclo de vida padrão de um Workflow | 24 horas |
| Workflows abertos simultaneamente por Session, por padrão | 10 |
Além disso, os agentes dentro de um Workflow não podem criar Workflows aninhados. Quando o orçamento se esgota, o Workflow em execução é pausado. Se um Agent falhar, o sistema normalmente tenta novamente uma vez; se falhar de novo, cabe ao fluxo de trabalho decidir como lidar com a situação. Em outras palavras, os 1.000 agentes são o total iniciado ao longo do ciclo de vida; em qualquer instante, há bem menos agentes realmente em execução.
Tarefas longas também trazem um problema de experiência: durante chamadas prolongadas a ferramentas, o Fable 5.2 pode passar bastante tempo sem exibir mensagens para o usuário, que pode achar que a tarefa travou. A recomendação oficial é ativar thinking.display: "updates" ou fazer com que o Harness peça ao modelo que informe o progresso após várias chamadas consecutivas a ferramentas. Nos testes oficiais, com esses lembretes, o maior período contínuo sem retorno caiu aproximadamente pela metade.
Primeiros passos com multiagentes: criando um orquestrador mínimo com Claude Fable 5.2
A seguir, vamos demonstrar o passo mais básico sem depender de nenhuma plataforma gerenciada: usar uma interface compatível com OpenAI para que o modelo coordenador divida as tarefas de acordo com os limites de contexto.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatível com OpenAI da APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Use o nome real listado na plataforma
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
A versão completa acrescenta hierarquia de modelos, execução concorrente, orçamento de tokens, uma nova tentativa em caso de falha e validação caixa-preta. A estrutura corresponde aos métodos de engenharia apresentados anteriormente:
Ver o exemplo completo de código de orquestração multiagente
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Uma chave para chamar modelos de vários provedores
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Modelo mais potente para coordenação e revisão
WORKER_MODEL = "your-fast-model"          # Modelo mais rápido e barato para subtarefas; substitua conforme necessário
TOKEN_BUDGET = 200_000                     # Orçamento de tokens para a tarefa inteira
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Cada subagente recebe apenas o contexto de que precisa; em caso de falha, tenta novamente uma vez
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Validação caixa-preta: fornece apenas o resultado e os critérios, sem o processo de exploração
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Controla a execução concorrente
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Este código serve apenas para demonstrar a estrutura. A etapa de revisão ainda depende do julgamento do modelo. Em produção, review deve ser substituída ou complementada por testes reais, como executar testes unitários ou iniciar o serviço para verificar os endpoints.
🚀 Dica para começar: o segredo dos multiagentes é atribuir modelos diferentes a cada função e conseguir comparar o consumo a qualquer momento. Recomendamos usar a APIYI, em apiyi.com, para conectar modelos como Claude, OpenAI e Gemini com uma única chave API. Primeiro, use a cota gratuita de teste para novos usuários e valide o fluxo de um único agente; depois, adicione gradualmente a camada de colaboração.
Análise do impacto da colaboração entre múltiplos agentes para desenvolvedores
Impacto para os desenvolvedores
- Comece com um único agente: estabeleça uma linha de base usando um único agente com um comando bem elaborado. Só adicione uma camada de colaboração quando surgirem gargalos como contaminação do contexto, possibilidade de executar subtarefas independentes em paralelo ou necessidade de configurações especializadas.
- Trate a infraestrutura como prioridade: APIs de modelos e ferramentas, limites de orçamento, controle de concorrência e logs de chamadas determinam se um sistema multiagente consegue operar com estabilidade. Sem logs, não dá para identificar qual subagente está repetindo trabalho.
- A divisão de tarefas entre modelos diferentes está se tornando padrão: usar modelos diferentes para coordenar, executar e revisar é uma das principais formas de controlar o aumento de custos de 3 a 10 vezes.
Impacto para o setor
- Os limites das capacidades da IA estão se expandindo: o foco está passando de “concluir uma tarefa de programação” para “organizar um projeto de engenharia de software de longo prazo”. O feedback de parceiros dos primeiros testes, como Vercel, Shopify e Datadog, também aponta nessa direção. Um engenheiro da Datadog, por exemplo, descreveu a ferramenta como um “comandante de incidentes” capaz de delegar tarefas a modelos mais rápidos. Vale lembrar que esse feedback foi divulgado no lançamento e veio de parceiros — não de testes cegos independentes.
- A capacidade de orquestração importa mais do que a quantidade de agentes: o grau de paralelismo das tarefas, o custo de coordenação, o estado compartilhado, os conflitos no código, a cobertura de testes e o custo das chamadas determinam, em conjunto, a eficiência real de um sistema multiagente.
Perguntas frequentes (FAQ)
P1: O que o experimento com 1.000 agentes do Claude Fable 5.2 realmente produziu?
A Anthropic revelou que o Fable 5.2 partiu de uma pasta vazia e coordenou mais de 1.000 subagentes trabalhando continuamente por 8 dias para criar um protótipo de sistema operacional capaz de inicializar em um notebook real. Ele inclui kernel, drivers, armazenamento de arquivos, sistema de janelas, tela de login e instalador. A descrição oficial é “protótipo funcional”. O código-fonte, a quantidade de linhas de código, o total de tokens e o custo não foram divulgados, e não houve auditoria independente.
P2: Vários agentes são sempre melhores do que um só?
Não. A Anthropic afirma explicitamente que vários agentes nem sempre são melhores do que um só. Algumas equipes passaram meses criando sistemas multiagente e, no fim, descobriram que otimizar o comando de um único agente produzia resultados semelhantes. Para a mesma tarefa, vários agentes normalmente consomem de 3 a 10 vezes mais tokens do que um único agente. Os benefícios são mais consistentes em três tipos de situação: isolamento de contexto, processamento em paralelo e divisão especializada de tarefas.
P3: Os ganhos de 90,2% e o uso de 15 vezes mais tokens servem para avaliar o Fable 5.2?
Não. Esses dois números vêm do sistema Anthropic Research, lançado em junho de 2025: os 90,2% correspondem ao desempenho em uma avaliação interna específica, a Research Eval, em comparação com o Opus 4 em modo de agente único; já a referência para o uso de 15 vezes mais tokens era o chat comum. Esses dados não têm relação com o experimento de sistema operacional do Fable 5.2, de 2026, e não devem ser misturados com os números de 3 a 10 vezes mais tokens para a mesma tarefa.
P4: Como montar rapidamente meu próprio protótipo multiagente usando uma API?
Recomendamos seguir estas etapas:
1. Crie uma conta em APIYI apiyi.com e obtenha uma chave API e créditos gratuitos para testes.
2. Defina `base_url` no código deste artigo como `https://api.apiyi.com/v1`.
3. Primeiro, execute uma versão de referência com um único agente e registre o uso de tokens e a taxa de sucesso.
4. Depois, atribua modelos diferentes ao coordenador e aos subagentes e compare as mudanças no custo e na qualidade.
P5: Como controlar os custos de um sistema multiagente?
Há quatro pontos principais: divida as tarefas de acordo com os limites de contexto para reduzir a transferência de informações; use modelos mais rápidos e baratos nas subtarefas e reserve os modelos mais poderosos para o planejamento e as revisões importantes; deixe claros nas instruções das ferramentas os custos da delegação e quais tarefas não vale a pena delegar, para evitar delegações excessivas; e defina um orçamento global de tokens e um limite de tarefas simultâneas. Para tarefas em lote executadas offline, vale considerar os descontos da Batch API. No uso diário, você também pode recorrer à cobrança por uso e às estatísticas de consumo da APIYI apiyi.com para acompanhar os custos com mais precisão.
P6: Quais são as limitações conhecidas dos sistemas multiagente atualmente?
A primeira é o custo: para a mesma tarefa, o uso de tokens geralmente aumenta de 3 a 10 vezes. A segunda são os limites de orquestração: nos Managed Agents divulgados publicamente, cada agente pode ter no máximo 25 subagentes diretos; os Workflows podem ter até 64 agentes trabalhando ao mesmo tempo; e o limite acumulado é de 1.000 agentes iniciados durante todo o ciclo de vida. A terceira é a validação: um agente revisor não substitui testes reais. Por fim, há problemas de experiência, como o acúmulo de regras e longos períodos sem retorno. Para lidar com isso, é preciso revisar as regras periodicamente e ativar as atualizações de progresso.
Principais conclusões sobre a colaboração entre múltiplos agentes no Claude Fable 5.2
- Quantidade não é sinônimo de eficiência: o valor de 1.000 agentes está na capacidade de organizá-los, não no número em si.
- Os papéis precisam estar bem definidos: o Orchestrator coordena, o Subagent executa, o Advisor recomenda e o Workflow gerencia o fluxo.
- Divida as tarefas respeitando os limites de contexto: cada agente deve cuidar de um módulo completo, incluindo os testes, para evitar distorções na comunicação entre papéis.
- Calcule os custos com cuidado: para a mesma tarefa, usar vários agentes costuma consumir de 3 a 10 vezes mais tokens do que usar um único agente.
- A validação precisa ser prática: além de um agente revisor, é essencial definir critérios de aceitação e realizar testes reais.
- Comece com um único agente: adicione uma camada de colaboração apenas quando surgir um gargalo real. Você pode fazer testes por etapas com modelos diferentes usando o serviço de múltiplos modelos da APIYI apiyi.com.
Resumo
O experimento de sistema operacional do Claude Fable 5.2 traz algumas lições:
- A capacidade de orquestração é a nova barreira de entrada: o avanço do Fable 5.2 está em sua maior aptidão para atuar como coordenador, inclusive chamando proativamente subagentes para revisar o próprio trabalho quando o Effort está alto.
- A colaboração entre vários agentes tem limites claros de aplicação: vale dividir tarefas que se beneficiam do isolamento de contexto, do processamento paralelo e da especialização. Já tarefas muito interdependentes e consultas simples não justificam essa divisão.
- Custo, concorrência e validação são três restrições incontornáveis: o aumento no consumo de tokens, os limites de agendamento e os testes reais determinam se o sistema consegue funcionar no longo prazo.
Para a maioria dos desenvolvedores, o caminho certo é começar com um único agente para estabelecer uma linha de base. Depois, com base nos gargalos reais, vale introduzir Subagents, Workflows ou Advisors, cuidando também da API do modelo, do orçamento, da concorrência e dos logs. A infraestrutura de API é a verdadeira base das aplicações multiagente.
Recomendamos usar a APIYI apiyi.com para validar rapidamente sua solução multiagente. A plataforma oferece uma interface unificada compatível com a OpenAI e créditos gratuitos para testes de novos usuários, facilitando a comparação entre a divisão de tarefas em diferentes modelos.
📚 Referências
- Anúncio oficial da Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Link:
anthropic.com/claude-fable-and-mythos-5-2 -
Descrição: fonte primária sobre experimentos com sistemas operacionais, avaliações de programação e preços
-
Building multi-agent systems: When and how to use them: cenários de uso e custos de sistemas multiagente (2026-01-23)
- Link:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
Descrição: dados sobre o uso de 3 a 10 vezes mais tokens e o princípio de divisão por limites de contexto
-
How we built our multi-agent research system: sistema de pesquisa da Anthropic (2025-06-13)
- Link:
anthropic.com/research/multi-agent-research-system -
Descrição: arquitetura Orchestrator-Worker, avaliação interna de 90.2% e dados sobre o uso de 15 vezes mais tokens
-
Documentação de orquestração multiagente e workflows do Managed Agents: padrões de colaboração e limites de execução
- Link:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Descrição: definições de Subagents, Dynamic Workflows e Advisor, além do limite de execução simultânea
-
Prompting Claude Fable 5.2: guia oficial de engenharia de comandos
- Link:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Descrição: comportamento de autorrevisão, experimentos com delegação excessiva e recomendações para fornecer feedback sobre o progresso
-
Especificações do modelo Fable 5.2: contexto, limite de saída e cobrança
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Descrição: contexto de 1M, saída máxima de 128K e API Model ID
Autor: equipe técnica da APIYI
Contato técnico: acesse a página inicial da APIYI em apiyi.com para falar conosco e trocar experiências sobre arquiteturas multiagente e integração com vários modelos.


