
9 ноября 2026 года Anthropic представила Claude Fable 5.2 и рассказала о внутреннем эксперименте. Он начался с пустой папки: Fable 5.2 координировала более 1000 дочерних агентов, которые непрерывно работали 8 дней и в итоге создали прототип операционной системы, запускающийся на ноутбуке.
Главная ценность: эта статья не пересказывает рекламные заявления, а опирается на опубликованные Anthropic материалы по разработке многоагентных систем. Мы разберём роли оркестратора, субагента, советника и рабочего процесса, объясним, как декомпозировать задачи, почему растут затраты и как обеспечить надёжность. В конце — практический список рекомендаций, которые разработчики смогут применить в работе.
Главное об эксперименте Claude Fable 5.2 по созданию операционной системы
Для начала разделим подтверждённые факты и то, что пока не раскрыто. Это важно, чтобы понять, с какими трудностями сопряжена совместная работа множества агентов.
| Параметр | Подробности |
|---|---|
| Дата публикации | 9 ноября 2026 года, вместе с анонсом Claude Fable 5.2 |
| Кто представил | Anthropic |
| С чего начался эксперимент | С пустой папки. Задача — разработать и реализовать прототип операционной системы |
| Масштаб | Более 1000 субагентов непрерывно работали 8 дней: писали, тестировали и проверяли код, а затем вносили исправления |
| Результат | Прототип системы с ядром, драйверами диска, клавиатуры и сети, постоянным хранением файлов, оконной системой, экраном входа, установщиком и встроенными функциями Claude. Он запускается на настоящем ноутбуке |
| Что не раскрыто | Структура распределения задач между агентами, Harness, протокол взаимодействия, объём кода, язык программирования, общее число токенов, стоимость эксперимента и результаты независимого аудита безопасности |
В официальном описании говорится working prototype operating system — то есть «работающий прототип операционной системы», а не готовая коммерческая ОС. Также стоит помнить, что примерно в то же время Anthropic рассказывала и о других экспериментах. Например, в эксперименте, связанном с Великой теоремой Ферма, упоминалась схема «1 ведущий + 999 помощников». Но это был отдельный проект, и переносить его структуру на разработку операционной системы нельзя.
Главное в этом эксперименте — не объём написанного кода, а то, что модель за 8 дней смогла организовать длительный проект по разработке ПО: разбить работу на задачи, параллельно продвигать их, собирать результаты, находить ошибки и назначать исправления. Отсюда вытекает главный вопрос статьи: за 1000 агентами стоит прежде всего сложная задача организации работы.
Как работает взаимодействие нескольких агентов: распределение ролей за Claude Fable 5.2
Прежде чем обсуждать, нужны ли несколько агентов, разберёмся с понятиями, которые легко перепутать. В таблице ниже они обобщены по материалам документации Anthropic Managed Agents.
| Понятие | Роль | Типичный пример |
|---|---|---|
| Agent | Агент, который выполняет задачи и вызывает инструменты | Помощник-программист, умеющий читать код и запускать тесты |
| Orchestrator | Координатор, который распределяет задачи и объединяет результаты | Разбивает задачу «создать блог» на модули и собирает их воедино |
| Subagent | Агент, которому поручают подзадачу; у него свой контекст | Самостоятельно реализует модуль комментариев и пишет тесты |
| Advisor | Не выполняет работу сам, а даёт экспертные советы в ключевые моменты | Помогает основному агенту, если тот зашёл в тупик |
| Workflow | Процесс, который задаёт порядок задач, параллельное выполнение и передачу результатов | Многоэтапный процесс: «исследование → реализация → проверка → доработка, если проверка не пройдена» |
| Harness | Внешняя система, которая вызывает модели и инструменты и управляет выполнением | Собственный код для управления задачами или платформа управляемых агентов |
Три модели взаимодействия нескольких агентов
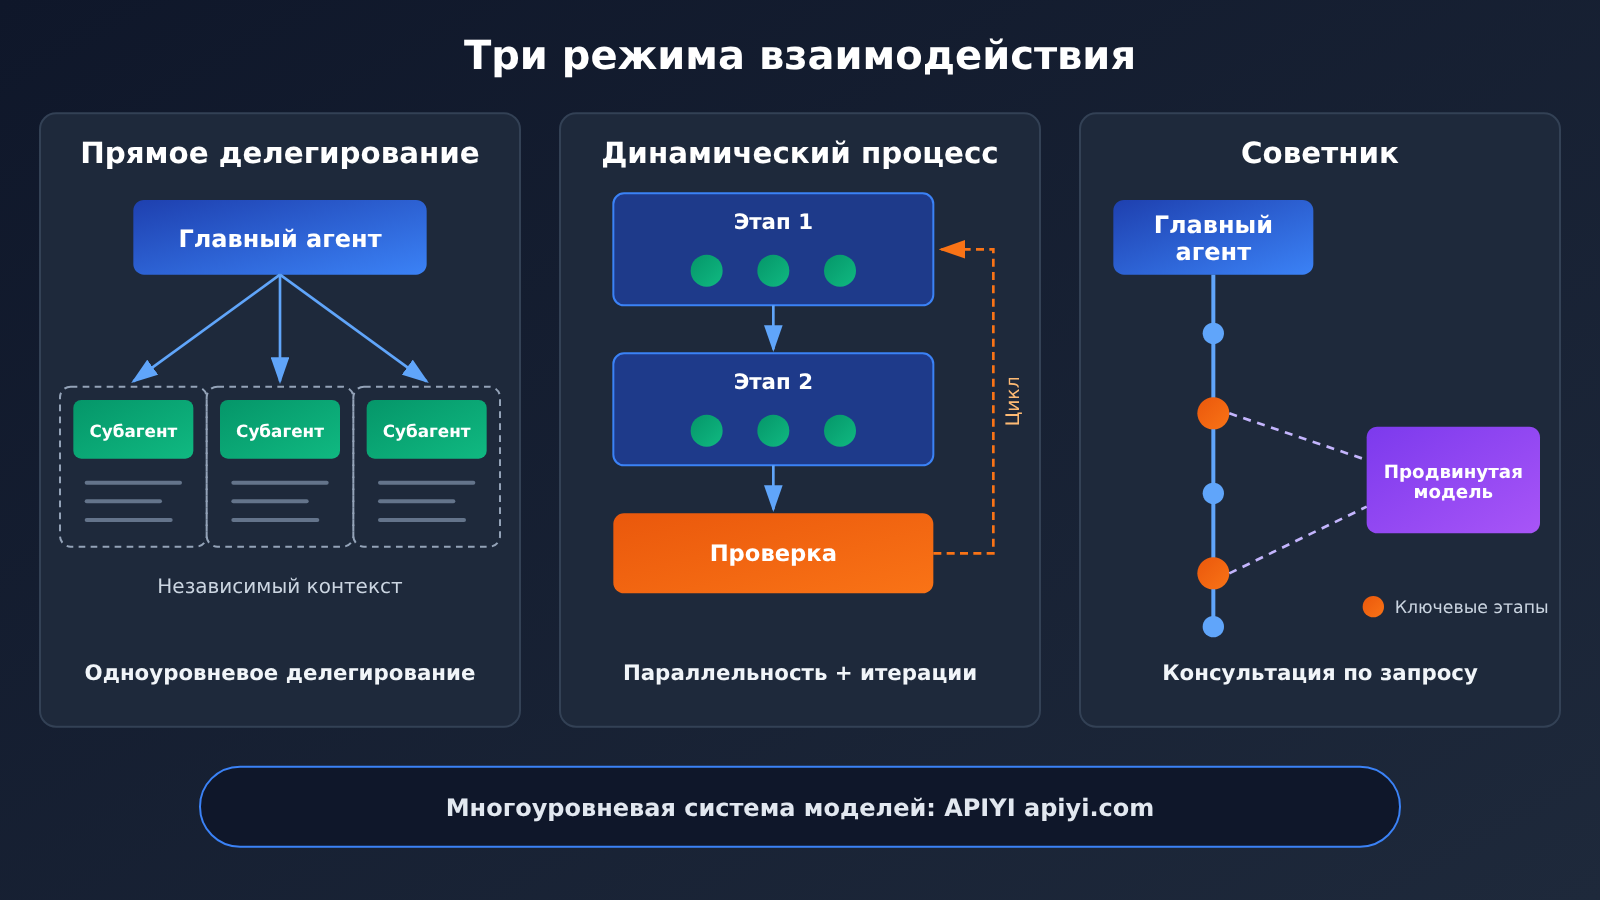
В документации Anthropic Managed Agents описаны три модели взаимодействия нескольких агентов — каждая подходит для своих задач.
- Прямое делегирование субагентам: основной агент сам решает, каких субагентов создать, какие задачи им поручить, когда проверить результаты и нужно ли задать уточняющие вопросы. У каждого субагента своя ветка сессии (Session Thread), но делегирование возможно только на один уровень: в одной сессии может быть не более 25 дочерних потоков. Подходит для небольшого числа специализированных задач, за которыми нужно следить по ходу выполнения.
- Dynamic Workflows — динамические рабочие процессы: основной агент больше не управляет каждым субагентом по отдельности, а создаёт программу рабочего процесса. Она может разбивать работу на этапы, запускать несколько агентов параллельно, передавать результаты, выбирать следующий этап на их основе и повторять выполнение, если проверка не пройдена, пока не будет достигнут лимит попыток. Подходит для масштабной проверки файлов и переноса кода между множеством модулей.
- Advisor — режим советника: основной агент по-прежнему выполняет работу сам, но в сложных или критически важных ситуациях обращается к более мощной модели. Задачу не нужно делить на части, поэтому затраты на координацию минимальны.
Разницу между тремя моделями поможет понять конкретный пример. Допустим, нужно перенести серверную часть интернет-магазина с Python на Go. Если речь только о модулях оплаты и складского учёта, достаточно прямого делегирования. Для переноса 200 независимых API и поэтапной проверки каждого подойдёт динамический рабочий процесс. А если задачу выполняет один агент уровня инженера, но иногда ему нужно попросить более мощную модель проверить проектирование транзакций в базе данных, выгоднее всего использовать Advisor.
Когда добавлять агентов: как правильно разбивать задачи между несколькими агентами
В статье Anthropic «Building multi-agent systems: When and how to use them» от 23 января 2026 года описан реальный случай: команда несколько месяцев строила сложную систему из нескольких агентов, а в итоге выяснила, что похожего результата можно добиться, просто улучшив промпт для одного агента. Поэтому сначала всегда нужно спросить себя: «А стоит ли вообще делить задачу?», а не «На сколько частей её разбить?»
Три сценария, в которых несколько агентов действительно полезны
Согласно статье, несколько агентов стабильно приносят пользу в трёх основных сценариях:
- Изоляция контекста. Например, агент поддержки сначала изучает историю заказов, а затем диагностирует техническую проблему. Данные о заказах занимают контекстное окно и мешают анализу. Если поручить поиск информации о заказах отдельному агенту и передавать основному только краткую сводку, ему будет проще сосредоточиться на задаче.
- Параллельная обработка. Можно отдельно изучать рынки разных регионов, параллельно проверять разные документы или одновременно анализировать несколько модулей кода. Anthropic особо отмечает: главное преимущество такой архитектуры — обычно более широкий охват и полнота работы, а не гарантированное сокращение общего времени выполнения.
- Разделение обязанностей по специализациям. Для разных агентов можно настроить отдельные системные промпты, инструменты, MCP-серверы, Skills и модели. Так одному агенту не придётся одновременно справляться со слишком большим числом задач.
Разделяйте работу по границам контекста, а не по ролям
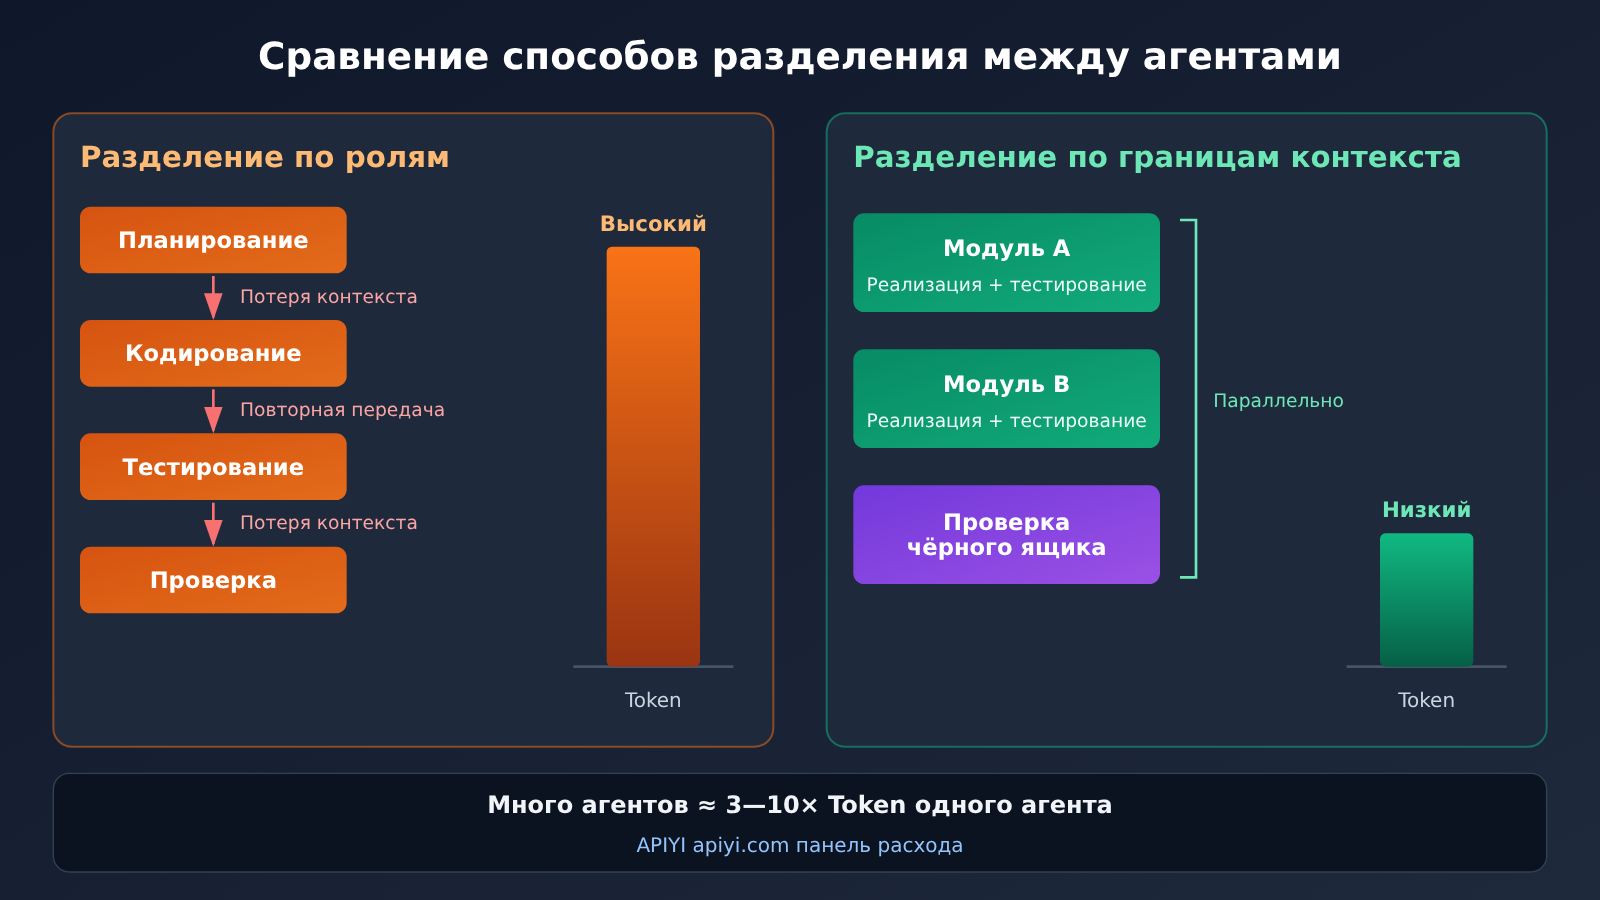
Принцип, предложенный Anthropic, называется Context-centric decomposition: задачи разделяют по границам контекста, а не механически по этапам. Первая мысль у многих команд — создать «агента-планировщика + агента-разработчика + агента-тестировщика + агента-ревьюера». На первый взгляд это напоминает слаженную команду разработчиков с чётким распределением обязанностей, но такой подход может создать немало проблем.
Агент-тестировщик не знает, почему код спроектирован именно так, а агент-ревьюер не в курсе предыдущих этапов исследования. Информация передаётся от одного агента к другому, искажается, словно в игре в испорченный телефон. Лучше поручить одному агенту целый функциональный модуль, включая реализацию и соответствующие тесты, другому — модуль с отдельным интерфейсом, а третьему — только проверку по принципу чёрного ящика. Последнему достаточно передать результат, чёткие критерии приёмки и инструменты тестирования.
| Тип задачи | Насколько подходят несколько агентов | Причина |
|---|---|---|
| Независимые маркетинговые исследования для разных регионов | Высокая | Подзадачи почти не требуют обмена информацией |
| Параллельная проверка большого объёма документации | Высокая | Каждый документ можно обработать отдельно, а затем свести результаты |
| Независимая разработка разных модулей | Высокая | При чётких интерфейсах границы контекста возникают естественным образом |
| Независимое тестирование и проверка | Высокая | Для проверки по принципу чёрного ящика достаточно результата и критериев |
| Изменение тесно связанных фрагментов кода | Низкая | Изменение в одном месте затрагивает другие, а передача работы обходится дорого |
| Задачи, требующие совместного доступа к большому объёму актуального состояния | Низкая | Затраты на синхронизацию могут превысить выигрыш от параллельной работы |
| Простой запрос фактической информации | Обычно не требуется | Один агент справится за один вызов |
Вернёмся к лабораторной работе по операционным системам. Между ядром, драйверами, файловой системой и оконной системой действительно есть относительно чёткие границы модулей. Это одна из причин, почему такую работу проще распараллелить в больших масштабах, чем, например, масштабный рефакторинг сложной бизнес-системы. Разумеется, Anthropic не раскрывала конкретный способ распределения задач, поэтому это лишь обоснованное предположение, а не установленный факт.
Почему мультиагентные системы обходятся дороже: учёт токенов в эпоху Claude Fable 5.2
Интуитивно кажется, что если распределить задачу между несколькими агентами и выполнять её параллельно, затраты снизятся. Но на практике часто происходит обратное. В статье Anthropic за январь 2026 года прямо сказано: на одну и ту же задачу мультиагентная архитектура обычно расходует в 3–10 раз больше токенов, чем один агент.
Дополнительные токены расходуются в основном по пяти причинам: каждому агенту нужно формировать собственный контекст; агентам приходится обмениваться описаниями задач и результатами; главный агент должен прочитать и свести воедино выводы нескольких субагентов; декомпозиция задачи сама по себе требует дополнительных вызовов; наконец, разные агенты могут дублировать работу друг друга.
Две группы данных — разные базовые показатели
Когда обсуждают затраты на мультиагентные системы, данные из разных источников часто смешивают. В таблице ниже они разделены:
| Источник данных | Показатель | База для сравнения |
|---|---|---|
| Статья «Building multi-agent systems», январь 2026 года | Мультиагентная система расходует в 3–10 раз больше токенов, чем один агент | Один агент, решающий ту же задачу |
| Система Anthropic Research, июнь 2025 года | Расход токенов примерно в 15 раз выше, чем в обычном чате | Обычный чат |
| Система Anthropic Research, июнь 2025 года | Внутренняя оценка Research Eval показала результат на 90,2% выше, чем у Opus 4 с одним агентом | Opus 4 с одним агентом; конкретная внутренняя оценка |
| Система Anthropic Research, июнь 2025 года | Исследование сложных запросов занимало примерно на 90% меньше времени; на раннем этапе обычно параллельно работали 3–5 субагентов | Однопоточное исследование в той же системе |
Важно уточнить: оба показателя — 90,2% и 15 раз — относятся к системе Research 2025 года. Первый отражает относительный результат в конкретной внутренней оценке и не означает, что точность любых задач выросла на 90,2%. Эти данные не связаны с экспериментами с операционной системой 2026 года, и напрямую сравнивать их с показателем 3–10 раз нельзя.
Общий объём вычислений, время выполнения и охват — это разные показатели
Чтобы оценить затраты на мультиагентную систему, нужно различать три показателя. Общий объём вычислений обычно растёт: контекст копируется, а результаты приходится читать повторно. Время выполнения может сократиться, если подзадачи действительно независимы. Охват задач обычно увеличивается, потому что несколько агентов могут одновременно исследовать больше направлений.
Согласно официальным ценам API, обычный режим Fable 5.2 стоит 8 долларов за миллион входных токенов и 40 долларов за миллион выходных. Batch API даёт скидку 50%, а чтение из кэша стоит 0,20 доллара за миллион токенов. Если даже для одной задачи с одним агентом требуется заметное количество токенов, при росте затрат в 3–10 раз разница становится очень ощутимой. Anthropic не публиковала фактические расходы на эксперимент с операционной системой, поэтому любые утверждения о том, «сколько стоили 8 дней», не имеют оснований.
Как проектировать надёжные мультиагентные системы: инженерные подходы на примере Claude Fable 5.2
Разделение моделей по уровням: не каждому агенту нужна самая мощная модель
В Managed Agents есть два способа определять агентов. Predefined Agent настраивается заранее и может иметь собственную модель, системный промпт, инструменты, MCP-сервер и навыки. Inline Agent определяется динамически во время выполнения и по умолчанию использует настройки модели и инструментов главного агента.
Так можно распределить агентов по стоимости и возможностям: для координатора и сложных проверок использовать мощную модель вроде Fable 5.2, для обычного поиска информации — модель уровня Sonnet, а для простых задач классификации — уровня Haiku. Это лишь пример архитектурного решения, а не фиксированная схема, предписанная Anthropic. Её нужно тестировать и адаптировать под реальные задачи.
Проверка: ревью Agent — это ещё не настоящая валидация
В документации Anthropic по промптингу для Fable 5.2 упоминается новое поведение: при высоких настройках Effort, например xhigh и max, Fable 5.2 самостоятельно привлекает Subagent, чтобы проверить свою работу. В тех же тестовых заданиях Fable 5.1 так не поступала. Это шаг вперёд в организации работы, но считать его гарантией качества нельзя.
Решение ревью Agent всё равно остаётся суждением модели. Для надёжной проверки нужны три вещи: чётко сформулированные критерии приёмки, исполняемые тесты по принципу чёрного ящика и реальная проверка изменений в коде и внешних системах — например, фактический запуск тестов и сервиса. Самое убедительное в эксперименте с операционной системой — жёсткий критерий «можно запустить на настоящем ноутбуке», а не слова какого-нибудь Agent: «Выглядит нормально».
Как избежать чрезмерного делегирования и нагромождения правил
Решение Agent делегировать задачу зависит не только от возможностей модели, но и от Harness и описаний инструментов. В тестах Anthropic выяснилось: если в описании инструмента Subagent указать дополнительные затраты на каждого дочернего Agent, объяснить, какие задачи стоит делегировать, какие — нет, и как описывать задачу, модель делегирует короткие задания примерно на треть реже, чем при формулировке, в которой подчёркиваются только причины для делегирования. При этом успешность выполнения задач не меняется.
Ещё одна проблема, которую легко упустить, — нагромождение правил. Fable 5.2 довольно строго следует ограничительным инструкциям, накопленным в контексте. Если файлы истории, замечания Reviewer и System Prompt раз за разом дополнять запретами, модель может начать опасаться выполнять в повседневной работе действия, которые вообще-то разрешены. Поэтому память Agent, правила и требования к согласованию нужно регулярно пересматривать и очищать.
Ограничения во время выполнения: реальные пределы публичного продукта
В публичном продукте у «1000 Agent» тоже есть чёткие ограничения. Ниже перечислены лимиты из документации Managed Agents. Они относятся к публичному продукту и не означают, что в экспериментах с внутренней операционной системой использовался тот же планировщик:
| Метрика | Ограничение |
|---|---|
| Прямые дочерние потоки Subagent | Не более 25 |
| Одновременно работающие потоки Dynamic Workflow | 64 |
| Agent, запускаемые в рамках жизненного цикла одного Workflow | 1000 |
| Жизненный цикл Workflow по умолчанию | 24 часа |
| Одновременно открытые Workflow в одной Session по умолчанию | 10 |
Кроме того, Agent внутри Workflow не могут создавать вложенные Workflow. Когда бюджет исчерпан, выполняющийся Workflow приостанавливается. Если Agent завершается с ошибкой, система обычно повторяет попытку один раз, а после повторного сбоя Workflow сам решает, что делать дальше. Иными словами, 1000 Agent — это общее число запусков за весь жизненный цикл, а одновременно работающих Agent значительно меньше.
При длительном выполнении возникает и проблема с обратной связью: во время долгих вызовов инструментов Fable 5.2 может редко выводить текст для пользователя, из-за чего создаётся впечатление, будто задача зависла. В документации рекомендуется включить thinking.display: "updates" или настроить Harness так, чтобы после нескольких вызовов инструментов подряд модель сообщала о ходе работы. По результатам официальных тестов, после добавления напоминаний о ходе выполнения максимальный период без обратной связи сокращался примерно вдвое.
Быстрый старт с несколькими агентами: создаём минимальный оркестратор на Claude Fable 5.2
Ниже — базовый пример работы через OpenAI-совместимый интерфейс, без зависимости от какой-либо облачной платформы. Координирующая модель делит задачу на подзадачи с учётом границ контекста.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-совместимый интерфейс APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Используйте фактическое название из списка моделей платформы
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
В полной версии добавлены разделение моделей по ролям, параллельное выполнение, бюджет токенов, одна повторная попытка при сбое и проверка по принципу чёрного ящика. По структуре она соответствует описанному выше инженерному подходу:
Показать полный пример кода оркестрации нескольких агентов
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Один ключ для вызова моделей разных провайдеров
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Мощная модель для координации и проверки
WORKER_MODEL = "your-fast-model"          # Более быстрая и дешёвая модель для подзадач — замените при необходимости
TOKEN_BUDGET = 200_000                     # Бюджет токенов на всю задачу
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Каждый дочерний агент получает только нужный ему контекст; при сбое выполняется одна повторная попытка
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Проверка по принципу чёрного ящика: передаём только результат и критерии, не показывая ход работы
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Ограничиваем число параллельных задач
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Этот код показывает только общую структуру. Проверка по-прежнему выполняется моделью. В production-среде функцию review стоит заменить реальными тестами или дополнить ими — например, запускать модульные тесты и проверять интерфейсы запущенного сервиса.
🚀 Совет для быстрого старта: главное в мультиагентной системе — назначить разные модели на разные роли и иметь возможность в любой момент сравнить их расходы. Подключите Claude, OpenAI, Gemini и другие модели через APIYI apiyi.com с помощью одного API-ключа. Сначала проверьте базовый сценарий с одним агентом, используя бесплатный тестовый лимит для новых пользователей, а затем постепенно добавляйте уровень взаимодействия между агентами.
Как мультиагентное взаимодействие влияет на разработчиков
Влияние на разработчиков
- Начинайте с одного агента: сначала задайте базовый сценарий с одним агентом и хорошо составленным промптом. Добавляйте уровень взаимодействия только тогда, когда столкнётесь с одной из трёх проблем: загрязнением контекста, возможностью независимо выполнять подзадачи параллельно или необходимостью специализированных настроек.
- Считайте инфраструктуру полноценной частью системы: стабильность мультиагентной системы зависит от API моделей и инструментов, лимитов бюджета, управления параллельными запросами и журналов вызовов. Без журналов не получится выяснить, какой субагент повторяет работу.
- Распределение ролей между разными моделями становится нормой: использование разных моделей для координатора, исполнителей и проверяющих — один из главных способов контролировать рост расходов в 3–10 раз.
Влияние на отрасль
- Возможности ИИ выходят за прежние рамки: ИИ переходит от «выполнения одной задачи по программированию» к «организации долгосрочного проекта по разработке ПО». На это указывают и отзывы ранних партнёров по тестированию, таких как Vercel, Shopify и Datadog. Например, инженер Datadog сравнил систему с «руководителем инцидента», который может поручать задачи более быстрым моделям. Важно учитывать, что это отзывы партнёров, опубликованные при запуске, а не результаты независимого слепого тестирования.
- Качество оркестрации важнее количества агентов: реальную эффективность мультиагентной системы определяют возможности параллельного выполнения задач, накладные расходы на координацию, общее состояние, конфликты кода, охват тестами и стоимость вызовов.
Часто задаваемые вопросы
Вопрос 1: Что показал эксперимент Claude Fable 5.2 с 1000 Agent?
Anthropic сообщила, что Fable 5.2 начал работу с пустой папки и в течение 8 дней координировал работу более 1000 дочерних Agent. В результате появился прототип операционной системы, который можно запустить на обычном ноутбуке. В него входят ядро, драйверы, файловое хранилище, оконная система, экран входа и установщик. Официально это «работающий прототип». Исходный код, объём кода, общее количество токенов и стоимость не раскрыты, независимого аудита также не проводилось.
Вопрос 2: Многоагентная система всегда лучше одного Agent?
Не всегда. Anthropic прямо отмечает, что многоагентный подход не обязательно превосходит работу одного Agent. Некоторые команды месяцами создавали многоагентные системы, а затем обнаруживали, что примерно такого же результата можно добиться, оптимизировав промпт одного Agent. На одну и ту же задачу многоагентная система обычно расходует в 3—10 раз больше токенов, чем один Agent. Стабильную пользу такой подход приносит главным образом в трёх случаях: при изоляции контекста, параллельной обработке и разделении задач между специализированными Agent.
Вопрос 3: Можно ли использовать прирост на 90,2% и расход токенов в 15 раз для оценки Fable 5.2?
Нет. Эти цифры относятся к системе Anthropic Research, представленной в июне 2025 года. Прирост на 90,2% — это результат на конкретном внутреннем тесте Research Eval по сравнению с одним Agent на Opus 4, а базой для сравнения при оценке расхода токенов в 15 раз был обычный чат. Эти показатели не связаны с экспериментом Fable 5.2 с операционной системой в 2026 году. Их также нельзя смешивать с данными о расходе токенов, который обычно в 3—10 раз выше при выполнении одной и той же задачи.
Вопрос 4: Как быстро собрать собственный прототип многоагентной системы через API?
Рекомендуем действовать так:
1. Зарегистрируйтесь на APIYI apiyi.com и получите API-ключ и бесплатный тестовый лимит.
2. В коде из этой статьи укажите для `base_url` значение `https://api.apiyi.com/v1`.
3. Сначала запустите базовую версию с одним Agent и зафиксируйте расход токенов и процент успешных результатов.
4. Затем назначьте координатору и дочерним Agent разные модели и сравните изменения стоимости и качества.
Вопрос 5: Как контролировать расходы на многоагентную систему?
Главное — учитывать четыре фактора: разделяйте задачи по границам контекста, чтобы сократить передачу информации; используйте для подзадач более быстрые и дешёвые модели, а мощные модели оставьте для планирования и ключевых проверок; укажите в инструкциях к инструментам стоимость делегирования и задачи, которые не стоит делегировать, чтобы избежать избыточной передачи задач; задайте общий лимит токенов и максимальное число параллельных процессов. Для пакетных офлайн-задач можно использовать скидки Batch API. А для повседневных запросов удобно вести точный учёт с помощью оплаты по факту использования и статистики расходов на APIYI apiyi.com.
Вопрос 6: Какие ограничения многоагентных систем известны на данный момент?
Во-первых, это стоимость: на одну и ту же задачу обычно уходит в 3—10 раз больше токенов. Во-вторых, ограничения планировщика: в опубликованной версии Managed Agents может быть не более 25 прямых дочерних потоков, в Workflow одновременно могут работать 64 потока, а за весь жизненный цикл можно запустить не более 1000 потоков. В-третьих, проверка результатов: наличие Agent-ревьюера не заменяет реальное тестирование. Наконец, накопление правил и длительное отсутствие обратной связи ухудшают работу системы, поэтому правила нужно регулярно пересматривать, а обновления о ходе выполнения — включить.
Ключевые выводы о совместной работе нескольких агентов в Claude Fable 5.2
- Количество не равно эффективности: ценность 1000 агентов — в способности организовать их работу, а не в самом количестве.
- Роли нужно разграничить: оркестратор координирует, субагент выполняет задачи, советник дает рекомендации, а рабочий процесс управляет последовательностью действий.
- Разделяйте работу по границам контекста: поручайте одному агенту целый модуль вместе с тестами — так меньше риск искажений при передаче задач между ролями.
- Учитывайте затраты: выполнение той же задачи несколькими агентами обычно обходится в 3–10 раз дороже по токенам, чем одним.
- Проверка должна быть практической: помимо агента-ревьюера нужны критерии приемки и реальные тесты.
- Начните с одного агента: добавляйте уровень взаимодействия, только когда возникнет реальное узкое место. Для поэтапного тестирования можно подключить несколько моделей через APIYI apiyi.com.
Итоги
Эксперимент с операционной системой на Claude Fable 5.2 позволяет сделать несколько выводов:
- Умение координировать работу становится новым порогом возможностей: Fable 5.2 лучше справляется с ролью координатора, в том числе при высоком Effort самостоятельно привлекает субагентов для проверки своей работы.
- У мультиагентных систем есть четкие границы применимости: задачи стоит разделять, если для них важны изоляция контекста, параллельная обработка или специализация. Для тесно связанных задач и простых запросов разделение нецелесообразно.
- Стоимость, параллелизм и проверка — три жестких ограничения: увеличение расхода токенов, пределы планировщика и необходимость реального тестирования определяют, сможет ли система стабильно работать в долгосрочной перспективе.
Большинству разработчиков лучше сначала установить базовый уровень с одним агентом, а затем, исходя из реальных узких мест, подключать субагентов, рабочие процессы или советников. При этом важно наладить работу с API моделей, бюджетом, параллелизмом и логами. Именно API-инфраструктура служит настоящей основой мультиагентных приложений.
Быстро проверить свою мультиагентную схему можно через APIYI apiyi.com: платформа предоставляет единый интерфейс, совместимый с OpenAI, и бесплатный тестовый лимит для новых пользователей. Это упрощает сравнение и распределение задач между разными моделями.
📚 Источники
- Официальный анонс Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Ссылка:
anthropic.com/claude-fable-and-mythos-5-2 -
Описание: первоисточник данных об экспериментах с операционными системами, оценке навыков программирования и ценах
-
Создание мультиагентных систем: когда и как их использовать: сценарии применения и стоимость мультиагентных систем (2026-01-23)
- Ссылка:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
Описание: данные о расходе токенов в 3–10 раз и принцип разделения задач по границам контекста
-
Как мы создали мультиагентную исследовательскую систему: исследовательская система Anthropic (2025-06-13)
- Ссылка:
anthropic.com/research/multi-agent-research-system -
Описание: архитектура Orchestrator-Worker, 90,2% во внутренних оценках и данные о расходе токенов в 15 раз
-
Документация Managed Agents по мультиагентной оркестрации и Workflow: режимы взаимодействия и ограничения выполнения
- Ссылка:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Описание: определения Subagents, Dynamic Workflows и Advisor, а также ограничения на количество параллельных процессов
-
Настройка промптов для Claude Fable 5.2: официальное руководство по промпт-инжинирингу
- Ссылка:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Описание: самопроверка модели, эксперименты с чрезмерным делегированием и рекомендации по обратной связи о ходе работы
-
Документация со спецификациями модели Fable 5.2: контекст, максимальный объём вывода и тарификация
- Ссылка:
platform.claude.com/docs/en/models/fable-5-2/overview - Описание: контекстное окно на 1 млн токенов, максимальный объём вывода 128 тыс. токенов и API Model ID
Автор: техническая команда APIYI
Технические вопросы: посетите главную страницу APIYI — apiyi.com — и свяжитесь с нами, чтобы обсудить мультиагентную архитектуру и практику подключения нескольких моделей.


