
2026年11月9日、AnthropicはClaude Fable 5.2を発表し、社内実験の内容を明らかにしました。実験は空のフォルダーから始まり、Fable 5.2は1,000を超えるサブエージェントを連携させ、8日間にわたって作業を続け、最終的にノートPCで起動できるOSのプロトタイプを作り上げました。
この記事のポイント:宣伝内容を繰り返すのではなく、Anthropicが公開したマルチエージェントのエンジニアリング資料をもとに、Orchestrator、Subagent、Advisor、Workflowそれぞれの役割を解説します。タスクの分割方法、コストが増える理由、信頼性を高める設計についても説明し、最後に開発者がすぐに実践できるチェックリストを紹介します。
Claude Fable 5.2のOS実験:概要
まず、確認済みの事実と未公開の情報を分けて整理しましょう。これが、マルチエージェント連携のハードルを理解するうえでの前提になります。
| 情報項目 | 詳細 |
|---|---|
| 発表日 | 2026年11月9日、Claude Fable 5.2とあわせて公開 |
| 発表元 | Anthropic |
| 実験の出発点 | 空のフォルダー。OSのプロトタイプを設計・実装するタスク |
| 実行規模 | 1,000を超えるサブエージェントが8日間にわたり、24時間体制でコードの作成、テスト、レビュー、修正を実施 |
| 最終成果物 | カーネル、ディスク・キーボード・ネットワークドライバー、永続ファイルストレージ、ウィンドウシステム、ログイン画面、インストーラー、Claude機能を内蔵したプロトタイプシステム。実際のノートPCで起動可能 |
| 未公開の情報 | エージェントの役割分担、Harness、通信プロトコル、コード量、プログラミング言語、総Token消費量、実験コスト、第三者によるセキュリティ監査 |
公式発表で使われている表現は「working prototype operating system」、つまり「動作するOSのプロトタイプ」です。完成度の高い商用OSという意味ではありません。また、Anthropicは同時期にほかの実験についても発表しています。たとえばフェルマーの最終定理に関する実験では「1人のLeadと999人のHelper」という構成が明らかにされましたが、これは別の実験であり、OSプロジェクトにそのまま当てはめることはできません。
この実験で本当に注目すべきなのは、コードをどれだけ書いたかではありません。モデルが8日間にわたるソフトウェア開発プロジェクトを組織し、タスクを分割して並行して進め、成果を集約し、エラーを見つけ、修正を割り当てられるという点です。ここから、この記事の中心となる問いが浮かび上がります。1,000のエージェントを動かすうえで、本当に難しいのは組織化です。
マルチAgentの連携はどう機能するのか:Claude Fable 5.2を支える役割分担
「マルチAgentにするべきか」を考える前に、混同しやすい概念を整理しておきましょう。次の表は、Anthropic Managed Agentsのドキュメントに沿ってまとめたものです。
| 概念 | 役割 | 代表的な例 |
|---|---|---|
| Agent | タスクを実行し、ツールを呼び出す知的エージェント | コードを読み、テストを実行できるプログラミングアシスタント |
| Orchestrator | タスクを割り振り、結果を統合する調整役 | 「ブログシステムを作る」という依頼を複数のモジュールに分割して、結果をまとめる |
| Subagent | タスクを委任され、独立したコンテキストでサブタスクを完了するAgent | コメント機能を実装し、テストまで作成するAgent |
| Advisor | 自ら作業はせず、重要な場面で専門的な助言を提供する役割 | メインAgentが行き詰まったとき、より高性能なモデルに解決策を相談する |
| Workflow | タスクの順序、並列実行、結果の受け渡しを管理する実行フロー | 「調査→実装→レビュー→不合格ならやり直し」という複数段階の処理 |
| Harness | モデルやツールを呼び出し、実行を管理する外部システム | 自作のスケジューリングコードやマネージドAgentプラットフォーム |
マルチAgentの3つの連携パターン
AnthropicのManaged Agentsドキュメントでは、マルチAgentの連携を3つのパターンに分類しています。それぞれ適した用途が異なります。
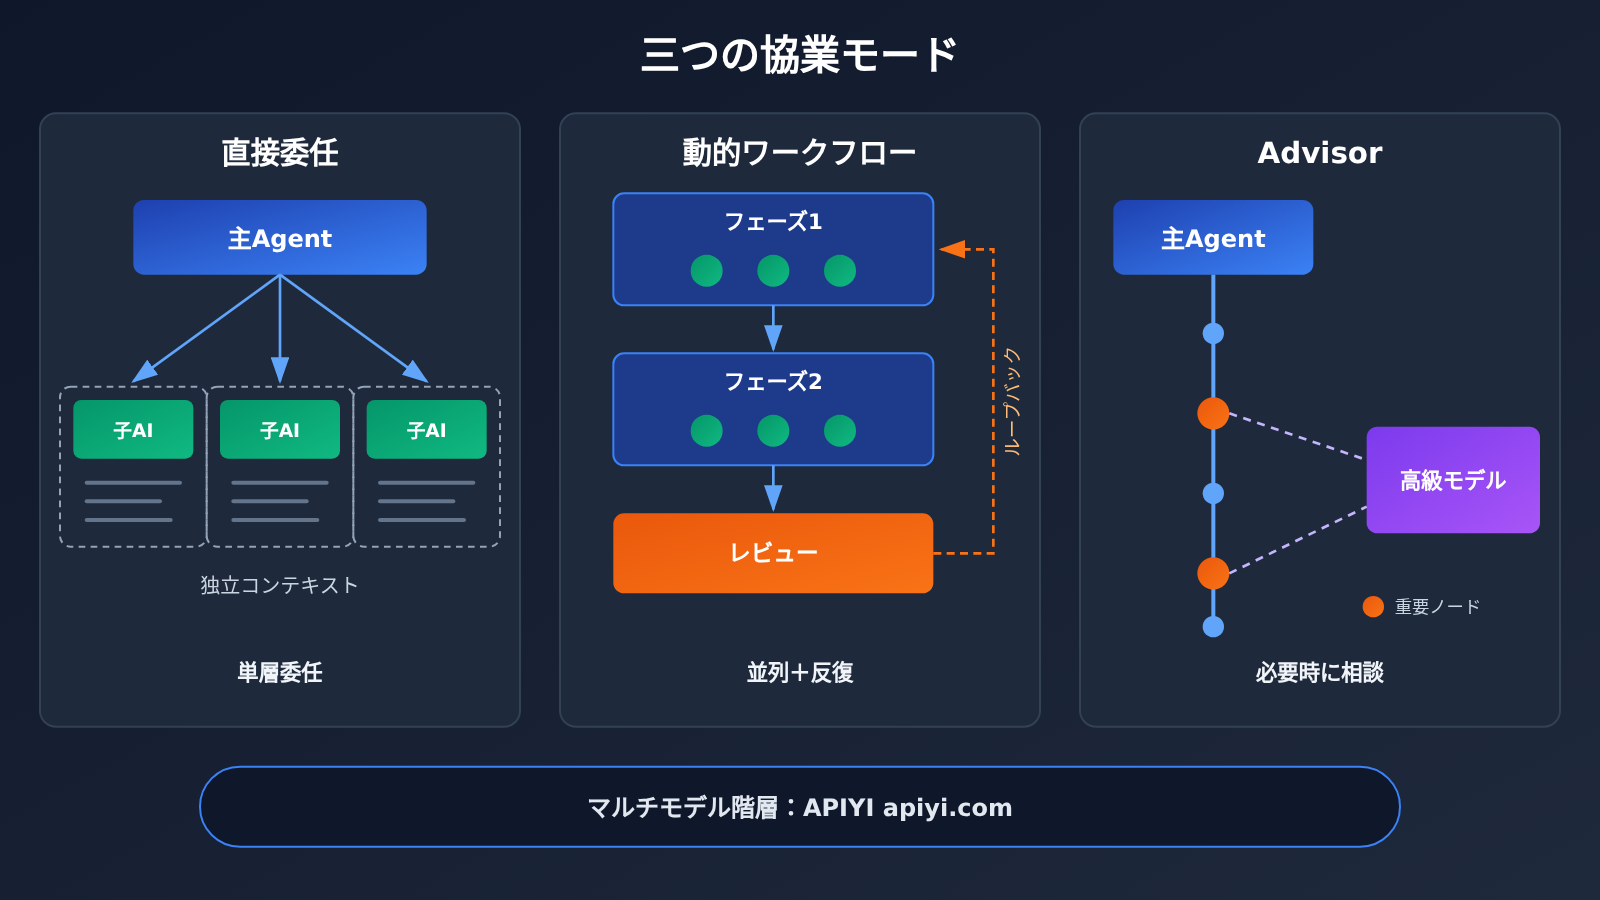
- Subagentへの直接委任:メインAgentが、どのSubagentを作成するか、どんなタスクを任せるか、いつ結果を確認するか、追加で質問するかを判断します。各Subagentは独立したSession Threadを持ちますが、委任は1階層までで、1つのSessionにつき直接の子スレッドは最大25個です。継続的なフォローが必要な少数の専門タスクに適しています。
- Dynamic Workflows(動的ワークフロー):メインAgentがSubagentを1つずつ管理するのではなく、ワークフローのプログラムを生成します。プログラムは処理を段階に分け、複数のAgentを並列実行し、結果を受け渡せます。また、結果に応じて次の段階を選択したり、レビューに通らなければ上限回数に達するまで再実行したりできます。大量のファイルレビューや、複数モジュールにまたがるコード移行などに適しています。
- Advisor(アドバイザー)モード:メインAgentが作業を続けながら、難しい場面や重要な判断が必要な場面で、より高性能なモデルに相談します。タスクを分割する必要がなく、連携にかかるコストを最小限に抑えられます。
3つの違いは、具体例で考えるとわかりやすくなります。たとえば、ECサイトの管理システムをPythonからGoに移行するとします。決済と在庫の2つのモジュールだけを移行するなら、直接委任で十分です。200個の独立したAPIを移行し、1つずつレビューするなら、動的ワークフローが向いています。エンジニア級のAgentが1つの作業を進めていて、データベースのトランザクション設計をときどき上位モデルに確認するだけなら、Advisorが最も効率的です。
Agentを増やすタイミング:マルチAgentタスクを適切に分割する方法
Anthropicは2026年1月23日の記事「Building multi-agent systems: When and how to use them」で、実際によくある現象を紹介しています。複雑なマルチAgentシステムの構築に数カ月を費やしたものの、最終的には、単一Agentのプロンプトを改善するだけでほぼ同等の成果が得られると分かったチームもあるそうです。だからこそ、最初に考えるべきなのは「いくつに分けるか」ではなく、常に「分けるべきか」です。
マルチAgentが真価を発揮する3つの場面
この記事によると、マルチAgentが安定して効果を発揮する場面は、主に次の3つです。
- コンテキストの分離:たとえば、カスタマーサポートAgentが大量の注文履歴を読んでから技術的な問題を診断する場合、注文データがコンテキストを圧迫し、判断を妨げることがあります。注文の照会を独立したAgentに任せ、必要な要約だけを返せば、メインAgentは集中力を保てます。
- 並列処理:地域ごとに市場を調査する、複数のファイルを並行してレビューする、異なるコードモジュールを同時に検査するといった作業です。Anthropicは、この種のアーキテクチャの主な価値は、必ずしも合計所要時間の短縮ではなく、タスクのカバー範囲や網羅性を高めることにあると指摘しています。
- 専門分野ごとの分担:AgentごとにSystem Prompt、ツール、MCP Server、Skills、モデルを使い分け、単一Agentに多くの役割を背負わせないようにします。
役割ではなく、コンテキストの境界で分ける
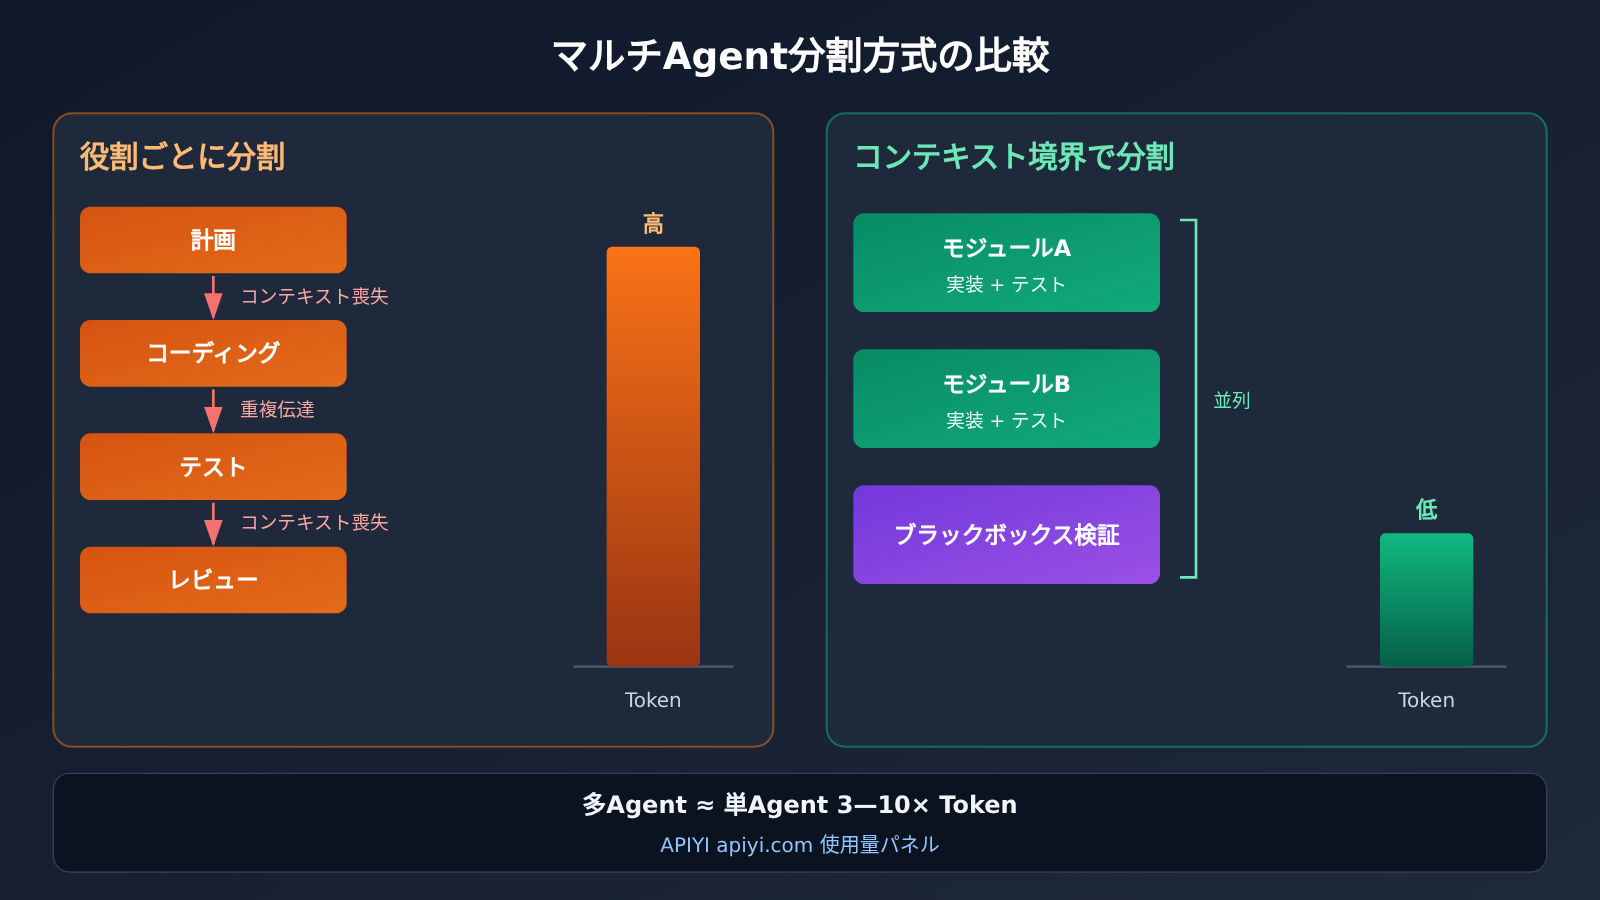
Anthropicが提唱する設計原則は、Context-centric decomposition、つまり問題の工程に機械的に沿って分けるのではなく、コンテキストの境界に沿って分けることです。多くのチームはまず「計画Agent+コーディングAgent+テストAgent+レビューAgent」と考えます。一見、役割分担の明確な開発チームのようですが、実際には大きな問題があります。
テストAgentはコードがそのように設計された理由を知らず、レビューAgentはそれまでの試行錯誤を把握していません。Agent間で情報が何度も受け渡されるため、「伝言ゲーム」のように内容が変わってしまうおそれがあります。より合理的なのは、1つのAgentに、実装と対応するテストを含む機能モジュール全体を任せ、別のAgentには独立したインターフェースを持つモジュールを担当させる方法です。さらに、3つ目のAgentにはブラックボックス検証だけを任せ、検証対象の成果物、明確な受け入れ基準、テストツールを渡します。
| タスクの種類 | マルチAgentとの相性 | 理由 |
|---|---|---|
| 複数地域を対象とした独立した市場調査 | 高い | サブタスク間で共有する情報がほとんどない |
| 大量の文書の並行レビュー | 高い | 文書ごとに独立して処理でき、最後にまとめられる |
| 異なるモジュールの独立開発 | 高い | インターフェースが明確であれば、自然にコンテキストの境界が生まれる |
| 独立したテストと検証 | 高い | ブラックボックス検証に必要なのは成果物と基準だけ |
| 密接に結合したコードの変更 | 低い | 1カ所の変更が複数箇所に影響し、引き継ぎコストも高い |
| 大量のリアルタイム状態を共有する必要があるタスク | 低い | 状態同期のコストが、並列化によるメリットを上回る可能性がある |
| 簡単な事実確認 | 通常は不要 | 単一Agentの1回の呼び出しで完了できる |
OSの実験に戻ると、カーネル、ドライバー、ファイルシステム、ウィンドウシステムの間には、比較的明確なモジュール境界があります。その点も、OSの実験が「複雑な業務システムの大規模なリファクタリング」より大規模な並列作業に向いている理由の1つです。もちろん、Anthropicは具体的な分担方法を公開していないため、これは妥当な推測として扱うべきで、事実と見なすことはできません。
マルチエージェントのコストが高くなる理由:Claude Fable 5.2時代のToken収支
タスクを多くのエージェントに分担して並列処理させれば、コストを抑えられると考える人は少なくありません。しかし、実際には逆の結果になることがよくあります。Anthropicが2026年1月に公開した記事では、同じタスクを処理する場合、マルチエージェント構成では通常、単一エージェントの3〜10倍のTokenを使用すると明確に指摘されています。
追加のTokenは、主に5つの要因から発生します。各エージェントがそれぞれ独自のコンテキストを構築すること、エージェント間でタスクの説明や結果をやり取りすること、メインエージェントが複数のサブエージェントの出力を読み、要約すること、タスクの分解自体に追加の呼び出しが必要になること、そして複数のエージェントが同じ作業を重複して行う可能性があることです。
2つのコストデータは、比較対象がまったく異なる
マルチエージェントのコストについて議論するとき、異なる情報源のデータが混同されることがあります。以下の表では、それぞれを分けて整理しています。
| データの出典 | 指標 | 比較対象 |
|---|---|---|
| 2026年1月「Building multi-agent systems」 | マルチエージェントのToken消費量は、単一エージェントの3〜10倍 | 同じタスクを処理する単一エージェント |
| 2025年6月のAnthropic Researchシステム | Token消費量は通常のチャットの約15倍 | 通常のチャット |
| 2025年6月のAnthropic Researchシステム | 内部のResearch Evalでは、単一エージェントのOpus 4を90.2%上回る | 単一エージェントのOpus 4。特定の社内評価 |
| 2025年6月のAnthropic Researchシステム | 複雑なクエリの調査時間を最大約90%短縮。初期の代表的な並列数はサブエージェント3〜5個 | 同システムでの単一スレッド調査 |
90.2%と15倍という数値は、いずれも2025年のResearchシステムに関するものです。前者は特定の社内評価における相対的な性能であり、あらゆるタスクで精度が90.2%向上することを意味するわけではありません。これらは2026年のオペレーティングシステム実験とは関係がなく、3〜10倍という数値と直接比較することもできません。
総計算量、実行時間、カバレッジはそれぞれ別の指標
マルチエージェントのコストを理解するには、3つの指標を区別する必要があります。コンテキストが複製され、結果が何度も読み返されるため、総計算量は通常増加します。一方、サブタスクが本当に互いに独立していれば、実行時間は短縮する可能性があります。また、複数のエージェントが同時により多くの方向を探索できるため、タスクのカバレッジは広がる傾向があります。
公式APIの料金に基づいて試算すると、Fable 5.2の通常モードは入力が100万Tokenあたり8ドル、出力が100万Tokenあたり40ドルです。Batch APIでは50%の割引が適用され、キャッシュ読み取りは1 MTokあたり0.20ドルです。単一エージェントのタスクで相当量のTokenを消費する場合、消費量が3〜10倍になれば、コストの差は非常に大きくなります。Anthropicはオペレーティングシステム実験の実際の請求額を公表していないため、「8日間でいくらかかった」といった主張には根拠がありません。
信頼性の高いマルチエージェントシステムの設計方法:Claude Fable 5.2から学ぶエンジニアリング手法
モデルの使い分け:すべての Agent に最強モデルが必要なわけではない
Managed Agents では、Agent を2つの方法で定義できます。Predefined Agent は事前に設定しておく Agent で、それぞれ独自のモデル、System Prompt、ツール、MCP Server、Skills を設定できます。一方、Inline Agent は実行時に動的に定義され、デフォルトではメイン Agent のモデルとツール設定を引き継ぎます。
つまり、コストと能力に応じて役割を分けられます。たとえば、調整役や複雑なレビューには Fable 5.2 のような高性能モデルを使い、通常の情報検索には Sonnet クラス、単純な分類には Haiku クラスのモデルを使う方法があります。これはあくまで設計例であり、Anthropic が定めた固定のアーキテクチャではありません。実際のタスクに合わせてテストし、調整する必要があります。
検証:レビュー Agent は実際の検証とは異なる
Anthropic は Fable 5.2 の Prompting ドキュメントで、新たな変化について触れています。xhigh や max など、Effort を高く設定すると、Fable 5.2 は自ら Subagent を呼び出して作業をチェックします。一方、Fable 5.1 は同じテストタスクでそのような動作をしませんでした。これはオーケストレーション能力の進歩ですが、品質保証とみなすことはできません。
レビュー Agent が行うのは、あくまでモデルによる判断です。本当に信頼できる検証には、明確な受け入れ基準、実行可能なブラックボックステスト、コードや外部システムへの変更を実際に確認する仕組み(テストの実行やサービスの起動など)の3つが必要です。OS の実験で最も説得力があるのは、「実際のノート PC で起動できる」という明確な成果であり、Agent が「問題なさそうです」と言うことではありません。
過剰な委任とルールの積み重ねを防ぐ
Agent がタスクを委任するかどうかは、モデルの能力だけでなく、Harness やツールの説明にも左右されます。Anthropic のテストでは、Subagent ツールの説明に「各子 Agent の追加コスト」「委任に適したタスクと適さないタスク」「タスクの説明方法」を明記したところ、委任する理由だけを強調した場合に比べ、短いタスクでの委任頻度が約3分の1に減りました。一方で、タスクの成功率は変わりませんでした。
見落とされがちなもう一つの問題は、ルールの積み重ねです。Fable 5.2 は、コンテキスト内に蓄積された制限的な指示に比較的忠実に従います。過去のファイル、Reviewer の意見、System Prompt に禁止事項が次々と追加されると、本来は許可されている操作まで日常業務で実行しなくなる可能性があります。そのため、Agent のメモリ、ルール、承認要件を定期的に整理する必要があります。
実行時の制限:公開製品における現実的な上限
公開製品でも、「1000 個の Agent」には明確な制限があります。以下は Managed Agents のドキュメントに記載された制限です。公開製品に関するものであり、社内の OS 実験でも同じスケジューラーが使われていたことを示すものではありません。
| 指標 | 制限 |
|---|---|
| 直接の Subagent 子スレッド | 最大 25 個 |
| Dynamic Workflow の同時実行ワーカー数 | 64 個 |
| 1つの Workflow のライフサイクル中に起動できる Agent 数 | 1000 個 |
| Workflow のデフォルトのライフサイクル | 24 時間 |
| 1つの Session で同時に開ける Workflow 数(デフォルト) | 10 個 |
また、Workflow 内の Agent は、さらにネストした Workflow を作成できません。予算に達すると、実行中の Workflow は一時停止します。Agent が失敗した場合、通常はシステムが1回再試行し、それでも失敗した場合は Workflow が対応を決定します。つまり、1000 個というのは「ライフサイクル中に起動できる累計数」であり、同時に稼働している Agent はそれよりはるかに少ないということです。
長時間実行では、ユーザー体験にも課題があります。Fable 5.2 は長時間のツール呼び出し中、ユーザー向けのテキストをほとんど出力しないことがあり、タスクが止まったと誤解される可能性があります。公式には、thinking.display: "updates" を有効にするか、ツール呼び出しが何度か続いた後に Harness からモデルへ進捗の報告を促す方法が推奨されています。公式テストでは、進捗を促すメッセージを追加したところ、フィードバックが途切れる時間の最長値がおよそ半分に短縮されました。
マルチエージェント入門:Claude Fable 5.2 で最小限のオーケストレーターを構築する
ここでは、ホスティングプラットフォームを使わず、OpenAI互換インターフェースで基本的な手順を紹介します。まずは、調整役のモデルがコンテキストの境界に沿ってタスクを分割する仕組みを作ります。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYIのOpenAI互換インターフェース
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # プラットフォームのモデル一覧に表示される実際の名称を使用
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
完全版では、モデルの使い分け、並列実行、トークン予算、1回の失敗時リトライ、ブラックボックス方式の受け入れ確認を加えています。構成は、前述したエンジニアリング手法に対応しています。
マルチエージェントの完全なオーケストレーション例を表示
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # 1つのキーで複数のモデルを呼び出す
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # 調整とレビューには高性能モデルを使用
WORKER_MODEL = "your-fast-model"          # サブタスクにはより高速で低コストなモデルを使用。必要に応じて置き換え
TOKEN_BUDGET = 200_000                     # タスク全体のトークン予算
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # 各サブエージェントには必要なコンテキストだけを渡し、失敗したら1回再試行する
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # ブラックボックス方式の受け入れ確認:成果物と基準だけを渡し、探索過程は渡さない
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # 同時実行数を制御
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
このコードは構成を示すための例にすぎず、レビューもモデルによる判定です。本番環境では、review を実際のテスト実行に置き換えるか、テストを追加して補完してください。たとえば、ユニットテストの実行や、サービスを起動してインターフェースを確認する方法があります。
🚀 すぐに試すためのヒント:マルチエージェントのポイントは、役割ごとに異なるモデルを使い、利用状況をいつでも比較できるようにすることです。APIYI(apiyi.com)を利用すれば、1つのAPIキーでClaude、OpenAI、Geminiなどのモデルに接続できます。まずは新規ユーザー向けの無料テスト枠で単一エージェントの基準を確認し、そこから段階的に協調処理を追加していくのがおすすめです。
マルチエージェント協業が開発者に与える影響
開発者への影響
- まずは単一エージェントから始める:単一エージェントに適切なプロンプトを与えて基準を作りましょう。コンテキストの汚染、サブタスクの独立した並列処理、専門的な設定の必要性という3つのボトルネックが生じた場合に限り、協業の仕組みを追加します。
- インフラを重要な要素として捉える:モデルAPI、ツールAPI、予算上限、同時実行制御、呼び出しログが、マルチエージェントシステムの安定稼働を左右します。ログがなければ、どのサブエージェントが同じ作業を繰り返しているのか特定できません。
- 複数モデルの使い分けが当たり前になる:調整役、実行役、レビュー役に異なるモデルを使うことは、コストが3〜10倍に膨らむのを抑える主な手段の一つです。
業界への影響
- AIの能力の境界が広がる:「一つのプログラミングタスクを完了する」段階から、「長期的なソフトウェア開発プロジェクトを組織する」段階へと移りつつあります。Vercel、Shopify、Datadogなど、初期テストに参加したパートナーからのフィードバックも、この変化を示しています。たとえばDatadogのエンジニアは、より高速なモデルにタスクを割り振る「インシデント指揮官」のような存在だと表現しました。ただし、これらは発表時に公開されたパートナーの声であり、独立したブラインドテストの結果ではありません。
- エージェントの数より、オーケストレーション能力が重要:タスクの並列化のしやすさ、調整にかかるオーバーヘッド、共有状態、コードの競合、テストカバレッジ、呼び出しコストが合わさって、マルチエージェントの実際の効率が決まります。
よくある質問(FAQ)
Q1: Claude Fable 5.2 の 1000 Agent 実験では、実際に何ができたのですか?
Anthropic の発表によると、Fable 5.2 は空のフォルダーからスタートし、1000 を超えるサブ Agent を連携させて 8 日間連続で作業させました。その結果、実際のノートパソコンで起動できる OS のプロトタイプが完成しました。カーネル、ドライバー、ファイルストレージ、ウィンドウシステム、ログイン画面、インストーラーが含まれています。公式には「動作するプロトタイプ」と位置づけられていますが、ソースコード、コード量、総 Token 数、コストは公開されておらず、第三者による監査も行われていません。
Q2: マルチ Agent は必ずシングル Agent より優れていますか?
そうとは限りません。Anthropic は、マルチ Agent が常にシングル Agent より優れているわけではないと明言しています。数カ月かけてマルチ Agent システムを構築したチームが、最終的にシングル Agent のプロンプトを最適化するだけで、ほぼ同等の成果が得られると分かった例もあります。同じタスクの場合、マルチ Agent はシングル Agent の 3~10 倍の Token を消費するのが一般的です。安定した効果が見込めるのは、コンテキストの分離、並列処理、専門性に応じた分業という 3 つの場面に限られます。
Q3: 90.2% の向上と 15 倍の Token 消費を、Fable 5.2 の評価に使えますか?
使えません。この 2 つの数字は、2025 年 6 月に発表された Anthropic Research システムのものです。90.2% は特定の内部 Research Eval における、シングル Agent の Opus 4 と比べた性能で、15 倍という数字の比較対象は通常のチャットです。これらは 2026 年の Fable 5.2 による OS 実験とは関係がなく、「同じタスクで 3~10 倍」というデータと混同することもできません。
Q4: API を使って、自分のマルチ Agent プロトタイプを手早く構築するにはどうすればよいですか?
次の手順がおすすめです。
1. APIYI apiyi.com に登録し、APIキーと無料のテストクレジットを取得する
2. この記事のコードにある `base_url` を `https://api.apiyi.com/v1` に設定する
3. まずシングル Agent のベースラインを実行し、Token 数と成功率を記録する
4. 次に、コーディネーターとサブ Agent に異なるモデルを割り当て、コストと品質の変化を比較する
Q5: マルチ Agent のコストを抑えるにはどうすればよいですか?
ポイントは 4 つです。コンテキストの境界に沿ってタスクを分割し、情報の受け渡しを減らすこと。サブタスクには、より高速で低コストなモデルを使い、計画や重要なレビューに限って高性能モデルを使うこと。ツールの説明に委任コストと、委任する価値のないタスクを明記し、過剰な委任を防ぐこと。そして、全体の Token 予算と同時実行数の上限を設定することです。バッチで実行するオフラインタスクには Batch API の割引を活用できます。日常的な呼び出しでは、APIYI apiyi.com の従量課金と使用量の統計を利用すると、コストを細かく把握できます。
Q6: マルチ Agent システムには、現時点でどのような制約がありますか?
1 つ目はコストです。同じタスクでも、Token 消費量は通常 3~10 倍になります。2 つ目はスケジューリングの上限です。公開されている Managed Agents では、直接の子スレッド数は最大 25、Workflow の同時実行スレッド数は 64、ライフサイクル全体で起動できるスレッド数は累計 1000 が上限です。3 つ目は検証です。レビュー Agent がいるからといって、実際のテストが不要になるわけではありません。4 つ目は、ルールの蓄積や長時間フィードバックがないといった使用感の問題です。ルールを定期的に整理し、進捗の更新を有効にする必要があります。
Claude Fable 5.2のマルチAgent協業における重要ポイント
- 数が多ければ効率が上がるわけではない:1000個のAgentの価値を決めるのは、数そのものではなく、組織化する能力です
- 役割を明確にする:Orchestratorは調整、Subagentは実行、Advisorは提案、Workflowはプロセス管理を担当します
- コンテキストの境界に沿って分割する:1つのAgentにモジュール全体とテストを任せ、役割ごとに伝言を回すことで生じる情報の劣化を避けましょう
- コストを把握する:同じタスクを複数のAgentで処理すると、通常は単一Agentの場合の3〜10倍のTokenが必要です
- 検証を実際に行う:レビュー用Agentだけでなく、受け入れ基準と実際のテストも欠かせません
- 単一Agentから始める:実際のボトルネックが見えてから協業レイヤーを加えましょう。APIYI apiyi.comで複数モデルに接続し、段階的にテストする方法もあります
まとめ
Claude Fable 5.2を使ったOS実験から、次のことが分かります。
- オーケストレーション能力が新たなハードルに:Fable 5.2の進歩は、調整役としての能力が高まった点にあります。高いEffort設定では、自分の作業を見直すために自らSubagentを呼び出すこともできます
- マルチAgentには明確な適用範囲がある:コンテキストの分離、並列処理、専門性を活かした分業には分割する価値があります。一方、密接に連携するタスクや簡単な問い合わせは、分割する必要がありません
- コスト、並行処理、検証が3つの厳しい制約に:Tokenの増加、スケジューリングの上限、実際のテストによって、システムを長期的に運用できるかが決まります
多くの開発者にとって、まず単一Agentで基準を確立し、実際のボトルネックに応じてSubagent、Workflow、Advisorを導入していくのが適切です。同時に、モデルAPI、予算、並行処理、ログもきちんと整備しましょう。API基盤こそが、マルチAgentアプリケーションを支える土台です。
マルチAgentの構成をすばやく検証するには、APIYI apiyi.comの利用がおすすめです。OpenAI互換の統一インターフェースと、新規ユーザー向けの無料テスト枠が用意されているため、異なるモデルの役割分担を比較しやすくなります。
📚 参考資料
- Anthropic公式発表:Claude Fable 5.2 and Mythos 5.2(2026-11-09)
- リンク:
anthropic.com/claude-fable-and-mythos-5-2 -
説明:OS実験、プログラミング評価、価格に関する一次情報
-
Building multi-agent systems: When and how to use them:マルチエージェントの適用シーンとコスト(2026-01-23)
- リンク:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
説明:トークン数が3~10倍になるデータと、コンテキストの境界に基づいて分割する原則
-
How we built our multi-agent research system:AnthropicのResearchシステム(2025-06-13)
- リンク:
anthropic.com/research/multi-agent-research-system -
説明:Orchestrator-Workerアーキテクチャ、内部評価での90.2%のスコア、トークン数が15倍になるデータ
-
Managed AgentsのマルチエージェントオーケストレーションとWorkflowに関するドキュメント:協調パターンと実行制限
- リンク:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
説明:Subagents、Dynamic Workflows、Advisorの定義と同時実行数の上限
-
Prompting Claude Fable 5.2:公式プロンプトエンジニアリングガイド
- リンク:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
説明:自己レビューの挙動、過剰な委任に関する実験、進捗報告の提案
-
Fable 5.2モデル仕様ドキュメント:コンテキスト、出力上限、料金
- リンク:
platform.claude.com/docs/en/models/fable-5-2/overview - 説明:100万トークンのコンテキスト、最大128Kの出力、API Model ID
著者: APIYI技術チーム
技術交流: マルチエージェントアーキテクチャやマルチモデル接続の実践について、APIYI(apiyi.com)のトップページからお気軽にお問い合わせください。


