
El 9 de noviembre de 2026, Anthropic presentó Claude Fable 5.2 y dio a conocer un experimento interno. El experimento partió de una carpeta vacía: Fable 5.2 coordinó a más de 1000 subagentes, trabajó durante 8 días seguidos y terminó creando un prototipo de sistema operativo que puede arrancar en una computadora portátil.
Valor principal: este artículo no repite el discurso promocional. A partir de la información pública de Anthropic sobre ingeniería multiagente, explica las funciones de Orchestrator, Subagent, Advisor y Workflow; cómo dividir las tareas; por qué aumentan los costos, y cómo diseñar la fiabilidad. Al final, incluye una lista de prácticas que los desarrolladores pueden aplicar directamente.
Resumen de los datos clave del experimento del sistema operativo Claude Fable 5.2
Primero, distingamos los hechos confirmados de la información que aún no se ha revelado. Es un paso fundamental para entender los retos de la colaboración multiagente.
| Elemento | Detalles |
|---|---|
| Fecha de presentación | 9 de noviembre de 2026, junto con Claude Fable 5.2 |
| Empresa | Anthropic |
| Punto de partida del experimento | Una carpeta vacía; el objetivo era diseñar e implementar un prototipo de sistema operativo |
| Escala de ejecución | Más de 1000 subagentes trabajaron durante 8 días seguidos, las 24 horas, escribiendo, probando, revisando y modificando código |
| Resultado final | Un sistema prototipo que incluye kernel, controladores de disco/teclado/red, almacenamiento persistente de archivos, sistema de ventanas, pantalla de inicio de sesión, instalador y funciones integradas de Claude; puede arrancar en una computadora portátil real |
| Información no revelada | Estructura de distribución de tareas entre agentes, Harness, protocolo de comunicación, cantidad de código, lenguaje de programación, consumo total de tokens, costo del experimento y auditorías de seguridad externas |
La descripción oficial es “prototipo de sistema operativo funcional” (working prototype operating system), no un sistema operativo comercial maduro. También hay que tener en cuenta que, en ese mismo periodo, Anthropic dio a conocer otros experimentos. Por ejemplo, en uno relacionado con el último teorema de Fermat mencionó una estructura de “1 Lead + 999 Helpers”. Sin embargo, se trataba de un experimento independiente y no se puede asumir que se aplicara al proyecto del sistema operativo.
Lo más interesante de este experimento no es la cantidad de código escrito, sino la capacidad del modelo para organizar un proyecto de ingeniería de software de largo recorrido durante 8 días: dividir tareas, avanzar en paralelo, integrar resultados, detectar errores y organizar las correcciones. Esto nos lleva a la pregunta central del artículo: detrás de 1000 agentes, el verdadero reto es la organización.
Cómo funciona la colaboración multiagente: división de roles detrás de Claude Fable 5.2
Antes de hablar de «si conviene usar varios agentes», hay que aclarar algunos conceptos que suelen confundirse. La siguiente tabla resume las ideas de la documentación de Anthropic Managed Agents.
| Concepto | Función | Ejemplo típico |
|---|---|---|
| Agent | Agente capaz de ejecutar tareas y usar herramientas | Un asistente de programación que puede leer código y ejecutar pruebas |
| Orchestrator | Coordinador que asigna tareas e integra resultados | Divide «crear un sistema de blogs» en varios módulos y reúne los resultados |
| Subagent | Agente al que se le delega una subtarea y que tiene su propio contexto | Se encarga de implementar el módulo de comentarios y preparar sus pruebas |
| Advisor | No realiza el trabajo directamente; ofrece asesoramiento especializado en momentos clave | Cuando el agente principal se atasca, consulta a un modelo más potente |
| Workflow | Proceso que organiza el orden de las tareas, la ejecución en paralelo y la entrega de resultados | Un proceso por etapas: «investigar → implementar → revisar → repetir si no se aprueba» |
| Harness | Sistema externo que invoca modelos y herramientas y gestiona la ejecución | Código de orquestación propio o una plataforma de agentes gestionados |
Tres modos de colaboración multiagente
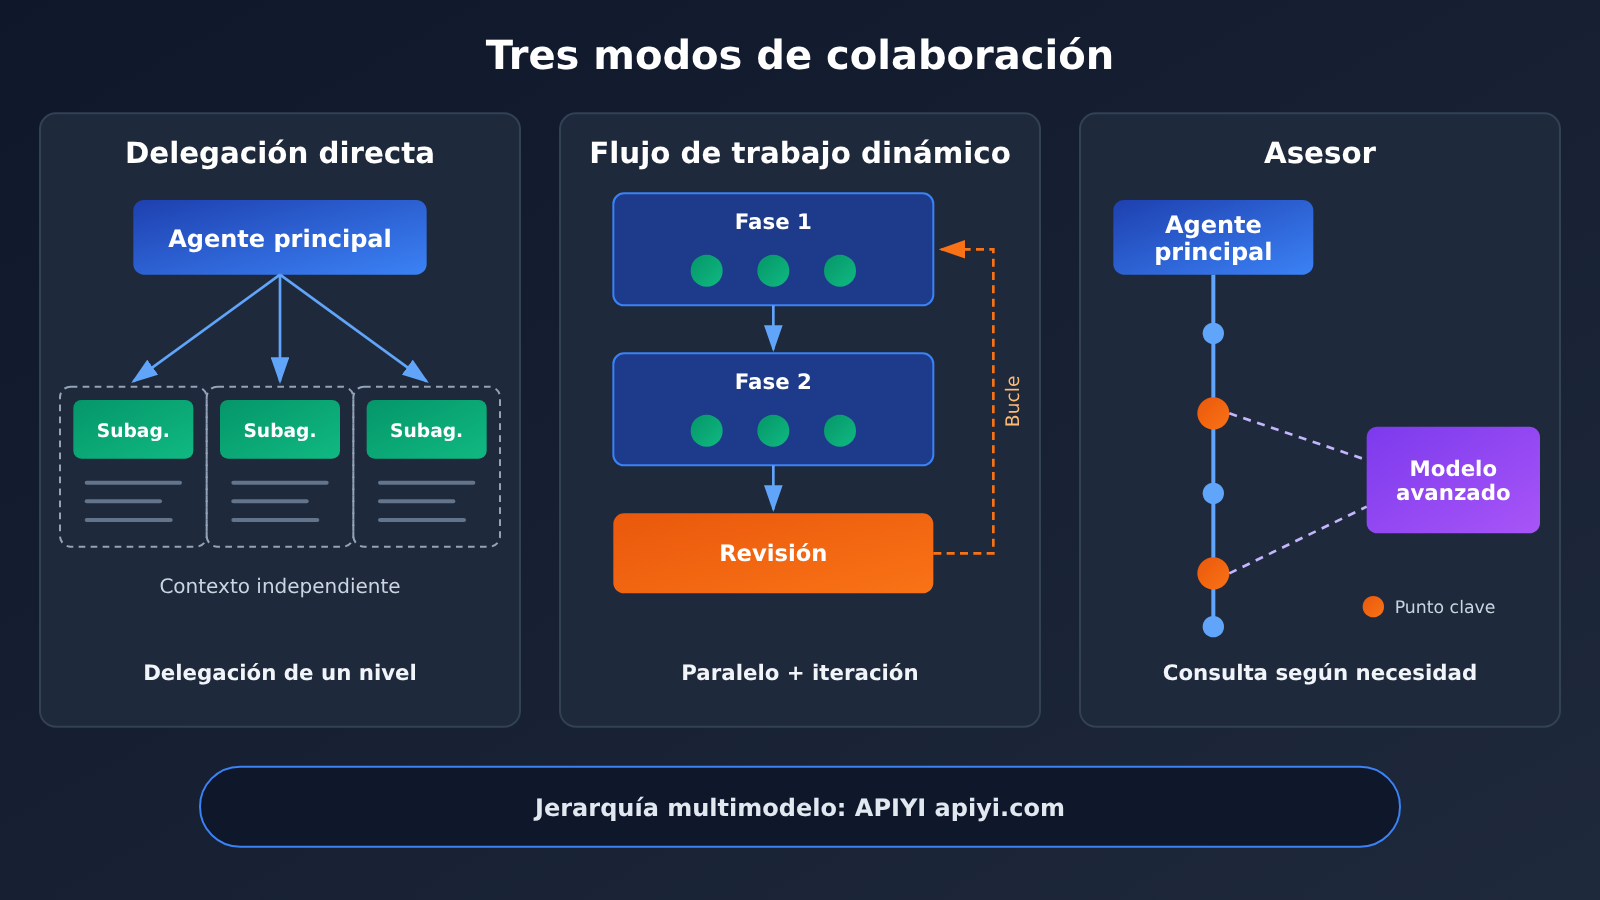
La documentación de Anthropic Managed Agents divide la colaboración multiagente en tres modos, cada uno adecuado para distintos escenarios.
- Delegación directa a subagentes: el agente principal decide qué subagentes crear, qué tareas asignarles, cuándo consultar los resultados y si necesita hacer preguntas adicionales. Cada subagente tiene su propio Session Thread, pero la delegación solo tiene un nivel: una sola sesión puede tener como máximo 25 subprocesos directos. Es una opción adecuada para unas pocas tareas especializadas que requieren seguimiento continuo.
- Dynamic Workflows (flujos de trabajo dinámicos): el agente principal deja de gestionar los subagentes uno por uno y genera un programa de flujo de trabajo. El programa puede dividir las tareas en etapas, ejecutar varios agentes en paralelo, transmitir resultados, elegir la siguiente etapa según esos resultados y repetir la ejecución si una revisión no se aprueba, hasta alcanzar el límite de iteraciones. Es una opción adecuada para tareas como revisar grandes cantidades de archivos o migrar código de varios módulos.
- Modo Advisor: el agente principal sigue realizando el trabajo directamente y solo consulta a un modelo más potente en los puntos difíciles o críticos. Su ventaja es que no hace falta dividir la tarea, por lo que los costos de coordinación son mínimos.
Un ejemplo concreto ayuda a entender las diferencias. Supongamos que hay que migrar de Python a Go el backend de una tienda en línea: si solo se migran los módulos de pagos e inventario, basta con la delegación directa; si hay que migrar y revisar uno por uno 200 endpoints independientes, conviene un flujo de trabajo dinámico; si el trabajo lo realiza un agente con nivel de ingeniería y solo necesita consultar ocasionalmente a un modelo avanzado sobre el diseño de las transacciones de la base de datos, el modo Advisor es la opción más rentable.
Cuándo añadir agentes: cómo dividir correctamente las tareas entre varios agentes
En su artículo «Building multi-agent systems: When and how to use them», publicado el 23 de enero de 2026, Anthropic señala un fenómeno real: algunos equipos pasan meses creando sistemas multiagente complejos y, al final, descubren que mejorar la indicación de un solo agente ofrece resultados similares. Por eso, la primera pregunta siempre debería ser «¿conviene dividir la tarea?», no «¿en cuántas partes?».
Tres situaciones en las que los sistemas multiagente aportan valor de verdad
Según el artículo, hay tres tipos de situaciones en las que los sistemas multiagente pueden aportar valor de forma consistente:
- Aislamiento del contexto: por ejemplo, un agente de atención al cliente lee primero un largo historial de pedidos y después diagnostica un problema técnico. Los datos de los pedidos ocupan espacio en la ventana de contexto y pueden interferir en el análisis. Si un agente independiente se encarga de consultar los pedidos y devuelve solo un resumen con lo necesario, el agente principal puede centrarse mejor.
- Procesamiento en paralelo: investigar mercados de distintas regiones, revisar varios documentos a la vez o comprobar diferentes módulos de código en paralelo. Anthropic destaca que, en este tipo de arquitectura, el principal beneficio suele ser ampliar la cobertura y la exhaustividad de la tarea, no garantizar que el tiempo total sea menor.
- Especialización: configurar distintos agentes con indicaciones del sistema, herramientas, servidores MCP, Skills y modelos diferentes para evitar que un solo agente tenga que asumir demasiadas responsabilidades.
Dividir por límites de contexto, no por roles
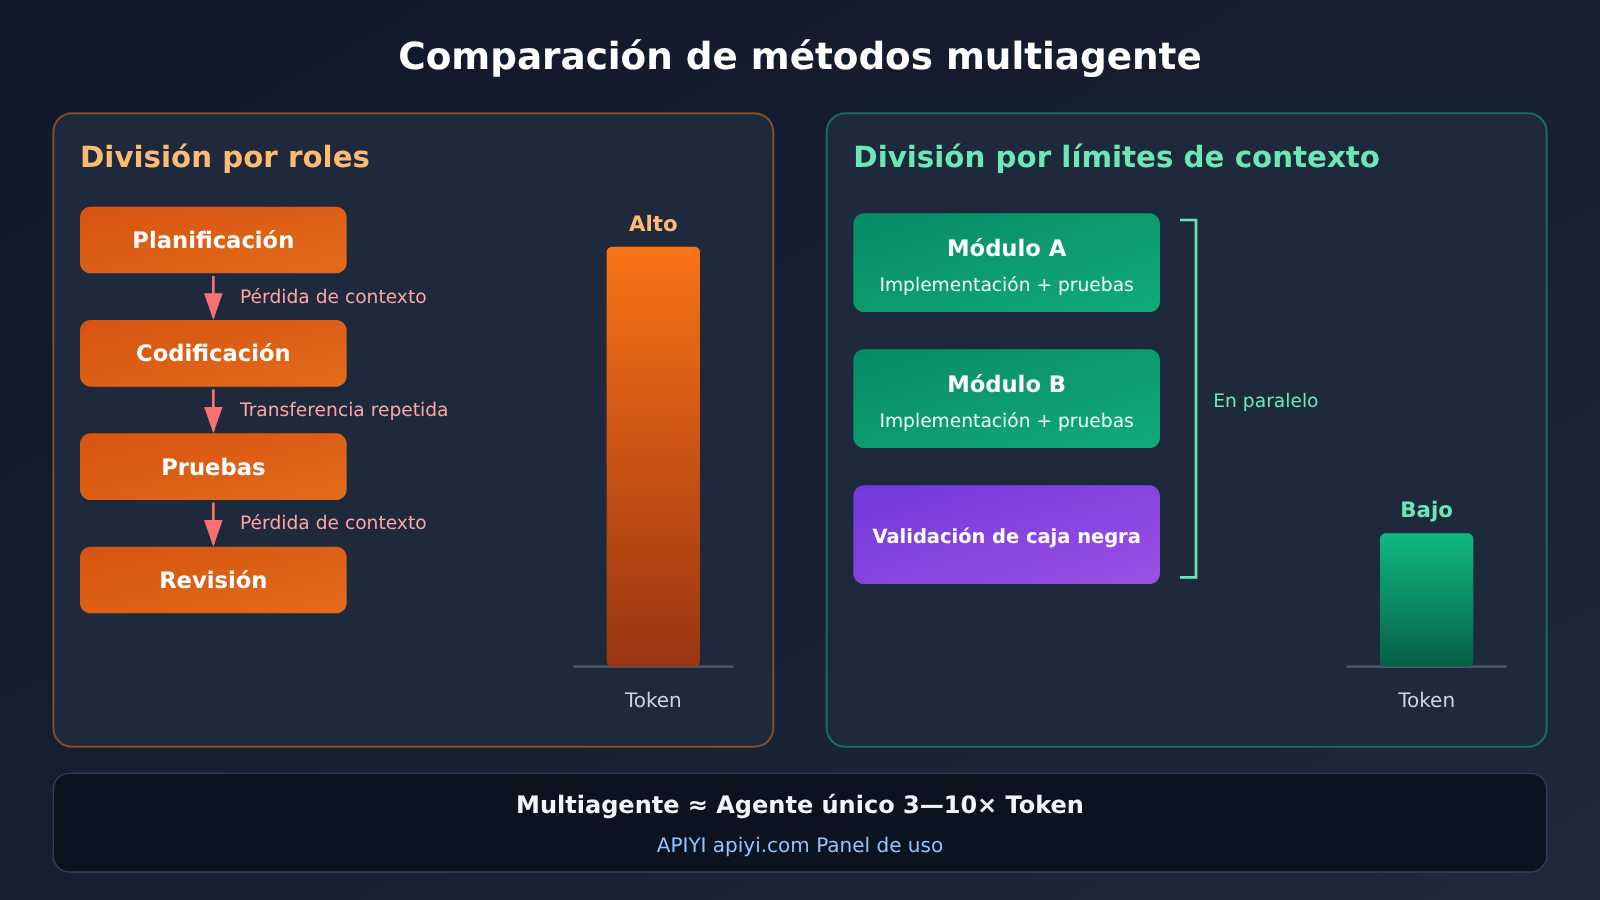
El principio de diseño que propone Anthropic es la descomposición centrada en el contexto (Context-centric decomposition): dividir según los límites del contexto, en lugar de hacerlo mecánicamente por etapas. La primera idea de muchos equipos es crear un «agente de planificación + agente de programación + agente de pruebas + agente de revisión». Parece un equipo de desarrollo con responsabilidades bien definidas, pero en la práctica presenta problemas importantes.
El agente de pruebas no sabe por qué se diseñó el código de esa manera y el agente de revisión desconoce el proceso de exploración previo. La información se transmite una y otra vez entre agentes y puede distorsionarse, como en el juego del teléfono. Un enfoque más sensato sería asignar a un agente un módulo funcional completo, incluida su implementación y las pruebas correspondientes; a otro, un módulo con una interfaz independiente; y a un tercero, únicamente la verificación de caja negra, con los resultados que debe validar, criterios de aceptación claros y herramientas de prueba.
| Tipo de tarea | Idoneidad para varios agentes | Motivo |
|---|---|---|
| Investigación de mercado independiente en varias regiones | Alta | Las subtareas apenas comparten información |
| Revisión en paralelo de muchos documentos | Alta | Cada documento puede procesarse por separado y resumirse al final |
| Desarrollo independiente de distintos módulos | Alta | Cuando las interfaces están claras, los límites de contexto surgen de forma natural |
| Pruebas y verificación independientes | Alta | Para la verificación de caja negra solo hacen falta los resultados y los criterios |
| Cambios en código muy acoplado | Baja | Un cambio puede afectar a muchas partes y el coste de coordinación es elevado |
| Tareas que requieren compartir mucho estado en tiempo real | Baja | El coste de sincronización puede superar las ventajas del paralelismo |
| Consultas sencillas sobre hechos | Normalmente no hace falta | Un solo agente puede resolverlas en una invocación |
Volviendo al laboratorio de sistemas operativos, entre el kernel, los controladores, el sistema de archivos y el sistema de ventanas hay límites entre módulos relativamente claros. Esta es también una de las razones por las que resulta más adecuado para trabajar en paralelo a gran escala que la «refactorización a gran escala de un sistema empresarial complejo». Eso sí, Anthropic no ha publicado cómo organizó concretamente el trabajo, así que esta explicación es una hipótesis razonable, no un hecho confirmado.
Por qué los sistemas multiagente cuestan más: el balance de tokens en la era de Claude Fable 5.2
Mucha gente supone que repartir una tarea entre más agentes para que trabajen en paralelo reduce los costos. En la práctica, suele ocurrir lo contrario. En un artículo de enero de 2026, Anthropic señaló claramente que para una misma tarea, una arquitectura multiagente suele consumir entre 3 y 10 veces más tokens que una arquitectura con un solo agente.
El consumo adicional de tokens se debe principalmente a cinco factores: cada agente tiene que crear su propio contexto; los agentes intercambian descripciones de tareas y resultados; el agente principal debe leer y resumir las respuestas de varios subagentes; desglosar la tarea genera llamadas adicionales; y varios agentes pueden acabar repitiendo parte del trabajo.
Dos conjuntos de datos con referencias distintas
Al hablar de los costos de los sistemas multiagente, es común mezclar datos de distintas fuentes. Esta tabla los presenta por separado:
| Fuente de los datos | Métrica | Referencia de comparación |
|---|---|---|
| «Building multi-agent systems», enero de 2026 | El consumo de tokens multiagente es entre 3 y 10 veces el de un solo agente | Un solo agente que realiza la misma tarea |
| Sistema Anthropic Research, junio de 2025 | El consumo de tokens es aproximadamente 15 veces el del chat normal | Chat normal |
| Sistema Anthropic Research, junio de 2025 | Research Eval interno supera en un 90,2 % a Opus 4 con un solo agente | Opus 4 con un solo agente, en una evaluación interna específica |
| Sistema Anthropic Research, junio de 2025 | El tiempo de investigación de consultas complejas se reduce hasta aproximadamente un 90 %; al principio, lo habitual era trabajar en paralelo con 3–5 subagentes | Investigación en un solo hilo con el mismo sistema |
Conviene subrayar que las cifras del 90,2 % y de 15 veces proceden ambas del sistema Research de 2025. La primera solo refleja el rendimiento relativo en una evaluación interna específica; no significa que la precisión mejore un 90,2 % en todas las tareas. Estas cifras no guardan relación con los experimentos de sistemas operativos de 2026 y tampoco se pueden comparar directamente con el factor de 3 a 10 veces.
El cómputo total, el tiempo de ejecución y la cobertura son tres cosas distintas
Para entender los costos de los sistemas multiagente, hay que distinguir tres métricas. El cómputo total suele aumentar, porque se duplica el contexto y los resultados se leen varias veces. El tiempo de ejecución puede reducirse, siempre que las subtareas sean realmente independientes. Y la cobertura de la tarea suele aumentar, porque varios agentes pueden explorar más opciones al mismo tiempo.
Si hacemos una estimación con las tarifas oficiales de la API, Fable 5.2 en modo estándar cuesta 8 dólares por millón de tokens de entrada y 40 dólares por millón de tokens de salida. La API Batch ofrece un descuento del 50 %, y las lecturas de caché cuestan 0,20 dólares por MTok. Si una tarea con un solo agente ya consume una cantidad considerable de tokens, al multiplicarla por 3–10 la diferencia se vuelve muy notable. Anthropic no ha publicado la factura real de los experimentos de sistemas operativos, así que cualquier afirmación sobre «cuánto costaron 8 días» carece de fundamento.
Cómo diseñar un sistema multiagente fiable: métodos de ingeniería aprendidos de Claude Fable 5.2
Jerarquía de modelos: no todos los agentes necesitan el modelo más potente
Managed Agents admite dos formas de definir agentes. Predefined Agent se configura de antemano y puede tener su propio modelo, System Prompt, herramientas, MCP Server y Skills. Inline Agent se define dinámicamente durante la ejecución y, de forma predeterminada, hereda la configuración del modelo y las herramientas del agente principal.
Esto permite distribuir los costes y las capacidades: usar un modelo potente como Fable 5.2 para el coordinador y las revisiones complejas, un modelo de nivel Sonnet para la búsqueda habitual de información y uno de nivel Haiku para clasificaciones sencillas. Es solo un ejemplo de diseño, no una arquitectura fija establecida por Anthropic; conviene probarla y ajustarla según las tareas reales.
Verificación: un Agent revisor no equivale a una verificación real
En la documentación de prompting de Fable 5.2, Anthropic menciona un cambio reciente: con niveles de esfuerzo altos, como xhigh y max, Fable 5.2 recurre activamente a un Subagent para revisar su trabajo. Fable 5.1 no hacía lo mismo en las mismas tareas de prueba. Esto supone una mejora en la capacidad de orquestación, pero no debe confundirse con una garantía de calidad.
Un Agent revisor sigue basándose, en esencia, en el criterio del modelo. Para que la verificación sea realmente fiable se necesitan tres cosas: criterios de aceptación claros, pruebas de caja negra ejecutables y comprobaciones reales del código y de los cambios en sistemas externos (por ejemplo, ejecutar las pruebas y poner en marcha el servicio de verdad). Lo más convincente del experimento con el sistema operativo es precisamente el resultado verificable de que «se puede iniciar en una computadora portátil real», no que algún Agent diga que «parece estar bien».
Cómo evitar la delegación excesiva y la acumulación de reglas
La decisión de un Agent de delegar tareas no depende solo de las capacidades del modelo; también influyen el Harness y las instrucciones de las herramientas. En sus pruebas, Anthropic observó que, cuando las instrucciones de la herramienta Subagent especificaban el costo adicional de cada subagent, qué tareas convenía delegar y cuáles no, y cómo describirlas, el modelo delegaba aproximadamente un tercio menos en tareas breves que con una versión que solo destacaba los motivos para delegar. La tasa de éxito se mantenía igual.
Otro problema fácil de pasar por alto es la acumulación de reglas. Fable 5.2 sigue con bastante rigor las instrucciones restrictivas que se van acumulando en el contexto. Si los archivos históricos, las observaciones de los revisores y el System Prompt no dejan de añadir prohibiciones, el modelo podría acabar evitando realizar, en el trabajo diario, acciones que sí están permitidas. Por eso conviene revisar y depurar periódicamente la memoria, las reglas y los requisitos de aprobación del Agent.
Límites de ejecución: el techo real de los productos públicos
Los «1000 agentes» también tienen límites claros en los productos públicos. Estos son los límites que aparecen en la documentación de Managed Agents. Corresponden a productos públicos y no implican que los experimentos internos con sistemas operativos usaran el mismo planificador:
| Métrica | Límite |
|---|---|
| Hilos secundarios directos de Subagent | Máximo de 25 |
| Hilos de trabajo simultáneos de Dynamic Workflow | 64 |
| Agentes iniciados durante el ciclo de vida de un Workflow | 1000 |
| Ciclo de vida predeterminado de un Workflow | 24 horas |
| Workflows abiertos simultáneamente por Session de forma predeterminada | 10 |
Además, los agentes de un Workflow no pueden crear Workflows anidados. Cuando se alcanza el presupuesto, el Workflow en ejecución se pausa. Si un agente falla, el sistema suele reintentarlo una vez; si vuelve a fallar, el flujo de trabajo decide cómo proceder. En otras palabras, los 1000 agentes son el total acumulado de agentes iniciados durante todo el ciclo de vida: en un momento dado, hay muchos menos ejecutándose de verdad.
Las ejecuciones prolongadas también plantean un problema de experiencia de usuario: durante las llamadas a herramientas que duran mucho, Fable 5.2 puede mostrar poco texto dirigido al usuario, que podría pensar que la tarea se ha quedado bloqueada. La recomendación oficial es activar thinking.display: "updates" o hacer que el Harness pida al modelo que informe de sus avances después de varias llamadas consecutivas a herramientas. En las pruebas oficiales, los recordatorios de progreso redujeron aproximadamente a la mitad el tiempo máximo sin respuesta.
Primeros pasos con varios agentes: crea un orquestador mínimo con Claude Fable 5.2
A continuación, veremos el paso más básico sin depender de ninguna plataforma alojada: usar una interfaz compatible con OpenAI para que un modelo coordinador divida las tareas según los límites del contexto.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI, interfaz compatible con OpenAI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Usa el nombre que aparece en la lista de modelos de la plataforma
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
La versión completa incorpora una jerarquía de modelos, ejecución en paralelo, un presupuesto de tokens, un único reintento en caso de fallo y una revisión de caja negra. Su estructura refleja los métodos de ingeniería explicados antes:
Ver el ejemplo completo de orquestación con varios agentes
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Una clave permite invocar modelos de distintos proveedores
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Modelo avanzado para coordinar y revisar
WORKER_MODEL = "your-fast-model"          # Modelo más rápido y económico para las subtareas; cámbialo según tus necesidades
TOKEN_BUDGET = 200_000                     # Presupuesto de tokens para toda la tarea
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Cada subagente recibe solo el contexto que necesita; si falla, se reintenta una vez
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Revisión de caja negra: solo se entregan el resultado y los criterios, no el proceso de exploración
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Controla la ejecución en paralelo
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Este código solo ilustra la estructura; la revisión sigue dependiendo del criterio del modelo. En un entorno de producción, conviene sustituir review por pruebas reales o complementarlo con ellas, por ejemplo, ejecutando pruebas unitarias o iniciando el servicio para comprobar sus interfaces.
🚀 Consejo para empezar: La clave de los sistemas con varios agentes está en asignar modelos distintos a cada rol y poder comparar su consumo en cualquier momento. Te recomendamos usar APIYI (apiyi.com) para conectar Claude, OpenAI, Gemini y otros modelos con una sola clave API. Primero, prueba el flujo de un solo agente con el crédito gratuito para nuevos usuarios y, después, añade gradualmente la capa de colaboración.
Análisis del impacto de la colaboración multiagente en los desarrolladores
Impacto en los desarrolladores
- Empieza con un solo agente: establece una base con un único agente y una buena indicación. Añade una capa de colaboración solo cuando aparezca alguno de estos tres obstáculos: contaminación del contexto, subtareas que puedan ejecutarse en paralelo de forma independiente o necesidad de configuraciones especializadas.
- Trata la infraestructura como un elemento clave: las API de modelos y herramientas, los límites de presupuesto, el control de concurrencia y los registros de llamadas determinan si un sistema multiagente puede funcionar de forma estable. Sin registros, es imposible averiguar qué subagente está repitiendo trabajo.
- La división del trabajo entre varios modelos será habitual: asignar modelos diferentes al coordinador, los ejecutores y los revisores es una de las principales formas de controlar el aumento de costes, que puede multiplicarse entre 3 y 10 veces.
Impacto en el sector
- Se amplían los límites de la IA: se pasa de «completar una tarea de programación» a «coordinar un proyecto de ingeniería de software de larga duración». Los comentarios de los primeros socios de prueba, como Vercel, Shopify y Datadog, apuntan en esa dirección. Por ejemplo, un ingeniero de Datadog lo describió como un «comandante de incidentes» capaz de asignar tareas a modelos más rápidos. Conviene tener en cuenta que son comentarios de socios publicados en el momento del lanzamiento, no resultados de pruebas a ciegas independientes.
- La capacidad de orquestación importa más que el número de agentes: el grado de paralelismo de las tareas, los costes de coordinación, el estado compartido, los conflictos en el código, la cobertura de las pruebas y el coste de las invocaciones determinan en conjunto la eficiencia real de un sistema multiagente.
Preguntas frecuentes
Q1: ¿Qué consiguió exactamente el experimento de 1000 agentes de Claude Fable 5.2?
Anthropic reveló que Fable 5.2 coordinó a más de 1000 agentes secundarios durante 8 días seguidos, partiendo de una carpeta vacía, para crear un prototipo de sistema operativo capaz de arrancar en un portátil real. Incluía kernel, controladores, almacenamiento de archivos, sistema de ventanas, pantalla de inicio de sesión e instalador. La descripción oficial es «un prototipo funcional». No se han publicado el código fuente, el volumen de código, el total de tokens ni el costo, y tampoco se ha realizado una auditoría externa.
Q2: ¿Los sistemas multiagente son siempre mejores que los de un solo agente?
No necesariamente. Anthropic afirma explícitamente que los sistemas multiagente no siempre superan a los de un solo agente. Algunos equipos pasan meses creando sistemas multiagente y, al final, descubren que optimizar la indicación de un solo agente da resultados similares. Para una misma tarea, los sistemas multiagente suelen consumir entre 3 y 10 veces más tokens que los de un solo agente. Los beneficios son más consistentes en tres situaciones: aislamiento del contexto, procesamiento en paralelo y división del trabajo por especialidades.
Q3: ¿Se pueden usar el aumento del 90,2 % y los 15 veces más tokens para evaluar Fable 5.2?
No. Estas dos cifras proceden del sistema Research de Anthropic, publicado en junio de 2025: el 90,2 % corresponde al rendimiento en una evaluación interna específica de Research frente a Opus 4 con un solo agente, y la referencia para la comparación de 15 veces más tokens es el chat estándar. No tienen relación con el experimento del sistema operativo de Fable 5.2 de 2026, ni deben mezclarse con el dato de entre 3 y 10 veces más tokens para una misma tarea.
Q4: ¿Cómo puedo crear rápidamente mi propio prototipo multiagente a través de una API?
Te recomendamos seguir estos pasos:
1. Regístrate en APIYI apiyi.com y obtén una clave API y crédito gratuito para pruebas.
2. Configura `base_url` en el código de este artículo como `https://api.apiyi.com/v1`.
3. Empieza con una configuración de referencia de un solo agente y registra los tokens y la tasa de éxito.
4. Después, asigna modelos distintos al coordinador y a los agentes secundarios y compara los cambios en el costo y la calidad.
Q5: ¿Cómo se pueden controlar los costos de un sistema multiagente?
Hay cuatro medidas clave: dividir las tareas según los límites del contexto para reducir el traspaso de información; usar modelos más rápidos y económicos para las subtareas, y reservar los modelos más potentes para la planificación y las revisiones importantes; especificar en las instrucciones de las herramientas el costo de delegar y qué tareas no conviene delegar, para evitar hacerlo en exceso; y establecer un presupuesto global de tokens y un límite de concurrencia. Para tareas por lotes sin conexión, puedes considerar el descuento de Batch API. Para las llamadas habituales, también puedes llevar un control detallado con la facturación por uso y las estadísticas de consumo de APIYI apiyi.com.
Q6: ¿Qué limitaciones conocidas tienen actualmente los sistemas multiagente?
La primera es el costo: para una misma tarea, el consumo de tokens suele multiplicarse entre 3 y 10 veces. La segunda son los límites de orquestación: en Managed Agents, el máximo es de 25 subprocesos directos; Workflow admite hasta 64 subprocesos de trabajo simultáneos, con un máximo acumulado de 1000 inicios durante su ciclo de vida. La tercera es la verificación: un agente de revisión no sustituye a las pruebas reales. La cuarta son los problemas de experiencia, como la acumulación de reglas y los largos periodos sin recibir comentarios. Para solucionarlos, hay que limpiar las reglas periódicamente y activar las actualizaciones de progreso.
Puntos clave de la colaboración entre múltiples agentes en Claude Fable 5.2
- La cantidad no equivale a eficiencia: el valor de 1000 agentes está en su capacidad de organización, no en la cantidad por sí sola.
- Hay que definir bien los roles: Orchestrator coordina, Subagent ejecuta, Advisor asesora y Workflow gestiona los procesos.
- Divide el trabajo según los límites del contexto: asigna a un agente un módulo completo con sus pruebas para evitar distorsiones al transmitir información entre roles.
- Calcula bien los costos: para una misma tarea, trabajar con varios agentes suele consumir entre 3 y 10 veces más tokens que trabajar con uno solo.
- La verificación debe ser concreta: además de un agente revisor, hacen falta criterios de aceptación y pruebas reales.
- Empieza con un solo agente: añade capas de colaboración cuando aparezcan cuellos de botella reales. Puedes probar distintos niveles de trabajo con varios modelos mediante APIYI, en apiyi.com.
Resumen
El experimento con el sistema operativo de Claude Fable 5.2 deja varias enseñanzas:
- La capacidad de orquestación es ahora un requisito clave: el avance de Fable 5.2 está en su mayor capacidad para asumir el papel de coordinador, incluida la iniciativa de recurrir a subagentes para revisar su trabajo cuando opera con un nivel alto de Effort.
- La colaboración entre agentes tiene límites claros de aplicación: vale la pena dividir las tareas que requieren aislar contextos, trabajar en paralelo o especializar funciones; no así las tareas muy acopladas ni las consultas sencillas.
- Los costos, la concurrencia y la verificación son tres restricciones importantes: el aumento del consumo de tokens, los límites de programación y las pruebas reales determinan si un sistema puede funcionar de forma sostenible.
Para la mayoría de los desarrolladores, lo más conveniente es establecer primero una base con un solo agente y, luego, incorporar Subagent, Workflow o Advisor según los cuellos de botella reales. Al mismo tiempo, hay que preparar bien las API de modelos, el presupuesto, la concurrencia y los registros. La infraestructura de API es la base de cualquier aplicación con múltiples agentes.
Te recomendamos validar rápidamente tu solución multiagente con APIYI, en apiyi.com. La plataforma ofrece una interfaz unificada compatible con OpenAI y una cuota gratuita de prueba para nuevos usuarios, lo que facilita comparar cómo se distribuyen las tareas entre distintos modelos.
📚 Referencias
- Anuncio oficial de Anthropic: Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Enlace:
anthropic.com/claude-fable-and-mythos-5-2 -
Descripción: fuente primaria sobre experimentos con sistemas operativos, evaluaciones de programación y precios
-
Building multi-agent systems: When and how to use them: casos de uso y costos de los sistemas multiagente (2026-01-23)
- Enlace:
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
Descripción: datos sobre el consumo de tokens, de 3 a 10 veces mayor, y el principio de dividir el trabajo según los límites del contexto
-
How we built our multi-agent research system: sistema de investigación de Anthropic (2025-06-13)
- Enlace:
anthropic.com/research/multi-agent-research-system -
Descripción: arquitectura Orchestrator-Worker, 90,2 % en evaluaciones internas y datos sobre un consumo de tokens 15 veces mayor
-
Documentación de Managed Agents sobre orquestación multiagente y workflows: patrones de colaboración y límites de ejecución
- Enlace:
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
Descripción: definiciones de Subagents, Dynamic Workflows y Advisor, además del límite de concurrencia
-
Prompting Claude Fable 5.2: guía oficial de ingeniería de indicaciones
- Enlace:
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
Descripción: comportamiento de autorrevisión, experimentos sobre delegación excesiva y recomendaciones para informar sobre el progreso
-
Documentación de especificaciones del modelo Fable 5.2: contexto, límite de salida y facturación
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: contexto de 1M, salida máxima de 128K e ID de modelo de la API
Autor: Equipo técnico de APIYI
Intercambio técnico: Visita la página de inicio de APIYI en apiyi.com y contáctanos para conversar sobre arquitecturas multiagente y prácticas de integración de varios modelos.


