
작성자 주: RoboDojo Sim에서 Claude Fable 5.2가 64.9%를 기록한 조건을 살펴봅니다. Opus 5.5, GPT-6 Astra와의 차이, 이 점수로 입증할 수 없는 것, 도입 전에 따져봐야 할 비용과 제한도 함께 짚어봅니다.
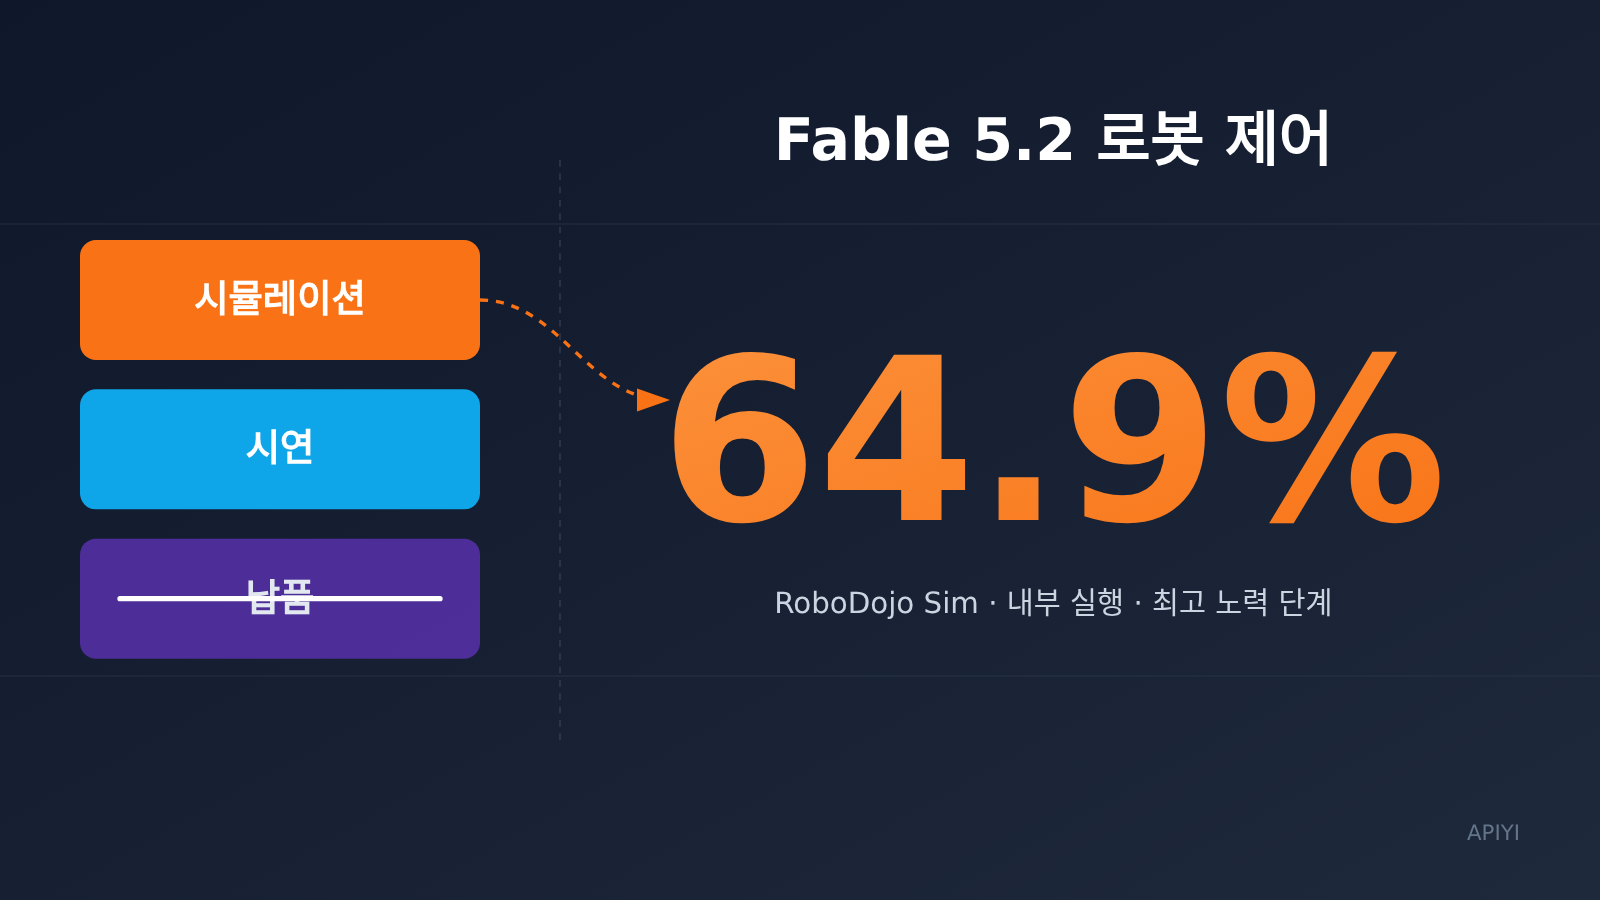
먼저 결론부터 말씀드릴게요. Anthropic 내부에서 최고 노력 설정으로 실행한 RoboDojo Sim에서 Claude Fable 5.2는 64.9%, Opus 5.5는 39.4%, GPT-6 Astra는 29.8%, Fable 5.1은 27.6%를 기록했습니다. 카메라 이미지를 보고 시뮬레이션 속 양팔을 제어한 결과이지, 공장에 실제로 납품한 기록은 아닙니다.
이 글은 “로봇 시대가 왔다”는 홍보물이 아닙니다. 아래에서 시뮬레이션 점수, 데모 영상, 실제 배포를 나눠서 살펴볼게요. API 연동과 비용을 고민 중이라면, 다 읽고 나서 이 64.9% 때문에 지금 기술 방향을 바꿔야 할지 판단할 수 있을 거예요.
핵심 가치: Fable 5.2의 64.9%가 무엇을 입증하는지, 무엇을 입증하지 못하는지, 지금 사전 검증에 어떤 모델을 호출할 수 있는지 구분합니다.
Claude Fable 5.2의 64.9%는 정확히 무엇을 의미할까요?
이 수치는 세 문장으로 설명할 수 있어요. RoboDojo는 모델이 카메라 이미지에 따라 시뮬레이션 환경의 양팔 로봇을 제어할 수 있는지 측정하는 공개 벤치마크예요. Anthropic의 발표문 각주에는 64.9%가 Anthropic 내부에서 실행한 결과이며, 사용 가능한 최고 노력 수준을 적용했다고 나와 있어요. 2026-11-10 기준으로 RoboDojo 공개 리더보드에서 같은 수치를 확인하지 못했으므로, 이 결과를 ‘공개 리더보드 1위’라고 쓰거나 ‘세계 최강의 로봇 모델’이라고 말해서는 안 돼요.
아래는 2026-11-09 Anthropic 발표문에 나온 RoboDojo Sim 비교 결과예요.
| 모델 | RoboDojo Sim | Fable 5.2와의 차이 | 설명 |
|---|---|---|---|
| Claude Fable 5.2 | 64.9% | — | 내부 실행, 최고 노력 수준 |
| Claude Opus 5.5 | 39.4% | 25.5%p 낮음 | 같은 표에 수록 |
| GPT-6 Astra | 29.8% | 35.1%p 낮음 | Anthropic이 실행한 결과이며, OpenAI 자체 발표 결과가 아님 |
| Claude Fable 5.1 | 27.6% | 37.3%p 낮음 | 이전 세대 |
| Gemini 4 Carbon | 표에 값 없음 | 비교 불가 | 수치가 없으므로 0으로 간주할 수 없음 |
27.6%에서 64.9%로, 세대 간 성능이 두 배 이상 향상됐어요. 전체 결과표에서도 눈에 띄는 차이예요. 다만 이 점수에는 시뮬레이션 환경, 내부 실행, 최고 노력 수준이라는 세 가지 전제가 있어요. 이 중 하나라도 달라지면, 예를 들어 실제 로봇으로 평가하거나 제3자가 재검증하거나 기본 노력 수준을 적용하면 이 수치를 그대로 가져다 쓸 수 없어요.
Fable 5.2와 Mythos 5.2는 어떤 관계인가요?
발표문에 따르면 Claude Fable 5.2와 Claude Mythos 5.2는 같은 기반 모델이에요. Fable은 사이버 보안과 생물 안전 보호 장치가 더 강력해 모든 사용자에게 공개돼요. Mythos는 생명과학 또는 사이버 보안 검증 프로그램을 통과한 조직에만 제공돼요. Mythos가 ‘더 강력한 별도의 모델’인 것은 아니므로, 로봇 분야 성능을 평가할 때는 Fable 5.2만 보면 돼요.
공식 모델 ID는 다음과 같아요.
- Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS:
claude-fable-5-2 - Amazon Bedrock:
anthropic.claude-fable-5-2 - Mythos 모델 ID:
claude-mythos-5-2및anthropic.claude-mythos-5-2
Fable 5.2의 로봇 제어 핵심 기능: 데모에서 확인할 수 있는 것
발표문에 따르면 Fable 5.2는 이전 Claude 모델보다 물리적 로봇을 훨씬 잘 제어하며, 전용 훈련을 받지 않은 작업도 수행할 수 있어요. 함께 공개된 데모 영상에는 큐브 맞추기, 병뚜껑 돌려 열기, 로봇 그림 그리기 등 세 가지 장면이 담겼어요.
이 내용은 어디까지나 ‘발표문에 나온 데모’로 받아들여야 해요. 데모는 특정 설정에서 모델이 이런 동작을 수행했다는 점을 보여줄 뿐, 성공률이나 재시도 횟수, 실패 비율을 알려주지는 않아요. Anthropic이 바로 설치해 사용할 수 있는 로봇 기술 패키지를 출시했다는 뜻도 아니고요. 전용 훈련을 받지 않은 작업도 포함됐다는 공식 설명은 주목할 만하지만, 독립적으로 재현한 데이터가 제시되지 않은 공식 발표라는 점은 변함없어요.
발표문은 또 Fable 5.2가 동일한 테스트 스위트에서 다른 프런티어 모델은 물론, 로봇 제어를 위해 특별히 설계된 시스템 대부분보다 높은 성능을 보였다고 밝혔어요. 하지만 후자의 비교 대상 목록은 공개되지 않아 어떤 시스템과 어떤 버전을 비교했는지 알 수 없어요. 이 문장은 방향성을 보여주는 신호로 볼 수는 있지만, 확정적인 결론으로 받아들여서는 안 돼요.
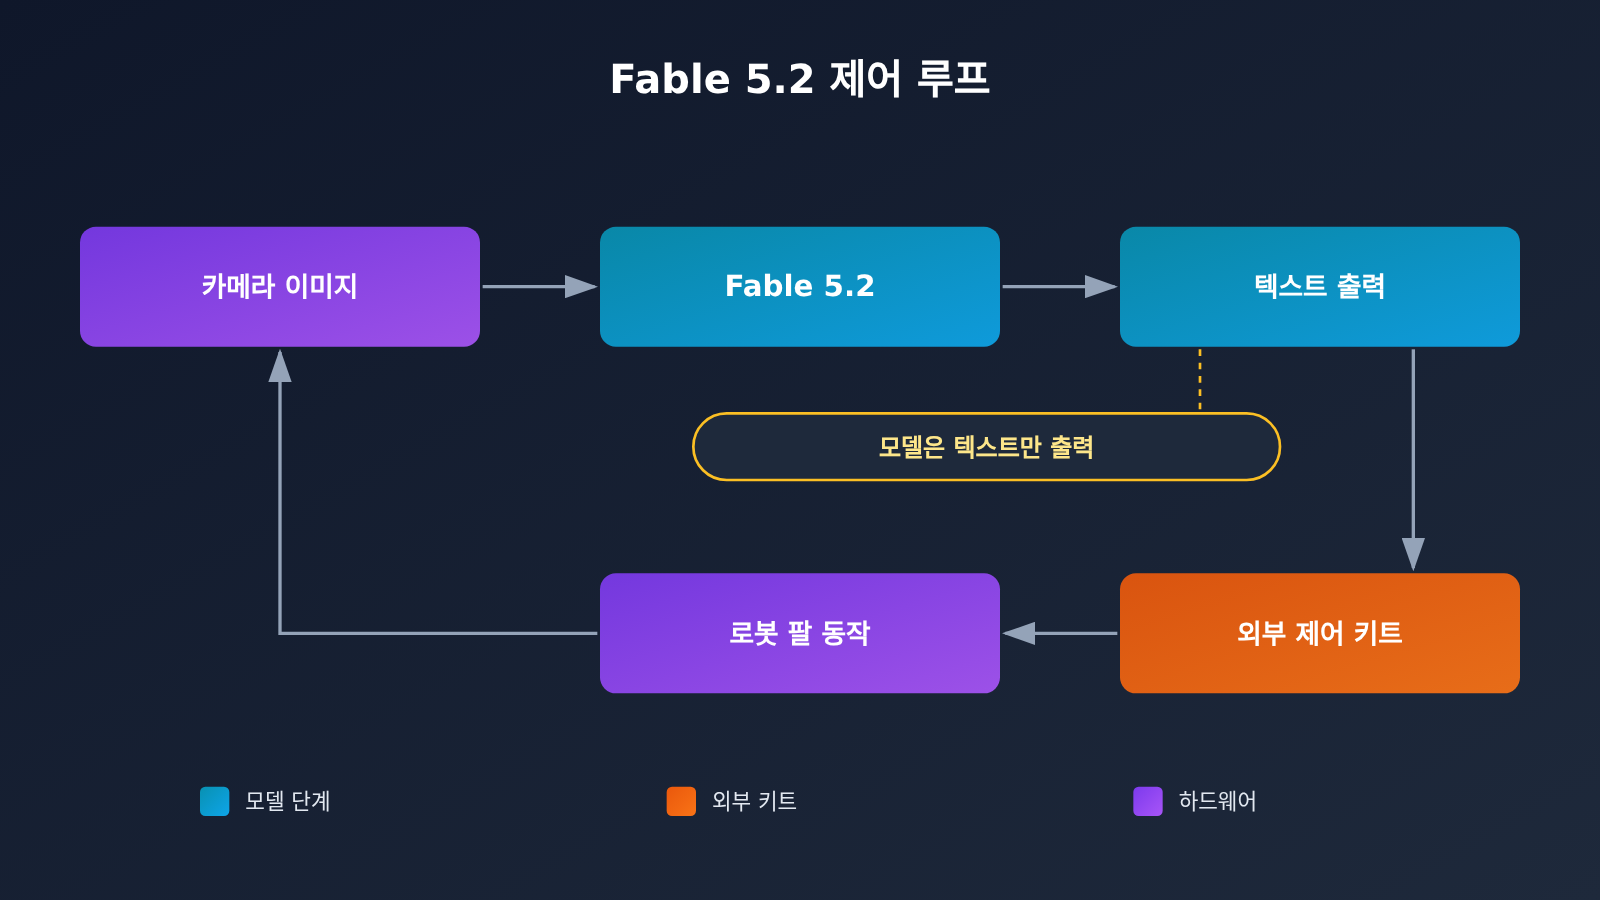
모델은 텍스트를 출력하고, 제어는 외부 도구 모음이 담당해요
이 점은 데모 영상만 보면 놓치기 쉬워요. 모델 페이지에 따르면 Fable 5.2의 입력은 텍스트와 이미지이고, 출력은 텍스트뿐이에요. 모델이 모터 명령을 직접 내리는 건 아니에요. 매 단계마다 외부 도구 모음이 텍스트를 동작으로 변환하고, 새로운 카메라 화면을 다시 모델에 전달해야 해요.
따라서 실제 환경에서의 제어 성능은 모델뿐 아니라 사용하는 도구 모음에도 달려 있어요. 동작 공간을 어떻게 정의하는지, 파싱에 실패했을 때 어떻게 대응하는지, 단계별 지연 시간이 감당할 만한 수준인지가 모두 중요하죠. RoboDojo의 64.9%는 Anthropic 자체 도구 모음으로 측정한 결과예요. 다른 도구 모음을 사용했을 때 점수가 어떻게 달라지는지는 아직 알 수 없어요.
Fable 5.2 실측 데이터: 로봇과 컴퓨터 조작의 격차는 다르다
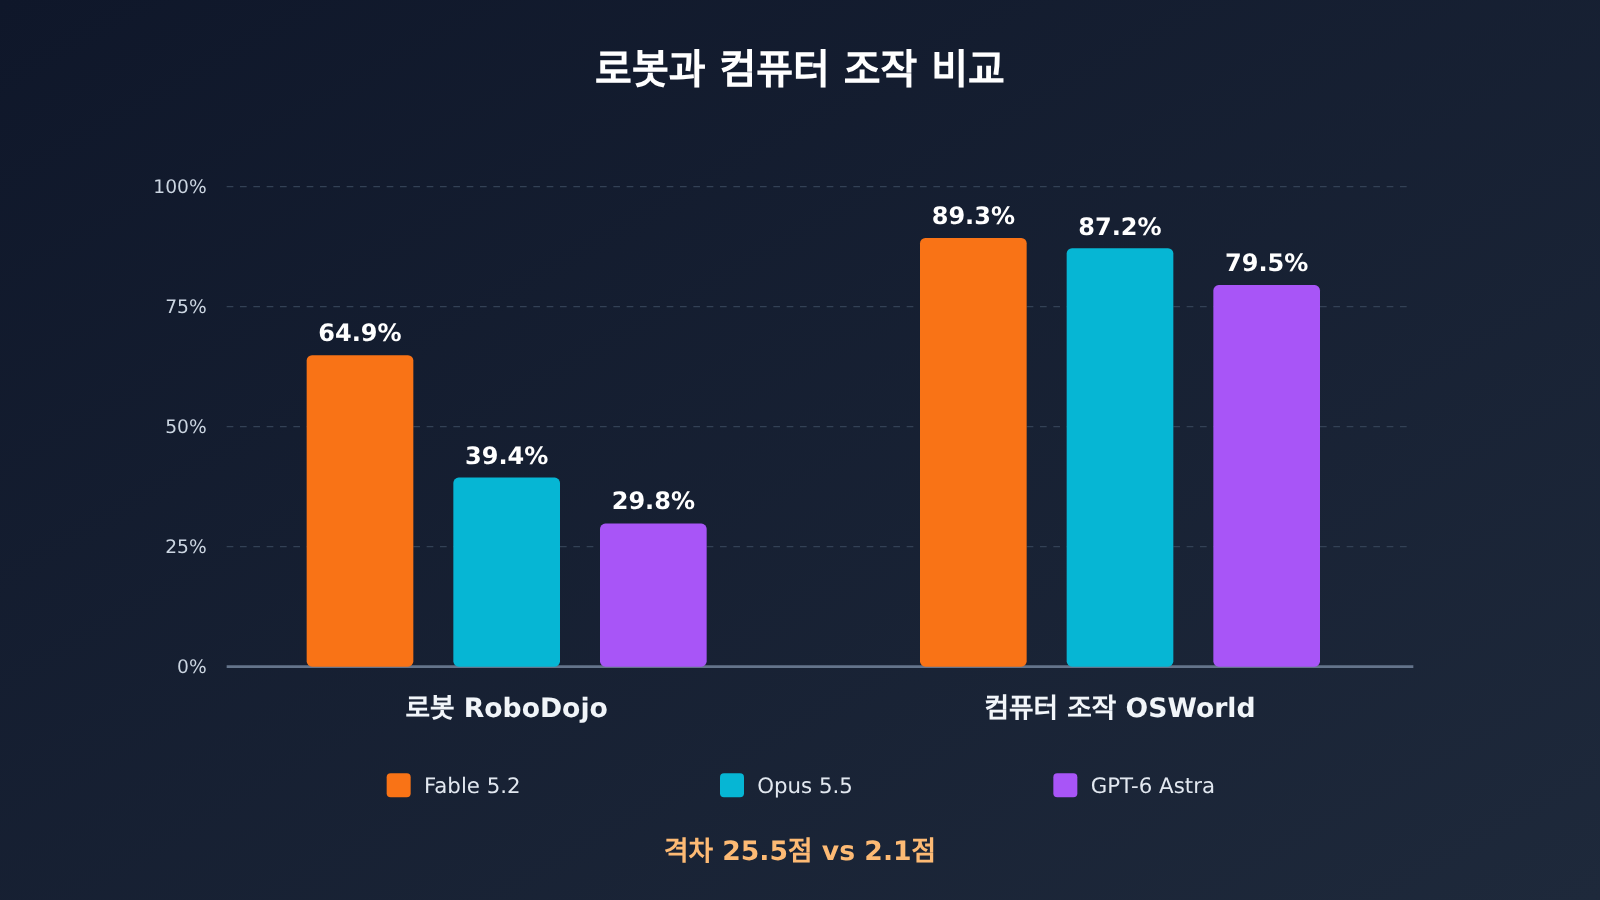
“Fable 5.2가 강력하다”는 말을 보고 로봇 벤치마크 점수와 다른 분야의 점수를 한데 묶어 생각하는 경우가 많아요. 아래 표는 모두 Anthropic이 2026-11-09에 발표한 자료에서 가져왔으며, ‘조작’과 관련된 몇 가지 테스트에서 모델 간 격차가 얼마나 다른지 보여줘요.
| 테스트 항목 | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Fable 5.2의 Opus 5.5 대비 우위 |
|---|---|---|---|---|
| RoboDojo Sim(시뮬레이션 양팔 조작) | 64.9% | 39.4% | 29.8% | 25.5%p |
| OSWorld 2.1(컴퓨터 조작, 오프라인 세트 일부) | 89.3% | 87.2% | 79.5% | 2.1%p |
| AutomationBench | 51.4% | 42.5% | 41.4% | 8.9%p(Carbon은 53.9%로 더 높음) |
| Remote Labor Index(High 등급) | 41.3% | 21.3% | 20.8% | 20.0%p |
OSWorld 2.1에서 Fable 5.2는 Opus 5.5보다 2.1%p 높을 뿐이에요. RoboDojo에서 39.4%에서 64.9%로 벌어진 격차와는 규모가 다르죠. 컴퓨터 조작 에이전트 작업이 필요하다면, Opus 5.5와 Fable 5.2의 차이는 로봇 벤치마크에서만큼 크지 않아요.
노력 등급: 64.9%는 기본 설정에서 나온 점수가 아니에요
발표 자료의 성적표는 별도 표시가 없는 한, 각 모델에서 당시 사용할 수 있었던 가장 높은 노력 등급을 기준으로 했어요. Fable 5.2의 Claude API 기본 effort는 high이고, Claude 앱과 Claude Code에서는 Medium이에요. 즉, 기본 매개변수로 호출하면 64.9%에 해당하는 설정으로 결과를 얻는다고 보장할 수 없어요.
최고 등급을 사용하면 더 오래 생각하고 더 많은 토큰을 사용해요. 로봇처럼 반복적인 의사결정이 필요한 루프에서는 매 단계마다 최고 등급으로 추론할 경우 지연 시간과 비용이 모두 커져요. 64.9%가 high나 medium 등급에서 어느 정도로 떨어지는지는 발표 자료에 나와 있지 않아요.
사양 비교: Fable 5.2, Opus 5.5, GPT-6 Astra
| 항목 | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| 컨텍스트 | 1M | 1M | 1,050,000 |
| 최대 출력 | 128K | 128K | 128,000 |
| 입력 / 출력 모달리티 | 텍스트 + 이미지 / 텍스트 | 텍스트 + 이미지 / 텍스트 | 텍스트 + 이미지 / 텍스트 |
| API 기본 노력 등급 | high | medium | low부터 max까지 지원 |
| 지연 시간 등급 | Moderate | Moderate | 공식 페이지에 동일한 기준으로 표기되지 않음 |
| 지식 기준일 | 2026년 6월 | 2026-06 | 2026-04-30 |
세 모델 모두 출력은 텍스트예요. 로봇을 제어할 때 피할 수 없는 공통 전제죠.
Fable 5.2의 점수에 포함할 수 없는 항목
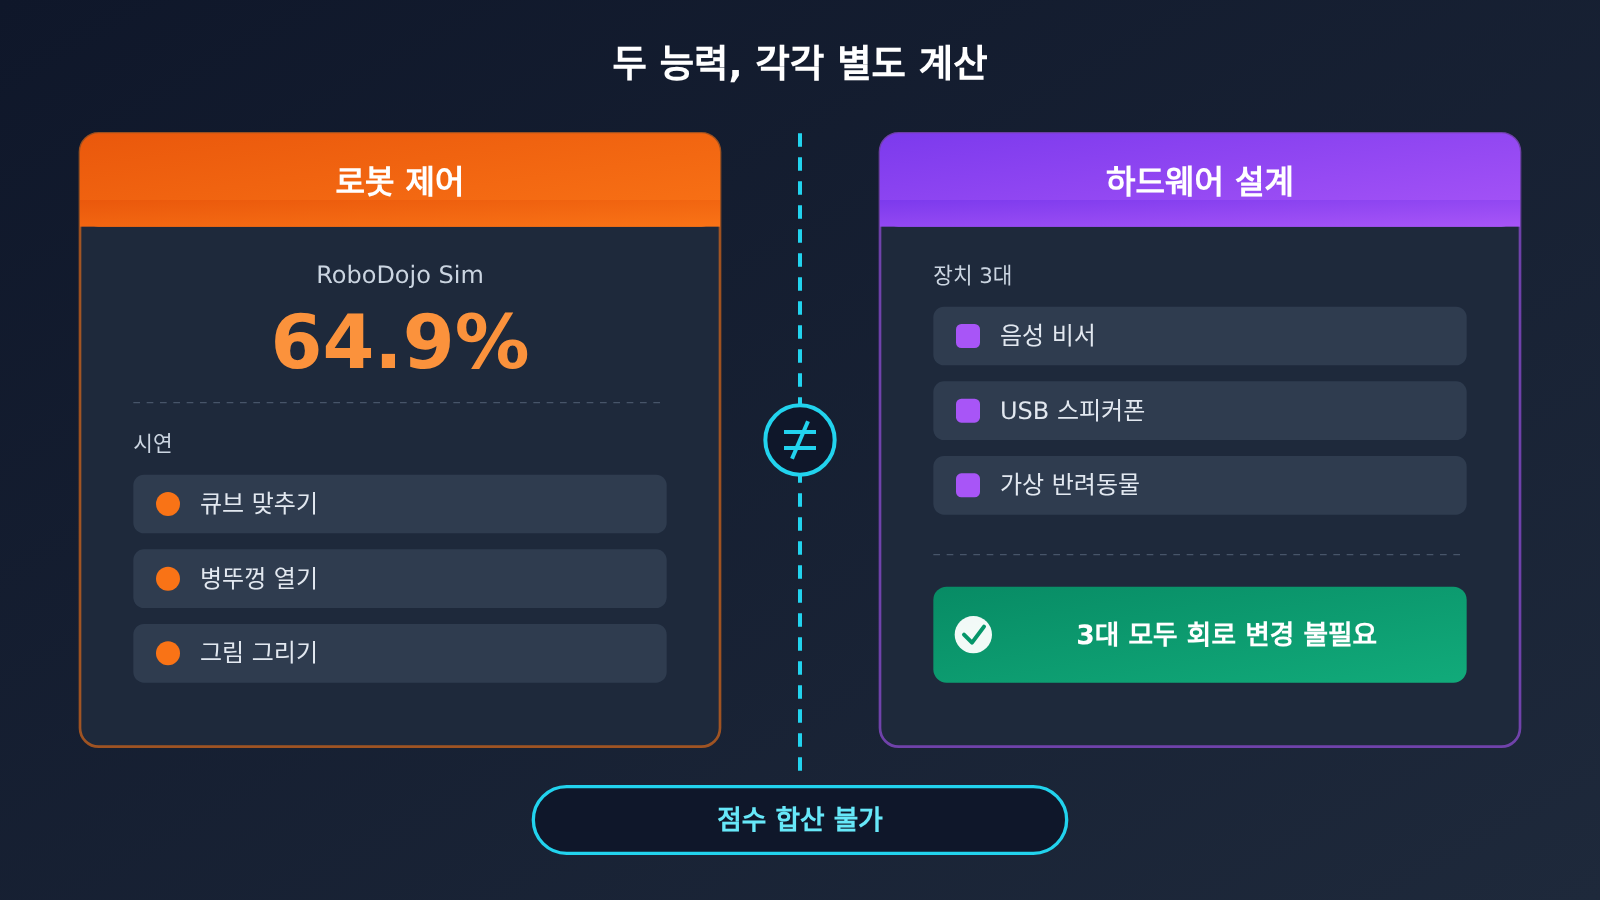
전자 기기 3종은 하드웨어 설계 실험이에요
출시 글에는 한 문장으로 된 프롬프트만으로 Fable 5.2가 작동하는 전자 기기 3종을 설계했다는 내용도 있어요. 가정용 음성 비서, USB 스피커폰, 휴대용 가상 반려동물이에요. 이 프로젝트는 Diode와 함께 진행했으며, 회로 기판은 각각 하루도 안 돼 제작됐고 세 기기 모두 회로를 수정하지 않고 작동했어요.
이 사례가 보여주는 건 하드웨어 설계 능력이에요. RoboDojo와는 관계가 없고, 기기 자체도 로봇이 아니에요. 이를 64.9%와 함께 제시하면 “설계부터 제어까지 모두 해낸다”는 인상을 줄 수 있지만, 두 사례는 서로 관련이 없어요.
Fable 5.2의 한계: 제어 루프에 영향을 주는 제약
아래 내용은 모델 페이지와 업데이트 안내에 나와 있어요. 각각은 제어 루프를 구축할 때 직접 고려해야 하는 사항이에요.
- 강제 도구 호출은 오류가 발생해요:
tool_choice를any또는tool로 설정하면 400 오류가 반환돼요. 툴킷이 “반드시 액션 도구를 호출해야 하는” 구조라면, 모델이 직접 선택하도록 바꾸고 파싱 단계에서 대체 처리를 해야 해요. - 샘플링 매개변수를 설정할 수 없어요:
temperature,top_p,top_k를 전달하면 400 오류가 반환돼요. - 생각을 끌 수 없어요: 적응형 사고는 항상 켜져 있고,
effort로 사고량만 조정할 수 있어요. 업데이트 안내에 따르면 medium 이상에서는 프롬프트에 “생각하지 말고 바로 답하라”고 써도 사고를 멈추지 않아요. - 긴 도구 호출 흐름에서는 설명이 거의 없어요: 도구를 연속해서 호출할 때 모델이 사용자에게 보여주는 출력이 적을 수 있고, 설명 없이 바로 도구를 호출할 수도 있어요. 모니터링 화면에서 모델이 진행 상황을 먼저 보고할 거라고 기대하면 안 돼요.
- 작업을 일찍 멈출 수 있어요: 한 차례 응답이 끝나자마자 멈추고 할 일 목록만 남기거나, 평범한 장애물 하나에 막힐 때가 있어요. low 설정에서 더 자주 나타나요.
- 거절 응답도 사용량에 포함돼요: 요청을 거절하면 HTTP 200과 함께
stop_reason이refusal로 반환되며, 속도 제한 할당량도 사용해요. - 데이터 보존: 데이터는 30일간 보존해야 해요. Anthropic의 명시적인 승인을 받지 않았다면 제로 데이터 보존을 적용할 수 없어요.
로봇 제어 루프는 매 단계에서 실행 가능한 동작을 내놓아야 해요. 위 제약을 모두 고려하면, 모델을 제어 루프에 연결하기 전에 시간 초과, 빈 동작, 거절, 중간 중단을 모두 복구 가능한 상태로 처리하도록 설계해야 해요.
Fable 5.2 가격: 도입 전에 비용부터 따져보기
공식 가격은 토큰 100만 개 기준이며, 모델 페이지와 업데이트 안내, 빠른 모드 페이지를 참고했어요.
| 과금 항목 | Fable 5.2 | Opus 5.5 | GPT-6 Astra(짧은 컨텍스트) |
|---|---|---|---|
| 일반 입력 / 출력 | $8 / $40 | $4 / $20 | $10 / $50 |
| 캐시 읽기 | $0.20 | $0.20 | $1(캐시 입력) |
| 캐시 쓰기 | 5분 $10, 1시간 $16 | 공식 페이지에 있지만 이 글에는 미기재 | $12.5 |
| 배치 | 배치 할인 50% 적용 시 $4 / $20 | 동일하게 50% 할인 | 이 글에는 미기재 |
| 빠른 모드 | $16 / $80 | $8 / $40 | — |
몇 가지 더 살펴볼 점이 있어요. Fable 5.2는 Fable 5.1($10 / $50)보다 20% 저렴해요. 빠른 모드의 성능은 그대로이며, 출력 속도는 일반 모드보다 최대 2.5배 빠르지만, 공식적으로 빠른 모드의 캐시 가격은 별도로 공개되지 않았어요. 배율을 적용해 계산하면 캐시 읽기는 약 $0.40, 5분 캐시 쓰기는 약 $20, 1시간 캐시 쓰기는 약 $32예요. 속도 모드가 다르면 프롬프트 캐시를 공유하지 않으므로, 빠른 모드에서 일반 모드로 전환하면 캐시 미스가 발생해요. GPT-6 Astra는 입력이 272K 토큰을 초과하면 전체 요청에 입력 2배, 출력 1.5배의 요금을 적용해요.
로봇 루프에서는 매 단계마다 새 이미지 한 장을 전송하지만, 앞서 전달한 시스템 프롬프트와 동작 설명은 거의 바뀌지 않아요. 이런 구조에서는 캐시를 활용해 비용을 줄일 수 있지만, 단계마다 들어가는 이미지와 추론 토큰은 줄일 수 없어요.
지금 Fable 5.2를 호출할 수 있나요? APIYI 출시 현황
2026-11-10 기준, APIYI apiyi.com의 전체 모델 목록과 공개 가격 API에는 아직 claude-fable-5-2가 없고, Mythos 모델도 없습니다. 이 모델을 최대한 빠르게 출시할 예정입니다. 모델명과 가격은 플랫폼의 모델 목록을 기준으로 확인해 주세요. 출시 전까지는 이 글에서 Fable 5.2의 APIYI 가격을 안내하지 않으며, 그룹별 배율을 적용해 공식 가격을 환산하지도 않습니다.
해당 날짜에 APIYI 전체 모델 목록에서 호출할 수 있는 관련 모델은 다음과 같습니다. (목록에 표시된 가격, 단위: 백만 토큰당 달러)
| 모델 ID | 입력 / 출력 | 캐시 읽기 | 엔드포인트 | 적합한 용도 |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | 도구 호출 및 컴퓨터 조작 루프 구축 |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | 이전 세대 기준 모델과 비교 |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | 이전 버전과 비교 |
gpt-6-astra |
$10 / $50 | $1 | responses(주), chat | 다른 업체 모델과 비교 |
전체 모델 목록에 표시된 가격은 기준 가격이며, 실제 청구액은 토큰 그룹별 배율을 적용하므로 청구서를 확인해야 합니다. gpt-6-astra의 각주에는 입력 토큰 구간 가격만 나와 있습니다. (272,000토큰 이하는 $10, 272,001~1,050,000토큰은 $20) 긴 컨텍스트의 출력 가격은 명시되어 있지 않으니 콘솔 청구 내역을 확인해 주세요. OpenAI 호환 인터페이스를 사용해 연결하고 base_url에 https://api.apiyi.com/v1을 입력하면 됩니다.
실용적인 방법은 먼저 claude-opus-5-5로 이미지 입력, 동작 분석, 실패 복구 과정을 검증한 뒤, Fable 5.2가 APIYI에 출시되면 모델 ID를 바꿔 비교하는 것입니다. 로봇 분야의 성능 차이(25.5포인트)는 컴퓨터 조작(2.1포인트)보다 훨씬 크므로 Fable 5.2를 기다릴 이유는 있습니다. 다만 데모 영상만 보고 결정하기에는 정보가 부족합니다.
Fable 5.2 로봇 능력의 장단점 분석
장점
- 세대 간 성능 향상 폭이 큼: RoboDojo Sim 점수가 27.6%에서 64.9%로 올라, 전체 성적표에서 가장 큰 폭으로 개선된 항목 중 하나예요.
- 동종 모델보다 뚜렷하게 앞섬: Opus 5.5보다 25.5%포인트, GPT-6 Astra보다 35.1%포인트 높아요(Anthropic이 공개한 자료 기준).
- 가격 인하: 표준 요금은 5.1보다 20% 저렴하고, 캐시 읽기 요금은 $0.20예요.
- 일관된 시각 입력 지원: 이미지 입력과 1M 컨텍스트를 지원해 긴 다단계 시각 기록도 처리할 수 있어요.
한계
- 근거 수준이 낮음: 내부 실행 결과이자 최고 노력 설정 기준이에요. 공개 벤치마크에서 같은 수치를 확인하지 못했고, 독립적인 재검증도 없어요.
- 시뮬레이션 데이터만 있음: 시연 영상에는 성공률이 제시되지 않았어요. “대부분의 전용 로봇 시스템보다 뛰어나다”는 주장에도 비교 대상 목록이 첨부되지 않았어요.
- 제어 루프 제약이 많음: 텍스트만 출력하고, 도구 호출을 강제할 수 없어요. 사고 과정을 끌 수도 없고, 긴 작업 흐름에서 먼저 설명하는 경우도 드물어요.
- 최고 설정의 비용이 높음: 점수는 최고 노력 설정을 기준으로 해요. 실제 배포 시 지연 시간과 토큰 소비량은 직접 측정해야 해요.
이 결과만 보고 모델을 바꾸면 안 되는 경우
자체 시뮬레이션 환경이나 실제 로봇 제어 루프가 없다면 64.9%라는 수치는 검증할 방법이 없어 실질적인 의미가 없어요. 네트워크 보안, 생물학 관련 작업, 일상적인 코딩이 필요하다면 이 점수로는 해당 작업의 성능을 입증할 수 없어요. 그런 분야에 맞는 테스트 항목을 살펴봐야 해요. 공개 자료에서 Anthropic이 권하는 방법은 대부분의 코딩과 지식 작업을 Opus 5.5로 시작한 다음, 난이도에 따라 더 높은 등급이나 낮은 등급으로 조정하는 거예요.
자주 묻는 질문 FAQ
Q1: Fable 5.2의 64.9%는 공개 리더보드 점수인가요?
아니요. 출시 게시물의 각주에는 Anthropic 내부에서 실행한 결과라고 명시되어 있어요. RoboDojo 자체는 공개 벤치마크지만, 2026-11-10 기준으로 공개 리더보드 페이지에서 같은 수치를 확인하지 못했어요.
Q2: 64.9%는 기본 노력 설정에서 나온 점수인가요?
아니요. 사용 가능한 가장 높은 노력 설정에서 나온 점수예요. Claude API의 기본 설정은 high이고, Claude 앱과 Claude Code의 기본 설정은 Medium이에요. 기본 설정에서 몇 점을 얻는지는 출시 게시물에 공개되지 않았어요.
Q3: Fable 5.2가 전용 로봇 시스템보다 뛰어난가요?
출시 게시물에서는 “로봇 제어 전용으로 제작된 대부분의 시스템”보다 뛰어나다고 했지만, 구체적인 목록은 공개하지 않았어요. 어떤 시스템보다 뛰어난지는 현재 알 수 없어요.
Q4: Gemini 4 Carbon은 왜 RoboDojo 점수가 없나요?
출시 게시물의 표에서 해당 항목이 비어 있고, 이유는 설명되어 있지 않아요. 빈칸이 0점을 의미하는 것은 아니며, 이를 근거로 성능을 추측할 수도 없어요.
Q5: 지금 API를 통해 미리 준비하려면 어떻게 해야 하나요?
2026-11-10 기준으로 APIYI apiyi.com에는 아직 `claude-fable-5-2`가 등록되지 않았어요. 이 모델은 최대한 빨리 출시할 예정이며, 모델 ID와 가격은 플랫폼의 모델 목록을 확인해 주세요. 우선 등록된 `claude-opus-5-5`로 이미지 입력과 도구 호출 흐름을 테스트한 뒤, 모델이 출시되면 전환해 비교해 볼 수 있어요.
Q6: 전자기기 세 대가 로봇 제어 능력을 입증하나요?
아니요. 음성 비서, USB 스피커폰, 가상 반려동물은 Diode와 협력해 진행한 하드웨어 설계 실험으로, 회로 설계 능력에 해당해요. RoboDojo의 양팔 제어 점수와는 관련이 없어요.
Q7: 컴퓨터 조작 에이전트는 Fable 5.2를 기다려야 하나요?
그럴 필요는 크지 않아요. OSWorld 2.1에서 Fable 5.2는 89.3%, Opus 5.5는 87.2%로 차이가 2.1%포인트에 불과해요. 반면 Opus 5.5의 정가는 Fable 5.2의 절반이에요.
Fable 5.2 로봇 역량 핵심 요약
- 점수의 의미: 64.9%는 내부 실행 환경에서 최고 노력 단계로 측정한 시뮬레이션 양팔 제어 성적이에요.
- 격차: Opus 5.5보다 25.5%포인트, GPT-6 Astra보다 35.1%포인트 높아요.
- 비교 항목: OSWorld에서는 2.1%포인트 앞서는 데 그쳤어요. 두 격차를 혼동하면 안 돼요.
- 시연의 의미: 루빅스 큐브 풀기, 병뚜껑 돌려 열기, 그림 그리기는 출시 글에 나온 시연이지, 제품화된 기술은 아니에요.
- 제어 루프의 제약: 텍스트만 출력하고,
tool_choice를 강제하면 400 오류가 반환되며, 사고 기능을 끌 수 없어요. - 출시 상태: 2026-11-10 기준 APIYI에는 아직 등록되지 않았어요. 우선
claude-opus-5-5로 제어 루프를 구축할 수 있어요.
요약
Claude Fable 5.2가 로봇 제어에서 실제로 발전했다는 신호는 분명해요. RoboDojo Sim 점수가 이전 세대의 27.6%에서 64.9%로 올랐고, Anthropic이 제시한 비교에서도 뚜렷하게 앞서요. 다만 이 수치는 시뮬레이션 환경, 내부 실행, 최고 노력 단계에만 적용돼요. 실제 로봇의 성공률을 포함하지 않으며, 공장 납품 역량을 의미하지도 않아요.
자체 시뮬레이션이나 실제 로봇 제어 루프를 갖추고 있다면 Fable 5.2가 출시된 뒤 비교 테스트를 해볼 만해요. 텍스트 출력 파싱, 도구 호출을 강제할 수 없는 점, 사고 기능을 끌 수 없는 점도 미리 설계에 반영해야 해요. 제어 루프가 없거나 해결하려는 문제가 코드 작성이나 컴퓨터 조작이라면, 64.9%라는 수치만으로 기존 방식을 바꿀 필요는 없어요.
작성자: APIYI 기술팀
기술 문의: APIYI apiyi.com 홈페이지에서 문의해 주세요. 모델 출시 일정은 플랫폼 모델 목록을 기준으로 확인해 주세요.


