
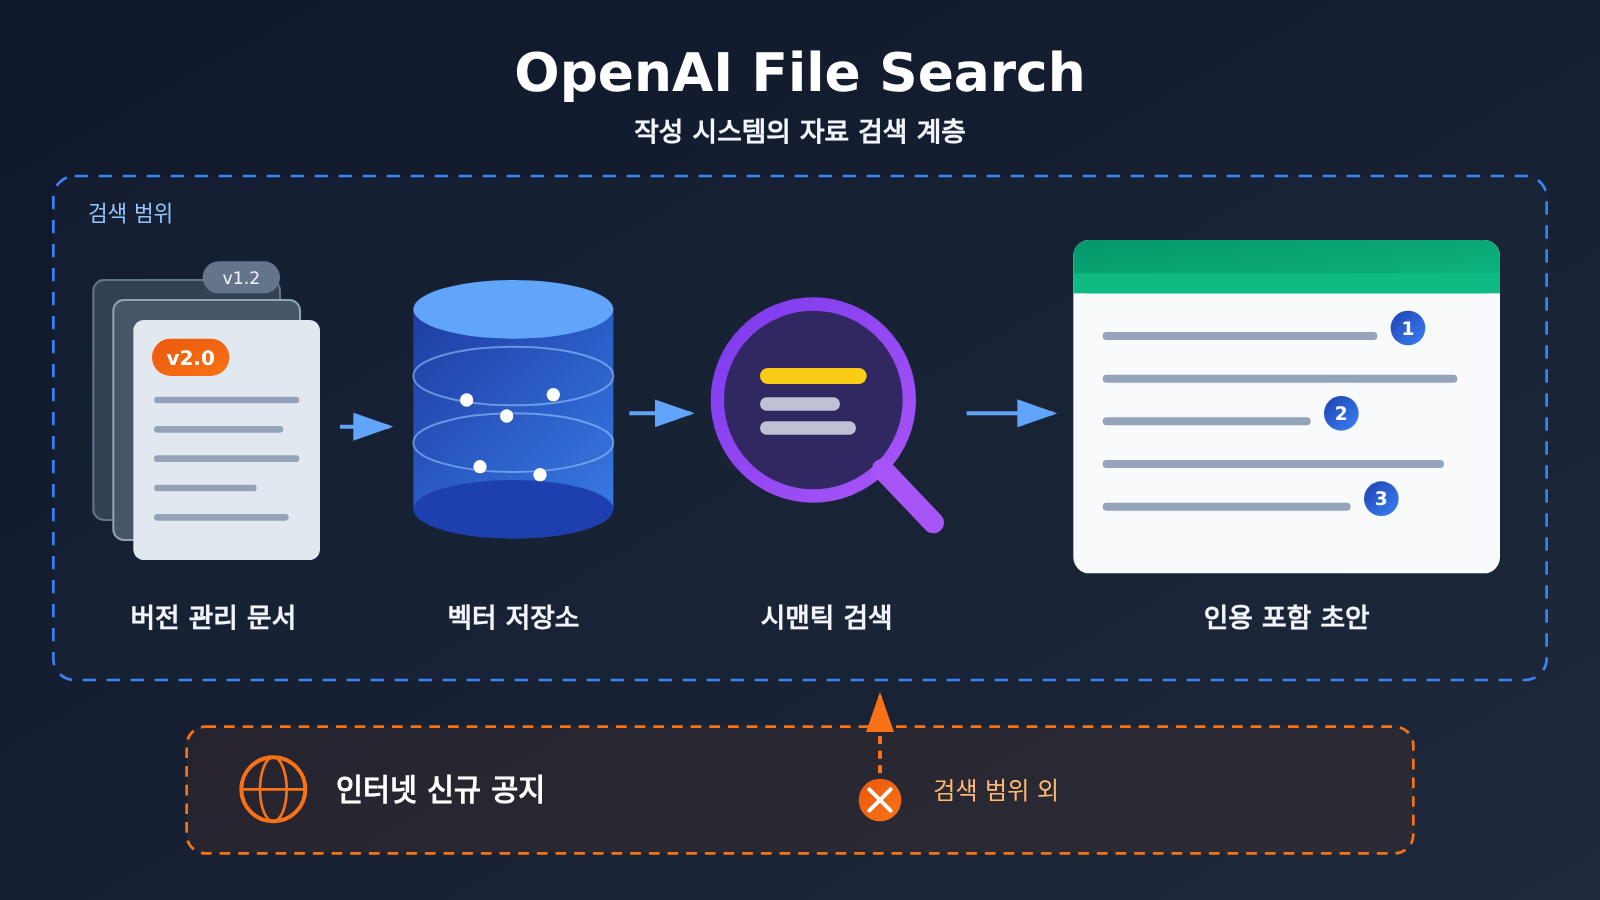
일부는 채울 수 있지만, 전부는 채울 수 없어요. OpenAI File Search가 해결하는 건 “이미 가진 자료를 정확히 찾지 못하고 인용이 불분명한” 문제예요. 벡터 저장소에서 파일을 의미 기반으로 검색하고, 답변에 파일 인용을 함께 붙여 주니 글쓰기 시스템에는 꽤 유용하죠. 하지만 “자료 자체가 없거나 낡은” 문제는 해결하지 못해요. 이 도구는 이미 넣어 둔 파일만 검색할 뿐, 인터넷에 올라온 새 공지를 스스로 찾아내지 않아요. 인용 표시도 해당 내용이 어느 파일에서 나왔는지 알려 줄 뿐, 결론이 올바르게 쓰였다는 것까지 보장하지는 않아요.
그래서 더 정확한 판단은 이래요. File Search는 글쓰기 시스템의 “자료 검색 계층”을 맡을 수 있지만, 자료 수집과 버전 관리, 사실 검증은 여전히 별도로 해야 해요.
이 글을 읽고 나면 알 수 있는 것
- Responses API에서 File Search가 맡는 위치, 그리고 글쓰기 흐름에 제공할 수 있는 기능
- 검색 개수(recall)를 어떻게 조정하고, 응답이 실제로 검색한 내용을 반환하게 만들어 문제를 추적하는 방법
- 파일을 삭제한 뒤에도 단기간 검색될 수 있는 이유와, 글쓰기 시스템이 여기에 어떻게 대응해야 하는지
- 자료 누락, 검색 실패, 생성 오류라는 세 가지 문제를 각각 어느 계층에서 고쳐야 하는지
- 적재 시 어떤 메타데이터를 저장해야 지난 제한을 현행 규칙으로 잘못 쓰는 일을 막을 수 있는지
인덱스: 본문에 앞서 몇 가지 핵심 개념을 설명하고, 대상별로 미치는 영향을 정리해요. “객관적 사실” 부분은 OpenAI 공식 문서를 근거로 File Search의 동작 방식, 조정 가능한 파라미터, 알려진 동작을 살펴봐요. “분석과 판단” 부분에서는 이 기능을 글쓰기 시스템에 넣었을 때의 역할 분담, 문제 해결 경로, 적재 규범을 논의하고, 마지막으로 경계해야 할 몇 가지 오해를 짚어요.
OpenAI File Search 관련 개념 알아보기
| 개념 | 간단한 설명 |
|---|---|
| Responses API | OpenAI의 응답 생성 인터페이스로, 한 번의 요청에서 도구를 연결할 수 있어요. File Search도 그중 하나예요 |
| File Search | Responses API의 내장 도구로, 벡터 저장소에 있는 파일에서 관련 청크를 검색해 답변 생성을 도와요 |
| 벡터 저장소(Vector Store) | 업로드된 파일과 그 벡터 표현을 저장하는 저장소로, File Search의 검색 범위가 바로 이 저장소예요 |
| 시맨틱 검색 | 의미 유사도를 기준으로 내용을 찾는 방식이에요. 표면적인 단어가 달라도 의미가 관련된 단락을 찾아낼 수 있어요 |
| 파일 인용(Citation) | 답변에서 어떤 내용이 어느 파일에서 나왔는지 표시해, 독자와 검토자가 다시 확인하기 쉽게 해요 |
max_num_results |
한 번의 검색에서 최대 몇 개 결과를 반환할지 제어하는 매개변수예요 |
include |
요청 매개변수로, file_search_call.results를 전달하면 응답에 실제로 검색된 내용이 포함돼요 |
| 최종 일관성 | 쓰기나 삭제 작업이 모든 곳에 즉시 반영되지 않아, 단시간 내에는 이전 상태가 보일 수 있어요 |
OpenAI File Search 영향 한눈에 보기
| 대상 | 주요 영향 |
|---|---|
| 글쓰기 시스템 개발자 | 자체 검색 서비스를 구축하지 않고도 시맨틱 검색과 파일 인용을 얻을 수 있어요. 하지만 데이터 적재 기준과 문제 해결 절차는 직접 설계해야 해요 |
| 콘텐츠 편집자 / 검토자 | 인용은 다시 확인하는 일을 편하게 해 주지만, 결론은 여전히 하나하나 검증해야 하며 “인용이 있다”는 이유만으로 바로 승인해서는 안 돼요 |
| 기술 문서 유지보수 담당자 | 신규·구 버전 문서에 버전과 날짜를 잘 표시해야 해요. 그렇지 않으면 오래된 제한 사항이 검색되어 새 글에 포함될 수 있어요 |
| 비용 책임자 | 벡터 저장소 저장 비용과 도구 호출 모두 과금되며, 정확한 기준은 OpenAI의 현재 가격 페이지를 확인해야 해요. 자료양이 많다면 비용을 미리 추산해야 해요 |
OpenAI File Search 객관적 사실
아래 내용은 OpenAI 개발자 문서 가운데 File Search와 Retrieval 두 가이드를 근거로 하며, 확인 날짜는 2026-11-17이에요. 두 문서는 계속 관리되고 있는 문서이고, 이 글에서는 해당 기능의 최초 공개 날짜를 확인하지 않았어요.
File Search란 무엇인가: Responses API 안의 검색 도구
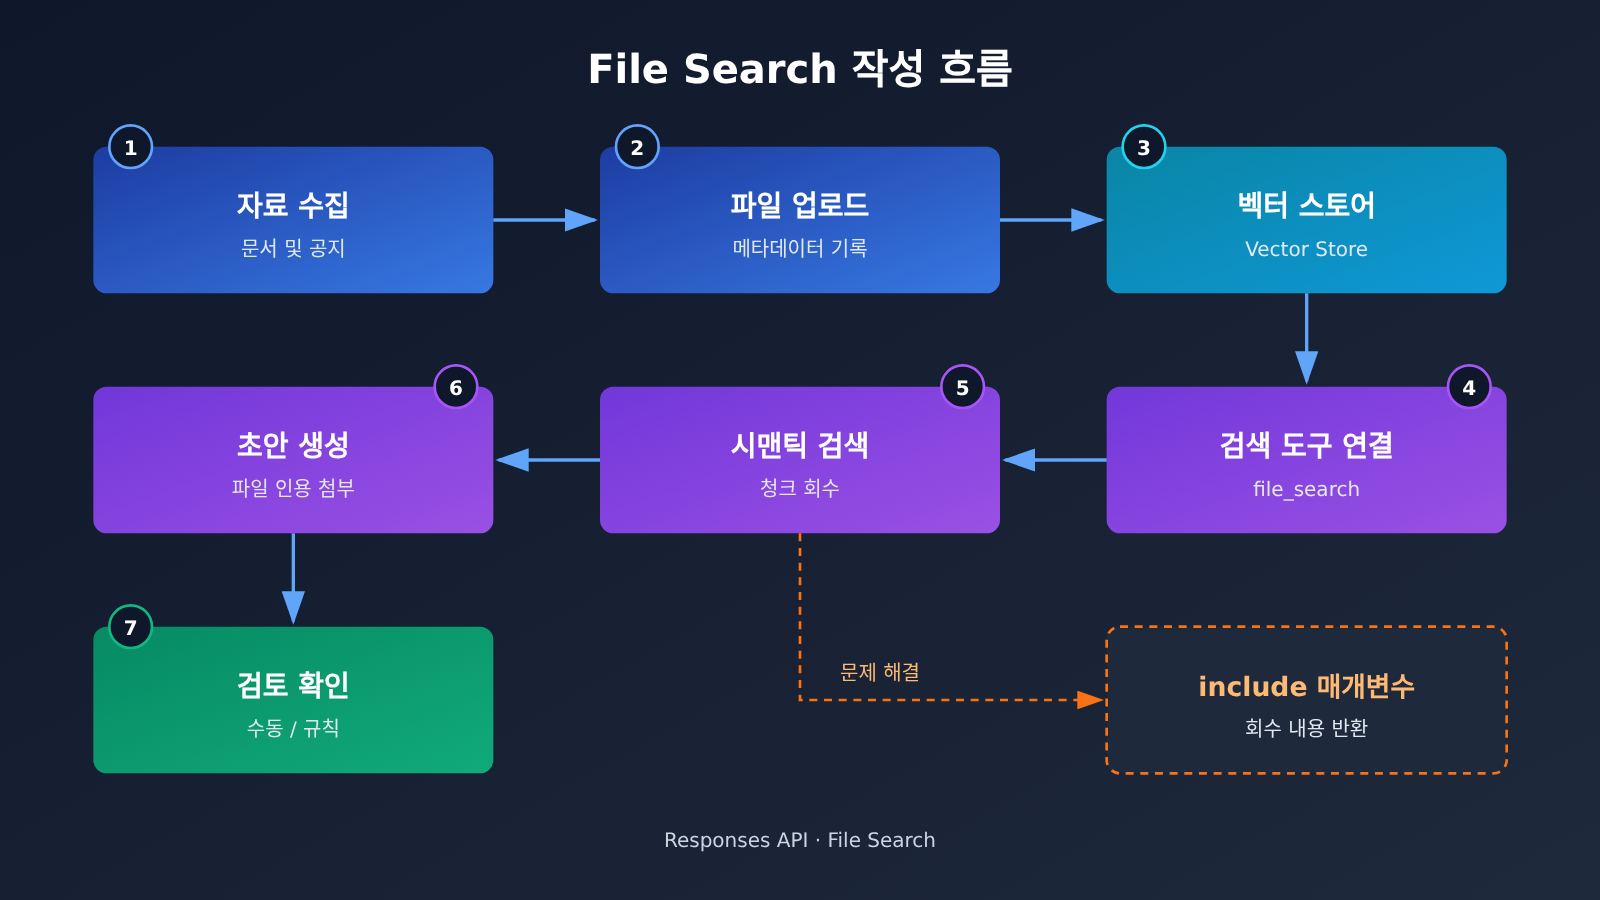
File Search는 Responses API가 제공하는 도구예요. 개발자는 먼저 파일을 벡터 스토어에 업로드하고, 요청을 보낼 때 tools에 File Search를 선언하면서 벡터 스토어를 지정해요. 모델이 답변을 생성할 때 이 파일들에서 관련 내용을 검색하고, 답변에는 파일 참조를 붙여 정보 출처를 표시할 수 있어요.
의미 기반 검색을 사용하기 때문에, 의미는 이어지지만 단어가 완전히 일치하지 않는 내용도 찾아낼 수 있어요. 예를 들어 “인터페이스 속도 제한”을 검색했는데 문서에 “요청 빈도 상한”이라고 적혀 있어도 검색될 수 있어요. 글쓰기 시스템 입장에서 이 말은, 질문할 때 원문 표현을 똑같이 따라 쓸 필요가 없다는 뜻이에요.
File Search의 조정 파라미터와 트러블슈팅 스위치
문서에서 작성 시스템과 가장 직접적으로 맞닿아 있는 파라미터 두 가지를 정리하면 다음과 같아요:
| 파라미터 / 동작 | 역할 | 작성 흐름에서의 의미 |
|---|---|---|
max_num_results |
한 번의 검색에서 반환되는 결과 수를 조정 | 수가 적으면 컨텍스트를 아끼지만 근거가 불완전할 수 있고, 많으면 범위는 넓어지지만 노이즈도 함께 늘어나요 |
| 기본 반환 내용 | 도구 호출은 기본적으로 전체 검색 결과를 반환하지 않아요 | 최종 답변만 보면 모델이 실제로 무엇을 읽었는지 판단할 수 없어요 |
include: ["file_search_call.results"] |
응답에 실제로 회수된 내용을 포함시키기 | “검색되지 않음”과 “검색은 됐지만 잘못 씀”을 구분할 수 있어서 트러블슈팅에 필수예요 |
| 파일 인용 | 답변에 출처 파일을 표시 | 다시 확인하기엔 편하지만, 결론이 맞다는 뜻은 아니에요 |
아래는 최소 호출 예시예요. 벡터 스토어를 연결하고, 검색 수를 제한하며, 응답에 검색 결과를 함께 반환하도록 요구하는 방법을 보여줘요. 모델 이름과 벡터 스토어 ID는 여러분의 설정으로 바꿔 주세요:
from openai import OpenAI

client = OpenAI()  # 환경 변수 OPENAI_API_KEY에서 키를 읽어요

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # 검색 수: 근거 범위와 노이즈 사이의 균형점
    }],
    include=["file_search_call.results"],  # 실제 검색된 내용을 반환해서 트러블슈팅을 쉽게
)

# 출력 순회: 최종 텍스트도 얻고, 어떤 청크가 검색됐는지도 확인할 수 있어요
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
File Search 파일 삭제의 최종 일관성
문서에 따르면 벡터 스토어에서 파일을 삭제하는 작업은 최종 일관성(eventual consistency) 을 가집니다. 즉, 삭제한 뒤 일정 시간 동안은 해당 파일이 여전히 검색될 수 있어요. 그래서 “삭제하면 즉시 검색되지 않는다”라고 대외적으로 내세울 수는 없습니다. 만약 어떤 자료가 잘못되었거나 기간이 지나 반드시 서비스에서 내려가야 한다면, 작성 시스템은 삭제 작업에만 의존하지 말고 자체 계층에서도 필터링을 하는 것이 좋아요.
File Search가 하지 않는 일
공식 문서의 설명과 도구 자체의 동작 방식을 보면, 몇 가지는 분명히 짚고 넘어가야 해요:
- File Search는 벡터 스토어에 이미 존재하는 파일만 검색하며, 인터넷상의 새로운 공지나 문서 업데이트를 자동으로 발견하지 않습니다.
- 인용 표시는 내용이 어느 파일에서 왔는지를 알려줄 뿐, 그 파일을 근거로 도출한 결론이 올바른 것까지 보장하지는 않아요.
- 벡터 스토어 저장과 도구 호출 모두 과금되며, 비용은 OpenAI가 현재 공표한 가격을 기준으로 합니다. 이 글에서는 구체적인 수치를 제시하지 않아요.
- 이 글은 APIYI나 기타 서드파티 플랫폼이 File Search 관련 인터페이스와 호환되는지 검증하지 않았습니다. 관련 지원 여부는 각 플랫폼의 공식 설명을 기준으로 확인해 주세요.
OpenAI File Search 분석 판단
판단 1: File Search가 보완하는 건 “검색 계층”이지 “자료 계층”이 아니에요
글쓰기 시스템의 자료 부족은 보통 두 가지 양상으로 나타나요. 하나는 자료는 가지고 있지만 정확히 찾지 못하는 경우예요. 모델이 기억에 의존해 글을 쓰고, 출처도 명확히 밝히지 못하죠. 다른 하나는 아예 자료가 없거나, 자료가 이미 낡아버린 경우예요. File Search는 첫 번째 경우에 아주 효과적이에요. 시맨틱 검색은 관련 자료를 더 유연하게 끌어오고, 파일 인용 덕분에 각 콘텐츠를 다시 확인할 수 있어요.
두 번째 경우에는 아무것도 할 수 없어요. 이 도구는 새로운 공지를 먼저 가져오지 않아요. 벡터 DB에 무엇이 들어 있는지, 그만큼만 검색할 수 있죠. 예를 들어 어떤 모델의 가격이나 제한이 방금 조정됐는데 DB에는 옛 문서만 있다면, File Search는 “정확하게” 만료된 정보를 검색한 뒤 그럴듯하게 신뢰할 만한 인용까지 붙여줘요. 이건 인용이 없는 것보다 더 위험해요. 검토를 더 쉽게 통과할 수 있으니까요.
그래서 File Search는 글쓰기 시스템의 한 계층으로 봐야 하고, 전체 자료 방안으로 보면 안 돼요. 자료 수집, 정기 업데이트, 버전 폐기는 여전히 별도의 프로세스가 담당해야 해요.
판단 2: 삼분법으로 File Search 작성 문제 파악하기
한 편의 글이 잘못 작성됐을 때, 문제는 세 가지 다른 단계에서 발생할 수 있어요. include: ["file_search_call.results"]의 가치는 이 세 가지 문제를 처음으로 구분할 수 있게 해준다는 데 있어요.
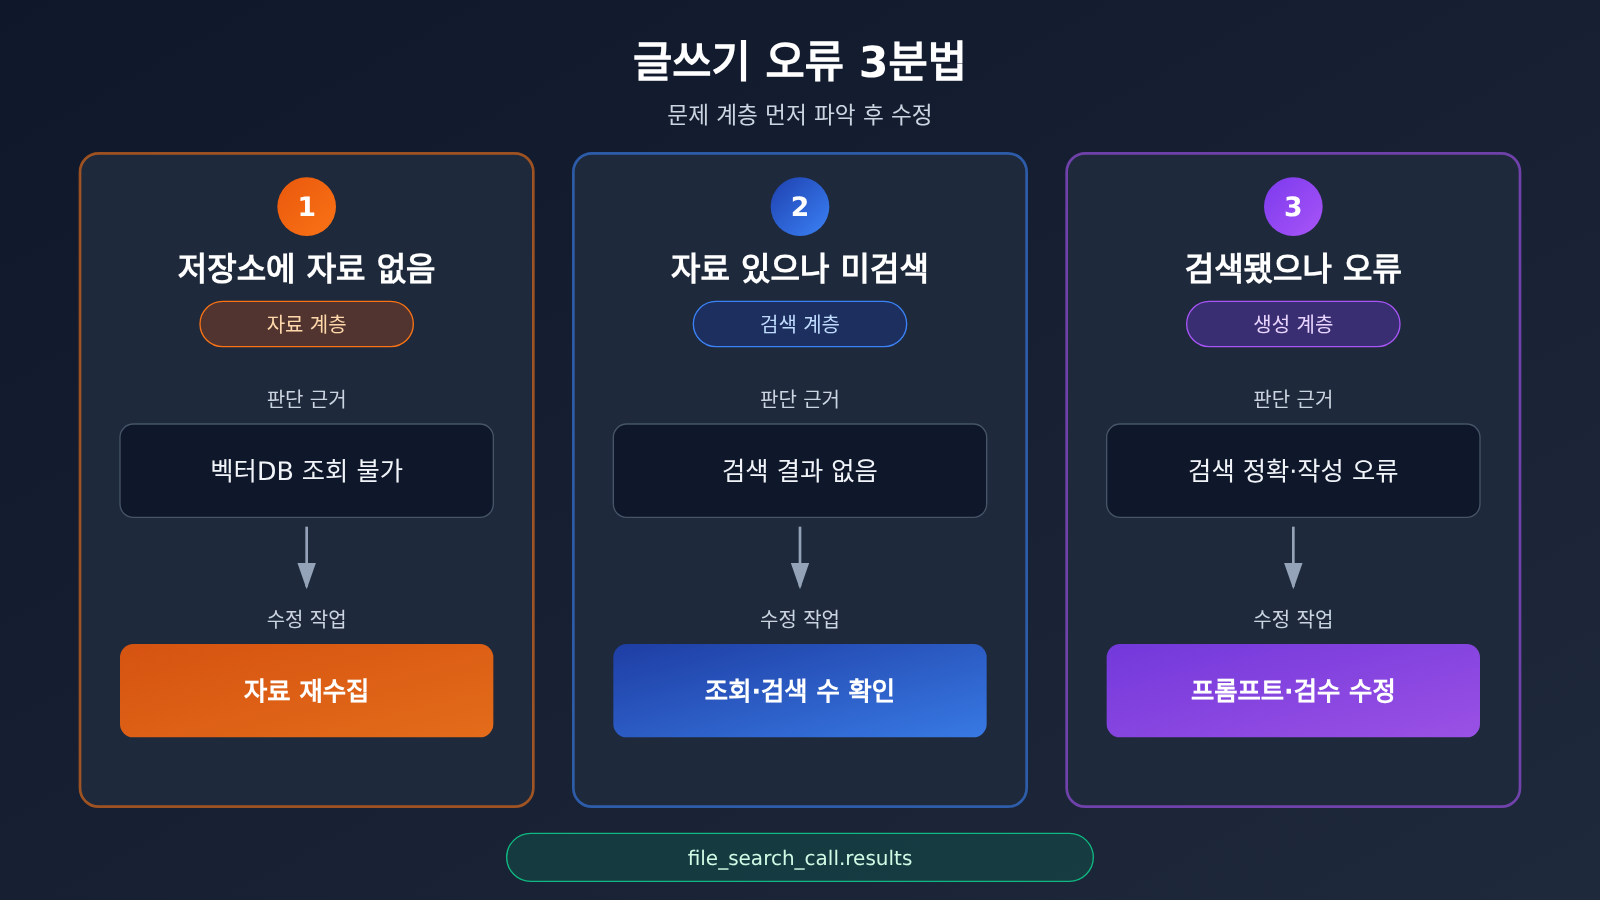
| 문제 유형 | 판단 근거 | 수정 방향 |
|---|---|---|
| 라이브러리에 자료 없음 | 벡터 라이브러리에서 관련 파일을 찾을 수 없음 | 자료 추가 수집, 자료 계층 문제에 해당 |
| 자료는 있지만 미검색 | 파일이 라이브러리에 있지만 file_search_call.results에 없음 |
쿼리 표현 조정, 질문 분할, 또는 max_num_results 적절히 증가 |
| 검색됐지만 잘못 작성 | 검색 결과는 올바르지만 완성 원고와 일치하지 않음 | 생성 프롬프트와 검토 규칙 수정, 생성 계층 문제에 해당 |
검색 내용이 반환되지 않으면, 팀은 흔히 “AI가 또 지어냈다”고 뭉뚱그려 말하고 나서 프롬프트를 고치려 해요. 많은 경우 진짜 원인은 라이브러리에 이 자료가 없거나, 쿼리가 이를 맞히지 못한 것이에요. 먼저 문제가 어느 계층에서 발생했는지 파악한 뒤 움직이면 훨씬 덜 헤매게 돼요.
판단 3: OpenAI File Search 인덱싱 메타데이터가 글쓰기 품질의 상한을 결정해요
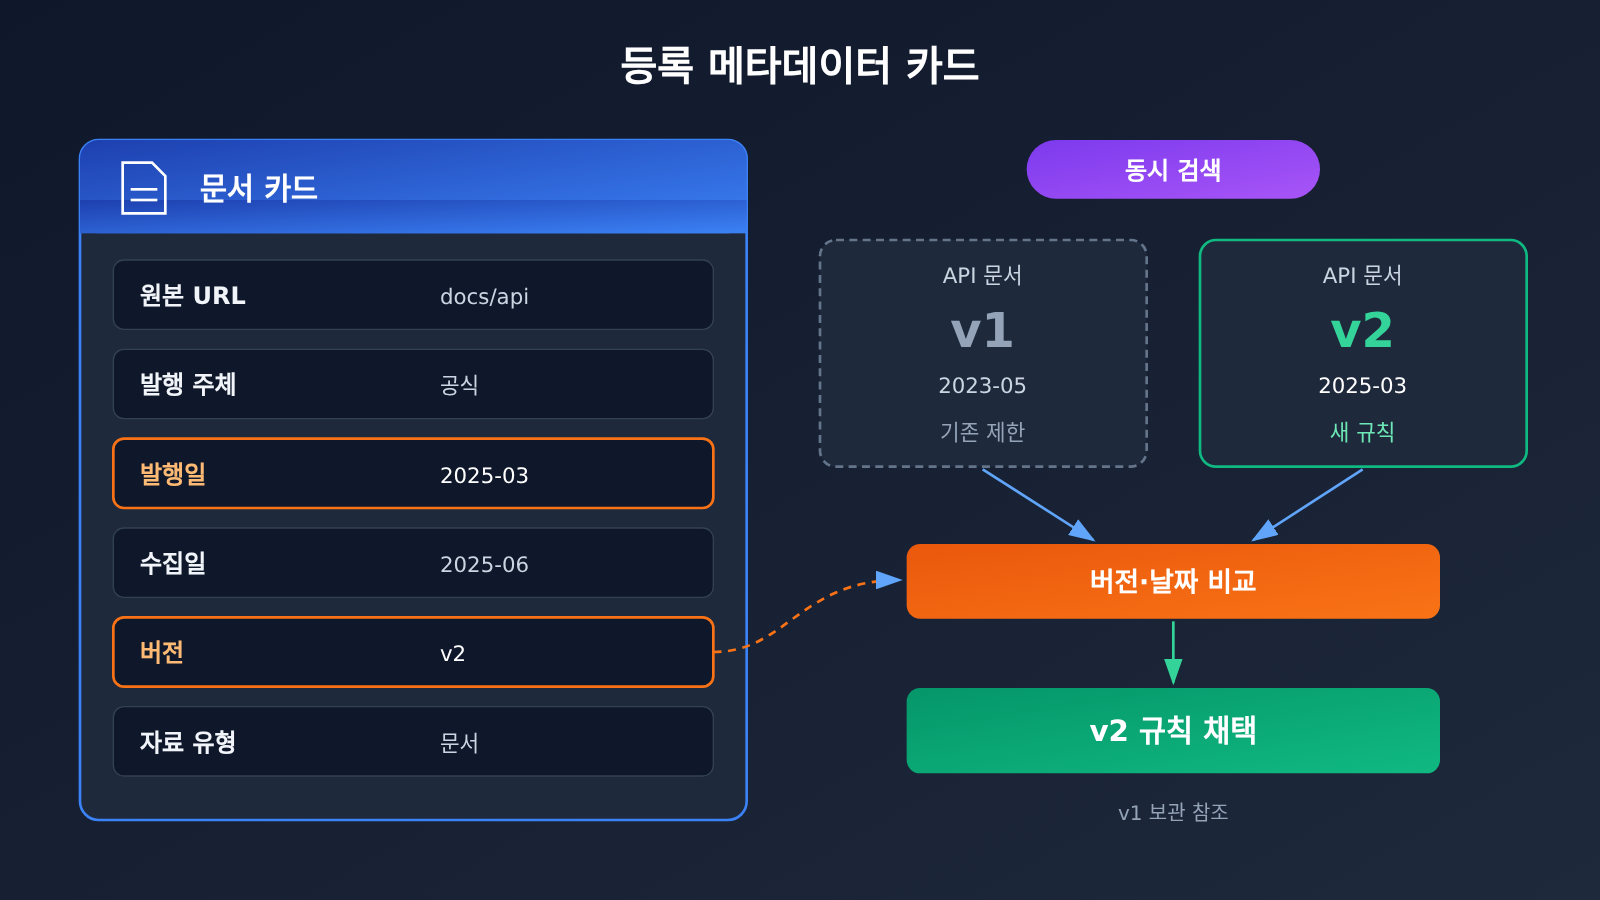
검색은 저장소에 들어 있는 내용만 반환할 수 있고, 저장소 속 내용의 품질은 인덱싱할 때 무엇을 기록했는지에 달려 있어요. 글쓰기 시스템에서는 파일 본문만 업로드해서는 부족하니, 각 자료에 최소한 다음 정보를 함께 붙이길 권해요:
| 메타데이터 필드 | 용도 |
|---|---|
| 원본 URL | 원본을 확인하러 돌아가기 쉽고, 참고 자료에 나열할 수도 있어요. |
| 발행 주체 | 공식 발언, 제3자 해석, 커뮤니티 소문을 구분해요. |
| 발행일 | 정보가 아직 유효한지 판단해요. |
| 수집일 | 자료가 얼마나 오래 업데이트되지 않았는지 판단해요. |
| 버전 번호 | 신·구 문서가 공존할 때 오래된 제한을 현행 규칙으로 오인하지 않게 해요. |
| 자료 유형 | 공지, 문서, 블로그, 포럼 게시글을 구분해 신뢰도를 설정하기 쉬워요. |
그중 버전 정보가 가장 쉽게 간과돼요. 같은 API의 신·구 문서가 모두 저장소에 있을 수 있고, 의미상 매우 비슷해서 검색할 때 동시에 반환될 가능성이 커요. 버전과 날짜가 없으면 모델이 어느 제한이 이미 폐지됐는지 판단하기 어려워요. 오래된 문서를 바로 삭제하는 것보다 버전 정보를 남기는 편이 더 안전해요. 하나는 과거 버전과 비교하는 글을 쓸 때 여전히 쓰이고, 또 하나는 삭제 자체도 최종 일관성을 따르기 때문에 지웠다고 해서 바로 사라지는 건 아니거든요.
판단 4: 검색 결과 수에는 정답이 없어요
max_num_results를 작게 조정하면 컨텍스트가 더 깔끔해지고 비용과 노이즈가 모두 낮아지지만, 핵심 근거를 놓칠 수 있어요. 특히 여러 자료를 서로 대조해야 하는 주제에서 이런 문제가 생기죠. 가격, 제한 조건, 버전 차이를 동시에 다루는 경우처럼 말이에요. 반대로 크게 조정하면 더 폭넓게 포괄하지만, 무관한 조각들이 주의를 분산시키고 모델이 서로 다른 버전의 정보를 섞어 쓸 가능성도 높아져요.
비교적 현실적인 방법은 글 유형별로 나눠서 설정하는 거예요. 뉴스 해설 유형은 여러 출처의 교차 검증이 필요하니 적절히 넉넉하게 잡을 수 있고, 단일 API의 파라미터 설명이라면 좁힐 수 있죠. 구체적인数值에 범용적인 최적해는 없으며, 감으로 고정값을 정하기보다는 반환된 검색 내용을 실제로 관찰한 뒤 조정해야 해요.
주목해야 할 후속 변화
다음 몇 가지는 지켜볼 만한 방향이며, 아직 확인된 사실은 아니에요: File Search가 버전이나 날짜로 직접 필터링할 수 있도록 더 세밀한 메타데이터 필터링을 제공할지, 삭제 작업의 반영 지연에 대해 더 명확한 설명이 나올지, 과금 방식이 조정될지. 이런 변화는 모두 글쓰기 시스템의 아키텍처 선택에 직접 영향을 주니, 연동하기 전에 공식 문서와 가격 페이지를 다시 확인하시길 권해요.
File Search를 글쓰기 시스템에 연동할 때 가장 흔한 오판은 “검색과 인용 기능이 있으니 자료 문제는 해결됐다”고 생각하는 거예요. 실제로는 이미 가진 자료를 더 잘 활용하게 해줄 뿐이고, 자료 자체의 최신성과 정확성은 여전히 수집, 버전 관리, 검수를 통해 보장해야 해요.
어찌하여 못이 이처럼 맑을까? 근원에서 살아오는 물이 있기 때문이지. — 주희(朱熹), 《관서유감(觀書有感)》


