
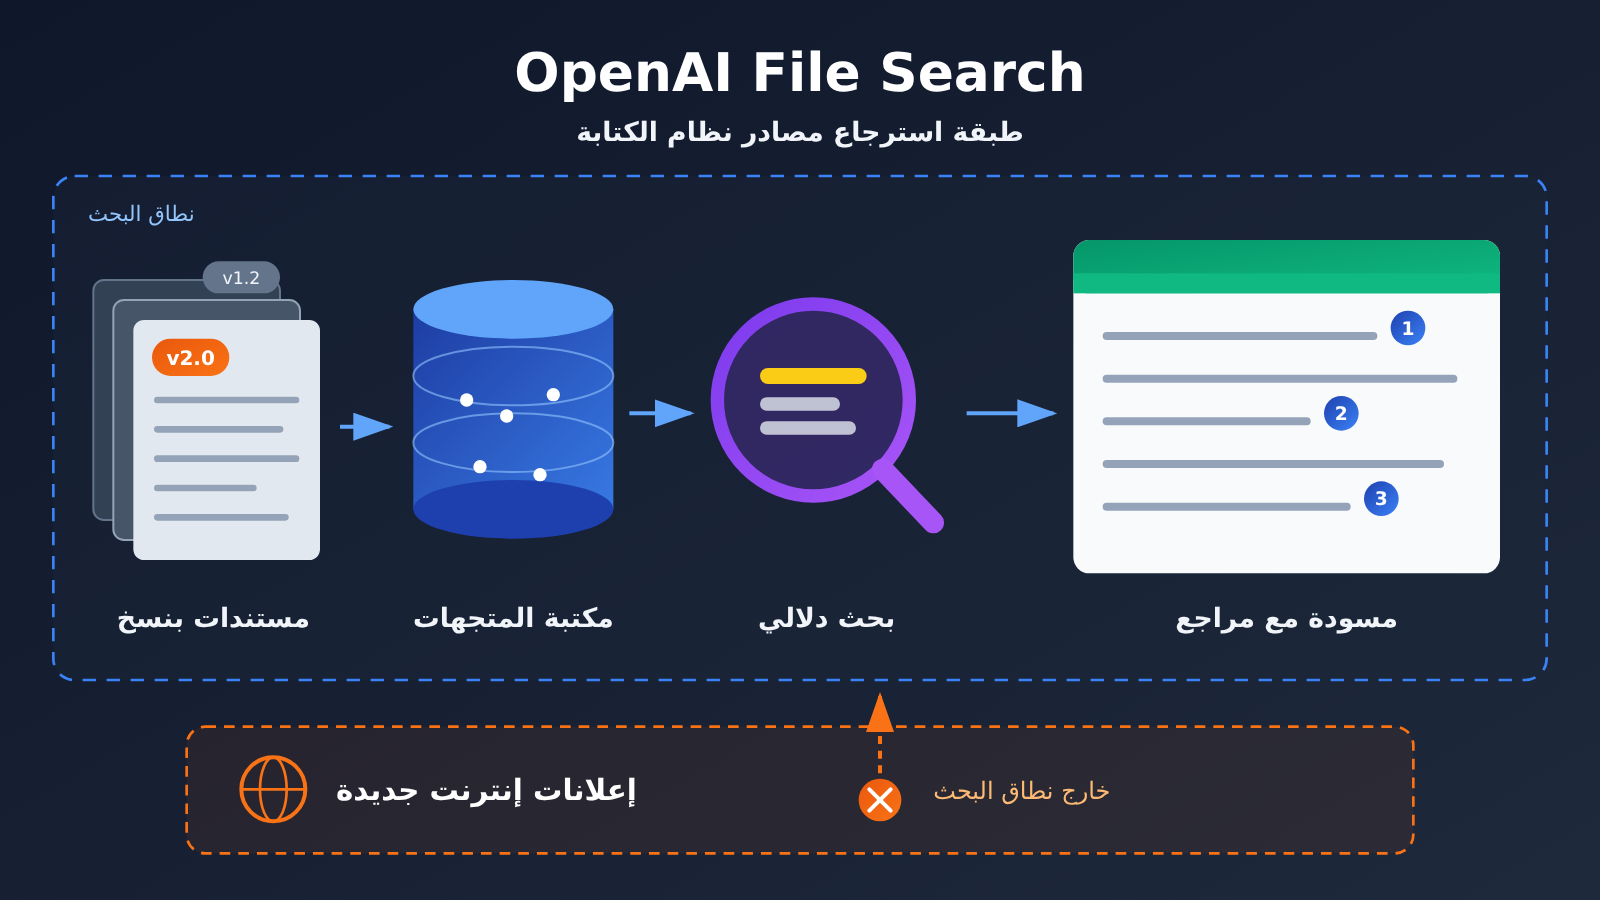
يمكنه سدّ جزء من الفجوة، لكنه لا يسدّها كلها. يعالج OpenAI File Search مشكلة «عدم دقة العثور على المواد المتوفرة، وعدم وضوح الاستناد إليها». فهو يستطيع استرجاع الملفات دلاليًا من مكتبة المتجهات، وإرفاق مراجع الملفات في الإجابة، وهذا مفيد جدًا لنظام الكتابة. لكنه لا يعالج مشكلة «غياب المادة نفسها أو انتهاء صلاحيتها»: فالأداة تسترجع فقط الملفات التي أضفتها أنت، ولا تكتشف تلقائيًا الإعلانات الجديدة على الإنترنت. وعلامات الاستناد لا تدل إلا على الملف الذي جاء منه المحتوى، ولا تضمن صحة الاستنتاج.
لذا فالحكم الأدق هو: يمكن أن يكون File Search «طبقة استرجاع المواد» في نظام الكتابة، بينما يبقى جمع المواد وإدارة الإصدارات ومراجعة الوقائع مهامًا مستقلة يجب القيام بها على حدة.
ماذا ستخرج به من هذا المقال؟
- موقع File Search داخل Responses API، وما هي القدرات التي يقدمها لسير عمل الكتابة
- كيفية ضبط عدد النتائج المسترجعة، وكيف تجعل الاستجابة تعيد المحتوى الذي تم استرجاعه فعليًا، لتسهيل تشخيص المشكلات
- لماذا قد يظل الملف قابلاً للاسترجاع لفترة قصيرة بعد حذفه، وكيف ينبغي لنظام الكتابة التعامل مع ذلك
- أين يجب إصلاح كل نوع من المشكلات الثلاث: غياب المادة، وفشل الاسترجاع، والخطأ في التوليد
- ما البيانات الوصفية (metadata) التي يُنصح بحفظها عند الإدخال إلى المكتبة، لتجنب كتابة قيود منتهية الصلاحية كقواعد سارية
فهرس المحتويات: يبدأ تمهيد المقال بشرح بعض المفاهيم الأساسية، ثم عرض التأثيرات مرتبة حسب فئة الجمهور. أما قسم «الوقائع الموضوعية» فيعتمد على وثائق OpenAI الرسمية، ويعرض طريقة عمل File Search والمعاملات القابلة للضبط والسلوكيات المعروفة. ويناقش قسم «التحليل والحكم» تقسيم الأدوار بعد إدخاله في نظام الكتابة، ومسار استكشاف الأخطاء وإصلاحها، وقواعد الإدخال إلى المكتبة، ويوضح في الختام بعض المفاهيم الخاطئة التي يجب الحذر منها.
مفاهيم يجب معرفتها حول OpenAI File Search
| المفهوم | شرح موجز |
|---|---|
| Responses API | واجهة توليد الاستجابات من OpenAI، ويمكنك ربط الأدوات في طلب واحد، وFile Search إحدى هذه الأدوات |
| File Search | أداة مدمجة في Responses API تسترجع مقاطع ذات صلة من ملفات مخزن المتجهات، لتساعد في توليد الإجابة |
| مخزن المتجهات (Vector Store) | مخزن يحتفظ بالملفات المرفوعة وتمثيلاتها المتجهية، وهو نطاق الاسترجاع الذي يعمل عليه File Search |
| البحث الدلالي | البحث عن المحتوى حسب تشابه المعنى، فيمكن العثور على مقاطع تختلف ألفاظها الحرفية لكن تتقارب معانيها |
| الإحالة إلى الملف (Citation) | تحديد الملف الذي جاء منه جزء معين من الإجابة، ليعود إليه القارئ والمراجع بسهولة |
max_num_results |
معامل يحدد الحد الأقصى لعدد النتائج التي تعيدها عملية استرجاع واحدة |
include |
معامل في الطلب، عند تمرير file_search_call.results تصبح الاستجابة تضم المحتوى المسترجع فعليًا |
| الاتساق النهائي | عمليات الكتابة أو الحذف لا تسري فورًا في كل مكان، فقد ترى حالة قديمة لفترة قصيرة |
نظرة سريعة على تأثير OpenAI File Search
| الفئة | التأثير الرئيسي |
|---|---|
| مطورو أنظمة الكتابة | يحصلون على بحث دلالي وإحالات إلى الملفات دون بناء خدمة استرجاع خاصة بهم. لكن عليهم تصميم معايير إدخال الملفات وإجراءات استكشاف الأخطاء بأنفسهم |
| محررو المحتوى / المراجعون | الإحالات تسهّل المراجعة، لكن يبقى عليهم التحقق من كل استنتاج بندًا بندًا، ولا يمكن تمرير شيء لمجرد أنه «يحمل إحالة» |
| القائمون على صيانة الوثائق التقنية | يجب وسم الوثائق بالنسخة والتاريخ، وإلا فقد يسترجع البحث قيودًا من نسخة قديمة وتُكتب في مقال جديد |
| مسؤولو التكاليف | تخزين مخزن المتجهات واستدعاءات الأدوات كلها تُحاسب عليها، والفصل يعود إلى صفحة أسعار OpenAI الحالية، وعندما تكبر كمية البيانات يصبح التقدير المسبق ضروريًا |
حقائق موضوعية حول File Search من OpenAI
يعتمد المحتوى التالي على دليلي File Search وRetrieval في وثائق مطوري OpenAI، وكان تاريخ التحقق 2026-11-17. هذان الدليلان وثيقتان قيد الصيانة، ولم يتم التحقق في هذا المقال من تاريخ الإصدار الأول لهذه الميزة.
ما هو File Search: أداة استرجاع داخل Responses API
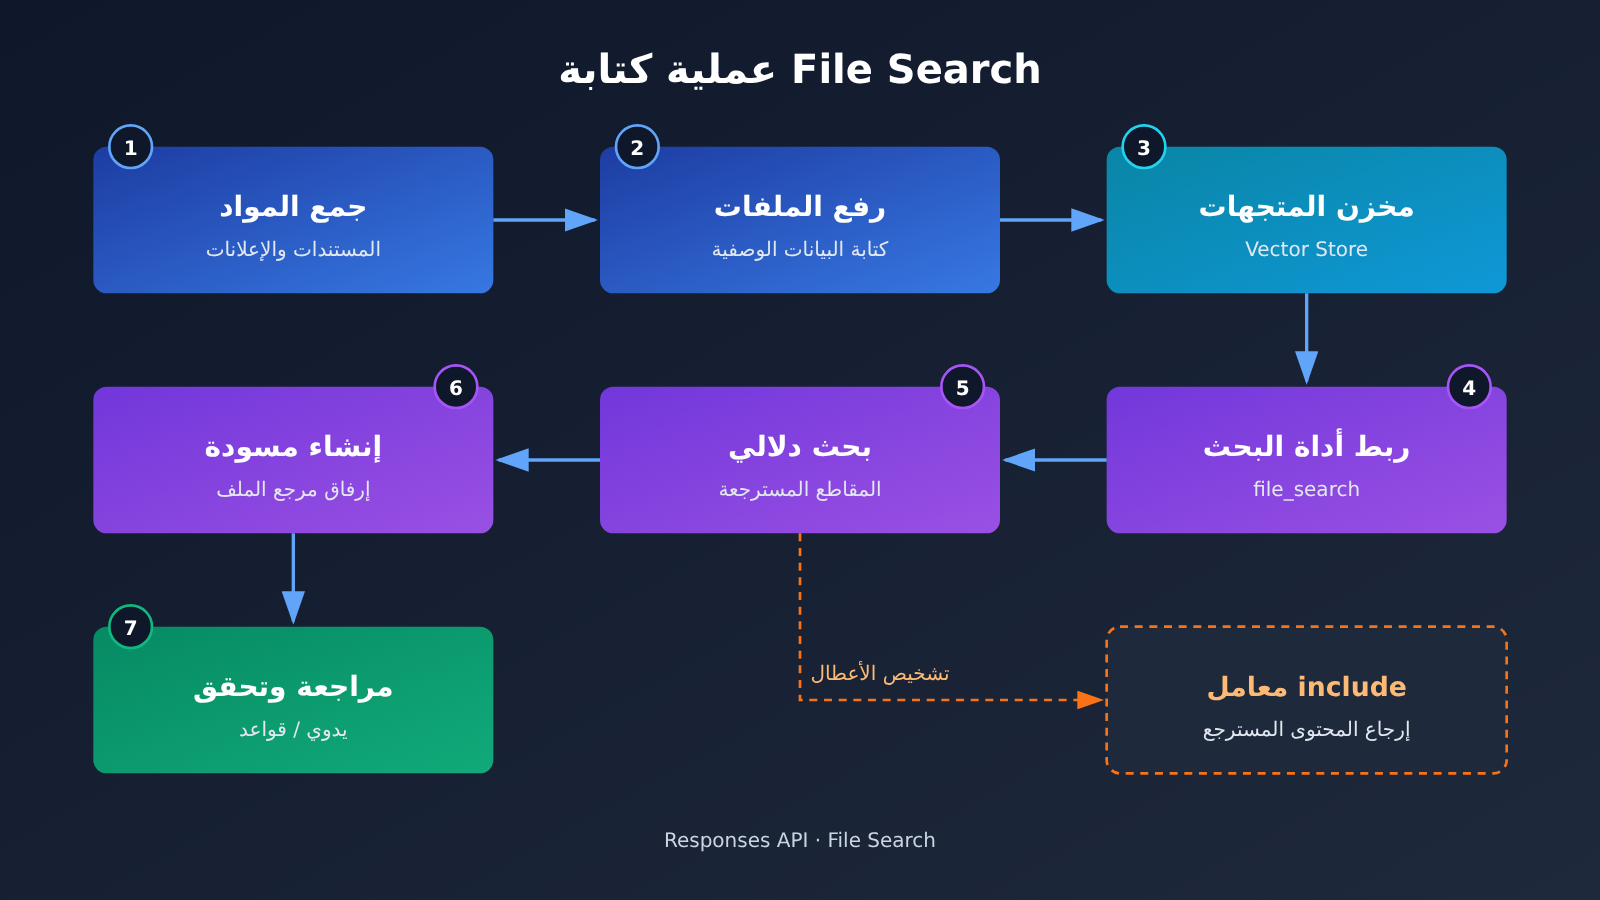
File Search أداة تقدمها Responses API. يرفع المطور الملفات أولًا إلى مخزن المتجهات، ثم يعلن File Search ضمن tools عند إرسال الطلب ويحدد مخزن المتجهات. وخلال توليد الإجابة يسترجع النموذج محتوى ذا صلة من هذه الملفات، ويمكن أن تأتي الإجابة مرفقة بمراجع للملفات تحدد مصدر المعلومات.
تعتمد الأداة على الاسترجاع الدلالي، فتجد محتوى مرتبطًا بالمعنى حتى لو لم تتطابق الألفاظ تمامًا. فمثلًا عند الاستعلام عن «تحديد معدل الطلبات» بينما المكتوب في الوثيقة «الحد الأعلى لتكرار الطلبات»، فقد يُسترجع المحتوى ذاك أيضًا. وبالنسبة لأنظمة الكتابة، يعني هذا أنك لست مضطرًا عند طرح السؤال إلى نسخ صياغة النص الأصلي حرفيًا.
معاملات File Search القابلة للضبط ومفاتيح تشخيص الأعطال
هناك معاملان في التوثيق يرتبطان ارتباطًا مباشرًا بنظام الكتابة:
| المعامل / السلوك | الوظيفة | ما يعنيه بالنسبة لسير عمل الكتابة |
|---|---|---|
max_num_results |
ضبط عدد النتائج التي يعيدها البحث الواحد | عدد أقل يعني استهلاكًا أقل للسياق، لكن الأدلة قد تكون ناقصة؛ وعدد أكبر يعني تغطية أوسع، لكن الضجيج يزداد أيضًا |
| المحتوى المُعاد افتراضيًا | استدعاء الأداة لا يعيد نتائج البحث الكاملة افتراضيًا | عند النظر إلى الإجابة النهائية فقط، لا يمكنك معرفة ما قرأه النموذج فعلًا |
include: ["file_search_call.results"] |
جعل الاستجابة تحتوي على المحتوى المسترجع فعليًا | يمكّنك من التمييز بين “لم يُسترجع شيء” و”استُرجع لكن الكتابة جاءت خاطئة”، وهو أمر ضروري عند التشخيص |
| الإحالات إلى الملفات | وضع أسماء الملفات المصدرية في الإجابة | يسهّل الرجوع للتحقق، لكنه لا يعني أن الاستنتاج صحيح |
فيما يلي مثال استدعاء بأبسط صورة، يوضح كيفية ربط مخزن المتجهات، وتقييد عدد النتائج المسترجعة، وطلب أن تعيد الاستجابة نتائج البحث. استبدل اسم النموذج ومعرّف مخزن المتجهات في المثال بإعداداتك الخاصة:
from openai import OpenAI

client = OpenAI()  # قراءة المفتاح من متغير البيئة OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # عدد النتائج المسترجعة: موازنة بين تغطية الأدلة والضجيج
    }],
    include=["file_search_call.results"],  # إعادة المحتوى المسترجع فعليًا لتسهيل التشخيص
)

# المرور على المخرجات: للحصول على النص النهائي ومعرفة المقاطع التي تم استرجاعها
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
الاتساق النهائي لحذف الملفات في File Search
توضح الوثائق أن حذف ملف من مكتبة المتجهات يخضع لمبدأ الاتساق النهائي: فقد يظل الملف قابلاً للاسترجاع لفترة من الوقت بعد الحذف. لذلك لا يمكن الجزم للعملاء بأن «الملف يصبح غير قابل للاسترجاع فور الحذف». وإذا كان لا بد من إيقاف مادة ما لأنها خاطئة أو منتهية الصلاحية، فمن الأفضل أن يقوم نظام الكتابة نفسه بالتصفية على مستواه الخاص، بدلاً من الاعتماد على عملية الحذف وحدها.
ما لا يفعله File Search
بناءً على ما تصفه الوثائق الرسمية وآلية عمل الأداة، هناك عدة نقاط ينبغي توضيحها:
- يبحث File Search فقط في الملفات الموجودة بالفعل داخل مكتبة المتجهات، ولا يكتشف تلقائياً الإعلانات الجديدة أو تحديثات المستندات على الإنترنت.
- توضح علامات الاقتباس الملف الذي جاء منه المحتوى، لكنها لا تضمن صحة الاستنتاجات المستندة إلى ذلك الملف.
- تخزين مكتبة المتجهات واستدعاء الأداة كلاهما مدفوع، وتُحدد التكلفة وفق الأسعار التي تعلنها OpenAI حالياً، ولا يقدم هذا المقال أرقاماً محددة.
- هذا المقال لم يتحقق من توافق APIYI أو أي منصة أخرى تابعة لجهات خارجية مع الواجهات المتعلقة بـ File Search، وللاطلاع على حالة الدعم يُرجى الرجوع إلى البيانات الرسمية لكل منصة.
تحليل وتقييم OpenAI File Search
الحكم الأول: File Search يعالج “طبقة الاسترجاع” لا “طبقة المصادر”
غالبًا ما تظهر ثغرة المصادر في أنظمة الكتابة على شكلين. الشكل الأول: لديك مصادر، لكنك لا تستطيع تحديدها بدقة، فيكتب النموذج اعتمادًا على انطباعه، ولا يستطيع توضيح المصدر. الشكل الثاني: لا تملك مصادر أصلًا، أو أن مصادرك أصبحت قديمة. File Search فعّال جدًا مع الشكل الأول: فالبحث الدلالي يزيد مرونة الاستدعاء، والإحالات إلى الملفات تجعل كل فقرة قابلة للتحقق منها.
أما الشكل الثاني فلا يستطيع التعامل معه. فالأداة لا تذهب من تلقاء نفسها لجلب الإعلانات الجديدة، وما يوجد في قاعدة المتجهات هو كل ما تستطيع استرجاعه. فمثلًا لو عُدّل سعر نموذج ما أو قيوده للتو، بينما تحتوي القاعدة على الوثائق القديمة فقط، فإن File Search سيسترجع “بدقة” معلومات منتهية الصلاحية، ويزيّنها بإحالة تبدو موثوقة. وهذا أخطر من غياب الإحالة، لأنه أيسر في تجاوز المراجعة.
لذلك ينبغي النظر إلى File Search باعتباره طبقة واحدة داخل نظام الكتابة، وليس حلًا متكاملًا للمصادر. أما جمع المصادر وتحديثها الدوري واستبعاد النسخ القديمة، فلا تزال بحاجة إلى عمليات مستقلة تتولى ذلك.
المعيار الثاني: استخدام التصنيف الثلاثي لتحديد مشكلات الكتابة في File Search
عندما يخرج مقال مكتوبًا بشكل خاطئ، فقد تكمن المشكلة في إحدى ثلاث مراحل مختلفة. وتكمن قيمة include: ["file_search_call.results"] في أنها تتيح، للمرة الأولى، تمييز هذه الأنواع الثلاثة من المشكلات عن بعضها.
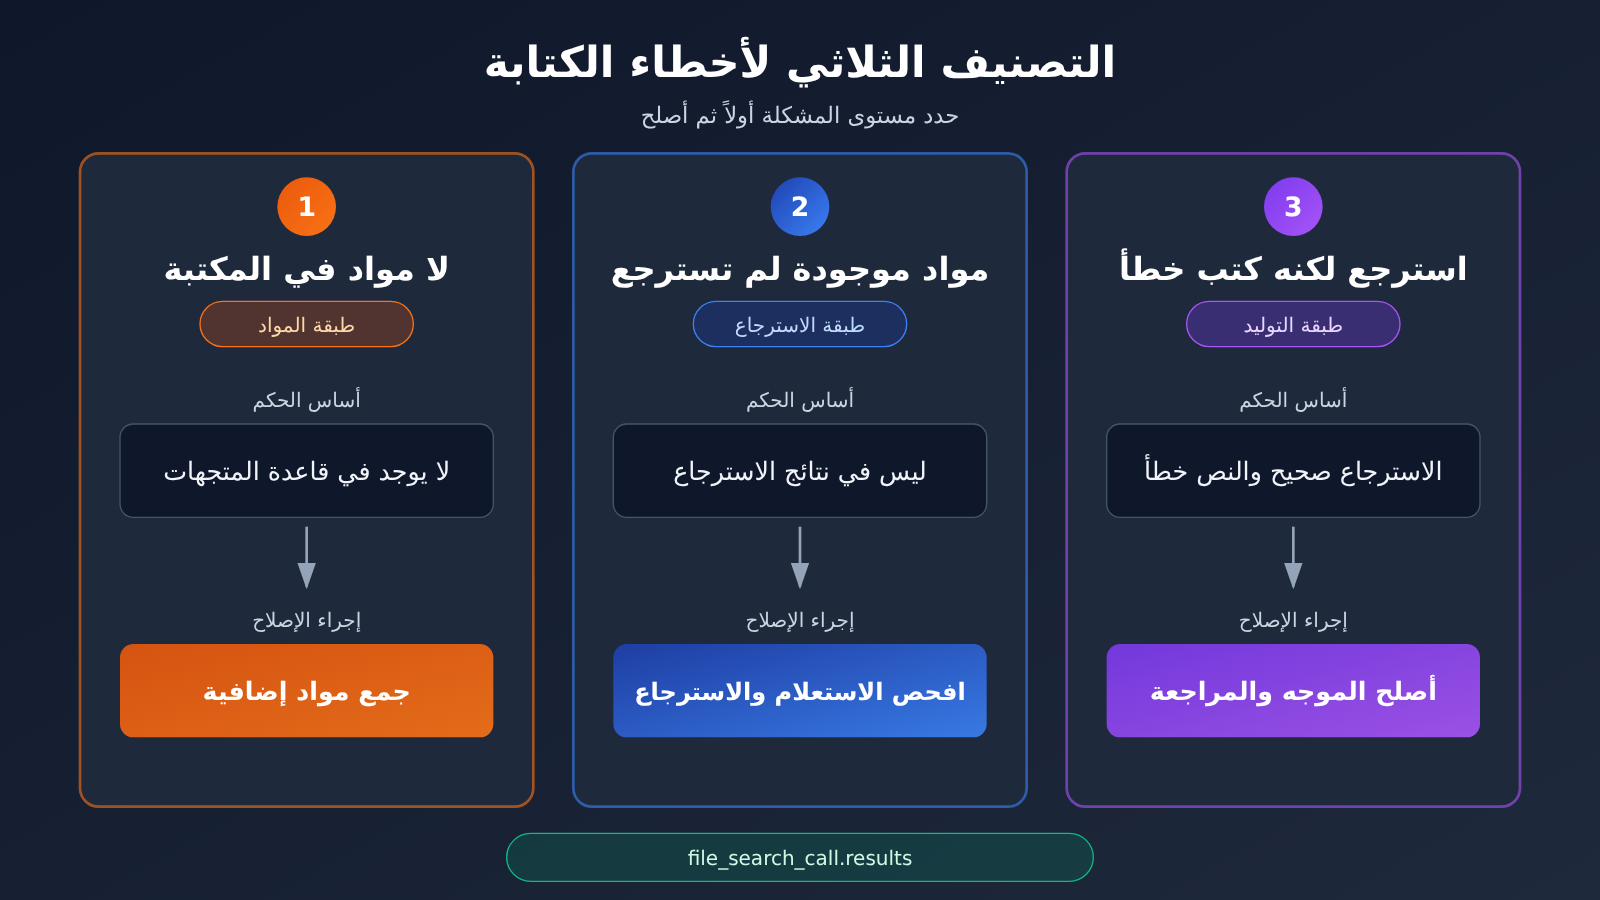
| نوع المشكلة | معيار التحديد | اتجاه الإصلاح |
|---|---|---|
| لا توجد مواد في المخزن | لا يمكن العثور على الملفات ذات الصلة في مخزن المتجهات | جمع مواد إضافية؛ وهذه مشكلة على مستوى المواد |
| توجد مواد لكنها لم تُسترجع | الملف موجود في المخزن، لكنه غير موجود في file_search_call.results |
ضبط صياغة الاستعلام، أو تقسيم السؤال، أو زيادة max_num_results بشكل مناسب |
| تم الاسترجاع لكن الكتابة خاطئة | نتائج الاسترجاع صحيحة، لكن المسودة النهائية لا تطابقها | تعديل موجه التوليد وقواعد المراجعة؛ وهذه مشكلة على مستوى التوليد |
إذا لم تُعِد نتائج الاسترجاع أي محتوى، فغالبًا ما يكتفي الفريق بالقول بشكل عام «الذكاء الاصطناعي يختلق الأمر من جديد»، ثم يذهب لتعديل الموجه. لكن السبب الحقيقي في كثير من الحالات هو عدم وجود هذه المادة في المخزن، أو أن الاستعلام لم يعثر عليها. وإذا حددت أولاً في أي طبقة تكمن المشكلة قبل البدء في الإصلاح، فستوفر على نفسك الكثير من المحاولات غير الضرورية.
المعيار الثالث: البيانات الوصفية عند الفهرسة في OpenAI File Search تحدّد الحدّ الأقصى لجودة الكتابة
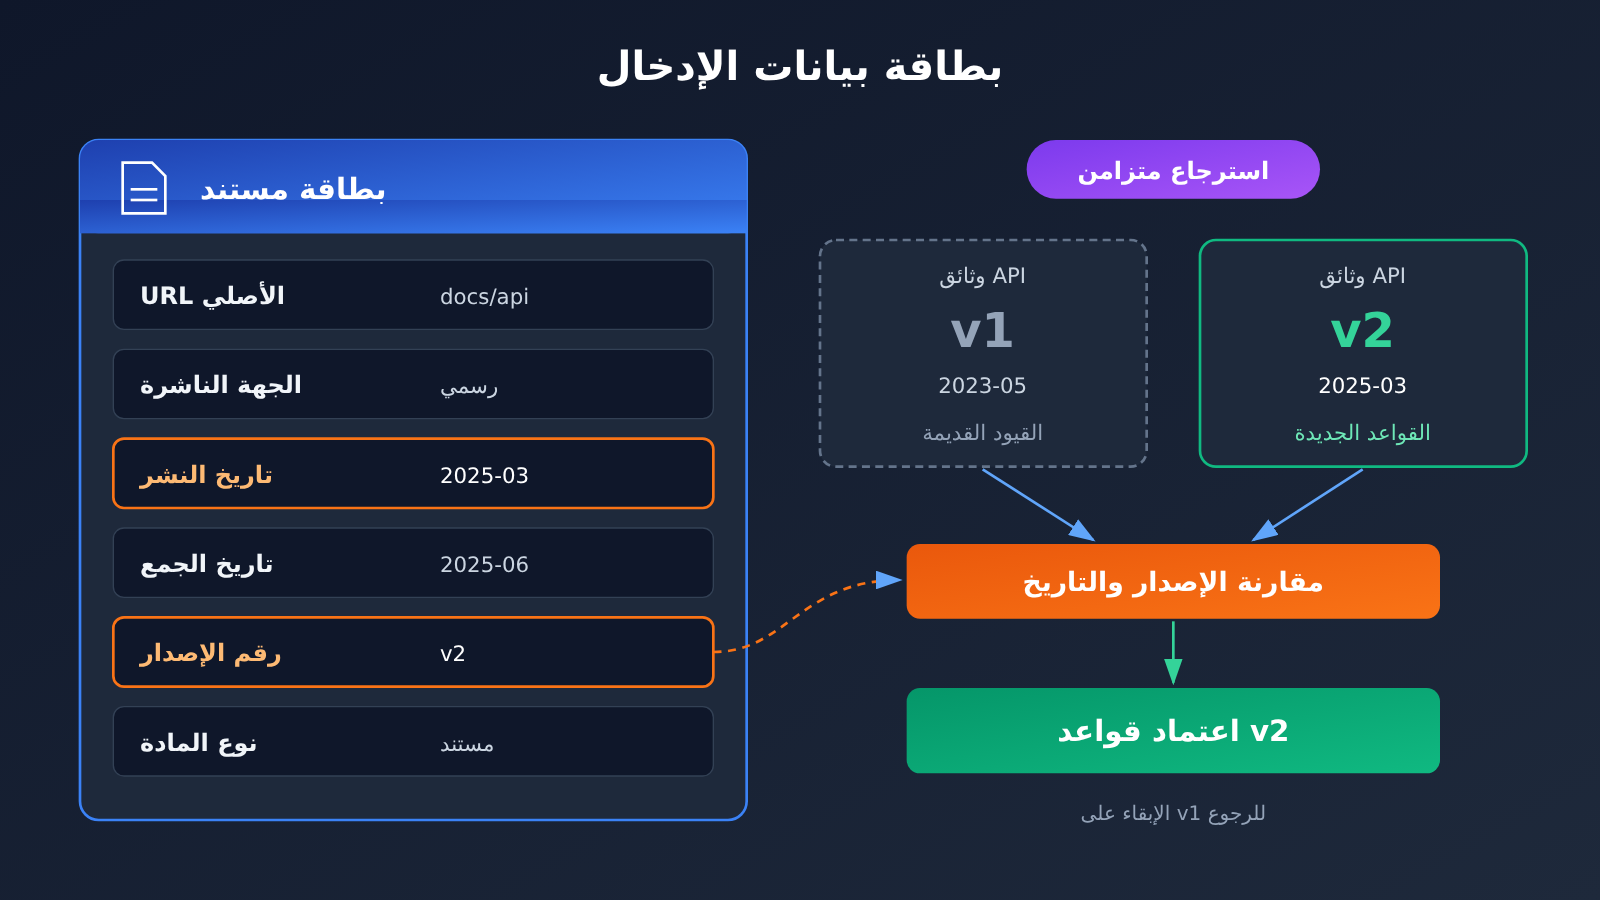
البحث لا يعيد إلا المحتوى الموجود في قاعدة البيانات، وجودة هذا المحتوى تعتمد على ما تم تسجيله لحظة الفهرسة. وبالنسبة لنظام الكتابة، فإن رفع نص الملف وحده لا يكفي؛ لذا يُنصح بأن تُرفق كل مادة على الأقل بالمعلومات التالية:
| حقل البيانات الوصفية | الغرض |
|---|---|
| عنوان URL الأصلي | يسهّل العودة إلى المصدر للتحقق، ويمكن إدراجه في قائمة المراجع |
| الجهة الناشرة | تميّز بين البيانات الرسمية والتفسيرات الخارجية وشائعات المجتمع |
| تاريخ النشر | لتحديد ما إذا كانت المعلومات لا تزال صالحة |
| تاريخ الجمع | لمعرفة منذ متى لم تُحدَّث المادة |
| رقم الإصدار | عند وجود مستندات قديمة وجديدة معًا، يمنع اعتبار القيود القديمة قواعد سارية |
| نوع المادة | يميّز بين الإعلانات والمستندات والمدونات ومنشورات المنتديات، ما يسهّل ضبط درجة الموثوقية |
ومن بين هذه الحقول، معلومات الإصدار هي الأكثر عرضة للتجاهل. فقد يوجد في قاعدة البيانات مستند قديم وآخر جديد للواجهة نفسها، وهما متشابهان دلاليًا إلى حد كبير، وقد يُستدعى الاثنان معًا عند البحث. وإذا غاب الإصدار والتاريخ، يصعب على النموذج تحديد أي قيد قد أُلغي فعلًا. والاحتفاظ بمعلومات الإصدار أكثر أمانًا من حذف المستندات القديمة مباشرة؛ فمن جهة، ما زالت مفيدة عند كتابة مقارنات تاريخية، ومن جهة أخرى، الحذف نفسه متوافق في النهاية (eventually consistent)، أي أن المحذوف قد لا يختفي فورًا.
الاعتبار الرابع: عدد النتائج المسترجعة ليس له إجابة نموذجية
عند تصغير max_num_results، يصبح السياق أنظف، وتنخفض التكلفة والتشويش، لكن قد تفوتك أدلة أساسية. وهذا يظهر خصوصًا في الموضوعات التي تحتاج إلى عدة مصادر تتصادق مع بعضها، مثل الموضوعات التي تتناول في الوقت نفسه الأسعار والقيود وفروقات الإصدارات. أما التكبير فيغطي نطاقًا أشمل، لكن المقاطع غير ذات الصلة ستُشتّت الانتباه، ويزيد احتمال أن يخلط النموذج بين معلومات إصدارات مختلفة.
الطريقة العملية أكثر هي ضبط القيمة بشكل منفصل حسب نوع المقال. فمقالات تفسير الأخبار تحتاج إلى تحقق متقاطع من مصادر متعددة، لذا يمكن توسيعها نسبيًا. أما شرح معلمات واجهة برمجية واحدة فيمكن تضييقه. ولا توجد قيمة عددية محددة تمثل الحل الأمثل العام، بل ينبغي ضبطها بعد ملاحظة المحتوى المسترجع فعليًا، بدلًا من تعيين قيمة ثابتة انطلاقًا من الإحساس.
التغيرات المستقبلية التي تستحق المتابعة
النقاط التالية اتجاهات تستحق المراقبة، وليست حقائق مؤكدة: هل سيوفّر File Search تصفية بيانات وصفية أدق تفصيلًا، بحيث يمكن التصفية مباشرة حسب الإصدار أو التاريخ؛ وهل ستكون هناك توضيحات أوضح بشأن تأخر سريان عمليات الحذف؛ وهل ستُعدَّل طريقة احتساب الفاتورة. كل هذه التغيرات ستؤثر مباشرة على اختيار هندسة نظام الكتابة، ويُنصح بإعادة مراجعة الوثائق الرسمية وصفحة الأسعار قبل الإدماج.
عند إدماج File Search في نظام الكتابة، فإن أكثر الأخطاء شيوعًا هو الاعتقاد بأنه «بمجرد توفر الاسترجاع والاستشهاد، تكون مشكلة المصادر قد حُلّت». في الواقع، إنه يجعل استخدام المصادر الموجودة أفضل، لكن حداثة المصادر نفسها ودقتها لا تزال تعتمد على الجمع وإدارة الإصدارات والمراجعة.
كيف يبقى الماء صافيًا إلى هذا الحد؟ من المنبع يأتي الماء الحي المتدفق. — تشو شي، «تأملات في القراءة»


