
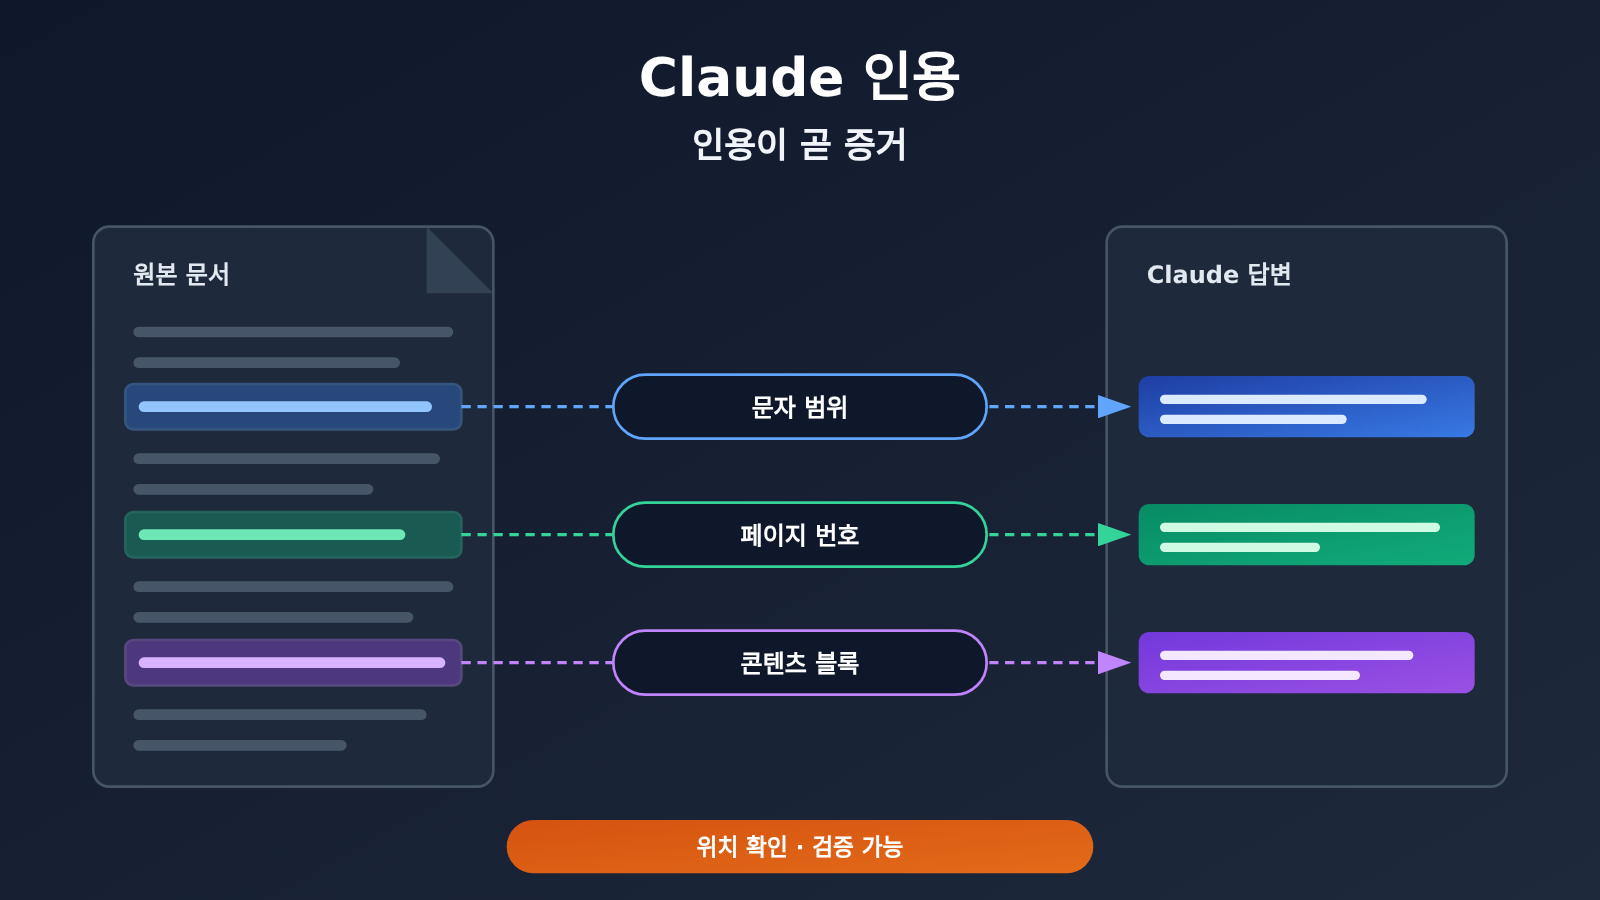
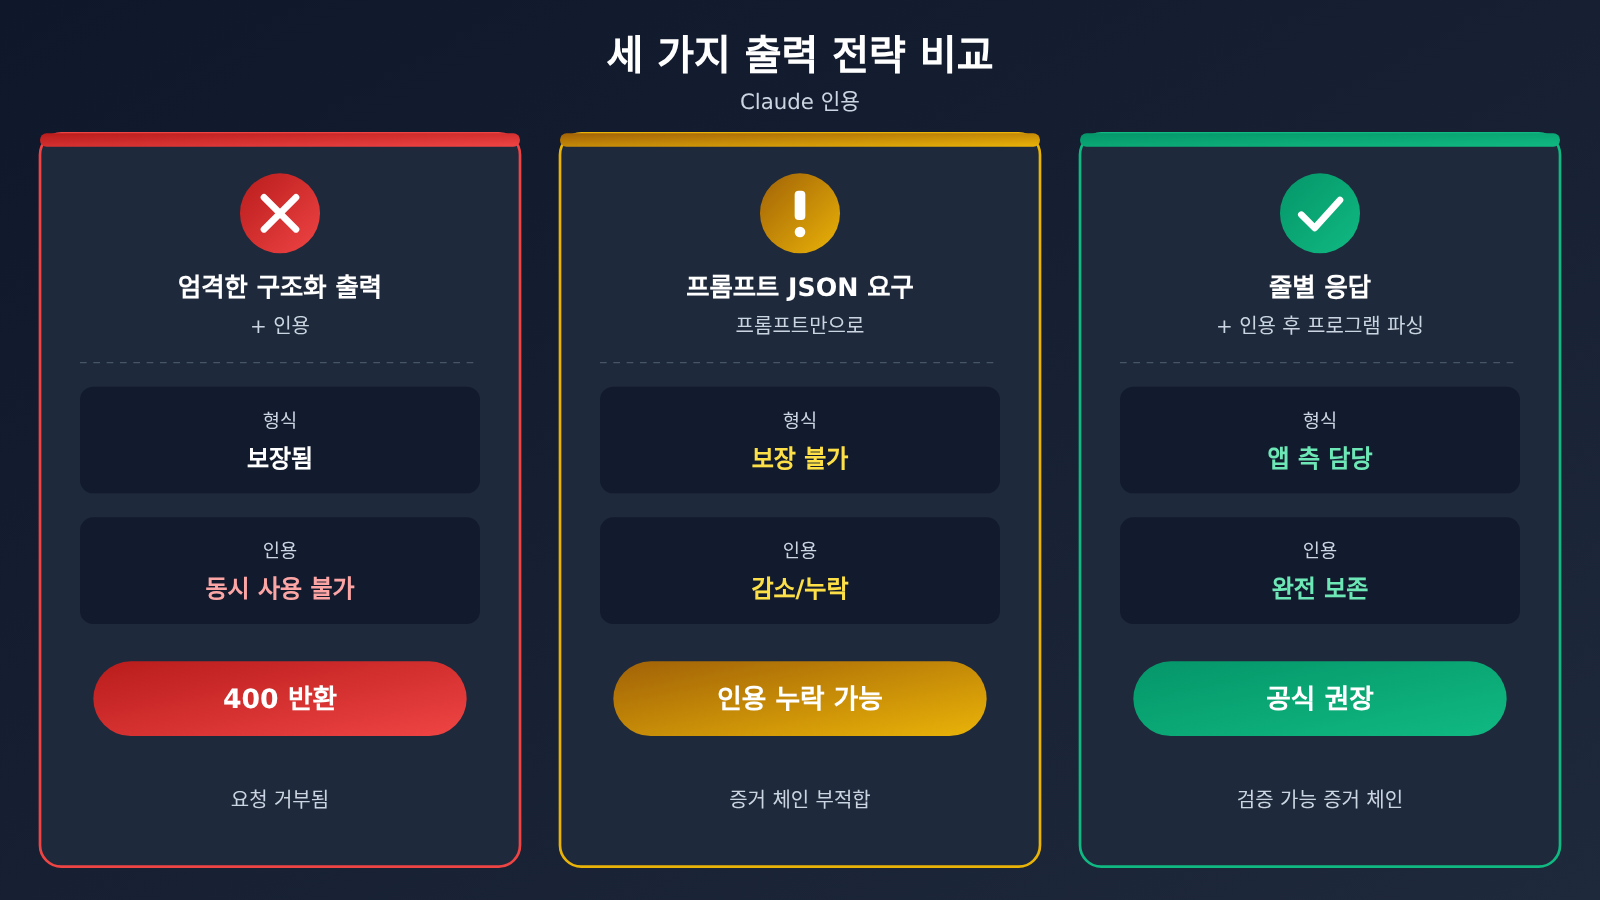
바로 답하자면: Claude Citations를 사용하면 모델의 답변이 제공한 문서의 특정 구절과 위치를 가리키게 할 수 있어요. 일반 텍스트는 문자 범위로, PDF는 페이지로, 사용자 정의 콘텐츠는 블록으로 위치를 지정해요. 인용을 실제로 검증 가능하게 만들려면 애플리케이션 쪽이 핵심이에요. 각 결론의 필드 값, 대응하는 인용 객체, 한정 조건을 함께 저장해야 하죠. 구조화된 데이터로 변환하는 과정에서 인용을 잃어서는 안 돼요.
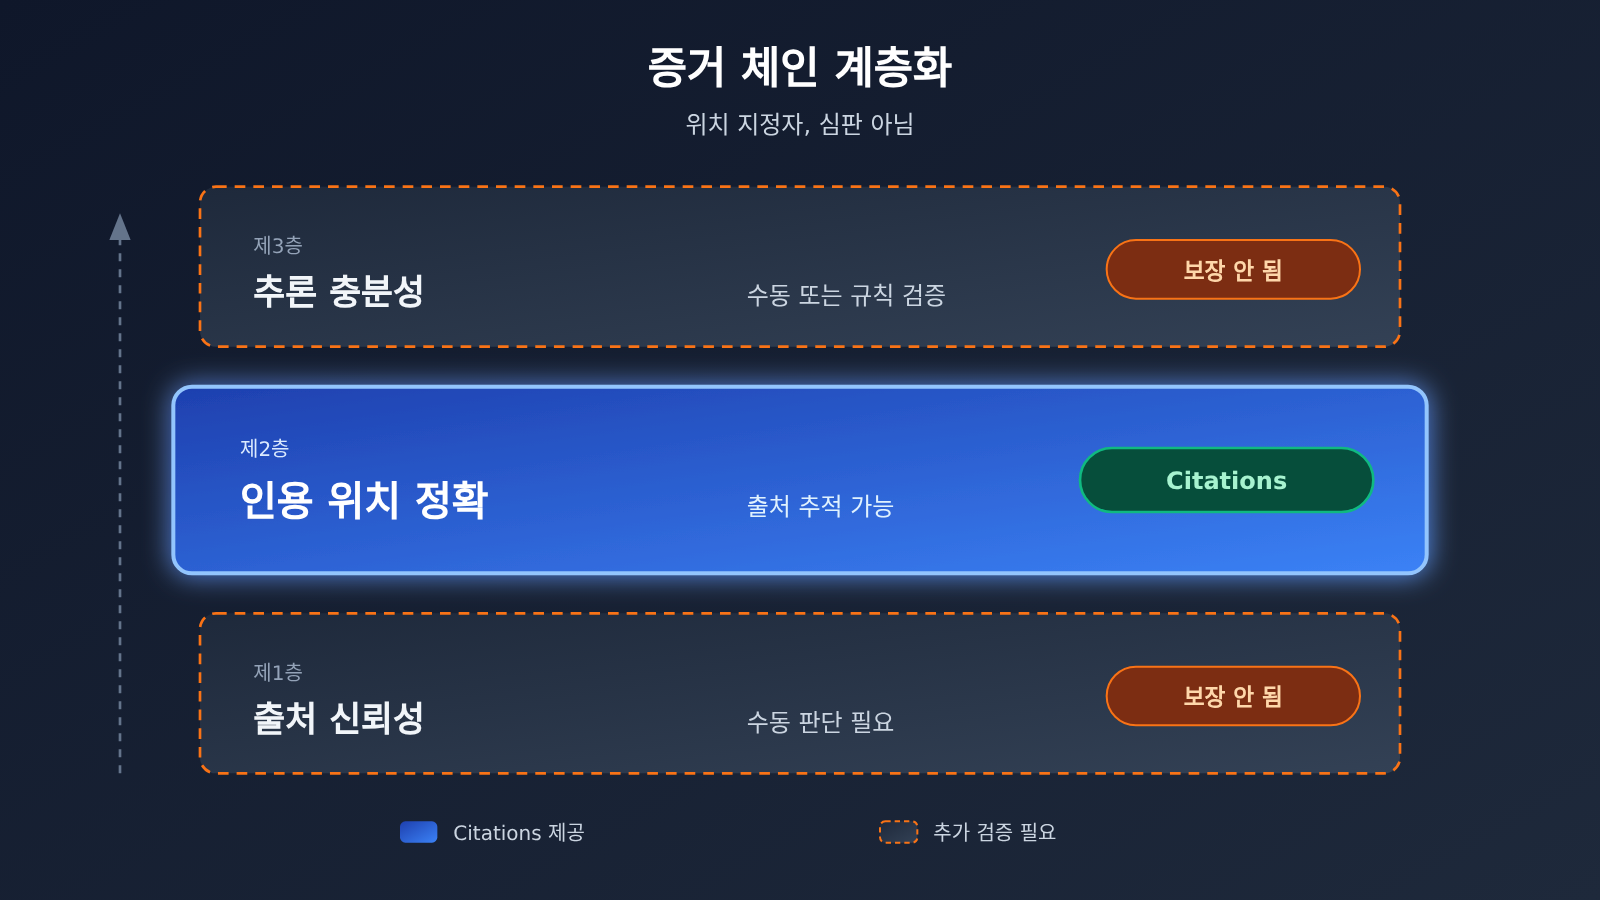
짚고 넘어갈 점은, 인용 위치가 정확하다는 게 “이 문장이 문서에서 찾을 수 있다”는 뜻일 뿐, 출처 자체가 진실하다거나 추론이 충분하다는 뜻은 아니에요. Citations는 사람이 검토할 수 있게 돕는 도구이지, 검토를 대체하지는 못해요.
이 글을 읽으면 무엇을 알 수 있을까요?
- Claude Citations가 어떤 입력에 유효한지, 그리고 세 가지 위치 지정 방식이 각각 무엇인지.
- 인용을 켠 뒤 왜 엄격한 구조화 출력
output_config.format을 동시에 사용할 수 없는지, 그리고 공식적으로 권장하는 대체 방법. - 스캔한 PDF와 이미지의 인용 기능상 제한, 그리고 애플리케이션 쪽에서 취할 수 있는 보완 방법.
- “필드 값+인용+한정 조건” 데이터 구조를 어떻게 설계해야 가격, 컨텍스트 길이, 지역 같은 정보가 검증을 견딜 수 있는지.
인덱스: 본문 도입부에서는 먼저 개념 표로 관련 용어를 설명하고, 이어서 이 기능이 서로 다른 사용자 집단에 어떤 영향을 주는지 설명해요. ‘객관적 사실’ 부분은 공식 문서를 근거로 위치 지정 방식, 호환성 충돌, 입력 제한을 정리해요. ‘분석과 판단’ 부분에서는 인용을 어떻게 검증 가능한 증거로 만들지, 그리고 어떤 주장은 대외적으로 내세울 수 없는지 논의해요.
Claude Citations를 이해하기 전에 알아야 할 개념
| 개념 | 간단한 설명 |
|---|---|
| 인용(Citations) | Claude API의 기능 중 하나로, 응답에서 사용자가 제공한 문서의 인용 조각과 그 위치를 반환합니다 |
| 문자 범위 위치 지정 | 순수 텍스트 문서의 인용 방식으로, 인용된 원문을 문자 시작·끝 위치로 표시합니다 |
| 페이지 번호 위치 지정 | PDF 문서의 인용 방식으로, 페이지 단위로 출처를 표시합니다 |
| 콘텐츠 블록 위치 지정 | 사용자 정의 콘텐츠의 인용 방식으로, 개발자가 직접 나눈 블록을 단위로 합니다 |
| 엄격한 구조화 출력 | output_config.format을 통해 모델이 지정된 형식으로 출력하도록 강제하며, 인용 기능과 동시에 활성화할 수 없습니다 |
| 추출 가능한 텍스트 | PDF에서 직접 읽을 수 있는 텍스트 계층이며, 스캔본에는 이 계층이 없는 경우가 많습니다 |
| OCR | 광학 문자 인식으로, 이미지 속 텍스트를 텍스트로 변환합니다. 애플리케이션 측 처리에 속하며 Claude의 인용 기능은 아닙니다 |
| 제한 조건 | 하나의 수치가 성립하기 위한 전제, 예를 들어 과금 단위, 모델 버전, 적용 지역 등입니다 |
Claude Citations 영향 한눈에 보기
| 대상 | 영향 |
|---|---|
| 개발자 | 질의응답, 검색 증강, 자료 추출 유형 애플리케이션에 위치 지정 가능한 출처를 붙일 수 있습니다. 하지만 구조화 출력과 인용 사이에서 선택해야 하며, 파싱 로직을 직접 설계해야 합니다 |
| 콘텐츠 및 연구 인력 | 검증 시 원문 조각이나 페이지 번호로 바로 이동할 수 있어 한 페이지씩 찾아보는 수고를 줄입니다. 하지만 출처가 신뢰할 만한지, 결론이 성립하는지는 여전히 스스로 판단해야 합니다 |
| 제품 및 운영 | “가격, 사양, 정책”처럼 반드시 출처를 제시해야 하는 정보 표시에 적합합니다. 스캔 자료는 먼저 텍스트화와 검증을 완료해야 합니다 |
| 일반 사용자 | 출처가 붙은 답변을 보면 스스로 확인하기 쉽지만, “인용이 있다”를 “반드시 정확하다”로 이해해서는 안 됩니다 |
Claude Citations 객관적 사실
다음 사실은 Claude 공식 문서를 기준으로 정리했어요(출처: platform.claude.com/docs/en/build-with-claude/citations). 확인 날짜는 2026-11-17이에요. 이 페이지는 계속 관리되는 문서라서 이 글에서는 이 기능의 최초 공개일을 확인하지 못했고, 따라서 최초 출시 시점은 밝히지 않아요.
Claude Citations의 세 가지 위치 지정 방식
Citations는 사용자가 직접 제공한 문서를 대상으로 해요. 모델이 답변할 때 인용된 원문 조각과 문서 내 위치를 함께 반환하죠. 위치 지정의 세밀도는 문서 유형에 따라 달라져요.
| 문서 유형 | 위치 지정 방식 | 검토 시 활용 방법 |
|---|---|---|
| 일반 텍스트 | 문자 범위 | 시작·끝 위치로 원문을 잘라 글자 단위로 대조할 수 있어요 |
| 페이지 번호 | 해당 페이지로 이동해 직접 확인해야 하고, 페이지 안에서 구체적인 위치는 직접 찾아야 해요 | |
| 사용자 정의 콘텐츠 | 콘텐츠 블록 | 개발자가 나눈 블록 단위로 다시 확인하며, 정밀도는 분할 방식에 따라 달라져요 |
보시다시피 세 방식의 정밀도는 서로 달라요. 문자 범위가 가장 세밀해서 프로그램으로 검증하기에 적합하고, 페이지 번호 방식은 사람이 페이지 안에서 찾아야 하며, 콘텐츠 블록의 정밀도는 개발자가 어떻게 나누느냐에 전적으로 달려 있어요. 블록을 너무 크게 나누면 인용은 “정확”할 수 있어도 검토 비용은 눈에 띄게 커져요.
Claude Citations와 엄격한 구조화 출력은 호환되지 않아요
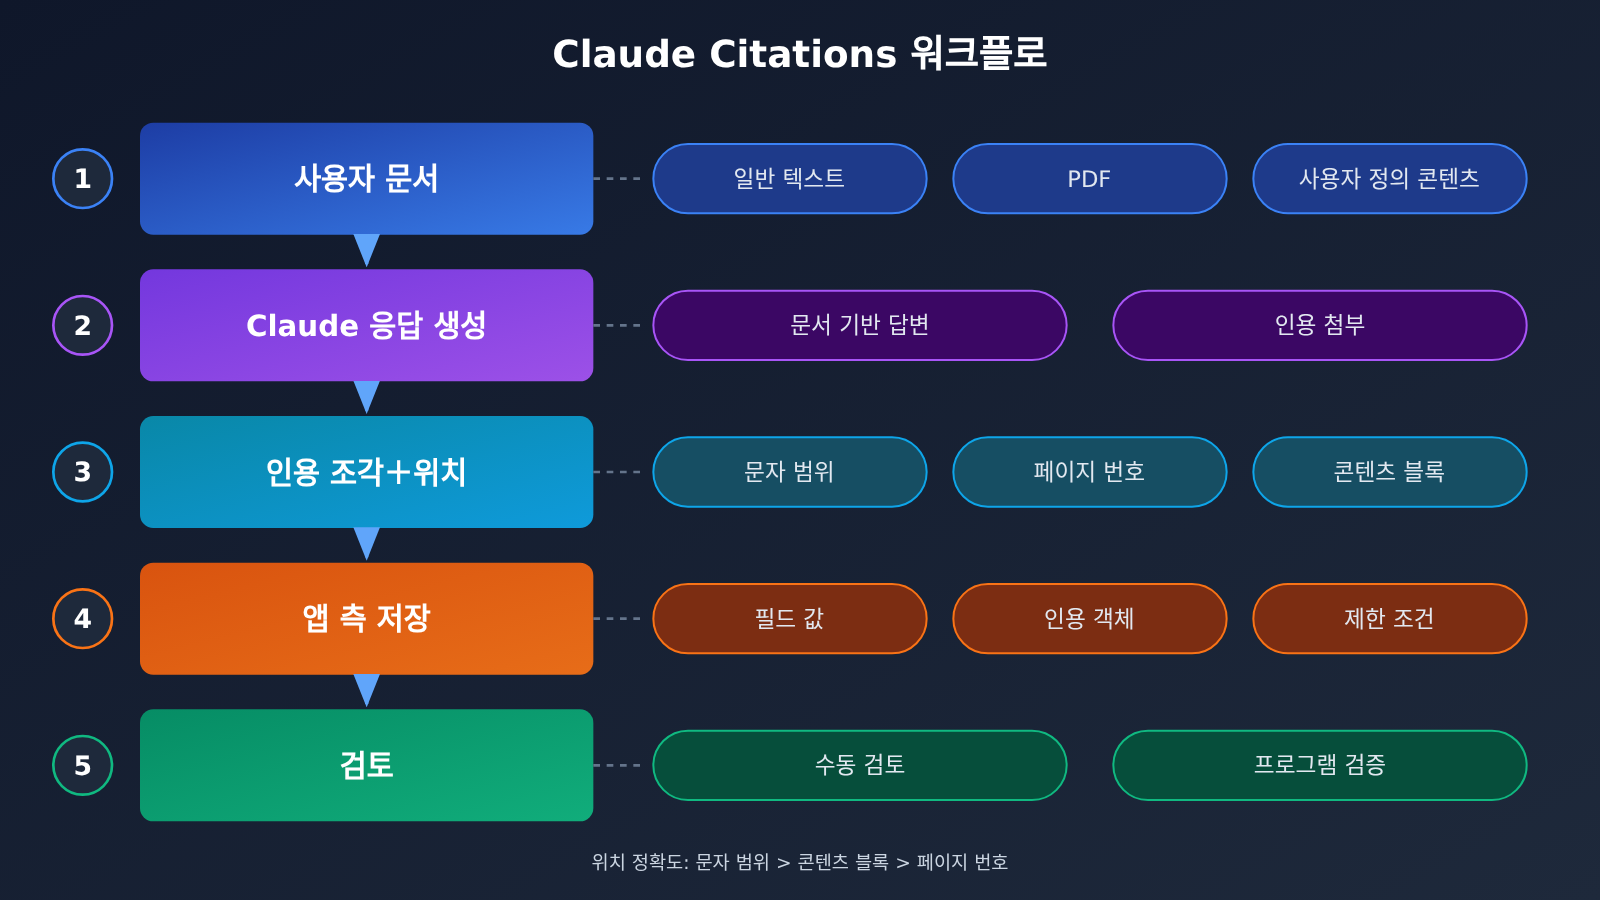
실제 적용 단계에서 가장 쉽게 빠지는 함정이에요. 공식 문서에 명시되어 있는데, 인용(citations)을 활성화한 뒤에는 엄격한 구조화 출력 output_config.format을 동시에 사용할 수 없어요. 둘 다 켜면 요청이 400 오류를 반환합니다.
공식에서 제시한 대안은 모델이 필드별로, 줄별로 인용을 붙여 답하게 하고, 프로그램이 이를 파싱해 필요한 구조로 만드는 방식이에요. 그럴듯해 보이는 또 다른 방법은 프롬프트에서만 모델에게 JSON 출력을 요구하는 것이에요. 이렇게 하면 때로는 JSON을 얻을 수 있지만, 인용이 줄어들거나 심지어 전혀 없을 수도 있어요. 두 방법을 확실히 구분해야 합니다:
- 엄격한 구조화 출력: 형식이 보장되지만, 인용과 동시에 활성화할 수 없어요.
- 프롬프트로만 JSON 요구: 형식이 보장되지 않고 인용도 누락될 수 있어 근거 체인으로 쓰기엔 부적합해요.
- 필드별·줄별 응답+인용, 이후 프로그램 파싱: 공식 권장 방식으로, 형식은 애플리케이션 측이 책임지고 인용은 유지돼요.
Claude Citations의 입력 제한
| 입력 유형 | 직접 인용 가능 여부 | 설명 |
|---|---|---|
| 텍스트 레이어가 있는 PDF | 가능 | 페이지 단위로 위치 지정 |
| 추출 가능한 텍스트가 없는 스캔 PDF | 직접 인용 불가 | 텍스트 레이어가 없어 텍스트 위치 지정 불가 |
| 이미지 | 지원 안 됨 | 인용 기능이 이미지 내용을 다루지 않음 |
| OCR로 변환된 텍스트 | 애플리케이션 측 처리에 따라 다름 | OCR은 애플리케이션 측 권장 방식이며, 이미지 인용 기능이 아님 |
여기서 “직접 인용 불가”를 정확히 이해하는 게 중요해요. 이는 스캔 PDF가 추출 가능한 텍스트를 갖추지 못했을 때 직접 인용할 수 없다는 뜻이지, 모든 스캔 자료를 영원히 처리할 수 없다는 의미는 아니에요. 개발자는 먼저 애플리케이션 측에서 텍스트를 얻은 뒤, 그 텍스트를 문서로 모델에 넘길 수 있어요.
효과 향상에 관한 설명
벤더는 인용 기능에 대해 약 20% 향상이라는 표현을 내놓은 적이 있어요. 이 수치는 벤더 자체의 주장에만 기인하며, 이 글에서는 독립적으로 검증하지 않았어요. 또한 이 글은 어떤 성능 테스트도 수행하지 않았으므로, 정량적인 이득에 대한 결론은 제시하지 않아요.
Claude Citations 분석과 판단
다음은 앞서 정리한 사실을 바탕으로 한 해석과 제안이며, 이는 작성자의 판단일 뿐 공식 결론은 아니에요.
Claude Citations를 ‘필드 값+인용+한정 조건’으로 정착시키기
인용의 진짜 가치는 모든 결론을 추적하고 검증할 수 있도록 만드는 데 있어요. 만약 최종적으로 데이터베이스에 저장되는 값이 ‘128K’나 ‘3달러’ 같은 숫자 하나뿐이라면, 인용 정보는 데이터 변환 과정에서 사라지고 맙니다. 그리고 나중에 누구도 그 값이 어디에서 왔는지, 어떤 조건에서 성립하는지 확인할 수 없게 되죠.
비교적 안전한 방법은 모든 사실형 필드마다 세 가지를 함께 저장하는 거예요: 필드 값, 인용 객체, 한정 조건. 아래는 애플리케이션 측에서 사용할 데이터 구조의 예시예요. 필드 이름은 개발자가 임의로 정하는 것이며, Claude API의 반환 형식은 아니에요:
{
  "field": "input_price",
  "value": "3",
  "qualifiers": {
    "unit": "USD per million input tokens",
    "model_version": "<文档中标注的版本>",
    "region": "<适用地区,如文档未提及则为 null>"
  },
  "citation": {
    "doc_id": "pricing-2026-11",
    "location_type": "page",
    "location": "<模型返回的页码或字符范围>",
    "quoted_text": "<模型返回的原文片段>"
  },
  "verified": false
}
예시에 나온 가격 값은 구조를 보여주기 위한 것일 뿐, 실제 가격을 나타내지는 않아요. 설계할 때 몇 가지 핵심 포인트가 있어요:
- 가격은 반드시 과금 단위를 함께 보존해야 해요: 같은 숫자라도 1천 token당인지 1백만 token당인지에 따라 의미가 천 배나 달라져요.
- 능력 정보는 반드시 버전을 함께 보존해야 해요: 컨텍스트 윈도우 길이와 기능 지원 여부는 모델 버전에 따라 달라지기 때문에, 버전에서 떨어진 숫자는 금방 효력을 잃어요.
- 지역 관련 정보는 적용 범위를 분명히 적어야 해요: 문서에서 언급하지 않았다면 비워 두고, 임의로 추론해 채워 넣지 마세요.
- 원문 스니펫을 보존하세요: 검토할 때 다시 모델을 호출하지 않고도 직접 대조할 수 있어요.
엄격한 구조화 출력 대신 줄 단위 응답 사용
인용과 output_config.format은 동시에 활성화할 수 없기 때문에, 엔지니어링 관점에서는 “형식은 우리가 책임진다”는 방식을 받아들여야 해요. 실행 가능한 흐름은 다음과 같아요:
- 프롬프트에 추출할 필드를 하나씩 나열하고, 모델이 각 줄마다 필드 하나만 답하도록 요구하며 그 줄에 인용을 붙이게 해요.
- 애플리케이션 측에서 줄 단위로 파싱하고, 각 줄의 응답 텍스트와 그 줄이 가진 인용 객체를 일대일로 대응시켜요.
- 고정 규칙으로 텍스트를 목표 구조로 변환하는 동시에, 인용은 그대로
citation필드에 기록해요. - 인용이 없는 줄은 표시를 남겨 수동 검토로 보내거나 바로 버리고, 확정된 사실로 데이터베이스에 넣지 않아요.
이렇게 하면 JSON을 바로 쓰는 것보다 파싱 단계가 하나 더 늘어나지만, 그 대신 모든 필드에 출처가 생겨요. 가격이나 컴플라이언스 조항처럼 오류 비용이 큰 정보라면 이 과정은 충분히 값어치가 있어요.
스캔 자료 처리: 먼저 텍스트를 얻고, 다음에 이차 검증
스캔한 PDF를 마주하면, 애플리케이션 측에서 먼저 OCR로 텍스트를 얻은 뒤 모델에 인용을 맡길 수 있어요. 하지만 OCR 자체도 오차를 유발하므로, 최소한 다음 항목은 검증해야 해요:
- 숫자와 단위: 소수점, 천 단위 구분 기호, 통화 기호가 가장 잘못 인식되기 쉬운데, 바로 이런 것들이 가격 정보의 핵심이에요.
- 표 구조: 행과 열이 어긋나면 값이 잘못된 항목에 대응되는데, 인용 위치가 아무리 정확해도 의미가 없어요.
- 페이지 번호 매핑: OCR 텍스트 속 위치가 원본 스캔 페이지로 다시 매핑되어야 해요. 그렇지 않으면 검토 담당자가 출처를 찾을 수 없어요.
즉, 이 체인에서 인용이 가리키는 것은 OCR 텍스트이지 원본 스캔 이미지가 아니에요. 신뢰도 상한은 OCR 품질에 달려 있어요.
Claude Citations가 증명하지 못하는 것
인용이 붙으면 답변의 검증 가능성은 높아지지만, 외부에 설명할 때는 신중해야 해요. 다음 몇 가지 주장은 근거가 부족하니 사용해서는 안 됩니다:
- “자동으로 인터넷에서 검증해 준다”: Citations는 사용자가 제공한 문서를 대상으로 하며, 인터넷 검색과는 관계가 없어요.
- “환각 제로”: 인용 위치가 정확하다고 해서 모델의 요약이나 추론에 편향이 없다는 뜻은 아니에요.
- “출처는 반드시 믿을 수 있다”: 원본 문서 자체에 오류가 있다면, 인용은 오류를 정확하게 지적해 줄 뿐이에요.
- “모든 스캔 PDF는 처리할 수 없다”: 제한은 추출 가능한 텍스트가 없을 때 직접 인용할 수 없다는 점이고, 애플리케이션 측에는 여전히 보완 수단이 있어요.
더 정확하게 말하자면 이렇습니다: Claude Citations는 “이 문장이 어디에서 나왔는가”에 대한 입증 비용을 낮춰 주지만, “이 문장이 맞는가”는 여전히 사람이나 규칙이 판단해야 해요.
앞으로 주목할 만한 방향
다음 내용은 예측이나 지켜봐야 할 사항이며, 이미 확인된 사실은 아니에요:
- 인용과 엄격한 구조화 출력이 향후 버전에서 호환될 수 있을지. 호환이 된다면 앞서 설명한 줄 단위 파싱 방식은 크게 간소화될 수 있어요.
- 인용 기능이 이미지나 스캔 페이지의 시각적 위치 지정으로 확장될지. 현재 문서에서는 이미지 인용을 명확히 지원하지 않는다고 밝히고 있어요.
- 벤더가 주장하는 효과 향상이 다양한 유형의 문서에서도 성립하는지, 제3자나 자체 업무 데이터로 검증해야 해요.
이러한 질문들에 명확한 답이 나오기 전까지는 Claude Citations를 근거 사슬의 “위치 지정자”로 보는 것이 “심판”으로 보는 것보다 안전한 전략이에요.
모든 책을 다 믿는다면, 책이 없느니만 못하다. ——《맹자·진심하》


