
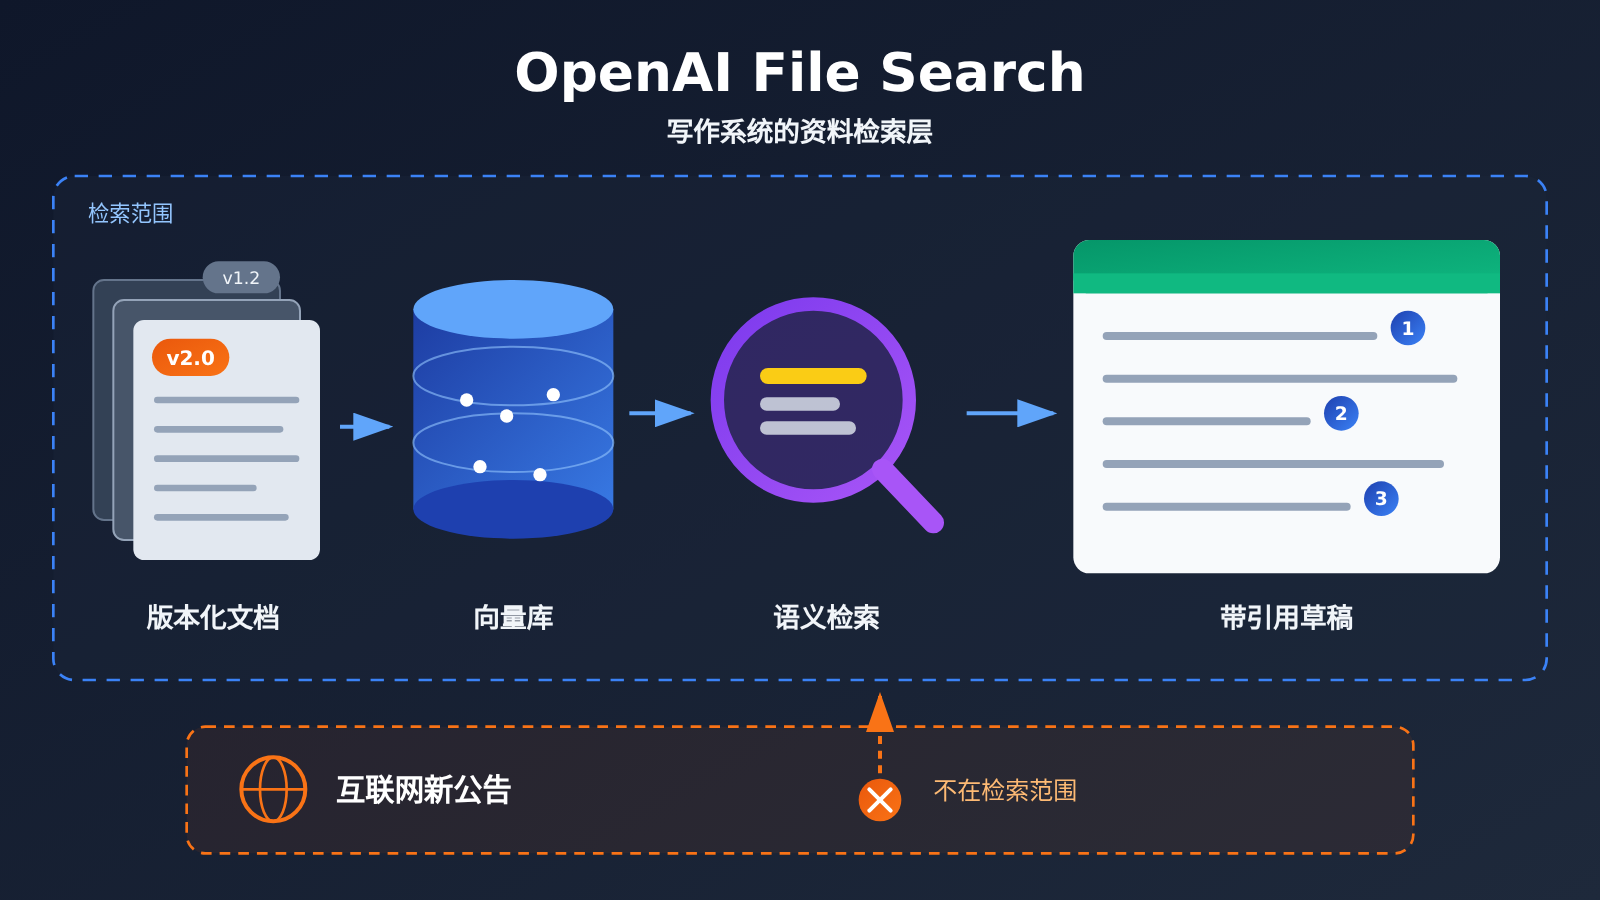
能补上一部分,但补不全。 OpenAI File Search 解决的是“已有资料找不准、引用不清”的问题。它能从向量库里按语义检索文件,并在回答中附上文件引用,这对写作系统很有用。它不解决“资料本身缺失或过期”的问题:工具只检索你已经放进去的文件,不会自动发现互联网上的新公告。引用标记也只能说明内容出自哪份文件,不能保证结论写对了。
所以更准确的判断是:File Search 可以做写作系统的“资料检索层”,资料采集、版本管理和事实审核仍要单独做。
您读完此文能了解到什么?
- File Search 在 Responses API 中的定位,以及它能为写作流程提供哪些能力
- 如何调整召回数量,如何让响应返回实际检索到的内容,方便排查问题
- 删除文件后为什么短期内仍可能被检索到,写作系统应如何应对
- 资料缺失、召回失败、生成写错这三类问题分别该在哪一层修复
- 入库时建议保存哪些元数据,才能避免把过期限制写成现行规则
索引: 正文前导先解释几个关键概念,并按人群列出影响。“客观事实”部分依据 OpenAI 官方文档,梳理 File Search 的工作方式、可调参数和已知行为。“分析判断”部分讨论它放进写作系统后的分工、排障路径和入库规范,最后说明需要警惕的几个误区。
OpenAI File Search 相关概念 To Know
| 概念 | 简要解释 |
|---|---|
| Responses API | OpenAI 的响应生成接口,可以在一次请求中挂载工具,File Search 就是其中一种 |
| File Search | Responses API 的内置工具,从向量库中的文件检索相关片段,用来辅助生成回答 |
| 向量库(Vector Store) | 存放已上传文件及其向量表示的库,File Search 的检索范围就是它 |
| 语义检索 | 按意义相似度查找内容,字面用词不同但意思相关的段落也能被找到 |
| 文件引用(Citation) | 回答中标注某段内容出自哪个文件,便于读者和审核者回查 |
max_num_results |
控制一次检索最多返回多少条结果的参数 |
include |
请求参数,传入 file_search_call.results 后,响应会包含实际召回的内容 |
| 最终一致性 | 写入或删除操作不会立刻在所有地方生效,短时间内可能看到旧状态 |
OpenAI File Search 影响速览
| 人群 | 主要影响 |
|---|---|
| 写作系统开发者 | 不用自建检索服务,就能获得语义检索和文件引用。需要自己设计入库规范和排障流程 |
| 内容编辑 / 审核者 | 引用让回查更方便,但仍需逐条核对结论,不能因为“有引用”就直接放行 |
| 技术文档维护者 | 新旧版本文档要标好版本和日期,否则旧限制可能被检索出来、写进新文章 |
| 成本负责人 | 向量库存储和工具调用都要计费,具体以 OpenAI 当前价格页为准,资料量大时需要预估 |
OpenAI File Search 客观事实
以下内容依据 OpenAI 开发者文档中 File Search 与 Retrieval 两份指南,核查日期为 2026-11-17。这两份是维护中的文档,本文未核实该功能的首次发布日期。
File Search 是什么:Responses API 里的检索工具
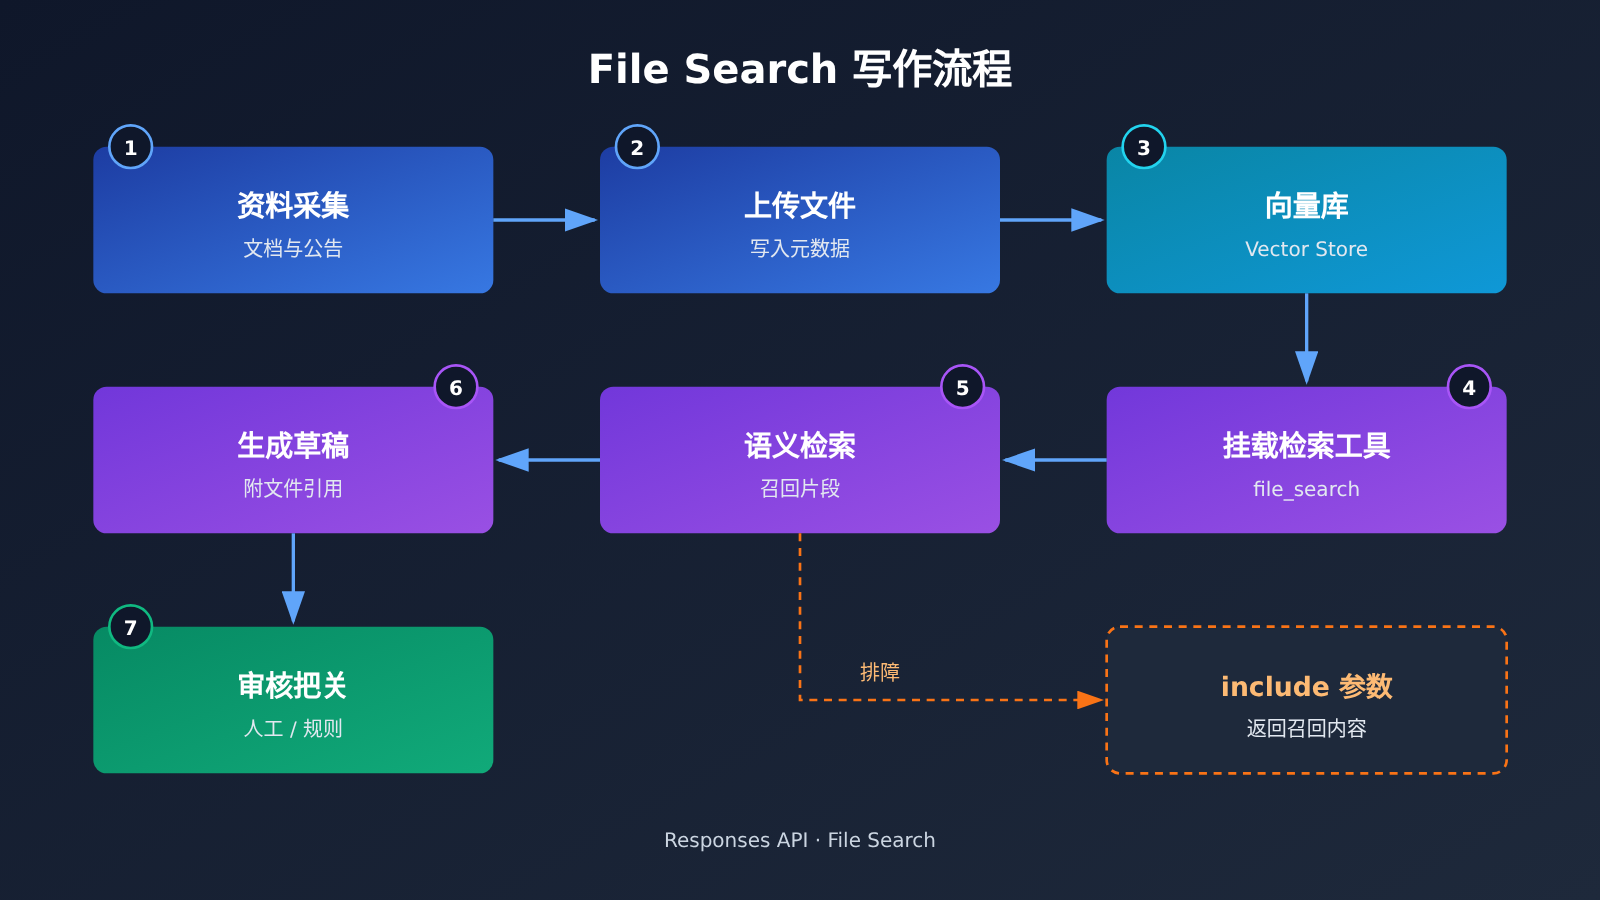
File Search 是 Responses API 提供的工具。开发者先把文件上传到向量库,发起请求时在 tools 中声明 File Search 并指定向量库。模型生成回答时会从这些文件中检索相关内容,回答可以附带文件引用,标明信息出处。
它使用语义检索,能找到意思相关但字词不完全一致的内容。比如查询“接口限流”,文档里写的是“请求频率上限”,也有可能被召回。对写作系统来说,这意味着提问时不必完全复刻原文措辞。
File Search 的可调参数与排障开关
文档中有两个参数和写作系统关系最直接:
| 参数 / 行为 | 作用 | 对写作流程的意义 |
|---|---|---|
max_num_results |
调整单次检索返回的结果数量 | 数量少更省上下文,但证据可能不全;数量多覆盖更广,但噪声也会增加 |
| 默认返回内容 | 工具调用默认不返回完整检索结果 | 只看最终回答时,无法判断模型到底读到了什么 |
include: ["file_search_call.results"] |
让响应包含实际召回的内容 | 能把“没召回”和“召回了但写错”区分开,排障必备 |
| 文件引用 | 回答中标注出处文件 | 方便回查,但不等于结论正确 |
下面是一个最小调用示例,展示如何挂载向量库、限制召回数量,并要求响应返回检索结果。其中的模型名和向量库 ID 请替换成你自己的配置:
from openai import OpenAI

client = OpenAI()  # 从环境变量 OPENAI_API_KEY 读取密钥

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # 召回数量:在证据覆盖与噪声之间权衡
    }],
    include=["file_search_call.results"],  # 返回实际召回内容,便于排障
)

# 遍历输出:既能拿到最终文本,也能看到检索到了哪些片段
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
File Search 删除文件的最终一致性
文档说明,从向量库删除文件是最终一致的:删除后的一段时间内,该文件仍有可能被检索到。因此不能对外宣称“删除后立即不可检索”。如果某份资料因为错误或过期必须下线,写作系统最好在自己这一层也做过滤,而不是只依赖删除操作。
File Search 不做什么
根据官方文档的描述和工具本身的机制,有几点需要明确:
- File Search 只检索已经存在于向量库中的文件,不会自动发现互联网上的新公告或文档更新。
- 引用标记说明内容来自哪份文件,不保证基于这份文件得出的结论正确。
- 向量库存储和工具调用都收费,费用以 OpenAI 当前公布的价格为准,本文不给出具体数字。
- 本文未验证 API易 或其他第三方平台是否兼容 File Search 相关接口,相关支持情况请以各平台官方说明为准。
OpenAI File Search 分析判断
判断一:File Search 补的是“检索层”,不是“资料层”
写作系统的资料短板通常有两种。一种是手里有资料但找不准,模型凭印象写,出处说不清。另一种是根本没有资料,或者资料已经过时。File Search 对第一种很有效:语义检索提高了召回的灵活度,文件引用让每段内容都能回查。
对第二种它无能为力。工具不会主动去抓新公告,向量库里是什么,它就只能检索到什么。比如某个模型的价格或限制刚刚调整,而库里只有旧文档,File Search 会“准确地”检索到过期信息,再配上一个看起来很可靠的引用。这比没有引用更危险,因为它更容易骗过审核。
所以 File Search 应该看作写作系统里的一层,而不是整个资料方案。资料采集、定期更新、版本淘汰仍然需要单独的流程来负责。
判断二:用三分法定位 File Search 写作问题
一篇文章写错了,问题可能出在三个不同环节。include: ["file_search_call.results"] 的价值在于,它让这三类问题第一次可以被区分开。
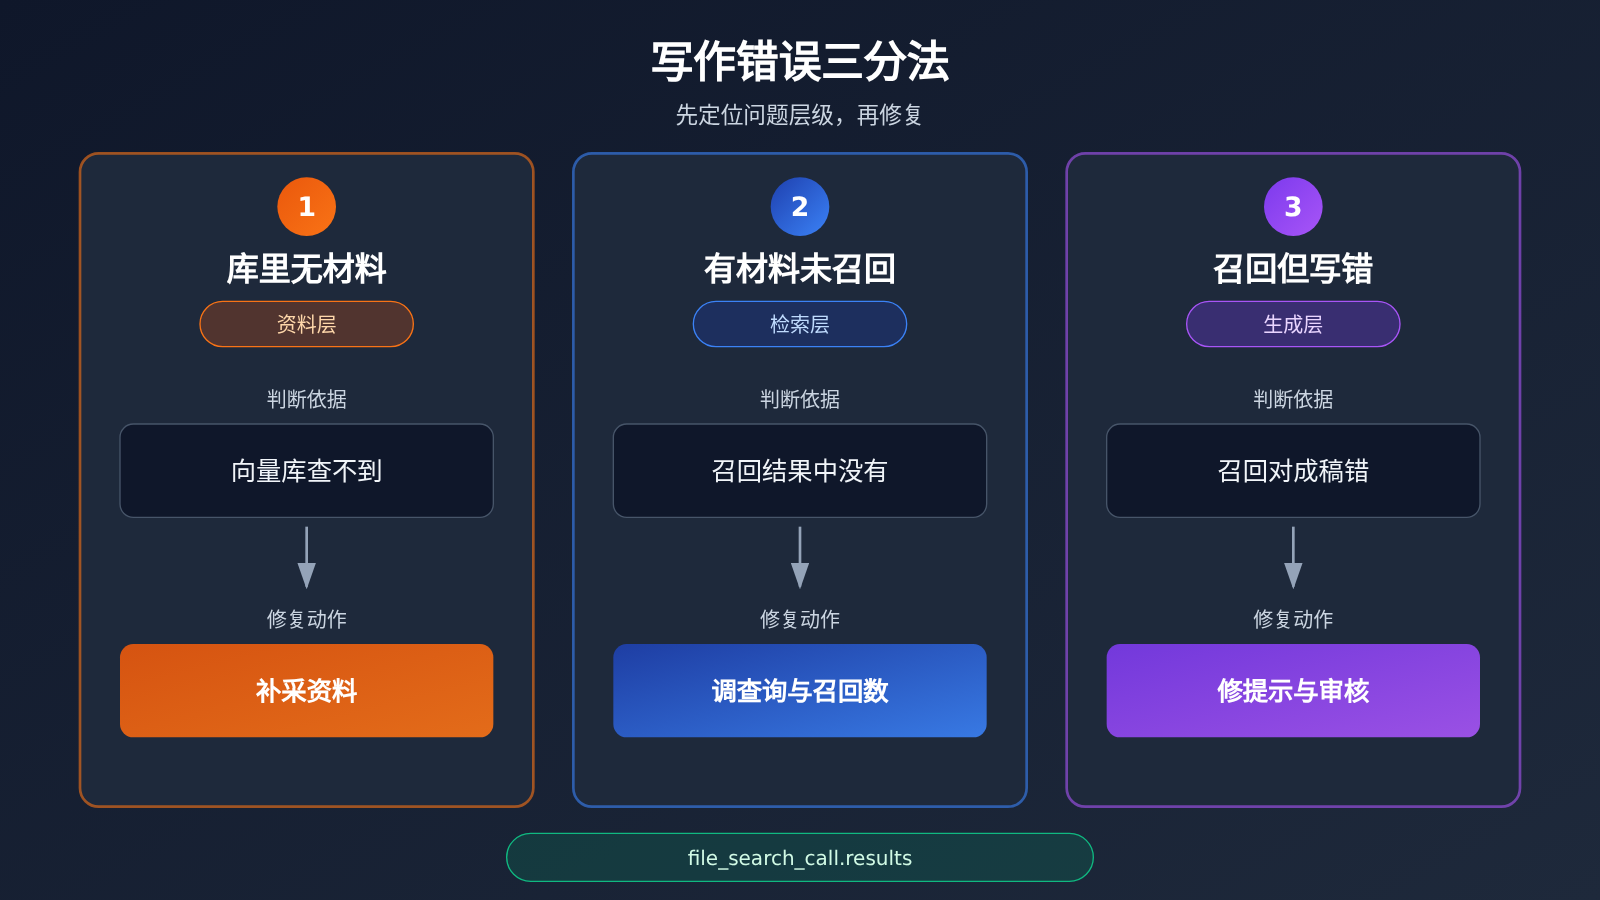
| 问题类型 | 判断依据 | 修复方向 |
|---|---|---|
| 库里没有材料 | 在向量库中查不到相关文件 | 补采资料,属于资料层问题 |
| 有材料但未召回 | 文件在库里,但 file_search_call.results 中没有它 |
调整查询措辞、拆分问题,或适当增加 max_num_results |
| 召回了但写错了 | 召回结果正确,成稿却与之不符 | 修改生成提示和审核规则,属于生成层问题 |
如果没有返回召回内容,团队往往只能笼统地说“AI 又编了”,然后去改提示词。很多时候真正的原因是库里没有这份资料,或者查询没有命中它。先判断问题出在哪一层再动手,能少走很多弯路。
判断三:OpenAI File Search 入库元数据决定写作质量上限
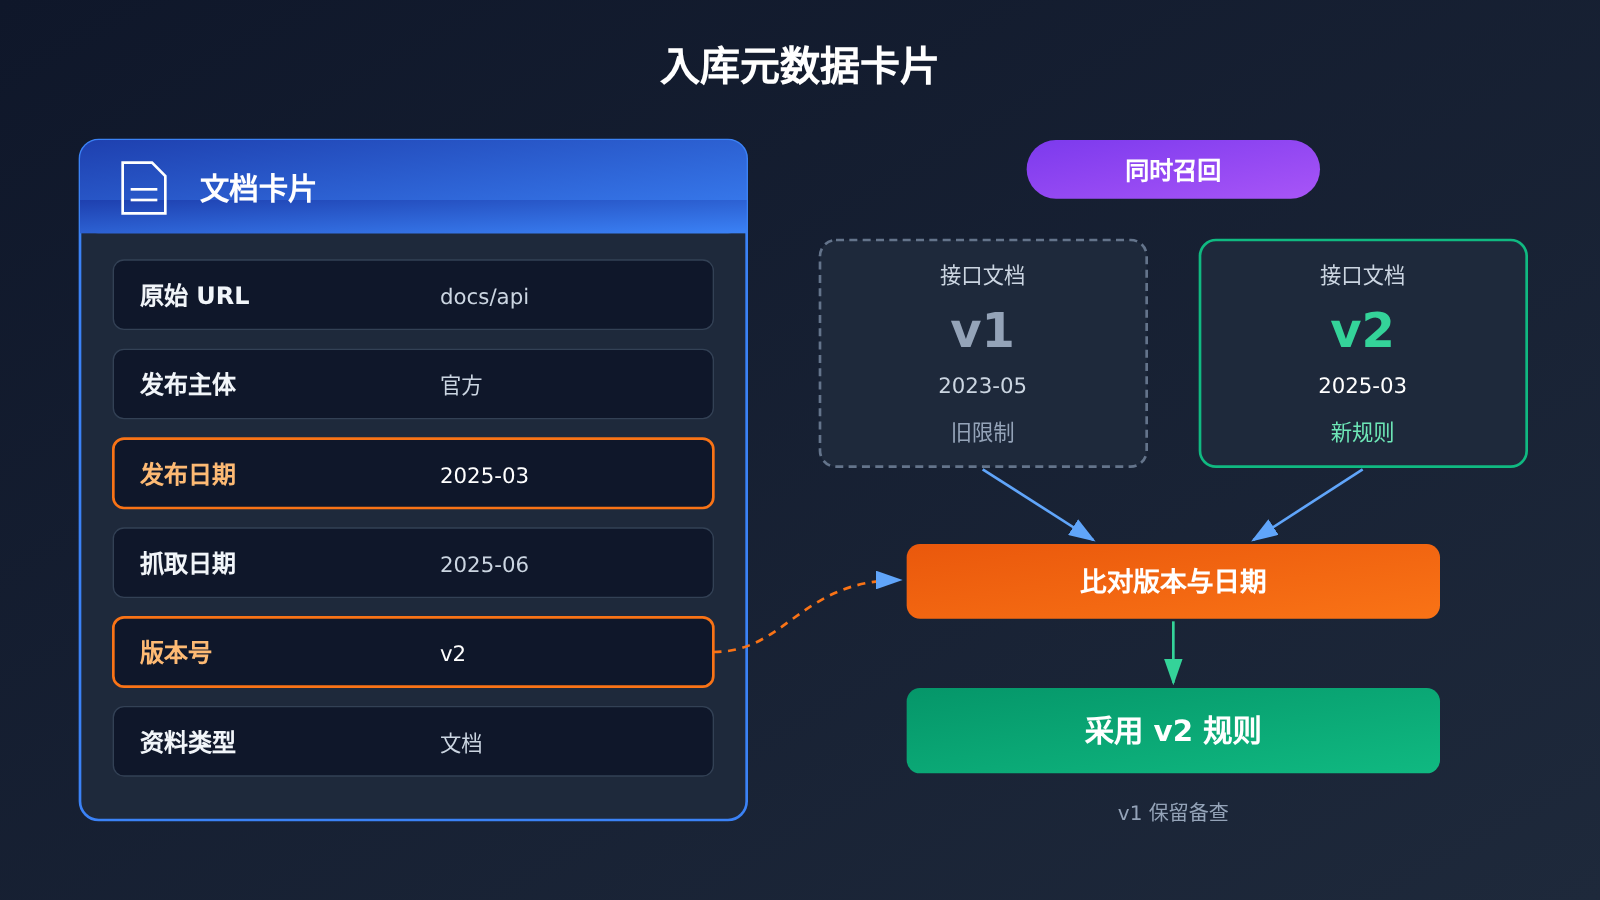
检索只能返回库里的内容,而库里内容的质量取决于入库时记录了什么。对写作系统来说,单纯上传文件正文是不够的,建议每份资料至少附带以下信息:
| 元数据字段 | 用途 |
|---|---|
| 原始 URL | 方便回到源头核实,也能在参考资料中列出 |
| 发布主体 | 区分官方说法、第三方解读和社区传言 |
| 发布日期 | 判断信息是否仍然有效 |
| 抓取日期 | 判断资料多久没有更新 |
| 版本号 | 新旧文档共存时避免把旧限制当作现行规则 |
| 资料类型 | 区分公告、文档、博客、论坛帖,便于设定可信度 |
其中版本信息最容易被忽视。同一个接口的新旧文档可能都在库里,语义上又高度相似,检索时很可能同时被召回。如果没有版本和日期,模型很难判断哪条限制已经被废除。保留版本信息比直接删除旧文档更稳妥,一方面写历史对比时还用得到,另一方面删除本身也是最终一致的,删了不一定马上消失。
判断四:召回数量没有标准答案
max_num_results 调小,上下文更干净,成本和噪声都更低,但可能漏掉关键证据。尤其是需要多份资料互相印证的主题,例如同时涉及价格、限制和版本差异时。调大则覆盖更全,但无关片段会稀释注意力,模型也更可能混用不同版本的信息。
比较实际的做法是按文章类型分开设置。资讯解读类需要多来源交叉验证,可以适当放宽。单一接口的参数说明则可以收紧。具体数值没有通用最优解,应该结合返回的召回内容实际观察后再调整,而不是凭感觉设定一个固定值。
需要关注的后续变化
以下几点属于值得观察的方向,并非已确认的事实:File Search 是否会提供更细粒度的元数据过滤,以便直接按版本或日期筛选;删除操作的生效延迟会不会有更明确的说明;计费方式是否调整。这些变化都会直接影响写作系统的架构选择,接入前建议重新查阅官方文档和价格页。
把 File Search 接入写作系统,最容易出现的误判就是“有了检索和引用,资料问题就解决了”。实际上它让已有资料用得更好,资料本身的新鲜度和准确性,仍然要靠采集、版本管理和审核来保证。
问渠那得清如许?为有源头活水来。——朱熹《观书有感》


