
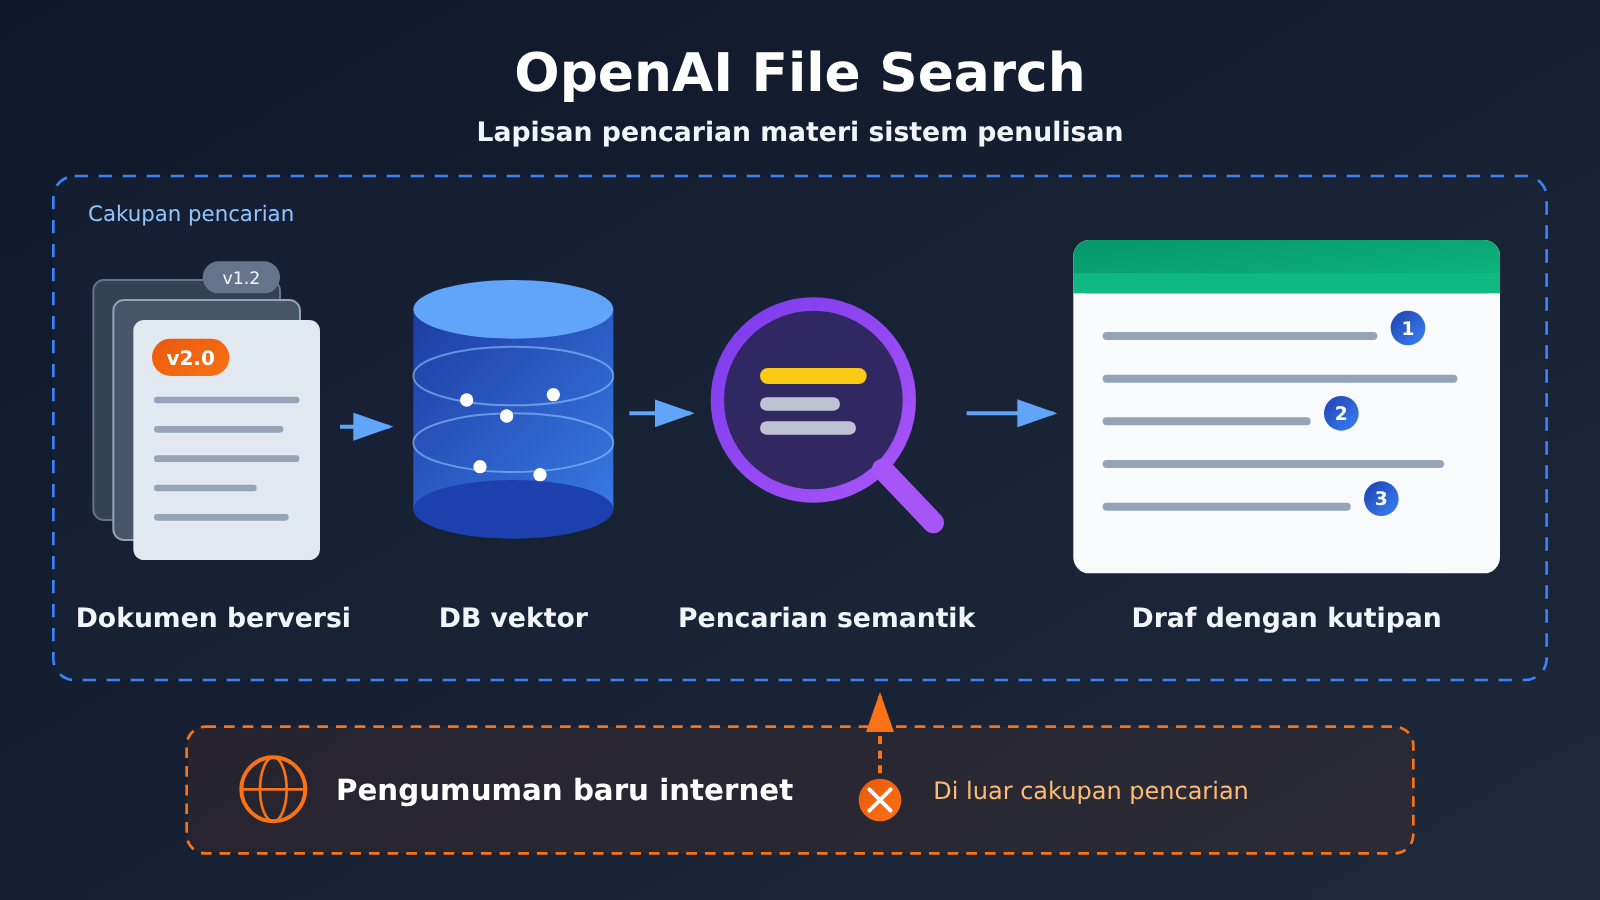
Bisa menutup sebagian celah, tetapi tidak sepenuhnya. OpenAI File Search menyelesaikan masalah “materi yang sudah ada sulit ditemukan dengan tepat dan rujukannya tidak jelas”. Fitur ini dapat mencari file secara semantik dari basis data vektor dan menyertakan rujukan file dalam jawaban, yang sangat berguna untuk sistem penulisan. Namun, File Search tidak menyelesaikan masalah “materi itu sendiri hilang atau sudah kedaluwarsa”: alat ini hanya mencari file yang sudah Anda masukkan, tidak otomatis menemukan pengumuman baru di internet. Tanda rujukan juga hanya menunjukkan dari file mana konten berasal, bukan jaminan bahwa kesimpulannya benar.
Jadi penilaian yang lebih akurat adalah: File Search dapat menjadi “lapisan pencarian materi” pada sistem penulisan, sementara pengumpulan materi, pengelolaan versi, dan verifikasi fakta tetap harus dilakukan secara terpisah.
Apa yang bisa Anda pahami setelah membaca artikel ini?
- Posisi File Search dalam Responses API, serta kemampuan apa saja yang bisa diberikannya untuk alur penulisan
- Cara menyesuaikan jumlah hasil yang diambil (recall), dan cara membuat respons mengembalikan konten yang benar-benar ditemukan agar memudahkan penelusuran masalah
- Mengapa file yang sudah dihapus masih mungkin ditemukan dalam jangka pendek, dan bagaimana sistem penulisan harus menanganinya
- Tiga jenis masalah—materi hilang, pengambilan gagal, dan kesalahan penulisan saat generasi—harus diperbaiki di lapisan mana masing-masing
- Metadata apa yang disarankan untuk disimpan saat memasukkan data, agar batasan yang sudah kedaluwarsa tidak ditulis sebagai aturan yang berlaku saat ini
Indeks: Bagian pengantar menjelaskan beberapa konsep kunci dan mencantumkan dampaknya berdasarkan kelompok pembaca. Bagian “Fakta Objektif” berdasarkan dokumentasi resmi OpenAI, menguraikan cara kerja File Search, parameter yang dapat disesuaikan, dan perilaku yang telah diketahui. Bagian “Analisis dan Penilaian” membahas pembagian kerja setelah File Search dimasukkan ke sistem penulisan, jalur penelusuran masalah, dan standar pemasukan data, lalu diakhiri dengan beberapa miskonsepsi yang perlu diwaspadai.
Konsep Terkait OpenAI File Search yang Perlu Diketahui
| Konsep | Penjelasan singkat |
|---|---|
| Responses API | Antarmuka pembuatan respons milik OpenAI yang memungkinkan pemasangan tool dalam satu permintaan; File Search adalah salah satunya |
| File Search | Tool bawaan Responses API yang mengambil fragmen relevan dari file di vector store untuk membantu pembuatan jawaban |
| Vector Store (Penyimpanan Vektor) | Penyimpanan file yang sudah diunggah beserta representasi vektornya; cakupan pencarian File Search adalah tempat ini |
| Pencarian semantik | Mencari konten berdasarkan kemiripan makna; paragraf dengan kata yang berbeda tetapi maknanya terkait tetap bisa ditemukan |
| Sitasi file (Citation) | Menandai dalam jawaban dari file mana suatu bagian berasal, sehingga pembaca dan peninjau mudah memeriksa ulang |
max_num_results |
Parameter yang mengatur berapa banyak hasil maksimum yang dikembalikan dalam satu kali pencarian |
include |
Parameter permintaan; setelah diisi file_search_call.results, respons akan menyertakan konten yang benar-benar diambil |
| Konsistensi akhir | Operasi tulis atau hapus tidak langsung berlaku di semua tempat; dalam waktu singkat masih mungkin terlihat status lama |
Ringkasan Dampak OpenAI File Search
| Kelompok | Dampak utama |
|---|---|
| Pengembang sistem penulisan | Tidak perlu membangun layanan pencarian sendiri untuk mendapatkan pencarian semantik dan sitasi file. Namun tetap perlu merancang standar pemasukan data dan alur troubleshooting sendiri |
| Editor / peninjau konten | Sitasi membuat pemeriksaan ulang lebih mudah, tetapi kesimpulan tetap harus diverifikasi satu per satu; tidak bisa langsung diloloskan hanya karena “ada sitasi” |
| Pemelihara dokumentasi teknis | Dokumen versi lama dan baru harus diberi label versi dan tanggal; jika tidak, batasan lama bisa ikut terambil dan masuk ke artikel baru |
| Penanggung jawab biaya | Penyimpanan vector store dan pemanggilan tool keduanya dikenai biaya; rujuk halaman harga OpenAI yang berlaku saat ini, dan bila volume materi besar perlu dilakukan estimasi |
Fakta Objektif OpenAI File Search
Konten berikut mengacu pada dua panduan dalam dokumentasi developer OpenAI, yaitu File Search dan Retrieval, dengan tanggal verifikasi 2026-11-17. Kedua dokumen tersebut masih dalam pemeliharaan, dan artikel ini belum memverifikasi tanggal rilis pertama fitur ini.
Apa itu File Search: alat pencarian di Responses API
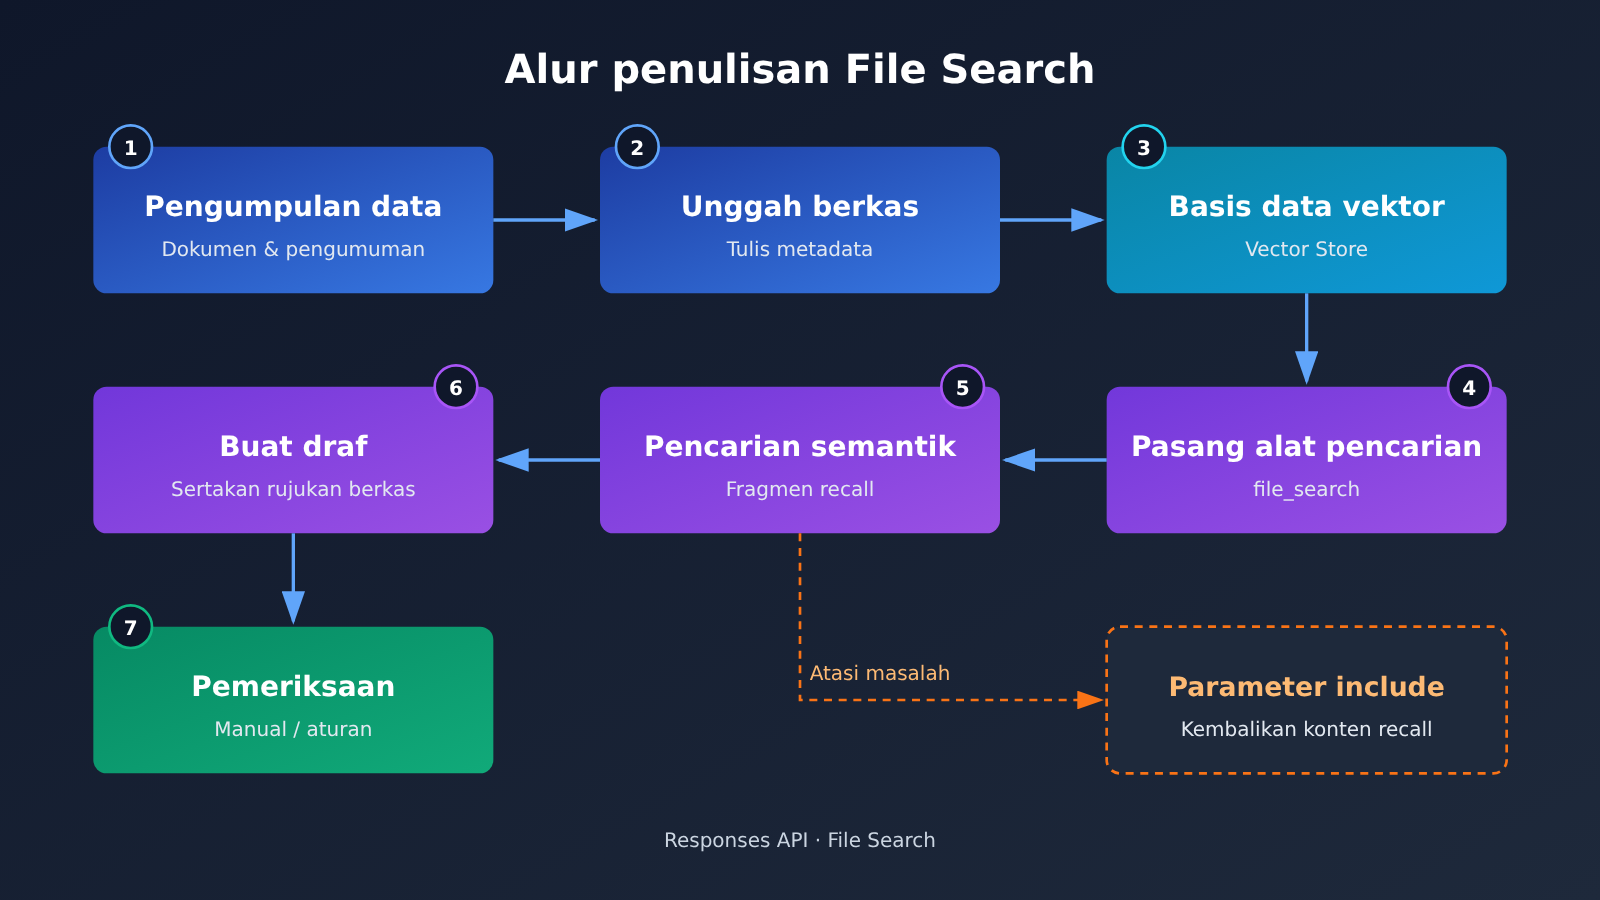
File Search adalah alat yang disediakan oleh Responses API. Developer terlebih dahulu mengunggah file ke vector store, lalu saat mengirim permintaan mendeklarasikan File Search di tools dan menentukan vector store yang dipakai. Ketika model menghasilkan jawaban, model akan mencari konten relevan dari file-file tersebut, dan jawaban bisa disertai kutipan file yang menunjukkan sumber informasi.
Alat ini memakai pencarian semantik, sehingga mampu menemukan konten yang relevan secara makna meskipun kata-katanya tidak sepenuhnya sama. Misalnya saat mencari “pembatasan laju API”, sementara di dokumen tertulis “batas frekuensi permintaan”, konten itu tetap bisa ditemukan. Bagi sistem penulisan, ini berarti saat mengajukan pertanyaan kita tidak perlu meniru persis kata-kata teks aslinya.
Parameter yang Bisa Disesuaikan dan Opsi Troubleshooting pada File Search
Dalam dokumentasi, ada dua parameter yang paling berkaitan langsung dengan sistem penulisan:
| Parameter / Perilaku | Fungsi | Makna bagi alur penulisan |
|---|---|---|
max_num_results |
Menyesuaikan jumlah hasil yang dikembalikan dalam satu kali pencarian | Jumlah sedikit lebih menghemat konteks, tetapi bukti bisa tidak lengkap; jumlah banyak memberi cakupan lebih luas, tetapi noise juga bertambah |
| Konten yang dikembalikan secara default | Pemanggilan alat secara default tidak mengembalikan hasil pencarian lengkap | Jika hanya melihat jawaban akhir, tidak bisa menilai apa yang sebenarnya dibaca model |
include: ["file_search_call.results"] |
Membuat respons menyertakan konten yang benar-benar di-recall | Dapat membedakan antara “tidak ada yang di-recall” dan “sudah di-recall tetapi salah ditulis”, wajib untuk troubleshooting |
| Referensi file | Menandai file sumber dalam jawaban | Memudahkan pengecekan ulang, tetapi tidak berarti kesimpulannya benar |
Berikut adalah contoh pemanggilan minimal yang menunjukkan cara memasang vector store, membatasi jumlah hasil recall, dan meminta respons mengembalikan hasil pencarian. Ganti nama model dan ID vector store dengan konfigurasi Anda sendiri:
from openai import OpenAI

client = OpenAI()  # Membaca kunci dari variabel lingkungan OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # Jumlah hasil recall: menyeimbangkan cakupan bukti dan noise
    }],
    include=["file_search_call.results"],  # Mengembalikan konten yang benar-benar di-recall agar mudah melakukan troubleshooting
)

# Menelusuri output: mendapatkan teks akhir sekaligus melihat fragmen yang di-recall
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Konsistensi akhir pada penghapusan file di File Search
Dokumentasi menjelaskan bahwa menghapus file dari basis data vektor bersifat konsisten akhir: dalam kurun waktu tertentu setelah penghapusan, file tersebut masih mungkin ikut terambil dalam pencarian. Jadi kita tidak bisa mengklaim ke publik bahwa “begitu dihapus, file langsung tidak bisa ditemukan”. Kalau ada materi yang harus diturunkan karena keliru atau sudah kedaluwarsa, sebaiknya sistem penulisan juga melakukan penyaringan di lapisannya sendiri, bukan sekadar mengandalkan operasi penghapusan.
Hal-hal yang tidak dilakukan File Search
Berdasarkan penjelasan dokumentasi resmi dan mekanisme alat itu sendiri, ada beberapa poin yang perlu diperjelas:
- File Search hanya mencari file yang sudah ada di basis data vektor, dan tidak akan menemukan secara otomatis pengumuman atau pembaruan dokumen baru yang ada di internet.
- Penanda kutipan menunjukkan dari file mana konten berasal, tetapi tidak menjamin bahwa kesimpulan yang diambil dari file tersebut benar.
- Penyimpanan di basis data vektor dan pemanggilan alat sama-sama berbayar, dengan biaya mengikuti harga yang saat ini diumumkan OpenAI; artikel ini tidak mencantumkan angka spesifiknya.
- Artikel ini belum memverifikasi apakah APIYI atau platform pihak ketiga lainnya kompatibel dengan antarmuka terkait File Search. Untuk dukungan terkait, silakan mengacu pada penjelasan resmi masing-masing platform.
Analisis dan Penilaian OpenAI File Search
Penilaian pertama: File Search mengisi “lapisan pencarian”, bukan “lapisan materi”
Kekurangan sistem penulisan dalam hal materi biasanya ada dua macam. Pertama, materi sudah ada, tetapi tidak dapat ditemukan dengan tepat; model menulis berdasarkan kesan samar, dan sumbernya tidak jelas. Kedua, materi tidak ada sama sekali, atau materi yang ada sudah kedaluwarsa. File Search sangat efektif untuk kasus pertama: pencarian semantik meningkatkan fleksibilitas recall, dan kutipan file memungkinkan setiap bagian konten ditelusuri kembali.
Untuk kasus kedua, File Search tidak berdaya. Alat ini tidak akan secara aktif mengambil pengumuman baru; apa pun yang ada di basis data vektor, hanya itu yang dapat ia temukan. Misalnya, harga atau batasan suatu model baru saja disesuaikan, sementara basis data hanya berisi dokumen lama. File Search akan “secara akurat” menemukan informasi kedaluwarsa, lalu melengkapinya dengan kutipan yang tampak sangat meyakinkan. Ini lebih berbahaya daripada tidak ada kutipan, karena lebih mudah mengelabui proses peninjauan.
Jadi, File Search harus dipandang sebagai salah satu lapisan dalam sistem penulisan, bukan keseluruhan solusi materi. Pengumpulan materi, pembaruan berkala, dan penghentian versi lama tetap memerlukan proses terpisah yang menanganinya.
Penilaian Kedua: Menggunakan metode tiga bagian untuk menemukan masalah penulisan File Search
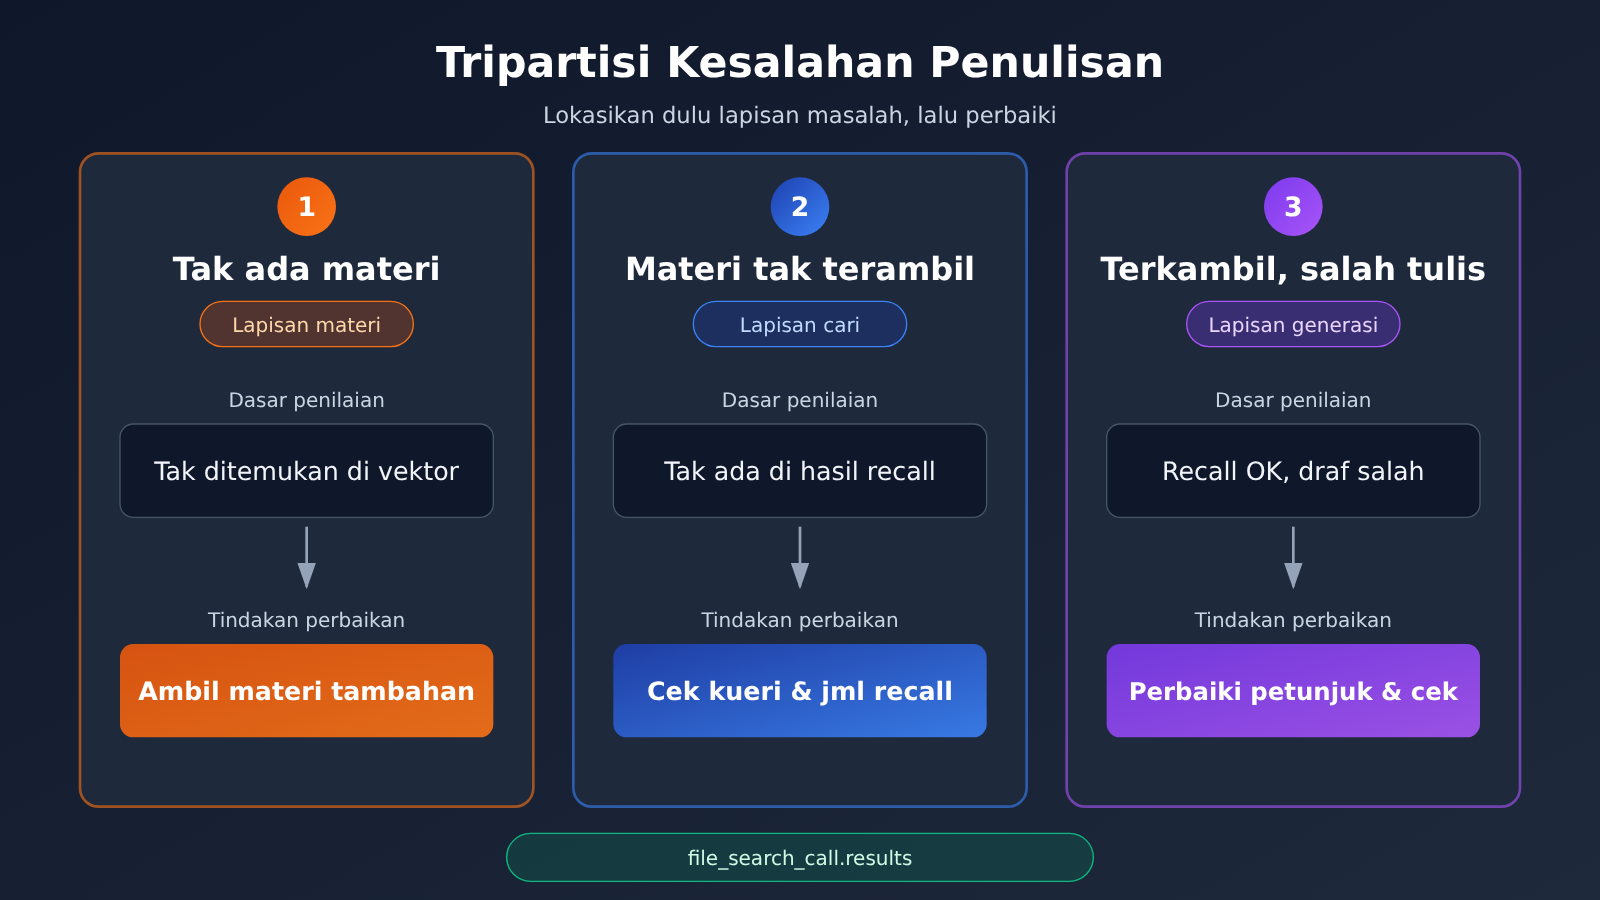
Ketika sebuah artikel ditulis dengan salah, masalahnya bisa muncul di tiga tahap yang berbeda. Nilai dari include: ["file_search_call.results"] adalah memungkinkan ketiga jenis masalah ini untuk pertama kalinya dapat dibedakan.
| Jenis masalah | Dasar penilaian | Arah perbaikan |
|---|---|---|
| Tidak ada materi di pustaka | Tidak ditemukan file terkait di basis data vektor | Lengkapi pengumpulan materi, ini masalah di lapisan materi |
| Ada materi tapi tidak terpanggil | File ada di pustaka, tapi tidak ada dalam file_search_call.results |
Sesuaikan rumusan kueri, pecah pertanyaan, atau tingkatkan max_num_results secukupnya |
| Terpanggil tapi ditulis salah | Hasil pemanggilan benar, tapi draf akhir tidak sesuai | Ubah petunjuk generasi dan aturan peninjauan, ini masalah di lapisan generasi |
Jika tidak ada konten pemanggilan yang dikembalikan, tim sering kali hanya bisa mengatakan secara umum “AI mengarang lagi”, lalu pergi mengubah petunjuk. Sering kali penyebab sebenarnya adalah pustaka tidak memiliki materi ini, atau kueri tidak menemukannya. Tentukan dulu di lapisan mana masalahnya muncul sebelum bertindak, ini bisa menghindari banyak jalan yang salah.
Kriteria ketiga: Metadata yang dimasukkan ke OpenAI File Search menentukan batas atas kualitas penulisan
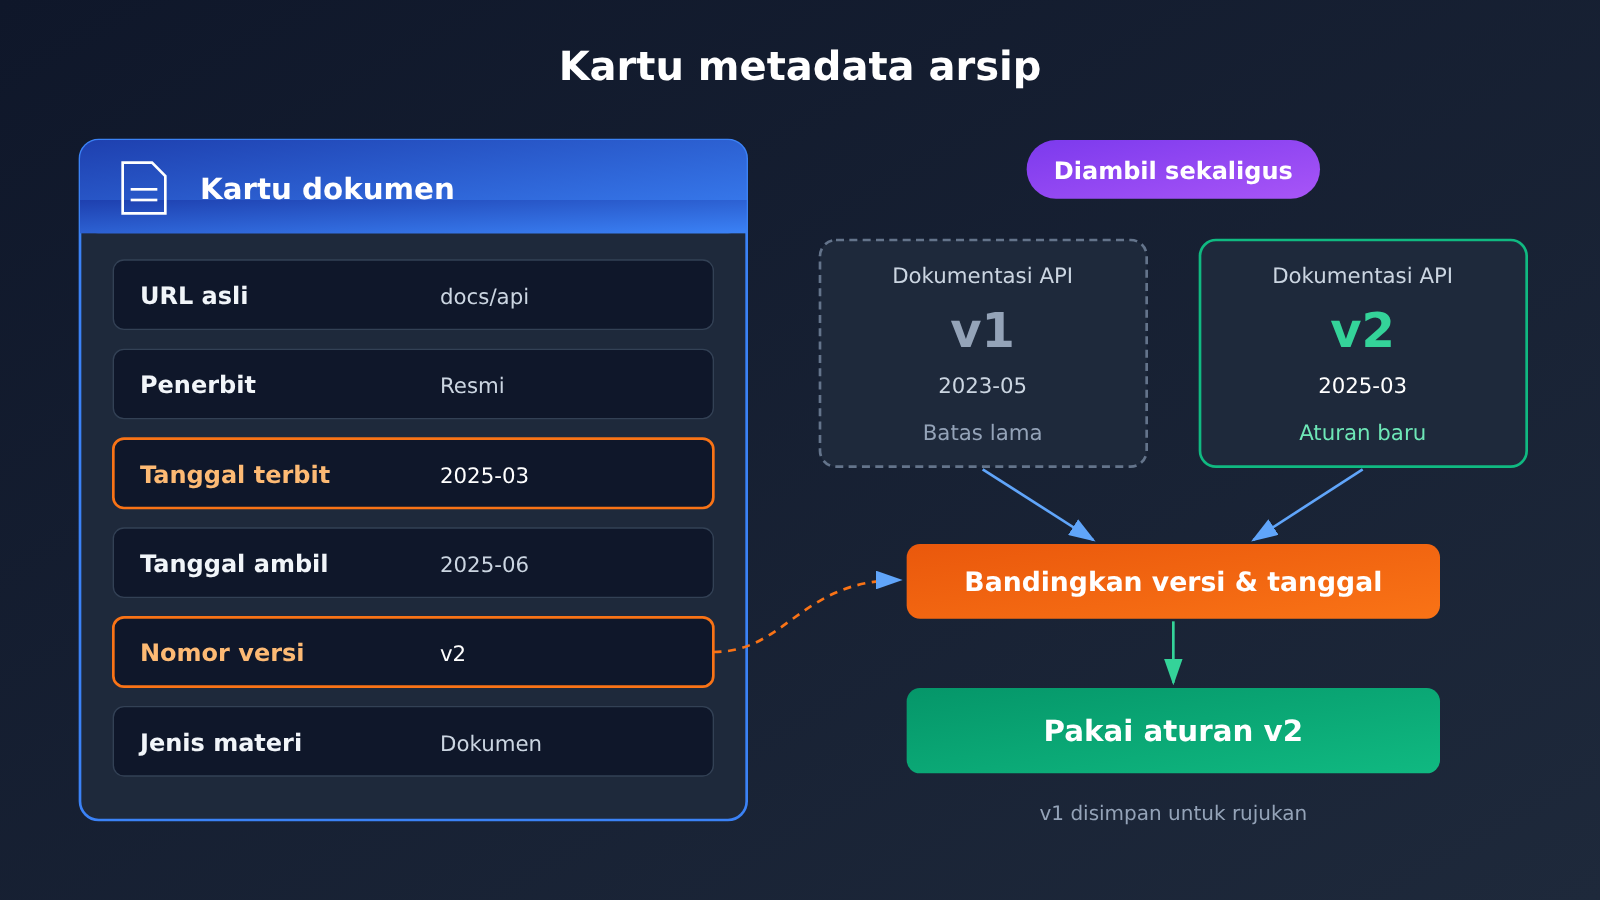
Pencarian hanya bisa mengembalikan konten yang ada di dalam basis data, dan kualitas konten di basis data bergantung pada apa yang dicatat saat diimpor. Untuk sistem penulisan, mengunggah isi dokumen saja tidak cukup; sebaiknya setiap materi setidaknya menyertakan informasi berikut:
| Bidang metadata | Kegunaan |
|---|---|
| URL asli | Memudahkan verifikasi kembali ke sumber asal, dan bisa dicantumkan di daftar referensi |
| Entitas penerbit | Membedakan pernyataan resmi, interpretasi pihak ketiga, dan rumor komunitas |
| Tanggal terbit | Menilai apakah informasi masih berlaku |
| Tanggal pengambilan | Menilai sudah berapa lama materi tidak diperbarui |
| Nomor versi | Saat dokumen lama dan baru hidup berdampingan, menghindari memperlakukan batasan lama sebagai aturan yang berlaku saat ini |
| Jenis materi | Membedakan pengumuman, dokumentasi, blog, dan posting forum, untuk memudahkan menetapkan tingkat kredibilitas |
Di antaranya, informasi versi paling mudah diabaikan. Dokumen lama dan baru untuk antarmuka yang sama mungkin sama-sama ada di basis data, dan secara semantik sangat mirip, sehingga saat pencarian keduanya sangat mungkin diambil sekaligus. Jika tidak ada versi dan tanggal, model akan sulit menentukan batasan mana yang sudah dicabut. Mempertahankan informasi versi lebih aman daripada langsung menghapus dokumen lama; di satu sisi, informasi itu masih berguna saat menulis perbandingan historis, di sisi lain, penghapusan itu sendiri juga mengikuti eventual consistency, jadi setelah dihapus belum tentu langsung hilang.
Penilaian keempat: tidak ada jawaban baku untuk jumlah hasil recall
Memperkecil max_num_results membuat konteks lebih bersih, biaya dan noise lebih rendah, tetapi bisa saja melewatkan bukti kunci. Terutama untuk topik yang butuh beberapa sumber saling menguatkan, misalnya ketika menyangkut harga, batasan, dan perbedaan versi sekaligus. Sebaliknya, memperbesarnya membuat cakupan lebih lengkap, tetapi fragmen yang tidak relevan akan mengencerkan perhatian, dan model juga lebih mungkin mencampur informasi dari versi yang berbeda.
Pendekatan yang lebih praktis adalah mengatur nilainya secara terpisah berdasarkan jenis artikel. Artikel ulasan informasi butuh verifikasi silang dari banyak sumber, jadi boleh dilonggarkan. Sementara penjelasan parameter untuk satu API bisa lebih diketatkan. Angka pastinya tidak punya solusi optimal universal; sebaiknya sesuaikan setelah mengamati isi recall yang benar-benar dikembalikan, bukan menetapkan nilai tetap berdasarkan perasaan belaka.
Perubahan lanjutan yang perlu diperhatikan
Poin-poin berikut adalah arah yang layak diamati, bukan fakta yang sudah terkonfirmasi: apakah File Search akan menyediakan filter metadata yang lebih granular, sehingga bisa menyaring langsung berdasarkan versi atau tanggal; apakah jeda efektif operasi penghapusan akan dijelaskan lebih gamblang; apakah skema penagihan akan disesuaikan. Perubahan-perubahan ini akan langsung memengaruhi pilihan arsitektur sistem penulisan, jadi sebaiknya periksa ulang dokumentasi resmi dan halaman harga sebelum melakukan integrasi.
Saat mengintegrasikan File Search ke dalam sistem penulisan, salah paham yang paling sering muncul adalah anggapan bahwa “selama ada retrieval dan sitasi, masalah materi sudah beres”. Kenyataannya, fitur ini membuat materi yang sudah ada lebih terpakai; kebaruan dan akurasi materi itu sendiri tetap harus dijaga melalui pengumpulan, manajemen versi, dan peninjauan.
Bagaimana air di kolam bisa sebening itu? Karena ada sumber mata air yang mengalir terus-menerus. — Zhu Xi, Membaca Buku dan Merenung


