
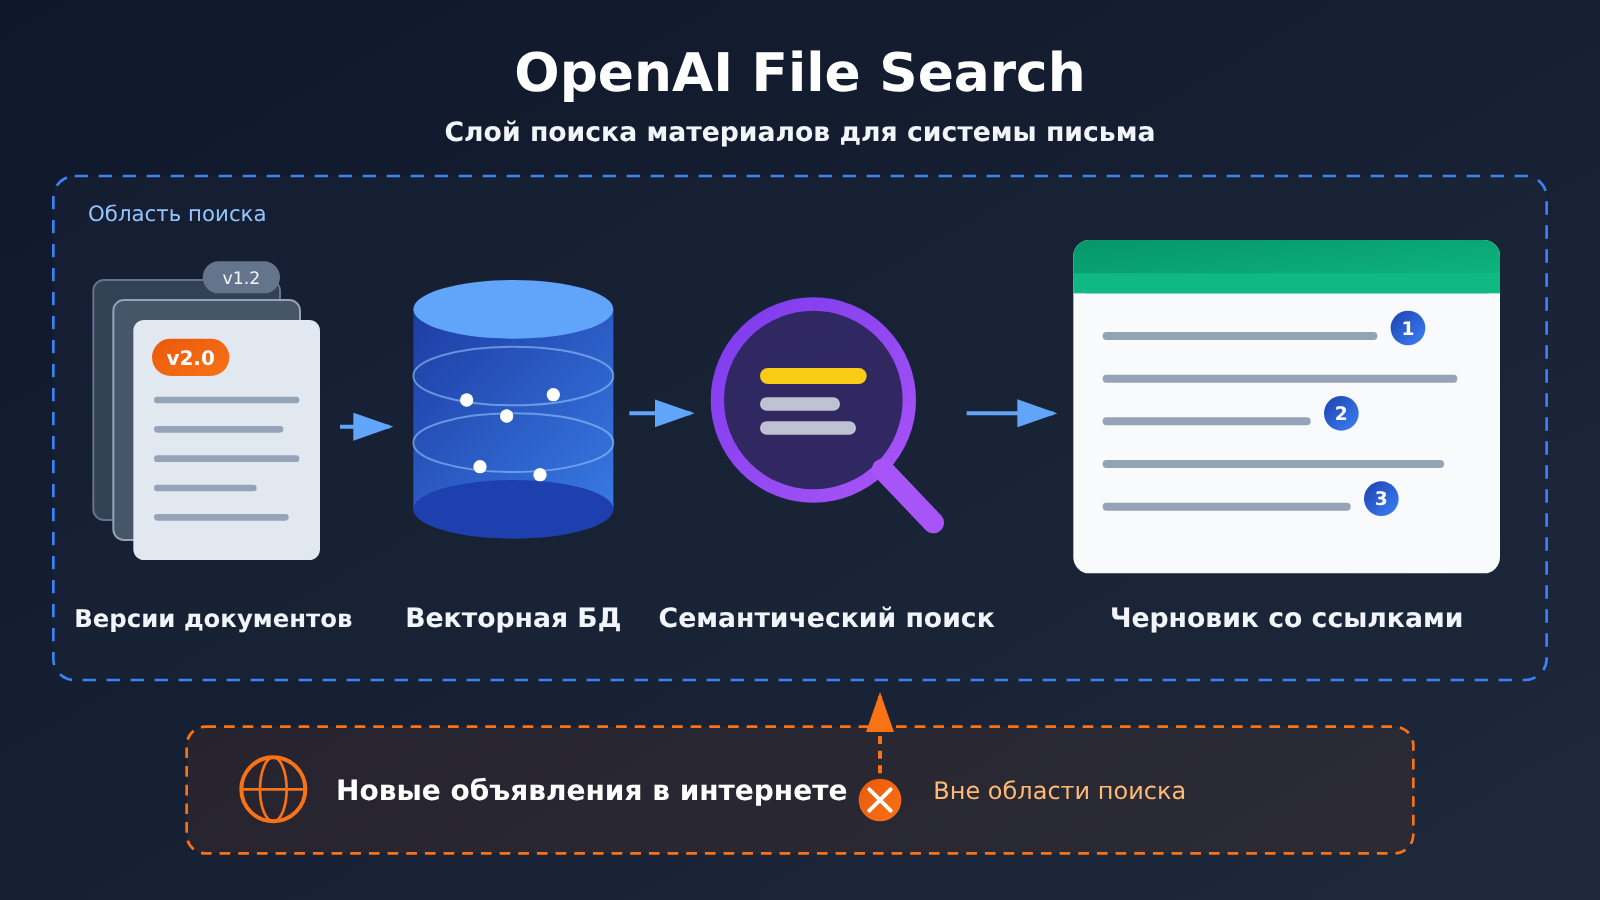
Часть пробелов закрыть можно — но не все. OpenAI File Search решает проблему «в уже имеющихся материалах трудно найти нужное, а цитирование неясно». Он умеет семантически искать файлы в векторной базе и прикладывать к ответу ссылки на файлы — для системы написания текстов это полезно. Но он не решает проблему «самих материалов не хватает или они устарели»: инструмент ищет только среди файлов, которые вы уже загрузили, и не обнаруживает автоматически новые объявления в интернете. Ссылочные пометки говорят лишь о том, из какого файла взят фрагмент, но не гарантируют, что вывод сделан правильно.
Поэтому более точная оценка такая: File Search может быть «слоем поиска материалов» в системе написания текстов, а сбор материалов, управление версиями и проверку фактов всё равно нужно делать отдельно.
Что вы узнаете из этой статьи?
- Как File Search встроен в Responses API и какие возможности он даёт процессу написания текстов
- Как регулировать количество найденных фрагментов и как заставить ответ вернуть фактически найденное содержимое, чтобы облегчить диагностику
- Почему файл после удаления ещё какое-то время может находиться поиском и что с этим делать системе написания текстов
- На каком уровне исправлять три типа проблем: нехватку материалов, неудачный поиск и ошибки генерации
- Какие метаданные стоит сохранять при загрузке, чтобы устаревшие ограничения не превратились в действующие правила
Содержание: Во вступительной части объясню несколько ключевых понятий и перечислю последствия для разных групп читателей. В разделе «Объективные факты», опираясь на официальную документацию OpenAI, разберу, как работает File Search, какие параметры можно настраивать и какое поведение известно. В разделе «Анализ и выводы» обсужу, как распределяются задачи после включения File Search в систему написания текстов, как искать причины сбоев и какие правила соблюдать при загрузке материалов; в конце — несколько заблуждений, которых стоит остерегаться.
Что важно знать об OpenAI File Search
| Понятие | Краткое пояснение |
|---|---|
| Responses API | Интерфейс генерации ответов OpenAI, который позволяет подключать инструменты в рамках одного запроса; File Search — один из них |
| File Search | Встроенный инструмент Responses API: извлекает релевантные фрагменты из файлов в векторном хранилище и помогает формировать ответ |
| Векторное хранилище (Vector Store) | Хранилище загруженных файлов и их векторных представлений; именно в нём File Search выполняет поиск |
| Семантический поиск | Поиск по смысловой близости: находятся фрагменты, где смысл совпадает, даже если формулировки разные |
| Ссылка на файл (Citation) | В ответе указывается, из какого файла взята информация, чтобы читателю и проверяющему было проще вернуться к источнику |
max_num_results |
Параметр, который задаёт максимальное число результатов, возвращаемых за один поиск |
include |
Параметр запроса: если передать file_search_call.results, в ответ попадут фактически найденные фрагменты |
| Конечная согласованность | Операции записи или удаления не применяются мгновенно везде; некоторое время можно видеть старое состояние |
Влияние OpenAI File Search: кратко
| Аудитория | Что меняется |
|---|---|
| Разработчики систем написания текстов | Можно получить семантический поиск и ссылки на файлы без собственного поискового сервиса. Но нужно продумать правила добавления документов в хранилище и процесс устранения неполадок |
| Редакторы и проверяющие контента | Ссылки облегчают возврат к источнику, но выводы всё равно нужно проверять по одному. Нельзя пропускать проверку только потому, что в материале есть ссылки |
| Сопровождающие техническую документацию | В документации для разных версий нужно указывать версию и дату, иначе старые ограничения могут всплыть в результатах поиска и попасть в новую статью |
| Ответственные за расходы | Хранение в векторном хранилище и вызовы инструментов тарифицируются; актуальные цены смотрите на текущей странице тарифов OpenAI. При большом объёме материалов расходы стоит оценить заранее |
OpenAI File Search: объективные факты
Приведённые ниже сведения основаны на двух руководствах из документации OpenAI для разработчиков — File Search и Retrieval; дата проверки — 2026-11-17. Оба документа поддерживаются в актуальном виде, однако в этой статье не проверялась дата первого выпуска функции.
Что такое File Search: инструмент поиска по файлам в Responses API
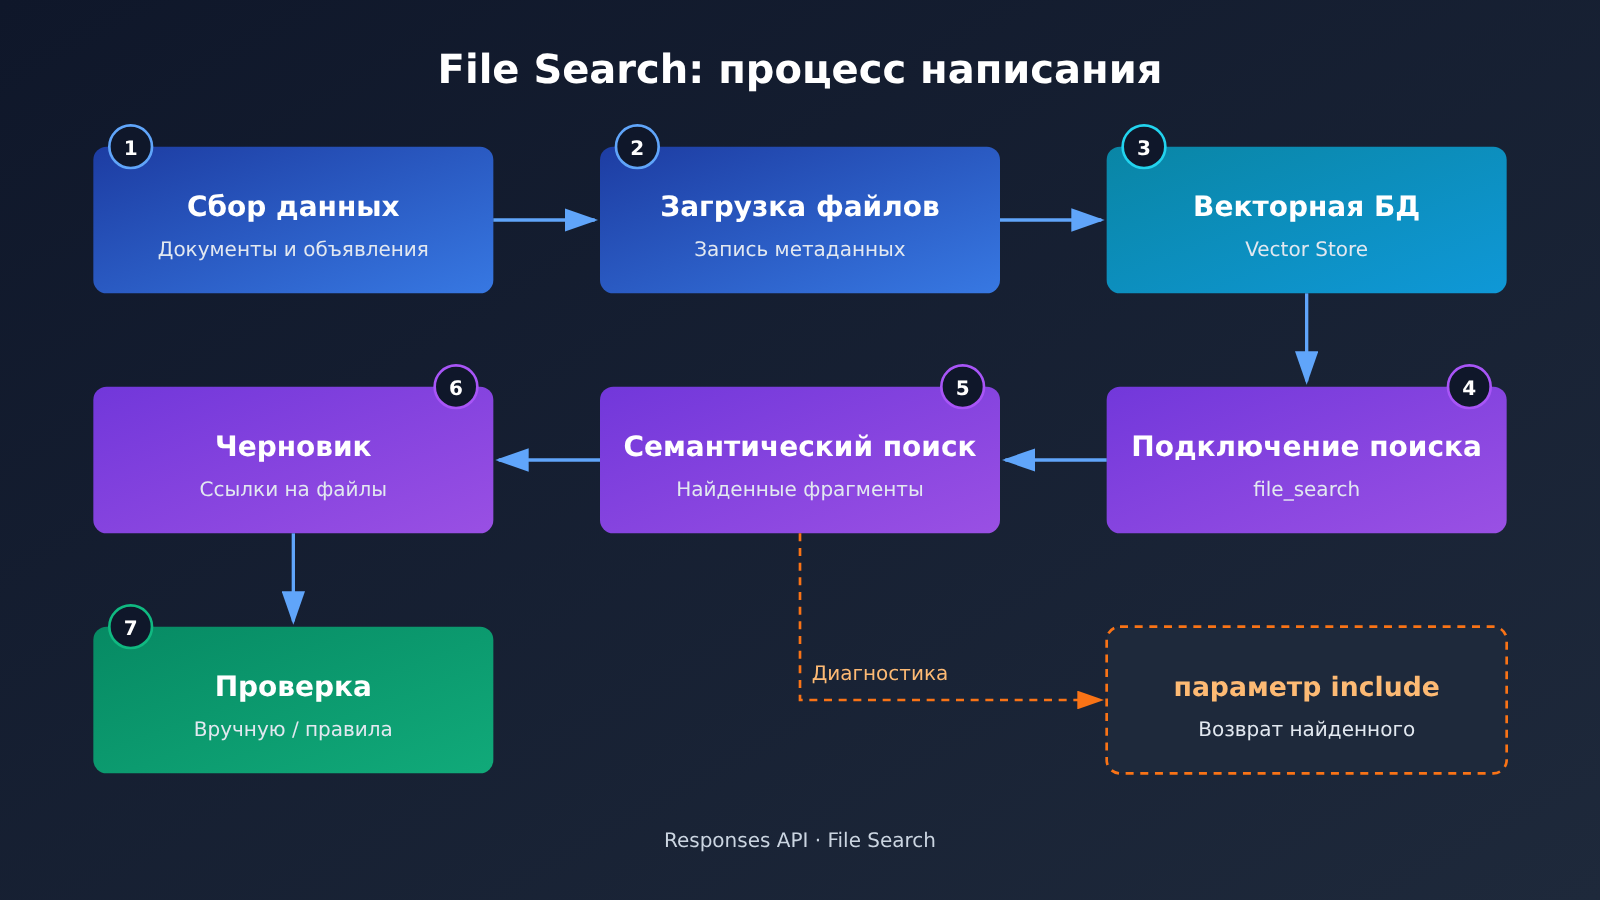
File Search — это инструмент, который предоставляет Responses API. Разработчик сначала загружает файлы в векторное хранилище, а при отправке запроса объявляет File Search в tools и указывает векторное хранилище. Генерируя ответ, модель извлекает релевантный контент из этих файлов; ответ может сопровождаться ссылками на файлы с указанием источника информации.
Здесь используется семантический поиск: находится контент, близкий по смыслу, даже если слова совпадают не полностью. Например, по запросу «ограничение частоты запросов к API» может быть найден фрагмент, где написано «верхний предел частоты запросов». Для системы, которая пишет тексты, это означает, что при постановке вопроса не обязательно дословно повторять формулировки из исходного материала.
Настраиваемые параметры File Search и переключатели для отладки
В документации есть два параметра, которые напрямую связаны с системой написания текстов:
| Параметр / поведение | Назначение | Значение для процесса написания |
|---|---|---|
max_num_results |
Регулирует количество результатов, возвращаемых за один поиск | Меньше — экономит контекст, но доказательства могут быть неполными; больше — шире охват, но и шума становится больше |
| Возврат по умолчанию | Вызов инструмента по умолчанию не возвращает полные результаты поиска | Глядя только на финальный ответ, невозможно понять, что именно прочитала модель |
include: ["file_search_call.results"] |
Заставляет ответ включать фактически извлечённое содержимое | Позволяет отличить «не нашлось» от «нашлось, но написано неправильно» — обязательный инструмент для отладки |
| Ссылка на файл | В ответе указывается исходный файл | Удобно для перепроверки, но не гарантирует правильность вывода |
Ниже — минимальный пример вызова, показывающий, как подключить векторное хранилище, ограничить количество извлекаемых результатов и потребовать, чтобы ответ возвращал результаты поиска. Имя модели и ID векторного хранилища замените на свою конфигурацию:
from openai import OpenAI

client = OpenAI()  # читает ключ из переменной окружения OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # количество извлекаемых результатов: баланс между покрытием доказательств и шумом
    }],
    include=["file_search_call.results"],  # возвращает фактически извлечённое содержимое для удобства отладки
)

# обходим вывод: получаем и финальный текст, и видим, какие фрагменты были извлечены
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Окончательная согласованность при удалении файлов в File Search
В документации указано, что удаление файла из векторного хранилища является окончательно согласованным: в течение некоторого времени после удаления файл всё ещё может находиться в результатах поиска. Поэтому нельзя утверждать, что «после удаления файл сразу становится недоступен для поиска». Если какой-то материал нужно снять с публикации из-за ошибки или устаревания, системе, которая его использует, лучше дополнительно фильтровать на своём уровне, а не полагаться только на операцию удаления.
Чего File Search не делает
Судя по официальной документации и механике самого инструмента, стоит прояснить несколько моментов:
- File Search ищет только те файлы, которые уже есть в векторном хранилище, и не обнаруживает автоматически новые объявления или обновления документов в интернете.
- Ссылки-цитаты показывают, из какого файла взят фрагмент, но не гарантируют, что выводы, сделанные на основе этого файла, верны.
- Хранение в векторном хранилище и вызовы инструмента платные; стоимость определяется текущими ценами, опубликованными OpenAI, и в этой статье конкретные цифры не приводятся.
- В этой статье не проверялось, совместимы ли APIYI или другие сторонние платформы с интерфейсами, связанными с File Search; актуальную информацию о поддержке смотрите в официальных документах соответствующих платформ.
Анализ OpenAI File Search
Суждение первое: File Search закрывает «слой поиска», а не «слой материалов»
В системах для написания текстов обычно есть две слабые стороны, связанные с материалами. Первая: материалы есть, но их не удаётся точно найти — модель пишет по памяти, а откуда взято, непонятно. Вторая: материалов нет вообще или они уже устарели. С первым File Search справляется хорошо: семантический поиск делает выдачу гибче, а ссылки на файлы позволяют проверить каждый фрагмент.
Со вторым он не поможет. Инструмент сам не ходит за свежими анонсами: что лежит в векторной базе, то он и найдёт. Например, только что изменились цена или ограничения какой-то модели, а в базе остались лишь старые документы — File Search «точно» найдёт устаревшую информацию и приложит ссылку, которая выглядит вполне надёжно. Это опаснее, чем отсутствие ссылки: так проще обмануть проверку.
Поэтому File Search стоит рассматривать как один из слоёв системы для написания текстов, а не как всё решение для работы с материалами. Сбор материалов, регулярное обновление и отбраковка устаревших версий по-прежнему требуют отдельного процесса.
Критерий второй: как с помощью трёх категорий определить, где именно ошибся File Search
Если в тексте есть ошибка, проблема может скрываться в одном из трёх разных звеньев. Ценность include: ["file_search_call.results"] в том, что он впервые позволяет разделить эти три типа проблем.
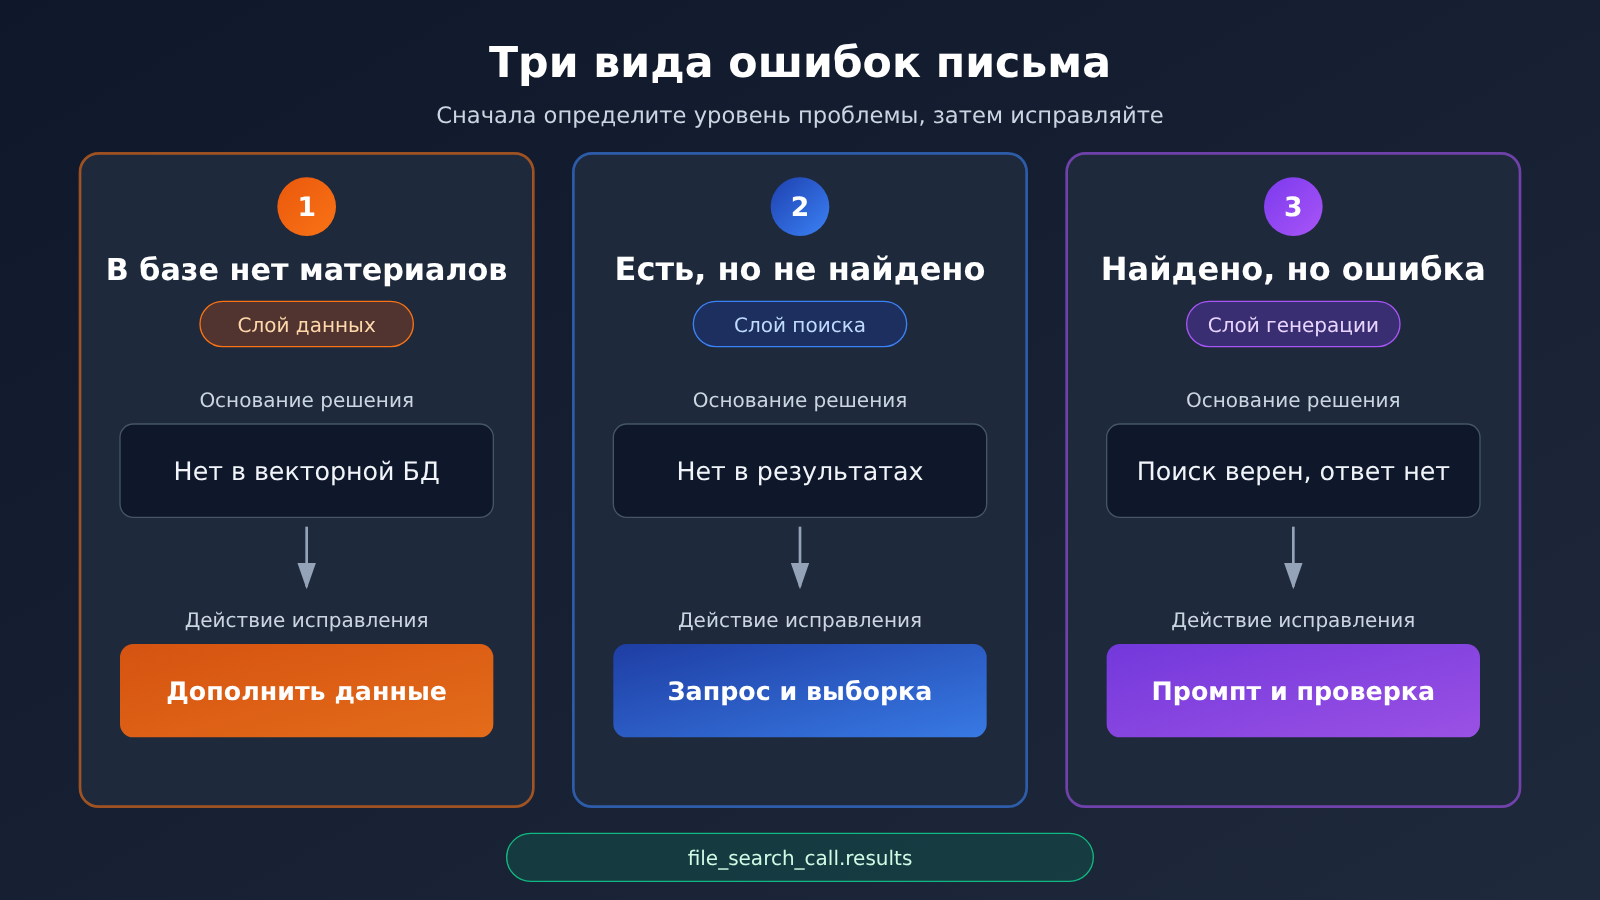
| Тип проблемы | Как определить | Что исправлять |
|---|---|---|
| В базе нет материала | В векторной базе не находится релевантных файлов | Добрать материалы — это проблема уровня данных |
| Материал есть, но не найден | Файл в базе есть, но в file_search_call.results его нет |
Переформулировать запрос, разбить вопрос на части или немного увеличить max_num_results |
| Нашли, но написали неверно | Найденные результаты верны, а итоговый текст им противоречит | Изменить промпт генерации и правила проверки — это проблема уровня генерации |
Если поиск ничего не возвращает, команда обычно отделывается расплывчатым «ИИ опять всё выдумал» и идёт править промпт. Но очень часто настоящая причина в том, что в базе просто нет нужного материала или запрос по нему не попал. Прежде чем что-то менять, определите, на каком уровне проблема, — это экономит кучу времени и сил.
Критерий третий: метаданные, записываемые при загрузке в OpenAI File Search, задают верхнюю границу качества текста
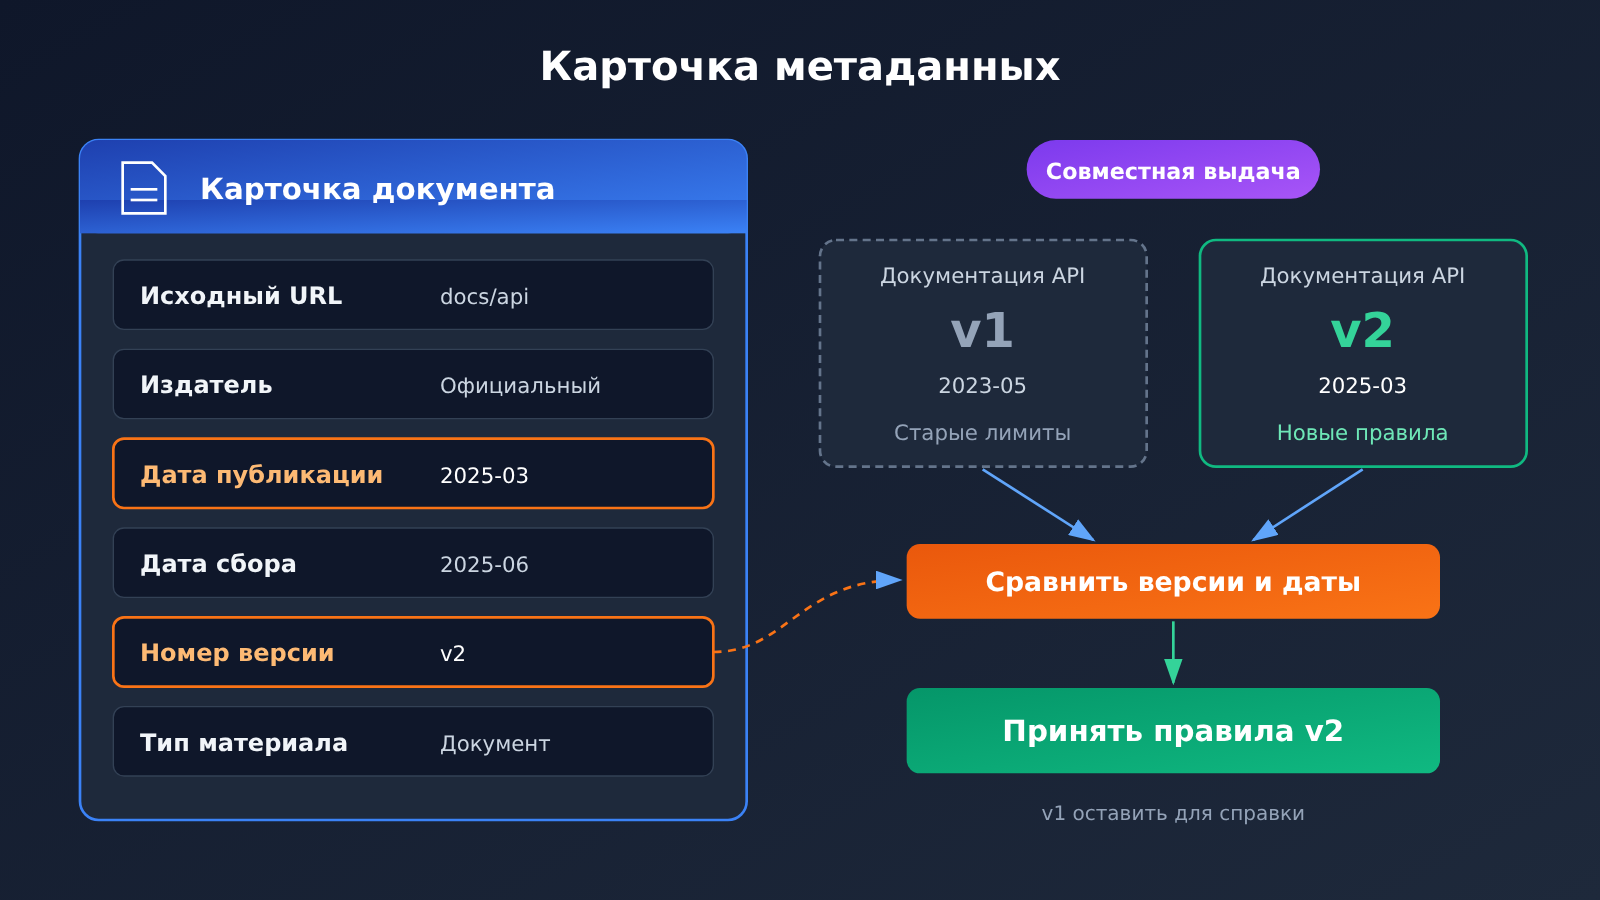
Поиск может вернуть только то, что есть в базе, а качество содержимого базы зависит от того, что было записано при загрузке. Для системы генерации текста просто загрузить тело файла недостаточно. Рекомендуется для каждого материала как минимум добавлять следующие сведения:
| Поле метаданных | Назначение |
|---|---|
| Исходный URL | Позволяет вернуться к источнику для проверки и указать его в списке справочных материалов |
| Издатель / источник публикации | Помогает отличать официальные заявления от сторонних интерпретаций и слухов сообщества |
| Дата публикации | Показывает, актуальна ли информация |
| Дата сбора | Показывает, как давно материал не обновлялся |
| Номер версии | Помогает не принимать старые ограничения за действующие правила, когда старые и новые документы существуют одновременно |
| Тип материала | Позволяет различать объявления, документацию, блоги и посты на форумах, чтобы задать уровень доверия |
Чаще всего упускают сведения о версии. В базе могут одновременно лежать старые и новые документы по одному и тому же API, и семантически они очень похожи — при поиске их вполне могут вернуть вместе. Если нет версии и даты, модели трудно понять, какое ограничение уже отменено. Сохранять сведения о версии надёжнее, чем просто удалять старые документы: с одной стороны, они ещё пригодятся при написании исторических сравнений; с другой — удаление подчиняется согласованности в конечном счёте, то есть удалённое не обязательно исчезнет сразу.
Критерий четвёртый: для числа召回 нет единственно верного ответа
Если уменьшить max_num_results, контекст становится чище — ниже и затраты, и шум, — но можно упустить ключевые доказательства. Особенно в темах, где нужно, чтобы несколько источников подтверждали друг друга: например, когда одновременно речь идёт о цене, ограничениях и различиях между версиями. Если же увеличить — покрытие будет полнее, но не относящиеся к делу фрагменты размывают внимание, и модель чаще начинает смешивать информацию из разных версий.
Практичнее настраивать это отдельно по типам статей. Для разборов новостей нужно перекрёстное подтверждение из нескольких источников — здесь ограничение можно ослабить. А для описания параметров одного интерфейса его можно зажать посильнее. Универсально оптимальных значений не существует: подстраивать стоит, реально наблюдая за тем, что возвращается в результатах поиска, а не задавать фиксированное значение на глаз.
Какие дальнейшие изменения стоит отслеживать
Перечисленное ниже — направления, за которыми имеет смысл наблюдать, а не уже подтверждённые факты: появится ли у File Search более гранулярная фильтрация по метаданным, чтобы можно было сразу отбирать по версии или дате; станет ли задержка применения операции удаления описана более явно; изменится ли модель оплаты. Все эти изменения напрямую влияют на выбор архитектуры системы создания текстов, поэтому перед подключением рекомендуется заново сверяться с официальной документацией и страницей с ценами.
Самое частое заблуждение при подключении File Search к системе создания текстов — «раз есть поиск и цитирование, проблема материалов решена». На деле это лишь помогает лучше использовать уже имеющиеся материалы, а их свежесть и точность по-прежнему обеспечиваются сбором данных, управлением версиями и проверкой.
Отчего ручей так прозрачен и чист? — Оттого, что у истока бьёт живой родник. — Чжу Си, «Впечатления от чтения»


