
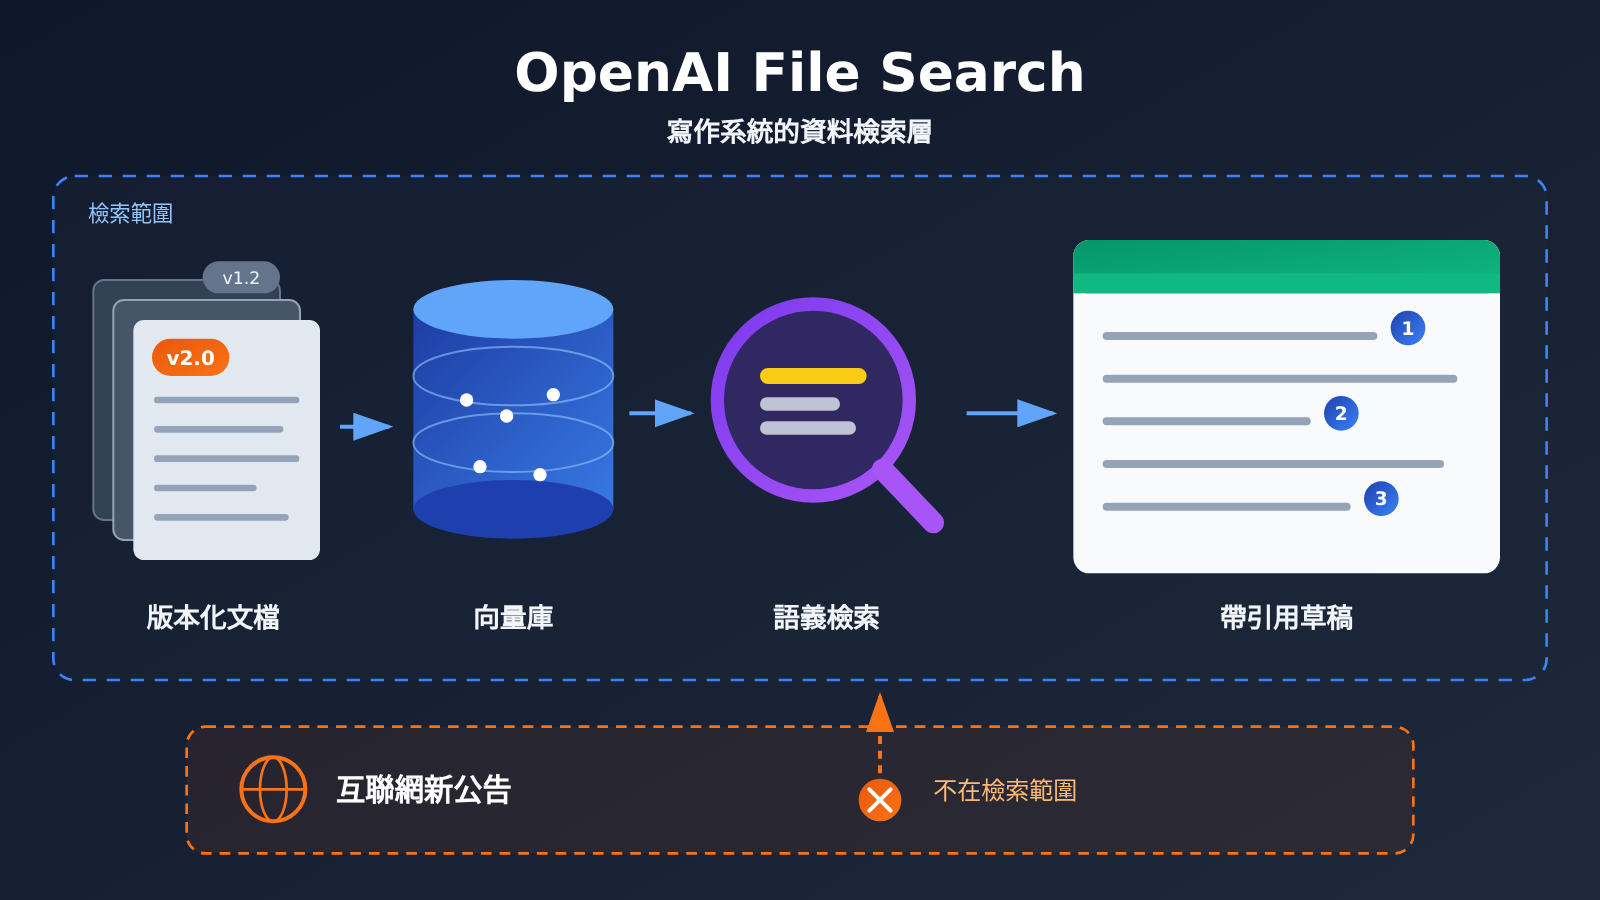
能補上一部分,但補不全。 OpenAI File Search 解決的是“已有資料找不準、引用不清”的問題。它能從向量庫裏按語義檢索文件,並在回答中附上文件引用,這對寫作系統很有用。它不解決“資料本身缺失或過期”的問題:工具只檢索你已經放進去的文件,不會自動發現互聯網上的新公告。引用標記也只能說明內容出自哪份文件,不能保證結論寫對了。
所以更準確的判斷是:File Search 可以做寫作系統的“資料檢索層”,資料採集、版本管理和事實審覈仍要單獨做。
您讀完此文能瞭解到什麼?
- File Search 在 Responses API 中的定位,以及它能爲寫作流程提供哪些能力
- 如何調整召回數量,如何讓響應返回實際檢索到的內容,方便排查問題
- 刪除文件後爲什麼短期內仍可能被檢索到,寫作系統應如何應對
- 資料缺失、召回失敗、生成寫錯這三類問題分別該在哪一層修復
- 入庫時建議保存哪些元數據,才能避免把過期限制寫成現行規則
索引: 正文前導先解釋幾個關鍵概念,並按人羣列出影響。“客觀事實”部分依據 OpenAI 官方文檔,梳理 File Search 的工作方式、可調參數和已知行爲。“分析判斷”部分討論它放進寫作系統後的分工、排障路徑和入庫規範,最後說明需要警惕的幾個誤區。
OpenAI File Search 相關概念 To Know
| 概念 | 簡要解釋 |
|---|---|
| Responses API | OpenAI 的響應生成接口,可以在一次請求中掛載工具,File Search 就是其中一種 |
| File Search | Responses API 的內置工具,從向量庫中的文件檢索相關片段,用來輔助生成回答 |
| 向量庫(Vector Store) | 存放已上傳文件及其向量表示的庫,File Search 的檢索範圍就是它 |
| 語義檢索 | 按意義相似度查找內容,字面用詞不同但意思相關的段落也能被找到 |
| 文件引用(Citation) | 回答中標註某段內容出自哪個文件,便於讀者和審覈者回查 |
max_num_results |
控制一次檢索最多返回多少條結果的參數 |
include |
請求參數,傳入 file_search_call.results 後,響應會包含實際召回的內容 |
| 最終一致性 | 寫入或刪除操作不會立刻在所有地方生效,短時間內可能看到舊狀態 |
OpenAI File Search 影響速覽
| 人羣 | 主要影響 |
|---|---|
| 寫作系統開發者 | 不用自建檢索服務,就能獲得語義檢索和文件引用。需要自己設計入庫規範和排障流程 |
| 內容編輯 / 審覈者 | 引用讓回查更方便,但仍需逐條覈對結論,不能因爲“有引用”就直接放行 |
| 技術文檔維護者 | 新舊版本文檔要標好版本和日期,否則舊限制可能被檢索出來、寫進新文章 |
| 成本負責人 | 向量庫存儲和工具調用都要計費,具體以 OpenAI 當前價格頁爲準,資料量大時需要預估 |
OpenAI File Search 客觀事實
以下內容依據 OpenAI 開發者文檔中 File Search 與 Retrieval 兩份指南,覈查日期爲 2026-11-17。這兩份是維護中的文檔,本文未覈實該功能的首次發佈日期。
File Search 是什麼:Responses API 裏的檢索工具
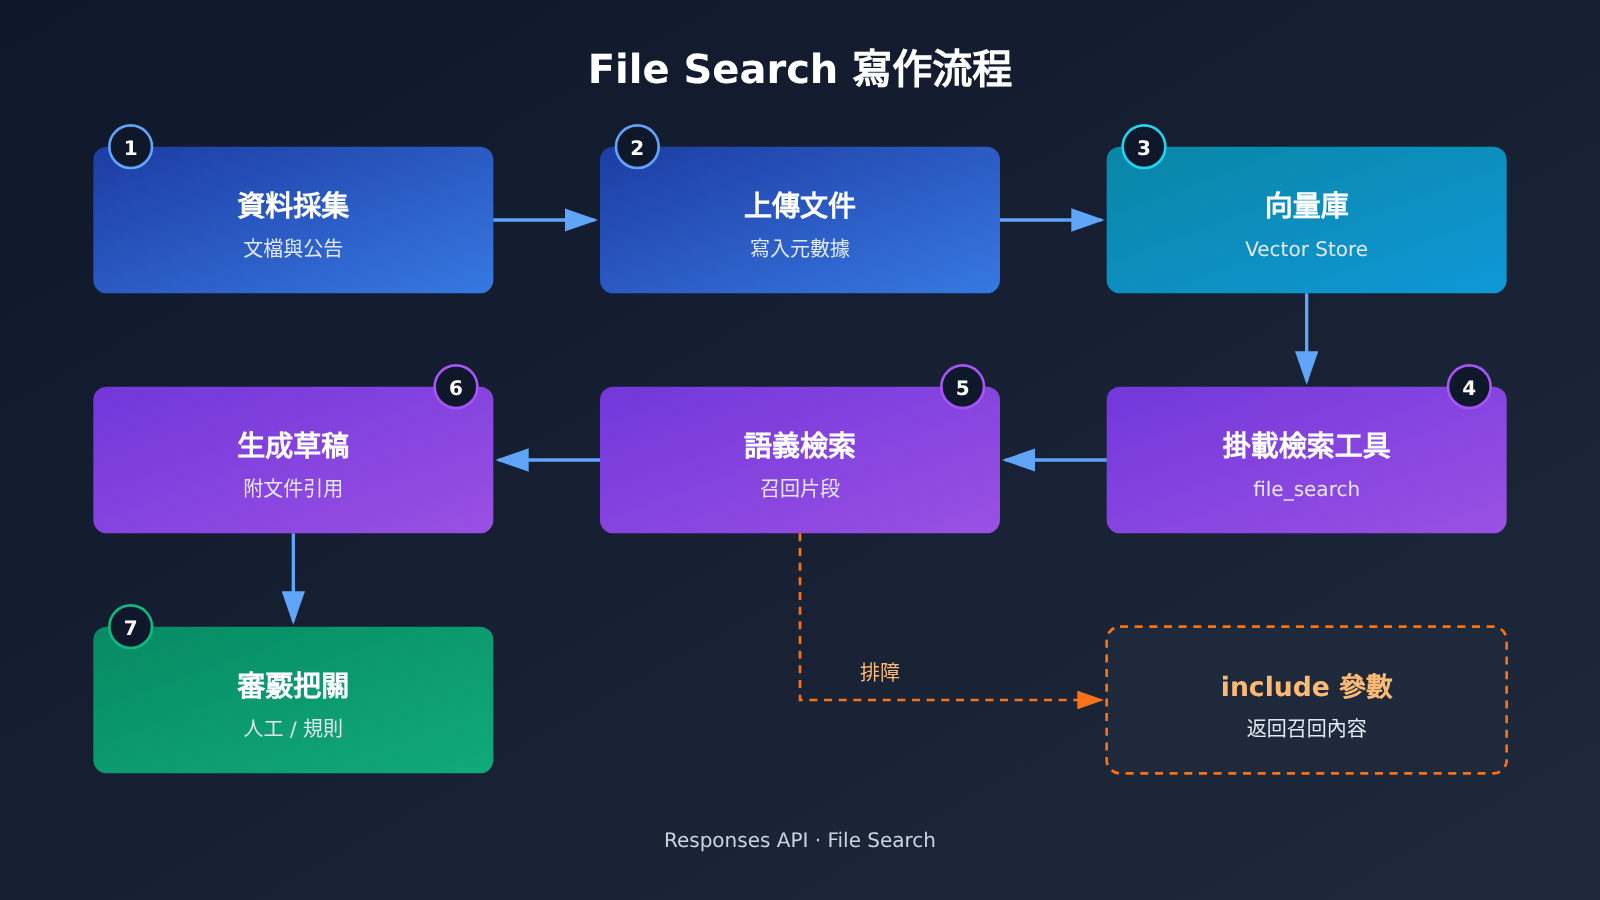
File Search 是 Responses API 提供的工具。開發者先把文件上傳到向量庫,發起請求時在 tools 中聲明 File Search 並指定向量庫。模型生成回答時會從這些文件中檢索相關內容,回答可以附帶文件引用,標明信息出處。
它使用語義檢索,能找到意思相關但字詞不完全一致的內容。比如查詢“接口限流”,文檔裏寫的是“請求頻率上限”,也有可能被召回。對寫作系統來說,這意味着提問時不必完全復刻原文措辭。
File Search 的可調參數與排障開關
文檔中有兩個參數和寫作系統關係最直接:
| 參數 / 行爲 | 作用 | 對寫作流程的意義 |
|---|---|---|
max_num_results |
調整單次檢索返回的結果數量 | 數量少更省上下文,但證據可能不全;數量多覆蓋更廣,但噪聲也會增加 |
| 默認返回內容 | 工具調用默認不返回完整檢索結果 | 只看最終回答時,無法判斷模型到底讀到了什麼 |
include: ["file_search_call.results"] |
讓響應包含實際召回的內容 | 能把“沒召回”和“召回了但寫錯”區分開,排障必備 |
| 文件引用 | 回答中標註出處文件 | 方便回查,但不等於結論正確 |
下面是一個最小調用示例,展示如何掛載向量庫、限制召回數量,並要求響應返回檢索結果。其中的模型名和向量庫 ID 請替換成你自己的配置:
from openai import OpenAI

client = OpenAI()  # 從環境變量 OPENAI_API_KEY 讀取密鑰

response = client.responses.create(
    model="YOUR_MODEL",
    input="根據資料庫,總結該接口目前的調用限制,並標明出處。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # 召回數量:在證據覆蓋與噪聲之間權衡
    }],
    include=["file_search_call.results"],  # 返回實際召回內容,便於排障
)

# 遍歷輸出:既能拿到最終文本,也能看到檢索到了哪些片段
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
File Search 刪除文件的最終一致性
文檔說明,從向量庫刪除文件是最終一致的:刪除後的一段時間內,該文件仍有可能被檢索到。因此不能對外宣稱“刪除後立即不可檢索”。如果某份資料因爲錯誤或過期必須下線,寫作系統最好在自己這一層也做過濾,而不是隻依賴刪除操作。
File Search 不做什麼
根據官方文檔的描述和工具本身的機制,有幾點需要明確:
- File Search 只檢索已經存在於向量庫中的文件,不會自動發現互聯網上的新公告或文檔更新。
- 引用標記說明內容來自哪份文件,不保證基於這份文件得出的結論正確。
- 向量庫存儲和工具調用都收費,費用以 OpenAI 當前公佈的價格爲準,本文不給出具體數字。
- 本文未驗證 API易 或其他第三方平臺是否兼容 File Search 相關接口,相關支持情況請以各平臺官方說明爲準。
OpenAI File Search 分析判斷
判斷一:File Search 補的是“檢索層”,不是“資料層”
寫作系統的資料短板通常有兩種。一種是手裏有資料但找不準,模型憑印象寫,出處說不清。另一種是根本沒有資料,或者資料已經過時。File Search 對第一種很有效:語義檢索提高了召回的靈活度,文件引用讓每段內容都能回查。
對第二種它無能爲力。工具不會主動去抓新公告,向量庫裏是什麼,它就只能檢索到什麼。比如某個模型的價格或限制剛剛調整,而庫裏只有舊文檔,File Search 會“準確地”檢索到過期信息,再配上一個看起來很可靠的引用。這比沒有引用更危險,因爲它更容易騙過審覈。
所以 File Search 應該看作寫作系統裏的一層,而不是整個資料方案。資料採集、定期更新、版本淘汰仍然需要單獨的流程來負責。
判斷二:用三分法定位 File Search 寫作問題
一篇文章寫錯了,問題可能出在三個不同環節。include: ["file_search_call.results"] 的價值在於,它讓這三類問題第一次可以被區分開。
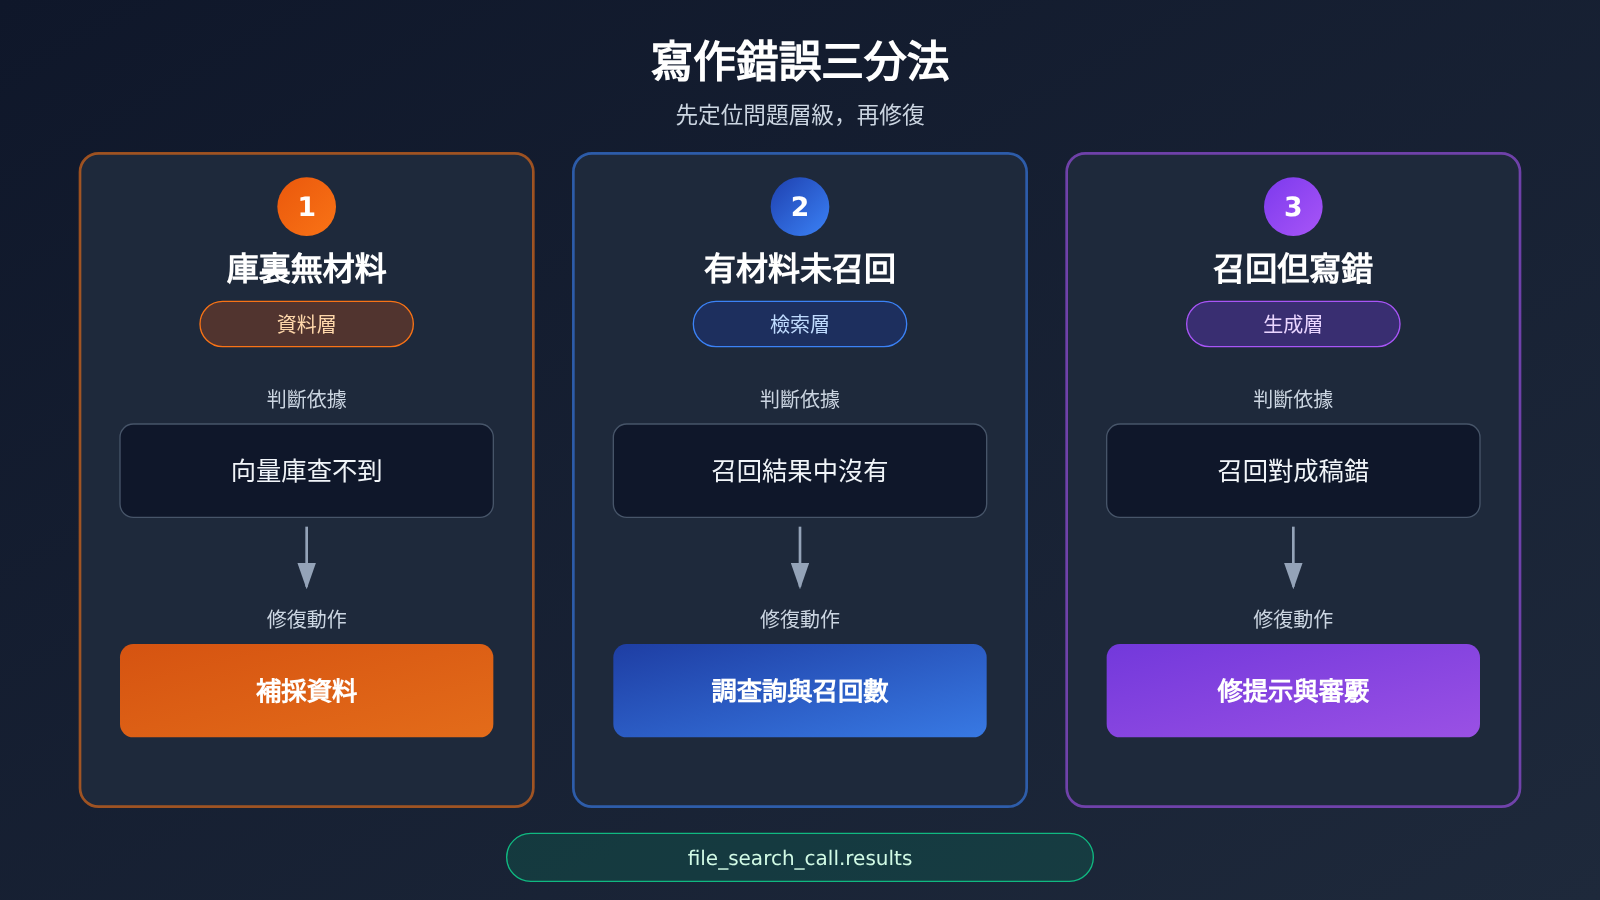
| 問題類型 | 判斷依據 | 修復方向 |
|---|---|---|
| 庫裏沒有材料 | 在向量庫中查不到相關文件 | 補採資料,屬於資料層問題 |
| 有材料但未召回 | 文件在庫裏,但 file_search_call.results 中沒有它 |
調整查詢措辭、拆分問題,或適當增加 max_num_results |
| 召回了但寫錯了 | 召回結果正確,成稿卻與之不符 | 修改生成提示和審覈規則,屬於生成層問題 |
如果沒有返回召回內容,團隊往往只能籠統地說“AI 又編了”,然後去改提示詞。很多時候真正的原因是庫裏沒有這份資料,或者查詢沒有命中它。先判斷問題出在哪一層再動手,能少走很多彎路。
判斷三:OpenAI File Search 入庫元數據決定寫作質量上限
檢索只能返回庫裏的內容,而庫裏內容的質量取決於入庫時記錄了什麼。對寫作系統來說,單純上傳文件正文是不夠的,建議每份資料至少附帶以下信息:
| 元數據字段 | 用途 |
|---|---|
| 原始 URL | 方便回到源頭覈實,也能在參考資料中列出 |
| 發佈主體 | 區分官方說法、第三方解讀和社區傳言 |
| 發佈日期 | 判斷信息是否仍然有效 |
| 抓取日期 | 判斷資料多久沒有更新 |
| 版本號 | 新舊文檔共存時避免把舊限制當作現行規則 |
| 資料類型 | 區分公告、文檔、博客、論壇帖,便於設定可信度 |
其中版本信息最容易被忽視。同一個接口的新舊文檔可能都在庫裏,語義上又高度相似,檢索時很可能同時被召回。如果沒有版本和日期,模型很難判斷哪條限制已經被廢除。保留版本信息比直接刪除舊文檔更穩妥,一方面寫歷史對比時還用得到,另一方面刪除本身也是最終一致的,刪了不一定馬上消失。
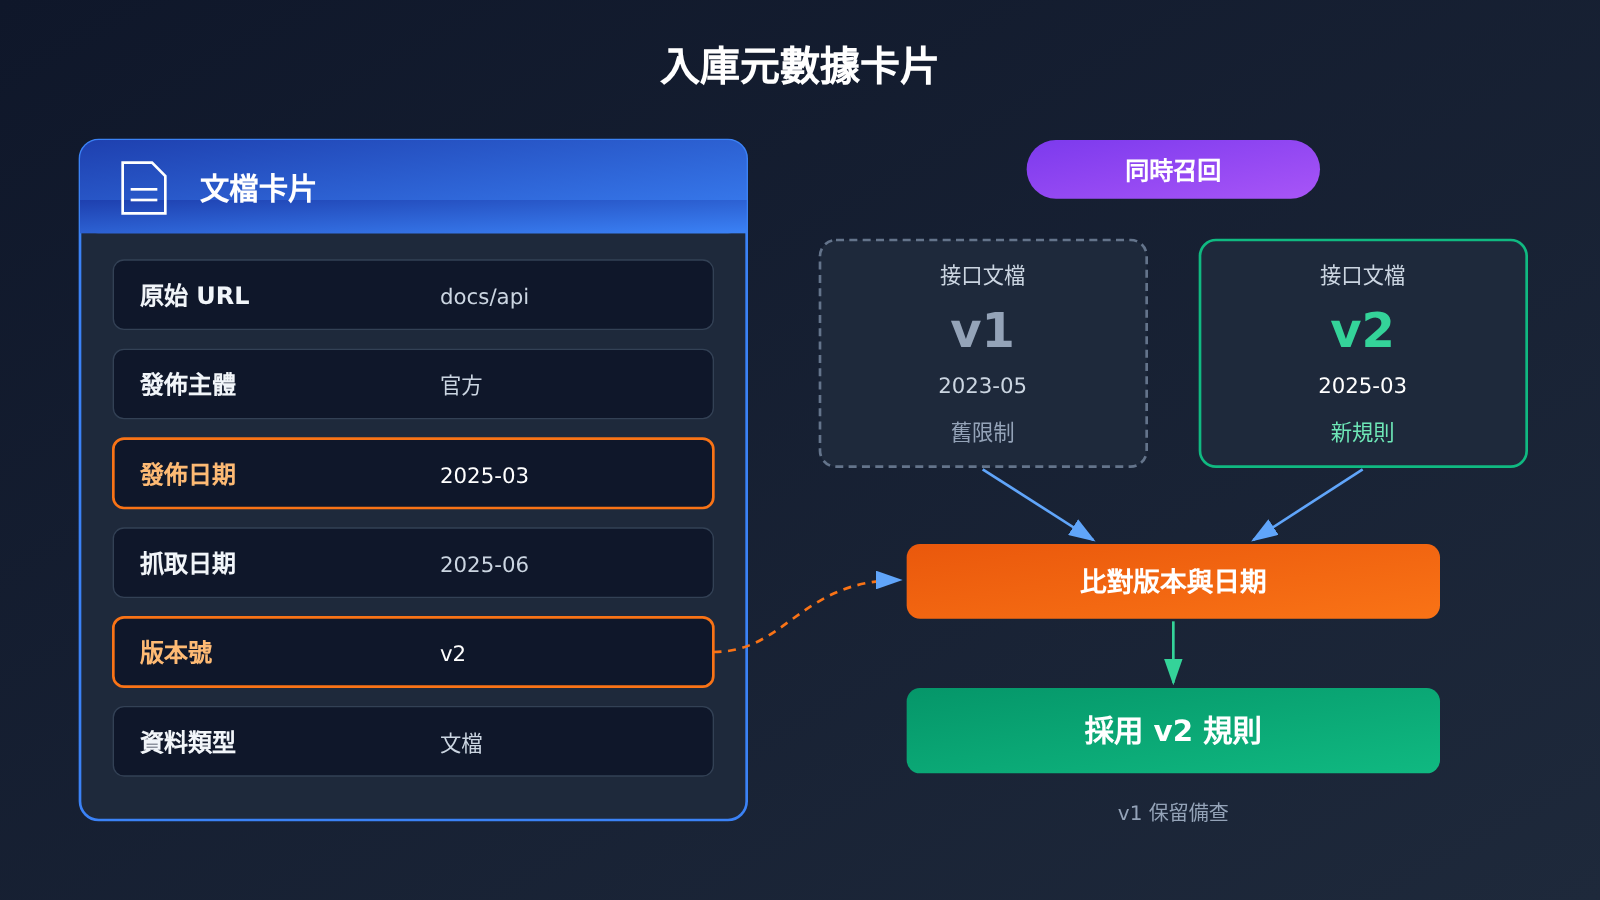
判斷四:召回數量沒有標準答案
max_num_results 調小,上下文更乾淨,成本和噪聲都更低,但可能漏掉關鍵證據。尤其是需要多份資料互相印證的主題,例如同時涉及價格、限制和版本差異時。調大則覆蓋更全,但無關片段會稀釋注意力,模型也更可能混用不同版本的信息。
比較實際的做法是按文章類型分開設置。資訊解讀類需要多來源交叉驗證,可以適當放寬。單一接口的參數說明則可以收緊。具體數值沒有通用最優解,應該結合返回的召回內容實際觀察後再調整,而不是憑感覺設定一個固定值。
需要關注的後續變化
以下幾點屬於值得觀察的方向,並非已確認的事實:File Search 是否會提供更細粒度的元數據過濾,以便直接按版本或日期篩選;刪除操作的生效延遲會不會有更明確的說明;計費方式是否調整。這些變化都會直接影響寫作系統的架構選擇,接入前建議重新查閱官方文檔和價格頁。
把 File Search 接入寫作系統,最容易出現的誤判就是“有了檢索和引用,資料問題就解決了”。實際上它讓已有資料用得更好,資料本身的新鮮度和準確性,仍然要靠採集、版本管理和審覈來保證。
問渠那得清如許?爲有源頭活水來。——朱熹《觀書有感》


