
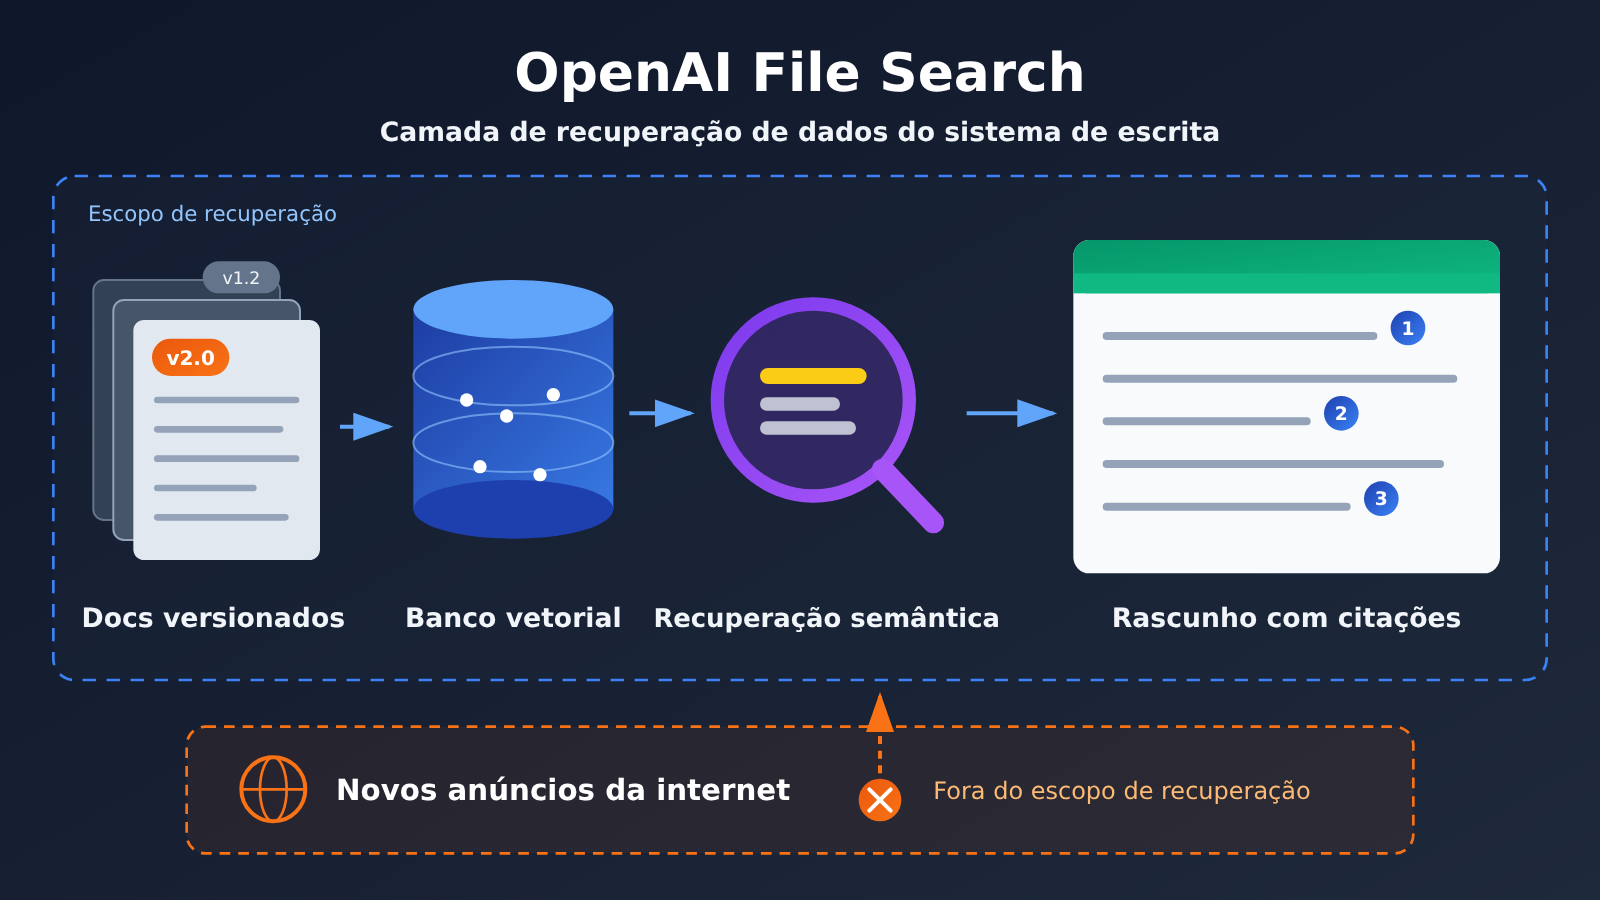
Dá para suprir uma parte, mas não tudo. O OpenAI File Search resolve o problema de “não encontrar com precisão materiais que já existem e citações pouco claras”. Ele consegue recuperar arquivos de um banco de vetores por meio de busca semântica e anexa referências aos arquivos nas respostas — algo muito útil para um sistema de escrita. O que ele não resolve é o problema de “o material em si está ausente ou desatualizado”: a ferramenta só recupera os arquivos que você já colocou ali, não sai descobrindo automaticamente novos anúncios na internet. As marcas de citação também só indicam de qual arquivo o conteúdo veio; não garantem que a conclusão esteja correta.
Então o julgamento mais preciso é este: o File Search pode funcionar como a “camada de recuperação de materiais” de um sistema de escrita, mas a coleta de materiais, o gerenciamento de versões e a auditoria de fatos ainda precisam ser feitos separadamente.
O que você vai aprender ao ler este artigo?
- O posicionamento do File Search na Responses API e quais capacidades ele pode oferecer ao fluxo de escrita
- Como ajustar a quantidade de recuperação e como fazer a resposta retornar o conteúdo efetivamente recuperado, o que facilita a investigação de problemas
- Por que um arquivo ainda pode ser recuperado por um curto período depois de excluído, e como o sistema de escrita deve lidar com isso
- Em qual camada cada um dos três tipos de problema — material ausente, falha na recuperação e erro de geração — deve ser corrigido
- Quais metadados é recomendável salvar no momento da ingestão, para evitar transformar restrições desatualizadas em regras vigentes
Índice: Antes do texto principal, explicamos alguns conceitos-chave e listamos os impactos por público. A parte de “fatos objetivos” se baseia na documentação oficial da OpenAI para organizar o modo de funcionamento do File Search, os parâmetros ajustáveis e os comportamentos conhecidos. A parte de “análise e julgamento” discute a divisão de responsabilidades depois de colocá-lo em um sistema de escrita, os caminhos para solução de problemas e as normas de ingestão, e por fim aponta alguns equívocos dos quais é preciso ficar atento.
Conceitos essenciais sobre o OpenAI File Search
| Conceito | Explicação breve |
|---|---|
| Responses API | Interface de geração de respostas da OpenAI que permite anexar ferramentas em uma única requisição; o File Search é uma delas |
| File Search | Ferramenta integrada da Responses API que recupera trechos relevantes de arquivos em um armazenamento vetorial para auxiliar na geração da resposta |
| Vector Store (armazenamento vetorial) | Armazenamento que contém os arquivos enviados e suas representações vetoriais; é nele que o File Search faz a busca |
| Busca semântica | Encontra conteúdo por similaridade de significado; trechos com palavras diferentes, mas com sentido relacionado, também podem ser encontrados |
| Citação (Citation) | Indica na resposta de qual arquivo veio determinado trecho, facilitando a verificação por leitores e revisores |
max_num_results |
Parâmetro que controla quantos resultados no máximo uma busca pode retornar |
include |
Parâmetro da requisição; ao passar file_search_call.results, a resposta inclui o conteúdo realmente recuperado |
| Consistência eventual | Operações de escrita ou exclusão não entram em vigor imediatamente em todos os lugares; por um breve período, pode-se ver o estado antigo |
Visão rápida dos impactos do OpenAI File Search
| Público | Impacto principal |
|---|---|
| Desenvolvedores de sistemas de escrita | Não precisam criar um serviço de busca próprio para obter busca semântica e citações de arquivos. Ainda assim, precisam definir padrões de ingestão e fluxos de solução de problemas |
| Editores de conteúdo / revisores | As citações facilitam a verificação, mas as conclusões ainda precisam ser conferidas uma a uma; não se deve aprovar algo só porque “tem citação” |
| Mantenedores de documentação técnica | Documentos de versões antigas e novas devem ser marcados com versão e data; caso contrário, restrições antigas podem ser recuperadas e incluídas em artigos novos |
| Responsáveis por custos | Armazenamento no armazenamento vetorial e chamadas de ferramentas são cobrados; consulte a página de preços atual da OpenAI. Com grande volume de dados, é preciso fazer uma estimativa |
Fatos objetivos sobre o OpenAI File Search
O conteúdo a seguir baseia-se em dois guias da documentação para desenvolvedores da OpenAI — File Search e Retrieval — com data de verificação em 2026-11-17. Ambos são documentos em manutenção, e este artigo não verificou a data do lançamento inicial desse recurso.
O que é o File Search: a ferramenta de recuperação dentro da Responses API
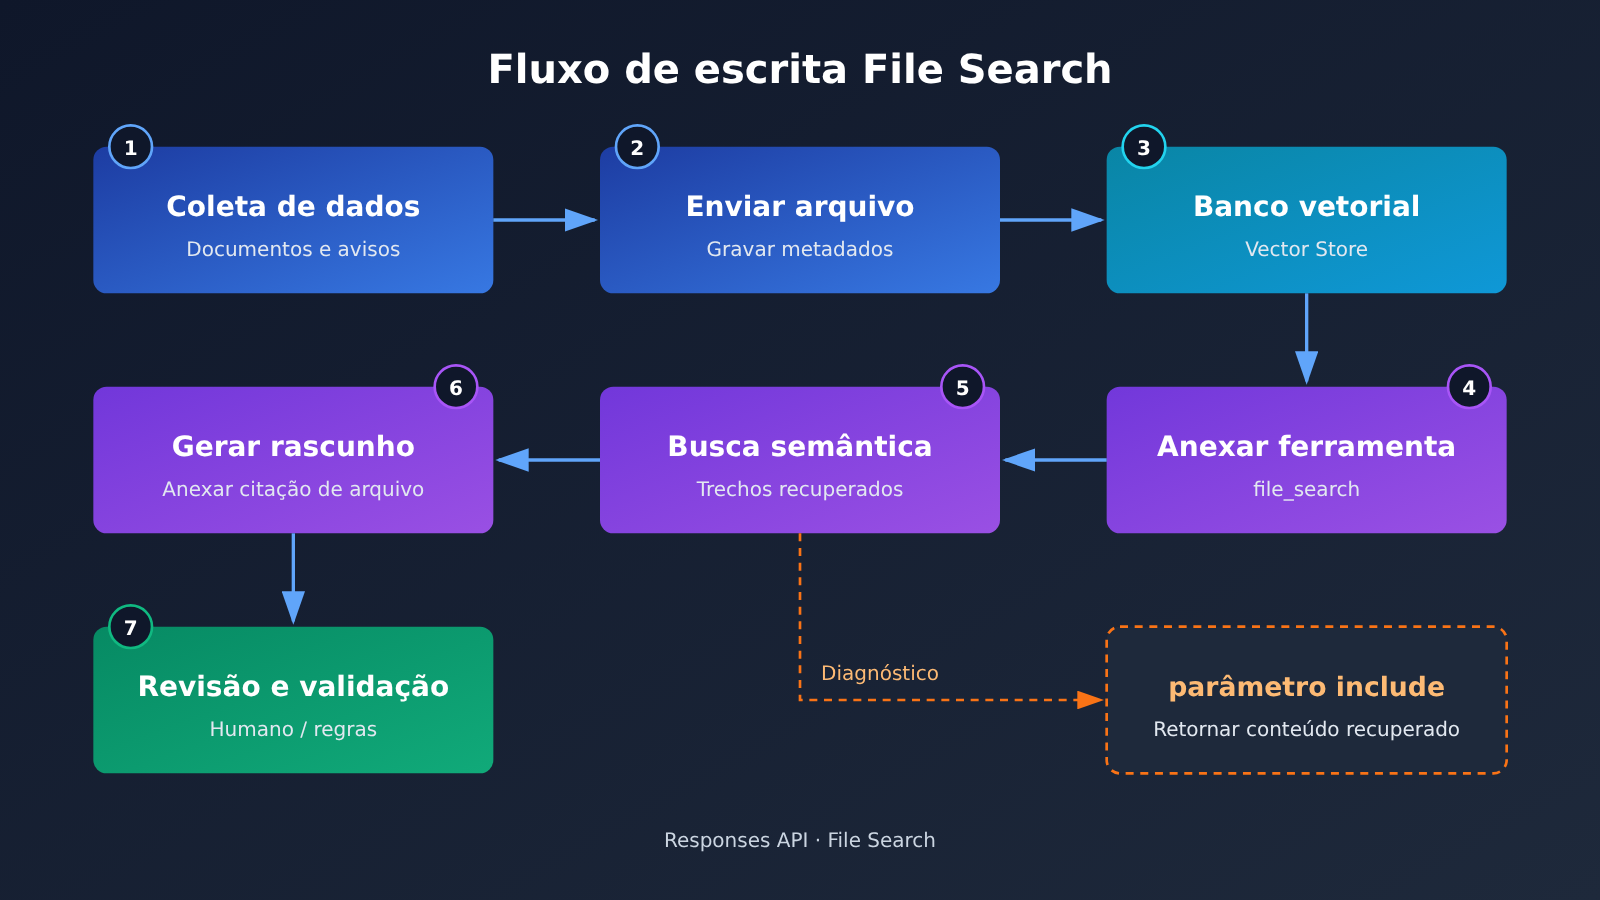
O File Search é uma ferramenta disponibilizada pela Responses API. O desenvolvedor primeiro faz o upload dos arquivos para um vector store (armazenamento vetorial) e, ao disparar a requisição, declara o File Search em tools e indica o vector store. Na hora de gerar a resposta, o modelo recupera o conteúdo relevante desses arquivos, e a resposta pode vir acompanhada de citações de arquivos, apontando de onde veio a informação.
Ele usa recuperação semântica, ou seja, consegue encontrar conteúdo que é relacionado em significado mesmo quando as palavras não batem exatamente. Por exemplo, se a consulta for “limitação de taxa da interface”, um trecho que diga “teto de frequência de requisições” também pode ser recuperado. Para um sistema de escrita, isso significa que na hora de perguntar não é preciso repetir ao pé da letra as palavras do texto original.
Parâmetros ajustáveis e controles de diagnóstico do File Search
Há dois parâmetros na documentação que têm relação mais direta com o sistema de escrita:
| Parâmetro / Comportamento | Função | Significado para o fluxo de escrita |
|---|---|---|
max_num_results |
Ajusta a quantidade de resultados retornados em uma única busca | Menos resultados economizam contexto, mas as evidências podem ficar incompletas; mais resultados ampliam a cobertura, mas também aumentam o ruído |
| Conteúdo retornado por padrão | A chamada da ferramenta por padrão não devolve os resultados completos da busca | Olhando só a resposta final, não dá para saber o que o modelo realmente leu |
include: ["file_search_call.results"] |
Faz a resposta incluir o conteúdo efetivamente recuperado | Permite distinguir “não recuperou” de “recuperou, mas escreveu errado” — indispensável para diagnóstico |
| Referência de arquivo | Anota o arquivo de origem na resposta | Facilita a verificação, mas não significa que a conclusão esteja correta |
A seguir está um exemplo mínimo de chamada, mostrando como montar o vector store, limitar a quantidade de recuperação e exigir que a resposta retorne os resultados da busca. Substitua o nome do modelo e o ID do vector store pelos seus próprios:
from openai import OpenAI

client = OpenAI()  # lê a chave da variável de ambiente OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # quantidade de recuperação: equilíbrio entre cobertura de evidências e ruído
    }],
    include=["file_search_call.results"],  # retorna o conteúdo efetivamente recuperado, facilitando o diagnóstico
)

# percorre a saída: dá para obter o texto final e também ver quais trechos foram recuperados
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Consistência eventual ao excluir arquivos no File Search
A documentação informa que a exclusão de arquivos do banco de dados vetorial segue o modelo de consistência eventual: por um tempo após a exclusão, o arquivo ainda pode ser recuperado. Portanto, não dá para afirmar publicamente que “ele fica impossível de recuperar imediatamente após a exclusão”. Se algum material precisar sair do ar por estar incorreto ou desatualizado, o sistema de escrita é aconselhável a fazer a filtragem também na própria camada, em vez de depender apenas da operação de exclusão.
O que o File Search não faz
Com base na descrição da documentação oficial e no funcionamento da própria ferramenta, alguns pontos precisam ficar claros:
- O File Search só recupera arquivos que já estão no banco de dados vetorial; não descobre automaticamente novos avisos ou atualizações de documentos na internet.
- As marcações de citação indicam de qual arquivo o conteúdo veio, mas não garantem que as conclusões tiradas desse arquivo estejam corretas.
- O armazenamento no banco vetorial e as chamadas da ferramenta são cobrados; os preços seguem a tabela publicada atualmente pela OpenAI, e este artigo não traz valores específicos.
- Este artigo não verificou se a APIYI ou outras plataformas de terceiros são compatíveis com as interfaces relacionadas ao File Search; para saber sobre o suporte, consulte as descrições oficiais de cada plataforma.
Análise e avaliação do OpenAI File Search
Consideração 1: o File Search reforça a “camada de recuperação”, não a “camada de fontes”
As lacunas de fontes em sistemas de escrita geralmente têm duas origens. Uma é ter material em mãos, mas não conseguir encontrá-lo com precisão; o modelo escreve de memória e não consegue deixar a origem clara. A outra é não ter fonte alguma, ou ter fontes desatualizadas. O File Search é muito eficaz para o primeiro caso: a recuperação semântica aumenta a flexibilidade da busca, e as referências de arquivos permitem verificar cada trecho.
Para o segundo caso, ele não consegue fazer nada. A ferramenta não sai buscando novos comunicados por conta própria; o que estiver no banco de vetores é tudo o que ela pode recuperar. Por exemplo, se o preço ou os limites de um modelo acabaram de ser ajustados, e o banco só tem documentos antigos, o File Search vai recuperar “com precisão” informações desatualizadas e ainda acompanhá-las de uma referência que parece confiável. Isso é mais perigoso do que não ter referência, porque engana mais facilmente a revisão.
Portanto, o File Search deve ser visto como uma camada dentro do sistema de escrita, e não como a solução completa para fontes. Coleta de fontes, atualização periódica e eliminação de versões antigas ainda precisam de processos separados para serem tratados.
Diagnóstico 2: usar a classificação em três categorias para localizar problemas de escrita do File Search
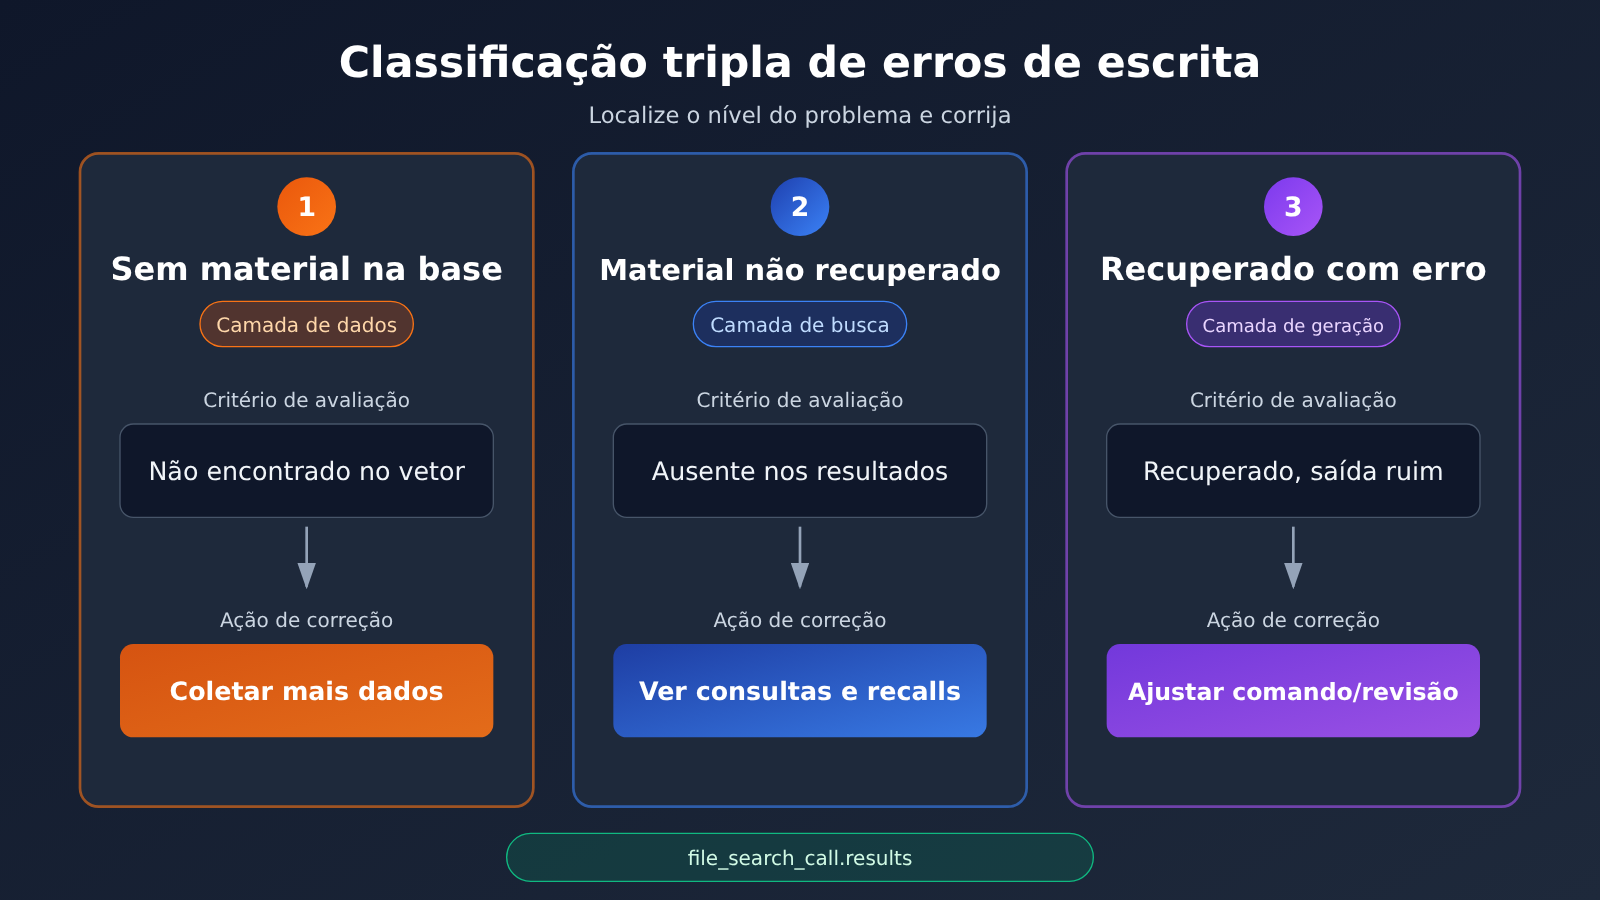
Quando um texto sai errado, o problema pode estar em três etapas diferentes. O valor de include: ["file_search_call.results"] é que ele permite, pela primeira vez, distinguir esses três tipos de problema.
| Tipo de problema | Como identificar | Direção de correção |
|---|---|---|
| Não há material na base | Não é possível encontrar arquivos relevantes na base vetorial | Complementar a coleta de material; trata-se de um problema na camada de dados |
| Há material, mas não foi recuperado | O arquivo está na base, mas não aparece em file_search_call.results |
Ajustar a formulação da consulta, dividir a pergunta ou aumentar adequadamente max_num_results |
| Foi recuperado, mas o texto saiu errado | O resultado da recuperação está correto, mas o texto final não corresponde a ele | Alterar o comando de geração e as regras de revisão; trata-se de um problema na camada de geração |
Se nenhum conteúdo de recuperação for retornado, a equipe muitas vezes só consegue dizer de forma genérica que “a IA inventou de novo” e então vai alterar o comando. Muitas vezes, a causa real é que a base não tem esse material ou que a consulta não o encontrou. Identificar primeiro em qual camada está o problema antes de agir economiza bastante retrabalho.
Critério 3: os metadados de indexação no OpenAI File Search definem o teto de qualidade da escrita
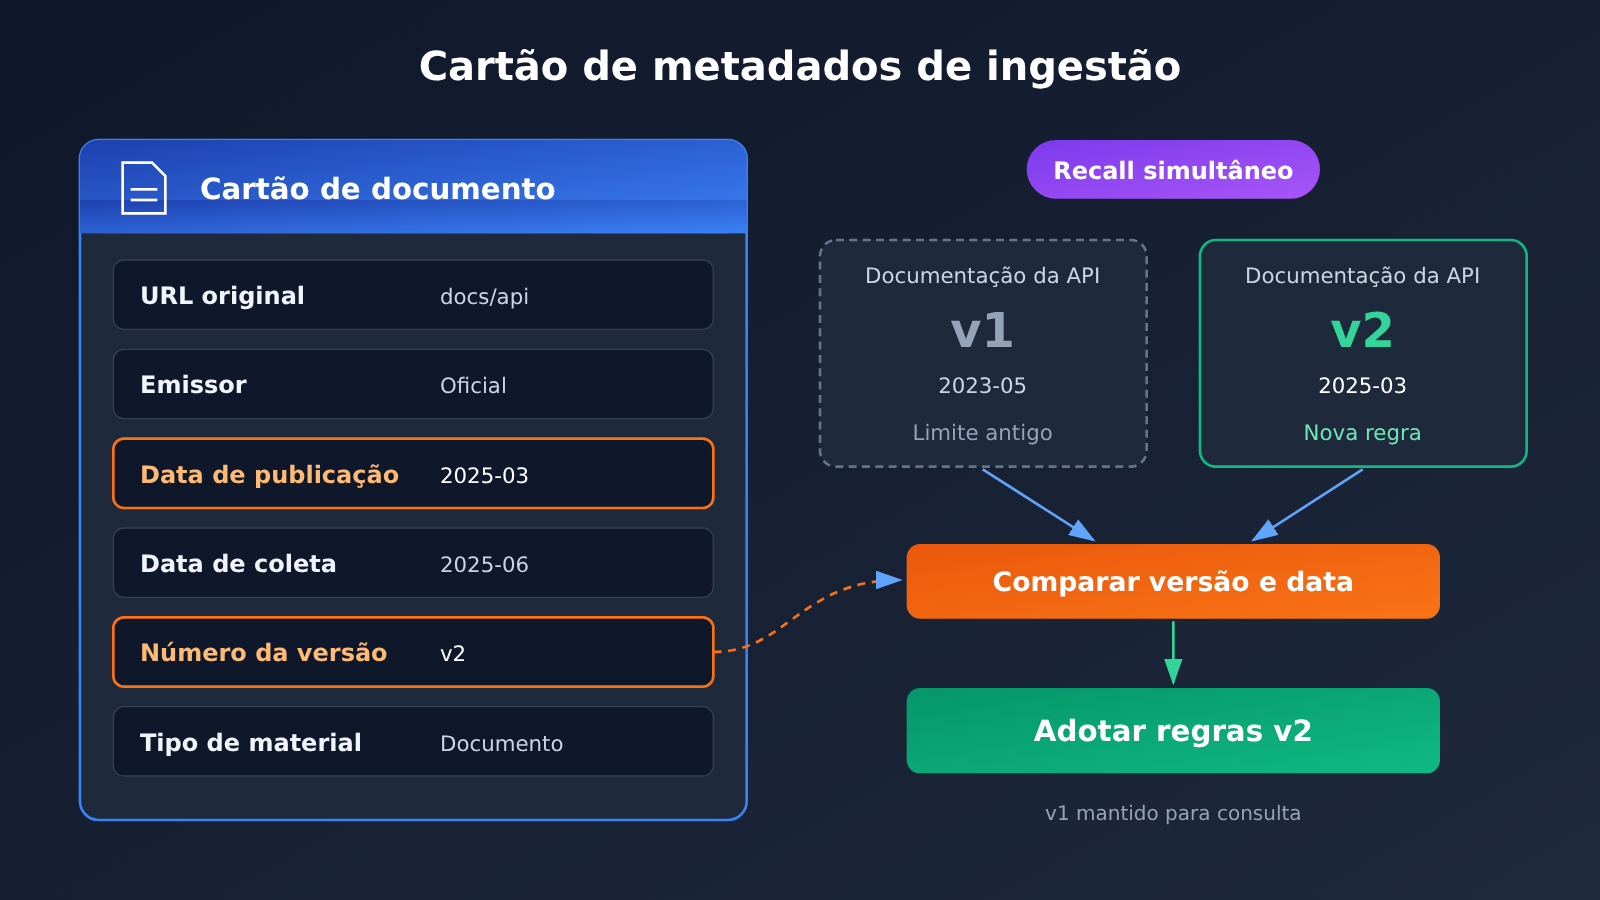
A busca só consegue retornar o que está na base, e a qualidade do conteúdo da base depende do que foi registrado no momento da indexação. Para um sistema de escrita, apenas enviar o corpo do arquivo não é suficiente; recomenda-se que cada material traga pelo menos as seguintes informações:
| Campo de metadados | Finalidade |
|---|---|
| URL de origem | Facilita voltar à fonte para verificar e também permite listar nos materiais de referência |
| Entidade publicadora | Distinguir declarações oficiais, interpretações de terceiros e boatos da comunidade |
| Data de publicação | Avaliar se a informação ainda é válida |
| Data de coleta | Avaliar há quanto tempo o material não é atualizado |
| Número da versão | Evitar tratar restrições antigas como regras vigentes quando documentos novos e antigos coexistem |
| Tipo de material | Distinguir anúncios, documentação, blogs e posts de fórum, para definir a confiabilidade |
A informação de versão é a que mais facilmente passa despercebida. Documentos novos e antigos da mesma interface podem estar ambos na base e, semanticamente, muito parecidos, podendo ser recuperados ao mesmo tempo na busca. Sem versão e data, o modelo tem dificuldade de julgar qual restrição já foi revogada. Manter a informação de versão é mais seguro do que simplesmente apagar os documentos antigos: por um lado, ainda é útil ao escrever comparações históricas; por outro, a exclusão em si também é eventualmente consistente — apagar não significa que some imediatamente.
Critério quatro: não existe resposta padrão para a quantidade de resultados recuperados
Diminuir o max_num_results deixa o contexto mais limpo e reduz custo e ruído, mas pode deixar passar evidências decisivas — especialmente em temas que dependem de várias fontes se confirmando mutuamente, como quando envolvem ao mesmo tempo preço, limites e diferenças de versão. Aumentar demais cobre mais, mas trechos irrelevantes diluem a atenção e o modelo fica mais propenso a misturar informações de versões diferentes.
A abordagem mais prática é definir valores separados por tipo de artigo. Conteúdos de análise de notícias precisam de validação cruzada entre múltiplas fontes, então dá para afrouxar um pouco. Já uma documentação de parâmetro de uma única interface pode ser mais enxuta. Não existe um número universalmente ótimo: o ideal é ajustar observando de fato o conteúdo recuperado, em vez de fixar um valor no chute.
Mudanças futuras que vale acompanhar
Os pontos abaixo são direções que merecem observação, não fatos já confirmados: se o File Search vai oferecer filtragem de metadados mais granular, permitindo filtrar diretamente por versão ou data; se o atraso para as operações de exclusão entrarem em vigor terá uma explicação mais clara; se a forma de cobrança será ajustada. Todas essas mudanças afetam diretamente as escolhas de arquitetura do sistema de escrita, então vale reconsultar a documentação oficial e a página de preços antes de integrar.
Ao integrar o File Search a um sistema de escrita, o erro de julgamento mais comum é achar que “com recuperação e citação, o problema dos materiais está resolvido”. Na prática, ele faz com que os materiais existentes sejam mais bem aproveitados; a atualidade e a precisão dos próprios materiais continuam dependendo de coleta, gestão de versões e revisão.
Por que o rio é tão límpido? Porque a água viva vem da fonte. — Zhu Xi, “Lendo com Sentimento”


