
著者注:Code Arena WebDev ランキング 6 位の Qwen4-Max を読み解きます。上位 6 の構図、中国国産モデル同士の差、トップモデルとのスコア差、そして票数と 1 タスクあたりのコストの正しい読み方です。
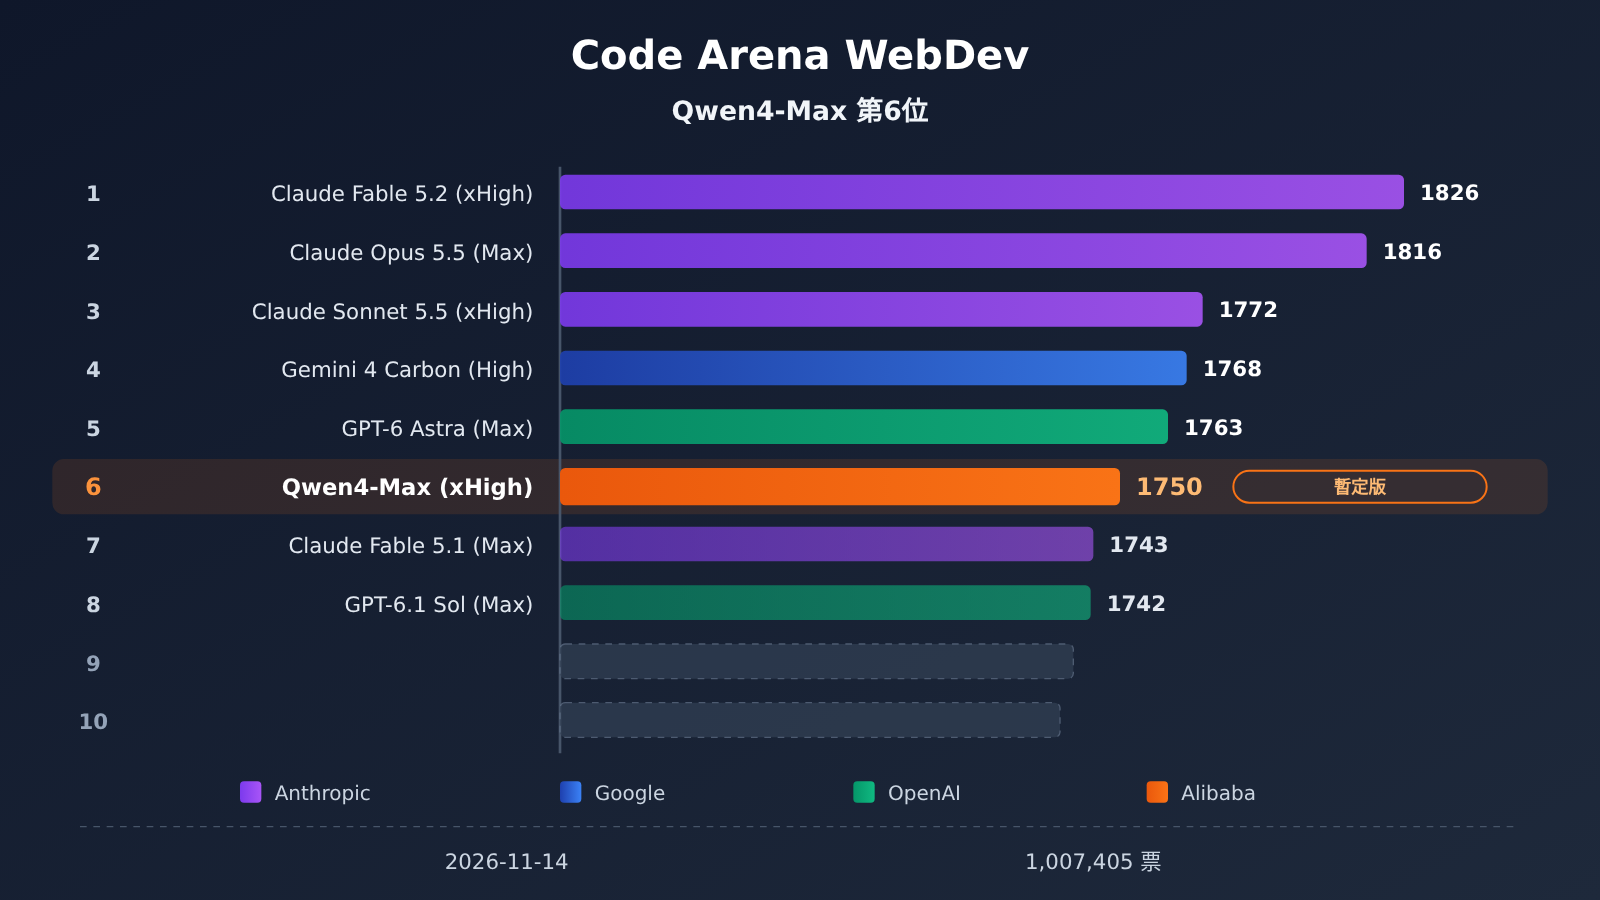
まず結論から。arena.ai の Code Arena WebDev ランキング(Overall カテゴリ、ページ上の表記は 2026-11-14)では、Qwen4-Max(xHigh)が 1750 点で 6 位に入っています。中国国産モデルがこのランキングの上位 6 に入ったのは初めてで、上位 6 の中でアメリカの研究所以外のモデルはこれだけです。
これは 6 位を 1 位に仕立て上げる宣伝稿ではありません。 Qwen4-Max にはランキング上で Preliminary のマークが付いており、票数はわずか 1,814 票で、順位はまだ変動します。Alibaba が公開した同じ公式図の中でも、Terminal-Bench と ProgramBench では Opus 5.5 と GPT-6 Astra にまだ明確に劣っています。
本記事の核心的価値:この記事を読み終えれば、自分で開いて照合できるランキングのメタデータが手に入り、Qwen4-Max の 6 位をどう使うべきか、どう使うべきでないかが分かります。
Qwen4-Max Code Arena WebDev 第6位の核心ポイント
順位を議論する前に、まずランキングのメタデータを確認しておきましょう。「何位」という主張は、日付・票数・参加モデル数を先に照合しなければ、その順位が妥当かどうかを判断するのは難しくなります。
| 要点 | データ(同じランキングの公開データ) | どう読むか |
|---|---|---|
| ランキングと分類 | arena.ai Code Arena WebDev、Overall | あくまでWeb開発カテゴリのブラインドテストにおける選好を表す |
| ページの日付 | 2026-11-14 | 順位は投票に応じて継続的に変化する |
| 総票数 / モデル数 | 1,007,405票 / 159モデル | サンプル数は大きいものの、モデルごとの票数差は非常に大きい |
| Qwen4-Max の順位とスコア | 6位、1750点 | 上位6位で唯一の非米国ラボ製モデル |
| Qwen4-Max の票数とフラグ | 1,814票、Preliminary | まだ予備評価の段階にある |
| 1タスク当たりのコスト P50 | $4.18 | ランキング上の統計による中央値であり、モデルの単価ではない |
Qwen4-Max のランキング基準を詳しく見る
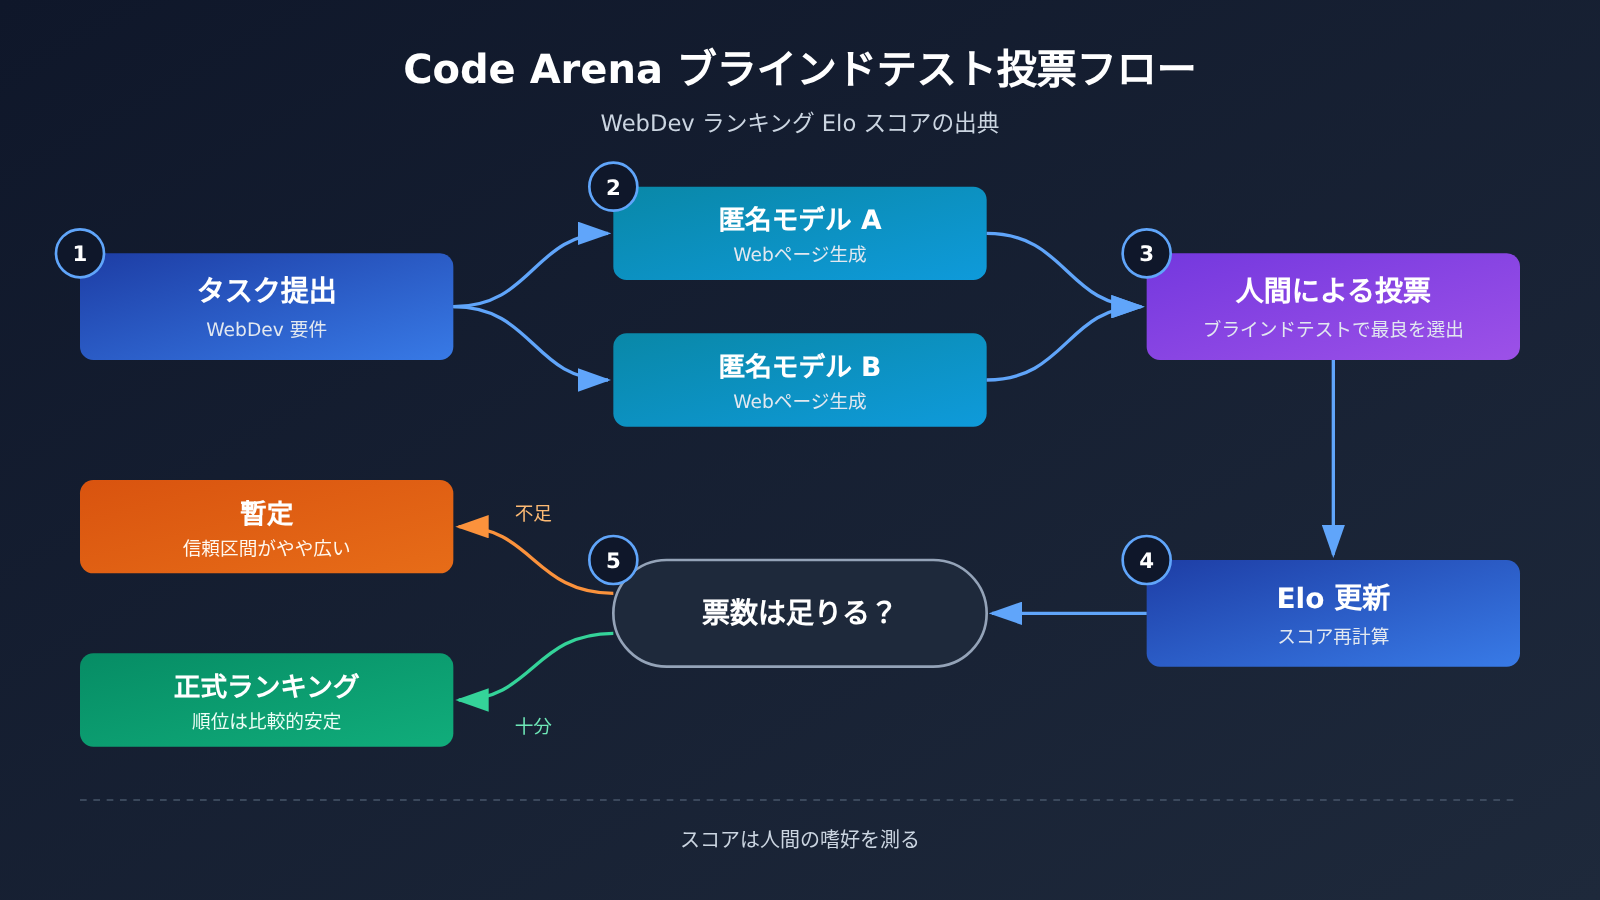
Code Arena の Elo スコアは、ブラインドテストによる人手投票から算出されます。ユーザーが同一のWeb開発タスクを提示し、匿名化された2つのモデルの出力を見て、より良い方を投票します。スコアが反映するのは「人間の評価者が見て、どちらのWebページの方がより良いか」という選好であり、総合的な生産性スコアではありません。
Preliminary フラグの意味も理解しておく必要があります。これは、そのモデルが対戦に参加した回数がまだ十分ではなく、信頼区間が広いことを示しています。同じランキングで4位の Gemini 4 Carbon (High) にもこのフラグが付いているため、4位から6位の範囲で今後数週間のうちに順位が入れ替わっても不思議ではありません。
Code Arena WebDev のトップ6は誰か:Qwen4-Max の競争構図
トップ10をすべて並べると、Qwen4-Max がどの位置にいるのかがより直感的に見えてきます。上位5位はアメリカの3つのラボが独占しており、そのうち Anthropic だけで3席を占めています。
| 順位 | モデル | スコア | 所属ラボ | 備考 |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | 首位 |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | 単タスクあたり P50 $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminary | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | 単タスクあたり P50 $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Preliminary、1,814票 |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
上位5位の構図が Qwen4-Max にとって意味するもの
トップ6のうち Anthropic が3席(Fable 5.2、Opus 5.5、Sonnet 5.5)、Google と OpenAI が各1席、Alibaba が1席となっています。つまり Qwen4-Max は、緩いランキングの中でたまたま順位を拾ったのではなく、3つのトップラボのフラッグシップモデルの間に「割り込んで」一つの位置を確保しているのです。
もう一つ注目すべき点は、6位から8位が非常に密集していることです。1750、1743、1742 と、3者の差は10ポイント未満です。Qwen4-Max が Claude Fable 5.1 と GPT-6.1 Sol をリードしている幅は、GPT-6 Astra に13ポイント遅れている幅よりも小さいのです。順位の安定性については、投票数が増えてから判断する必要があります。
Qwen4-Max の国産モデル界での位置づけ
国産陣営だけを見ると、Qwen4-Max のリードはかなり明確です。国産モデルの中で唯一トップ10に入っており、2位のモデルは13位まで登場しません。
| 国産順位 | モデル | スコア | ランキング順位 | Qwen4-Max との差 |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 第 6 | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 第 13 | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 第 16 | −74 |
| 4 | Qwen3.8-Max | 1670 | 第 18 | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 第 18 | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 第 19 | −89 |
| 7 | Kimi K3 (Max) | 1658 | 第 20 | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 第 26 | −111 |
| 9 | Hy4 preview | 1632 | 第 27 | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 第 31 | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 第 33 | −129 |
国産モデル内の差が持つ2つの意味
1つ目は世代間の飛躍です。Qwen4-Max は自社の前世代にあたる Qwen3.8-Max(0902)より 74 ポイント高く、順位は 16 位から 6 位へとジャンプしました。同じランキング、同じ投票メカニズムの下で、この上昇幅はかなり目を見張るものがあります。
2つ目は国産2位との距離です。Qwen4-Max は Kimi K3.1 Pro より 64 ポイント高く、この差は Opus 5.5 に 66 ポイント劣っていることとほぼ同じです。つまり、Qwen4-Max は現在、国産陣営と世界トップとの間の中間地点に位置しています。下を見れば国産のライバルを引き離し、上を見れば首位までまだ距離がある、という状況です。
1点注意しておきたいのは、国産の 2 位から 7 位が 1686 から 1658 の間にひしめいており、スコア差がごく小さいことです。このランキングでこの数社の優劣をつけるのは、あまり意味がありません。
Qwen4-Max は世界のトップとどれだけ差があるのか
Code Arena WebDev でのスコア差
Qwen4-Max とトップモデルとのスコア差を並べ、一般的な Elo 式(400点尺度)で「対戦勝率」をざっくり推定すると、これらの差が実際に何を意味するのかを理解しやすくなります。arena の具体的な統計手法は標準 Elo と異なる可能性があるため、以下の勝率は直感的な参考値としてのみ扱ってください。
- 第5位 GPT-6 Astra との比較:1750 対 1763、13点差、推定対戦勝率は約48%で、ほぼ互角です。
- 第2位 Opus 5.5 との比較:66点差、推定対戦勝率は約41%。
- 第1位 Fable 5.2 との比較:76点差、推定対戦勝率は約39%。
- 中国勢2位の Kimi K3.1 Pro との比較:64点リード、推定対戦勝率は約59%。
ランキング全体のスコア範囲は 1071〜1826 です。この尺度では、Qwen4-Max と首位の 76 点差はそれほど大きくありませんが、ウェブ開発の好みにおいては、Anthropic のトップモデルが依然として評価者から支持されていることも示しています。
同図のその他のベンチマーク:Elo が高いからといってターミナルタスクに強いわけではない
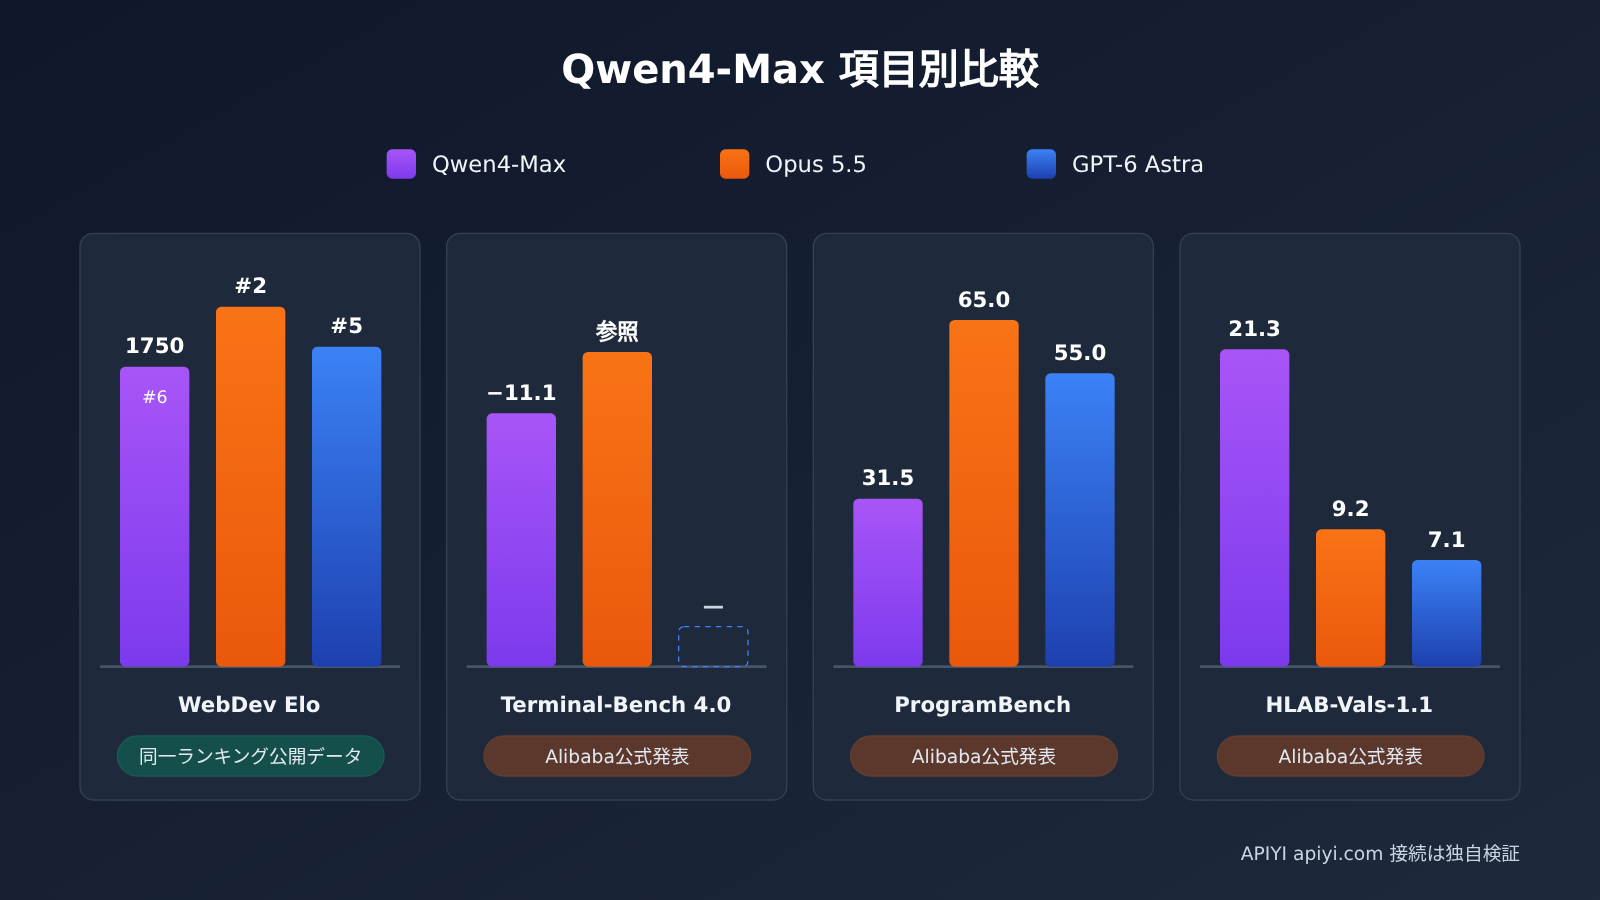
Alibaba が Qwen4-Max を発表した際に用いたのは、複数ベンチマークを1枚の図にまとめたものです。以下のデータはすべてAlibaba 公式の自己申告であり、arena ランキングのデータでも、第三者による再現結果でもありません。
| ベンチマーク(公式自己申告) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | その他 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
この表から重要なことが分かります。Qwen4-Max はウェブ開発のブラインドテストでは高スコアですが、ターミナル操作系やエンジニアリングプログラミング系のベンチマークでは依然として差が顕著です。Terminal-Bench 4.0 では Opus 5.5 より 11.1 点低く、図中の Kimi モデルの 67.2 はさらに高い値です。ProgramBench では、その 31.5 は Opus 5.5 の半分にも満たありません。
一方で、明確にリードしている項目もあります。HLAB-Vals-1.1 で Qwen4-Max は 21.3 を記録し、Opus 5.5 の 9.2 や GPT-6 Astra の 7.1 を大きく上回っています。AA-Briefcase でも GPT-6 Astra を上回っています。したがってより正確に言えば、Qwen4-Max は能力の分布がトップモデルと異なるのであって、「全般的に接近している」わけではありません。
Qwen4-Max の投票数とコストの読み方
投票数:1,814票が意味するもの
順位が定着するかどうかは、投票数に大きく左右されます。Qwen4-Max の1,814票は、総投票数約100万票のうち0.2%未満にすぎず、同じランキングの複数の中国製モデルと比べてもかなり少ないです。
| モデル | 順位 | 投票数 | タスクあたりコスト P50 | ステータス |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6位 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 13位 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 16位 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 2位 | 同ランキングの公開データ | $8.99 | — |
| GPT-6 Astra (Max) | 5位 | 同ランキングの公開データ | $9.43 | — |
Qwen3.8-Max の投票数は Qwen4-Max の約12.7倍で、そのスコアはより「安定値」に近いと言えます。Qwen4-Max の1750点は現時点では初期の読み取り値に近く、今後上方修正も下方修正もあり得ます。この順位を引用する際は、「Preliminary、1,814票、2026-11-14」という3つの条件を併記するのが望ましいです。
単一タスクコスト P50:モデルの単価ではない
ランキング上の「単一タスクコスト P50」とは、そのランキングのタスクにおいて、1回のタスクにかかる費用の中央値を指します。これはモデルの出力長や推論強度の設定(xHigh、Max など)に大きく左右されるため、モデルの100万トークンあたりの単価として比較することはできません。
この基準で見ると、Qwen4-Max の $4.18 は Opus 5.5($8.99)の約46%、GPT-6 Astra($9.43)の約44%に相当します。一方で、Kimi K3.1 Pro($0.89)の約4.7倍、前世代の Qwen3.8-Max($1.91)の約2.2倍でもあります。単一タスクのコストが重要なシーンであれば、Kimi K3.1 Pro が約5分の1のコストで1686点を獲得している点も、評価の対象として検討に値します。
Qwen4-Max の公式価格と APIYI の現在価格
以下は100万トークンあたりの価格です(取得日:2026-11-16)。
- Qwen4-Max 公式価格:入力 $1.5、出力 $4.5、キャッシュ読み取り $0.075。
- APIYI で販売中の Qwen フラッグシップ
qwen3.8-max:入力 $1.65、出力 $4.95、キャッシュ読み取り $0.20625。
なお、APIYI では現在 qwen4-max をまだ取り扱っていませんが、できるだけ早くラインナップに追加する予定です。両者は異なるモデルであるため、上記の価格をそのまま横並びで比較することはできません。実際に利用可能なモデルと価格については、APIYI apiyi.com プラットフォームのモデル一覧をご参照ください。
ランキング再確認・価格照合・接続先変更の3ステップ
ランキングを一通り読んだ後、開発者は通常3つのことを行います。順位を確認し、価格を確認し、モデルを自分のプロジェクトに接続して試す、という流れです。以下の順番で進めるのがおすすめです。
- ランキングを再確認する:arena.ai の Code Arena WebDev ページを開き、日付、投票数、Preliminary マークに変化がないか確認します。
- 価格を照合する:APIYI(apiyi.com)のモデル一覧で、現在販売中の Qwen モデルとリアルタイム価格を確認し、
qwen4-maxがすでに掲載されているかを見ます。 - 接続先を変更する:既存の OpenAI 互換 SDK で、base_url を
https://api.apiyi.com/v1に変更し、モデル ID はまずqwen3.8-maxを設定します。新しいモデルが掲載されたらqwen4-maxに切り替えて比較します。
🚀 すぐに試すためのヒント:自分の WebDev タスクで Qwen シリーズと Claude、GPT、Gemini の差を検証したい場合は、APIYI(apiyi.com)を使えば1つの APIキーで複数社のモデルをまとめて呼び出せます。新規ユーザーには無料のテスト枠があるので、まず小規模なサンプルをまとめて試してからモデル選定を決めるのに向いています。
Qwen4-Max の長所と短所の分析
Qwen4-Max の強み
- Web開発の選好スコアで中国国産モデルをリード:1750点。中国国産モデルの2位より64点高く、前世代より74点高いです。
- トップ層との差は一部ですでにかなり小さい:5位の GPT-6 Astra とはわずか13点差で、7位・8位とはほぼ並んでいます。
- タスクあたりのコストがトップ級フラッグシップより低い:P50 は $4.18 で、Opus 5.5 と GPT-6 Astra の半分未満です。
- 一部のベンチマークでは独自の強みがある:HLAB-Vals-1.1 の公式自己申告スコアは、Opus 5.5 や GPT-6 Astra を明確に上回っています。
Qwen4-Max の限界
- 順位はまだ安定していない:Preliminary マークが付いており、票数は1,814票なので、引用時には条件を明記する必要があります。
- ターミナル系・エンジニアリング系のコーディングベンチマークでは後れ:Terminal-Bench 4.0 と ProgramBench では Opus 5.5 や GPT-6 Astra を明確に下回っており、Agent やコマンドライン自動化を行う場合は別途評価が必要です。
- タスクあたりのコストは一部の中国国産モデルより高い:Kimi K3.1 Pro や Qwen3.8-Max よりかなり高く、コストに敏感な場面では必ずしも割安とは言えません。
Code Arena WebDev ランキングだけで判断すべきでないケース
主な用途がターミナル操作、長い一連のコード修正、多段階の Agent タスクである場合、WebDev Elo だけを見ると Qwen4-Max の実際の性能を過大評価してしまいます。このようなときは Terminal-Bench などのベンチマークのほうがニーズに近いです。同様に、予算が厳格な制約である場合は、順位だけを追うのではなく、タスクあたりのコストとスコアを合わせて見るべきです。このランキングが最も適切に答えるのは、「人間のレビュアーの目に、誰がより良い Webページを作るか」という問いです。
よくある質問(FAQ)
Q1: Qwen4-Max の Code Arena WebDev ランキング 6 位は実際の順位ですか?
ランキングページに表示されている実際の順位です(2026-11-14、Overall 分類、1750 点)。ただし Preliminary マークが付いており、票数はわずか 1,814 票のため、今後の順位は変動する可能性があります。引用する際はこうした条件も併記することをおすすめします。
Q2: Qwen4-Max と GPT-6 Astra、Opus 5.5 ではどのくらい差がありますか?
Code Arena WebDev では、Qwen4-Max は GPT-6 Astra より 13 点低く、Opus 5.5 より 66 点低く、首位の Fable 5.2 より 76 点低くなっています。一方、Alibaba 公式が自己申告した Terminal-Bench 4.0 と ProgramBench では、これら 2 モデルとの差は明らかに大きくなります。
Q3: Qwen4-Max は国産モデルの中でどのくらいリードしていますか?
トップ10に入った唯一の国産モデルであり、国産 2 位の Kimi K3.1 Pro(13 位、1686 点)より 64 点高く、自社の前世代である Qwen3.8-Max(0902)より 74 点高くなっています。
Q4: Qwen4-Max はどんな場面に最も適していますか?
このランキングの評価基準から見ると、Web ページのフロントエンド生成やランディングページ、インタラクティブプロトタイプといった WebDev タスクに適しています。ターミナル自動化や大規模なエンジニアリングレベルのコード変更などの場面では、ターミナル系ベンチマークを参照し、ご自身でサンプルを走らせて検証することをおすすめします。
Q5: API 経由で Qwen シリーズのモデルを呼び出して比較テストするには?
APIYI apiyi.com で登録して APIキーを取得し、OpenAI 互換 SDK で base_url を `https://api.apiyi.com/v1` に設定、モデル ID に `qwen3.8-max` を指定します。`qwen4-max` は現在まだ未上架ですが、できるだけ早く上架する予定です。上架後はモデル ID を変更するだけで比較対象を切り替えられます。
Q6: 単一タスクのコスト $4.18 は Qwen4-Max の価格ですか?
いいえ。$4.18 はランキングで集計された単一タスクあたりのコスト中央値(P50)で、出力長や推論ティアの影響を受けます。モデルの単価は 1M tokens あたりの入力・出力・キャッシュ読み取り価格で判断してください。最新価格は APIYI apiyi.com のモデル一覧で確認できます。
Qwen4-Max Code Arena WebDev の主なポイント
- 順位:2026-11-14 のランキングで6位、1750点。中国製モデルとして初のトップ6入りです。
- 勢力図:上位5位は Anthropic が3枠、Google が1枠、OpenAI が1枠を占めています。
- 安定性:Preliminary(暫定)表示付きで1,814票を獲得。順位は今後変動する可能性があります。
- 中国モデルとの差:Kimi K3.1 Pro を64点上回り、前世代を74点上回っています。
- 能力の範囲:Terminal-Bench と ProgramBench では、公式の自己申告値でも依然としてトップ勢に後れを取っています。
- コストの見方:P50 $4.18 は1タスクあたりの中央値であり、モデル自体の単価ではありません。
- 試し方:まずは APIYI で
qwen3.8-maxを使い、比較用のワークフローを組んでおき、新しいモデルが公開されたら切り替えるのがおすすめです。
まとめ
Qwen4-Max の Code Arena WebDev ランキングでの評価は、次の3点に集約できます。
- 初のトップ6入り:1750点で、トップ6の中で唯一の非米国ラボのモデル。5位とはわずか13点差です。
- 順位はまだ早期の読み値:Preliminary 表示、1,814票。引用する際は日付と票数を明記しましょう。
- Elo は総合力の高さを意味しない:公式に自己申告されたターミナル系およびエンジニアリング向けプログラミングのベンチマークでは、Opus 5.5 と GPT-6 Astra に依然として後れを取っています。
選定を進めている場合は、このランキングを「Web開発における好み」を測る参考軸のひとつとして捉え、自分のタスクサンプルやコスト予算と組み合わせて判断するのがよいでしょう。APIYI(apiyi.com)経由の統一インターフェースで候補モデルを同じタスク群に投入して比較し、自分のデータで結論を出すことをおすすめします。
📚 参考資料
- arena.ai Code Arena WebDev ランキング:本記事の順位・スコア・票数・タスク単価の出典
- リンク:
arena.ai -
説明: ページには 2026-11-14、Overall カテゴリと記載されています。最新の順位と Preliminary マークはご自身で確認できます
-
Alibaba Qwen4-Max 公式リリース画像:Terminal-Bench 4.0、ProgramBench などのベンチマークスコアの出典
- リンク: Qwen の公式発表チャネルを参照してください
- 説明: 記事中の関連データはすべて公式による自己申告であり、第三者による再現ではありません
作者: APIYI 技術チーム
技術交流: APIYI サイトのトップページからお気軽にお問い合わせください。モデルの掲載や接続方法については、docs.apiyi.com のドキュメントセンターをご覧ください


