
著者注:マルチプロジェクトの Agent には、独立したコンテキスト、永続的な状態、タスクスケジューリング、復旧メカニズムが必要です。並行して作業を進めるからこそ、追跡可能で互いに干渉しない仕組みが実現できます。
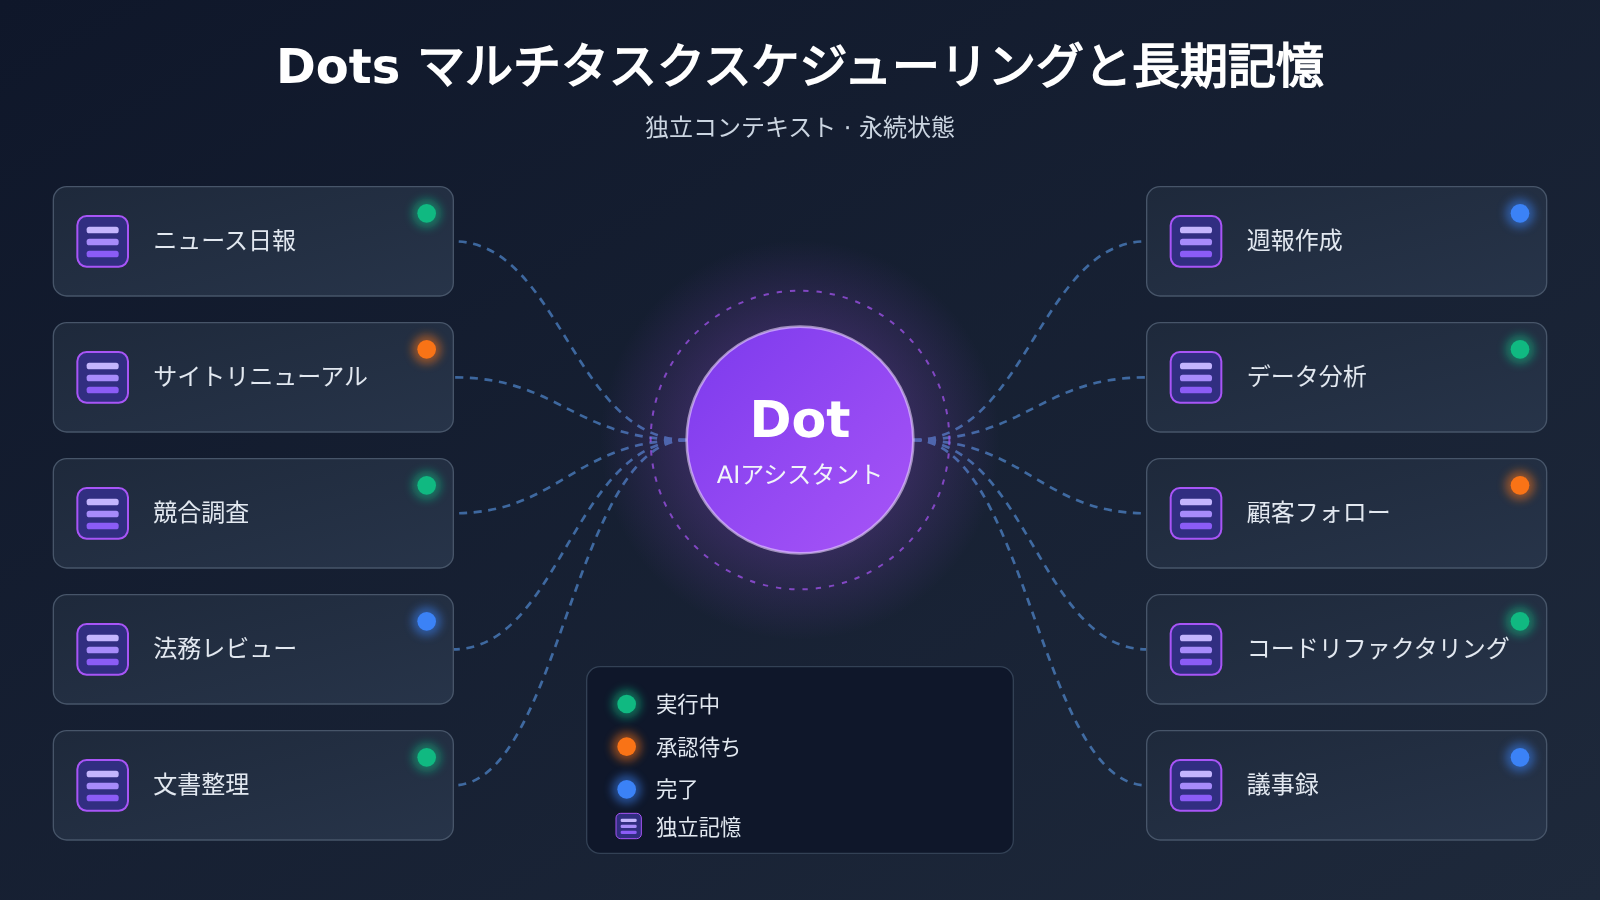
AI アシスタントが複数のプロジェクトを同時に進められるかどうかは、4つのポイントにかかっています。各作業に独立したコンテキストがあること、実行状態が永続的に保存されること、スケジューラが優先度と並行数を統一的に管理すること、中断後にチェックポイントから復旧できることです。複数のモデルを同時に呼び出すこと自体は難しくありません。難しいのは、それぞれの呼び出しが自分は何をしているのかを覚えていることです。OpenAI が 2026 年 9 月 29 日に公開した Dots は、このパターンを採用しています。公式ドキュメントによれば、1つの Dot は複数の責務項目を維持でき、作業をバックグラウンド Agent に分割して並行処理させられます。新しいタスクはそれぞれ独自の会話コンテキストを持ち、ユーザーと Dot のすべての履歴会話を自動的に引き継ぐことはありません。開発者は Checkpointer、Store、タスクキュー、ステートマシンを使って、同様のマルチプロジェクト管理システムを構築できます。
以下ではまず公式資料に基づいて Dots のマルチタスクと記憶のメカニズムを分解し、そのうえで全文を通じたプロジェクト管理の例を使って、4層のタスク構造、並行スケジューリング、中断からの復旧、実行追跡、コスト境界を順に設計していきます。タイトルにある「10のプロジェクト」はあくまで作業モードを表す例示的な表現であり、Dots も自前で構築するシステムも固定の10並列を持つわけではなく、無限に並行できるわけでもありません。文中の自前 Agent のコードは設計案に属するもので、架空の実行結果は添付していません。
To Know:Dots のマルチタスクスケジューリング関連用語
| 用語 | 説明 |
|---|---|
| Workspace | プロジェクトと権限をまとめるワークスペースで、通常は1人のユーザーまたは1つのチームに対応します。 |
| Project | プロジェクトの単位で、目標・資料・関連タスクを含みます。 |
| Task | 明確な目標を持つ作業のこと。たとえば「今日のOpenAIニュースを検索する」などが該当します。 |
| Run | タスクの1回の実際の実行記録です。同じTaskは何度でも実行できます。 |
| バックグラウンドAgent | Dotが並列でサブタスクを処理するために送り出す実行者で、完了後にDotへ報告します。 |
| Checkpointer | タスク実行のチェックポイントを保存するコンポーネントで、中断後の復元を担当します。 |
| Store | タスクをまたいだ長期的な情報を保存するストレージコンポーネントで、プロジェクトの背景を継続的に引き継ぎます。 |
| 状態マシン | ルールに従ってタスクの各段階の遷移を管理する仕組みです。待機中・実行中・承認待ちなどを扱います。 |
| 同時実行制限 | 同時に実行できるタスク数の上限で、APIの割り当て、サーバーリソース、コストによって制約されます。 |
| Tracing | モデル呼び出し、ツール呼び出し、引き継ぎの過程を記録する追跡機能です。 |
| Proactive Research | Dotsが新しいメッセージがないときに、認可済みの資料ソースに対して行う読み取り専用のバックグラウンド調査です。 |
1 Dots のマルチタスク・オーケストレーション:1つの Dot がなぜ複数の責務を同時に担えるのか
1.1 Dots が公式に示すマルチプロジェクト対応能力
公式の位置づけによれば、Dots は常駐型のパーソナル Agent です。独自のクラウドコンピュータとブラウザを持ち、ユーザーが離れた後も委任された作業を推進し続けられます。マルチタスクの面では、Tasks and memory のドキュメントに次の能力が挙げられています:
- 複数の作業項目の状態を同時に保持し、同じ会話の中でタスクを切り替える
- ユーザーはいつでも情報を追加し、優先度を調整できる
- 複雑なタスクをいくつかに分割し、バックグラウンド Agent に並行処理させる
- 独立した可視のタスクスレッドを作成し、各タスクの結果を集めてまとめる
- 作業が行き詰まったときにユーザーの介入を求め、バックグラウンドタスクの実行中もユーザーは引き続きメッセージを送れる
これらの能力を合わせると、Dot が担う役割はプロジェクトコーディネーターに近くなります。どの作業を先に行うか、どれを切り出して任せるか、どれをユーザーに戻すかを決めるのが Dot の役目で、個々のタスクの具体的な実行はバックグラウンド Agent、ChatGPT Work タスク、または Codex タスクが担えます。
1.2 マルチ会話・マルチタスク・マルチ Agent の違い
この3つの概念はよく混同されますが、それぞれ解決する問題は異なります。共通の例で見てみましょう。ユーザーのワークスペースに AI Radar(AI ニュース日報)、Website(サイトリニューアル)、Research(競合調査)という3つのプロジェクトがあるとします。
| モード | 動作の仕組み | 例での現れ方 | 解決する問題 |
|---|---|---|---|
| マルチ会話 | ユーザーがプロジェクトごとにチャットウィンドウを開く | ユーザー自身が Research がどこまで進んだかを覚えておく | チャット内容を分離するが、進捗は依然として人が管理 |
| マルチタスク | 1人のコーディネーターが複数タスクの状態を維持 | Dot が3つのプロジェクトそれぞれの進捗と優先度を記録 | 一元的なスケジューリングと状態の追跡 |
| マルチ Agent | コーディネーターがサブタスクを複数の実行者に割り当てる | バックグラウンド Agent が資料を収集し、別の実行者がレポートを書く | 並行実行と専門的な分業 |
Dots はこの3つを重ね合わせています。ユーザーは1つの入口で Dot とやり取りし、Dot が複数のタスクを維持し、必要に応じてバックグラウンド Agent を派遣します。自前のシステムでこの効果を再現するには、3層の能力をすべて実装する必要があり、複数のチャットウィンドウを開くだけではまったく足りません。
1.3 あるユーザーが語った並行実行の観察
Reddit であるユーザーが、1日のテストについて自ら語っていました。数百本の PDF と数千ページの文書を Dot にレビューさせ、同時に法律リサーチのタスクを走らせたというものです。彼が観察したのは、3つの実行プロセスが同時に存在する状況でした。Dot 自身のクラウドコンピュータがタスク A を処理し、彼が接続した Linux マシンがタスク B を処理し、別のバックグラウンドリサーチ Agent がタスク C を処理していました。また彼は、独立した法律リサーチタスクを起動した際に実行環境が利用できないことがあり、ローカル PC に接続してからようやく派遣に成功したとも述べています。
この個人的な観察から分かるのは、Dot のクラウドコンピュータ、ローカル PC、そして Work/Codex 環境がそれぞれ異なる実行リソースだという点です。筆者自身も、これらの経路が独立して無制限の割り当てを持つかどうかは検証していないと述べています。したがってこのテストは、Dots が作業を異なる環境に分派できることを示すだけであり、すべての Pro ユーザーが同じ並行規模を得られるとは推測できません。
2 Dotsの長期記憶:あるタスクに独立した記憶が必要な理由
2.1 新しいタスクのコンテキスト境界
公式ドキュメントには明確にこう書かれています。新しいタスクにはそれぞれ独自の会話コンテキストがあり、Dot とユーザーの間のすべての履歴会話を自動的に引き継ぐことはありません。Dot は過去の ChatGPT 会話を検索して背景を探すことができ、検索された内容は現在の作業のコンテキストとしてのみ使用されます。
この設計は非常に現実的です。すべてのタスクで全履歴を読み込んでしまうと、Research プロジェクトの競合他社レポートに Website プロジェクトのリニューアル議論が混ざり込む可能性がありますし、コンテキストもどんどん長くなり、コストも増えていきます。長期プロジェクトでは「このタスクは何を知っているべきか」を明示的に管理する必要があり、どんどん長くなる一本のチャット記録だけではこれを実現できません。
2.2 Dots記憶の4つのデータ層
公式資料によると、Dot のコンテキストは4つの異なるソースから来ています。
- ChatGPT Memory:Dot は ChatGPT の関連する記憶と最近の会話を読み取ることができます。
- Dot 自身のノート:ユーザーの好み、作業習慣、プロジェクトの意思決定、長期的な責任事項を蓄積します。
- 現在のタスクコンテキスト:今回の会話における指示、ファイル、検索結果、ツールの実行結果。
- 接続済みアプリのデータ:Dot は認可済みアプリのデータを読み取り、能動的なリサーチを通じて記憶を形成することもできます。
これらの層のライフサイクルはそれぞれ異なります。ChatGPT Memory と Dot ノートは異なるデータ層に属しており、ChatGPT Memory の共有をオフにしても、Dot がすでに取得した情報が自動的に削除されるわけではなく、プラグインを切断しても新たなアクセスが停止するだけです。2026年11月16日時点では、ユーザーは Dot の独立した記憶を一件ずつ確認・修正・削除することはできず、Dot を削除するとそれ自体のコンテキストの削除が開始されます。自前でシステムを構築して記憶層を設計する際には、この階層化の考え方を参考にしつつ、確認・削除が可能な管理インターフェースを追加するとよいでしょう。
3 Checkpointer と Store:マルチタスクエージェントの2種類の記憶
LangGraph の永続化ドキュメントでは、エージェントの記憶を2種類に分類しています。この分類はちょうど Dots の「タスクコンテキスト」と「長期ノート」に対応します。以下では引き続き Research プロジェクトの月次競合レポートを例に説明します。
3.1 Checkpointer:作業がどこまで進んだかを記録する
Checkpointer は単一のタスクスレッドの実行スナップショットを保存します。内容には現在のステップ、呼び出されたツール、ツールの戻り結果、そしてどのステップが人による承認待ちかが含まれます。例では、月次レポートタスクが6社の競合の価格ページを取得し終え、これから分析を始めようとしたところでサービスが再起動しました。チェックポイントがあれば、「分析」ステップから続行でき、取得済みの資料を取り直す必要はありません。
保存先の媒体は、チェックポイントが再起動を乗り越えられるかどうかを左右します。インメモリ実装は開発・テストに適していますが、プロセス再起動後に状態は失われます。ローカル永続化には SQLite を使えます。長期運用するサービスには PostgreSQL がより適しています。チェックポイントは増え続けるため、本番システムでは古い状態をクリーンアップする方針も定める必要があります。
3.2 Store:プロジェクトの背景を記憶する
Store はタスクをまたぎ、セッションをまたぐ長期資料を保存します。たとえばユーザーの好み、プロジェクトの背景、過去の意思決定、複数タスクで共有される知識などです。例では、「レポートの読者はプロダクトチーム」「API の価格と機能更新のみを追跡」「先月、更新停止したある競合を追跡しないと決定済み」が Store の内容に当たります。翌月に新しいレポートタスクを作成すると、これらの決定を読み込み、ユーザーが改めて伝え直す必要はありません。
3.3 Checkpointer と Store の役割比較
| 観点 | Checkpointer | Store |
|---|---|---|
| 適用範囲 | 単一のタスクスレッド | 複数タスク、スレッド横断 |
| 保存内容 | 実行状態のスナップショット | 長期資料と事実 |
| 中心的な価値 | 中断後の作業復元 | 新タスクへのプロジェクト背景の継承 |
| 具体例 | 「6社の価格ページを取得済み、次は分析」 | 「レポートの読者はプロダクトチーム」 |
| ライフサイクル | タスク状態に追随し、完了後にクリーンアップ可能 | 長期記憶戦略に基づいて保持・更新 |
両者の役割分担は明確で、どちらも欠かせません。Checkpointer だけでは、新しいタスクのたびに新入社員が入社するようなものです。Store だけでは、タスクが中断すると最初からやり直しになります。
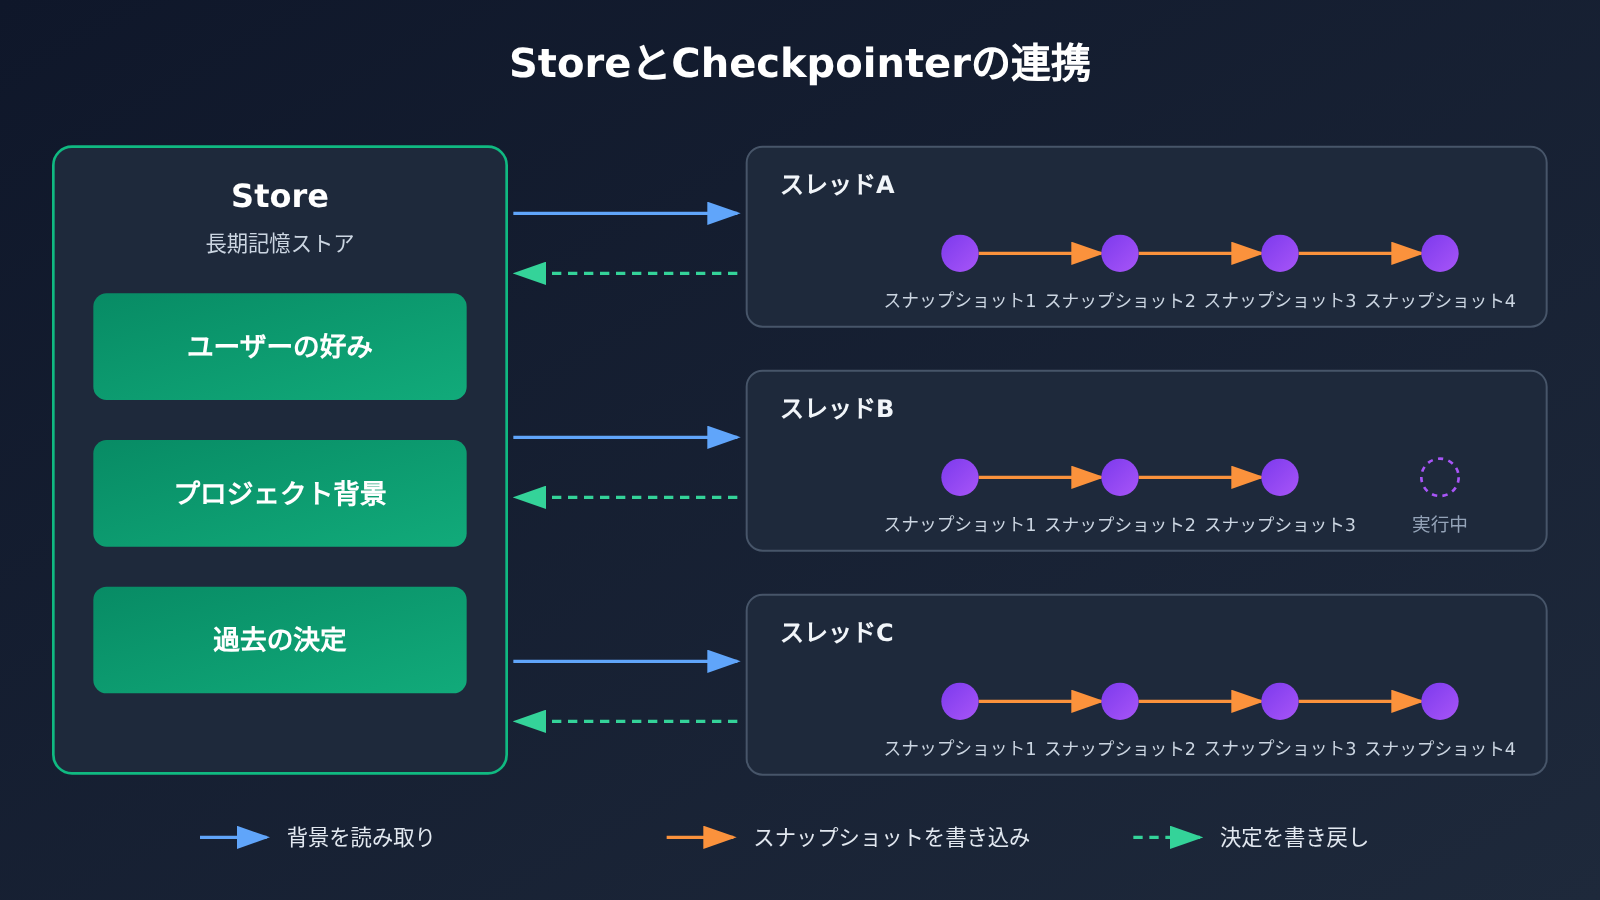
上の図の「背景を読み込む—スナップショットを書き込む—決定を書き戻す」という循環は、そのまま第6節のコードに対応します。サンプルコードは APIYI apiyi.com の OpenAI 互換インターフェース経由でモデルを呼び出しており、モデルを変更するときはモデル名だけを変えればよいです。
4 マルチプロジェクトタスク管理システムの設計:Workspace、Project、Task、Run
4.1 四層構造と独立した ID
自前で構築するマルチプロジェクト Agent では、四層構造を採用し、各層に独立した ID を持たせることをおすすめします。
| 階層 | 役割 | 例 |
|---|---|---|
| Workspace | ユーザーのワークスペースと権限を管理 | regulus |
| Project | 独立したプロジェクトの目標と資料を管理 | AI Radar、Website、Research |
| Task | 具体的なタスクを管理 | Daily News、Monthly Report |
| Run | ある実行の実績を記録 | Daily News の 2026-11-16 09:00 の実行 |
対応するツリー構造は次のとおりです。
Workspace: regulus
├── Project: AI Radar
│   ├── Task: Daily News
│   │   ├── Run: 2026-11-16
│   │   └── Run: 2026-11-17
│   └── Task: Topic Discovery
├── Project: Website
│   ├── Task: UI Improvement
│   └── Task: Bug Fix
└── Project: Research
    ├── Task: Competitor Analysis
    └── Task: Monthly Report
Task と Run を分けて記録することがポイントです。Daily News は毎日1回実行され、各 Run にはそれぞれ独自の入力、出力、所要時間、ステータスがあります。問題が発生した際には、どの日のどの実行だったかを正確に特定できます。
4.2 記憶のアクセス範囲とプロジェクトの分離
1つの Agent で複数のプロジェクトを管理する場合、各プロジェクトのファイルはデフォルトで相互に読み取れないようにします。記憶のアクセス範囲は階層ごとに分けることをおすすめします。
- ユーザー共通の好み(レポートは中国語で、結論を先に述べるなど):すべての認可済みプロジェクトから読み取り可能;
- プロジェクトの背景(Research の読者や追跡範囲など):そのプロジェクトのタスクのみ読み取り可能;
- 単一タスクの記録:現在のタスクと、明示的に認可された関連タスクのみ読み取り可能;
- 企業顧客の資料:指定された顧客プロジェクトのみ読み取り可能;
- 機密性の高い認証情報:独立した安全なストレージに保管し、モデルのコンテキストには決して入れない。
プロジェクトをまたいで資料を共有する場合は、出典と認可範囲を記録します。これは Dots のやり方と一致しています。公式の説明では、Dot のコンテキストには認証情報、画像、スクリーンショットが保持されず、権限の境界はプラグインの認可と Custom Rules の両方で制御されます。
5 マルチタスクスケジューリング:タスクを並列化しつつ互いに干渉させない方法
5.1 スケジューラと Agent 推論の分離
「いつ実行するか」と「どう実行するか」を2つのコンポーネントに分けて任せることをおすすめします。スケジューラは起動タイミング、プロジェクトの選択、現在の実行数、優先度、タイムアウト、リトライを担当し、Agent はタスクの理解、手順の策定、ツールの選択、結果の分析、成果の提出を担当します。こうすることで、スケジューリングのルールは決定論的に実行でき、モデルは推論が必要な部分だけを処理します。
技術選定としては、この組み合わせが参考になります。APScheduler で定期タスクを管理し、Celery でバックグラウンドタスクキューを実装し、Redis でメッセージと短期的な調整を担い、PostgreSQL でプロジェクトと実行状態を保存し、LangGraph のようなフレームワークで Agent のフローと永続化状態を管理します。小規模なプロトタイプなら Python の asyncio と SQLite でも動作し、第6節のコードはそのように設計されています。
5.2 3つの並列方式
マルチタスク Agent には少なくとも3つの並列方式があります。
- 独立タスクの並列:AI Radar の日次ニュースと Research の月次レポートは互いに依存しないため、同時に実行できます。
- サブタスクの並列:1つのプロジェクトを資料収集、ファクトチェックなどのサブタスクに分割して並行して進めます。
- モデルロールの並列:異なるモデルがそれぞれ専門的な作業を担当し、最後に統合します。
並列化できるかどうかを決める制約には、API の同時実行枠、サーバーリソース、タスクの依存関係、データベース書き込みの競合、モデルコスト、結果の衝突、重複実行などがあります。
5.3 例:資料収集、データ分析、レポート生成
Research プロジェクトの月次レポートは3つのサブタスクに分割されます。資料収集は AI Radar の日次ニュースと並行して実行できます。データ分析は資料収集の結果に依存するため、その完了を待つ必要があります。レポート生成は分析の結論に依存し、完了後は承認待ち状態になって、ユーザーが確認して初めて納品となります。
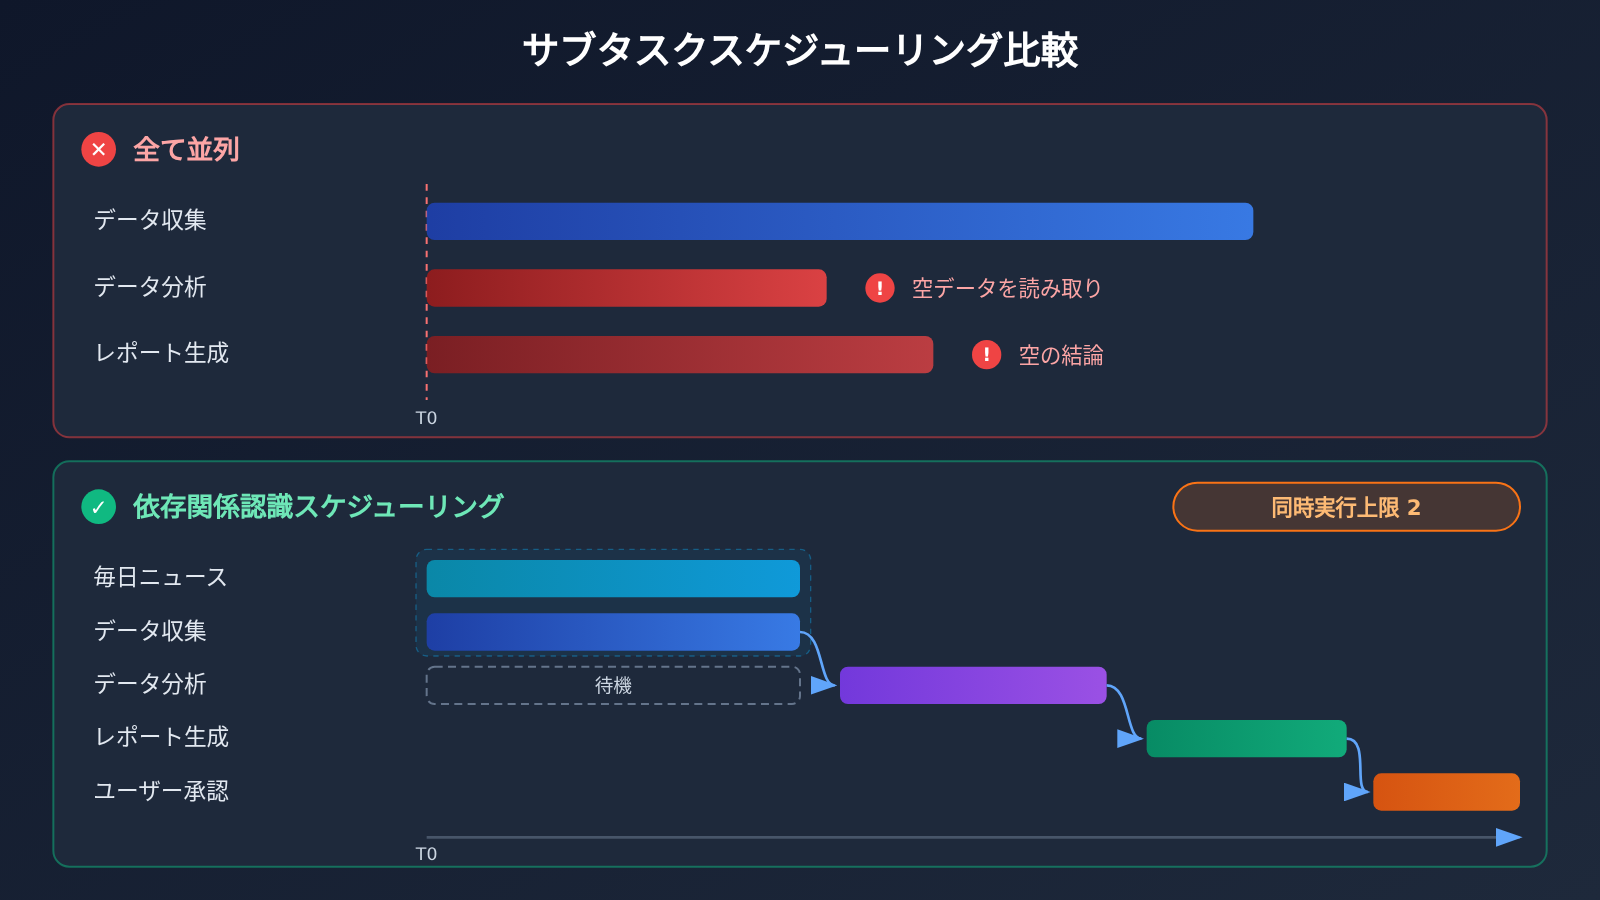
3つのサブタスクをまとめて起動すると一見速く見えますが、データ分析は資料を取得できないため空の結論を出してしまい、さらにはデータを捏造することさえあります。依存関係によってどのタスクを直列に実行しなければならないかが決まり、同時実行上限によって同時にいくつ走らせられるかが決まります。この両方をスケジューラに書き込み、モデルにその場で判断させるのは簡単に誤りを招きます。
5.4 モデルロールの分担
| サブタスク | 推奨モデルタイプ | 選定理由 | 利用可能なプラットフォーム |
|---|---|---|---|
| 資料収集と要約 | 軽量で高速なモデル | 呼び出し量が多く、コストに敏感 | APIYI apiyi.com、公式 API |
| データ分析 | 推論能力の高いモデル | 多段階の比較と計算が必要 | APIYI apiyi.com、公式 API |
| レポート生成 | 長文執筆能力の高いモデル | 構成と表現の品質が求められる | APIYI apiyi.com、公式 API |
| ファクトチェック | 執筆モデルとは異なるモデル | クロス検証により、同一ソース由来の誤りを減らす | APIYI apiyi.com、公式 API |
具体的なモデルは、プラットフォームの現在のモデル一覧を基準にしてください。1つのキーで複数のモデルに接続する場合、ロールの分担は設定で調整でき、コード構造を変更する必要はありません。
6 クイックスタート:統一インターフェースでマルチタスク Agent プロトタイプを構築
6.1 ミニマルな例:タスクにプロジェクト背景を注入する
以下のコードは、最も核心的なポイントを実演します。タスク実行前に、長期記憶からそのプロジェクトに属する背景だけを取り出す、という仕組みです。
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI互換インターフェース
)

# Store:プロジェクトごとに分離された長期背景
project_memory = {
    "research": "読者:プロダクトチーム;API の価格と機能更新のみを追跡;レポートは結論を先に提示",
    "ai-radar": "毎日 09:00 に OpenAI、Anthropic、Google の公式動向をまとめる",
}

def run_task(project_id: str, goal: str) -> str:
    resp = client.chat.completions.create(
        model="gpt-4.1-mini",
        messages=[
            {"role": "system", "content": f"プロジェクト背景:{project_memory[project_id]}"},
            {"role": "user", "content": goal},
        ],
    )
    return resp.choices[0].message.content

print(run_task("research", "今月注目すべき競合製品のアップデート一覧を出力してください"))
この例のポイントは、project_memory がプロジェクトごとに独立した長期背景として機能している点です。run_task を呼び出すたびに、指定した project_id に対応する背景だけが system メッセージに埋め込まれ、タスクの目的(goal)と組み合わされてモデルへ渡されます。こうした構造にしておくと、複数のプロジェクトを並行して回しても記憶が混ざらず、それぞれの文脈に沿った応答を得られます。
6.2 完全な設計案:ステートマシン、チェックポイント、依存関係、並行性
以下のコードは一つの設計案であり、Store、Checkpoint、ステートマシン、依存関係のスケジューリング、並行性の制限、リトライ、タイムアウト、実行記録をカバーし、各コンポーネントがどのように連携するかを説明しています。本番環境での検証は行っておらず、本文中にも架空の実行結果は掲載していません。
完全な設計案のコードを表示
import asyncio, json, sqlite3, time, uuid
from dataclasses import dataclass, field
from enum import Enum
from openai import AsyncOpenAI

client = AsyncOpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI統一インターフェース、1つのKeyで複数モデルを切り替え
)

class Status(str, Enum):
    PENDING = "pending"; RUNNING = "running"; WAITING = "waiting"
    APPROVAL = "approval"; COMPLETED = "completed"
    FAILED = "failed"; CANCELLED = "cancelled"; PAUSED = "paused"

db = sqlite3.connect("agent.db")
db.executescript("""
CREATE TABLE IF NOT EXISTS store(
  scope TEXT, key TEXT, value TEXT, source TEXT, PRIMARY KEY(scope, key));
CREATE TABLE IF NOT EXISTS checkpoint(
  run_id TEXT, task_id TEXT, step TEXT, state TEXT, ts REAL);
CREATE TABLE IF NOT EXISTS runs(
  run_id TEXT PRIMARY KEY, workspace_id TEXT, project_id TEXT, task_id TEXT,
  model_id TEXT, input_tokens INT, output_tokens INT,
  duration REAL, retry_count INT, final_status TEXT);
""")

def store_get(scopes: list[str]) -> str:
    """認可されたスコープのみを読み取る:user と project:<id>"""
    marks = ",".join("?" * len(scopes))
    rows = db.execute(f"SELECT key, value FROM store WHERE scope IN ({marks})", scopes)
    return "\n".join(f"- {k}: {v}" for k, v in rows)

def save_checkpoint(run_id, task_id, step, state):
    db.execute("INSERT INTO checkpoint VALUES (?,?,?,?,?)",
               (run_id, task_id, step, json.dumps(state, ensure_ascii=False), time.time()))
    db.commit()

def log_run(run_id, task, usage, duration, retries, status):
    db.execute("INSERT OR REPLACE INTO runs VALUES (?,?,?,?,?,?,?,?,?,?)",
               (run_id, "regulus", task.project_id, task.task_id, task.model,
                getattr(usage, "prompt_tokens", 0), getattr(usage, "completion_tokens", 0),
                duration, retries, status.value))
    db.commit()

@dataclass
class Task:
    task_id: str
    project_id: str
    goal: str
    model: str
    depends_on: list[str] = field(default_factory=list)
    needs_approval: bool = False

async def run_task(task: Task, done: dict, sem: asyncio.Semaphore,
                   max_retry: int = 2, timeout: int = 120):
    run_id = f"run-{uuid.uuid4().hex[:8]}"
    background = store_get(["user", f"project:{task.project_id}"])
    upstream = "\n\n".join(done[d] for d in task.depends_on)
    messages = [
        {"role": "system", "content": f"长期背景:\n{background}"},
        {"role": "user", "content": f"{task.goal}\n\n上游结果:\n{upstream or '无'}"},
    ]
    async with sem:  # 同時実行数の制限
        for attempt in range(max_retry + 1):
            start = time.time()
            save_checkpoint(run_id, task.task_id, f"attempt-{attempt}", messages)
            try:
                resp = await asyncio.wait_for(
                    client.chat.completions.create(model=task.model, messages=messages),
                    timeout)
                output = resp.choices[0].message.content
                status = Status.APPROVAL if task.needs_approval else Status.COMPLETED
                log_run(run_id, task, resp.usage, time.time() - start, attempt, status)
                save_checkpoint(run_id, task.task_id, status.value, {"output": output})
                if status == Status.COMPLETED:
                    done[task.task_id] = output
                return
            except Exception as e:  # タイムアウトまたはAPIエラー:指数バックオフ後にリトライ
                save_checkpoint(run_id, task.task_id, "error", {"error": str(e)})
                await asyncio.sleep(2 ** attempt)
        log_run(run_id, task, None, 0, max_retry, Status.FAILED)

async def schedule(tasks: list[Task], max_concurrency: int = 2) -> dict:
    sem = asyncio.Semaphore(max_concurrency)
    done: dict[str, str] = {}
    pending = {t.task_id: t for t in tasks}
    while pending:
        ready = [t for t in pending.values() if all(d in done for d in t.depends_on)]
        if not ready:  # 先行タスクの失敗、承認待ち、または循環依存の存在
            print("阻塞任务:", list(pending))
            break
        await asyncio.gather(*(run_task(t, done, sem) for t in ready))
        for t in ready:
            pending.pop(t.task_id)
    return done

tasks = [
    Task("daily-news", "ai-radar", "汇总今日 AI 官方动态", "gpt-4.1-mini"),
    Task("collect", "research", "收集本月竞品 API 价格与功能变更", "gpt-4.1-mini"),
    Task("analyze", "research", "对比变更并归纳趋势", "gpt-4.1", depends_on=["collect"]),
    Task("report", "research", "生成月度竞品报告", "gpt-4.1",
         depends_on=["analyze"], needs_approval=True),
]
asyncio.run(schedule(tasks))
コードには、前文の設計に対応する箇所がいくつかあります。store_get は user と現在のプロジェクトスコープだけを読み取り、プロジェクトの分離を実現しています。checkpoint テーブルは run ごとに各ステップを記録し、runs テーブルと組み合わせて Token と最終状態を記録します。schedule は依存関係で直列実行を決め、セマフォで並列度を制限します。実際のシステムではさらに、ツール呼び出し、承認コールバック、復帰エントリを追加する必要があります。
🚀 クイックスタート:プロトタイプ構築の段階では、APIYI apiyi.com から無料のテスト枠を取得するのがおすすめです。同じキーで、収集・分析・執筆という3つの役割にそれぞれ異なるモデルを割り当て、効果とコストを比較したうえで分担を決めるとよいでしょう。
7 マルチタスクAgentにおける中断・失敗・人手による承認の扱い方
7.1 タスクのステートマシン
タスクの進捗は明確な状態として記録すべきで、モデルがチャットで語る進捗はあくまで参考程度にとどめます。推奨されるメインフローは Pending(実行待ち)→ Running(実行中)→ Waiting(外部条件待ち)または Approval(承認待ち)→ Completed(完了)で、これとは別に Failed、Cancelled、Paused という3つの終了・一時停止状態を設けます。状態が遷移するたびにデータベースへ書き込み、スケジューラはデータベース上の状態だけを根拠に判断します。
7.2 再試行・タイムアウト・一時停止からの復帰
- 再試行:APIエラーやタイムアウトの後は指数バックオフで再試行し、retry_count を記録して、失敗しやすいステップを発見しやすくします。
- タイムアウト:各 Run に実行期限を設定し、超過したら Failed に切り替えてアラートを出します。ハングしたタスクが長期間にわたって並列実行の枠を占有するのを防ぎます。
- 一時停止と復帰:一時停止時にチェックポイントを保存し、復帰時は最後のチェックポイントから再開します。完了済みのツール呼び出しを繰り返し実行する必要はありません。
- 冪等性:メール送信やデータベース書き込みのように副作用のあるステップでは、再試行の前に実行済みかどうかを確認し、二重操作を避けます。
Dots の公式資料には、関連する細かい記述があります。実行中のタスクを停止することと、作成済みの定期プランをキャンセルすることは別物であり、Dot を一時停止しても、独立した Work、Codex、スケジュールタスクは動き続ける可能性があります。自社で構築するシステムでは、「今回の Run を停止する」「Task を一時停止する」「定期プランをキャンセルする」を3つの独立した操作として設計すべきです。
7.3 人手による承認:Dots の Custom Rules を参考に
Dots は Custom Rules で動作を4段階に分けています。確認せずにそのまま実行、事前承認のうえ実行、実行前に確認、ユーザーへ返却、の4つです。パスワード変更や資金移動といった操作は必ずユーザーが引き継ぐ必要があり、データの完全削除やソフトウェアのインストールは毎回の承認を求める場合があります。ユーザーの承認であっても、中核となる安全制限を覆すことはできません。
自社で構築するシステムでも、これを参考にツールへラベルを付けられます。読み取り専用の検索はそのまま実行、レポートのドラフトが完成したら Approval へ、対外的な送信・支払い・削除は一律で人に引き渡します。例のレポートタスクでは needs_approval=True が設定されており、生成後は承認待ち状態で停止し、ユーザーが確認してから Completed が書き込まれます。
8 マルチタスクAgentの実行トレーシング:Tracingとログ
複数プロジェクトを並行して進める場合、ユーザーから最もよく聞かれるのは「結局何をしたのか」という質問です。OpenAI Agents SDKのTracingでは、どのAgentが呼び出されたか、どのモデルが使われたか、どのツール呼び出しが発生したか、どこでhandoffが行われたか、どのセーフティチェックがトリガーされたか、そしてタスクが最終的にどのように終了したかを記録できます。
Tracingは1回の実行プロセスを再現するのが得意ですが、プロジェクト単位の統計には業務ログによる補完が必要です。各Runでは少なくともproject_id、task_id、run_id、model_id、input_tokens、output_tokens、tool_calls、duration、retry_count、final_statusを記録することをおすすめします。これらのフィールドがあれば、「Researchプロジェクトが今月いくらTokenを消費したか」「どのステップでリトライが最も多いか」「どのモデルの分析タスクが最も頻繁にタイムアウトするか」といった管理上の問いに答えられます。第6節のrunsテーブルは、このフィールド群の最小実装です。
9 マルチタスクAgentのコストと管理の境界
9.1 Dotsの費用構造
2026年11月16日時点では、個人ユーザーはChatGPT Pro 100、Pro 200、Pro 500の3つのサブスクリプションを通じてDotsを利用でき、月額料金はそれぞれ100ドル、200ドル、500ドルです。公式の個人Pro向けDotsの説明には、Dot単体の月額料金は記載されていません。Dotが委譲したChatGPT WorkまたはCodexのタスクは、対応製品の利用枠とルールに従って計算され、消費量はモデル、コンテキスト、推論、ツール呼び出し、検索によって決まります。個人Proの利用には年齢(18歳以上)と地域の制限があり、欧州経済領域、英国、スイスは対象外です。
企業向けワークスペースの課金方式は異なります。現行の公式ドキュメントでは、対象となる企業向けワークスペースは、作業タイプごとの固定料金または従量課金を選択できます。プレビュー期間は無料で、2026年11月18日以降、有効化済みのDotsに対して課金が開始されます。WorkまたはCodexに委譲されたタスクは別途課金されます。具体的な金額は、ワークスペースに実際に適用される料金に従います。
9.2 自前構築システムのコスト要因
自前でマルチタスクAgentを構築する場合、コストは主に次の4つから発生します。
- コンテキストの重複読み込み:各タスクにプロジェクトの背景を注入するため、背景が長いほど呼び出しごとの入力Tokenが増え、Store内の内容は定期的に整理する必要があります。
- リトライと失敗:分析タスクが1回失敗するたびに、上流の資料がモデルに再投入されます。
- モデル選択:すべてのサブタスクで最強モデルを使うと、コストは何倍にも増えます。
- 同時実行の上限枠:APIのレート制限によって、実際に利用可能な並列数が決まります。
9.3 並列数と有効な作業量
並列数と有効な作業量は別物です。依存関係が満たされていないタスクを前倒しで開始しても、無駄な結果を生むだけです。相互に矛盾する結論は人手で統合する必要があり、あるプロジェクトの誤ったデータが共有メモリを通じて別のプロジェクトに伝わると、手戻りコストはさらに高くなります。合理的な方法は、まずプロジェクトの分離と依存関係の正確さを確保し、その後、監視データに基づいて同時実行の上限を段階的に引き上げることです。
10 よくある質問(FAQ)
Q1:Dots のマルチタスクスケジューリングとは何ですか?
1つの Dot が複数の担当事項を同時に管理します。ユーザーはタスクを切り替えたり優先度を調整したりでき、Dot は複雑な作業をバックグラウンドの Agent に分解して並列処理させ、結果を集約したうえで判断が必要なタイミングでユーザーに返します。
Q2:Dots の長期記憶は、すべての過去の会話を覚えていますか?
すべてを読み込むわけではありません。新しいタスクには独自の会話コンテキストがあり、Dot は ChatGPT Memory、自身のノート、現在のタスクコンテキスト、接続済みアプリのデータを使って動作し、必要になったときに過去の会話を検索します。
Q3:Checkpointer と Store は互いに代替できますか?
両者の役割は異なります。Checkpointer は単一タスクの実行スナップショットを保存し、中断からの復元に使います。Store はタスクをまたぐプロジェクトの背景や意思決定を保存し、新しいタスクがコンテキストを引き継げるようにします。長期プロジェクトでは両方が必要です。
Q4:Dots は同時にいくつのタスクを並列実行できますか?
公式資料では固定の同時実行数は公開されていません。Dots は並列実行に対応していますが、実行環境や利用枠には上限があります。Reddit のユーザーが3つの実行プロセスが同時に動いているのを観察したと述べていますが、これはあくまで個人のテスト結果です。
Q5:自作のマルチプロジェクト Agent で、複数のモデルを素早く呼び出すには?
OpenAI 互換の集約インターフェースが利用できます。APIYI apiyi.com に登録して APIキーと無料テスト枠を取得したら、本記事のコードの base_url を `https://api.apiyi.com/v1` に設定するだけで、同じコードでサブタスクごとに GPT、Claude、Gemini などのモデルを割り当てられます。
Q6:マルチタスク Agent のモデルコストを抑えるには?
役割ごとにモデルを割り当てます。情報収集には軽量モデル、分析や執筆には強力なモデルを使い、Store 内のプロジェクト背景を簡潔にし、runs テーブルでプロジェクトごとの Token を集計します。APIYI apiyi.com の従量課金で呼び出すことで、まず小規模にテストしてから配分を決められます。
Q7:Dots と自建システムでは、セキュリティ面で何に注意すべきですか?
Agent はタスクを誤解したり、資料を誤判定したり、プロンプトインジェクションを受けたりする可能性があり、公式も現行の防御策ではすべてのリスクを排除できないと述べています。アカウント、資金、外部送信を伴う操作には人手による承認を設け、機密性の高い認証情報はモデルのコンテキストに入れないようにしてください。
11 Dots のマルチタスクスケジューリングと長期記憶:要点
- 核心となる難点:マルチタスク Agent の鍵は、独立したコンテキスト、永続状態、スケジューリング、そして復元にあります。
- Dots の仕組み:1つの Dot が複数の項目を調整し、バックグラウンド Agent が並列実行し、新タスクのコンテキストは相互に独立しています。
- 2種類の記憶:Checkpointer が実行の復元を担い、Store がプロジェクト背景の継続を担います。
- 4層構造:Workspace、Project、Task、Run はそれぞれ独立した ID を持ち、プロジェクト同士は互いに分離されています。
- スケジューリングの原則:依存関係が直列化を決め、並列度の上限が規模を決め、ルールはスケジューラに書き込みます。
- 追跡可能性:各 Run はモデル、Token、所要時間、リトライ回数、最終状態を記録します。
- 導入方法:APIYI apiyi.com の統一インターフェースを通じて、異なるサブタスクに異なるモデルを設定します。
12 まとめ
Dots は、個人用 Agent が複数の長期プロジェクトを管理するプロダクトの形を示しています。常時稼働し、タスクのコンテキストは互いに独立し、記憶は階層的に保存され、バックグラウンド Agent が並列実行し、高リスクな操作はユーザーに返されます。そのマルチプロジェクト能力は状態管理の上に築かれており、単に並列数を増やすだけでは実現できません。
同様のシステムを自前で構築する場合、本記事の順序に従って実装を進められます。まず4層構造とスコープ分割でプロジェクトの分離を実現し、次に Store と Checkpointer でそれぞれ「背景を記憶する」ことと「復元できる」ことを解決し、その後スケジューラで依存関係と並列度を管理し、最後に状態マシン、承認、実行ログによって各ステップを制御可能かつ検証可能にします。プロトタイプ段階では、APIYI apiyi.com を通じて異なるモデルが各役割でどのような効果を発揮するかを素早く検証し、その後ログデータに基づいて役割分担と並列度を調整することをお勧めします。
参考資料
- OpenAI:Introducing dots:製品発表のお知らせ
- リンク:
openai.com/index/introducing-dots - 説明: 製品の位置づけ、クラウドコンピューター、複数プロジェクトの実行
- ChatGPT Learn:Tasks and memory:Dots のタスクとメモリに関するドキュメント
- リンク:
learn.chatgpt.com/docs/dots/tasks-and-memory - 説明: バックグラウンド Agent、タスクごとに独立したコンテキスト、プロアクティブな調査
- OpenAI Help Center:Dots privacy, security, and safety FAQs:プライバシーとセキュリティに関する説明
- リンク:
help.openai.com/en/articles/20001529-dots-privacy-security-and-safety-faqs - 説明: 権限、承認、メモリの削除、データ保持
- ChatGPT Learn:Dots admin guide:エンタープライズ版の管理と課金
- リンク:
learn.chatgpt.com/docs/enterprise/dots-admin-guide - 説明: 企業ワークスペースの課金方法と課金開始日
- About ChatGPT Pro tiers:Pro サブスクリプションのプラン説明
- リンク:
help.openai.com/en/articles/9793128-about-chatgpt-pro-tiers - 説明: Pro 100、200、500 の価格と利用枠のルール
- LangGraph Persistence ドキュメント:Checkpointer と Store
- リンク:
github.com/langchain-ai/docs/blob/main/src/oss/langgraph/persistence.mdx - 説明: 短期的な実行状態と長期的な記憶の区分
- OpenAI Agents SDK:Tracing とワークフロー
- リンク:
developers.openai.com/api/docs/guides/agents/sdk - 説明: Agent 実行プロセスのトレーシングとデバッグ
作者:APIYI 技術チーム
技術交流:APIYI apiyi.com のトップページからお問い合わせください。その他の接続資料は docs.apiyi.com ドキュメントセンターでご覧いただけます。


