
著者注:同じ2.4Tクラスのフラッグシップでありながら、Qwen4-Max はリスト価格を25%引き下げ、出力上限は約3倍に、同一タスクでの token 消費は2〜3割減っています。本記事ではアーキテクチャ、ベンダー自己申告のベンチマークスコア、2世代のリスト価格を分解し、qwen3.8-max からの移行チェックリストを提示します。
2026年11月16日、Alibaba は Qwen4-Max を発表しました。まず結論からお伝えします。Qwen3.8-Max と比べて、入力・出力のリスト価格がそれぞれ25%ダウン、最大出力は128Kから393Kへ、およそ3倍、そして公式の Work360 評価では同一タスクの token 使用量が2〜3割少ないという結果です。すでに本番環境で qwen3.8-max を動かしているチームにとって、今回のアップグレードは真剣に評価する価値がありますが、一から作り直す必要はありません。
これは「新世代が全方位で圧勝」という宣伝記事ではありません。以下のスコアはすべてベンダー自己申告として明記し、サードパーティのランキングは公開ランキングのスナップショット(2026-11-14)として注記します。誇張されやすい2つの数字、すなわち「単一タスクのコスト62%削減」と「Arena 6位」については、個別に掘り下げて解説します。
この記事の価値:読み終えれば次の3点が判断できるはずです。節約分のうち何割が本当なのか、どのベンチマークが大きく伸びてどれがほぼ横ばいなのか、そして移行時にモデルIDの差し替え以外に何を変える必要があるのか。なお、APIYI(apiyi.com)経由で呼び出す場合、2026-11-16 11:00 時点でプラットフォームに qwen4-max はまだ登録されていません。現段階では qwen3.8-max をそのまま使い続けて問題ありません。できるだけ早くこのモデルを登録する予定です。
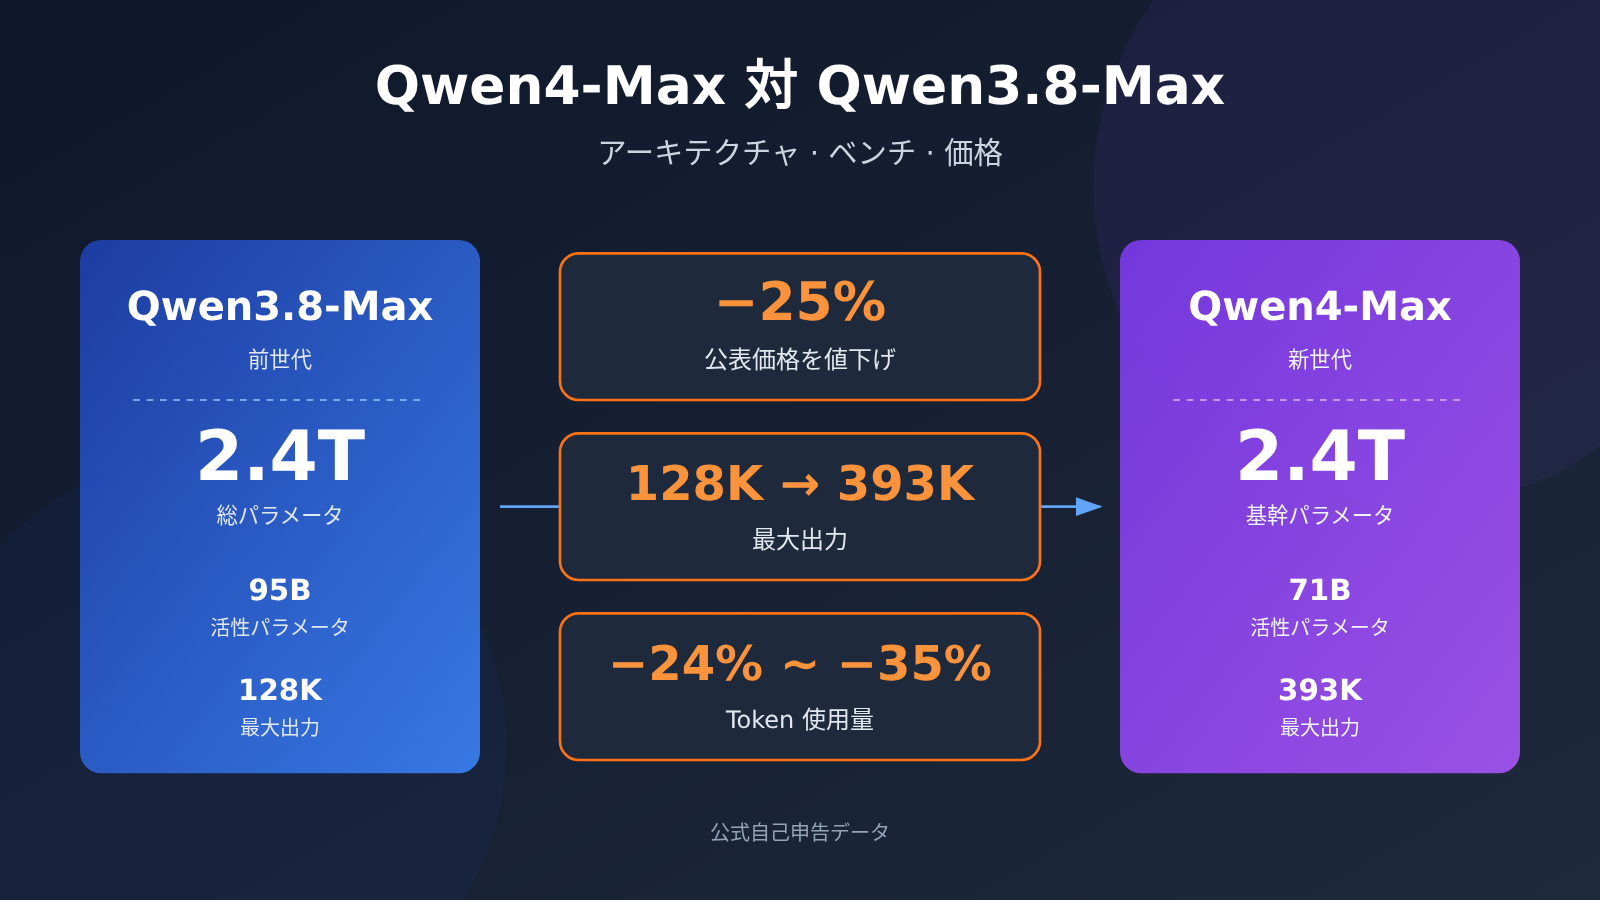
Qwen4-Max と Qwen3.8-Max の中核的差異をクイック比較
両世代モデルの総規模は同じクラスにありますが、Qwen4-Max ではアクティブパラメータ、出力上限、デフォルトの推論レベルが調整されています。まず仕様面の違いを下表にまとめ、価格は後続のコスト章で個別に扱います。
| 比較軸 | Qwen3.8-Max | Qwen4-Max | 変化 |
|---|---|---|---|
| パラメータ規模 | 2.4T 総パラメータ | 2.4T バックボーン + 328B N-gram Embedding | バックボーンは同級、埋め込みテーブルを追加 |
| 1回あたりのアクティブパラメータ | 95B | 71B | 約25%減 |
| コンテキスト | 1M | 1M(最大入力 991K、思考モード 983K) | 入力上限をやや引き締め |
| 最大出力 | 128K | 393K | 約3倍 |
| 最大思考連鎖 | 公式では単独記載なし | 262K | 明確な上限を新設 |
| デフォルト reasoning_effort | xhigh | high | デフォルトを1段階引き下げ |
| 視覚能力 | 画像入力に対応 | ネイティブ視覚 | 視覚がネイティブ機能に |
| オープンウェイト | Qwen3.8-2.4T-A95B | 資料では言及なし | — |
この表から今回のアップグレードの方針が見えます。総規模は変えず、1回あたりの計算をより節約し、出力の余地を広げています。アクティブパラメータを95Bから71Bへ下げたことは、リスト価格を引き下げられる根本的な前提であり、最大出力を393Kに広げたことは、長文レポートや大量のコード生成といったタスクの実現可能性を直接変えます。
注意が必要なのは、デフォルトの reasoning_effort が xhigh から high に変わった点です。コード側でこのパラメータを明示的に設定していない場合、モデルIDを切り替えた後に実際に動作する推論レベルが変わります。この点は移行チェックリストでも改めて強調します。
Qwen4-Max のアーキテクチャ変更:3つの変化が利用に与える影響
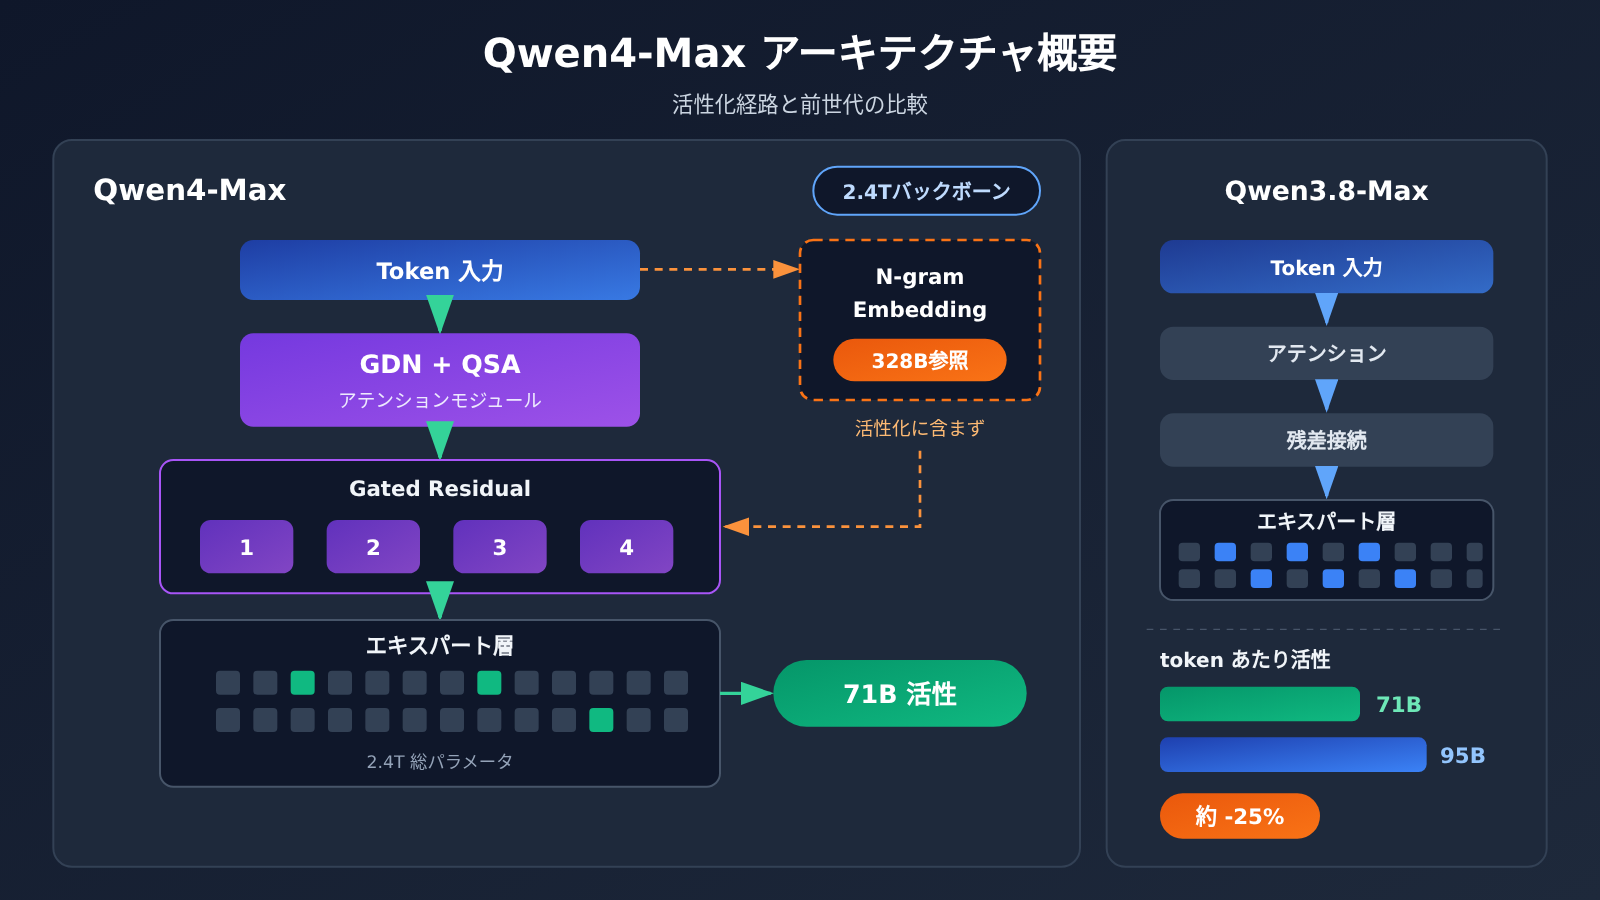
公式ブログでは、Qwen4-Max のアーキテクチャ変更を3つに整理しています。GDN + QSA、Gated Residual の4本の分岐、N-gram Embedding です。API利用者にとって、実装の詳細を層ごとに理解する必要はありませんが、これら3つの変更がそれぞれ何に影響するかを知っておくことは重要です。
GDN + QSA:アテンション層の変更
これはアテンション構造の調整です。公式はこれを 1M コンテキスト、393K の最大出力と合わせて紹介しています。私たちの理解では、主に長系列のシナリオにおける計算効率を狙ったものです。呼び出し側が直接体感できる結果は、同じ 1M コンテキストウィンドウで、Qwen4-Max がより長い出力を返し、しかも単価はむしろ低くなるという点です。
Gated Residual の4本の分岐
残差接続は、ゲート付きの4本の分岐に拡張されています。この種の変更は通常、学習の安定性と、異なる能力間の情報の流れに影響し、最終的にはモデルの挙動として現れます。実際の影響として、プロンプトがまったく同じでも、Qwen4-Max の出力スタイルや推論ステップの長さが前世代と異なる可能性があるため、Qwen3.8-Max 向けにファインチューニングしたプロンプトは回帰テストを行う必要があります。
N-gram Embedding:328B パラメータは計算量ではない
Qwen4-Max のパラメータ表記は「2.4T バックボーン / 71B アクティブパラメータ + 328B N-gram Embedding」です。一般的な設計では、この種の埋め込みはルックアップテーブル型のパラメータに分類され、トークンごとのバックボーンのアクティベーション計算には含まれません。そのため、328B をそのままアクティベーション量に加えて比較することはできません。推論コストに実際に関係するのは、71B 対 95B の比較です。つまり、1回のアクティベーションあたり約25%少なくなります。
事前学習の面では、公式は Qwen4-Max-Base が知識、コード、質問応答、STEM の4種類の内部評価で、BPB(バイトあたりのビット数、低いほど良い)がすべて最も低いことを示しています。Qwen3.8-Max-Base より約 5–13% 低くなっています。これは公式の内部評価ではありますが、少なくともベースモデル自体が向上していることを示しており、その後のベンチマークスコアの向上がポストトレーニングだけによるものではないことを物語っています。
Qwen4-Max ベンチマーク比較:大きく伸びた項目と、ほとんど変わらない項目
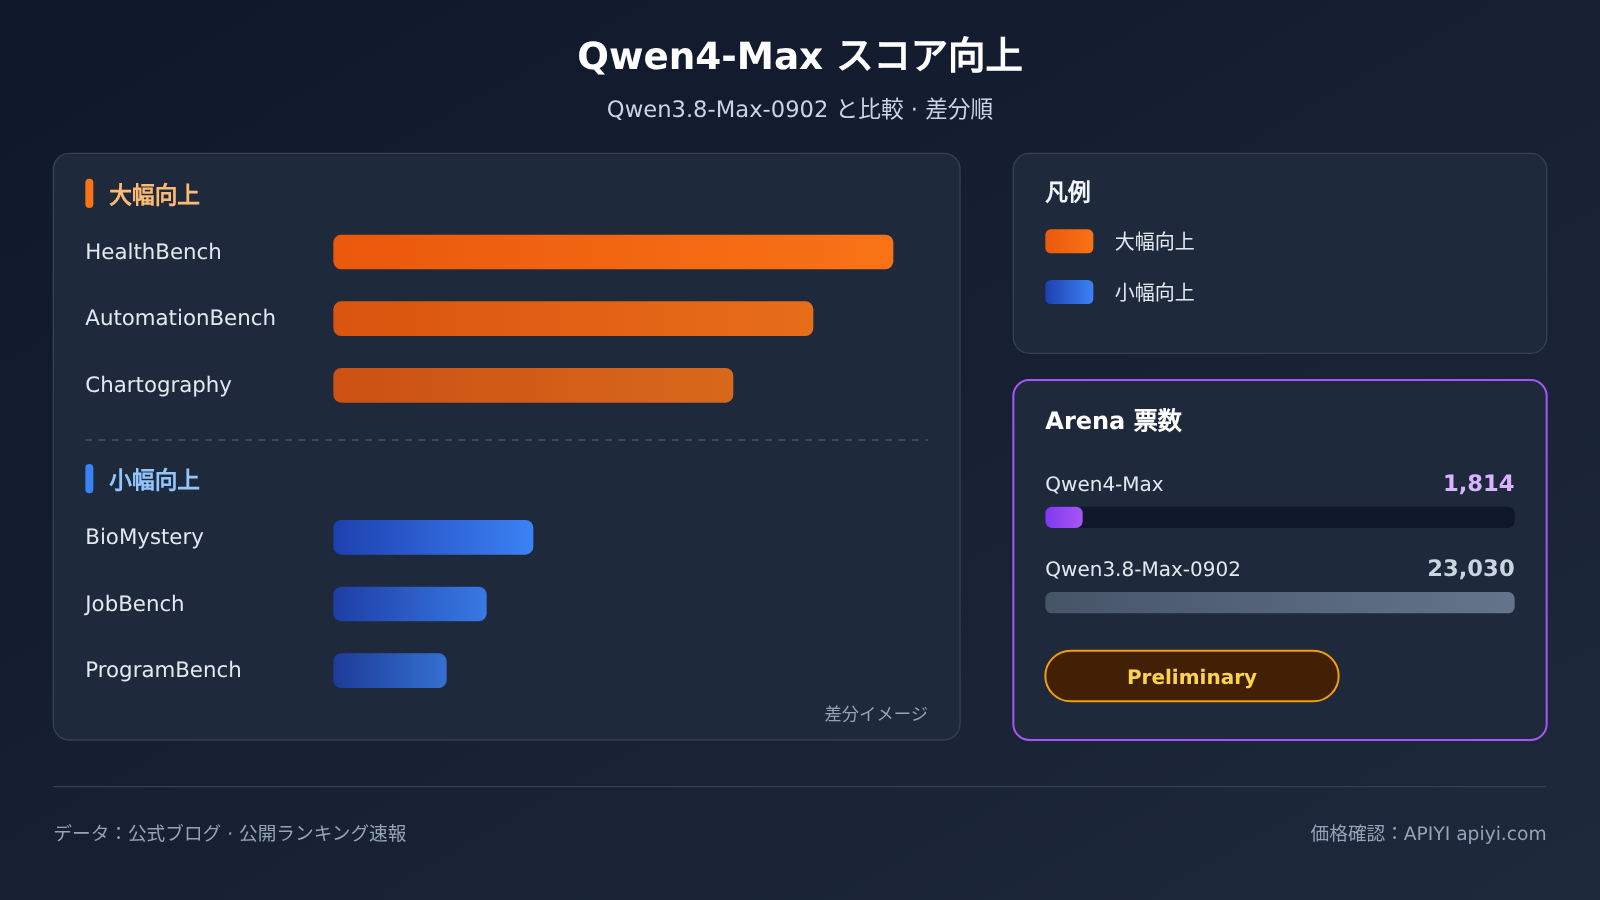
以下のデータはすべて、アリババが公開した同一の比較表に基づく公式の自己申告値で、比較対象は Qwen3.8-Max-0902(9月更新版)です。向上幅の大きい順に並べているので、アップグレードの効果がどこに集中しているかをひと目で確認できます。
| ベンチマーク(公式の自己申告値) | Qwen3.8-Max-0902 | Qwen4-Max | 差分 | 向上幅の評価 |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | 明瞭 |
| CodeArena | 1676 | 1750 | +74 | 明瞭 |
| HealthBench | 39.6 | 60.0 | +20.4 | 非常に明瞭 |
| AutomationBench | 56.2 | 72.5 | +16.3 | 非常に明瞭 |
| Chartography | 42.0 | 54.2 | +12.2 | 明瞭 |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | 明瞭 |
| APEX-Agents | 63.3 | 72.1 | +8.8 | 明瞭 |
| HLE | 43.9 | 51.7 | +7.8 | 明瞭 |
| DeepSWE | 69.3 | 75.7 | +6.4 | 中程度 |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | 中程度 |
| Video-Index | 63.2 | 68.1 | +4.9 | 中程度 |
| ProgramBench | 28.0 | 31.5 | +3.5 | 小さい |
| JobBench | 65.3 | 68.5 | +3.2 | 小さい |
| BioMystery | 84.1 | 85.0 | +0.9 | ほぼ変化なし |
向上が最も集中しているのはエージェントとツール呼び出し系のタスクです。AutomationBench は +16.3、Terminal-Bench は +9.6、APEX-Agents は +8.8 となっています。多段階のツール呼び出しやターミナル操作、自動化フローが業務の中心であれば、ここがアップグレード効果の最も大きい領域です。HealthBench は 39.6 から 60.0 へ上昇し、Chartography も 12.2 伸びていることから、医療Q&Aとグラフ理解もこの世代の重点分野だと言えます。
一方、BioMystery はわずか 0.9 の上昇にとどまり、JobBench と ProgramBench も 3 ポイント強の伸びです。これらのタスクではアップグレードによる限界的な効果は限定的なので、主力シナリオがたまたまこれらに近い場合、ベンチマークスコアだけではアップグレードの判断材料として十分ではありません。むしろコストを重視すべきです。公式が別途示した Work360 は 52.69 対 47.74 で、4.95 高い水準にあり、こちらも中程度の向上に分類されます。
安全性については、公式が示した Last Secure Code Bench の関数レベルのダブルパス率が 22.0% から 31.8% へ、3粒度同時安全率が 8% から 14.7% へと向上しています。絶対値はいまだに高くはなく、生成コードには引き続きセキュリティレビューが必要ですが、相対的な伸びは明瞭です。
Arena サードパーティランキング:1,814票のPreliminary順位
公式のCodeArenaにおける1750点というスコアは、サードパーティのarena.ai Code Arena WebDevランキングでも確認できます。以下は公開ランキングのスナップショット(2026-11-14)です:
- Qwen4-Max(xHigh):1750点、6位、Preliminary表記あり、1,814票、タスクあたり$4.18
- Qwen3.8-Max(0902):1676点、16位、23,030票、タスクあたり$1.91
- Qwen3.8-Max:1670点、18位
ここで2つ目に誇張されやすいポイントは、Qwen4-Maxがわずか1,814票なのに対し、前世代の0902版は23,030票で、約12倍の差があることです。Preliminaryマークが付いているということは、順位がまだ収束しておらず、6位も変動しうるということです。現時点で引用する際は「暫定6位」と書くのがよいでしょう。
スナップショットにはもう1つ注目すべき細部があります。Qwen4-MaxはxHighティアで参加しており、タスクあたりコストは$4.18で、Qwen3.8-Max 0902の$1.91より高くなっています。これは公式の「タスクあたりコストの低下」という主張と矛盾しません。測定したティアもタスク種別も異なるからです。しかし、これは私たちに次のことを思い出させます。最高推論ティアでは、Qwen4-Maxが必ずしもコスト効率が良いとは限らない、と。
Qwen4-Max の価格とコスト:削減できる費用の何割が実際に効くのか
アップグレードは結局のところモデルの切り替えなので、決断する前にまず価格を比較すべきです。以下の表では、2世代の公式定価と、APIYIで現在販売中の qwen3.8-max の価格を比較します。単位はすべて1Mトークンあたり、価格取得日は2026-11-16です。
| 計費項目(1Mトークンあたり) | Qwen3.8-Max 公式(シンガポールリージョン) | Qwen4-Max 公式 | Qwen4-Max 公式 人民元 | APIYI qwen3.8-max 現在価格 |
|---|---|---|---|---|
| 入力 | $2 | $1.5 | ¥10 | $1.65 |
| 出力 | $6 | $4.5 | ¥30 | $4.95 |
| キャッシュ読み取り | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| キャッシュ書き込み(5分) | 公式ブログに記載なし | $1.875 | ¥12.5 | ドキュメントに個別記載なし |
| キャッシュ書き込み(1時間) | 公式ブログに記載なし | $3 | ¥20 | ドキュメントに個別記載なし |
入力・出力はいずれも25%値下げ、キャッシュ読み取りは$0.25から$0.075へと約70%の値下げとなっており、今回の価格改定で最も大きな項目です。一方、Qwen4-Maxでは5分と1時間の2種類のキャッシュ書き込み価格が明示されているため、長いプレフィックスを頻繁に再利用するアプリケーションでは、この書き込みコストを予算に含める必要があります。
トークン節約:2~3割はWork360、4~5割はTerminal-Bench
公式が示すトークン節約量には2組のデータがあります。Work360では、Xhighティアで24%減、Highティアで35%減となっており、これが「2~3割の節約」の根拠です。Terminal-Bench 4.0ではさらに大きく、それぞれ48%減、49%減となっています。
ターミナル系タスクでは節約幅が明らかに大きくなっています。これは、こうしたタスクでツール呼び出しのターン数が減ることと関係している可能性があります。予算策定では、一般的なオフィス作業系タスクは2~3割と見積もるのが無難で、4~5割はTerminal-Benchに近いターミナル操作のシナリオにのみ当てはまります。
62%と51%が一致しない、その11ポイント分
ここは最初に誇張されやすいポイントです。公式は1タスクあたりのコストが$4.43から$1.67に下がったとしており、ドル換算では約62%減です。一方、中国語の表記では¥26.58から¥11.16へ、約58%減とされています。この2つの数値基準自体が一致していません。
公式のデータから推算すると、トークンが35%減、単価が25%低下し、両者を掛け合わせても約51%の削減幅にしかなりません。つまり 0.65 × 0.75 ≈ 0.49 です。残りの約11ポイントについては公式の説明がありません。私たちは、キャッシュ読み取り価格の大幅な引き下げ(約−70%)によるキャッシュヒットの効果と、ツール呼び出しターンの減少に起因する可能性があると推測していますが、これはあくまで推測であり、公式の説明ではありません。
堅実なやり方は、51%を「同じキャッシュヒット率の下での」参考上限とみなし、62%はキャッシュヒット率が高く、ツール呼び出しのターン数が多いシナリオでのみ近づき得る値と考えることです。あなたの業務に当てはめる場合、最も信頼できる根拠は、実際のトラフィックで1タスクあたりのコスト比較を一度行ってみることです。
APIYI の現行価格と販売状況
APIYI では現在 qwen3.8-max を販売しています。入力 $1.65、出力 $4.95、キャッシュ読み取り $0.20625 で、ドキュメント上の表記は Alibaba Cloud の $2 / $6 より 17.5% 低くなっています。同じ価格帯には qwen3.8-max-0902 もあり、オープンウェイト版の qwen3.8-2.4t-a95b は $1.72 / $5.16 / $0.215 です。
2026-11-16 11:00 の再確認時点では、qwen4-max は APIYI のモデルドキュメントにも価格リスト(全 284 モデル)にもまだ存在せず、未掲載となっています。このモデルはできるだけ早く掲載する予定です。モデル名と価格は APIYI apiyi.com プラットフォームのモデル一覧を基準とします。正直なところ、Qwen4-Max の公式表示単価はすでに現行の qwen3.8-max のプラットフォーム価格を下回っているため、掲載後は価格を改めて突き合わせてみる価値があります。
Qwen3.8-Max から Qwen4-Max への移行:チェックリスト
アップグレードはモデル ID をひとつ変えるだけだと思われがちですが、実際にはデフォルトパラメータ、コンテキストの境界、キャッシュ課金まで変わります。以下のチェックリストは「変えないと問題が起きる」順に優先度を並べたものです。
| チェック項目 | Qwen3.8-Max の現状 | Qwen4-Max へ移行後 | 推奨アクション |
|---|---|---|---|
| モデル ID | qwen3.8-max / qwen3.8-max-0902 |
プラットフォームのモデル一覧に準拠 | 公開後に切り替え、まず段階的リリースで |
| reasoning_effort のデフォルト値 | xhigh | high | 設定値を明示し、挙動が知らぬ間に変わるのを避ける |
| max_tokens の上限 | 128K | 393K | 下流の切り捨て、ストレージ、タイムアウト設定を確認 |
| 最大入力 | 1M | 991K(思考モード 983K) | 1M に迫る超長入力はトリミングが必要 |
| キャッシュ課金 | キャッシュ読み取り $0.25 | キャッシュ読み取り $0.075、さらに 5分 / 1時間の書き込み料金あり | キャッシュプレフィックスと TTL 戦略を再評価 |
| ビジョン入力 | 画像入力 | ネイティブビジョン | 画像関連のユースケースを回帰テストし直す |
| プロンプトと出力形式 | 前世代向けにチューニング済み | アーキテクチャ変更で挙動が異なる可能性 | 固定の評価セットで回帰テスト |
| コスト監視 | token 単位で計測 | token と単価が同時に低下 | 単価ではなくタスクあたりのコストで見る |
このチェックリストで最も見落とされやすいのが reasoning_effort です。Qwen3.8-Max のデフォルトは xhigh、Qwen4-Max のデフォルトは high なので、コード内で明示的に設定していなければ、切り替え後に token が節約できる反面、複雑な推論タスクでは期待した効果が得られない可能性があります。公式の token 削減データは Xhigh と High の2段階で示されているので、この2段階それぞれでテストしたうえで、本番でどちらを使うかを決めるのがおすすめです。
次に出力長です。393K の上限は、1回のレスポンスがこれまでよりずっと長くなり得ることを意味します。ログシステム、データベースのフィールド、ゲートウェイのタイムアウトが 128K 出力を前提に設計されているなら、あらかじめ余裕を持たせる必要があります。最大入力は 1M から 991K(思考モード 983K)へと絞られました。普段から上限まで使い切っていない業務なら影響は小さいですが、上限ぎりぎりまでドキュメントを詰め込むような場面ではそのままエラーになります。
APIYI 経由で呼び出す現時点の方法
今 APIYI を利用している場合、base_url は https://api.apiyi.com/v1、OpenAI 互換プロトコルを使い、model フィールドに qwen3.8-max を入れれば本番でそのまま動かし続けられます。9月の刷新版の挙動に固定したい場合は、qwen3.8-max-0902 に切り替えられます。価格は同じです。
qwen4-max がプラットフォームで公開された後は、プロトコルが変わらないため、コード側の移行は model フィールドを書き換えるだけで済みます。あとは上記のチェックリストに従って reasoning_effort と max_tokens を補ってください。まず 5%–10% のトラフィックで段階的に切り替え、タスクあたりのコストと業務指標を比較してから全量に広げることをおすすめします。
🚀 移行のヒント:今 APIYI apiyi.com を使っているプロジェクトは、引き続き
qwen3.8-maxを使いながら、評価セットと段階的リリースの切り替えスイッチを用意しておきましょう。qwen4-maxが公開されたら ID を差し替える。こうすれば「新モデル待ち」で業務が空回りする事態を避けられます。
Qwen4-Max と Qwen3.8-Max のシーン別推奨
Qwen4-Max へのアップグレードを優先的に検討したいシーン
- マルチターンのツール呼び出しと自動化:AutomationBench、Terminal-Bench、APEX-Agents がいずれも大きく向上しており、トークン節約効果もターミナル系タスクで最大です。
- 超長出力タスク:1回で 128K を超えるレポート、コード、ドキュメントを生成する必要がある場合、393K に対応する Qwen4-Max しか選択肢がありません。
- 医療Q&Aとチャート理解:HealthBench +20.4、Chartography +12.2 は、この世代で最も改善が顕著な領域です。
- コードセキュリティに要件がある:セキュリティの二重通過率は 22.0% から 31.8% に向上しましたが、レビュープロセスとの併用は引き続き必要です。
- キャッシュ再利用率が高いアプリ:キャッシュ読み取り価格が約70%低下するため、長いシステムプロンプトや固定ナレッジベースのプレフィックスを使うシーンで最も効果を発揮します。
Qwen3.8-Max を引き続き使いたいシーン
- 本番環境で安定稼働し、プロンプトを徹底的にチューニング済み:Qwen3.8-Max は依然として信頼できる本番モデルであり、アップグレードのためのアップグレードは不要です。
- 主要タスクが BioMystery、JobBench に近い:これらの方向性は改善幅が限定的で、移行コストがメリットを上回る可能性があります。
- オープンウェイトでの自社デプロイが必要:Qwen3.8-2.4T-A95B にはオープンウェイトがありますが、資料では Qwen4-Max のオープンウェイト版には触れられていません。
- APIYI 経由で呼び出し、すぐに使いたい:
qwen4-maxがまだ提供開始されていない期間は、qwen3.8-maxがすぐ使える選択肢です。
| あなたの状況 | 推奨 |
|---|---|
| エージェントやツール呼び出しが中心で、コスト削減を追求 | Qwen4-Max を優先的に評価し、High ティアで実コストを測定 |
| 128K を超える単一出力が必要 | Qwen4-Max しか選択できない |
| 本番環境が安定しており、主に汎用Q&A | Qwen3.8-Max を維持し、空き時間に回帰評価を実施 |
| オープンウェイトでの自社デプロイが必要 | 引き続き Qwen3.8-2.4T-A95B を使用 |
| 現在 APIYI 経由で接続 | 引き続き qwen3.8-max を使い、提供開始後に段階的に切り替え |
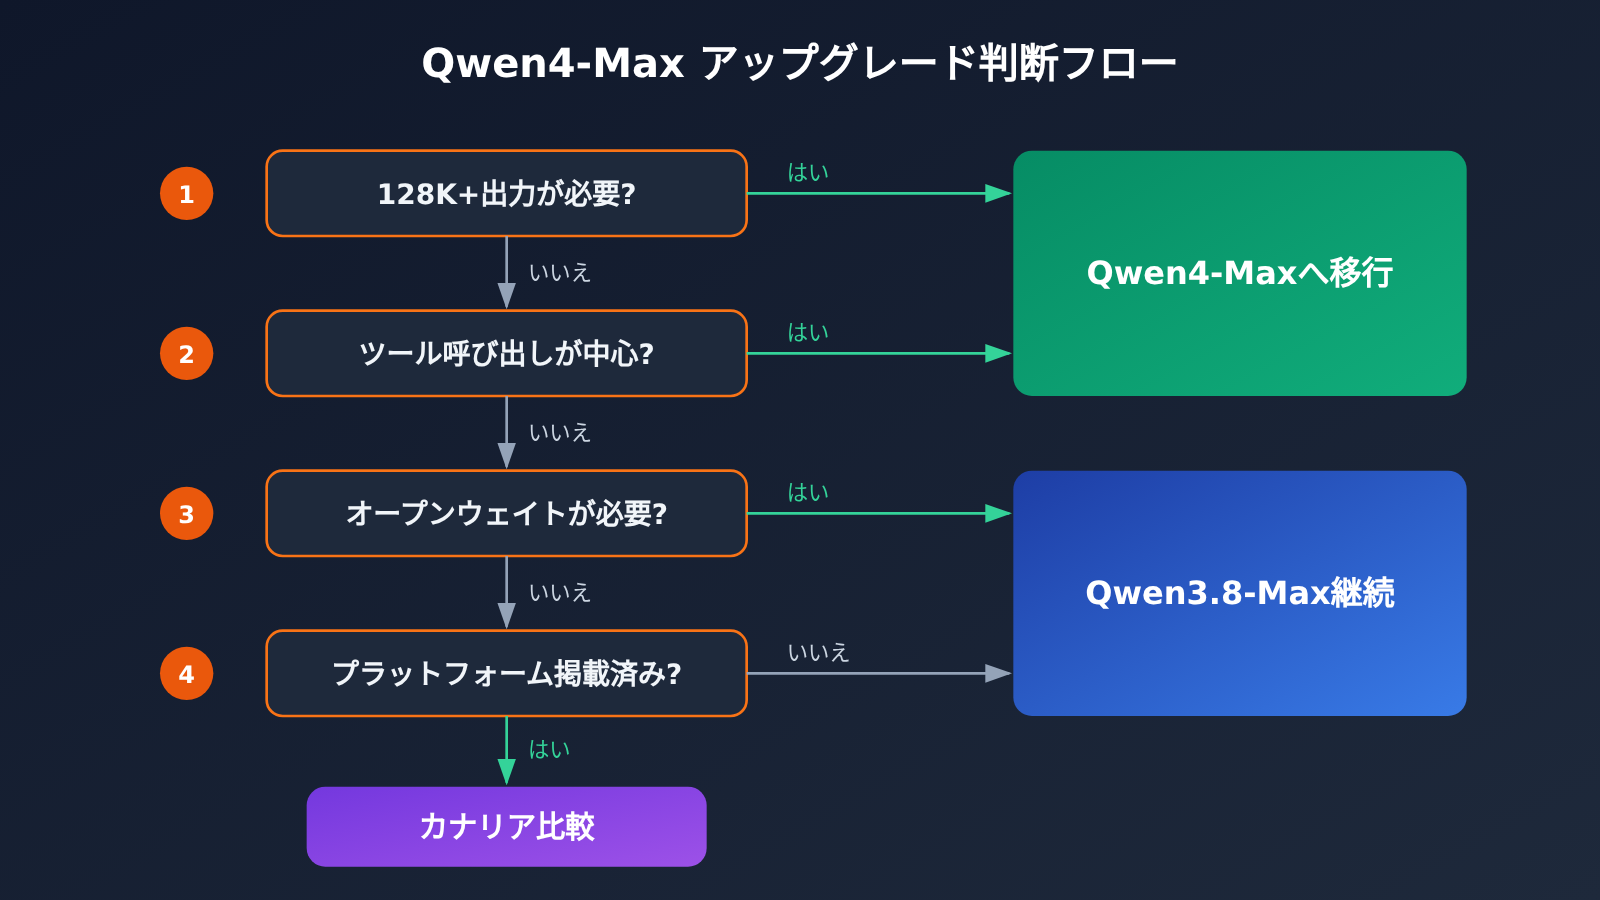
Qwen4-Max と Qwen3.8-Max の比較、導入判断のアドバイス
一言でまとめると:エージェント、長文出力、キャッシュ多用型の業務はアップグレードする価値あり。汎用的で安定運用中の業務は急がなくてよい。アップグレードによる3つのメリットのうち、単価25%減は確実です。トークン2〜3割削減は公式が特定のベンチマークで示したデータであり、タスク単価62%減という数字は、自社のキャッシュ状況とツール呼び出しのラウンド数が噛み合ってはじめて近づける値です。
💡 選択のヒント:意思決定の前に、実際の自分のタスクでそれぞれ1セットずつ実行し、タスク単価と結果の品質を比較することをおすすめします。ベンチマークの表だけを見るのではなく。APIYI(apiyi.com)なら同じAPIキーでまず
qwen3.8-maxのベースラインを計測でき、qwen4-maxが公開されたら同じコードのまま比較できます。
よくある質問(FAQ)
Q1:Qwen4-Max と Qwen3.8-Max はどんな関係ですか?
どちらも Qwen(通義千問)の2.4Tクラスのフラッグシップモデルです。Qwen3.8-Max は 2026-08-03 にリリースされ、0902 は9月のリフレッシュ版です。Qwen4-Max は 2026-11-16 にリリースされ、アーキテクチャが刷新されて1回あたりのアクティブパラメータは95Bから71Bに減り、出力上限は393Kに引き上げられ、定価は25%引き下げられました。
Q2:トークンが2〜3割減れば、請求額も2〜3割下がるのですか?
それ以上になることもあれば、そうならないこともあります。単価自体が25%下がり、さらにトークン削減が重なれば、理論上は同一タスクのコストを約51%下げられます。ただしトークン削減のデータは公式の Work360 評価に基づくもので、自社業務でどれだけ減るかは実測が必要です。xhigh 設定を使うと、Arena のスナップショットが示すように、かえってタスク単価が高くなる可能性もあります。
Q3:Qwen4-Max が Arena で6位というのは信頼できる順位ですか?
あくまで暫定的な結果です。公開リーダーボードのスナップショット(2026-11-14)では Qwen4-Max はわずか1,814票で Preliminary(暫定)と表示され、前世代の 0902 は 23,030票で、約12倍の差があります。スコア1750は公式の自己申告と一致していますが、票数が積み上がると順位は変動します。
Q4:今、APIYI 経由で qwen4-max を呼び出せますか?
2026-11-16 11:00 時点ではまだ利用できません。`qwen4-max` はまだ未提供ですが、できるだけ早く公開します。現在は `qwen3.8-max`、`qwen3.8-max-0902`、およびオープンウェイト版 `qwen3.8-2.4t-a95b` が利用可能です。最新のモデル名と価格は APIYI(apiyi.com)のモデル一覧を基準にしてください。新規ユーザーは無料のテスト枠でベースラインを計測できます。
Q5:移行の際、モデルIDを変えるだけで十分ですか?
それだけでは足りません。少なくとも reasoning_effort を明示的に設定し(デフォルト値が xhigh から high に変更)、必要に応じて max_tokens と下流のストレージ制限を緩め、1M に近い超長入力がないか確認し、キャッシュ書き込みコストを再評価する必要があります。プロトコル面では、OpenAI互換インターフェース `https://api.apiyi.com/v1` を使っていれば、コードは model フィールドを変えるだけです。
Q6:Qwen3.8-Max は引き続き使う価値がありますか?
あります。依然として2.4Tクラスのフラッグシップで、1Mコンテキスト、128K出力、思考モードと非思考モードが揃っており、オープンウェイト版もあります。Qwen4-Max は BioMystery や JobBench などのベンチマークでの改善がごく小さいため、そうした業務では安定稼働している Qwen3.8-Max がそのまま本番トラフィックを担ってまったく問題ありません。
Qwen4-Max と Qwen3.8-Max の比較:主なポイント(Key Takeaways)
- 規模は同等、アクティブパラメータは削減:2.4T のバックボーンは変わらず、1回あたりのアクティブパラメータは 95B から 71B に減少し、約25%減となります。
- 単価は25%低下:入力 $2→$1.5、出力 $6→$4.5、キャッシュ読み取りは約70%低下、キャッシュ書き込みの課金を新設。
- 出力は約3倍に:最大出力 128K→393K、最大入力は 991K に縮小。
- 改善はエージェント系に集中:AutomationBench、Terminal-Bench、HealthBench は顕著に向上、BioMystery はほぼ横ばい。
- 誇張してはいけない2点:62%のコスト削減幅から導けるのは約51%まで、Arena の6位はわずか1,814票で、しかも Preliminary 段階です。
- 移行はIDの付け替えだけではありません:reasoning_effort のデフォルト値、max_tokens の上限、キャッシュ戦略に注意。
- APIYI の現状:
qwen4-maxはまだ提供されていません。引き続きqwen3.8-maxを使用し、提供開始後に段階的なロールアウトで切り替えます。
まとめ
Qwen4-Max と Qwen3.8-Max の比較から得られる主な結論:
- コスト:単価25%低下は確実なメリットです。トークン削減の2〜3割は、自社業務での実測値を基準に判断してください。62%の削減幅のうち約11ポイントは出所が不明です。
- 能力:エージェント、ツール呼び出し、医療・グラフ分野では顕著に向上し、一部のベンチマークはほぼ横ばいです。スコアはいずれも公式の自己申告値です。
- 移行:プロトコルは変わりませんが、デフォルトの推論レベル、出力上限、キャッシュ課金はすべて変更されています。チェックリストに沿って項目ごとに確認する必要があります。
Qwen3.8-Max は引き続き信頼できる本番モデルです。アップグレードはデータに裏付けられた段階的ロールアウトの判断であるべきで、新バージョンが出たらすぐ全量切り替える、というものではありません。まず APIYI apiyi.com を通じて qwen3.8-max でコストと品質のベースラインを確立し、qwen4-max の提供開始後は同じインターフェース上で直接比較することをおすすめします。
📚 参考資料
- Qwen3.8 公式ブログ:Qwen3.8-Max のリリースノート。パラメータ、コンテキスト、公式価格を掲載
- リンク:
qwen.ai/blog?id=qwen3.8 -
説明:前世代の仕様とシンガポールリージョンにおける価格の出典
-
Hugging Face – Qwen3.8-2.4T-A95B:Qwen3.8 のオープンウェイト版
- リンク:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
説明:セルフデプロイ時に必要となるモデルカードと重みのダウンロード
-
Qwen 公式ブログ:Qwen4-Max のリリース記事と同一画像によるベンチマーク比較
- リンク:
qwen.ai/blog -
説明:アーキテクチャの変更、公式が自己申告したスコア、トークン数およびタスクあたりのコストデータの出典
-
arena.ai Code Arena WebDev:サードパーティ製モデルの対戦ランキング
- リンク:
arena.ai - 説明:本記事は 2026-11-14 時点のスナップショットを引用しており、順位は投票数に応じて変動します
作者:APIYI 技術チーム
技術交流:APIYI ウェブサイトのトップページからお気軽にお問い合わせください。モデルと価格は docs.apiyi.com のドキュメントセンターでご確認いただけます


