
節約は可能ですが、条件があります。 Google 公式ドキュメントに示された2つの仮定ケースによると、ツール200個・基本コンテキスト2,000トークンのシナリオでは、Gemini Tool Retrieval の入力トークンが164,000から23,650へ減少し、約85.6%削減されます。ツール10個・基本コンテキスト30,000トークンのシナリオでは、入力トークンが68,000から92,830へ増加し、約36.5%増えます。費用対効果があるかどうかは、1つの問いにかかっています。すなわち、削減された完全なツールSchemaが、サーバー側検索によって追加発生するコンテキストオーバーヘッドを相殺できるかどうかです。
この記事を読むと、次のことが分かります。
- Tool Retrieval がどの部分のトークンを削減し、どの部分のトークンを新たに追加するのか。
- 公式のツール200個ケースとツール10個ケースについての完全な前提条件と項目ごとの内訳。
- 公式パラメータに基づいて導出した損益分岐点の計算式、および「ツール数がいくつになれば有効化する価値があるか」の判断方法。
interaction.usageフィールドとキャッシュルールを使って、1回の Agent タスクの実際のコストを計算する方法。
索引:まず概念表と影響の概要で用語を統一し、自分がどのタイプの読者に当たるかを判断できるようにします。「客観的事実」の部分では、Google が公表したメカニズム、課金ルール、2つの算例の原文の前提を説明します。「分析・判断」の部分では、公式パラメータに基づいて導出した臨界点、3種類の「節約」の違い、単一タスクの請求計算式、有効化の判断表を示します。
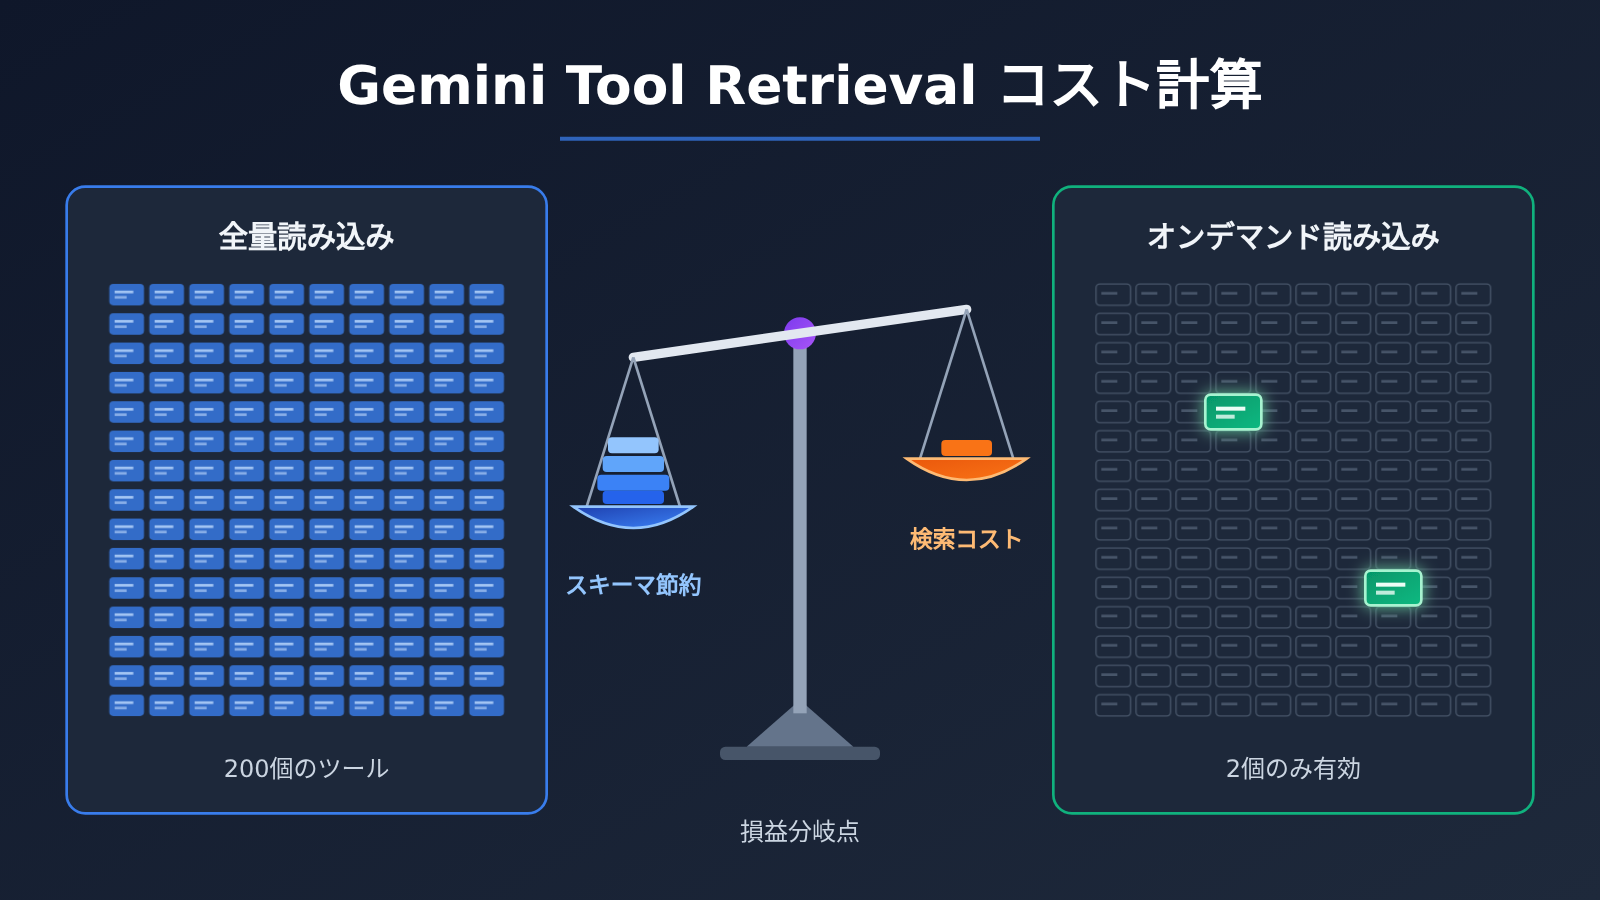
Gemini Tool Retrieval コスト分析の勘所:概念の解説
| 概念 | 簡単な説明 |
|---|---|
| 入力トークン | モデルに渡して処理させるテキスト、過去のコンテキスト、ツール宣言などの計量単位 |
| ツールスキーマ | モデルが関数呼び出しを生成する際に参照する完全なパラメータ定義。試算例では1つあたり約400トークン |
| 遅延ツールリスト | defer_loading: true を設定した後、モデルが最初に見るのはツール名と簡単な説明のみ。公式の初期テストでは1項目あたり約26トークン |
| 基礎コンテキスト B | 試算例において、毎回のモデル呼び出しで元々処理する必要がある履歴とタスク情報 |
| 検索後の推論 | サーバー側でツールを検索した後、既存のコンテキストと追加されたスキーマを伴って実行されるもう1回のモデル呼び出し |
total_tool_use_tokens |
同一リクエスト内で、サーバー側ツールと検索によって発生する追加のモデル呼び出し入力量 |
total_cached_tokens |
入力使用量のうち、キャッシュで処理され、キャッシュ料金で課金される部分 |
| 損益分岐点 | 同じ前提条件のもとで、静的ロードとオンデマンドロードの入力コストが等しくなる境界 |
| 1つの成功タスクあたりのコスト | 1つの業務目標を達成するためにかかった、各ラウンドのモデル呼び出しとツール費用の合計 |
Gemini Tool Retrieval の影響をひと目で
- 大規模なツールライブラリを組み込む Agent 開発者:ツールが多く、1回のタスクでごく一部しか使わない場合、重複入力によるスキーマコストを大幅に削減できる可能性があります。これは公式の200ツール試算例に対応するシナリオです。
- ツールセットが小さく、コンテキストが長いアプリ開発者:サーバー側検索のたびに追加のモデル推論が走り、長いコンテキストを再処理することになるため、有効化するとかえってコストが高くなる可能性があります。公式の10ツール試算例がまさに反例です。
- コスト計算を担当するエンジニアや FinOps 担当者:初回リクエストの
total_input_tokensだけを見ているとコストを過小評価してしまいます。total_tool_use_tokens、キャッシュヒット、出力トークンも併せて計上する必要があります。 - 企業のツールレジストリを運用するプラットフォームチーム:クライアント側検索モードでは、自社の権限フィルタや動的ツールと組み合わせられますが、検索のたびに API の往復が1回増えるため、コストの基準は別途評価する必要があります。
客観的事実:Gemini Tool Retrieval のリリースと課金メカニズム
Gemini Tool Retrieval とは何か、いつリリースされたか
2026年11月19日、Google は公式ブログで Gemini Interactions API における Tool Retrieval プレビュー機能の提供開始を発表しました。この機能は Preview 段階にあり、v1beta API バージョンを使用する必要があります。旧来の generateContent メソッドはサポートされていません。サーバーサイドモードの有効化方法は、tools に {"type": "tool_search"} を追加し、遅延読み込みしたい function または mcp_server に defer_loading: true を設定することです。
開発者ドキュメントで2026年11月20日時点に明確に記載されている対応モデル ID は次の4つです:gemini-4-hydrogen、gemini-4-argon、gemini-3.8-flash、gemini-3.6-flash。発表の「Gemini 3.6 以降のモデル」という表現のほうが広範ですが、ドキュメントに記載されていないモデルについては自身で検証する必要があり、サポートされていないモデルに defer_loading を設定すると HTTP 400 が返されます。
誤解しやすい点を一つ強調します。サーバーサイドモードでは、previous_interaction_id を使用した場合でも、開発者は各リクエストで遅延ツールの完全なパラメータを含む tools 配列全体を送信する必要があります。Tool Retrieval が変えるのは、完全なスキーマがモデルのコンテキストに入るタイミングであり、リクエストボディでこれらの定義を送信しなくなるわけではありません。
静的ローディングと Gemini Tool Retrieval のコストはどこから生まれるのか
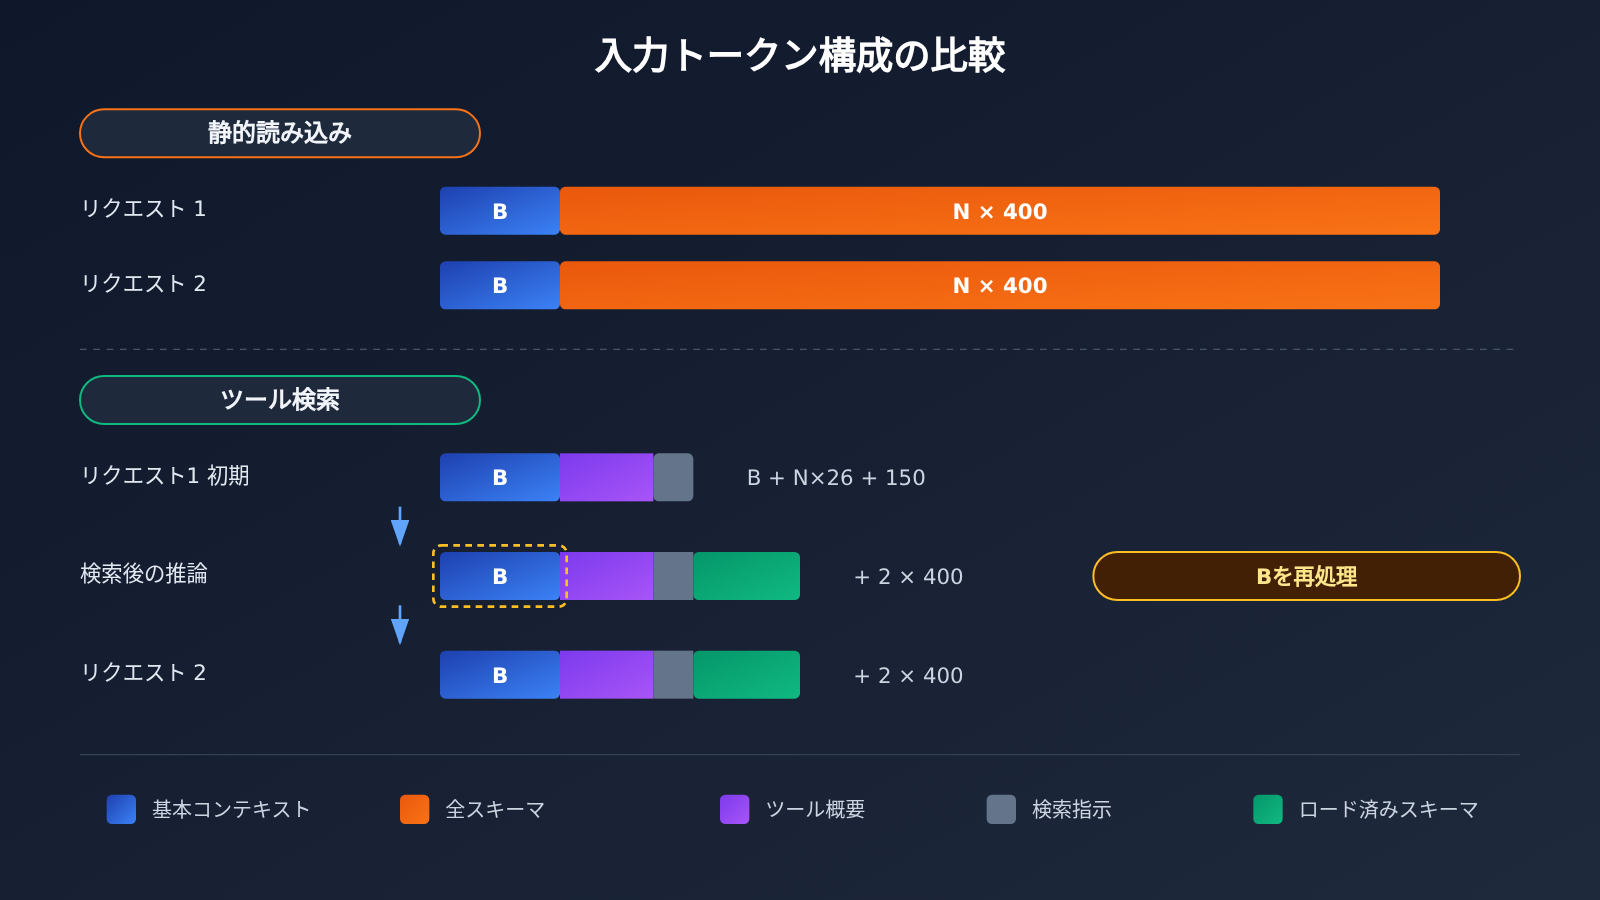
静的ローディングでは、モデル呼び出しのたびに全ツールの完全なスキーマを読み込む必要があります。たとえそのラウンドで返金用の関数を1つだけ使うとしても、この負担は変わりません。Tool Retrieval は、そうした完全な定義を短いツールリストで置き換える仕組みです。モデルが必要と判断すると tool_search_call を発行し、サーバー側が完全なスキーマを含む tool_search_result を返します。モデルはそれを基に function_call を生成します。
Google は Tool Retrieval に独立した機能料金は発生しないと明言しています。ただし、以下の項目は引き続き選択したモデルの料率で課金されます。
- 遅延対象となるすべてのツールの短いリスト項目。
tool_searchを有効にしたときに追加される固定の検索指示。- サーバー側の検索ごとに発生する追加のモデル推論。これは完全なコンテキストと、新たにロードされたスキーマを再処理します。
- ロードされたツールの完全なスキーマと、以降のラウンドにおける継続的な占有(現行ドキュメントにはアンロードの仕組みが記載されていません)。
- 通常の出力、Thinking、ツール実行結果に関わるトークン。
Gemini Tool Retrieval の公式算例:200 ツールと 10 ツール
2 組の算例はどちらも Google の Tool Retrieval ドキュメントに由来し、公式に明記された仮定ベースの計算例です。本番環境でのベンチマークではなく、出力トークンとキャッシュによるメリットも無視しています。共通の前提は次のとおりです。完全なスキーマ 1 件あたり 400 トークン、遅延ツールの要約 1 件あたり約 26 トークン、検索指示 150 トークン、1 回のタスクに外部リクエストが 2 回、最初のリクエスト内でサーバー側検索を 1 回実行し、合計 2 つのツールを読み込みます。
| 計算項目 | 200 ツール、B=2,000 | 10 ツール、B=30,000 |
|---|---|---|
| 静的読み込み:2 ×(B + N × 400) | 164,000 | 68,000 |
| リクエスト 1 の初期入力(B + N × 26 + 150) | 7,350 | 30,410 |
| リクエスト 1 の検索後推論(さらに 2 つのスキーマを加算) | 8,150 | 31,210 |
| リクエスト 2 の入力 | 8,150 | 31,210 |
| Tool Retrieval 合計 | 23,650 | 92,830 |
| 変化量 | -140,350 | +24,830 |
| 変化幅(公式の数値から再計算) | 約 -85.6% | 約 +36.5% |
200 ツールのシナリオで節約が顕著なのは、静的方式では毎回 80,000 トークン分のツール定義を抱え込む必要がある一方、基本コンテキストは 2,000 トークンしかなく、検索によって推論をもう 1 回実行するコストが小さいためです。10 ツールのシナリオは逆で、ツール定義の合計はわずか 4,000 トークンなので節約できる余地は限られています。さらに検索後の推論では 30,000 トークンの長いコンテキストをもう一度処理する必要があり、新たに発生するオーバーヘッドが節約分を直接上回ります。
Gemini Tool Retrieval の Usage フィールド、価格、キャッシュルール
Google は interaction.usage の中で、Tool Retrieval のコストを分析するために必要なフィールドを提供しています。
| フィールド | 意味 | コスト分析での役割 |
|---|---|---|
total_input_tokens |
リクエスト内で最初のモデル呼び出しの入力 | 「初期コンテキストがどれだけ短くなったか」しか反映できない |
total_tool_use_tokens |
サーバー側ツールと検索が引き起こした追加のモデル呼び出し入力 | 検索コストの主な発生源であり、もっとも見落とされやすい |
total_cached_tokens |
入力にすでに含まれ、キャッシュで処理された部分 | キャッシュ料率で計算され、重複して加算することはできない |
total_output_tokens |
モデルが生成した出力 | 出力料率で計算 |
total_thought_tokens |
推論過程で生成されたトークン | 選択したモデルの出力料率で計算 |
価格面について見ると、Google の料金ページにある Standard 標準価格では、Gemini 4 Hydrogen の入力が100万トークンあたり $1.50、出力(Thinking を含む)が $7.50、キャッシュ入力が $0.075 です。この入力単価だけで公式の算例を算術換算すると、ツール200個のシナリオでは約 $0.246 対 $0.0355、ツール10個のシナリオでは約 $0.102 対 $0.139 になります。ただしこれは仮定のトークン数に公式料率を掛けただけのものであり、実際の請求額ではありません。
キャッシュルールには2つのしきい値があり、それぞれ別に理解する必要があります。第一に、Interactions API は暗黙的キャッシュのみをサポートしており、2026年11月20日時点で、Gemini 4 シリーズ、Gemini 3.8 Flash、Gemini 3.6 Flash の暗黙的キャッシュの最低入力規模はいずれも 4,096 トークンです。第二に、Gemini 4 のマルチターン対話と Agent Loop では、新しいリクエストに少なくとも 2,050 トークンを追加すると、システムが前回のリクエスト全体をキャッシュします。不足する場合、前回リクエスト末尾の 2,050 トークンは標準入力価格で再課金され、モデル出力、Thinking、関数の結果もこの追加量に含まれます。
資料の確認日時点で、Google は Tool Retrieval が実際のタスクセットにおいてトークンをどれだけ節約できるか、レイテンシの改善幅、ツール選択の精度向上について公表しておらず、十分に検証可能な独立開発者の本番実測も見られません。
分析と判断:Gemini Tool Retrieval が本当にトークンを節約できるのはどんなときか
Gemini Tool Retrieval の損益分岐点:ツール数がいくつになると有効化する価値があるか
以下は公式の計算例のパラメータに基づいて導出した拡張例であり、Google が公開している汎用的なしきい値ではありません。N をツールの総数、B をベースコンテキストとし、S=400、D=26、H=150、K=2 および「2回のリクエスト、1回の検索」という前提を踏襲します:
- 静的読み込み:T_static = 2 ×(B + 400N)
- オンデマンド読み込み:T_retrieval = 3 ×(B + 26N + 150)+ 2 × 2 × 400
この式は公式の2組の結果を完全に再現できます。T_retrieval < T_static と置いて整理すると、722N > B + 2050、すなわち N > (B + 2050) / 722 が得られます。ここでの 2050 は 3 × 150 + 1600 に由来する単なる代数の結果であり、キャッシュに関するドキュメントで示されている Gemini 4 のマルチターンキャッシュの 2,050 トークン増加条件とは一切関係ありません。混同しないでください。
| ベースコンテキスト B | ツール数 N | 静的読み込み | Tool Retrieval | 変化 | 変化率 | データ属性 |
|---|---|---|---|---|---|---|
| 2,000 | 200 | 164,000 | 23,650 | -140,350 | -85.6% | 公式の計算例 |
| 30,000 | 10 | 68,000 | 92,830 | +24,830 | +36.5% | 公式の計算例 |
| 30,000 | 44 | 95,200 | 95,482 | +282 | +0.3% | 拡張導出 |
| 30,000 | 45 | 96,000 | 95,560 | -440 | -0.5% | 拡張導出 |
| 30,000 | 50 | 100,000 | 95,950 | -4,050 | -4.1% | 拡張導出 |
| 30,000 | 100 | 140,000 | 99,850 | -40,150 | -28.7% | 拡張導出 |
B=30,000 の場合、臨界値は N > 44.39 となり、45 個目のツールからオンデマンド読み込みがわずかに有利になります。しかも臨界点付近では節約効果はほとんど無視できます。同じ式で B=2,000 とすると、臨界値は約 5.6、つまり 6 個のツールで形勢が逆転します。このことから、ベースコンテキストが長いほど、検索時にコンテキストを再処理するコストを分散させるために、より大きなツールライブラリが必要になることがわかります。
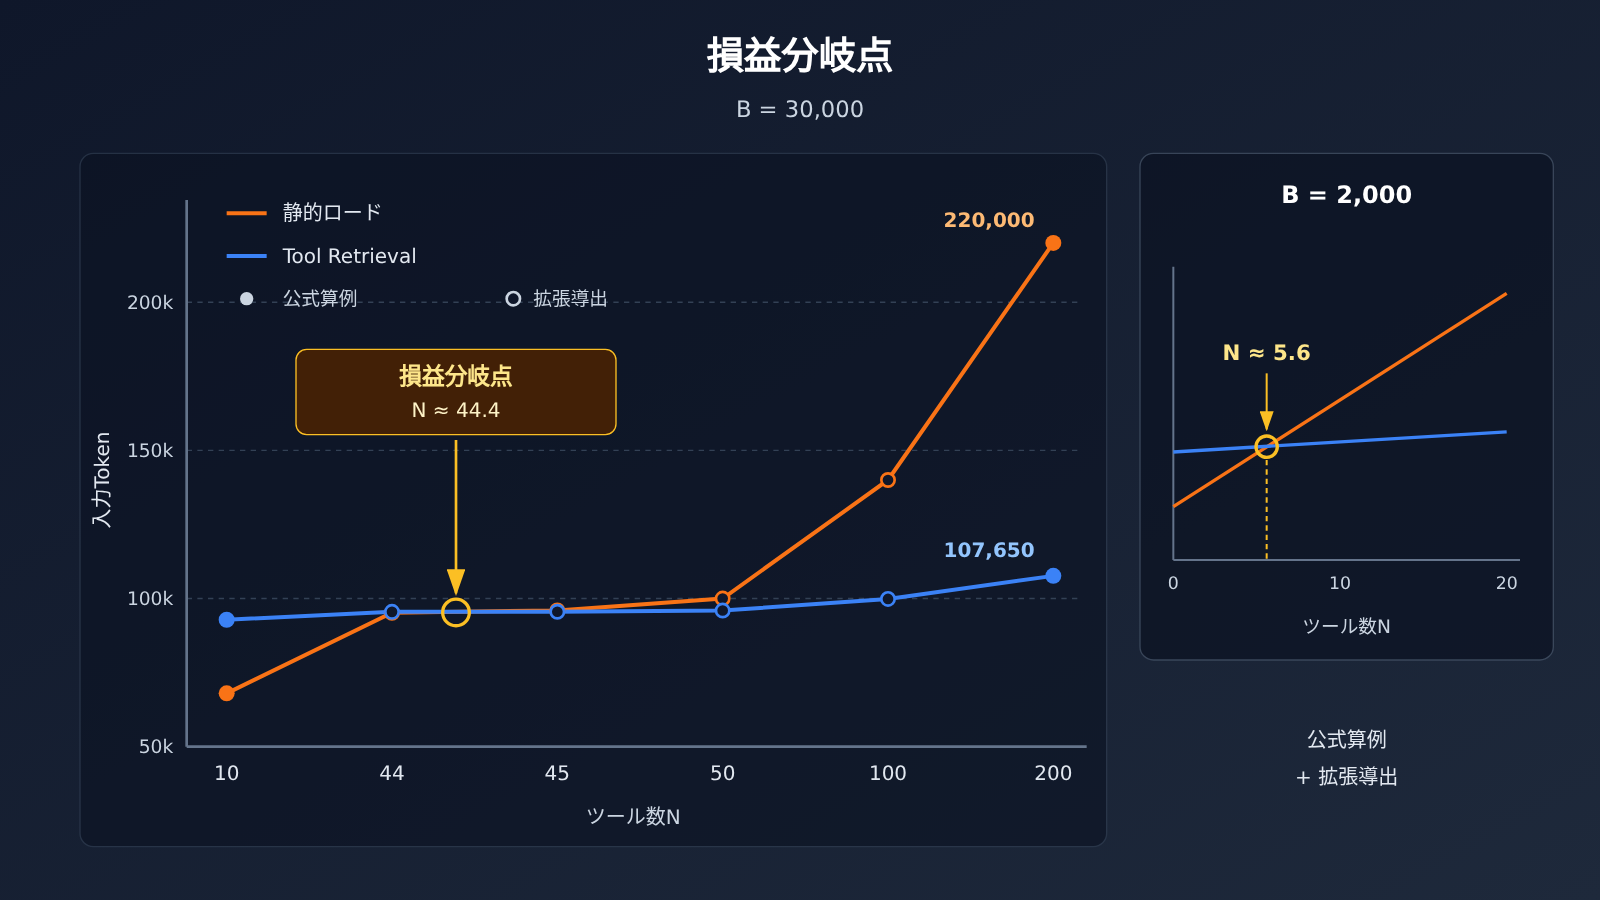
図注:最初の2行のデータは Google の公式計算例で、残りは同じ前提に基づく導出です。実際のタスクでは検索回数や読み込み数によって曲線が変わるため、自社の業務リクエストで再測定することをおすすめします。APIYI apiyi.com の統合インターフェースを使えば、複数モデルの静的読み込みベースラインをすばやく立ち上げて比較できます。
実際のタスクがこの一連の仮定に厳密に当てはまることはほとんどなく、次の変数によって臨界点は移動します:
- 検索回数:サーバー側検索が1回増えるたびに、「B + ツールリスト + 読み込み済みスキーマ」に近い規模のモデル入力が1回増えます。長いコンテキストのシナリオでは、毎回 B をもう一度支払うのと同じです。
- 実際の読み込み数 K:読み込むツールが多いほど節約量は少なくなります。読み込み済みのスキーマはアンロードできず、長い会話では蓄積し続けます。
- 個々のスキーマサイズ S:パラメータが複雑で説明が冗長なツールほど、オンデマンド読み込みのメリットは大きくなります。スキーマが非常に短い場合、メリットはリスト項目と検索指示に食われてしまいます。
- 会話ターン数:静的方式では各ターンで全スキーマを繰り返す必要があります。ターン数が多く、かつ新たな検索が発生しないほど、オンデマンド読み込みの優位性は明確になります。
入力Token削減、総課金減少、レスポンス高速化:Gemini Tool Retrievalの3つの「節約」
これら3つはよく混同されますが、等価ではありません。入力Tokenの削減は最も直感的ですが、total_input_tokens だけを見ると、total_tool_use_tokens に記録される検索後の推論を見落とし、節約幅を過大評価してしまいます。
総課金の減少はキャッシュと単価にも依存します。オンデマンド読み込みにより初期プロンプトが短くなりますが、元々大量のSchemaで4,096 Tokenの暗黙的キャッシュ閾値を超えていた場合、有効化によって逆にキャッシュを失う可能性があります。関数呼び出しと結果返却の短いループで、新規コンテンツが2,050 Token未満の場合、Gemini 4も前回リクエストの完全なキャッシュを取得できません。つまり、Tokenは減っても単価構造が悪化する可能性があるのです。
レスポンス高速化については、現在公式・独立系のいずれのデータも存在しません。サーバー側検索はクライアントの往復を増やしませんが、リクエスト内部では実際にモデル推論が余分に走ります。クライアント側検索では、検索ごとにAPI往復が1回増えます。レイテンシが速くなるか遅くなるかは、自身のエンドツーエンドテストでしか答えられません。
Gemini Tool Retrievalエージェントタスクの実際の請求額を計算する方法
公式のUsageセマンティクスに基づき、標準課金、キャッシュTokenが入力に含まれている、その他の従量課金ツールがないという前提で、単一リクエストは次のように概算できます:
USD ≈ [ (I + U − C) × P_in + C × P_cache + (O + T) × P_out ] / 1,000,000
ここでI、U、C、O、Tはそれぞれ上表の5つのフィールドに対応します。エージェントタスクは複数リクエストにまたがることが多く、各リクエストのUsageを合計してから計算し、最終的に「総コスト ÷ 成功したタスク数」で1成功タスクあたりのコストを求めます。
Tool Retrievalを有効化する前に、静的読み込みのベースラインを測定するのが最も確実な方法です。以下ではOpenAI互換インターフェースで静的Function Callingを1回実行し、ベースラインUsageを記録します:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI 統一インターフェース、静的読み込みベースラインの実行用
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",  # モデル名はプラットフォームのモデルリストに準拠
    messages=[{"role": "user", "content": "Refund 40 USD for order A-1042."}],
    tools=[{"type": "function", "function": {"name": "issue_refund",
            "parameters": {"type": "object", "properties": {
                "order_id": {"type": "string"}, "amount": {"type": "number"}},
                "required": ["order_id", "amount"]}}}]
)
print(resp.usage)  # 静的フルロード時の入力・出力Tokenを記録
注意すべき点として、Tool Retrieval自体はGoogle Interactions APIのv1betaバージョンに依存しています。上記の例は静的読み込みの対照データ取得のみに使用し、オンデマンド読み込み側ではInteractions APIをサポートする呼び出し方法を使用し、両方のUsageを同じコスト式に入れて比較してください。
完全な実装コードを表示:損益分岐点推算 + Usage請求額估算
import openai

# ---------- 1. 公式の計算例に沿った理論試算(拡展示例、公式のしきい値ではない) ----------
def static_tokens(B: int, N: int, S: int = 400) -> int:
    return 2 * (B + N * S)

def retrieval_tokens(B: int, N: int, D: int = 26, H: int = 150,
                     K: int = 2, S: int = 400) -> int:
    return 3 * (B + N * D + H) + 2 * K * S

def breakeven_tools(B: int) -> float:
    return (B + 2050) / 722  # S=400、D=26、H=150、K=2 の場合にのみ成立

for B, N in [(2000, 200), (30000, 10), (30000, 45), (30000, 100)]:
    s, r = static_tokens(B, N), retrieval_tokens(B, N)
    print(f"B={B:>6} N={N:>3} static={s:>7} retrieval={r:>7} "
          f"change={(r - s) / s:+.1%}")
print("B=30000 临界工具数:", round(breakeven_tools(30000), 2))

# ---------- 2. Usage フィールドから1リクエストあたりの費用を試算(米ドル) ----------
def request_cost(I, U, C, O, T, p_in, p_cache, p_out) -> float:
    """I/U/C/O/T はそれぞれ total_input / tool_use / cached / output / thought tokens に対応"""
    return ((I + U - C) * p_in + C * p_cache + (O + T) * p_out) / 1_000_000

# 例:Gemini 4 Hydrogen の標準価格 1.50 / 0.075 / 7.50(100万トークンあたり)
print(request_cost(I=7350, U=8150, C=0, O=200, T=0,
                   p_in=1.50, p_cache=0.075, p_out=7.50))

# ---------- 3. 静的ローディングのベースライン(OpenAI 互換インターフェース) ----------
client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def run_static_baseline(prompt: str, tools: list, model: str = "gemini-3.8-flash"):
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
        tools=tools
    )
    return resp.usage  # 複数ターンのタスクを集計する場合は、リクエストごとに累積加算
🚀 クイックスタート:まずは APIYI apiyi.com で1つの Key を使って静的ローディングのベースラインを動作させ、実際の業務タスクセットにおける Token と完了率を記録してから、Agent をオンデマンドローディングへ移行するかどうかを判断することをおすすめします。公式の参考数値だけでアーキテクチャを直接変更するのは避けましょう。
Gemini Tool Retrieval の有効化判断:あなたのツールライブラリは条件を満たしているか
公式のエンジニアリング推奨と上記の導出を総合すると、まず次の表で初期判断ができます。最終的には、実際のタスクにおける「1件あたりの成功コスト」と完了率を基準にしてください。
| ワークロードの特徴 | 推奨戦略 | 理由 |
|---|---|---|
| 約20個未満の安定したツールで、その多くを毎ラウンド使う | 静的読み込みを継続 | 公式推奨。節約できるスキーマが少なく、検索オーバーヘッドの割合が高い |
| ツールは少ないが、ベースのコンテキストが非常に長い | 静的読み込み、または少数の大きなスキーマのツールだけを遅延読み込み | 検索のたびに長いコンテキストを再処理する。10ツールの算例がまさに反例 |
| 数十から100個程度のツールで、1回に少数しか使わない | サーバー側検索を優先的に評価 | 大規模なロングテールのツールライブラリが、公式の200ツール算例に対応するシナリオ |
| 高頻度ツール+大量の低頻度専門ツールの混在 | 高頻度は直接読み込み、低頻度は defer_loading |
公式推奨のハイブリッド用法。単純なタスクでもまず検索してしまうのを避ける |
| マルチテナント、動的ツール、ユーザー権限によるフィルタリングが必要 | クライアント側検索を評価 | 自前のレジストリを接続できるが、検索のたびに往復が1回増える |
| システム指示で頻繁に名前が挙がるツール | 直接読み込みを維持 | 公式の注意点。名前を挙げられた遅延ツールは検索をバイパスして直接呼び出され、エラーになる可能性がある |
💡 選択のヒント:同じタスク群を静的とオンデマンドの2つの方式でそれぞれ実行し、モデル、ツールライブラリ、コンテキスト長、キャッシュ条件を揃えます。APIYI apiyi.com なら統一インターフェースの下で異なる Gemini やその他の主要モデルを切り替えてベースライン比較ができるため、コスト差をツール読み込み戦略そのものに帰属させやすくなります。
さらに、請求額に直接影響するエンジニアリング上の細部がいくつかあります。store=false で履歴を自前管理する場合、tool_search_call、tool_search_result およびその signature をそのまま保持しなければならず、そうしないと後続のリクエストで HTTP 400 が返される可能性があります。リクエストボディを小さくするために遅延ツールの parameters を省略することはできません。デバッグ時は interaction.status だけを見るのではなく、interaction.steps 内の function_call を確認する必要があります。これらの問題がリトライを引き起こすと、重複リクエストのトークンもコストに計上されます。
結局のところ、Tool Retrieval は「少数のツールが頻繁に使われ、大多数のツールが長期間使われない」という前提に立つコスト最適化のためのツールです。公式の相反する2つの算例がすでに境界を明示しています。ツールライブラリが大きいほど、コンテキストが短いほど、検索回数が少ないほど、節約できる可能性が高くなります。逆の場合はコストが増える可能性があります。本当に最適化すべきなのは初回リクエストのトークン数ではなく、成功したタスク1件あたりの総コストです。
清の陳澹然が『寤言・遷都建藩議』に記したように、「全局を謀らない者は、一域を謀るに足らない」。
参考資料
- Google 公式発表:Introducing Tool Retrieval in the Gemini API(2026-11-19)
- リンク:
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- リンク:
- Google Tool Retrieval 技術ドキュメント:設定、課金、公式サンプル、制限事項
- リンク:
aistudio.google.com/docs/tool-retrieval
- リンク:
- Google Context caching ドキュメント:暗黙的キャッシュのしきい値と Gemini 4 のマルチターンキャッシュ規則
- リンク:
aistudio.google.com/docs/caching
- リンク:
- Google Gemini Developer API 価格設定:モデルの入力・出力・キャッシュ料金
- リンク:
aistudio.google.com/docs/pricing
- リンク:
作者: APIYI 技術チーム
技術交流: Gemini など複数モデルを Agent シナリオで利用した際の Token コストを比較したい方は、APIYI apiyi.com にアクセスしてテスト用の枠を取得してください。接続方法の詳細は docs.apiyi.com のドキュメントセンターをご覧ください


