
企業エージェントは、繰り返し発生するタスクのたびに大規模言語モデルを呼び出す必要はありません。CVS Healthがオープンソース化した CUA Agent Kit は、より経済的なエンジニアリング手法を示しています。まずComputer-use Agentに未知の業務プロセスを探索させ、成功した過程をスクリーンショット、イベント、Traceとして記録します。次にCodexがそれらの証拠を、検証可能で保守しやすく、繰り返し実行できる決定論的コードへ変換します。
この手法は、AIの柔軟な探索能力と従来の自動化が持つ安定した実行能力を組み合わせ、「AIが探索し、コードで固定化し、継続的に保守する」ハイブリッドアーキテクチャを形作ります。エージェントがスクリプトに取って代わるのではなく、エージェントがスクリプトを書き、スクリプトを修正するのです。
この記事を読むとわかること
- CVS Health CUA Agent Kitが、AI探索からコード固定化までの2段階プロセスをどう実現するか
- スクリーンショット、events.jsonl、Trace、セマンティックロケーターが固定化の段階でそれぞれどんな役割を果たすか
- 固定化されたフローが大規模言語モデルを呼び出さずにどう動作し、異常発生後にどう保守するか
後半の客観的事実のパートでは、CUA Agent Kitの仕組み、AI操作からPlaywrightコードの間に何が起きるか、固定化後もエージェントが担う保守作業、このアーキテクチャと従来のRPAとの違いに関する研究上の根拠、開発者がどう実際に再利用を始められるかを順に説明します。分析・判断のパートでは、なぜエージェントが毎回ゼロから考えることが無駄なのか、そしてどんなタスクがこのハイブリッドアーキテクチャに適しているのか、どのタスクでは人間のレビューを必ず残すべきなのかを議論します。
To Know:CVS Agent 自動化ルートを理解するための7つの概念
| 概念 | 簡単な説明 |
|---|---|
| Computer Use | ソフトウェアの画面を観察し、クリックや入力などの操作を実行してタスクを完了する能力 |
| EHR | 電子健康記録システム。医療機関が患者のカルテを保存・処理する中核ソフトウェア |
| MCP | 外部ツールを検出して呼び出すための標準プロトコル |
| RPA | あらかじめ設定したルールやプログラムによって反復プロセスを実行する自動化方式 |
| Rubric points | 評価ルールに沿って分割された採点ポイント。部分的な要件の達成状況を測るもの |
| エンドツーエンド成功率 | タスク全体がすべての成功条件を満たす割合 |
| Trace | 実行プロセス、操作、ページ状態を記録した軌跡証拠 |
影響の概要:CVS Agent 自動化ルートは誰に影響するか
- 開発者と技術責任者:重要なのは「Agentを使うかどうか」ではなく、タスクごとに実行メカニズムを分解することです。探索フェーズの完了率、固定化したコードの安定性、保守を含む全体コストをそれぞれ検証する必要があり、1回のモデル呼び出し価格だけを見てはいけません。
- 医療機関とワークフロー責任者:合成デモ、ベンダー評価、企業の公開事例、自社パイロットを区別する必要があり、これらの証拠の重みは異なります。患者データや状態変更を伴うステップでは、事前に人手による承認、最小権限、操作の記録を徹底すべきです。
客観的事実:CVS Health CUA Agent Kitの2段階アプローチ
まず背景を整理しておきます。2026年11月16日、OpenAIは医療チーム向けComputer-use Agentの進展を発表し、臨床タスクおよび医療事務タスクの評価結果、ならびにCVS Health、Cigna Healthcare、Abridge、Ambienceなどとの協業事例を公開しました。CVS Healthはその中で本番環境の事例を明らかにし、CUA Agent KitをApache-2.0ライセンスでオープンソース化しました。
CVS Healthが公開した本番結果には、次のものが含まれます。ある本番ワークフロー上のエージェントが週末のうちに数か月分滞留していた書類送信タスクを処理したこと、別のエージェントが毎日数万回の専門科コンサルテーションにおけるシステム操作ステップを処理していることです。システムには検証チェックと人手による監督が組み込まれ、スクリーンショットや操作記録を通じて実際の操作とアプリケーションの状態を照合しています。ただし、これらは企業が自ら開示したデータである点に注意が必要です。「数万回」はコンサルテーションに関連するシステム操作ステップを指し、数万件の臨床判断をAIが単独で完了したことを意味しません。公開資料は、これらの本番エージェントが完全にオープンソース版Agent Kitに基づいて構築されたかどうかも明らかにしておらず、両者を直接同一視すべきではありません。
出典: openai.com/index/advancing-computer-use-for-healthcare-teams/
CVS HealthのCUA Agent Kitはどのように動作するのか?
プロジェクトのREADMEは自身の位置づけを非常に率直に示しています。これはブラウザとWindowsワークフローを自動化するためのスターターキットで、AIで手順を発見し、そのうえでコードによって繰り返し実行するものです。プロジェクトは特に、「タスクの進め方を明らかにすること」と「長期的に安定して繰り返し実行すること」は別の問題であり、それぞれ異なる手段で解決すべきだと強調しています。
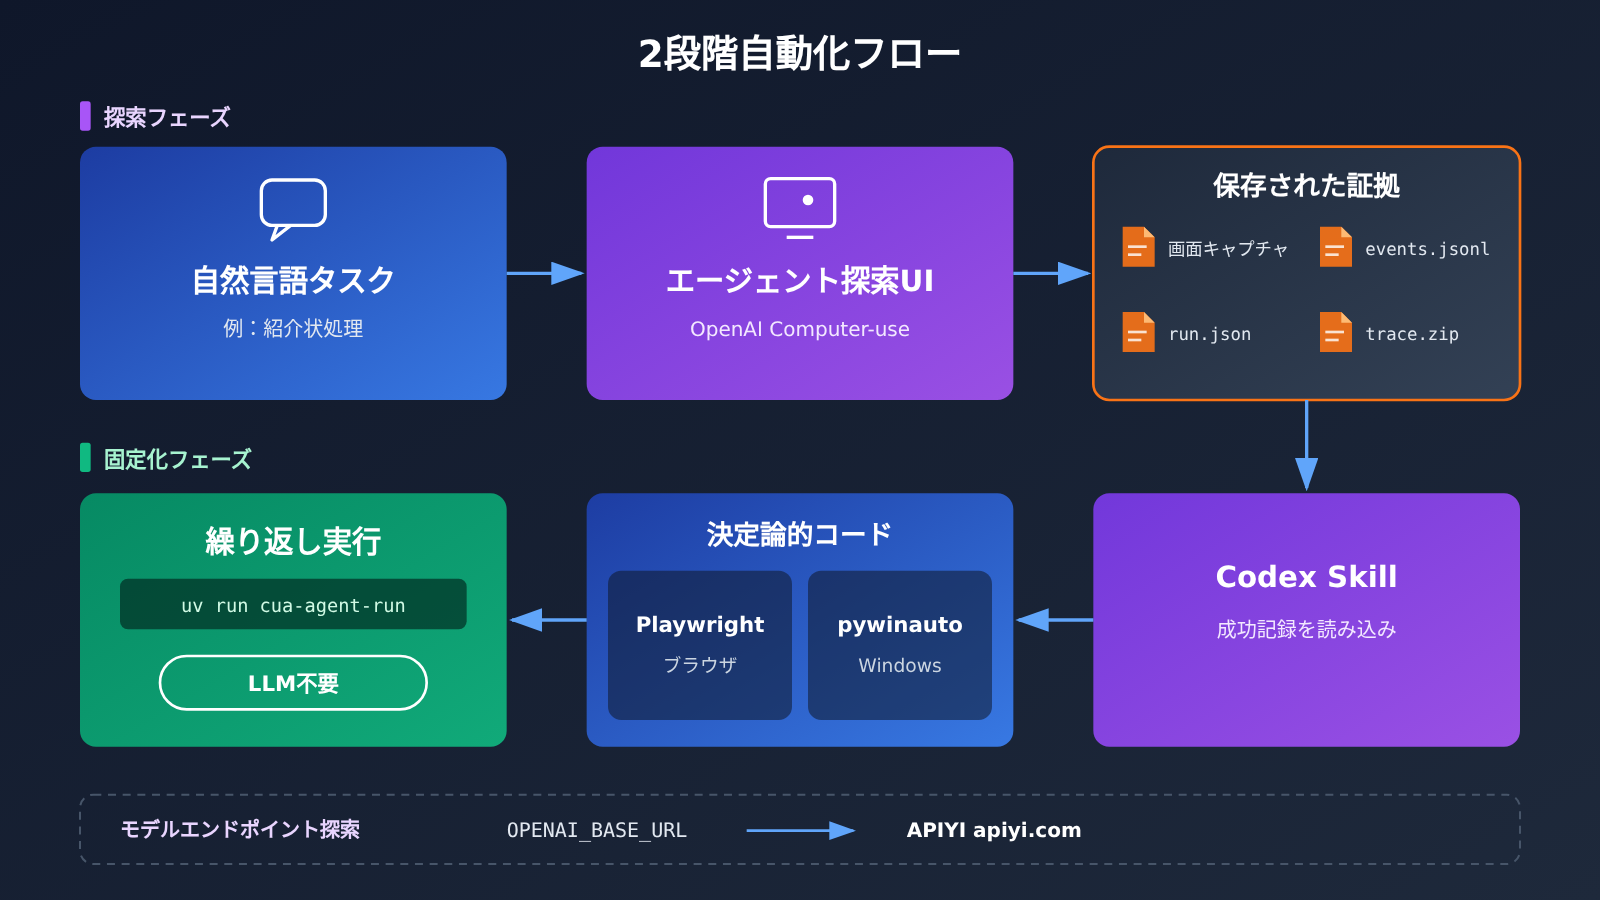
全体の流れは2つの段階に分かれます:
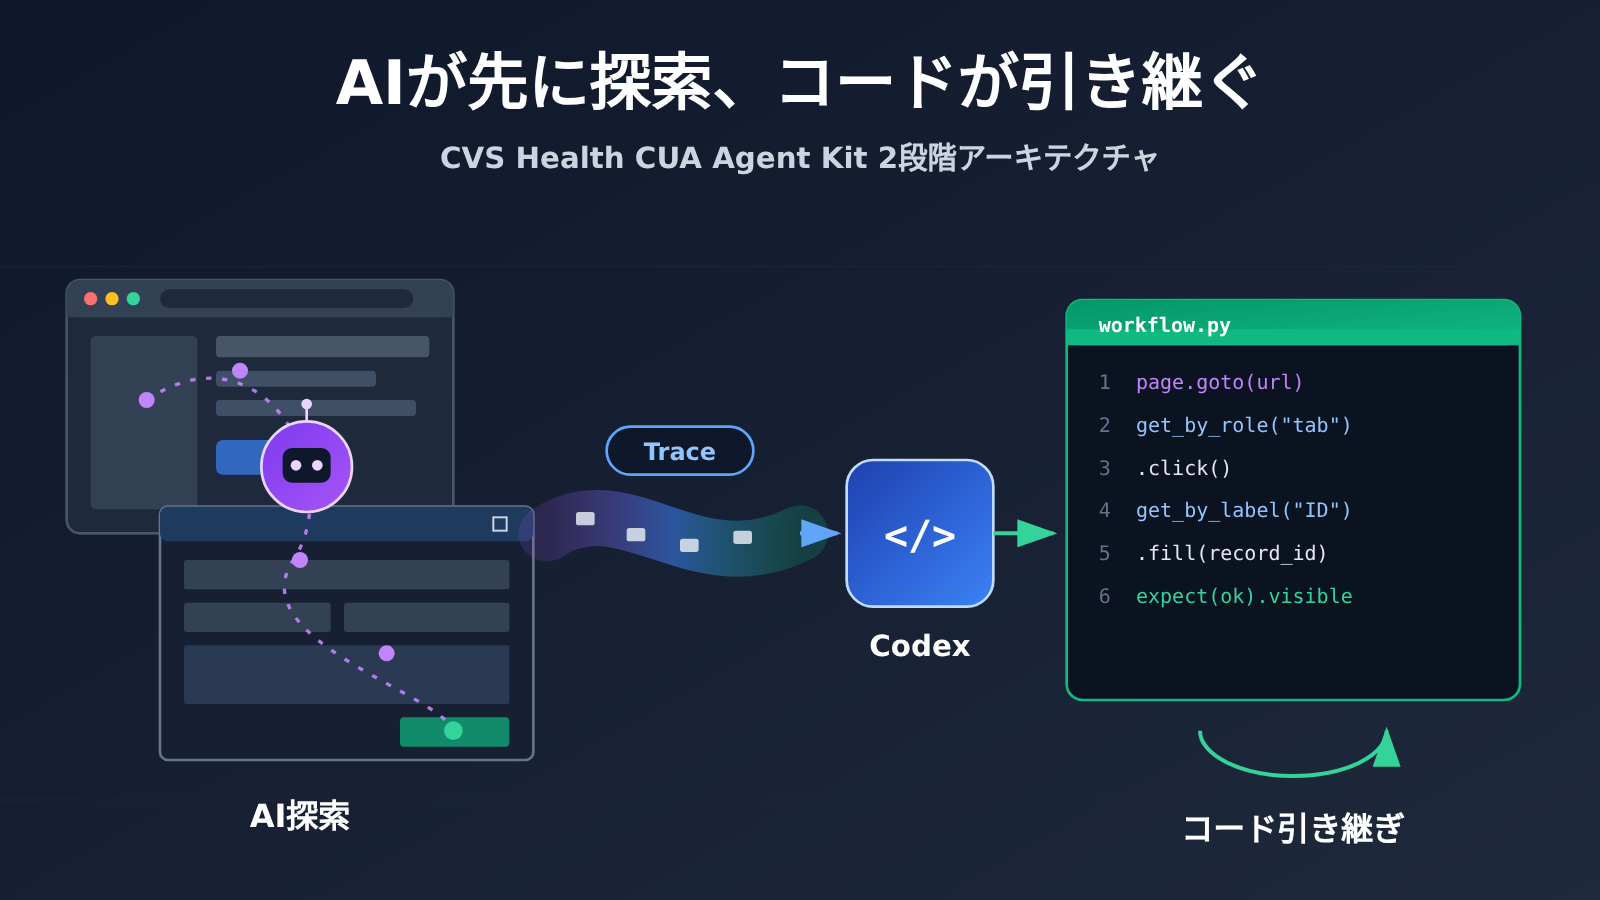
- 探索段階:OpenAI Computer-use Agentが自然言語で記述されたタスク(たとえば「あるレコードを見つけて紹介状を処理する」)を受け取り、実際のUI上で探索・実行・検証します。その過程でスクリーンショット、操作アクション、操作対象、実行トレースを保存します。
- 固定化段階:Codex Skillが成功済みの探索記録を読み取り、決定論的なワークフローコードを生成または更新します。その後、同じフローの繰り返し実行は通常のコードに任せ、大規模言語モデルが毎回推論し直す必要はなくなります。
探索段階で残される証拠はすべてディスクに保存されたファイルであり、モデル内部の推論過程にとどまるものではありません。READMEが公開している記録の種類は次のとおりです:
| 記録 | 主な用途 | 固定化段階での価値 |
|---|---|---|
| Screenshots | 各ステップの画面状態を記録 | エンジニアとCodexがページの実際の見た目を照合するため |
| events.jsonl | 操作イベントを1行ずつ記録 | 「何を、どの順序で行ったか」を再現 |
| run.json | 今回の実行情報を記録 | 異なる実行を区別し、成功したかどうかを判断 |
| trace.zip | Playwrightの実行トレース | 要素、ネットワーク、タイミングなどの詳細を提供し、コード生成と診断に用いる |
出典: github.com/cvs-health/cua-agent-kit
AI 操作から Playwright コードへ、CVS Agent Kit は何をしたのか?
固定化フェーズで最も重要なポイントは、生成されるのが「マウス座標のリプレイ」ではないという点です。CVS プロジェクトはブラウザワークフローを生成する際、セマンティックロケーター(Semantic Locators)を利用して Playwright コードを出力します。要素のロールや名前といったセマンティックな特徴を通じてターゲットを特定するのであって、特定の画面座標を丸暗記するわけではありません。
両者の違いは保守の場面で最もはっきりと現れます。座標リプレイは解像度やウィンドウサイズ、レイアウトの微調整といった影響を受けます。ボタンが数ピクセル動いただけでクリックが外れることがあり、しかもエラーが起きた後に座標の羅列から「本来どこをクリックしたかったのか」を読み出すのは困難です。セマンティックロケーターで書かれるコードは「『送信』という名前のボタンをクリックする」のようなもので、意図がコードの中に表現されています。エンジニアはそのままレビューでき、ページの部分的な調整が行われても壊れにくいという利点があります。もちろん、ボタンの名前が変わったりフローが改訂されたりすれば、セマンティックロケーターも同じように失敗します。ただ、その失敗は特定しやすいというだけです。
プロジェクトにおけるツールの役割分担は次のとおりです。
- Playwright:ブラウザワークフローの確定的な実行を担い、trace.zip のようなリプレイ可能なトレースを出力します。
- pywinauto:Windows デスクトップアプリケーションの自動化を担い、Web インターフェースを持たない旧システムもカバーします。
- Codex Skill:成功した探索トレースを読み取り、上記 2 種類のコードを生成または更新します。
このアプローチは OpenAI の公式ドキュメントが示す方向性と一致しています。OpenAI の Computer Use ガイドでは 2 つの道筋が紹介されています。1 つはモデルが構造化されたマウス・キーボード操作を返し、アプリケーション側がそれを実行する方法です。もう 1 つはモデルがコードを生成し、Playwright などのツールを通じてインターフェースを操作する方法です。ドキュメントは GPT-6 Astra に対してコード実行方式を推奨しており、Computer Tool は引き続きオプションの選択肢として扱われています。ComputerToolset、BrowserToolset、およびマネージドブラウザのエントリーポイントについては、公式ガイドの中でそれぞれ個別に説明されています。
出典: developers.openai.com/api/docs/guides/tools-computer-use
固定化された後、CVS Agent Kit の Agent には何が求められるのか?
フローを固定化した後、決定論的な実行は README に記載されたコマンドで行います。
uv run cua-agent-run
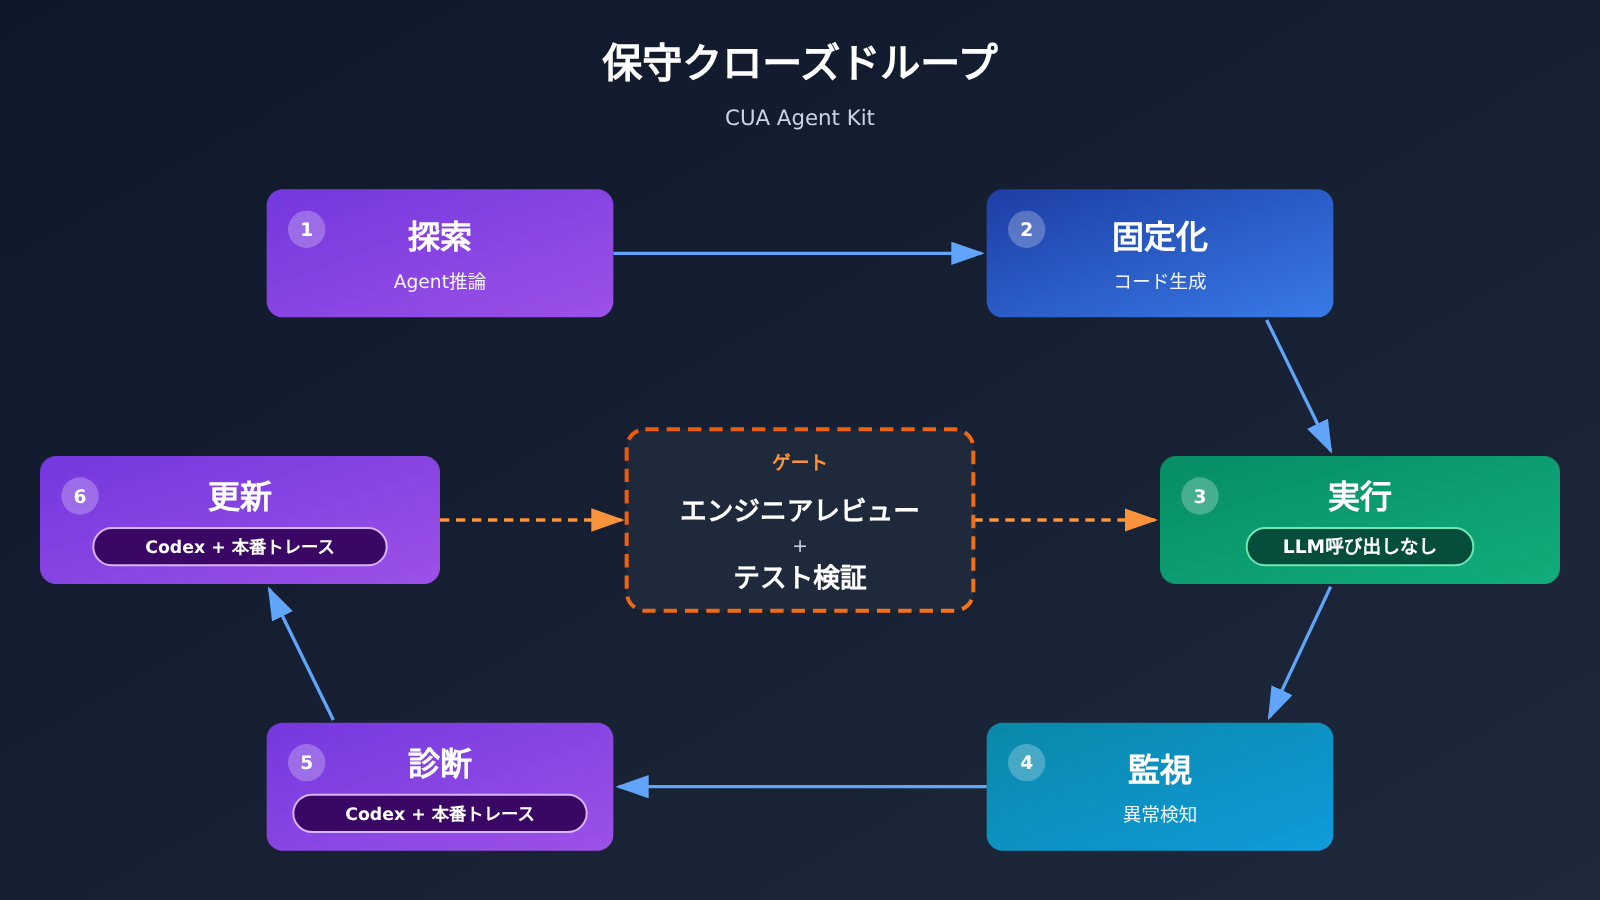
この段階では、毎回大規模言語モデルを呼び出す必要はなく、APIキーも不要です。ただし、プロジェクトは「固定化」を一度きりで完了する作業とは捉えていません。README で説明されている保守メカニズムは、次のようなクローズドループになっています。
- 固定されたワークフローが計画どおりに実行される
- 本番の Trace で異常を検出する
- Codex が Trace を使って問題を診断する
- 決定論的なコードを更新する
- エンジニアが変更内容をレビューする
- テストと検証を通過したうえで、再び繰り返し実行に投入する
言い換えれば、Agent の役割は「毎回自分で作業する」から「普段は立ち会わず、問題が起きたときにコードを直しに来る」へと変わったのです。コードは失敗するものですし、UI も改版されます。プロジェクト自身がそのことを前提としているからこそ、診断とレビューという工程が設計されているのです。
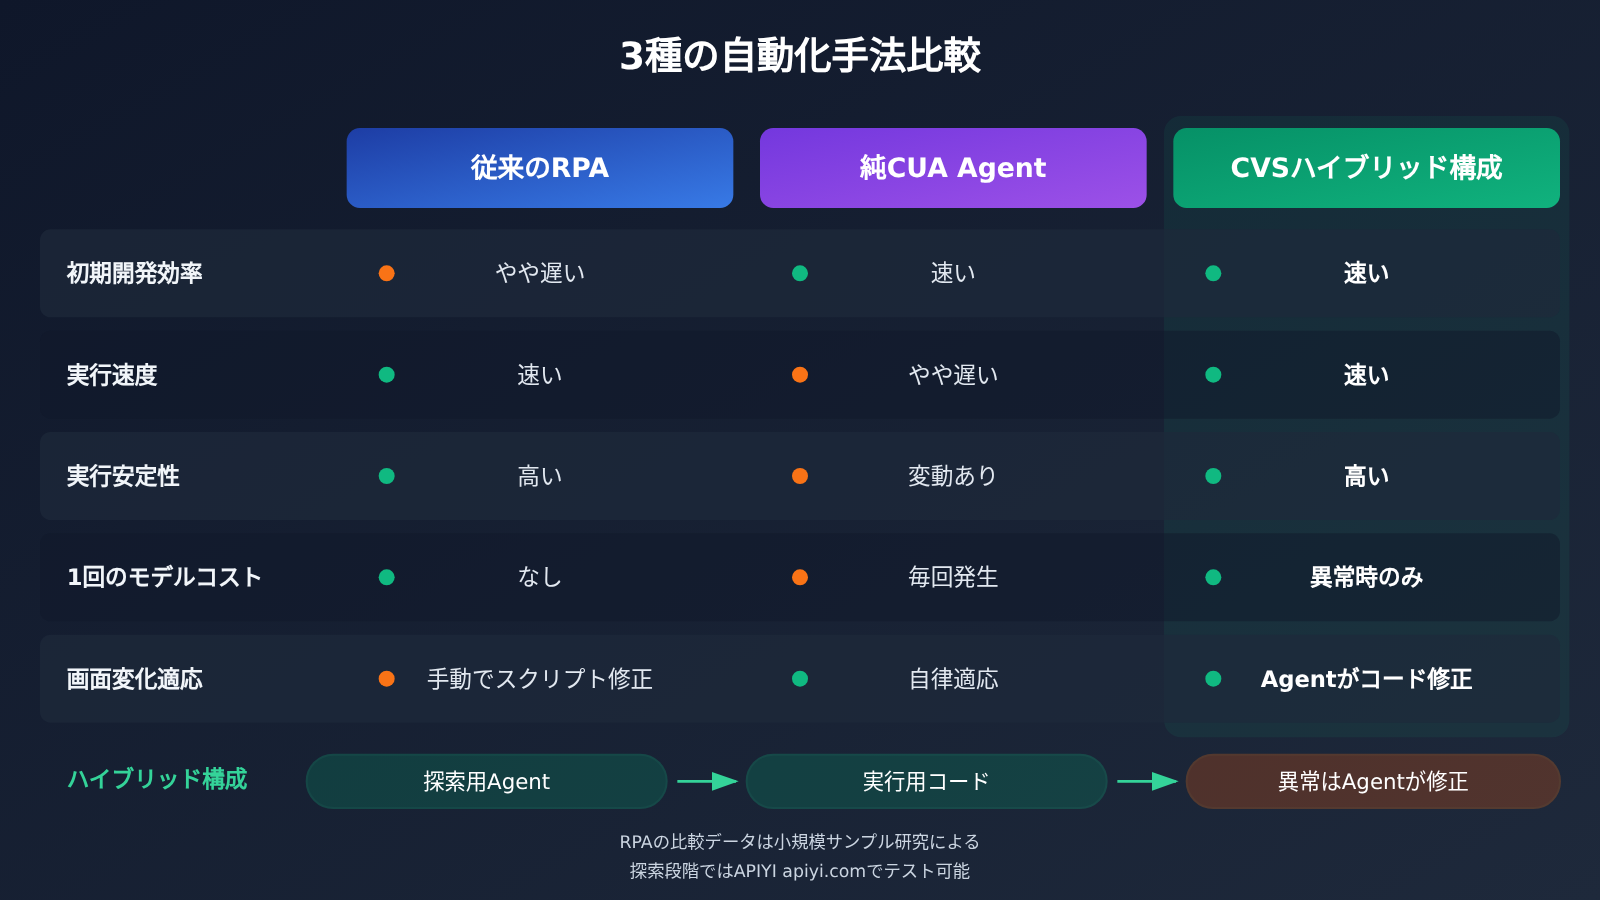
CVS のハイブリッドエージェント自動化は、従来の RPA と何が違うのか?
従来の RPA は、事前に設定したステップと画面位置の指定に依存しており、実行が速く結果も安定しています。一方で、開発や改版時のメンテナンスには人手が必要です。純粋なエージェントは自然言語を理解し、画面の変化にも適応できますが、毎回推論し直すためコストがかかり、結果にもばらつきが出ます。CUA Agent Kit の立ち位置はその中間にあります。エージェントが「人がフローを録画して作成する」工程を置き換え、実行フェーズでは決定論的なコードに戻す、という考え方です。
両者を直接比較した研究としては、2026 年に発表された Are LLM agents the new RPA? A comparative benchmark study of agentic automation and RPA across standardized workflow tasks(DOI: 10.1080/23311975.2026.2724760)が参考になります。この研究は 2025 年 5〜6 月に実施され、UiPath Studio 2023.4.0 と Anthropic Computer Use Agent を比較し、データ入力、監視、ドキュメント抽出という3種類の標準タスクを対象としています。
| タスク | RPA 成功率 | エージェント成功率 | 初期開発時間(単一開発者による観察) |
|---|---|---|---|
| P1 | 対照統計に含まれず | エージェントは1回実行しただけで失敗し、以降の統計に含まれていない | 非公開 |
| P2 | 100%(10回) | 90%(10回) | エージェント約10分、RPA約38分 |
| P3 | 100%(10回) | 60%(10回) | エージェント約15分、RPA約240分 |
研究ではさらに、RPA のほうが P2、P3 で実行速度が明確に速いことも確認されました。エージェント側の問題は主に、画面操作の失敗、コンテキストの喪失、判断ミスです。一方で、エージェントには動的な画面への適応力という潜在的な強みもあります。
ただし、この研究の限界は明確にしておく必要があります:
- サンプルが小さい:P2、P3 は各技術とも10回ですが、P1 は「各技術10回ずつ」ではなく、一概に一般化できません。
- 開発時間はあくまで初期観察:単一の開発者によるもので、統計的な代表性はなく、業界の平均値として扱うことはできません。
- ツールのバージョンが古い:研究で使われたのは2025年時点のエージェント構成であり、2026年の新しいモデルの成績を代表するものではありません。
それでも、結論の方向性は CVS の設計と互いに裏付け合っています。エージェントは素早い探索と柔軟な処理が得意で、RPA 的な決定論的実行は安定した反復において依然として強みを発揮します。
出典: tandfonline.com/doi/full/10.1080/23311975.2026.2724760
開発者が CVS CUA Agent Kit のアプローチをどう再利用できるか
README に記載されている環境要件は多くありません。
- Python 3.12 以降;
- uv(Python パッケージ・プロジェクト管理ツール);
- アクセス可能な対象 Web サイトまたはデスクトップアプリ;
- 探索フェーズでは
OPENAI_API_KEYが必要; OPENAI_BASE_URLでカスタム API エンドポイントを設定可能。
利用方法は次の3つのフェーズに対応します。発見(Agent が探索して証拠を残す)、固定化(Codex がコードを生成)、実行(決定論的実行)。発見と固定化フェーズの具体的なコマンドやパラメータはリポジトリの README を参照してください。実行フェーズは前述の uv run cua-agent-run です。
OPENAI_BASE_URL という設計は注目に値します。これは、探索フェーズのモデル入口を公式 API に指定できるほか、企業内ゲートウェイや OpenAI 互換インターフェースを提供する他のサービスにも向けられることを意味し、認証・課金・監査の統一に役立ちます。探索フェーズの環境変数は次のように設定できます。
# 探索フェーズ:モデル API が必要
export OPENAI_API_KEY="YOUR_API_KEY"
export OPENAI_BASE_URL="https://api.apiyi.com/v1"   # APIYI の統一インターフェースを使用、または自分のゲートウェイに変更

# 実行フェーズ:決定論的実行、API キーは不要
uv run cua-agent-run
一点強調しておきたいのは、Computer Use は特定の Responses API 機能とツールタイプに依存するということです。カスタムエンドポイントに切り替える前に、そのエンドポイントが探索フェーズに必要なモデルとツールをサポートしていることを確認し、簡単なフローで動作確認してから広く展開してください。
固定化之后、日常维护中最常做的事情是阅读 Trace 和事件日志。以下是一个辅助脚本示例:把一次运行的 events.jsonl 交给通用大規模言語モデル,让它整理出步骤清单和可疑失败点,供工程师审查时参考。events.jsonl 的具体字段以项目实际输出为准,这里只按行读取;涉及患者等敏感信息时,务必先脱敏,或只在合规环境内处理。
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # APIYI の OpenAI 互換インターフェース
)

def summarize_events(path: str, model: str = "gpt-4o-mini") -> str:
    """脱敏済みの events.jsonl を読み、手順リストと失敗が疑われる箇所を生成する"""
    with open(path, encoding="utf-8") as f:
        events = [json.loads(line) for line in f if line.strip()]

    sample = json.dumps(events[:200], ensure_ascii=False)  # コンテキスト長を制御
    prompt = (
        "以下はとある UI 自動化実行のイベントログです。"
        "操作手順を順番に列挙し、失敗の最も可能性が高い手順とその原因を指摘してください。"
        "ログ内容のみに基づき、憶測はしないでください。\n" + sample
    )
    resp = client.chat.completions.create(
        model=model,  # プラットフォーム上で実際に利用可能なモデルに置き換える
        messages=[{"role": "user", "content": prompt}],
    )
    return resp.choices[0].message.content

print(summarize_events("runs/latest/events.jsonl"))
このスクリプトはあくまで読解の補助であり、Codex が完全な Trace に基づいて問題を診断する代替にはなりませんし、エンジニアのレビューやテストの代替にもなりません。
🚀 クイックスタートのヒント:このアプローチを再利用する際は、まず社内テストサイト上の低リスクなフローで「探索 → 固定化 → 実行」の全チェーンを動作確認するとよいでしょう。探索フェーズではモデルを繰り返し呼び出して効果を比較する必要があるため、APIYI apiyi.com で無料テスト枠を取得し、同じ API キーで異なるモデルを切り替えてログ分析などの補助タスクを実行し、その後で本番環境のモデル選定を決めることができます。
分析と判断:CVS Agent 自動化路線のトレードオフ
以下の内容は前述の事実に基づく解釈であり、プロジェクト側や OpenAI の結論ではありません。
Agent が毎回ゼロから考えるのはなぜ無駄なのか?
多段階の業務自動化にはひとつの特徴があります。一度フローが通り抜ければ、その後のほとんどの実行は同じ経路をたどるということです。もし毎回 Computer-use Agent にスクリーンショットを取り直させ、インターフェースを理解させ、次のステップを計画させると、モデルは実のところ、すでに答えを知っている問題に対して繰り返しコストを支払うことになります。このような繰り返し推論は、同時に3つのコストを生み出します。
第一にコストです。Computer Use はマルチターンの呼び出しであり、各操作後のスクリーンショットは画像入力に該当し、Token が継続的に蓄積されます。OpenAI が 2026 年 11 月 17 日に公表した Standard 短コンテキスト価格を例にすると、GPT-6 Astra の入力・出力・キャッシュ入力はそれぞれ 100 万 Token あたり 10、50、1 ドル、GPT-6 Luna は 0.10、0.50、0.01 ドルです。HealthAdminBench 評価において、Luna のタスクあたりコストは 0.085 ドルで、Astra より 98% 低い結果でした。この比率から逆算すると、Astra はタスクあたり約 4.25 ドルとなりますが、これはあくまで推定値であり、ベンチマークテスト条件下のコストであって、本番の見積もりとして扱うことはできません。
第二にレイテンシです。各ステップでモデルの応答を待つ必要があり、フローが長くなるほど待ち時間も長くなります。前段の研究で RPA が P2、P3 の実行速度で Agent より著しく速かったのも、これが理由です。
第三に変動です。同一タスクを複数回実行すると、Agent が異なる経路をたどる可能性があり、研究では P3 の Agent 成功率はわずか 60% でした。予測可能性と監査可能性が求められる業務にとって、この不確実性はコストよりも受け入れが難しいものです。
したがって、2つの段階のコスト構造は分けて計算すべきです:
| コスト項目 | 探索段階(Agent) | 実行段階(決定論的コード) |
|---|---|---|
| モデル Token | 各ラウンドの視覚・テキスト入力、課金出力をそれぞれ集計。リトライ Token は総量に計上済みの場合は重複加算しない | 正常動作時はゼロ |
| ツールと実行環境 | ブラウザ、デスクトップ環境、コンテナなど実際に使用するサービス | コードを実行するマシンとブラウザ環境 |
| エンジニアリング投入 | タスク記述の作成、証拠の確認、生成コードのレビュー | 監視、異常診断、コード更新とテスト |
| 発生頻度 | 新フローのリリース時またはフロー大改修時 | 毎回の業務実行時 |
| 推奨される方法 | 複雑度に応じてモデルを階層的に選択し、高難度フローには強力モデル、構造化フローには低価格モデルを使用 | できるだけモデルを呼び出さず、異常時のみ Agent に戻って修復 |
ハイブリッドアーキテクチャの経済性はまさにこの表から来ています。高価なモデル呼び出しは低頻度の探索・修復段階に集中し、高頻度の実行段階は限界モデルコストがほぼゼロのコードに戻ります。実際の台帳には保守投入も加算する必要があり、UI の改版が頻繁になるほど探索段階に戻る回数が増え、節約幅は小さくなります。
💰 コストのヒント:探索段階のモデル階層的選定は、ベンチマークの数字をそのまま使うのではなく、自社の実際のフローで実測するのが最善です。APIYI apiyi.com を通じて、同じ OpenAI 互換インターフェースの下でモデルを切り替え、従量課金で利用できるため、探索やログ診断の段階で異なるモデルが実際に消費する Token を比較しやすいです。
ここには、見落とされがちな評価基準の問題がもう一つあります。OpenAI が公表した HealthAdminBench のスコアは Astra 94.3%、Luna 91.8% で、いずれも最高推論強度における rubric points の割合であり、エンドツーエンドの成功率ではありません。スタンフォードのチームによる論文 2604.09937v1 版には 135 タスク、1698 サブタスク(うち 1177 件が決定論的スコアリング、521 件がモデルによる判定)が含まれており、報告されている最良の完全タスク成功率は 36.3%(Claude Opus 4.6 CUA)、最良のサブタスク成功率は 82.8%(GPT-5.4 CUA)です。初期に Web で公開された 70 タスク・947 評価ポイントは別の公開バージョンに属するもので、歴史的な比較対象としてのみ扱えます。これらの数値はそれぞれ異なるモデル、日付、実行条件、指標に由来しており、同じランキング表に並べることはできません。
「まず探索してから固定化する」というアプローチでは、エンドツーエンドの成功率が部分的なスコアよりも重要になります。Codex が必要とするのは、完全に成功した一つの軌跡です。探索段階で 90% のサブステップを正しくこなしても、最後のコミットで行き詰まってしまえば、残された Trace はそのままでは固定化できません。モデルを選ぶ際は、自社のフローで完全タスクの成功率を測るべきです。
どのようなタスクが CVS 型のハイブリッド Agent アーキテクチャに適しているか?
ここまでの事実をまとめると、タスク分担の大まかな一覧表が得られます。
| タスクの特徴 | 推奨される実行方式 | 典型的な例 | 人による介入 |
|---|---|---|---|
| フローが未知、ドキュメント不足、UI が複雑 | Agent が探索し、証跡を残す | 古いシステムの操作経路を初めて整理する | 探索結果と生成コードをレビュー |
| フローが安定、高頻度の反復、状態検証が可能 | 決定論的なコードとして固定化 | システム間のファイル送信、固定フィールドの転記 | 結果の抜き取り検査、異常の監視 |
| 既存 API でカバーできる | API 呼び出しを優先 | 構造化データの書き込み | 通常の権限管理に従う |
| UI が頻繁に改版される | 固定化後に監視を強化し、探索に戻るための予算を確保 | サードパーティのポータル | コード更新のたびにレビューが必要 |
| リスクの高い業務状態を変更する | コードや Agent は下書き/承認待ちまでに留める | 申請の提出、メッセージ送信、レコードの変更 | 人による承認が必須 |
医療の現場では、他の協力企業のやり方も参照になります。Ambience が示したソリューションでは、カルテに曖昧な点があるときに Agent を止めて医師に確認し、送信前に承認を待ちます。Assort の事例では、API がカバーできる部分を担い、Computer Use は API でカバーできない UI 操作の手順だけを補完します。「API + Computer Use + 決定論的なコード + 人による承認」という組み合わせは、どれか一つの技術に賭けるよりも現実的です。
ここで明確にしておきたいのは、決定論的なコードは実行を予測可能にするだけで、結果が正しいことを保証するものではないという点です。探索フェーズで固定化した経路に欠陥があれば、コードはその欠陥を安定して繰り返します。システムをまたぐ操作では、一つの誤りが複数の下流システムへ複製されることもあります。そのため、操作前の状態チェック、操作後の結果検証、最小権限、そして全行程の記録は、固定化した後も省けません。本稿で扱うのはエンジニアリングアーキテクチャであり、患者の診療に関する助言は一切含みません。
実際に手を動かしたいチームにとって、比較的安全な進め方はこうです。まず非本番環境で、低リスクかつ高頻度で繰り返されるフローを一つ選び、探索、固定化、運用、そして人為的に用意した UI 変更を一度、最後まで通してみます。そのうえで、モデル呼び出しのコスト、コードの保守工数、障害からの復旧時間を記録します。この三つのデータは、どんなベンチマークスコアよりも、このアーキテクチャがあなたの現場で費用対効果に見合うかどうかを雄弁に語ってくれます。探索フェーズでの複数モデルの比較テストは、まず APIYI apiyi.com の無料枠から始め、実測結果に基づいて本番導入するモデルと接続方式を決めるとよいでしょう。
CVS のソリューションが注目に値するのは、Agent がどれほど賢いかを謳っているからではなく、Agent の限界を認めたうえで、賢さを最も必要なところに使っているからです。一度探索し、コードとして固定化し、壊れたら直す。この路線がより多くの企業で成立するかどうかは、最終的には各社のプロセスが実環境で示す実測データ次第です。
The proof of the pudding is in the eating.(プディングがおいしいかどうかは、食べてみて初めてわかる。つまり実際の効果は実践で検証するしかない。)
作者: APIYI 技術チーム
技術交流: APIYI apiyi.com のサイトトップページからぜひお問い合わせください。接続資料は docs.apiyi.com のドキュメントセンターでご覧いただけます。


