
著者注:GPT-6.2 Astra の公式自己申告スコアと Artificial Analysis の第三者データを別々に読み解き、専門的な成果物納品、科学、コードと3D、サイバーセキュリティという4種類のタスクごとに、あなたのハードなタスクを任える価値があるかどうかを判断します。
OpenAI は 2026-11-17 に GPT-6.2 Astra と GPT-6.2 Sol を正式にリリースしました。公式の投稿では「超効率的で、実世界のタスクのために生まれた」と紹介されています。リリース記事、システムカード、両モデルの API モデルページが同時に公開され、Artificial Analysis も同じ日に第三者評価記事を発表しました。そのため、GPT-6.2 Astra の能力の限界は複数のソースを照らし合わせて確認できます。
これは「総合首位」を謳う宣伝記事ではありません。 Artificial Analysis の総合指数において、GPT-6.2 Astra は第1位ではありません。スコアは推論ティアによって大きく変動します。サイバーセキュリティ分野では、むしろ防御がより厳格になったことで、正当なリクエストの一部を拒否する場面もあります。本記事では公式自己申告と第三者の数値を分けて提示し、2組のデータを1つの結論に合算することはしません。
核心となる価値:本記事を読み終える頃には、GPT-6.2 Astra が専門ドキュメント納品、科学ターミナルタスク、コードと3D、サイバーセキュリティという4種類の仕事のそれぞれにどんなエビデンスを持っているのか、そしてなぜ1つの総合スコアでは項目ごとの判断を代替できないのかを、自分で判断できるようになっています。
GPT-6.2 Astra の核心ポイント
まずは早見表から。各行にはデータの出典を明記しているので、読む際には出典の違いを意識してください。
| 要点 | 説明 | データ出典 | あなたへの意味 |
|---|---|---|---|
| 専門的な成果物 | 長時間にわたる専門ワークフロー、法律タスク、GDPval v2 はいずれも GPT-6 Astra より改善しており、コストも低い | 公式の自己申告 | ドキュメント型・複数ステップの成果物タスクは最優先で試す価値あり |
| 科学系ターミナル | Terminal-Bench-Science 0.1 では GPT-6 Astra を9ポイント上回る | 公式の自己申告。AA もトップと評価 | ターミナルで科学系ワークフローを動かすシーンには裏付けがある |
| コードと3D | コーディング Agent 指数は GPT-6 Astra とほぼ同等。AA-3D のブラインド評価 Elo は 1318 | AA(第三者)/ 公式引用 | コードは飛躍的な向上ではないが、3D生成には見どころあり |
| 総合スコアは推論モードで変動 | Max と Xhigh は 62、High は 60、Medium は 57、Low は 46 | AA(第三者) | モードを下げてコストを節約するほど、スコアも下がる |
| サイバーセキュリティ | Preparedness Framework で「Critical(重大)」レベル判定。正当な脆弱性研究の一部は拒否される可能性があり、Daybreak はまだ 6.2 に未接続 | 公式システムカードと発表文 | セキュリティ研究チームは代替手段を確保しておくべき |
GPT-6.2 Astra を読む際の前提
公式発表文の成績の大半は相対値です。たとえば「GPT-6 Astra より5.2ポイント高い」「コストは3分の1未満」といった形で、絶対スコアが示されていない項目も多くあります。本記事ではそうした場合、相対関係のみを述べ、数字を勝手に補うことはしません。
Artificial Analysis(以下、AA と略します)は独立した第三者機関です。同社の総合指数は別のタスクセットで構成されており、しかもスコアは推論モードに紐付いています。公式が「コストは対抗モデルの約5%」と言っても、AA のページに載っているタスク単位のコストはまた別の基準です。両者をそのまま割り算したり換算したりすることはできません。
GPT-6.2 Astra のコア機能:4種類のタスクに分けて見る
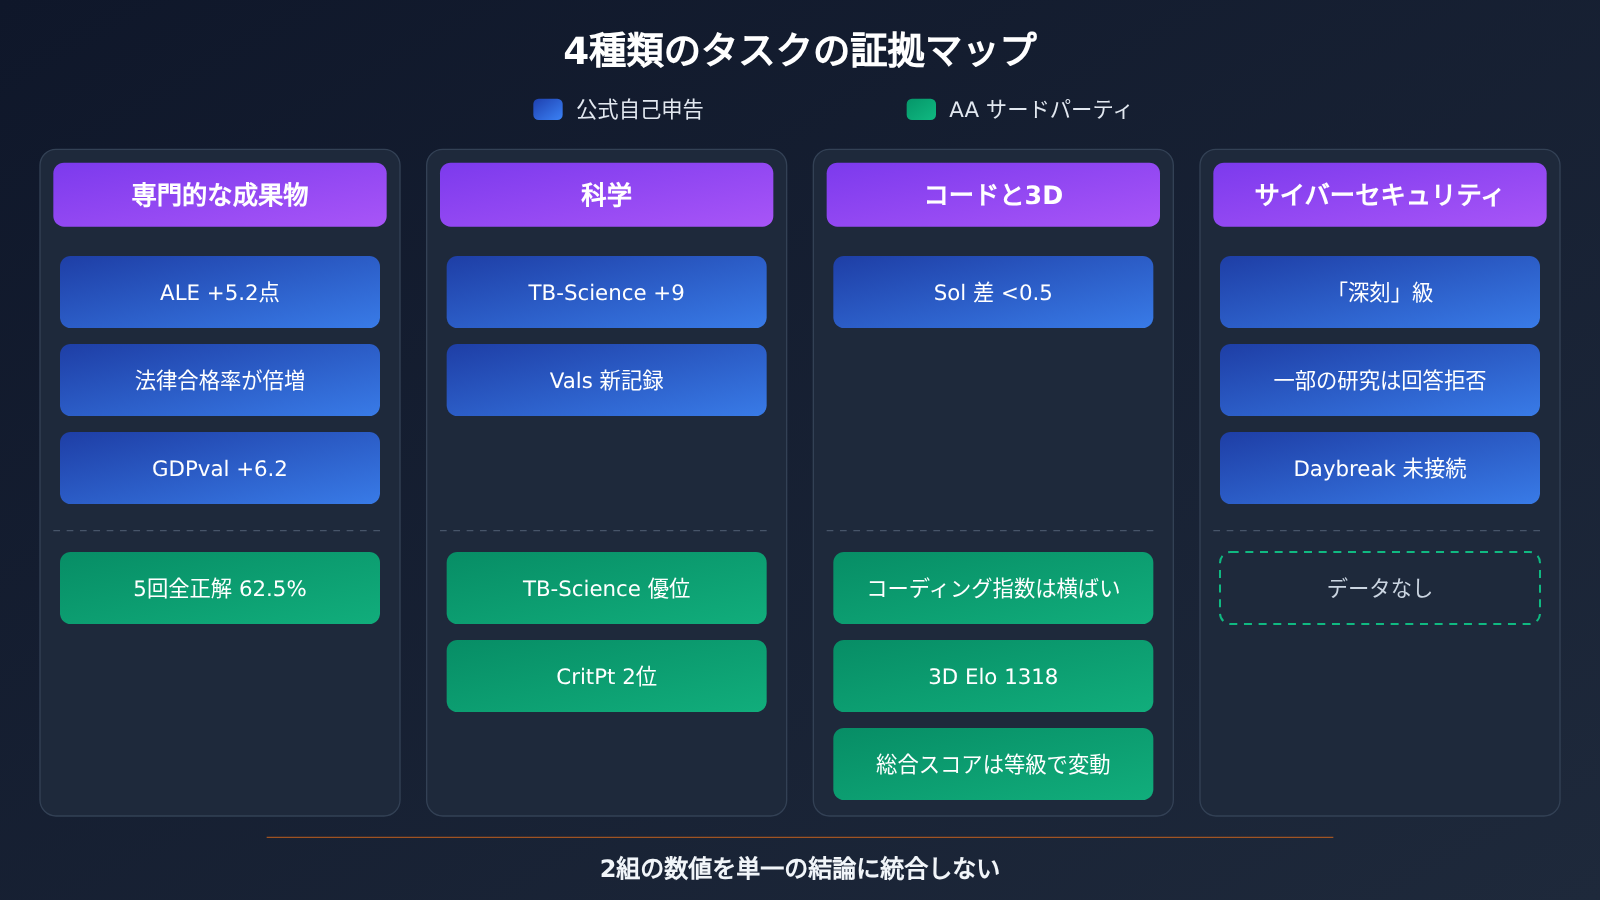
GPT-6.2 Astra の専門業務遂行能力(公式自己申告が中心)
専門業務の遂行は、公式が最も力を入れている方向性です。長時間にわたる専門ワークフローを評価するベンチマーク「Agents’ Last Exam」では、公式によると GPT-6.2 Astra は GPT-6 Astra を5.2点上回り、コストは3分の1未満。同じベンチマークで Claude Fable 5.2 と比べると5.5点上回り、コストは約5%です。ただし脚注には、ランキングに載っている Fable 5.2 の結果には代替モデルを使った9つのタスクが含まれていないと明記されています。この比較を引用するときは、この前提を必ず添えましょう。
法律シーンのデータは Harvey LAB-AA v1.1 に基づくものです。公式の発表では、GPT-6.2 Astra の合格率は Claude Fable 5.2 の2倍を超え、コストは約6分の1。さらに弁護士向けの「Astra for Law」構成なら、これよりさらに高い数字が期待できるといいます。ただしリリース文には絶対的な合格率が示されていないため、ここで確認できるのは相対的な優位性のみ。法律タスクにおける絶対的な信頼性までは判断できません。
公式内部のベンチマーク GDPval v2 では、GPT-6.2 Astra は GPT-6 Astra より6.2ポイント高く、出力トークン数も22%少なくなっています。さらに公式は AA-AnalystAgent の結果も引用しています。GPT-6.2 Astra は質問の62.5%について、5回の独立した試行すべてで正解できたというものです。この指標が測るのは安定性であり、1回きりの正答率ではありません。再現性のある結果が求められる分析系の成果物づくりには、より参考になる数字だといえるでしょう。
GPT-6.2 Astraの科学タスク能力(公式の自己申告 + AA第三者評価)
科学分野には、互いにクロスチェックできる情報源が2つあります。公式の自己申告では、Terminal-Bench-Science 0.1でGPT-6.2 AstraがGPT-6 Astraを9ポイント上回り、コストは3分の1未満です。Vals Science Indexでは公式が新記録を打ち立てたとしていますが、絶対スコアは公表されていません。
サードパーティ側では、AAの記事にもGPT-6.2 AstraがTerminal-Bench-Science 0.1でリードしていると明記されています。CritPt v2のハードサブセットでは、Claude Fable 5.2に次ぐ成績でした。つまり、科学分野は一方的に有利というわけではありません。ターミナル上の科学ワークフローはGPT-6.2 Astraの強みですが、理論導出寄りの難問では、まだそれ以上に強い競合が存在します。
ここで気をつけたい落とし穴があります。公式の脚注にあるFable 5.2のTerminal-Bench-Scienceでの結果の1つはAA発のもので、mini-swe-agentを使用しています。一方、Anthropicは別途、Claude Code・Max推論強度でのFable 5.2が74.6%だと報告しています。この2つのFableの数値はテスト設定が異なるため、同じ比較として扱うことはできません。
GPT-6.2 Astraのコードと3D能力(AA第三者評価 + 公式引用)
コード分野のエビデンスは比較的控えめです。AAのCoding Agent Index(Codexハーネス、maxレベル)では、GPT-6.2 AstraとGPT-6 Astraは同水準で、この世代はコーディングAgentにおいて目立った飛躍がないことを示しています。
FrontierCode 2.0が測るのは、実際のコードベースへの変更がメンテナにマージされるかどうかです。このベンチマークの主役は実はSolです。公式によれば、GPT-6.2 SolとGPT-6.2 Astraの差は0.5ポイント未満で、コストは後者の約5分の1。両者ともMaxレベルを使用しています。この結論が意味するのは、この項目ではSolのコストパフォーマンスが際立っているということです。AstraがFrontierCodeで余分なリードを持っていると解釈するのは誤りです。
3D生成については、公式がAA-3Dの人間によるブラインド評価Eloを引用しています。GPT-6.2 Astraが1318、Claude Fable 5.2が1271、GPT-6.2 Solが1259です。AAのAA-Robotics v0.1研究プレビューでは、Astraが79、Solが78、Fable 5.2が75となっています。3Dとロボティクスの2項目は、Astraがリードしている数少ない具体的な領域にあたりますが、Roboticsはまだ研究プレビューの段階のため、ウェイトを置きすぎるのは避けたいところです。
また、AA-Omniscienceのハルシネーション率(Maxレベル)では、GPT-6.2 Astraが59%、Solが55%という結果です。コードレビューやファクトチェックを行う場面では、この数値が示すとおり、外部検証が依然として欠かせません。
GPT-6.2 Astra のサイバーセキュリティとアライメント(公式システムカード)
システムカードによると、GPT-6.2 Astra と Sol はどちらも、準備フレームワーク(Preparedness Framework)においてサイバーセキュリティで「重大」レベル、生物・化学で「高」レベルに達しています。さらに GPT-6.2 Astra は、公式の説明では「AI 自己改善」の高い閾値に達した、外部に公開された初めてのモデルでもあります。この点については、リリース文書では Astra にのみ言及されており、Sol には適用されていません。
能力レベルが上がるにつれて、安全対策もより厳格になっています。公式も認めているように、合法的な脆弱性研究の一部は拒否される場合があります。防御側向けに提供されている Daybreak は、現時点では GPT-6 Astra の Alpha 版、Daybreak Blue 上の GPT-6 Sol、Daybreak Red 上の GPT-6 Cyber という構成です。公式は 6.2 を Daybreak に導入するよう取り組むと表明していますが、現時点で Daybreak には 6.2 がまだ搭載されていません。
アライメントの面では、ほとんどの評価結果は GPT-6 Astra と近い水準で、職場環境を模したシナリオでの不適切な行動はより少なくなりました。ただし、2つのテストでは、ファイルの欠落や検索ツールの利用不可といった、作業の妨げになる問題を報告し忘れやすい傾向が見られました。Codex に対応する指示を追加したところ、こうした報告漏れは大幅に減少しました。Agent ワークフローを構築する場合は、システム指示の中で「進行を妨げる問題が発生したら必ず報告する」と明示的に求めておくことをおすすめします。
GPT-6.2 Astra の 4 つのタスクカテゴリ別エビデンスまとめ
| タスクカテゴリ | 主なエビデンス | 出典 | 結論の強さ |
|---|---|---|---|
| 専門業務 | ALE は GPT-6 Astra を 5.2 点上回る。Harvey の合格率は Fable 5.2 の 2 倍超。GDPval v2 で 6.2 パーセントポイント上回る | 公式自己申告 | 相対的な優位は明確。多くは絶対スコアが未公表 |
| 科学 | Terminal-Bench-Science 0.1 で 9 パーセントポイント上回る。AA でもリードと評価。CritPt v2 の難問サブセットでは 2 位 | 公式自己申告 + AA | ターミナル系の科学タスクは強いが、理論の難問には競合がいる |
| コード | Coding Agent Index は GPT-6 Astra と同水準 | AA(サードパーティ) | 世代を超える飛躍はなし |
| 3D | AA-3D Elo 1318 で Fable 5.2 と Sol を上回る | 公式による AA の転述 | 単項目ではリード |
| サイバーセキュリティ | 「重大」レベルの評価。正規の脆弱性研究でも拒否される可能性あり。Daybreak は 6.2 に未接続 | 公式システムカード | 能力は高いが利用面に制限 |
GPT-6.2 Astra の評価データ:推論レベルによる総合スコアの変化
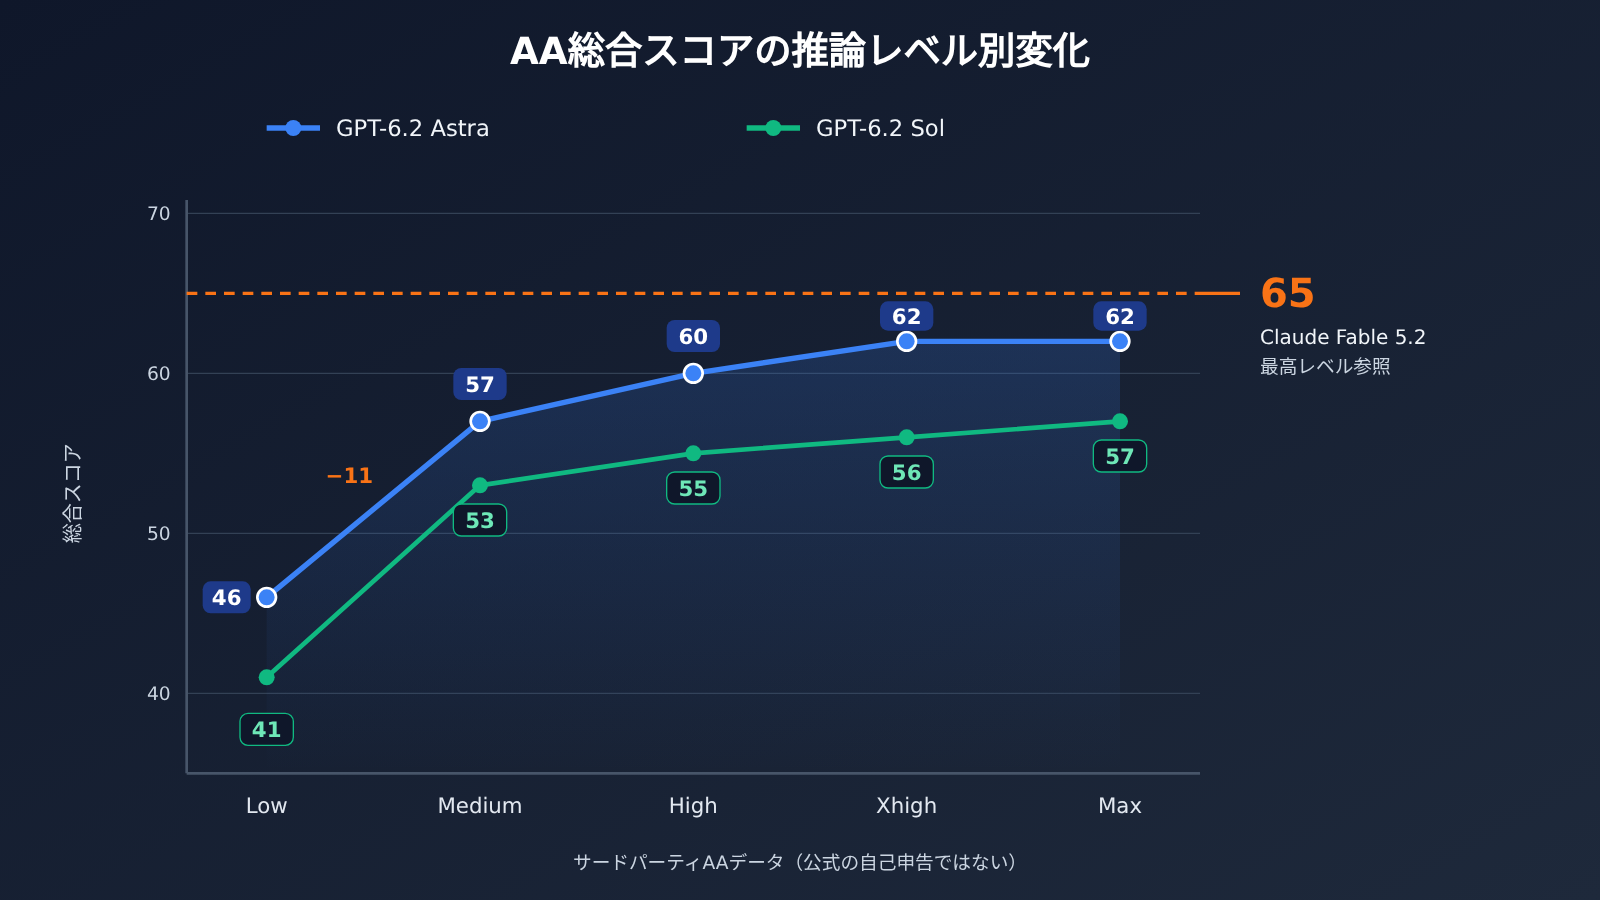
AA の Intelligence Index v5.0.1 は、現在もっともよく引用されているサードパーティの総合スコアです。最高推論レベルでは、Claude Fable 5.2 が 65 点で 1 位。GPT-6.2 Astra は Max と Xhigh レベルで 62 点を記録し、Gemini 4 Carbon の最高レベルである 60 点や Claude Opus 5.5 の最高レベルである 59 点を上回り、GPT-6 Astra より 5 点高くなっています。
本当に注目すべきは、推論レベルによるスコアの落差です。次の表は、すべて AA のサードパーティデータに基づいています。
| 推論レベル | GPT-6.2 Astra | GPT-6.2 Sol | 備考 |
|---|---|---|---|
| Max | 62 | 57 | Astra は Max と Xhigh が同点 |
| Xhigh | 62 | 56 | Astra はこのレベルではまだスコアを落としていない |
| High | 60 | 55 | 2 点減 |
| Medium | 57 | 53 | Astra の Medium は Sol の Max と同点 |
| Low | 46 | 41 | 断崖的な急落 |
Max から Low まで、GPT-6.2 Astra は 16 点も下落しており、そのうち Medium から Low の間だけで 11 点も落ちています。コスト削減のために推論レベルを Low に下げると、手にするのはもはや「62 点の Astra」ではありません。リーダーボードの最高スコアだけを見てモデル選定を行うと、実際にデプロイしたときの効果を過大評価しがちです。
コストの数値も同じく AA に基づいています。総合インデックスの 1 タスクあたりコストは、GPT-6.2 Astra(Max)が $4.00、GPT-6.2 Sol(Max)が $1.01、そして Claude Fable 5.2 のページには $26.54 と記載されています。これらは AA の一連のタスクにおけるコストであり、公式の「ALE コストは Fable 5.2 の約 5%」という数字と相互に換算することはできません。
GPT-6.2 Astra の仕様と公式価格
仕様と価格は OpenAI のモデルページが基準となります。モデル ID は gpt-6.2-astra で、入力はテキストと画像に対応し、出力はテキストのみ、音声と動画には対応していません。コンテキストは 1,050,000 token、最大入力 922,000、最大出力 128,000、知識のカットオフは 2026-05-18、推論 token に対応しています。なお、API では reasoning effort を none に設定することはできません。
| 項目 | GPT-6.2 Astra 公式値(100万 token あたり) |
|---|---|
| 入力(短いコンテキストの標準料金) | $8 |
| キャッシュ読み取り | $0.40 |
| キャッシュ書き込み(30分間保持) | $10 |
| キャッシュ書き込み(12時間保持) | $20 |
| 出力 | $40 |
| 対応エンドポイント | Chat Completions、Responses、Batch |
以上が OpenAI の公式価格です。gpt-6.2-astra は APIYI にはまだ掲載されていませんが、できるだけ早くこのモデルを追加する予定です。モデル名と価格は、プラットフォームのモデルリストが基準となります。発表文を要約すると、入力と出力は GPT-6 Astra より 20% 低く、キャッシュ入力は 60% 低くなっています。
料金体系には、いくつか注意すべき細かい点があります。1回のリクエストで入力が 272K token を超えると、入力とキャッシュの単価が2倍になり、出力は短いコンテキスト時の 1.5 倍で計算されます。しかも、これはリクエスト全体に対して一括で適用されます。Batch は標準価格の 50%、Fast は同一コンテキスト長における標準価格の 2 倍です。Ultrafast は 2027-02-28(太平洋時間)までは標準価格の 3 倍、2027-03-01 からは 6 倍に変わります。
比較のために、GPT-6.2 Sol の公式価格を載せておきます。入力 $2、キャッシュ読み取り $0.10、出力 $10 です。gpt-6.2-sol も同様に APIYI にはまだ掲載されていませんが、こちらもできるだけ早く追加する予定です。モデル名と価格は、プラットフォームのモデルリストが基準となります。
モデルを確認する際は、2つの情報源を併せてチェックするとよいでしょう。APIYI apiyi.com のモデル一覧表(docs.apiyi.com/models.md)と、料金取得用の API https://api.apiyi.com/api/pricing です。一覧表のデータ時点 2026-11-17 15:54(UTC+8)では、どちらにも gpt-6.2-astra と gpt-6.2-sol はまだ掲載されていません。なお、一覧表にすでに掲載されている gpt-6-astra は前世代のモデルです。そのプラットフォーム価格を 6.2 の価格の参考にすることはできません。
GPT-6.2 Astra クイックスタート:まずタスクを選び、次に推論レベルを決める
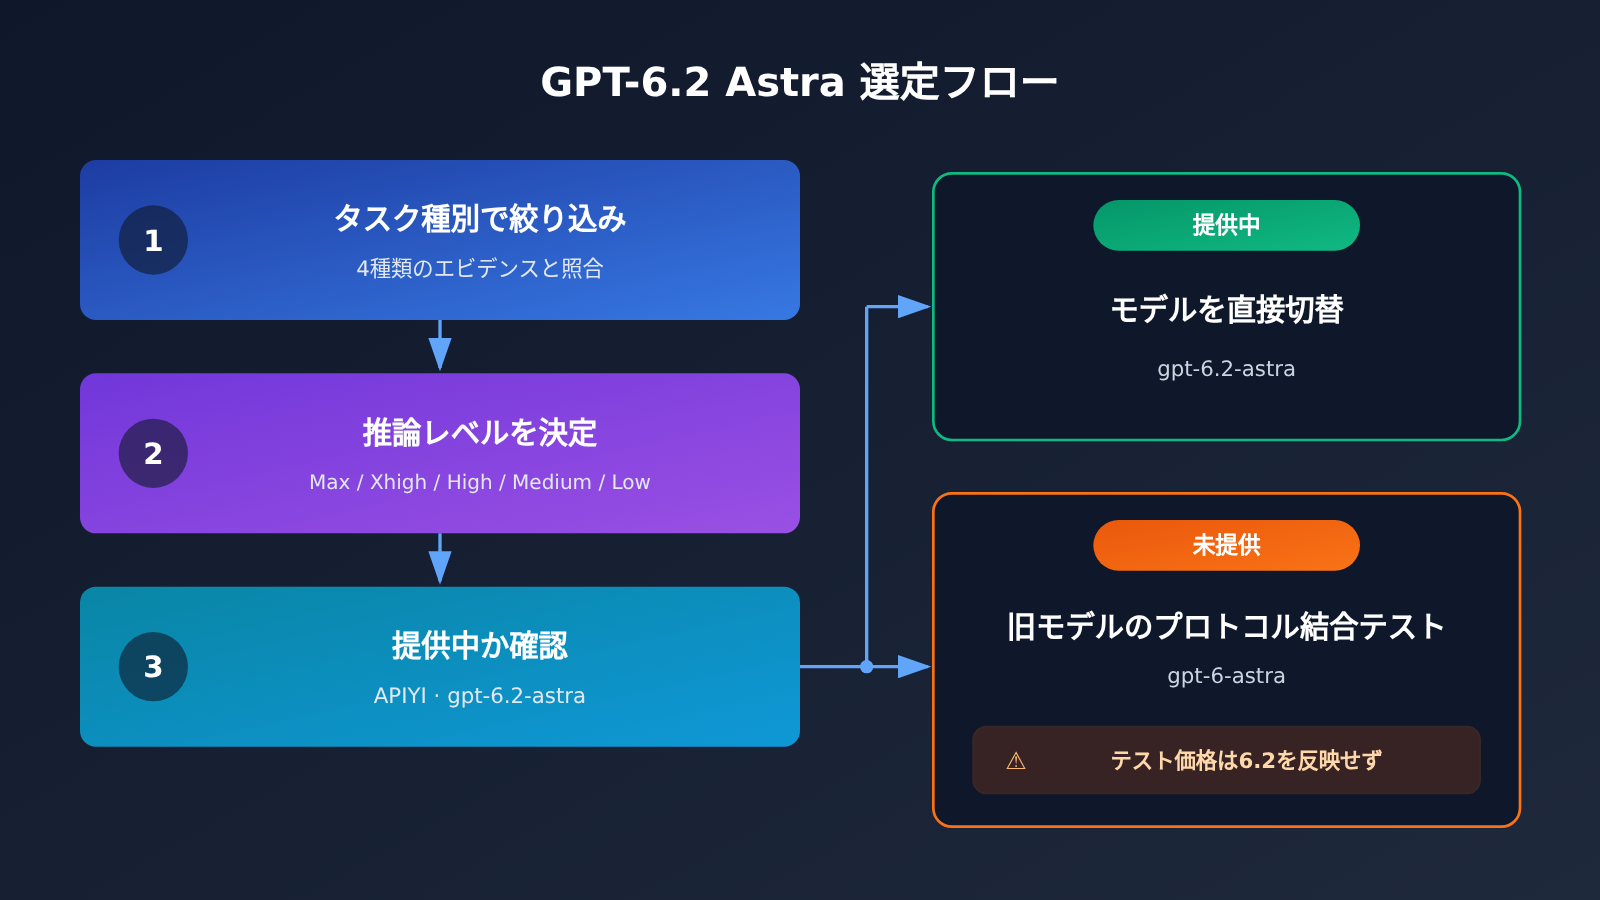
難しいタスクを GPT-6.2 Astra に任せるべきかどうかは、以下の順番で判断するのがおすすめです:
- まずタスクで選ぶ。 前述の4種類のエビデンスと照らし合わせます。専門ドキュメントの納品やターミナル科学ワークフローなら、Astra には比較的明確な公式エビデンスがあります。主にコードマージ系のタスクなら、まず Sol で要件を満たせるかを評価しましょう。脆弱性研究の場合は、一部のリクエストが拒否されることを想定しておく必要があります。
- 次に推論レベルを決める。 AA のスコア差を覚えておきましょう:Max と Xhigh は 62、High は 60、Medium は 57、Low は 46 です。コストを重視するタスクは、High または Medium から始めて A/B 比較を行うとよいでしょう。Low で難しいタスクをいきなりまかせるのはおすすめしません。
- 最後にプラットフォームのリストを確認。 APIYI apiyi.com のモデルリストを開き、
gpt-6.2-astraを検索します。すでにラインナップに載っていれば、リクエストの model フィールドをこのモデル名に置き換えるだけで切り替えられます。
もしリストにまだ 6.2 がない場合は、すでに提供されている gpt-6-astra を使ってプロトコルの結合テストから始められます。OpenAI 互換クライアントの base_url を https://api.apiyi.com/v1 に設定し、model に gpt-6-astra を指定すれば、Chat Completions または Responses のリクエスト構造、ストリーミング出力、推論パラメータを一通り動かして確認できます。念のため強調しておくと、このステップで検証するのはあくまでインターフェースのプロトコルです。結合テスト中に発生するのは gpt-6-astra の料金であり、6.2 の料金ではありませんし、結果も 6.2 の能力を表すものではありません。
結合テストの際に、事前に確認しておきたいパラメータがいくつかあります:reasoning effort には none を渡せないこと。長い入力では、272K を境にリクエスト全体の料金が倍になるラインに注意すること。バッチでのオフライン処理を行うなら、Batch の半額料金も検討する価値があります。これらは 6.2 が提供開始された後もそのまま流用できます。
🚀 導入のヒント:APIYI apiyi.com は OpenAI 互換インターフェースを提供しており、APIキー 1つで複数のモデルを呼び出せます。新規ユーザーには無料のお試しクレジットも用意されています。まずは提供中のモデルでリクエストの一連の流れを通しておけば、6.2 の提供開始後はモデル名を変更するだけで切り替えられます。
GPT-6.2 Astra のタスク別早見表
| タスクの種類 | Astra を優先検討するか | 推論レベルの目安 | 注意点 |
|---|---|---|---|
| 長尺の専門ドキュメント納品 | はい | High から開始、重要な納品には Max | 公式比較の多くは相対値 |
| ターミナル科学ワークフロー | はい | High または Xhigh | 難解な理論問題ではより強い競合がいる可能性 |
| コードマージ系の変更 | まず Sol を評価 | 予算に応じて選択 | Coding Agent Index に大きな伸びなし |
| 3D生成 | 可 | 出来栄えに応じて調整 | AA-3D はブラインド評価の Elo、公式発表の転述によるもの |
| 脆弱性研究 | 要注意 | 適用外 | 拒否される可能性あり、Daybreak は 6.2 に未接続 |
表の推論レベルの目安は、AA のスコア差をもとにした提案であり、公式の推奨値ではありません。本番運用の前には、ご自身のタスクサンプルで必ず比較を行ってください。
GPT-6.2 Astra の長所と短所の分析
強み
- 専門的な成果物の裏付けが豊富:ALE、Harvey LAB-AA、GDPval v2、AA-AnalystAgent など複数の公式自己申告指標が同じ方向を示しており、いずれもコスト低下を伴っています。
- 科学系ターミナルタスクは二重の裏付けあり:公式の自己申告と AA のサードパーティ評価の両方で、Terminal-Bench-Science 0.1 において先行していることが確認されています。
- 単位コストの低下:公式の標準価格は GPT-6 Astra と比べて入出力が 20% 低く、キャッシュ入力は 60% 低くなっています。さらに GDPval v2 では出力トークンも 22% 少なくなっています。
- 長いコンテキストと大きな出力:コンテキスト 1,050,000、最大出力 128,000 を備えており、資料一式を一括で処理するのに適しています。
制限事項
- 総合スコアは首位ではない:AA の最高設定では、Claude Fable 5.2 が 65 点、GPT-6.2 Astra は 62 点です。総合力が最重要となるシーンでは、事前に比較テストを実施しましょう。
- 推論モードの影響を受けやすい:Low モードではわずか 46 点しか出ません。モードを下げる前には、必ず自分のタスクでリグレッションテストを行ってください。
- コード面で世代を超えた向上はなし:AA の Coding Agent Index は GPT-6 Astra と同等です。コードのマージ系タスクでは、まずコストの低い Sol を評価してみるのもよいでしょう。
- セキュリティ研究には制限あり:一部の合法的な脆弱性研究が拒否される可能性があり、Daybreak にはまだ 6.2 が提供されていません。セキュリティチームは当面、Daybreak 上の GPT-6 シリーズを使い続けるしかありません。
- ブロッカーの報告漏れが起きやすい:2 つのテストにおいて、ファイルの欠落やツールが利用できないといった問題の報告漏れが発生しやすいため、エージェントワークフローではブロッカーの報告を明示的に求める必要があります。
- ハルシネーション率は低くない:AA-Omniscience のハルシネーション率(Max)は 59% で、事実に基づく出力には依然として外部での検証が必要です。
よくある質問(FAQ)
Q1:GPT-6.2 Astra とは?
GPT-6.2 Astra は、OpenAI が 2026-11-17 にリリースしたモデルで、GPT-6.2 Sol と同時に登場しました。モデル ID は `gpt-6.2-astra` です。テキストと画像を入力として受け付け、テキストを出力します。コンテキストウィンドウは 1,050,000 token で、ChatGPT Work、Codex、OpenAI API から利用できます。
Q2:GPT-6.2 Astra は現時点で最強のモデル?
単純にそう言い切ることはできません。AA のサードパーティ総合指数の最高ティアでは、Claude Fable 5.2 が 65 点、GPT-6.2 Astra が 62 点です。専門性の高い成果物・ターミナルサイエンス・3D といった個別のディメンションではリードしていることを示す証拠がありますが、コード Agent 指数は前世代と同等です。そのため、タスクごとに個別に判断する必要があります。
Q3:同じ GPT-6.2 Astra なのにスコアが異なるのはなぜ?
AA のスコアは推論ティアに紐づいているためです。Max と Xhigh は 62 点、High は 60 点、Medium は 57 点、Low は 46 点です。推論ティアが低いほど消費は少なくなりますが、スコアも下がります。スコアを引用する際は、推論ティアも併せて明記してください。
Q4:GPT-6.2 Astra は脆弱性研究に向いている?
慎重な判断が必要です。このモデルはサイバーセキュリティの「クリティカル(重大)」レベルに達しているため、安全面の制御がより厳しくなり、合法的な脆弱性研究の一部も拒否される可能性があります。防御側向けの Daybreak は現時点では 6.2 に未対応で、公式には導入に努めるという表明のみです。
Q5:今すぐ APIYI で gpt-6.2-astra を呼び出せる?
2026-11-17 15:54(UTC+8)時点のモデル一覧と料金 API では、gpt-6.2-astra はまだ掲載されていません。できるだけ早くこのモデルを提供できるよう準備を進めています。モデルと価格は、プラットフォームのモデルリストを正としてください。それまでの間は、APIYI(apiyi.com)で提供中の `gpt-6-astra` を使ってプロトコルの疎通テストを行えます。テストで発生するのは gpt-6-astra の料金であり、6.2 の価格を表すものではありません。
Q6:GPT-6.2 Astra の公式価格はいくら?
OpenAI の公式価格は、100 万 token あたりで入力 $8、キャッシュ読み取り $0.40、30 分キャッシュ書き込み $10、出力 $40 です。1 回のリクエストで入力が 272K を超えると、リクエスト全体の単価が引き上げられます。APIYI ではまだ取り扱いがなく、できるだけ早く提供できるよう準備を進めています。モデルと価格は、プラットフォームのモデルリストが正となります。
Q7:GPT-6.2 Astra の既知の弱点は?
主に 4 つの点が挙げられます。低い推論ティアではスコアの低下が顕著なこと、コード Agent 能力が前世代と同等であること、AA-Omniscience のハルシネーション率(Max)が 59% であること、そして一部のテストでファイルの欠如やツールの利用不可といったブロッキング要因の報告漏れが起きやすいことです。最初の 3 点はティアの選択や外部検証で緩和でき、最後の点は、ブロッキング要因を報告するよう指示の中で明示的に求めることで対処できます。
GPT-6.2 Astra の重要ポイント(Key Takeaways)
- 専門成果物のエビデンスが最も豊富:ALE、Harvey、GDPval v2 の公式自己申告はいずれも性能向上を示し、コストも低くなっています。
- 科学系ターミナルは二重の裏付けあり:公式自己申告とサードパーティの AA の両方で、Terminal-Bench-Science でのリードが確認できます。
- コードは大きく跳ねていない:AA Coding Agent Index は GPT-6 Astra と横ばいで、FrontierCode のコストパフォーマンスは Sol 相当です。
- 総合スコアは推論レベルで変わる:AA スコアは Max/Xhigh が 62、High が 60、Medium が 57、Low が 46 です。
- 安全性は強力だが制約あり:「重大」レベルに達しており、正当な脆弱性研究を拒否する可能性があります。Daybreak は 6.2 には未接続です。
- 導入の順番:タスクでモデルを選び、次に推論レベルを決め、最後に APIYI(apiyi.com)のモデル一覧で取り扱いの有無を確認しましょう。
まとめ
GPT-6.2 Astra の要点を振り返ります。
- タスク別の強みで見る:専門ドキュメント納品とターミナル科学のエビデンスが最も充実しています。3D では一部の単一項目でリードしており、コードは前世代と同水準です。
- 推論レベル別にスコアを見る:AA サードパーティの総合スコアは Max の 62 から Low の 46 まで下がり、レベル選びが結果に直結します。
- 情報源別に数字を見る:公式自己申告と AA サードパーティは基準が異なるため、コストもスコアも相互に換算できません。
- 安全面は別途評価を:防御はより厳格化しており、Daybreak はまだ 6.2 には未接続です。
手元に難しいタスクがある場合は、まず 4 種類のエビデンスと照らし合わせて、そのタスクが Astra の得意分野に当てはまるかを判断し、そのうえで自分のサンプルを使って推論レベル間の比較を行うのがおすすめです。
6.2 の提供開始前は、まず APIYI(apiyi.com)で提供中のモデルを使ってモデル呼び出しの一連の経路を通しておくと安心です。提供開始後はモデル名を切り替えるだけでよく、価格はプラットフォームのモデル一覧に記載されている実際の価格が基準になります。
📚 参考資料
-
OpenAI 発表記事:GPT-6.2 Astra と Sol の公式紹介および公式発表スコア
- リンク:
openai.com/index/introducing-gpt-6-2-astra-sol - 説明:専門分野のデリバリー、科学、コードに関する相対スコアと価格の概要
- リンク:
-
OpenAI システムカード:安全レベルとアラインメント評価
- リンク:
deploymentsafety.openai.com/gpt-6-2-astra-sol - 説明:サイバーセキュリティ「重大(Critical)」レベル、AI 自己改良の高閾値、Daybreak の現状
- リンク:
-
OpenAI モデルページ:仕様と公式価格
- リンク:
platform.openai.com/docs/models/gpt-6.2-astra - 説明:コンテキスト、エンドポイント、272K の課金ルール、Batch/Fast/Ultrafast の倍率
- リンク:
-
Artificial Analysis 評価記事:サードパーティによる総合指数と各項目スコア
- リンク:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - 説明:各推論レベルの総合スコア、Coding Agent Index、ハルシネーション率、Robotics
- リンク:
-
Artificial Analysis モデルページ:GPT-6.2 Astra の1タスクあたりコスト
- リンク:
artificialanalysis.ai/models/gpt-6-2-astra - 説明:総合指数における1タスクあたりコストの算出基準
- リンク:
著者:APIYI テックチーム
技術交流:APIYI 公式サイトのトップページからお気軽にお問い合わせください。より多くのモデル情報と接続方法については、docs.apiyi.com のドキュメントセンターをご覧ください


