
Jawaban langsung: Dalam kondisi ideal, cache petunjuk 30 menit bawaan OpenAI sudah lebih murah daripada tanpa cache sejak penggunaan ke-2, sedangkan cache 12 jam baru mulai hemat pada penggunaan ke-3. Kondisi ideal di sini adalah: prefiks tetap yang sama ditulis secara lengkap ke cache satu kali, semua permintaan berikutnya mengalami hit, dan tidak ada penulisan ulang selama periode tersebut. Dengan tarif resmi gpt-6-luna untuk konteks pendek standar, ketika prefiks tetap sepanjang 10000 Token dipakai total 10 kali, cache 30 menit menghemat sekitar 78.5% dibandingkan tanpa cache, sedangkan cache 12 jam menghemat sekitar 66%. Namun ini hanya hitungan untuk bagian prefiks tetap, bukan berarti seluruh permintaan mendapat diskon.
Apa yang bisa Anda pelajari setelah membaca artikel ini?
- Kondisi nyata terjadinya hit pada cache petunjuk, serta perbedaannya dengan “kemiripan semantik”.
- Bagaimana tarif penulisan untuk cache 30 menit dan 12 jam dihitung, dan mengapa biaya input biasa tidak dapat ditambahkan lagi.
- Satu set contoh perhitungan yang dapat diverifikasi untuk penggunaan 1, 2, 3, dan 10 kali, serta rumus titik impas yang berlaku untuk panjang prefiks berapa pun.
- Apa arti aturan ini bagi pengembang saat merancang struktur petunjuk dan mengatur tugas batch.
Indeks: Kami mulai dengan tabel konsep dan ringkasan dampak untuk menyelaraskan istilah serta kelompok yang terdampak; bagian “Fakta Objektif” merangkum aturan cache, harga, dan data contoh perhitungan dari dokumentasi resmi; bagian “Analisis dan Penilaian” menjelaskan hubungan matematis di balik titik impas, lalu membahas struktur petunjuk, penjadwalan batch, dan kesalahpahaman umum.
OpenAI Prompt Caching yang Perlu Diketahui: Penjelasan Konsep
| Konsep | Penjelasan singkat |
|---|---|
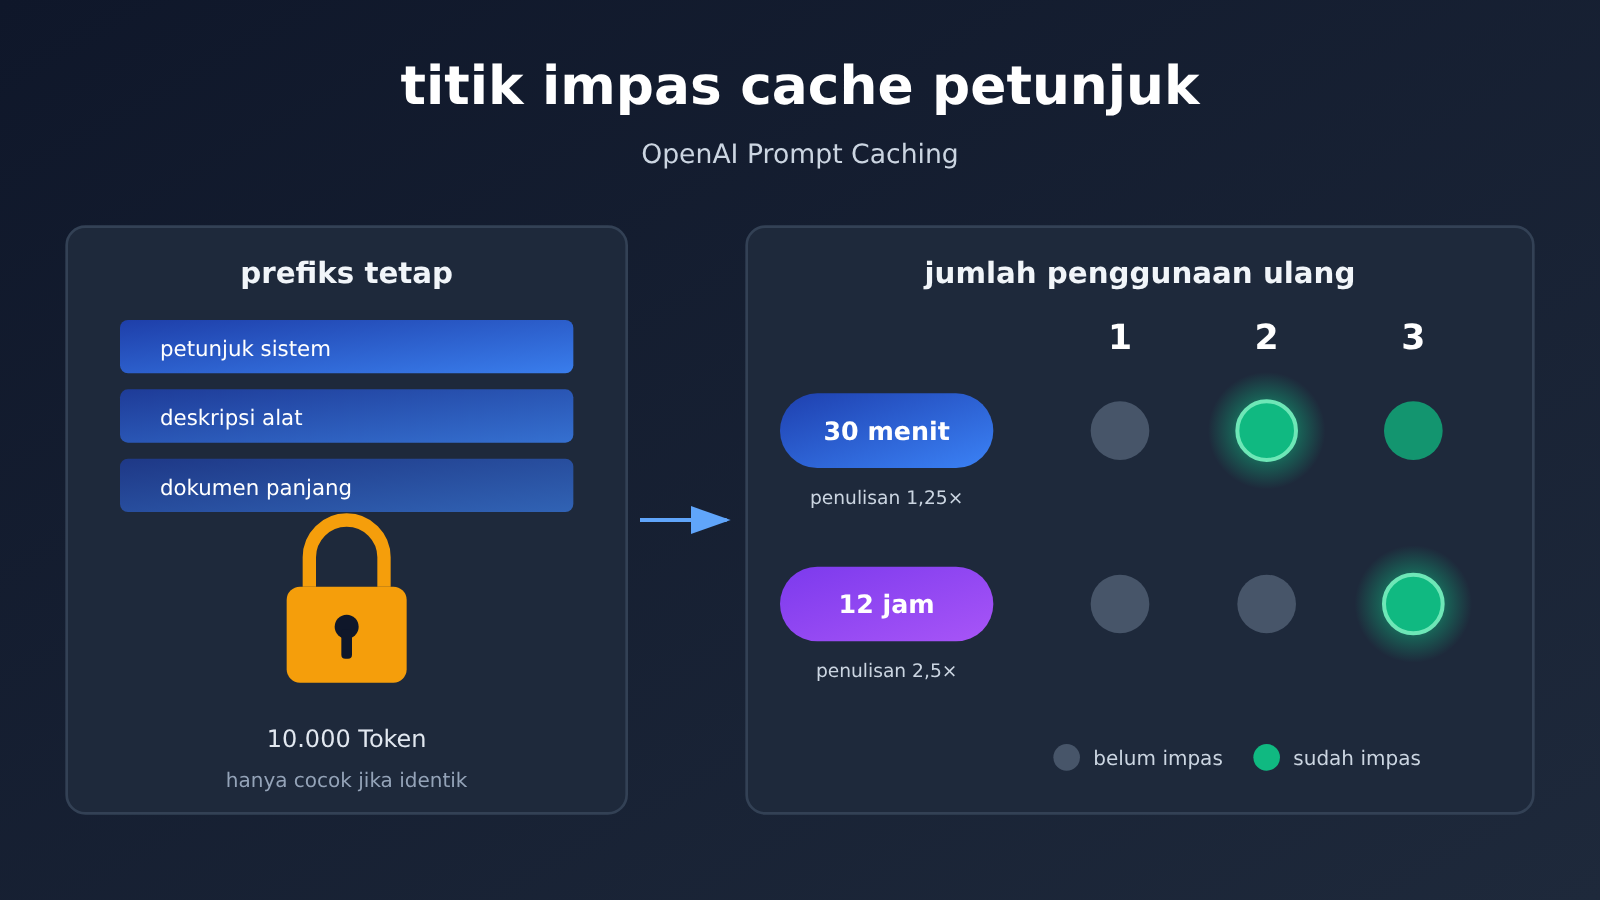
| Prompt Caching | OpenAI meng-cache prefiks prompt yang berulang; saat permintaan berikutnya mengenai cache, penagihan memakai harga “baca cache” yang lebih murah |
| Prefiks prompt | Konten berurutan dari awal pada input suatu permintaan; cache mencocokkan prefiks yang persis sama, bukan konten yang maknanya mirip |
| Token input yang dihitung | Token input yang dihitung untuk ambang cache; model GPT-5.6 dan setelahnya mensyaratkan minimal 1024 token agar cache dapat digunakan |
| Penulisan cache | Penagihan saat prefiks pertama kali disimpan ke cache, dihitung sebagai kelipatan harga input normal; ini merupakan tarif penulisan total |
| Pembacaan cache | Penagihan saat permintaan berikutnya mengenai cache, harganya jauh lebih rendah daripada input normal |
| Cache 30 menit / 12 jam | Dua pilihan masa berlaku cache; default 30 menit; opsi 12 jam tersedia di Responses API dan penulisannya lebih mahal |
| Tingkat pemrosesan Standard | Tingkat pemrosesan standar pada tabel harga resmi; harga berbeda antar tingkat pemrosesan dan tidak dapat dicampur |
| Tingkat Short context | Tabel harga resmi membedakan tingkat berdasarkan panjang konteks; artikel ini hanya memakai harga tingkat konteks pendek |
Ringkasan Dampak Prompt Caching OpenAI
- Developer API: Apakah cache menghemat biaya bergantung pada jumlah penggunaan ulang dan tingkat hit dalam masa berlaku, bukan “aktif langsung hemat”. Dengan opsi 30 menit, cukup total 2 kali penggunaan (penulisan pertama plus satu hit) agar lebih murah daripada tanpa cache; opsi 12 jam memiliki biaya penulisan lebih tinggi sehingga perlu lebih banyak penggunaan ulang untuk menutup biaya.
- Tim yang membangun Agent atau system prompt panjang: Taruh aturan tetap, deskripsi tool, dan dokumen panjang di depan; konten yang berubah di belakang; prefiks harus stabil agar cache hit. Ini masalah desain struktur, bukan parameter.
- Tim yang menangani tugas batch: Kirim permintaan dengan prefiks sama secara terkonsentrasi dalam masa berlaku cache untuk meningkatkan hit rate secara signifikan; jika tugas tersebar sepanjang hari, perlu menilai apakah opsi 12 jam layak.
- Yang bertanggung jawab atas perhitungan biaya: Cache hanya memengaruhi biaya input untuk bagian prefiks tetap; output, materi baru, pemanggilan tool, dan percobaan ulang tidak termasuk. Dalam tabel anggaran, persentase penghematan cache tidak bisa langsung diterapkan ke total tagihan.
Fakta Objektif tentang Cache Prompt OpenAI
Sumber Informasi dan Catatan Ketepatan Waktu
Materi yang menjadi dasar artikel ini diperiksa pada 2026-11-17, bersumber dari dokumentasi resmi OpenAI yang terus dipelihara: panduan cache prompt developers.openai.com/api/docs/guides/prompt-caching, serta halaman harga developers.openai.com/api/docs/pricing.md. Dokumen-dokumen tersebut dapat diperbarui kapan saja, dan kami belum memverifikasi tanggal publikasi pertama dari aturan-aturan terkait. Karena itu, artikel ini bukan berita hari ini, melainkan rangkuman dan perhitungan atas aturan yang berlaku saat ini.
Aturan pencocokan cache petunjuk
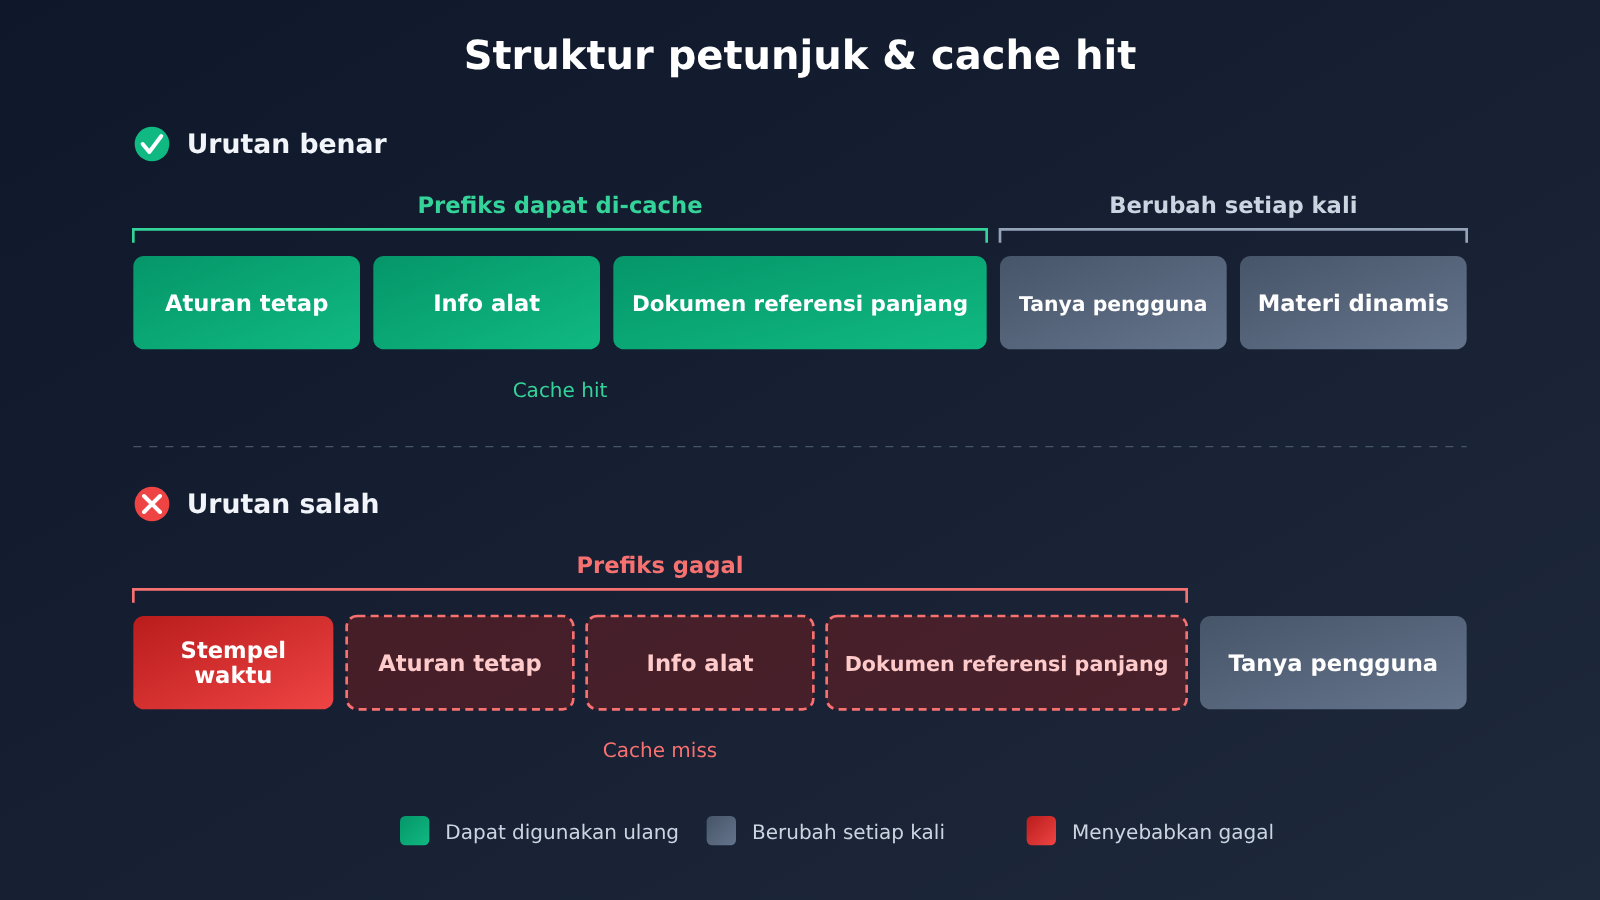
Objek pencocokan cache petunjuk OpenAI adalah prefiks petunjuk yang sama. Dua petunjuk yang maknanya hampir sama pun tidak akan cocok jika bagian awalnya berbeda — ini bukan pencarian kemiripan semantik. Artinya, perubahan satu karakter saja di dalam prefiks, misalnya menyisipkan waktu saat ini di awal petunjuk sistem, bisa membuat seluruh konten setelahnya kehilangan kesempatan untuk cocok.
Untuk GPT-5.6 dan model-model setelahnya, ambang cache adalah minimal 1024 Token input yang terlihat. Aturan model lama berbeda; kesimpulan tentang penghitungan biaya dan ambang dalam artikel ini hanya berlaku untuk aturan baru yang dijelaskan di dokumentasi resmi, dan tidak bisa langsung diterapkan pada model lama.
Dua tarif penulisan cache
| Tingkat cache | Tarif penulisan (relatif terhadap input biasa) | Keterangan penggunaan |
|---|---|---|
| 30 menit (default) | 1,25 kali | Waktu validitas cache default |
| 12 jam | 2,5 kali | Tersedia di Responses API |
Dokumentasi resmi menegaskan bahwa kedua pengali ini adalah tarif penulisan total: penulisan pertama ditagih dengan tarif tersebut, tanpa menambahkan lagi biaya input biasa. Perlu juga dicatat bahwa 12 jam merujuk pada waktu validitas cache, bukan batas waktu penghapusan data — keduanya tidak boleh dicampuradukkan.
Harga resmi gpt-6-luna
Berikut adalah harga gpt-6-luna pada halaman harga resmi OpenAI untuk tier pemrosesan Standard dan kategori Short context, dalam satuan per juta Token. Harga ini tidak dapat diterapkan pada long context atau tier pemrosesan lainnya, dan juga bukan penawaran dari platform pihak ketiga mana pun.
| Item penagihan | Harga (USD / juta Token) |
|---|---|
| Input biasa | $0.10 |
| Output | $0.50 |
| Baca cache | $0.01 |
| Penulisan cache 30 menit | $0.125 |
| Penulisan cache 12 jam | $0.25 |
Terlihat bahwa harga penulisan 30 menit sebesar $0.125 tepat 1,25 kali input biasa, sedangkan harga penulisan 12 jam sebesar $0.25 adalah 2,5 kali, sesuai dengan aturan kelipatan dalam dokumentasi. Baca cache hanya sepersepuluh dari input biasa.
Contoh perhitungan jumlah pemakaian ulang
Contoh perhitungan berikut adalah perhitungan teoretis yang diturunkan dari harga resmi, bukan hasil pengukuran aktual. Asumsinya: prefix tetap sebesar 10000 Token yang ditagih, pada penggunaan pertama ditulis penuh ke cache, kemudian setiap kali berikutnya selalu hit, dan tidak ada penulisan ulang selama periode tersebut.
| Total jumlah pemakaian | Tanpa cache | Cache 30 menit | Cache 12 jam |
|---|---|---|---|
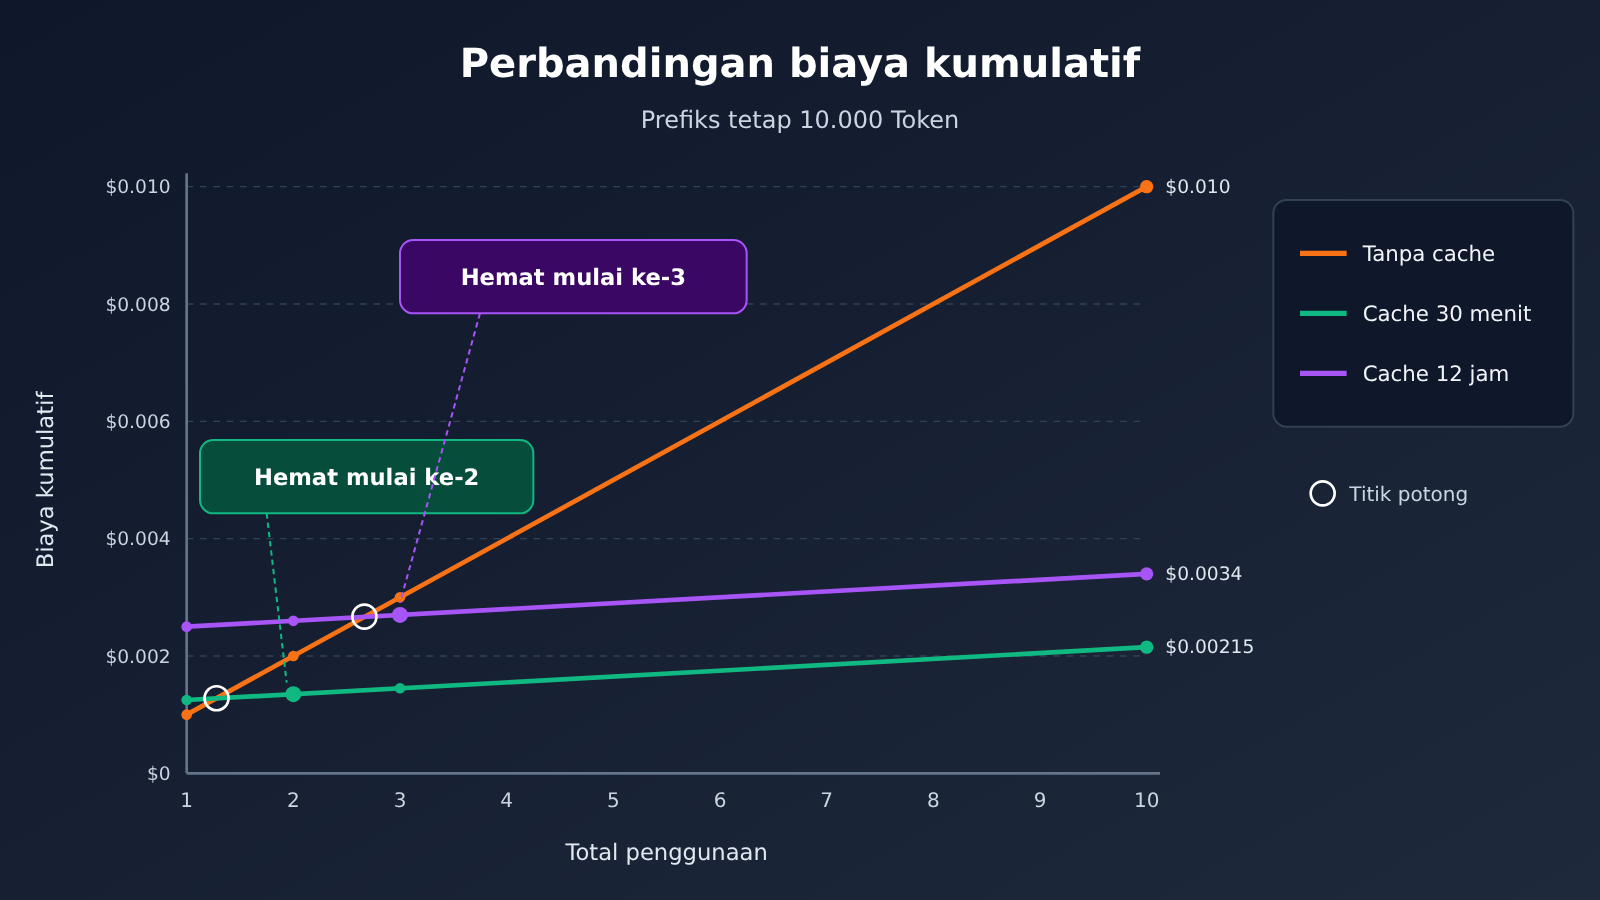
| 1 kali | $0.001 | $0.00125 | $0.0025 |
| 2 kali | $0.002 | $0.00135 | $0.0026 |
| 3 kali | $0.003 | $0.00145 | $0.0027 |
| 10 kali | $0.010 | $0.00215 | $0.0034 |
Dengan asumsi ini, cache 30 menit menjadi lebih murah daripada tanpa cache mulai dari total pemakaian kedua, sedangkan cache 12 jam menjadi lebih murah mulai dari pemakaian ketiga. Jika hanya dipakai 1 kali, kedua jenis cache justru lebih mahal daripada tanpa cache, karena Anda membayar premi penulisan tanpa menikmati diskon pembacaan.
Batas penerapan contoh perhitungan
Angka-angka dalam kelompok ini hanya menghitung bagian prefiks tetap. Materi baru yang ditambahkan pada setiap permintaan, output model, pemanggilan tool, serta percobaan ulang yang gagal, semuanya berada di luar cakupan perhitungan. Jadi angka ini bukan diskon untuk keseluruhan permintaan. Jika jeda antara dua penggunaan melebihi masa berlaku cache, permintaan berikutnya tidak bisa lagi dihitung sebagai “hit penuh”, dan biaya penulisan ulang perlu ditambahkan kembali.
Analisis dan Penilaian Cache Prompt OpenAI
Mengapa titik impasnya adalah 2 kali dan 3 kali
Dengan memperluas contoh perhitungan ke jumlah penggunaan N berapa pun, kita bisa menuliskan tiga garis biaya (dalam satuan biaya dolar per juta Token prefiks):
- Tanpa cache: 0.10 × N
- Cache 30 menit: 0.125 + 0.01 × (N − 1)
- Cache 12 jam: 0.25 + 0.01 × (N − 1)
Dengan membuat biaya cache lebih kecil daripada biaya tanpa cache, tier 30 menit memerlukan N lebih besar dari sekitar 1.28, artinya baru hemat mulai penggunaan ke-2; tier 12 jam memerlukan N lebih besar dari sekitar 2.67, artinya baru hemat mulai penggunaan ke-3. Kesimpulan ini tidak bergantung pada panjang prefiks, karena ketiga garis biaya sebanding dengan jumlah Token; prefiks yang semula 2000 Token diganti menjadi 50000 Token, jumlah kali titik impas tetap sama, yang berubah hanyalah besaran absolut yang dihemat. Prasyaratnya adalah prefiks memenuhi ambang 1024 Token dan tier harganya konsisten.
Dari segi struktur, premi penulisan adalah biaya sekali pakai, sedangkan penghematan dari setiap hit adalah selisih antara harga input biasa dan harga baca cache, yakni menghemat $0.09 per juta Token. Premi tier 30 menit hanya $0.025, sehingga satu kali hit sudah cukup menutupinya; premi tier 12 jam adalah $0.15, sehingga perlu dua kali hit untuk menutupinya. Inilah sebabnya kedua titik impas berbeda satu kali.
Skrip yang dapat digunakan ulang untuk menghitung titik impas
Skrip di bawah ini mereproduksi contoh perhitungan berdasarkan asumsi dalam artikel ini. Anda dapat mengganti harga dan jumlah penggunaan untuk dengan cepat menilai skenario Anda sendiri. Untuk parameter harga, gunakan nilai terbaru di halaman harga resmi.
# Berdasarkan harga resmi gpt-6-luna Standard / Short context (USD / juta Token)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Hanya menghitung biaya prefiks tetap; asumsikan penulisan lengkap pada penggunaan pertama, semua penggunaan berikutnya hit, tanpa penulisan ulang"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
Hasil eksekusi konsisten dengan tabel contoh perhitungan di atas. Jika kondisi aktual Anda adalah sebagian permintaan tidak hit, Anda dapat memperlakukan jumlah yang tidak hit sebagai “penulisan ulang”, dan titik impas akan bergeser sesuai.
Struktur petunjuk lebih penting daripada sakelar
Karena cache hanya mengenali prefiks yang benar-benar identik, urutan penyusunan petunjuk secara langsung menentukan tingkat cache hit. Pendekatan yang lebih aman adalah menempatkan aturan sistem tetap, penetapan peran, definisi alat, dan dokumen referensi di paling depan, lalu meletakkan pertanyaan pengguna, hasil pencarian, stempel waktu, dan materi lain yang berubah setiap kali di paling belakang. Begitu suatu field yang berubah ikut masuk ke bagian awal prefiks, sepanjang apa pun konten tetap di belakangnya tidak akan bisa digunakan ulang.
Ada satu kesalahpahaman umum lagi yang perlu disebutkan secara khusus: mengisi petunjuk dengan konten yang tidak relevan hanya agar mencapai ambang 1024 Token tidaklah menguntungkan. Token tambahan tersebut harus dibayar dengan harga tulis saat pertama kali, lalu setiap kali berikutnya juga dengan harga baca cache, dan bisa mengganggu pemahaman model terhadap instruksi yang sebenarnya. Arti ambang tersebut adalah untuk menjelaskan bahwa petunjuk pendek memang tidak memerlukan cache, bukan untuk mendorong agar petunjuk pendek dibuat menjadi panjang.
Pengaturan batch menentukan apakah semuanya bisa “tepat sasaran”
Asumsi kunci lain dari contoh perhitungan adalah semua permintaan berikutnya tepat sasaran. Dalam kenyataan, jika permintaan dengan prefiks yang sama tersebar di sepanjang hari, tingkat 30 menit kemungkinan besar akan kedaluwarsa di antara dua permintaan, sehingga setiap kali harus menulis ulang, yang justru lebih mahal daripada tanpa cache. Dalam situasi ini ada dua pendekatan: pertama, mengumpulkan tugas sejenis menjadi batch dan mengirimkannya secara berurutan dalam 30 menit; kedua, mengevaluasi tingkat 12 jam, dengan penulisan sekali pakai yang lebih tinggi untuk menukar masa berlaku yang lebih panjang.
Pilihan dapat disederhanakan menjadi penilaian berbasis pengalaman: permintaan padat dengan interval pendek, gunakan tingkat default 30 menit, cukup digunakan 2 kali total sudah lebih murah daripada tanpa cache; permintaan jarang tetapi prefiks yang sama digunakan berulang kali dalam hari yang sama, dan jumlah penggunaan total dapat secara stabil mencapai 3 kali atau lebih, maka tingkat 12 jam baru bermakna. Jika sebuah prefiks kemungkinan besar hanya digunakan 1 kali dalam masa berlaku, tanpa cache justru merupakan pilihan paling murah.
Bagian dalam perhitungan biaya yang mudah ditaksir berlebihan
Angka penghematan sekitar 78,5% dengan 10 kali penggunaan memang mencolok, tetapi itu hanya berlaku untuk biaya input prefiks tetap. Dalam struktur harga gpt-6-luna, harga output adalah 5 kali lipat dari input biasa. Jika keluaran suatu aplikasi sangat panjang, atau setiap permintaan membawa banyak materi pencarian baru, proporsi uang yang dihemat dari cache prefiks dalam total tagihan mungkin tidak tinggi. Saat menyusun anggaran, cara yang lebih masuk akal adalah memecah permintaan menjadi beberapa bagian seperti “prefiks tetap”, “input dinamis”, “output”, serta “alat dan pengulangan” untuk diperkirakan secara terpisah, dan hanya menerapkan rumus cache pada bagian pertama.
Selain itu, aturan pengali penulisan yang dijelaskan dalam artikel ini berlaku untuk GPT-5.6 dan model setelahnya; harga spesifik dalam contoh perhitungan hanya berlaku untuk gpt-6-luna tingkat pemrosesan Standard, tingkat Short context. Saat beralih ke model lama, tingkat konteks panjang, atau tingkat pemrosesan lainnya, perlu mencari harga baru dan menghitung ulang, jumlah penggunaan berulang juga mungkin berubah seiring. Dokumentasi resmi terus dipelihara, jika ada penyesuaian aturan selanjutnya, kesimpulan harus mengacu pada dokumentasi saat itu; ini adalah variabel yang perlu diperhatikan secara berkelanjutan, bukan perubahan yang sudah terjadi.
Xunzi dalam 《劝学》 menulis: “Menumpuk tanah hingga menjadi gunung, di sanalah angin dan hujan timbul; menumpuk air hingga menjadi kolam dalam, di sanalah naga muncul.” Demikian pula pembukuan cache petunjuk: satu kali penulisan hanyalah pengeluaran, penghematan sesungguhnya datang dari penggunaan ulang yang stabil berkali-kali dalam masa berlaku.


