
Catatan penulis: Artikel ini membedah halaman riset Tencent — uji buta (blind test), tabel benchmark di lampiran, dan testimoni dari pihak produk — untuk membandingkan Hy4 flash dengan GLM-5.3-Flash pada tugas sehari-hari, coding di terminal, biaya, dan protokol akses, sekaligus menjelaskan model mana yang bisa dipanggil hari ini di APIYI.
Tencent Hunyuan merilis Hy4 flash pada 2026-11-16, dan pihak resmi memposisikannya sebagai “model paling murah untuk produktivitas sehari-hari”. Banyak orang kini memilih antara GLM-5.3-Flash dan model ini sebagai tenaga utama sehari-hari. Halaman riset Tencent menyediakan tiga jenis materi: uji buta manual, tabel benchmark di lampiran, dan testimoni dari pihak produk. Arah kesimpulan dari ketiga sumber itu tidak sepenuhnya sejalan.
Ini bukan artikel kompromi bergaya “masing-masing punya kelebihan”. Di bawah ini ketiga data disajikan terpisah, dan setiap angka diberi keterangan sumbernya. Di bagian akhir diberikan pilihan yang tegas per skenario, sekaligus penjelasan model mana yang hari ini bisa langsung dipanggil di APIYI.
Nilai inti: Setelah membaca artikel ini, Anda akan tahu di mana Hy4 flash menang dalam uji buta, di mana GLM-5.3-Flash menang dalam benchmark lampiran, serta protokol dan dasar perhitungan harga yang perlu diperhatikan saat mengintegrasikannya.
Perbedaan inti Hy4 flash vs GLM 5.3 Flash
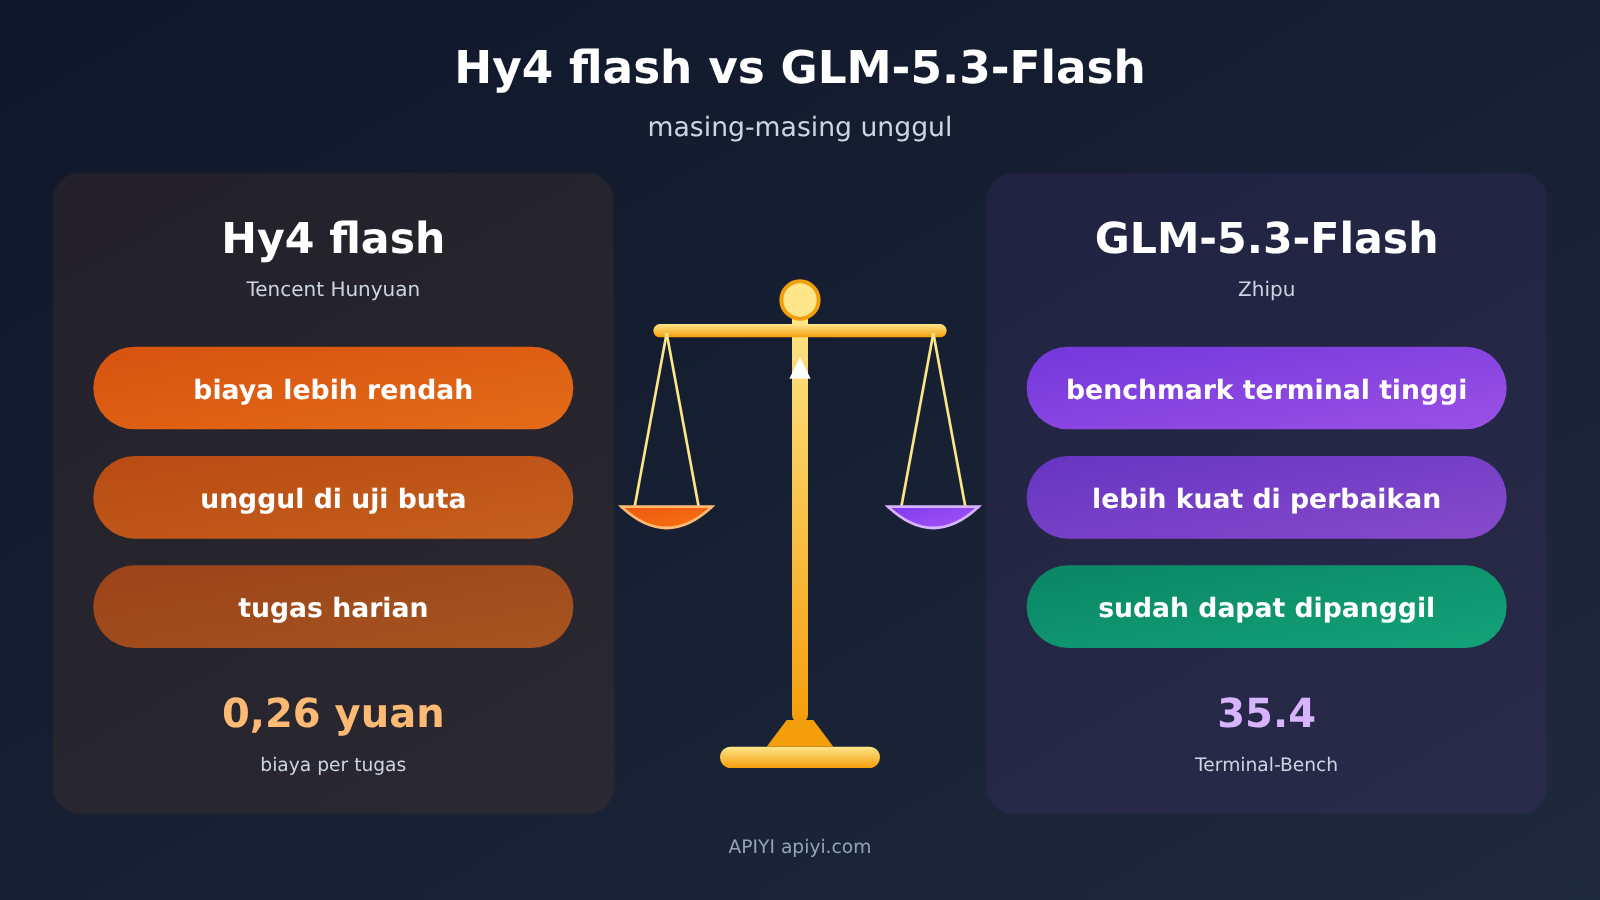
Langsung ke kesimpulan: tidak ada yang menang mutlak. Dalam uji blind Tencent, Hy4 flash memiliki tingkat kepuasan lebih tinggi, lebih cepat, dan lebih murah. Pada lampiran, untuk item seperti Terminal-Bench 4.0 dan PPTFixBench yang cenderung berfokus pada “perbaikan dan operasi terminal”, skor GLM-5.3-Flash lebih tinggi.
| Dimensi perbandingan | Hy4 flash | GLM-5.3-Flash | Sumber data |
|---|---|---|---|
| Tingkat kepuasan uji blind (skala 4 poin) | 2.79 | 2.53 | Tabel uji blind halaman riset Tencent (laporan sendiri Tencent) |
| Waktu end-to-end median | 6.7 menit | 7.6 menit | Sama seperti di atas |
| Biaya per tugas uji blind | 0.26 yuan | 0.81 yuan | Sama seperti di atas, RMB |
| Terminal-Bench 4.0 | 19.2 | 35.4 | Lampiran halaman riset Tencent |
| PPTFixBench | 23.7 | 28.6 | Lampiran halaman riset Tencent |
| MdCoEditBench (penulisan Markdown bersama) | 56.9 | 32.3 | Lampiran halaman riset Tencent |
| Spesifikasi | 224B parameter total (termasuk 64B Engram), 12B aktif, konteks 1M | 320B parameter total, 18B aktif, konteks 1M, output maksimum 128,000 | Halaman riset / halaman model APIYI |
| Platform yang tersedia | Tencent Cloud TokenHub, WorkBuddy, dll.; APIYI belum tersedia | APIYI apiyi.com sudah menyediakan glm-5.3-flash |
Halaman riset / daftar model APIYI |
Semua skor di tabel ini berasal dari pihak Tencent; GLM tidak muncul untuk membela diri. Saat membacanya, ingatlah: uji blind dan lampiran sama-sama dilaporkan sendiri oleh Tencent secara resmi, dan sebagian besar set evaluasi adalah set internal Tencent, bukan peringkat final pada papan peringkat publik.
Tiga cakupan data dalam perbandingan Hy4 flash vs GLM 5.3 Flash
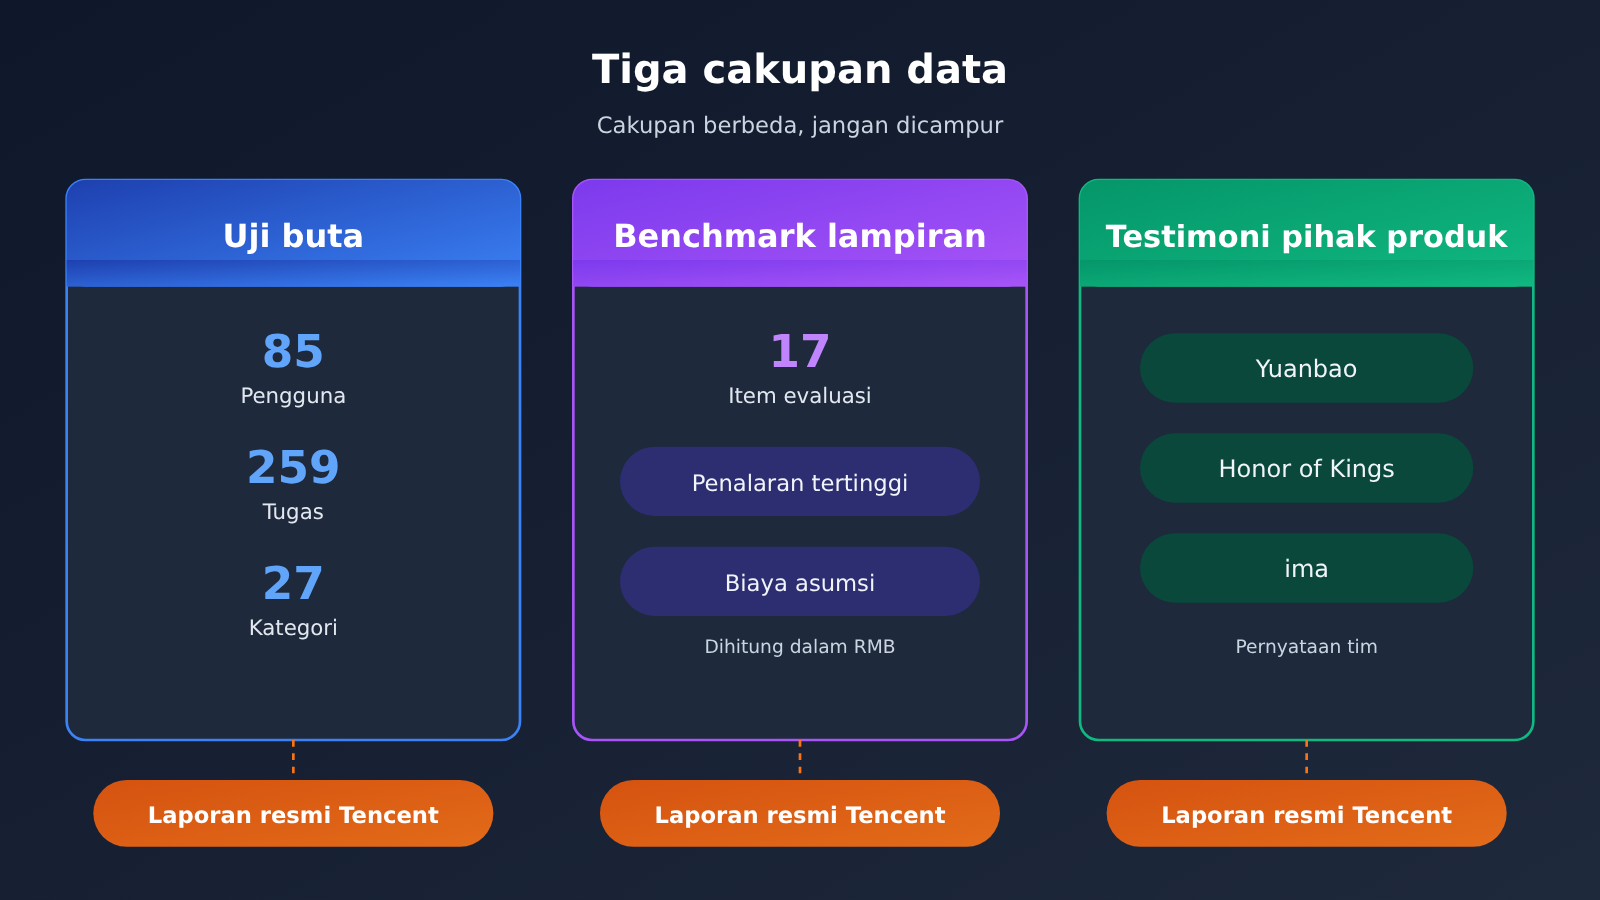
Ketiga materi memiliki cakupan yang sangat berbeda; jika dibaca dengan mencampurnya, mudah terjadi salah tafsir:
- Uji blind: 85 pengguna WorkBuddy internal, 259 tugas, 27 kategori. Model eksternal (termasuk GLM) memakai tier high; baris Hy4 flash tidak mencantumkan tier.
- Tabel lampiran: 17 item evaluasi, semua model memakai tingkat inferensi tertinggi masing-masing. Setiap sel menyertakan biaya per tugas; biaya dihitung berdasarkan harga tetap RMB yang ditetapkan Tencent.
- Keterangan dari pihak produk: angka yang dilaporkan sendiri oleh tim Yuanbao, Honor of Kings, ima, dan lainnya; masing-masing memiliki skenario dan baseline sendiri, tidak dapat digabungkan untuk perbandingan lintas produk.
Hasil Uji Buta Hy4 flash vs GLM 5.3 Flash
Uji buta adalah salah satu bukti paling menguntungkan bagi Hy4 flash. Tabel uji buta lengkap di halaman riset punya empat baris, dan kami daftarkan apa adanya seperti berikut (data yang dilaporkan sendiri oleh Tencent):
| Model | Tingkat kepuasan (skala 4) | Waktu end-to-end median | Biaya per tugas (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10.3 menit | 1.20 yuan |
| Hy4 flash (tingkat tidak disebutkan) | 2.79 | 6.7 menit | 0.26 yuan |
| Claude-Haiku-5.5 (high) | 2.81 | 6.8 menit | 4.73 yuan |
| GLM-5.3-Flash (high) | 2.53 | 7.6 menit | 0.81 yuan |
Kalau hanya melihat dua baris Hy4 flash dan GLM-5.3-Flash, tingkat kepuasan Hy4 flash lebih tinggi 0.26 poin, waktunya lebih singkat sekitar 0.9 menit, dan biaya per tugasnya kira-kira sepertiga dari GLM. Inilah dasar langsung untuk klaim “uji buta harian lebih murah”.
Ada tiga hal yang perlu dibaca dengan cermat. Pertama, skor kepuasan tertinggi ada pada DeepSeek dengan 3.09, bukan Hy4 flash. Kedua, Hy4 flash lebih rendah 0.02 poin dari Haiku, dan kata yang dipakai halaman riset adalah “mendekati” (close to), bukan melampaui. Ketiga, “penurunan biaya tugas 18 kali lipat” dalam postingan resmi berasal dari 4.73 yuan dibagi 0.26 yuan, dan objek pembandingnya adalah Haiku, bukan GLM.
Dari mana biaya uji buta Hy4 flash dibanding GLM 5.3 Flash berasal
Biaya dalam yuan di tabel uji buta dihitung oleh Tencent menurut dasar penetapan harga mereka sendiri. Angka itu mencerminkan “siapa yang mengeluarkan lebih sedikit untuk kumpulan tugas yang sama”, dan tidak sama dengan tagihan aktual Anda di platform mana pun. Biaya Hy4 flash yang rendah sebagian berasal dari harga daftar yang rendah, dan sebagian lagi karena pembelajaran penguatan (reinforcement learning) yang disebut di halaman riset berhasil memangkas rata-rata token output end-to-end sebesar 50%.
Halaman riset juga memuat satu set kesimpulan WorkIndex: biaya rata-rata per tugas adalah 1/13 dari Hy4 preview dan 1/20 dari Hy4. Kalimat-kalimat ini hanya berlaku untuk WorkIndex, jangan dipakai untuk menggantikan angka yuan di tabel uji buta, dan juga tidak ada hubungannya dengan GLM.
Benchmark Lampiran: Hy4 flash vs GLM 5.3 Flash
Lampiran adalah bagian di mana GLM-5.3-Flash berhasil membalikkan keadaan. Tabel berikut disalin utuh dari gambar bagian Appendix di halaman riset Tencent, hanya menyisakan dua kolom ini, dengan format “skor / biaya per tugas (RMB)”:
| Item evaluasi | Hy4 flash | GLM-5.3-Flash | Skor lebih tinggi |
|---|---|---|---|
| PPTGenBench | 54.2 / 0.169 | 53.6 / 1.460 | Hy4 flash |
| PPTCoEditBench | 74.0 / 0.105 | 67.3 / 0.489 | Hy4 flash |
| PPTFixBench | 23.7 / 0.253 | 28.6 / 2.517 | GLM |
| MdCoEditBench | 56.9 / 0.057 | 32.3 / 0.133 | Hy4 flash |
| WordEditBench | 46.2 / 0.629 | 47.6 / 2.840 | GLM |
| ExcelFixBench | 15.6 / 0.310 | 9.9 / 2.879 | Hy4 flash |
| AudioVideoBench | 17.8 / 0.344 | 11.9 / 3.370 | Hy4 flash |
| BuddyVQA Atlas (tanpa alat) | 48.5 / 0.007 | 50.1 / 0.019 | GLM |
| DeepSWE v1.1 | 64.6 / 0.290 | 67.8 / 3.230 | GLM |
| ProgramBench | 16.0 / 0.561 | 13.0 / 17.959 | Hy4 flash |
| Terminal-Bench 4.0 | 19.2 / 0.558 | 35.4 / 5.597 | GLM |
| APEX-Agents v1.1 | 63.1 / 0.087 | 51.5 / 0.485 | Hy4 flash |
| AutomationBench v1.0.6 | 52.2 / 0.038 | 48.4 / 0.104 | Hy4 flash |
| HLE-Full (dengan alat) | 55.2 / 0.060 | 52.2 / 0.616 | Hy4 flash |
| OSWorld 2.1 | 68.1 / 0.451 | 64.0 / 3.803 | Hy4 flash |
| MMMU-Pro | 75.8 / 0.010 | 77.0 / 0.013 | GLM |
| ZeroBench-main (dengan alat) | 45.8 / 0.077 | 35.3 / 1.861 | Hy4 flash |
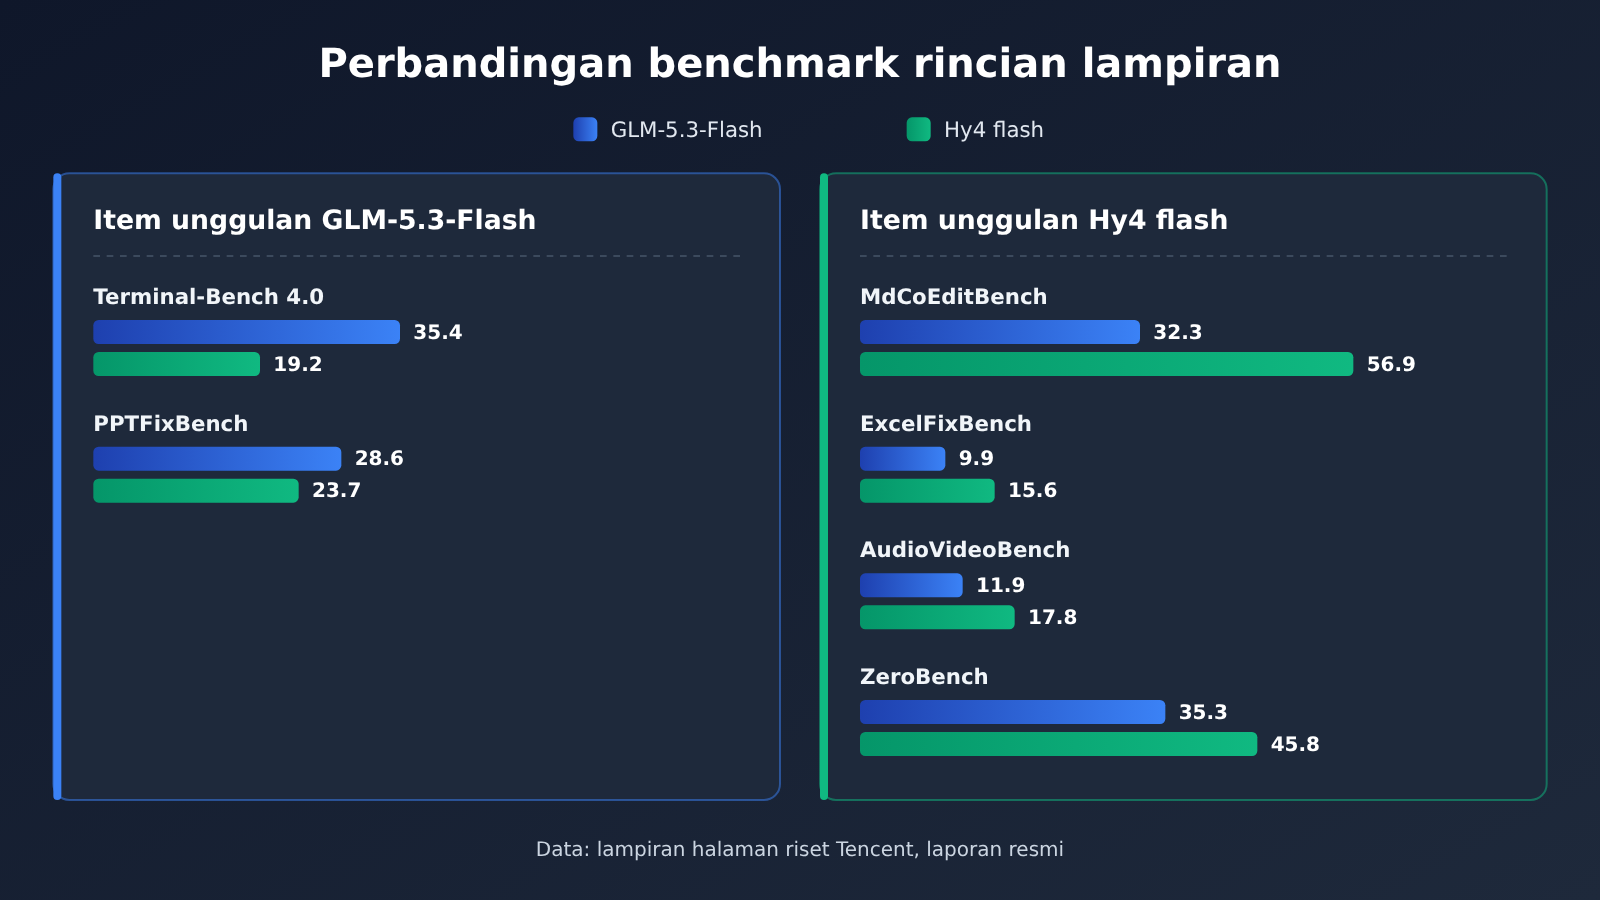
Selisih terbesar ada pada Terminal-Bench 4.0: GLM 35.4, Hy4 flash 19.2, hampir dua kali lipat. Benchmark ini memakai harness Claude Code, maksimal 500 putaran dengan durasi terpanjang 13 jam per sesi, dan menguji operasi terminal jangka panjang. Di PPTFixBench, GLM juga unggul sekitar 5 poin. Selain itu, GLM sedikit unggul pada DeepSWE, WordEditBench, BuddyVQA, dan MMMU-Pro.
Yang membuat Hy4 flash meninggalkan GLM adalah penulisan bersama Markdown (56.9 vs 32.3), perbaikan tabel, pemrosesan audio-video, dan ZeroBench. Item-item ini lebih dekat ke pekerjaan kantor sehari-hari: “menulis dokumen, memperbaiki tabel, mengolah materi”. Ini sejalan dengan rekomendasi di halaman riset: untuk rekayasa perangkat lunak jangka panjang, tetap gunakan Hy4, bukan Hy4 flash.
Kolom biaya di lampiran adalah asumsi Tencent, bukan tagihan platform
Keterangan asli di lampiran: biaya dihitung berdasarkan harga API resmi masing-masing model, dengan 1 dolar AS dikonversi ke 7.2 yuan. Harga tetap yang dipakai GLM-5.3-Flash adalah 0.8 yuan per juta token untuk input, 0.23 yuan untuk cache hit, dan 2.8 yuan untuk output, ditandai sebagai “harga API standar”. Ini adalah asumsi lampiran saat Tencent menyusun tabel, bukan harga resmi APIYI, dan jangan dipakai untuk mengonversi tagihan Anda di APIYI.
Testimoni pihak produk: Hy4 flash vs GLM 5.3 Flash
Halaman riset juga menyertakan testimoni dari tim produk Tencent, dan tiga di antaranya menyebut GLM-5.3-Flash secara langsung. Semuanya adalah pernyataan pihak produk sendiri, dengan skenario dan baseline yang berbeda-beda:
- Yuanbao (pernyataan pihak produk):Percakapan umum 2.52% lebih tinggi daripada GLM-5.3-Flash, dengan perbedaan paling jelas pada percakapan multi-giliran. Ini adalah evaluasi internal tim Yuanbao, bukan peringkat publik.
- Honor of Kings (pernyataan pihak produk):Dibandingkan dengan DeepSeek-V4.1-Flash-1017 dan GLM-5.3-Flash, kemampuan lokalisasi akar masalahnya hampir setara. Permintaan model 22.0% hingga 39.1% lebih sedikit, token 40.5% hingga 61.2% lebih sedikit, dan pemanggilan alat masing-masing 51.2% dan 7.7% lebih banyak.
- ima (pernyataan pihak produk):Dibandingkan kedua model di atas, waktu tunggu rata-rata 18% hingga 35% lebih singkat, skor respons 1.8% lebih tinggi, dan kualitas konten 8.1% lebih tinggi.
Kesamaan dari beberapa poin ini: Hy4 flash unggul dalam “lebih sedikit token, lebih sedikit menunggu”, sementara pada kualitas hampir setara atau sedikit unggul. Ini mendukung kesimpulan pengujian buta, tetapi tidak bisa membantah selisih Terminal-Bench di lampiran, karena jenis tugasnya sama sekali berbeda.
Perbandingan harga dan akses Hy4 flash vs GLM 5.3 Flash
Harga adalah bagian yang paling mudah salah tulis. Angka dari sumber berbeda tidak boleh dicampur; tabel di bawah memisahkan asal setiap harga (satuan semuanya dolar per satu juta token):
| Model / Sumber | Input | Output | Baca cache | Keterangan |
|---|---|---|---|---|
| Hy4 flash (harga resmi halaman riset Tencent) | 0.070 | 0.281 | 0.003 | Bukan harga resmi APIYI; TokenHub diskon 50% hingga 2026-11-30 |
glm-5.3-flash (halaman model APIYI apiyi.com) |
0.15 | 0.50 | 0.03 | Sudah tersedia, grup CodexResponses, Default, SVIP, pengali 1x |
glm-5-3-flash-260828 (tabel lengkap APIYI) |
0.15 | 0.499995 | 0.03 | Jalur lain, tidak bertentangan dengan baris sebelumnya |
hy4 (tabel lengkap APIYI) |
0.85 | 2.55 | 0.045 | Ini Hy4, bukan Hy4 flash |
| Hy4 (harga resmi halaman riset Tencent) | 0.834 | 2.501 | 0.042 | Harga resmi halaman riset, dipandang terpisah dari harga APIYI |
Diskon 50% Hy4 flash adalah harga jendela terbatas dari TokenHub. Halaman riset tidak mencetak tabel harga setelah diskon secara terpisah; jika Anda memperkirakannya sendiri dengan membagi 2, ingat bahwa setelah 30 November harga kembali ke harga resmi.
Hy4 flash belum tersedia di platform, kami akan segera menayangkan model ini; model dan harga mengacu pada daftar model platform. Saat ini APIYI hanya punya hy4, tidak ada versi flash Hunyuan sama sekali. Jika yang Anda butuhkan adalah versi Hunyuan Tencent dengan batas atas tinggi, Anda bisa memakai hy4 lebih dulu; jika yang Anda inginkan justru Hy4 flash, pada tahap ini hanya bisa lewat saluran resmi seperti Tencent Cloud TokenHub, WorkBuddy, dan sejenisnya. Halaman riset juga tidak memberikan ID model API, jadi sebelum memanggil, gunakan nama yang ditampilkan di konsol TokenHub.
Cara memanggil GLM-5.3-Flash di APIYI
glm-5.3-flash sudah bisa dipanggil hari ini. Di APIYI, model ini hanya mendukung OpenAI Chat Completions, tidak mendukung Anthropic Messages, dan juga tidak mendukung Responses. Hal ini menentukan apakah Anda bisa langsung menghubungkannya ke beberapa klien:
- Buat kunci di konsol apiyi.com.
- Setel base_url klien ke
https://api.apiyi.com/v1, jalur permintaannya adalah/chat/completions. - Di body permintaan, isi
modeldenganglm-5.3-flash, dan kirimmessagesdalam format OpenAI. - Thinking aktif secara default, input bisa teks, gambar, atau video, sedangkan output berupa teks.
Jika alat Anda hanya bisa mengirim permintaan berformat Anthropic Messages, glm-5.3-flash tidak bisa dipakai langsung. Untuk skenario seperti ini, entah ganti ke klien yang mendukung Chat Completions, atau ganti ke model yang menyediakan endpoint chat dan messages sekaligus. Parameter seperti konteks, output maksimum, dan endpoint mengacu pada halaman model APIYI.
🚀 Saran integrasi: Untuk model yang sudah tersedia di APIYI, gunakan kunci apiyi.com, kirim permintaan ke
https://api.apiyi.com/v1, dan klien yang kompatibel dengan OpenAI cukup mengubah dua konfigurasi agar langsung berjalan. Pengguna baru mendapat kuota uji gratis, jadi Anda bisa mencobaglm-5.3-flashdengan tugas harian Anda sendiri lebih dulu.
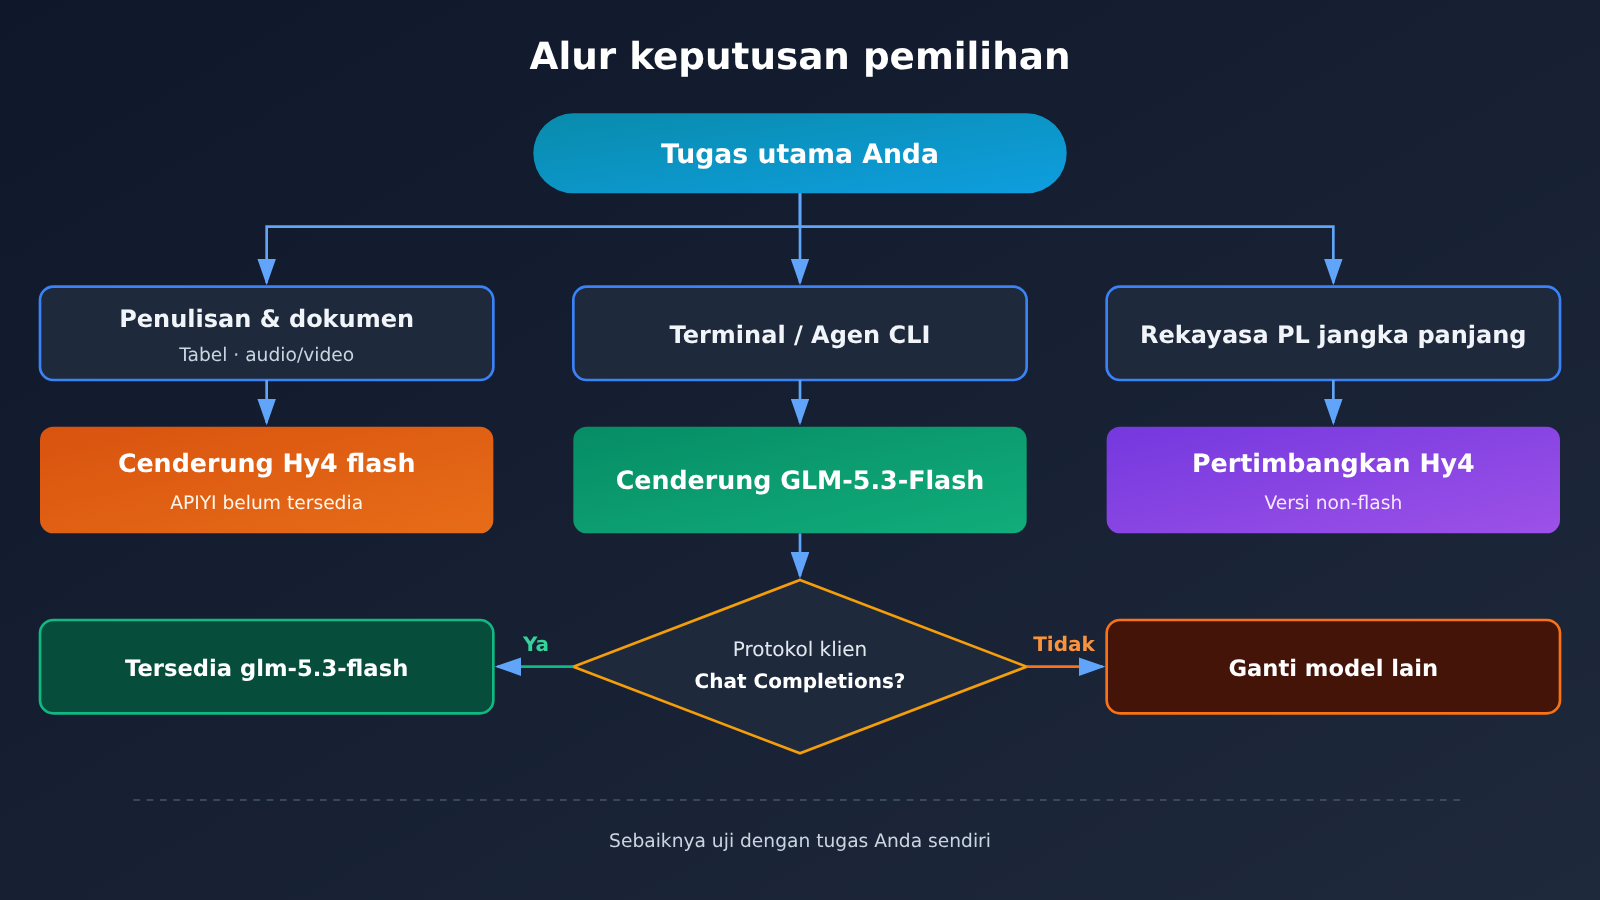
Rekomendasi skenario: Hy4 flash vs GLM 5.3 Flash
Kapan memilih Hy4 flash
- Penulisan dokumen & Markdown bersama: pada lampiran MdCoEditBench skornya 56.9 vs 32.3, selisihnya jelas terlihat.
- Perbaikan tabel, pemrosesan materi audio-video: Hy4 flash unggul di dua benchmark ini, ExcelFixBench dan AudioVideoBench.
- Tugas harian frekuensi tinggi yang sensitif biaya: blind test per tugas 0.26 yuan vs 0.81 yuan (angka yang dilaporkan sendiri oleh Tencent).
- Produk percakapan multi-giliran: menurut tim produk Yuanbao, percakapan umum lebih tinggi 2.52%, dan paling terasa pada percakapan multi-giliran.
Kapan memilih GLM-5.3-Flash
- Operasi terminal & tugas command line jarak panjang: Terminal-Bench 4.0 menunjukkan 35.4 vs 19.2, selisih terbesar di antara semua kategori.
- Tugas slide jenis perbaikan: PPTFixBench 28.6 vs 23.7.
- Butuh live hari ini:
glm-5.3-flashsudah tersedia di APIYI, sedangkan Hy4 flash belum. - Toolchain berbasis Chat Completions: klien dengan format OpenAI bisa langsung terhubung.
Saran keputusan: Hy4 flash vs GLM 5.3 Flash
| Situasi Anda | Saran |
|---|---|
| Sebagian besar pekerjaan berupa penulisan, dokumen, tabel, pemrosesan materi | Tunggu Hy4 flash tersedia, atau coba dulu lewat kanal resmi Tencent |
| Sebagian besar pekerjaan berupa operasi terminal, Agent command line | Pilih GLM-5.3-Flash |
| Perlu live di APIYI hari ini | Pilih glm-5.3-flash, lewat Chat Completions |
| Klien hanya mendukung Anthropic Messages | glm-5.3-flash tidak cocok, ganti ke model yang mendukung messages |
| Rekayasa perangkat lunak jarak panjang | Keduanya bukan pilihan utama, halaman riset menyarankan Hy4 |
💡 Saran pemilihan: blind test dan lampiran memberi arah yang berbeda, jadi cara paling aman adalah menjalankan sendiri satu batch tugas Anda pada masing-masing model.
glm-5.3-flashbisa langsung Anda uji di APIYI apiyi.com sekarang; setelah Hy4 flash tersedia, cukup ganti parametermodeluntuk membandingkannya dalam kode yang sama.
Pertanyaan Umum (FAQ)
Q1: Apa itu Hy4 flash dan GLM-5.3-Flash?
Hy4 flash adalah model untuk tugas sehari-hari yang dirilis Tencent Hunyuan pada 2026-11-16, dengan 224B parameter total, 12B aktif, dan jendela konteks 1M. GLM-5.3-Flash menurut catatan halaman model APIYI memiliki 320B parameter total, 18B aktif, dan jendela konteks 1M; vendor merilisnya pada 2026-08-26.
Q2: Hy4 flash dibandingkan GLM 5.3 Flash, siapa yang lebih kuat?
Tergantung jenis tugas. Dalam uji buta Tencent, tingkat kepuasan Hy4 flash adalah 2,79 dan GLM 2,53; di lampiran, Terminal-Bench 4.0 dan PPTFixBench lebih tinggi untuk GLM, sedangkan penulisan bersama Markdown, tabel, audio-video, dan ZeroBench lebih tinggi untuk Hy4 flash. Semua data dilaporkan sendiri oleh pihak resmi Tencent.
Q3: Yuanbao menyebut percakapan umum 2,52% lebih tinggi daripada GLM-5.3-Flash, apakah bisa dipercaya?
Ini adalah evaluasi yang diklaim sendiri oleh pihak produk Yuanbao, bukan peringkat publik, dan tidak ada rincian metode yang dipublikasikan. Ini bisa menjadi petunjuk bahwa Hy4 flash mungkin unggul untuk percakapan multi-turn, tetapi tidak sebaiknya dianggap sebagai kesimpulan pasti.
Q4: Apakah 0,8 yuan, 0,23 yuan, dan 2,8 yuan untuk GLM di lampiran adalah harga APIYI?
Bukan. Itu adalah asumsi harga tetap dalam yuan Tiongkok yang dipakai Tencent saat menyusun tabel lampiran. Harga `glm-5.3-flash` di halaman model APIYI adalah input 0,15, output 0,50, cache read 0,03 dolar AS per juta token; patokannya adalah daftar model di platform.
Q5: Apakah Hy4 flash sekarang bisa dipanggil di APIYI?
Hy4 flash belum tersedia; kami akan segera menghadirkan model ini. ID model dan harga mengikuti daftar model di platform. Saat ini yang bisa dipanggil di APIYI adalah `glm-5.3-flash` dan `hy4`; perhatikan bahwa `hy4` bukan versi flash. Info ketersediaan dapat dilihat di daftar model apiyi.com.
Q6: Apakah glm-5.3-flash bisa dihubungkan ke klien yang hanya mendukung format Anthropic?
Tidak bisa. `glm-5.3-flash` di APIYI hanya menyediakan endpoint OpenAI Chat Completions, tidak mendukung Messages dan Responses. Klien harus bisa mengarahkan base_url ke `/v1` dan mengirim permintaan Chat Completions.
Q7: Apa saja keterbatasan yang sudah diketahui dari kedua model?
Hy4 flash hanya mendapat 19,2 poin di Terminal-Bench 4.0, dan halaman risetnya juga mengakui bahwa rekayasa perangkat lunak jangka panjang tidak sebaik Hy4; bobot modelnya saat ini baru direncanakan untuk open source. GLM-5.3-Flash tertinggal dalam tingkat kepuasan uji buta dan penulisan bersama Markdown, serta hanya melalui Chat Completions. Data perbandingan keduanya berasal dari pihak Tencent.
Perbandingan Hy4 flash vs GLM 5.3 Flash: Poin-Poin Penting (Key Takeaways)
- Uji buta (blind test) Hy4 flash unggul: tingkat kepuasan 2.79 vs 2.53, 6.7 menit vs 7.6 menit, 0.26 yuan vs 0.81 yuan.
- Benchmark terminal GLM lebih tinggi: Terminal-Bench 4.0 adalah 35.4 vs 19.2, PPTFixBench juga GLM memimpin.
- Item kantor sehari-hari Hy4 flash lebih tinggi: penulisan bersama Markdown, perbaikan tabel, audio-video, skor ZeroBench lebih tinggi.
- Kesaksian hanya klaim sendiri: “lebih tinggi 2.52%” dari Yuanbao adalah klaim pihak produk sendiri, bukan papan peringkat publik.
- Harga: pisahkan sumbernya: yuan di lampiran adalah asumsi Tencent, dolar di halaman riset adalah tarif list (rate card), keduanya bukan harga resmi APIYI.
- Yang bisa dipanggil hari ini adalah GLM:
glm-5.3-flashsudah tersedia di APIYI apiyi.com, hanya mendukung Chat Completions.
Ringkasan
Kesimpulan inti dari perbandingan Hy4 flash vs GLM 5.3 Flash:
- Untuk tugas harian, pilih Hy4 flash: dalam uji buta Tencent lebih memuaskan, lebih cepat, lebih murah, dan benchmark dokumen serta tabel juga lebih tinggi.
- Untuk tugas terminal, pilih GLM-5.3-Flash: selisih Terminal-Bench 4.0 hampir dua kali lipat, tugas command-line jarak panjang (long-horizon) sebaiknya tidak memilih Hy4 flash.
- Untuk implementasi, lihat ketersediaan dan protokol: yang bisa dipanggil di APIYI hari ini adalah
glm-5.3-flash, hanya lewat Chat Completions; Hy4 flash belum tersedia.
Jika tugas Anda terutama menulis dan dokumen, Anda bisa memantau progres ketersediaan Hy4 flash; jika lebih condong ke operasi terminal, atau perlu langsung online, glm-5.3-flash adalah pilihan yang lebih langsung. Disarankan memakai kuota uji gratis di apiyi.com, jalankan tugas nyata Anda sendiri satu putaran dulu baru memutuskan.
📚 Referensi
-
Halaman riset Tencent Hunyuan Hy4 flash: tabel blind test, benchmark lampiran, testimoni pihak produk, dan harga daftar
- Tautan:
hy.tencent.ai/research/hy4-flash - Keterangan: semua blind test, skor lampiran, dan testimoni dalam artikel ini bersumber dari halaman ini, dan merupakan klaim resmi Tencent sendiri
- Tautan:
-
Postingan rilis resmi Tencent Hunyuan: rilis Hy4 flash dan harga daftar API
- Tautan:
x.com/TencentHunyuan/status/2122217770314301469 - Keterangan: sumber klaim “penurunan biaya tugas hingga 18 kali lipat”, dengan objek pembanding Claude Haiku 5.5
- Tautan:
-
Halaman model GLM-5.3-Flash di APIYI: parameter, konteks, endpoint, dan harga
- Tautan:
docs.apiyi.com/models/glm-5-3-flash - Keterangan: spesifikasi dan protokol
glm-5.3-flashmengacu pada halaman ini
- Tautan:
Penulis: Tim Teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman utama situs APIYI. Untuk model lain dan penjelasan integrasi, kunjungi pusat dokumentasi di docs.apiyi.com


