
Ringkasan: Artikel ini menjawab satu pertanyaan: apakah GPT-6.2 Sol dapat menangani pertanyaan data dari pengguna front-end, dan pertanyaan mana yang masih perlu diperiksa ulang.
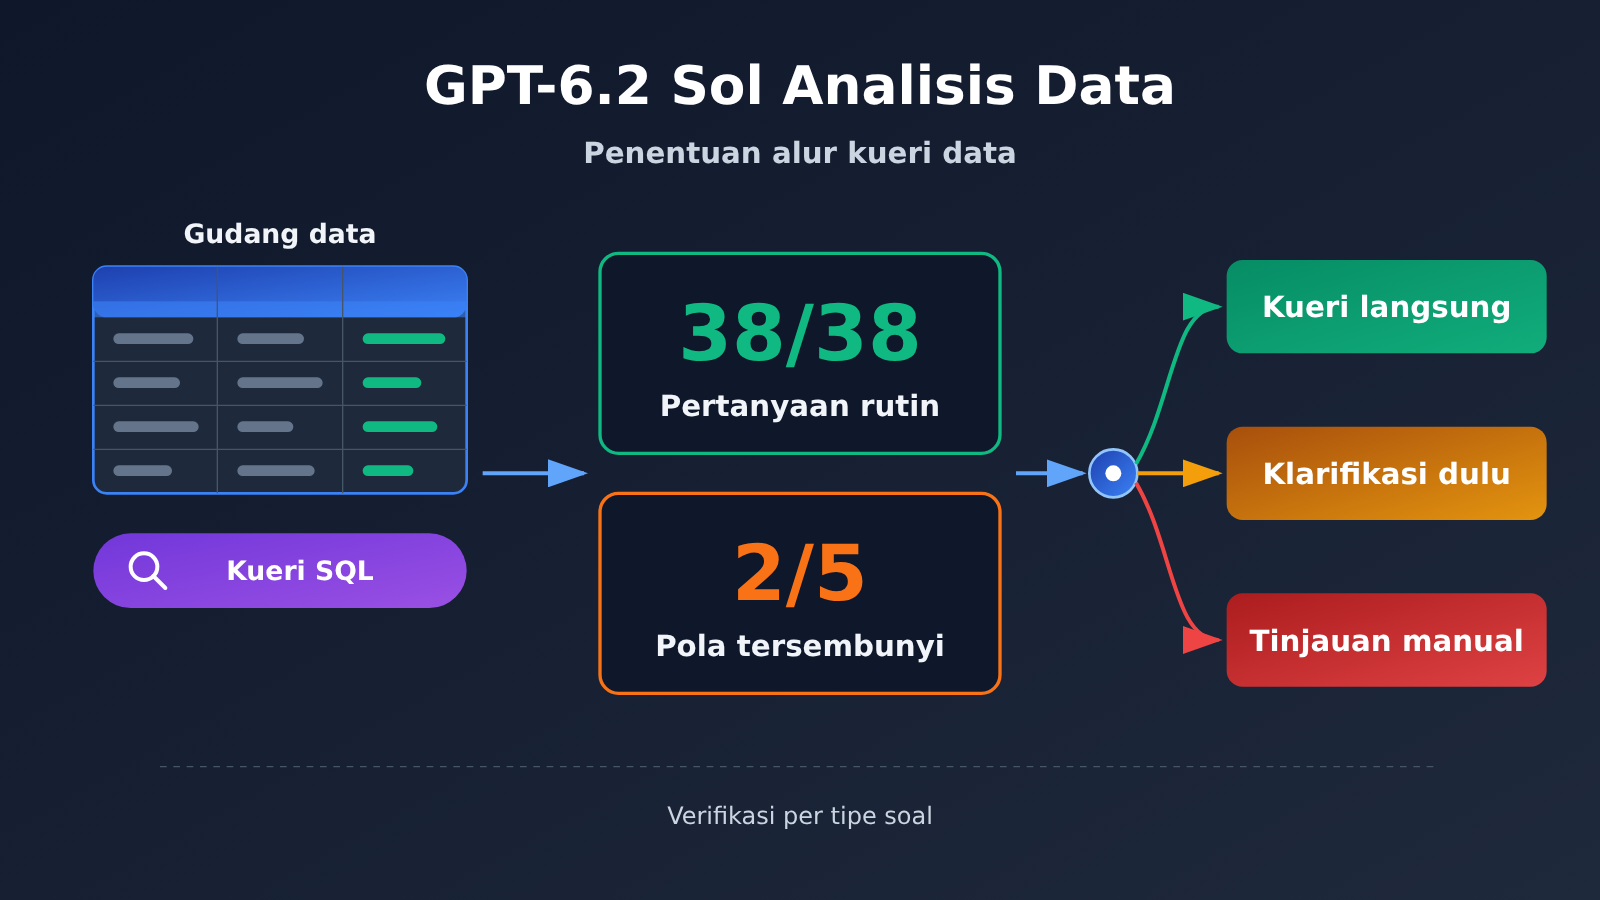
Performa GPT-6.2 Sol dalam analisis data dapat dibagi menjadi dua bagian. Dalam pengujian khusus satu putaran yang dirilis Plotly pada 17 November 2026, model ini menjawab benar seluruh 38 soal dari lima kategori: analisis rutin, penilaian ambiguitas, data yang tidak dapat dijawab, kualitas data, dan jebakan statistik. Waktu median per soal sekitar 10,5 detik. Dalam putaran pengujian yang sama, dari 5 soal pola tersembunyi, hanya 2 yang berhasil dijawab.
Dari sini dapat disimpulkan: pertanyaan data ringkasan dengan definisi metrik yang jelas dan dampak kecil dapat diujicobakan untuk dijawab langsung oleh Sol dengan izin hanya-baca; jika definisi metrik tidak lengkap, minta Sol mengklarifikasi terlebih dahulu; atribusi terbuka dan keputusan eksternal harus diserahkan kepada analis untuk ditinjau. Kesimpulan ini memiliki tiga prasyarat: pengujian hanya dijalankan satu putaran, bank soal berupa soal berbahasa Inggris yang mensimulasikan perusahaan tenaga angin, dan biaya berasal dari saluran OpenRouter. Setelah beralih ke data dan saluran Anda sendiri, perlu dilakukan penerimaan ulang berdasarkan jenis soal.
Peta Pengetahuan dan Indeks Bacaan Analisis Data GPT-6.2 Sol
Diagram di bawah ini adalah logika pembagian tugas untuk keseluruhan artikel. Setiap cabang mencantumkan kondisi input, output yang harus diberikan model, serta nomor bagian cabang tersebut di dalam teks.
Pengguna mengajukan pertanyaan data
 │
 ├─ Definisi metrik jelas + ringkasan berdampak rendah ──→ [1] Sol hanya-baca untuk tanya data
 │                              Output: nilai + pembilang/penyebut + rentang waktu & zona waktu + pernyataan kueri
 │
 ├─ Definisi metrik tidak ada / data kurang ────→ [3.2] Klarifikasi dulu
 │                              Output: satu pertanyaan lanjutan yang spesifik + daftar definisi metrik yang tersedia
 │
 └─ Analisis akar masalah terbuka / keputusan eksternal ──→ [3.3] Serahkan ke analis untuk ditinjau
                                Output: catatan penyelidikan awal + bukti pendukung + pemeriksaan penjelasan alternatif
            ↓
   [2] Gunakan latensi dan biaya per pertanyaan untuk memutuskan apakah ditaruh di lini depan
            ↓
   [4] Uji penerimaan dengan data sendiri berdasarkan jenis soal, serahkan hasil lengkap dengan tanggal data dan bukti kueri
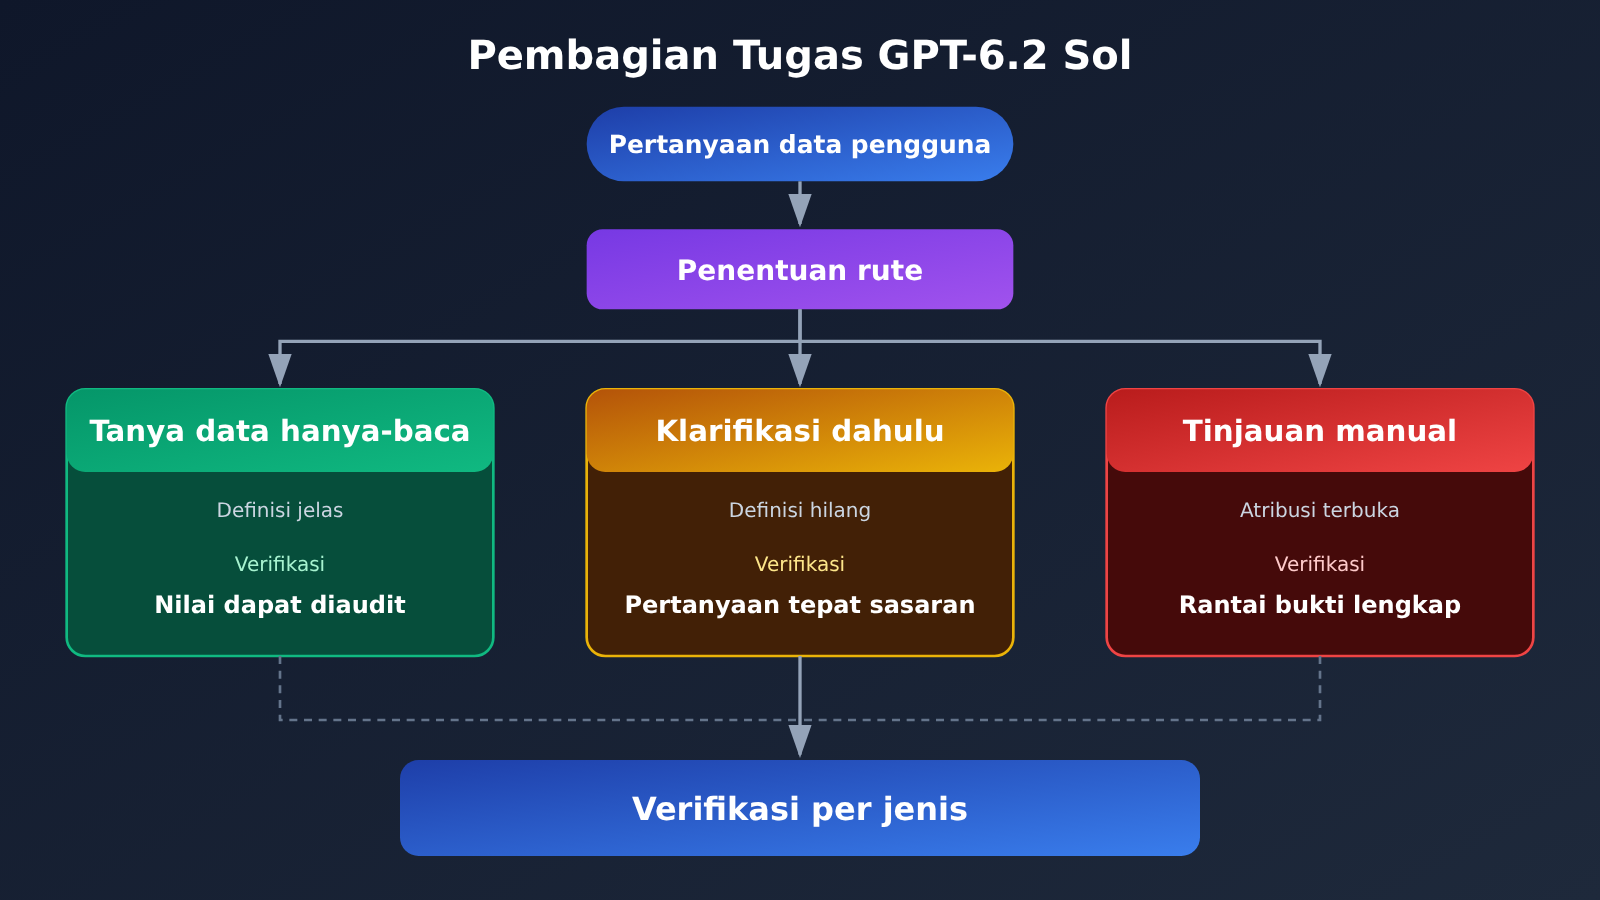
Urutan antar bagian adalah sebagai berikut. Bagian 3 yang bersifat paralel bisa dibaca sesuai kebutuhan, sedangkan bagian lainnya sebaiknya dibaca berurutan.
| No. Bagian | Pertanyaan yang dijawab | Apa yang diberikan untuk bagian berikutnya | Apa yang bisa dilakukan setelah membaca |
|---|---|---|---|
| 1 | Pada jenis soal apa Sol stabil | Batas jenis soal: 38/38 dan 2/5 | Menentukan cakupan yang bisa langsung ditanyai data |
| 2 | Apakah layak ditaruh di lini depan | Latensi, biaya per pertanyaan, dan asumsi ekstrapolasi | Menilai anggaran dan waktu tunggu untuk skenario interaktif |
| 3 | Petunjuk apa yang perlu diklarifikasi atau dialihkan ke manusia | Tiga pola kehilangan skor dan tiga contoh output | Merancang aturan routing |
| 4 | Bagaimana uji penerimaan dengan data sendiri | Metrik dan batasan per jenis soal | Menghasilkan satu deliverable yang dapat diperiksa ulang |
To Know: Istilah terkait analisis data GPT-6.2 Sol
| Istilah | Penjelasan singkat |
|---|---|
| Gudang data | Kumpulan data yang menghimpun data historis tersebar dari sistem bisnis, untuk keperluan kueri dan analisis |
| Definisi metrik | Definisi metrik, kondisi filter, pembilang dan penyebut, serta batas waktu |
| SQL hanya-baca | Cara kueri yang hanya melakukan pencarian dan agregasi, sumber data itu sendiri tetap memiliki izin hanya-baca |
| Soal pola tersembunyi | Di dalam data sudah ditanamkan anomali struktural; soal hanya memberi petunjuk, model harus aktif menemukan pola spesifiknya |
| Bukti kueri | Pernyataan kueri, definisi metrik, hasil, dan tanggal data yang memungkinkan orang lain memeriksa ulang kesimpulan |
| Latensi p50 / p95 | Separuh permintaan selesai dalam waktu berapa / 95% permintaan selesai dalam waktu berapa |
| Input cache | Token input yang diidentifikasi dapat digunakan ulang saat penagihan di sisi upstream, harga satuannya jauh lebih rendah daripada input biasa |
| Uji penerimaan berdasarkan jenis soal | Jenis soal seperti tanya data, klarifikasi, penolakan, dan eksplorasi dinilai terpisah, agar skor total tidak menutupi kesalahan pada jenis tertentu |
1. GPT-6.2 Sol untuk analisis data: mulai dari hasil tanya-jawab data yang bisa diterima secara stabil
1.1 Apa yang diuji Plotly
Dalam framework pengujian Plotly Studio Embedded, Plotly memanggil model melalui OpenRouter dan hanya membuka empat alat hanya-baca: menampilkan daftar dataset, menjalankan kueri SQL, membuat grafik, dan menampilkan tabel. Repositori pengujian menyimulasikan sebuah perusahaan tenaga angin, dengan sekitar 19,9 juta baris data, 44 tabel, dan 554 kolom. 43 soal berbahasa Inggris dinilai lulus atau tidak satu per satu berdasarkan kunci jawaban dan aturan penilaian. Model penilai adalah Claude Sonnet 5 dengan temperature=0; soal yang kehilangan poin ditinjau ulang secara manual oleh tim.
Pengaturan ini mendekati bentuk nyata tanya-jawab data BI perusahaan: model tidak bisa melihat seluruh data, hanya bisa mencari tabel sendiri, menulis SQL, membaca hasil, lalu menjawab. Bank soal dan kunci jawaban disimpan oleh Plotly, pihak luar tidak dapat mereproduksi per soal, jadi angka di bawah sebaiknya dipahami sebagai pengamatan satu putaran dengan penjelasan metode, bukan sebagai peringkat yang stabil.
| Jenis soal | Jumlah soal | Hasil GPT-6.2 Sol | Arti bagi bisnis |
|---|---|---|---|
| Analisis rutin | 20 | 20/20 | Ringkasan dengan definisi tetap bisa dicoba dijawab langsung |
| Penilaian ambiguitas | 5 | 5/5 | Mampu mengenali bahwa pertanyaan itu sendiri punya beberapa pemahaman |
| Data tidak bisa dijawab | 5 | 5/5 | Mampu menolak menjawab saat data tidak mendukung, tidak mengarang angka |
| Kualitas data | 3 | 3/3 | Mampu memperhatikan masalah seperti data hilang dan duplikat |
| Jebakan statistik | 5 | 5/5 | Mampu menghindari kesalahan baca statistik yang umum |
| Pola tersembunyi | 5 | 2/5 | Pencarian pola secara terbuka masih perlu verifikasi manual |
| Total | 43 | 40/43 | 38 soal pertama lulus semua, poin yang hilang semuanya terpusat di soal eksplorasi |
Plotly juga menyebutkan bahwa model lain mengalami fluktuasi hingga tiga soal saat dijalankan ulang. 40/43 hanya berbeda tiga soal dari nilai penuh, tepat berada dalam rentang fluktuasi itu. Karena itu yang lebih layak diperhatikan adalah distribusi poin yang hilang: semuanya jatuh pada soal pola tersembunyi, sementara lima kategori pertama tidak salah satu pun.
1.2 Mengapa tanya-jawab data dengan definisi tetap bisa diverifikasi
Ambil contoh laporan purnajual: «tingkat pengembalian barang per gudang dalam 7 hari terakhir» bisa diterima secara stabil asalkan tiga hal sudah ditetapkan lebih dulu: apakah penyebutnya pesanan yang sudah diterima atau semua pesanan, rentang waktu dipotong menurut zona waktu mana, dan apakah kondisi filter mengecualikan pesanan uji dan pesanan internal. Begitu ketiga hal ini ditulis dalam dokumen definisi, SQL dan hasil yang dihasilkan model bisa dicocokkan satu per satu dengan kueri manual.
Definisi tetap mengubah «apakah model pintar» menjadi «apakah angkanya konsisten», dan yang terakhir bisa dibandingkan secara otomatis. Inilah juga alasan 38 soal bisa lulus semua, dan kelulusan itu tetap bermakna: sebagian besar soal ini punya satu jawaban standar yang tunggal.
2. Latensi dan biaya analisis data GPT-6.2 Sol: perlukah ditaruh di frontend
2.1 Perbandingan satu putaran penuh antara dua generasi Sol
Ketika pengguna bertanya soal data di frontend, waktu tunggu langsung menentukan pengalaman. Laporan Plotly menyajikan perbandingan GPT-6.2 Sol dan GPT-6.1 Sol pada 43 soal dalam satu putaran yang sama:
| Metrik | GPT-6.1 Sol | GPT-6.2 Sol | Perubahan |
|---|---|---|---|
| Biaya satu putaran penuh | $2.61 | $1.22 | sekitar 53.3% lebih rendah |
| Median waktu per soal | 17.6 detik | 10.5 detik | sekitar 40.3% lebih rendah |
| Jumlah pemanggilan alat | 258 | 158 | berkurang jelas |
| Jumlah pemanggilan model | 227 | 173 | berkurang |
| Volume input | sekitar 7.8 juta token | sekitar 4.6 juta token | berkurang |
| Volume output | sekitar 70 ribu token | sekitar 45 ribu token | berkurang |
| Proporsi input cache | 94% | 97% | meningkat |
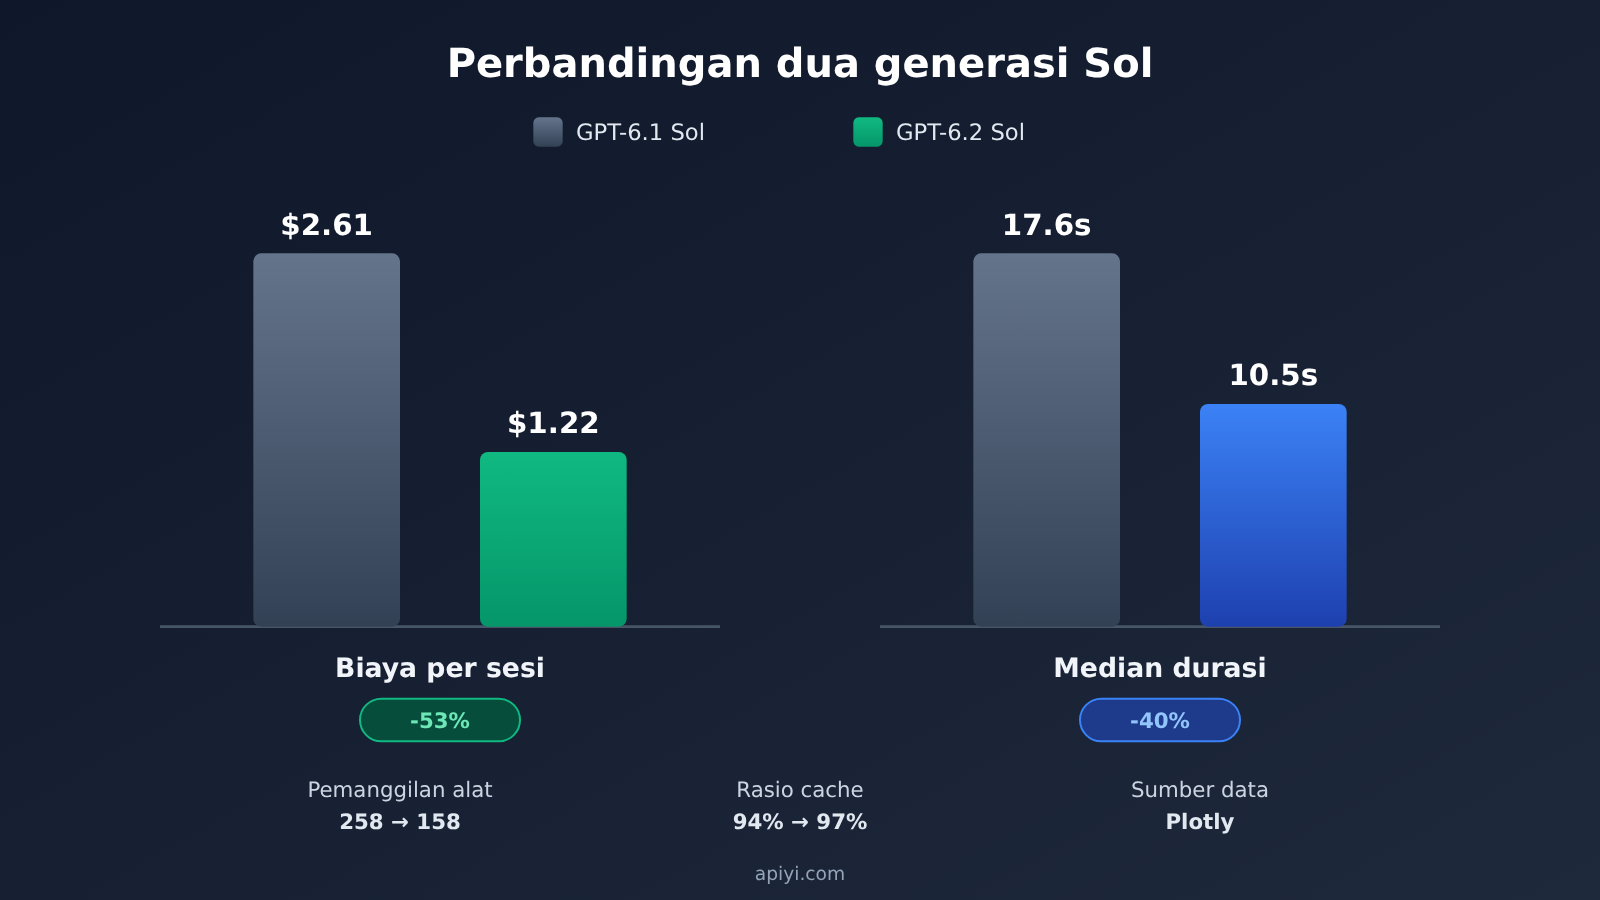
Harga dasar Standard konteks pendek kedua generasi Sol sama, tetapi biaya satu putaran penuh hampir separuh. Selisihnya berasal dari proses pengerjaan tugas: jumlah putaran pemanggilan lebih sedikit, token yang dibaca dan ditulis lebih sedikit, tingkat cache hit lebih tinggi. Jadi saat menilai biaya skenario analisis data, patokannya sebaiknya “berapa biaya untuk menyelesaikan satu soal”, dan harga per juta token hanyalah salah satu faktor di dalamnya.
2.2 Ekstrapolasi sekitar $28.4 per seribu soal dan asumsinya
Bagi $1.22 satu putaran penuh dengan 43 soal, rata-ratanya sekitar $0.0284/soal, diekstrapolasikan ke seribu soal menjadi sekitar $28.4. Angka ini hanya berlaku jika asumsi berikut terpenuhi sekaligus:
- Distribusi jenis soal sama dengan 43 soal Plotly, di mana soal eksplorasi sekitar 12%;
- Menggunakan kanal OpenRouter dan skema harga yang sama;
- Proporsi cache bertahan di sekitar 97%, antarsoal berbagi system prompt dan penjelasan struktur tabel yang sama;
- Setiap soal hanya dijalankan sekali, tanpa percobaan ulang.
Angka lain di papan peringkat Plotly adalah median biaya per soal $0.017, yang merupakan statistik berbeda dari nilai rata-rata. Soal eksplorasi memanggil lebih banyak alat dan memakan waktu lebih lama, sehingga menaikkan rata-rata, sedangkan median lebih mendekati biaya satu soal tanya-jawab data biasa. Saat menyusun anggaran, pakai median untuk memperkirakan tanya-jawab data sehari-hari, lalu tambahkan porsi terpisah sesuai proporsi soal eksplorasi.
Harga resmi OpenAI untuk Standard konteks pendek adalah: input biasa $2.00, pembacaan cache $0.10, output $10.00 (USD / juta token, output sudah termasuk token penalaran). Jika total input permintaan melewati 272K, seluruh pesanan dialihkan ke konteks panjang. Harga publik antarmuka APIYI apiyi.com untuk tier pendek sama dengan harga resmi, sedangkan tier panjang adalah input $3, pembacaan cache $0.15, penulisan cache $3.75, output $11.25. Permintaan tunggal pada skenario tanya-jawab data biasanya jauh di bawah 272K; peralihan tier hanya perlu diperhatikan saat menyuapkan banyak struktur tabel atau hasil historis sekaligus.
3. Tiga Jenis Sinyal dalam Analisis Data GPT-6.2 Sol: Kapan Berklarifikasi, Kapan Serahkan ke Manusia
3.1 Mengapa Soal Pola Tersembunyi Kehilangan Poin
Dari 38 soal tanpa pola tersembunyi, 6.2 Sol rata-rata memakai sekitar 2,9 pemanggilan alat per soal, sedangkan 6.1 Sol sekitar 4,3, dan keduanya lolos semua soal. Pada 5 soal berpola tersembunyi, laporan khusus Sol mencatat 6.2 Sol rata-rata sekitar 9 kueri basis data, sedangkan 6.1 Sol sekitar 16. (Pada contoh di artikel papan peringkat Plotly, generasi sebelumnya memakai acuan sekitar 18 kali; artikel ini berpedoman pada laporan khusus.)
Setelah pemeriksaan manual, tiga soal yang kehilangan poin adalah:
- tidak memisahkan pola yang disisipkan sebagai entitas tersendiri;
- tidak menunjukkan objek spesifik mana yang terdampak;
- tidak menemukan bagian data tempat efek itu benar-benar ada.
Ketiga jenis kehilangan poin ini punya satu kesamaan: kueri berhenti di permukaan. Ini bisa dicatat sebagai satu observasi: versi baru melakukan pencarian yang lebih dangkal pada soal eksplorasi. Soal hubungan sebab-akibat “jumlah kueri yang sedikit menyebabkan kehilangan poin” sendiri masih perlu eksperimen dengan variabel terkontrol untuk dipastikan. Bagi bisnis, kesimpulannya tetap sama: untuk soal atribusi apa pun yang menuntut pencarian bukti secara aktif, jawaban pertama model tidak boleh langsung dianggap kesimpulan.
3.2 Metrik Tidak Jelas: Tanya Dulu, Baru Jawab
Berikut demonstrasi tiga jenis output memakai dataset tiket purnajual fiktif. Dataset berisi empat tabel: pesanan, tiket, batch produk, dan gudang. Output di bawah ini adalah contoh rancangan, bukan hasil pengukuran sebenarnya.
Jawaban normal (metrik jelas). Saat pengguna bertanya “tampilkan tingkat pengembalian barang 7 hari terakhir per gudang”, output yang memenuhi syarat bukan hanya nilai tiap gudang, tetapi juga harus menyertakan: pembilang (jumlah tiket pengembalian barang fisik), penyebut (jumlah pesanan yang sudah diterima pada periode yang sama), rentang tanggal dan zona waktu (misalnya waktu Beijing 11-13 sampai 11-19), dimensi agregasi (gudang), plus SQL yang dieksekusi.
Tanya metrik dulu (metrik tidak jelas). Jika pengguna hanya bertanya “berapa tingkat pengembalian minggu lalu”, model sebaiknya bertanya balik lebih dulu: “Tingkat pengembalian dihitung berdasarkan pengajuan refund, atau berdasarkan barang yang benar-benar dikembalikan? Keduanya cukup berbeda pada kasus refund saja.” Lalu daftarkan kedua definisi metrik itu agar pengguna memilih; sebelum pengguna memilih, jangan keluarkan angka.
3.3 Atribusi Terbuka: Serahkan ke Analis
Saat pengguna bertanya “tingkat pengembalian suatu kanal berlipat dua, anomali terkonsentrasi di batch mana”, ini sudah masuk kategori soal pola tersembunyi. Model bisa lebih dulu melakukan penyelidikan awal: memastikan ada tidaknya data yang hilang, apakah ukuran sampel keseluruhan cukup, lalu memecah data berurutan berdasarkan kanal, kategori, gudang, dan batch. Output setidaknya harus menyimpan satu bukti pendukung, serta satu pemeriksaan untuk menyingkirkan penjelasan alternatif (misalnya memastikan volume pesanan kanal itu pada minggu tersebut tidak turun secara tidak wajar, sehingga menyingkirkan kemungkinan kenaikan dua kali lipat akibat penyebut yang mengecil).
Setelah semua itu dilakukan, output harus diberi label “menunggu tinjauan analis”, bukan “kesimpulan”. Aturan perutean bisa diringkas dalam satu tabel:
| Sinyal | Pertanyaan tipikal | Perutean | Output model | Fokus penerimaan |
|---|---|---|---|---|
| Metrik jelas, dampak rendah | Tingkat pengembalian 7 hari per gudang | Sol kueri data hanya-baca | Nilai + metrik + SQL | Nilai konsisten dengan kueri manual |
| Metrik atau data kurang | Berapa tingkat pengembalian minggu lalu | Klarifikasi dulu | Satu pertanyaan balik + kandidat metrik | Pertanyaan balik tepat sasaran pada celah |
| Atribusi terbuka, keputusan eksternal | Anomali terkonsentrasi di batch mana | Serahkan ke analis untuk tinjauan | Catatan penyelidikan + bukti pendukung + pemeriksaan penjelasan alternatif | Cakupan bukti, positif palsu dan negatif palsu |
4. Menguji kemampuan analisis data GPT-6.2 Sol dengan data Anda sendiri
4.1 Kode integrasi dan routing
gpt-6.2-sol dapat dipanggil melalui dua endpoint, yaitu Responses dan Chat Completions; pemanggilan fungsi dan tool bawaan menggunakan jalur Responses. Kedua endpoint tidak menerima tingkat penalaran none, jadi saat memigrasikan kode lama, periksa parameter ini. Berikut contoh minimal untuk klasifikasi routing dengan Chat Completions:
import openai, json

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Antarmuka kompatibel OpenAI APIYI
)

question = "上周退货率多少"
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[
        {"role": "system", "content": "把用户的数据问题分类为 direct / clarify / escalate,"
                                      "只返回 JSON:{\"route\":..., \"reason\":...}"},
        {"role": "user", "content": question},
    ],
)
print(json.loads(resp.choices[0].message.content))
Lihat contoh lengkap pemanggilan tool SQL hanya-baca (Responses API)
import openai, json, sqlite3

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Buka database dalam mode hanya-baca di level database; pemeriksaan regex hanyalah pengaman lapis kedua
conn = sqlite3.connect("file:aftersales.db?mode=ro", uri=True)

def run_readonly_sql(sql: str) -> str:
    head = sql.strip().lower()
    if not (head.startswith("select") or head.startswith("with")):
        return json.dumps({"error": "only read-only queries allowed"})
    rows = conn.execute(sql).fetchmany(200)
    return json.dumps({"rows": rows, "row_count": len(rows)}, default=str)

tools = [{
    "type": "function",
    "name": "run_readonly_sql",
    "description": "在售后数据仓库执行只读 SQL,返回最多 200 行",
    "parameters": {
        "type": "object",
        "properties": {"sql": {"type": "string"}},
        "required": ["sql"],
    },
}]

instructions = (
    "你是数据分析助手。回答必须包含:分子、分母、时间范围与时区、聚合维度、所执行的 SQL。"
    "口径不明确时先提问;涉及归因的结论标注为待分析师复核。"
)

resp = client.responses.create(
    model="gpt-6.2-sol",
    instructions=instructions,
    input="按仓库列过去 7 天的退货率",
    tools=tools,
)

# Proses pemanggilan tool dalam loop hingga model memberikan jawaban akhir
while True:
    calls = [o for o in resp.output if o.type == "function_call"]
    if not calls:
        break
    outputs = [{
        "type": "function_call_output",
        "call_id": c.call_id,
        "output": run_readonly_sql(json.loads(c.arguments)["sql"]),
    } for c in calls]
    resp = client.responses.create(
        model="gpt-6.2-sol",
        previous_response_id=resp.id,
        input=outputs,
        tools=tools,
    )

print(resp.output_text)
print("output_tokens:", resp.usage.output_tokens)
🚀 Mulai cepat: Saat memvalidasi dengan sampel bisnis Anda sendiri, Anda dapat mengajukan kuota uji gratis untuk pengguna baru melalui APIYI apiyi.com. Kunci API yang sama dapat digunakan untuk beralih antara
gpt-6.2-soldan model-model populer lainnya, membandingkan secara berdampingan pada set pertanyaan yang sama, selama sumber data tetap hanya-baca.
4.2 Metrik penerimaan berdasarkan jenis pertanyaan
Bank soal penerimaan sebaiknya mencakup tiga jenis routing pada bagian 3, dengan penilaian terpisah untuk setiap jenis pertanyaan.
| Jenis pertanyaan | Metrik utama | Cara penilaian | Yang disarankan dicatat |
|---|---|---|---|
| Pertanyaan kuantitatif dengan definisi baku | Tingkat akurasi nilai | Bandingkan baris per baris dengan hasil SQL manual | Biaya per pertanyaan, latensi p50/p95 |
| Definisi yang hilang | Tingkat klarifikasi yang tepat | Apakah pertanyaan lanjutan mengenai sasaran definisi yang benar-benar hilang | Apakah muncul “bertanya padahal tidak seharusnya bertanya” |
| Data yang tidak dapat dijawab | Tingkat penolakan yang benar | Tidak mengarang angka | Jumlah jawaban keliru |
| Atribusi terbuka | Cakupan bukti, false positive dan false negative | Apakah bukti pendukung + pemeriksaan penjelasan alternatif sudah lengkap | Konsistensi saat dijalankan berulang kali |
Laporan Plotly hanya memberikan median durasi; penerimaan Anda sendiri harus melengkapi p95. Pengalaman di front-end sering kali tertarik oleh sedikit permintaan ekor panjang, dan pertanyaan eksploratif terutama rentan terhadap ekor panjang. Dari sisi biaya, baca jumlah output dari usage.output_tokens, token penalaran biasanya tercantum dalam subitem output_tokens_details.reasoning_tokens, lalu gabungkan dengan jumlah pembacaan cache untuk menghitung biaya aktual per pertanyaan.
4.3 Batasan sampel kecil dan pengulangan
Pola tersembunyi Plotly hanya terdiri dari 5 pertanyaan, interval kepercayaan 2/5 sangat lebar; dengan kumpulan pertanyaan lain bisa jadi 1/5, bisa juga 4/5. Saat model lain dijalankan ulang, pernah muncul fluktuasi hingga tiga pertanyaan, jadi perbedaan skor total satu putaran tidak cukup untuk mendukung pemilihan model. Saat melakukan penerimaan sendiri, jalankan pertanyaan eksploratif setidaknya beberapa putaran, dan selaraskan lima variabel: snapshot data, set alat, tingkat penalaran model, saluran pemanggilan, tabel penilaian. Jika salah satu berubah, hasil sebelum dan sesudahnya tidak dapat dibandingkan secara langsung.
💡 Saran penerimaan: Saluran adalah variabel yang mudah terlewat. Biaya Plotly berasal dari OpenRouter, sedangkan penagihan saluran produksi dan strategi cache Anda bisa berbeda. Disarankan untuk menjalankan ulang di APIYI apiyi.com dengan snapshot data yang sama, menghitung ulang biaya per seribu pertanyaan berdasarkan tagihan aktual, lalu menentukan kuota front-end.
4.4 Satu Deliverable yang Dapat Diterima
Kriteria kelulusan: setiap hasil pertanyaan data harus bisa diverifikasi ulang secara independen oleh orang ketiga. Berikut bentuk satu deliverable yang memenuhi syarat (data fiktif):
question: Rasio pengembalian per gudang selama 7 hari terakhir
route: direct
data_snapshot: 2026-11-19 23:59 (Asia/Shanghai)
metric_definition:
  numerator: Jumlah tiket pengembalian barang fisik (status = returned)
  denominator: Jumlah pesanan yang sudah diterima pada periode yang sama (tidak termasuk pesanan uji dan pesanan internal)
  time_range: 2026-11-13 ~ 2026-11-19, waktu Beijing
  group_by: warehouse_id
query: "SELECT w.warehouse_id, ... GROUP BY w.warehouse_id"
result: [{warehouse: Gudang Tiongkok Timur 1, rate: 3.1%}, {warehouse: Gudang Tiongkok Selatan 2, rate: 2.4%}]
model: gpt-6.2-sol
cost_usd: 0.012
latency_s: 8.7
reviewer: Tidak perlu peninjauan (pertanyaan data dengan definisi tetap)
Satu deliverable memuat tanggal data, definisi metrik, kueri, dan hasil. GPT-6.2 Sol sudah bisa lolos verifikasi pada tahap pertanyaan data di garda depan ini. Output yang tidak punya butir-butir tersebut, meskipun angkanya kebetulan benar, tidak boleh masuk ke laporan. Kalau ingin menjalankan alur ini di gudang Anda sendiri, Anda bisa mulai dari antarmuka yang kompatibel dengan OpenAI di APIYI apiyi.com — luncurkan dulu pertanyaan data dengan definisi tetap, lalu perluas bertahap ke klarifikasi dan atribusi.
Referensi
- Plotly – Laporan Khusus Analisis Data GPT-6.2 Sol: hasil per butir untuk 43 soal, perbandingan biaya dan waktu
- Tautan:
plotly.com/blog/gpt-6-2-sol-plotly-data-analytics-bench
- Tautan:
- Plotly – Metode Pengujian DataAnalyticsBench: desain tipe soal, aturan penilaian, dan kriteria statistik peringkat
- Tautan:
plotly.com/blog/introducing-dataanalyticsbench
- Tautan:
- OpenAI – Kartu Model GPT-6.2 Sol: jendela konteks, dukungan endpoint, dan aturan penagihan konteks panjang
- Tautan:
developers.openai.com/api/docs/models/gpt-6.2-sol
- Tautan:
- OpenAI – Harga API: harga satuan input, cache, dan output Standard
- Tautan:
developers.openai.com/api/docs/pricing
- Tautan:
- Antarmuka Harga Publik APIYI: ekspresi harga tier pendek dan tier panjang untuk
gpt-6.2-sol- Tautan:
api.apiyi.com/api/pricing
- Tautan:
Penulis: Tim Teknis APIYI
Komunikasi teknis: Silakan hubungi kami di beranda situs resmi APIYI. Materi integrasi selengkapnya dapat diakses di pusat dokumentasi docs.apiyi.com


