
Catatan penulis: Dua contoh perhitungan manual untuk menjelaskan dengan jelas cara penetapan harga konteks pendek dan konteks panjang GPT-6.2 Astra, serta pengali Batch, Fast, dan Ultrafast.
OpenAI merilis GPT-6.2 Astra dan GPT-6.2 Sol pada 17 November 2026, dengan ID model masing-masing gpt-6.2-astra dan gpt-6.2-sol. Harga standar konteks pendek yang tercantum di halaman model resmi memang terlihat lugas, tetapi saat benar-benar memperkirakan tagihan, harga standar konteks pendek tidak bisa langsung dikalikan ke konteks panjang, Fast, maupun Ultrafast. Begitu input satu permintaan melebihi 272K token, harga satuan untuk keseluruhan permintaan tersebut ikut berubah; dan jika memilih Fast atau Ultrafast, harus dikalikan lagi dengan faktor pengali pada tingkat konteks yang sesuai.
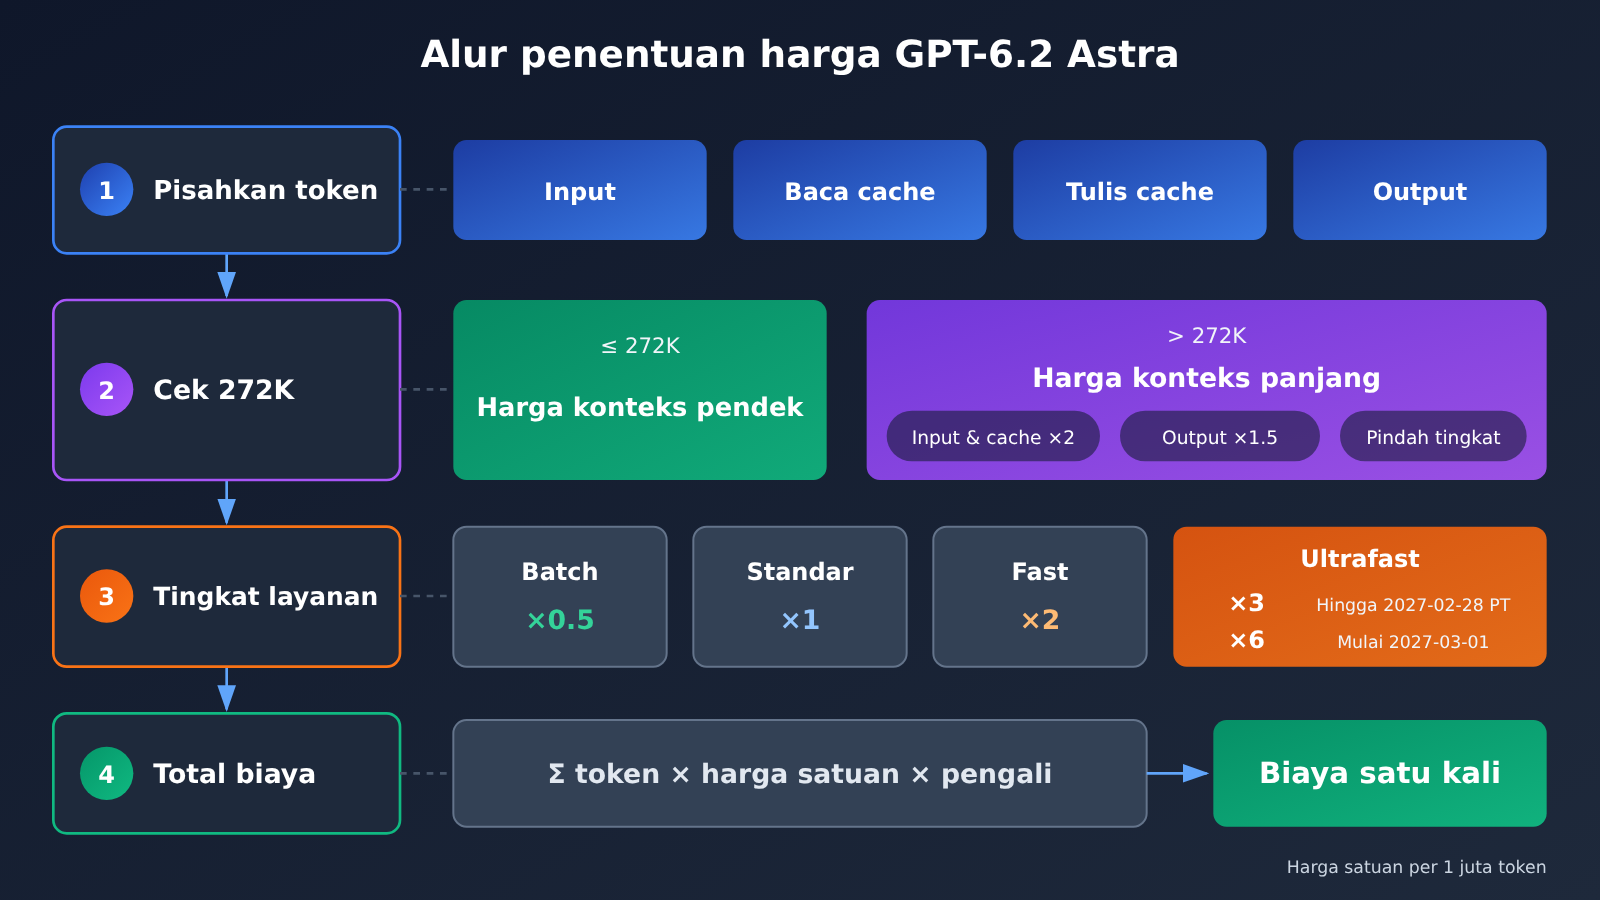
Ini bukan sekadar mengulang isi daftar harga, melainkan sekumpulan aturan yang bisa kamu hitung sendiri dengan kertas dan pena: pertama, pisahkan token ke dalam empat kategori — input, baca cache, tulis cache, dan output; kemudian tentukan apakah permintaan tersebut termasuk konteks pendek atau konteks panjang; terakhir, terapkan pengali tingkat layanan.
Nilai utamanya: Setelah membaca artikel ini, kamu bisa memperkirakan sendiri biaya satu permintaan dan tugas batch GPT-6.2 Astra, sekaligus memahami angka mana yang merupakan harga resmi dan mana yang merupakan tolok ukur evaluasi pihak ketiga, sehingga tidak mencampuradukkan keduanya.
Poin Inti Perhitungan Harga GPT-6.2 Astra
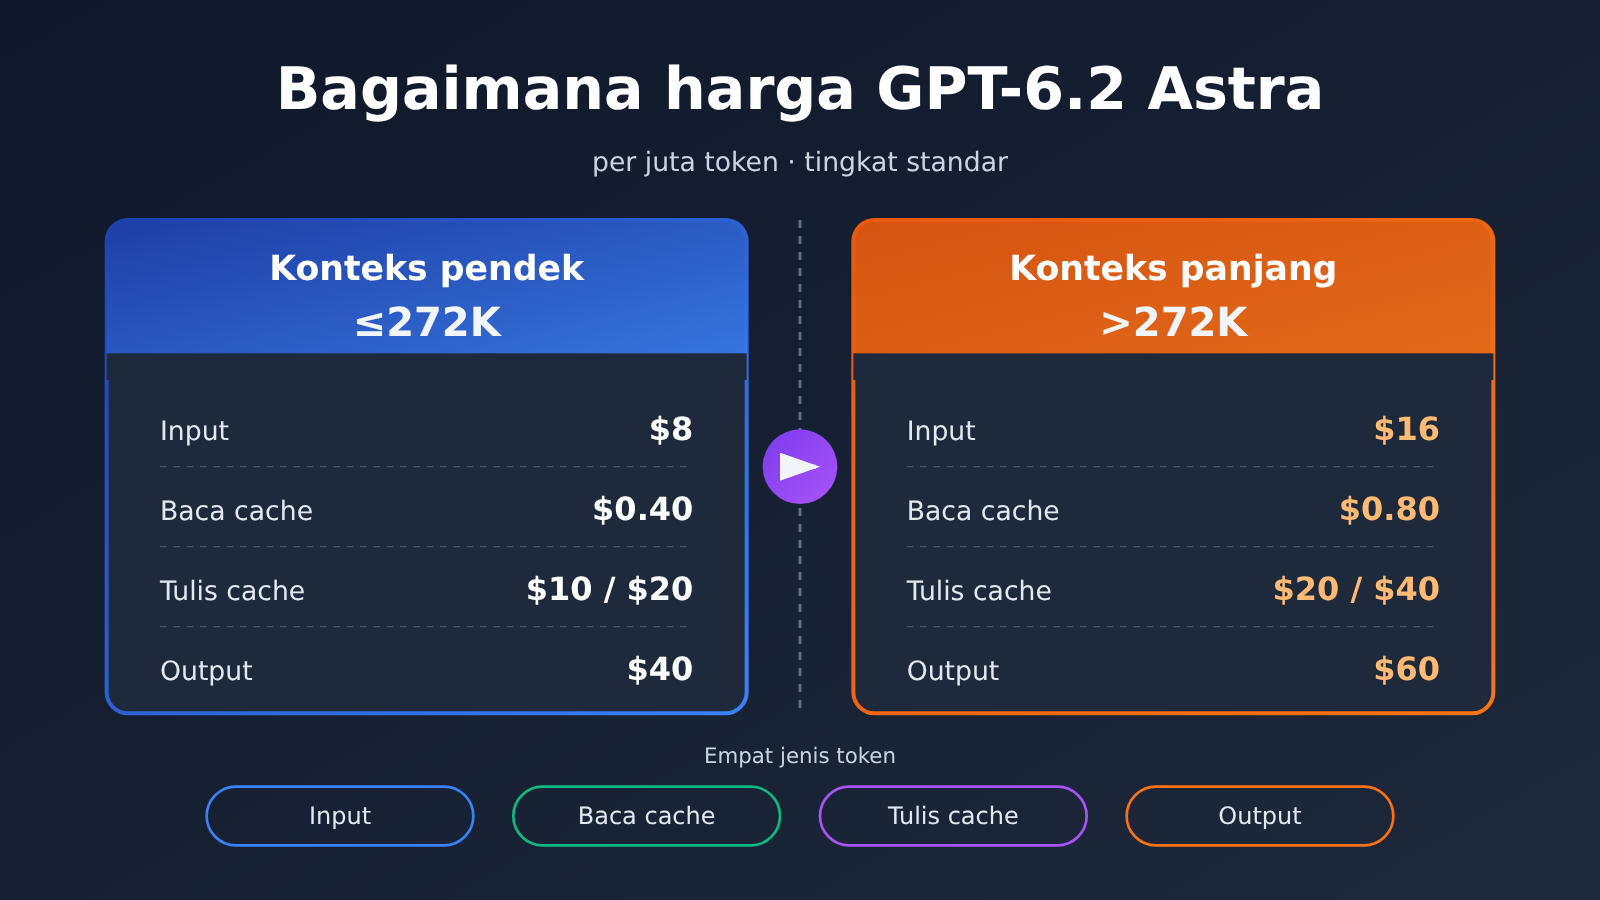
Mari kita luruskan aturannya dulu. Tabel berikut dirangkum dari halaman model resmi OpenAI (harga daftar yang dilaporkan resmi oleh OpenAI sendiri), satuannya semuanya per 1 juta token, untuk tingkat standar.
| Komponen Biaya | Konteks Pendek (input ≤272K) | Konteks Panjang (input >272K, seluruh permintaan) | Keterangan |
|---|---|---|---|
| Input | $8 | $16 | Input konteks panjang digandakan |
| Baca Cache | $0.40 | $0.80 | Harga satuan cache juga digandakan |
| Tulis Cache (retensi 30 menit) | $10 | $20 | Termasuk kategori cache, digandakan |
| Tulis Cache (retensi 12 jam) | $20 | $40 | Termasuk kategori cache, digandakan |
| Output | $40 | $60 | Output 1.5 kali lipat dari harga konteks pendek |
Kolom konteks panjang disimpulkan dari kalimat asli di halaman model: ketika input permintaan melebihi 272K token, harga satuan input dan cache digandakan, output menjadi 1.5 kali lipat harga konteks pendek, dan dihitung untuk seluruh permintaan. Artinya, yang digandakan bukan hanya “bagian yang melebihi 272K”, melainkan semua token dalam permintaan tersebut berganti memakai harga satuan di kolom kanan.
gpt-6.2-astra dan gpt-6.2-sol saat ini belum ada di tabel model lengkap APIYI (waktu data 2026-11-17 15:54, UTC+8) maupun di endpoint harga publik: belum tersedia, kami akan segera menambahkan model ini; jenis model dan harga mengacu pada daftar model di platform. Sebelum integrasi resmi, Anda bisa cek dulu status ketersediaan dan harga sebenarnya di daftar model apiyi.com, baru menerapkan rumus perhitungan dari artikel ini.
Mengapa Empat Jenis Token GPT-6.2 Astra Dihitung Terpisah
Tagihan untuk satu permintaan biasanya terdiri dari empat komponen. Input biasa adalah bagian petunjuk yang kali ini tidak mengenai cache sekaligus tidak ditulis ke cache; baca cache adalah bagian yang mengenai cache yang sudah ada, harga satuannya hanya seperdua puluh dari harga input; tulis cache adalah bagian petunjuk yang kali ini ditulis ke dalam cache, dibedakan menjadi dua tingkat berdasarkan durasi retensi: 30 menit dan 12 jam; sedangkan output adalah konten yang dihasilkan model. GPT-6.2 Astra mendukung token reasoning; token yang dihasilkan selama proses reasoning umumnya dihitung ke sisi output, detail pastinya mengacu pada rincian usage di tagihan.
Harga satuan keempat jenis ini selisihnya sangat besar: baca cache $0.40, input $8, tulis cache $10 atau $20, output $40. Kalau semua token dihitung dengan harga input, estimasi biaya tugas yang padat output akan terlalu rendah; kalau tulis cache diabaikan, biaya pemanggilan pertama akan kurang terhitung. Jadi, saat mengestimasi biaya, Anda wajib memisahkan dulu keempat jenis token, baru mengalikannya satu per satu.
Cara Menentukan Ambang Batas 272K pada GPT-6.2 Astra
Acuan penentuannya adalah total token input dari permintaan tersebut, dan bagian yang mengenai cache juga termasuk input; sebaiknya merujuk pada penjelasan resmi dan usage aktual. Jendela konteks model ini 1,050,000, input maksimum 922,000, output maksimum 128,000, jadi permintaan konteks panjang tetap bisa dikirim, hanya saja pembayarannya memakai harga satuan yang berbeda.
Satu cara praktis untuk menilainya: jumlahkan semua petunjuk sistem, riwayat percakapan, dokumen hasil retrieval, dan hasil yang dikembalikan tool. Kalau totalnya mendekati 272K, Anda perlu memutuskan lebih awal — mau mengompres konteks, memecahnya menjadi beberapa permintaan, atau menerima bahwa seluruh permintaan pindah tingkat tarif.
Cara Menerapkan Pengali Tingkat Layanan GPT-6.2 Astra
Tingkat konteks menentukan harga satuan dasar, sedangkan tingkat layanan menentukan berapa kali lipat harga dasar itu dikalikan. Tabel berikut juga berasal dari halaman model resmi.
| Tingkat Layanan | Pengali | Cakupan Berlaku | Catatan |
|---|---|---|---|
| Batch | 50% dari harga standar | Pemrosesan batch asinkron | Cocok untuk tugas bervolume besar yang tidak mendesak |
| Standar | 1x | Bawaan | Menjadi dasar dari dua contoh di artikel ini |
| Fast | 2x | Harga standar dengan panjang konteks yang sama | Permintaan konteks panjang harus memakai harga satuan konteks panjang lalu dikali 2 |
| Ultrafast | 3x | Hingga 2027-02-28 (waktu Pasifik) | Ada tenggat waktu |
| Ultrafast | 6x | Mulai 2027-03-01 | Anggaran harus dihitung ulang dengan pengali baru |
Cakupan Fast sudah dijelaskan gamblang di halaman model, yaitu 2 kali lipat dari “harga standar dengan panjang konteks yang sama”, jadi kalau permintaan konteks panjang memakai Fast, biaya inputnya $16 × 2 = $32 dan outputnya $60 × 2 = $120. Pengali Ultrafast diterapkan dengan logika yang sama, tapi khusus soal waktu perlu perhatian ekstra: kalau anggaran proyekmu mencakup periode setelah Maret 2027, bagian Ultrafast harus diestimasi ulang dengan pengali 6x, jangan asal pakai angka 3x yang lama.
Satu batasan lagi yang berkaitan tidak langsung dengan biaya: API tidak mengizinkan reasoning effort disetel ke none. Artinya token penalaran selalu ada, jadi saat mengestimasi volume output, sisakan ruang ekstra untuk penalaran — jangan hanya menghitung berdasarkan panjang jawaban akhirnya saja.
GPT-6.2 Astra Panduan Cepat: Dua Contoh Perhitungan Manual
Dua contoh di bawah ini hanya menggunakan perkalian dan penjumlahan, dengan harga satuan dihitung “per 1 juta token”, jadi rumus setiap barisnya adalah “jumlah token × harga satuan ÷ 1,000,000”.
Contoh 1: Permintaan Konteks Pendek GPT-6.2 Astra
Skenarionya adalah asisten tanya jawab dengan petunjuk sistem yang panjang. Setiap permintaan memiliki total input 100,000 token, terdiri dari 60,000 token petunjuk sistem dan cuplikan pengetahuan yang tetap (cocok untuk dimasukkan ke cache), 40,000 token konten pengguna yang berubah setiap permintaan, serta output (termasuk reasoning) sekitar 5,000 token. Total input 100K, di bawah 272K, sehingga menggunakan harga satuan konteks pendek.
| Item Penagihan | Permintaan Pertama (menulis cache 30 menit) | Permintaan Berikutnya (cache hit) |
|---|---|---|
| Input normal 40,000 × $8 | $0.32 | $0.32 |
| Penulisan cache 60,000 × $10 | $0.60 | — |
| Pembacaan cache 60,000 × $0.40 | — | $0.024 |
| Output 5,000 × $40 | $0.20 | $0.20 |
| Total per permintaan | $1.12 | $0.544 |
Terlihat bahwa setelah cache hit, biaya per permintaan hampir turun setengahnya, sementara penulisan cache pada permintaan pertama justru lebih mahal daripada tidak menggunakan cache sama sekali (tanpa cache: 100,000 × $8 = $0.80, ditambah output menjadi $1.00). Jika beralih ke penulisan cache 12 jam, baris penulisan berubah menjadi 60,000 × $20 = $1.20, dan hanya menguntungkan jika cache akan diakses berulang kali dalam periode 12 jam.
Dengan estimasi $0.544 per permintaan setelah cache hit, 1,000 permintaan sekitar $544. Selanjutnya terapkan pengali tingkatan: Batch sekitar $272, Fast sekitar $1,088, Ultrafast sekitar $1,632 sebelum 2027-02-28, dan sekitar $3,264 mulai 2027-03-01. Untuk mekanisme pemotongan biaya yang spesifik saat Batch dikombinasikan dengan cache, sebaiknya merujuk pada penjelasan tagihan resmi; angka di sini hanya perkiraan kasar berdasarkan pengali tingkatan.
Contoh Kedua: Permintaan Konteks Panjang GPT-6.2 Astra Melebihi 272K
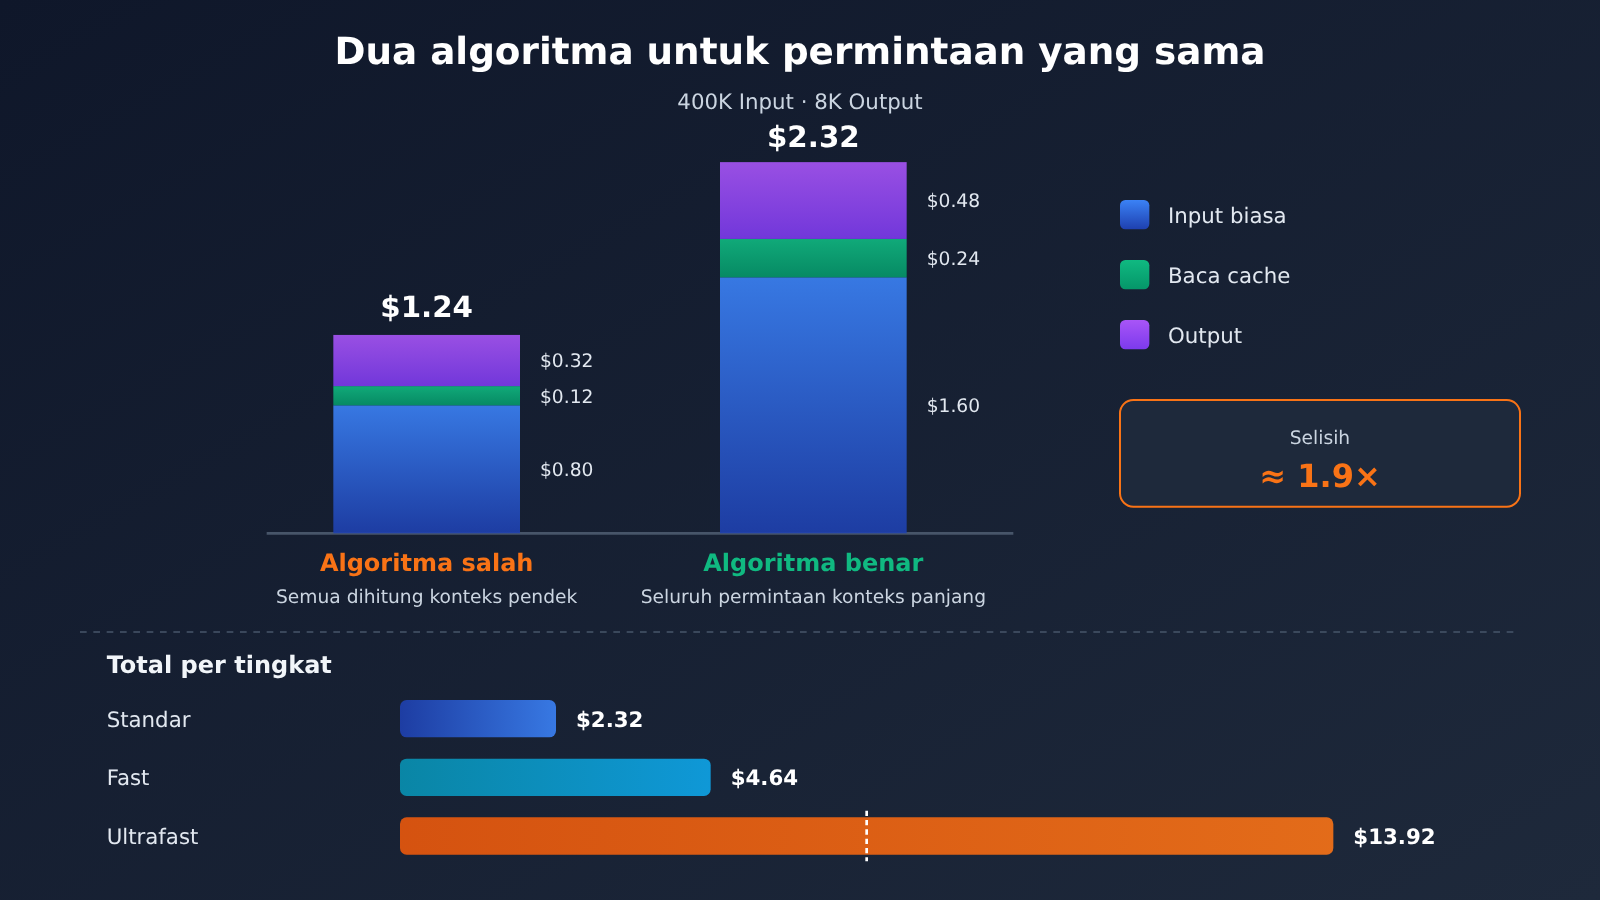
Skenarionya adalah memasukkan satu repositori kode utuh atau sekumpulan kontrak ke dalam konteks untuk dianalisis. Total input sekali permintaan 400,000 token, di mana 300,000 mengenai cache, 100,000 merupakan input biasa, dan output sekitar 8,000 token. Karena total input melebihi 272K, seluruh permintaan dihitung dengan harga satuan konteks panjang.
| Komponen Biaya | Perhitungan Benar (Seluruh Permintaan Konteks Panjang) | Perhitungan Salah (Semua Dihitung Konteks Pendek) |
|---|---|---|
| Input biasa 100,000 | × $16 = $1.60 | × $8 = $0.80 |
| Pembacaan cache 300,000 | × $0.80 = $0.24 | × $0.40 = $0.12 |
| Output 8,000 | × $60 = $0.48 | × $40 = $0.32 |
| Total per permintaan | $2.32 | $1.24 |
Kedua metode perhitungan ini menghasilkan selisih hampir dua kali lipat. Kesalahan umum lainnya adalah “hanya menggandakan 128K yang melebihi 272K” — cara ini juga tidak sesuai dengan keterangan di halaman model yang menuliskan “dihitung berdasarkan seluruh permintaan”. Hanya ada satu cara yang benar: begitu melewati ambang batas, input, pembacaan cache, dan penulisan cache untuk permintaan tersebut semuanya dihitung dua kali lipat, sedangkan output dihitung 1.5 kali lipat.
Di atas dasar perhitungan itu, baru kita terapkan tier-nya: Fast menjadi $2.32 × 2 = $4.64; Ultrafast hingga 2027-02-28 sebesar $6.96, dan mulai 2027-03-01 menjadi $13.92; Batch sekitar $1.16. Jika tugas ini dijalankan 200 kali sehari, tier standar sekitar $464 per hari, sedangkan dengan Ultrafast (setelah Maret 2027) sekitar $2,784 per hari — selisih sebesar ini cukup untuk mengubah keputusan solusi teknis.
🎯 Saran Perhitungan Harga: Ganti angka token pada kedua contoh di atas dengan nilai aktual milikmu sendiri, dan kamu langsung mendapatkan anggaran versi pertama. Semua angka pada grafik diestimasi berdasarkan harga resmi yang tertera di halaman model OpenAI; setelah GPT-6.2 Astra tersedia di APIYI, harga satuan aktual mengacu pada daftar model di apiyi.com.
Langkah Persiapan Pemanggilan di APIYI
gpt-6.2-astra saat ini belum tersedia di platform, dan kami akan segera merilisnya; jenis model dan harga mengacu pada daftar model di platform. Setelah tersedia, cara integrasinya sama seperti model kompatibel OpenAI lainnya, jadi kamu bisa menyiapkannya dengan langkah-langkah berikut:
- Buat kunci API di konsol APIYI, lalu gunakan kredit uji coba gratis untuk pengguna baru guna menjalankan sampel kecil terlebih dahulu.
- Di sisi klien, atur base_url menjadi
https://api.apiyi.com/v1, dan isi ID model dengangpt-6.2-astra. - Halaman model resmi menunjukkan bahwa model ini mendukung endpoint Chat Completions dan Responses, serta Batch; tidak mendukung Realtime, Assistants, fine-tuning, pembuatan gambar, video, dan suara — alur kerja yang membutuhkan kemampuan tersebut perlu memilih model lain.
- Jangan atur tingkat reasoning menjadi
none, karena API akan menolaknya; mulailah pengujian dari tingkat yang lebih rendah dan amati perubahan token output. - Setelah setiap pemanggilan, baca usage pada respons, catat input, cache hit, dan output secara terpisah, lalu masukkan angkanya ke tabel di artikel ini untuk memverifikasi biayanya.
🚀 Mulai Cepat: Sebelum model ini tersedia, kamu bisa menggunakan model sebelumnya yang sudah tersedia,
gpt-6-astra, untuk menguji alur endpoint dan logika statistik usage terlebih dahulu. Begitu 6.2 dirilis, kamu cukup mengganti ID modelnya saja.
Perbandingan Harga Tercantum GPT-6.2 Astra dan Model Terkait
Tabel berikut menyatukan harga tercantum resmi dengan harga di daftar harga utama APIYI untuk model yang sudah tersedia, agar mudah dibandingkan. Perhatikan bahwa kedua sumber ini berbeda: harga resmi adalah penetapan harga dari vendor, sedangkan harga platform adalah harga tercantum di daftar harga utama APIYI (2026-11-17 15:54, UTC+8).
| Model | Input / Output / Baca Cache (per 1 juta token) | Sumber Harga | Platform yang Tersedia |
|---|---|---|---|
| gpt-6.2-astra | $8 / $40 / $0.40 | Harga tercantum resmi OpenAI | Belum tersedia di APIYI, mengacu ke daftar model platform |
| gpt-6.2-sol | $2 / $10 / $0.10 | Harga tercantum resmi OpenAI | Belum tersedia di APIYI, mengacu ke daftar model platform |
| gpt-6-astra (versi sebelumnya) | $10 / $50 / $1; input di atas 272,000: $20 | Daftar harga utama APIYI | Sudah tersedia di APIYI (apiyi.com) |
| gpt-6.1-sol | $2 / $10 / $0.1; input di atas 272,000: $4 | Daftar harga utama APIYI | Sudah tersedia di APIYI |
| gemini-4-carbon | $2 / $10 / $0.1 (harga perkenalan) | Daftar harga utama APIYI | Sudah tersedia di APIYI |
Tentang GPT-6.2 Sol: harga standar resmi untuk konteks pendek adalah input $2, baca cache $0.10, tulis cache 30 menit $2.50, tulis cache 12 jam $5, dan output $10. Aturan 272K untuk seluruh permintaan serta pengali tiap tingkatnya sama seperti Astra. Model ini belum tersedia, tapi kami akan segera menghadirkannya di platform; nama model dan harga mengikuti daftar model di platform.
Saat membandingkan dengan gpt-6-astra, ingat bahwa itu adalah versi sebelumnya: di daftar harga utama APIYI harganya input $10, output $50, baca cache $1. Menurut pengumuman resmi, harga input dan output GPT-6.2 Astra 20% lebih rendah dari GPT-6 Astra, dan harga input cache 60% lebih rendah — angka-angka ini cocok dengan kombinasi $8 / $40 / $0.40. Jangan menganggap harga platform gpt-6-astra atau gpt-6.1-sol sebagai harga untuk versi 6.2.
Gemini 4 Carbon juga punya satu catatan waktu: di tingkat standar resmi Google, sampai 2026-11-30 harganya input $2 dan output $10, lalu mulai 2026-12-01 berubah menjadi input $4 dan output $20. Halaman penjelasan APIYI saat ini masih mencantumkan harga perkenalan, jadi untuk harga aktual setelah 1 Desember silakan merujuk ke daftar model di platform. Selain itu, daftar harga Google tidak memiliki baris “di atas 272K, seluruh permintaan digandakan”, jadi saat membandingkan antar vendor, jangan menerapkan aturan konteks panjang milik GPT-6.2 ke model Google.
💡 Saran pemilihan: Konsumsi token untuk beban kerja yang sama bisa berbeda di setiap model — harga satuan murah belum tentu berarti tagihan murah. Disarankan untuk melakukan pemanggilan model di APIYI terhadap beberapa model yang sudah tersedia menggunakan set sampel yang sama, hitung total biaya berdasarkan usage aktual, baru mengambil keputusan.
Cara Membaca Data Resmi dan Data Pihak Ketiga GPT-6.2 Astra
Untuk menghitung tagihan, sebenarnya cukup menggunakan harga resmi, tetapi banyak orang terbiasa mengutip angka “biaya per tugas” — di sinilah sumber datanya perlu dibedakan.
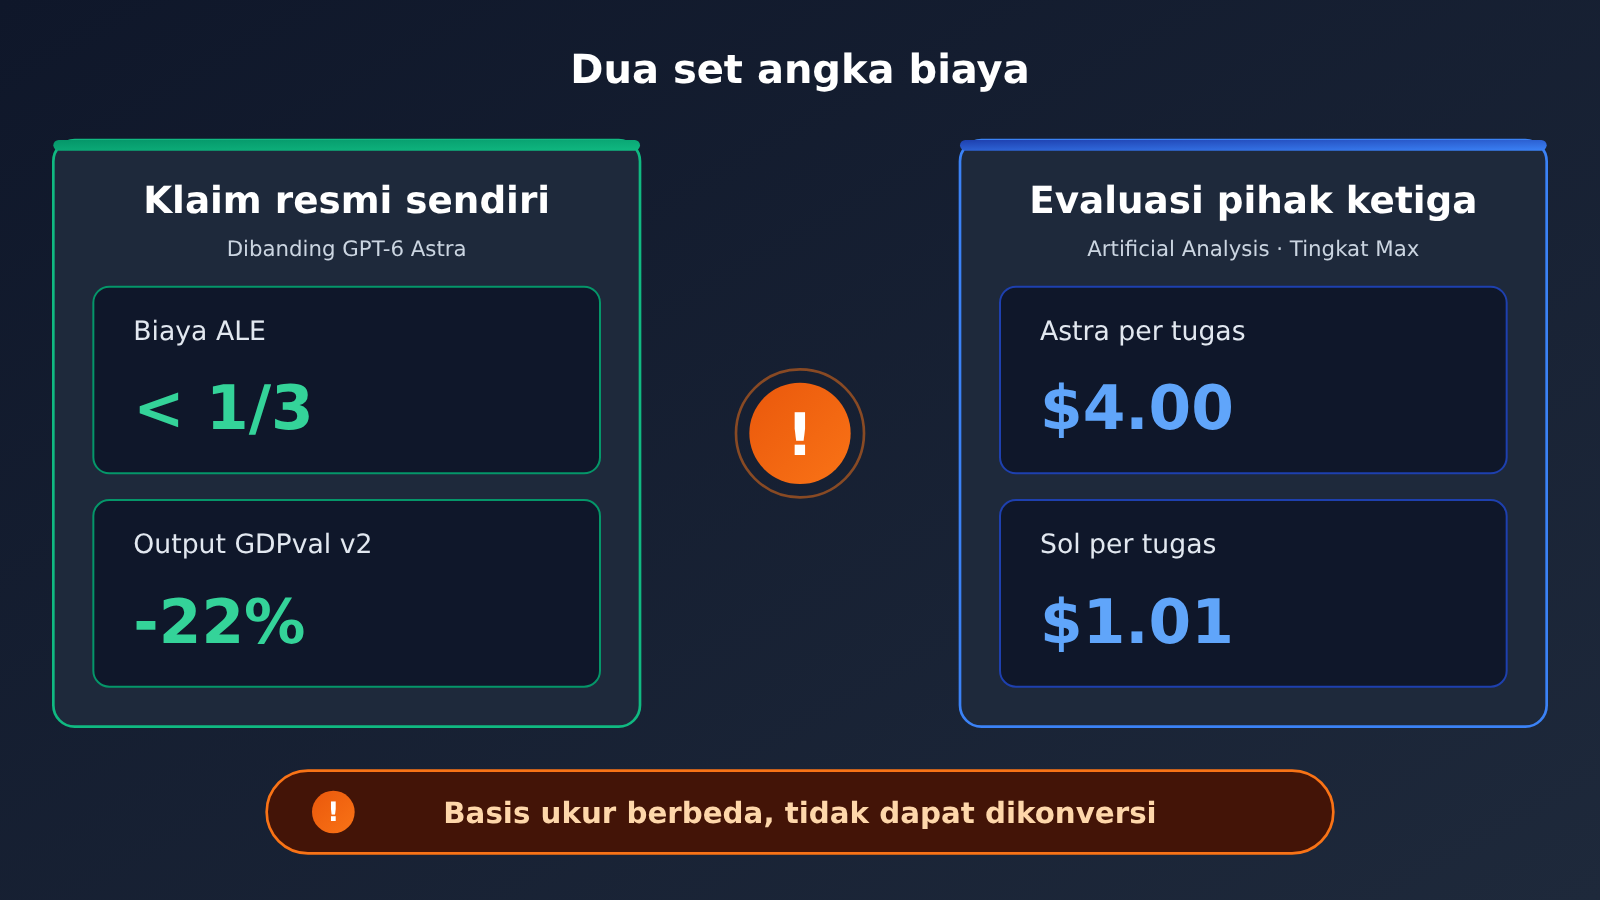
Laporan resmi OpenAI: Dalam pengumuman rilisnya, OpenAI menyatakan bahwa di Agents’ Last Exam, GPT-6.2 Astra mencatat skor 5.2 poin lebih tinggi dari GPT-6 Astra dengan biaya kurang dari sepertiga; sementara di GDPval v2 internal, GPT-6.2 Astra unggul 6.2 poin persentase dari GPT-6 Astra dengan output token 22% lebih sedikit. Semua angka ini dihitung pada tugas yang dipilih sendiri oleh pihak resmi, yang menunjukkan konsumsi token memang menurun di tugas-tugas tersebut, tetapi tidak bisa langsung dikonversi menjadi biaya bisnis Anda.
Pihak ketiga: Artificial Analysis mengukur di Intelligence Index v5.0.1 bahwa biaya per tugas pada indeks gabungan GPT-6.2 Astra (tingkat penalaran Max) tercatat sekitar $4.00, sedangkan GPT-6.2 Sol (tingkat penalaran Max) sekitar $1.01. Ini adalah rata-rata pada rangkaian tugas evaluasi mereka di tingkat penalaran tertinggi — bukan harga satuan GPT-6.2 Astra, dan tidak berarti tugas Anda selalu menghabiskan $4.00 setiap dijalankan. Menurunkan tingkat penalaran akan mengubah konsumsi token secara signifikan, dan skor pada tingkat High, Medium, serta Low yang juga dilaporkan pihak ketiga pun berbeda-beda.
Kedua set angka ini menggunakan tugas, tingkat penalaran, dan metode statistik yang berbeda, sehingga tidak sebaiknya saling dikonversi atau digabung menjadi satu kesimpulan. Untuk memperkirakan tagihan Anda sendiri, tetaplah kembali ke tiga langkah: “urai token, tentukan ambang batas, kalikan faktor pengali”.
Pertanyaan yang Sering Diajukan (FAQ)
Q1: Berapa harga standar GPT-6.2 Astra?
Sesuai halaman model resmi OpenAI, harga standar untuk konteks pendek adalah per 1 juta token: input $8, pembacaan cache $0.40, penulisan cache 30 menit $10, penulisan cache 12 jam $20, output $40. Model ini belum tersedia di platform; kami akan segera menambahkannya. Model dan harga mengacu pada daftar model di platform.
Q2: Apakah kenaikan harga hanya berlaku untuk bagian yang melebihi 272K?
Tidak. Halaman model menyebutkan bahwa perhitungan dilakukan berdasarkan keseluruhan permintaan: ketika input permintaan melebihi 272K token, harga satuan input dan cache untuk seluruh permintaan tersebut digandakan, dan output menjadi 1,5 kali harga konteks pendek. Pada Contoh 2, permintaan yang sama dengan perhitungan yang benar adalah $2.32, sedangkan jika dihitung seluruhnya dengan tarif konteks pendek hanya $1.24.
Q3: Kapan pengali Ultrafast berubah?
Hingga 2027-02-28 (waktu Pasifik), pengalinya 3 kali harga standar, dan mulai 2027-03-01 menjadi 6 kali. Saat menyusun anggaran untuk proyek jangka panjang, penggunaan Ultrafast setelah bulan Maret sebaiknya dihitung terpisah dengan pengali 6 kali.
Q4: Skenario apa yang paling sering menyebabkan salah hitung biaya GPT-6.2 Astra?
– **Analisis repositori kode**: memasukkan seluruh repositori sekaligus dengan mudah melewati batas 272K, sehingga seluruh permintaan pindah tarif.
– **Tugas Agent multi-putaran**: riwayat percakapan dan hasil alat terus menumpuk, dan permintaan di tahap akhir bisa diam-diam melewati ambang batas.
– **Penulisan cache pertama kali**: harga satuan penulisan cache pada permintaan pertama lebih tinggi daripada input biasa, jadi biaya cold start perlu dihitung terpisah.
– **Permintaan konteks panjang dengan Fast atau Ultrafast aktif**: dua faktor kenaikan harga saling dikalikan.
Q5: Bagaimana cara memanggil GPT-6.2 Astra melalui APIYI?
`gpt-6.2-astra` belum tersedia di platform; kami akan segera menambahkannya. Model dan harga mengacu pada daftar model di platform. Sebelum dirilis, Anda bisa mendaftar di apiyi.com dan mengklaim kuota uji gratis, lalu gunakan model yang sudah tersedia, `gpt-6-astra` (input $10, output $50, pembacaan cache $1), untuk mencoba pemanggilan model via Responses atau Chat Completions beserta statistik usage-nya. Setelah model baru tersedia, cukup ganti ID modelnya.
Q6: Apakah angka $4.00 dari Artificial Analysis bisa dipakai sebagai harga satuan?
Tidak bisa. Angka tersebut adalah biaya rata-rata per tugas dari pihak ketiga pada rangkaian tugas Intelligence Index dengan tingkat penalaran Max, yang hanya mencerminkan konsumsi rata-rata dari kelompok tugas tersebut. Panjang tugas, tingkat cache hit, dan tingkat penalaran Anda berbeda, sehingga biaya sebaiknya dihitung sendiri berdasarkan harga satuan resmi.
Q7: Keterbatasan apa saja pada GPT-6.2 Astra yang dapat memengaruhi biaya?
Tingkat penalaran (reasoning) tidak bisa disetel ke `none`, sehingga token penalaran tidak bisa sepenuhnya dihemat; hanya mendukung input teks dan gambar serta output teks, tidak mendukung audio dan video; tidak mendukung Realtime, Assistants, dan fine-tuning. Kartu sistem resmi juga menyebutkan bahwa dalam beberapa pengujian, model ini cenderung gagal melaporkan masalah yang menghambat proses (misalnya file yang hilang) — di alur Agent, setiap kali terjadi percobaan ulang, tagihan ikut bertambah. Sebaiknya minta model untuk melaporkan situasi seperti ini secara eksplisit di dalam petunjuk.
Poin Inti Perhitungan Harga GPT-6.2 Astra (Key Takeaways)
- Empat kategori dihitung terpisah: Harga satuan input, pembacaan cache, penulisan cache, dan output berbeda jauh, jadi wajib dikalikan satu per satu.
- 272K adalah ambang batas untuk seluruh permintaan: Setelah terlampaui, input dan cache ×2, output ×1.5 — bukan hanya bagian yang melebihi batas.
- Tingkatan dikalikan bertumpuk: Batch diskon 50%, Fast ×2 untuk panjang konteks yang sama, Ultrafast dihitung terpisah.
- Ultrafast punya tenggat waktu: ×3 sebelum 2027-02-28 (PT), ×6 mulai 2027-03-01.
- Cache mahal di awal, hemat setelahnya: Penulisan pertama lebih mahal dari harga input, dan setelah cache hit, biaya per permintaan bisa mendekati setengah harga.
- Jangan campuradukkan acuan perhitungan: Angka resmi yang dilaporkan sendiri maupun biaya satu tugas dari pihak ketiga bukanlah harga satuan.
- Ketersediaan mengikuti daftar model: Kedua varian 6.2 belum tersedia di APIYI, gunakan dulu model sebelumnya untuk memverifikasi alurnya.
Ringkasan
Perhitungan harga GPT-6.2 Astra bisa diringkas menjadi tiga langkah:
- Pisahkan token: Bagi satu permintaan menjadi input biasa, pembacaan cache, penulisan cache, dan output; token penalaran dihitung ke sisi output.
- Periksa ambang batas: Jika total input permintaan melebihi 272K, seluruh permintaan beralih ke harga satuan konteks panjang — input dan cache ×2, output ×1.5.
- Kalikan faktor pengali: Pilih pengali sesuai Batch, standar, Fast, atau Ultrafast; ingat, Ultrafast berubah menjadi 6× mulai 2027-03-01.
Saat menyusun anggaran, pakai dulu tabel di Contoh 1 dan Contoh 2 dengan memasukkan jumlah token milikmu sendiri, lalu hitung sekali lagi masing-masing untuk tingkatan standar dan tingkatan percepatan yang mau kamu gunakan — selisihnya biasanya lebih besar dari perkiraan. GPT-6.2 Astra dan GPT-6.2 Sol belum tersedia di APIYI; kami akan segera merilis kedua model ini, dan nama model beserta harganya mengacu pada daftar model di platform. Sebelum dirilis, kamu bisa di apiyi.com memanfaatkan kuota gratis dan model yang sudah tersedia untuk menyiapkan terlebih dahulu alur pencatatan statistik usage dan verifikasi biaya.
📚 Referensi
-
Artikel rilisan OpenAI: Catatan rilis GPT-6.2 Astra dan Sol
- Tautan:
openai.com/index/introducing-gpt-6-2-astra-sol - Keterangan: Ringkasan harga standar dan data kemampuan yang dilaporkan resmi OpenAI
- Tautan:
-
Halaman model OpenAI – gpt-6.2-astra: Spesifikasi dan aturan harga lengkap
- Tautan:
platform.openai.com/docs/models/gpt-6.2-astra - Keterangan: Gunakan halaman ini sebagai acuan untuk harga penulisan cache, aturan 272K untuk seluruh pesanan, serta multiplikator Batch/Fast/Ultrafast
- Tautan:
-
Halaman model OpenAI – gpt-6.2-sol: Spesifikasi dan harga resmi Sol
- Tautan:
platform.openai.com/docs/models/gpt-6.2-sol - Keterangan: Harga standar jendela konteks pendek Sol beserta aturan harga yang sama
- Tautan:
-
Kartu sistem OpenAI: Evaluasi keamanan dan alignment
- Tautan:
deploymentsafety.openai.com/gpt-6-2-astra-sol - Keterangan: Keterbatasan yang diketahui, seperti masalah hambatan yang tidak terlaporkan
- Tautan:
-
Artikel evaluasi Artificial Analysis (pihak ketiga): Hasil Intelligence Index
- Tautan:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Keterangan: Data pihak ketiga seperti biaya per tugas pada tingkat reasoning Max
- Tautan:
-
Daftar model lengkap dan endpoint harga APIYI: Model yang tersedia dan harga resmi platform
- Tautan:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Keterangan: Gunakan sumber ini sebagai acuan untuk status ketersediaan kedua model 6.2 dan harga model pembanding
- Tautan:
Penulis: Tim teknis APIYI
Diskusi teknis: Silakan hubungi kami melalui halaman beranda situs APIYI. Untuk materi integrasi lebih lengkap, kunjungi pusat dokumentasi docs.apiyi.com


