
Nota del autor: ambos son modelos insignia de nivel 2.4T; Qwen4-Max reduce un 25% el precio de lista, casi triplica el límite de salida y usa entre un 20% y un 30% menos tokens para una misma tarea. Este artículo desglosa la arquitectura, los resultados de benchmark autodeclarados por el fabricante y los precios de lista de las dos generaciones, además de una lista de comprobación para migrar desde qwen3.8-max.
El 16 de noviembre de 2026, Alibaba presentó Qwen4-Max. Primero, la conclusión: en comparación con Qwen3.8-Max, la nueva generación reduce un 25% los precios de lista de entrada y salida, eleva el máximo de salida de 128K a 393K, casi el triple y, en la evaluación oficial Work360, usa entre un 20% y un 30% menos tokens para una misma tarea. Para los equipos que ya ejecutan qwen3.8-max en producción, esta actualización merece una evaluación seria, pero no exige empezar de cero.
Este no es un artículo promocional del tipo «la nueva generación arrasa en todo». A continuación, todas las puntuaciones se etiquetan como autodeclaradas por el fabricante, y las clasificaciones de terceros como instantáneas de clasificaciones públicas (2026-11-14). Dos cifras que se prestan a exageración —la reducción del 62% en el coste por tarea y el sexto puesto en Arena— las desglosaremos por separado.
Valor clave: al terminar podrás responder a tres preguntas: qué parte del ahorro es real, qué benchmarks mejoran de forma clara y cuáles apenas se mueven, y qué más hay que cambiar al migrar, además del ID del modelo. Además, si llamas a través de APIYI (apiyi.com), a fecha de 2026-11-16, 11:00, la plataforma aún no tiene qwen4-max disponible; por ahora puedes seguir usando qwen3.8-max. Publicaremos este modelo lo antes posible.
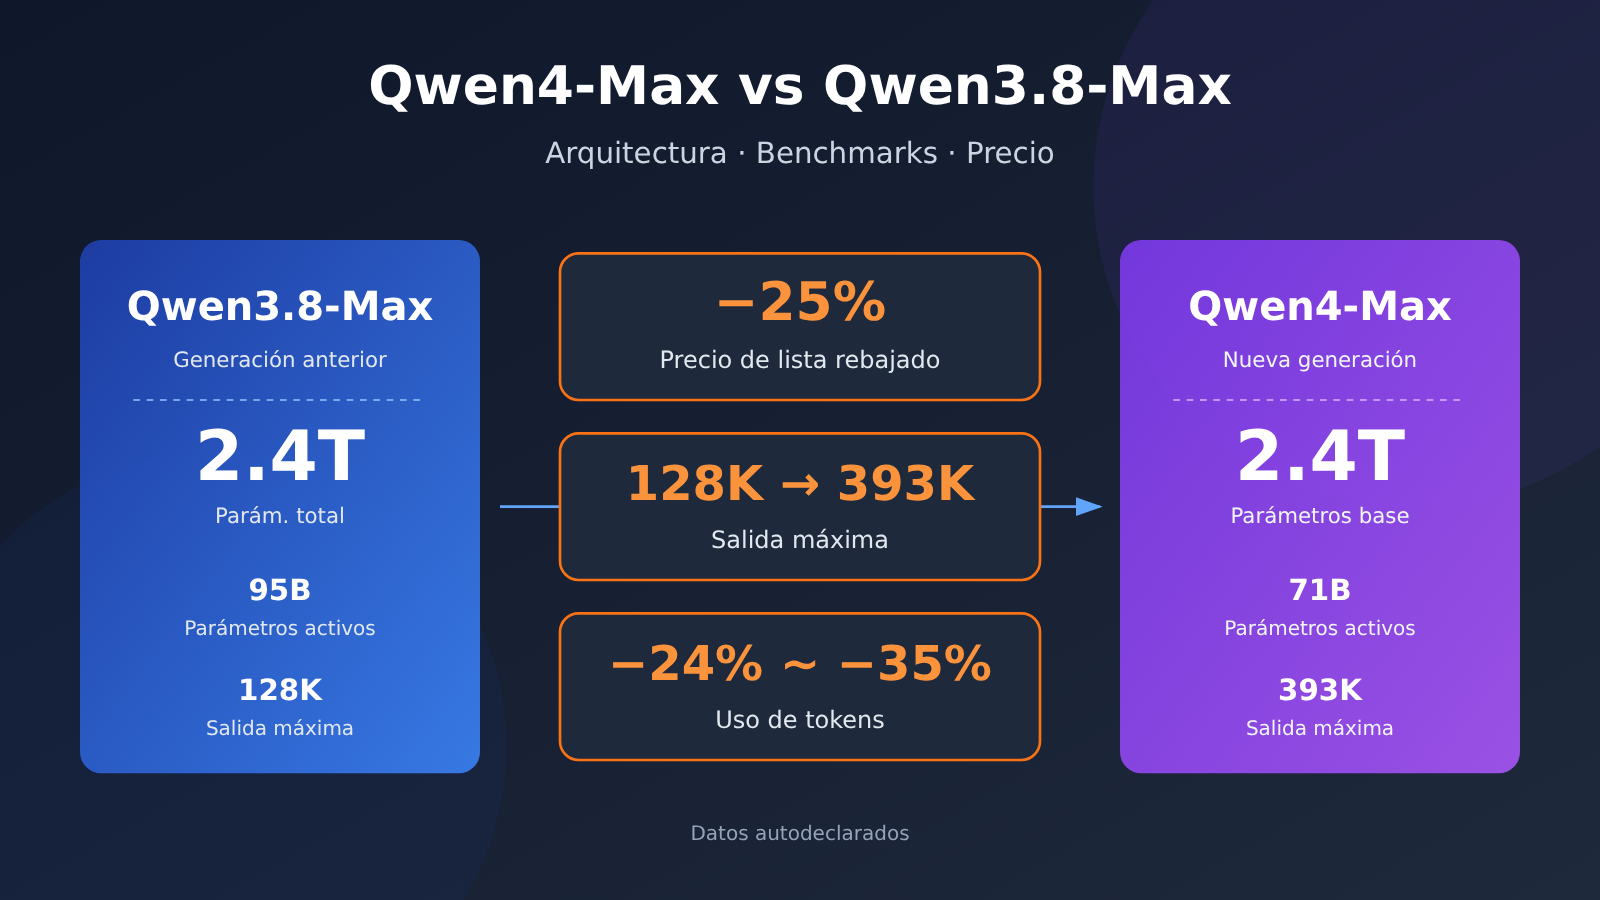
Vistazo rápido a las diferencias clave entre Qwen4-Max y Qwen3.8-Max
El tamaño total de las dos generaciones de modelos está en el mismo rango, pero Qwen4-Max introduce ajustes en los parámetros activados, el límite de salida y el nivel de razonamiento predeterminado. La siguiente tabla reúne primero las diferencias en cuanto a especificaciones; el precio se trata aparte en la sección de costos más adelante.
| Aspecto de comparación | Qwen3.8-Max | Qwen4-Max | Cambio |
|---|---|---|---|
| Tamaño de parámetros | 2.4T de parámetros totales | Backbone de 2.4T + 328B de embedding N-gram | Backbone equivalente, nueva tabla de embeddings |
| Activación por invocación | 95B | 71B | Aproximadamente 25% menos |
| Contexto | 1M | 1M (entrada máxima 991K, modo de pensamiento 983K) | Límite de entrada ligeramente más restrictivo |
| Salida máxima | 128K | 393K | Aproximadamente 3 veces |
| Cadena de pensamiento máxima | La documentación oficial no lo detalla por separado | 262K | Nuevo límite explícito |
reasoning_effort predeterminado |
xhigh | high | El nivel predeterminado baja un escalón |
| Capacidad visual | Admite entrada de imágenes | Visión nativa | La visión pasa a ser una capacidad nativa |
| Pesos abiertos | Qwen3.8-2.4T-A95B | No se menciona en la documentación | — |
Esta tabla deja ver la lógica de esta actualización: mismo tamaño total, menos cómputo por invocación y más espacio de salida. La bajada de los parámetros activados de 95B a 71B es la premisa de fondo para poder reducir el precio de lista; llevar la salida máxima a 393K cambia directamente la viabilidad de tareas como informes extensos o generación de grandes bloques de código.
Hay que advertir que el reasoning_effort predeterminado pasa de xhigh a high. Si tu código no configura explícitamente este parámetro, al cambiar el ID del modelo el nivel de razonamiento que se ejecuta realmente cambiará; esto se recalcará de nuevo en la lista de migración.
Cambios de arquitectura de Qwen4-Max: cómo afectan al uso las tres modificaciones
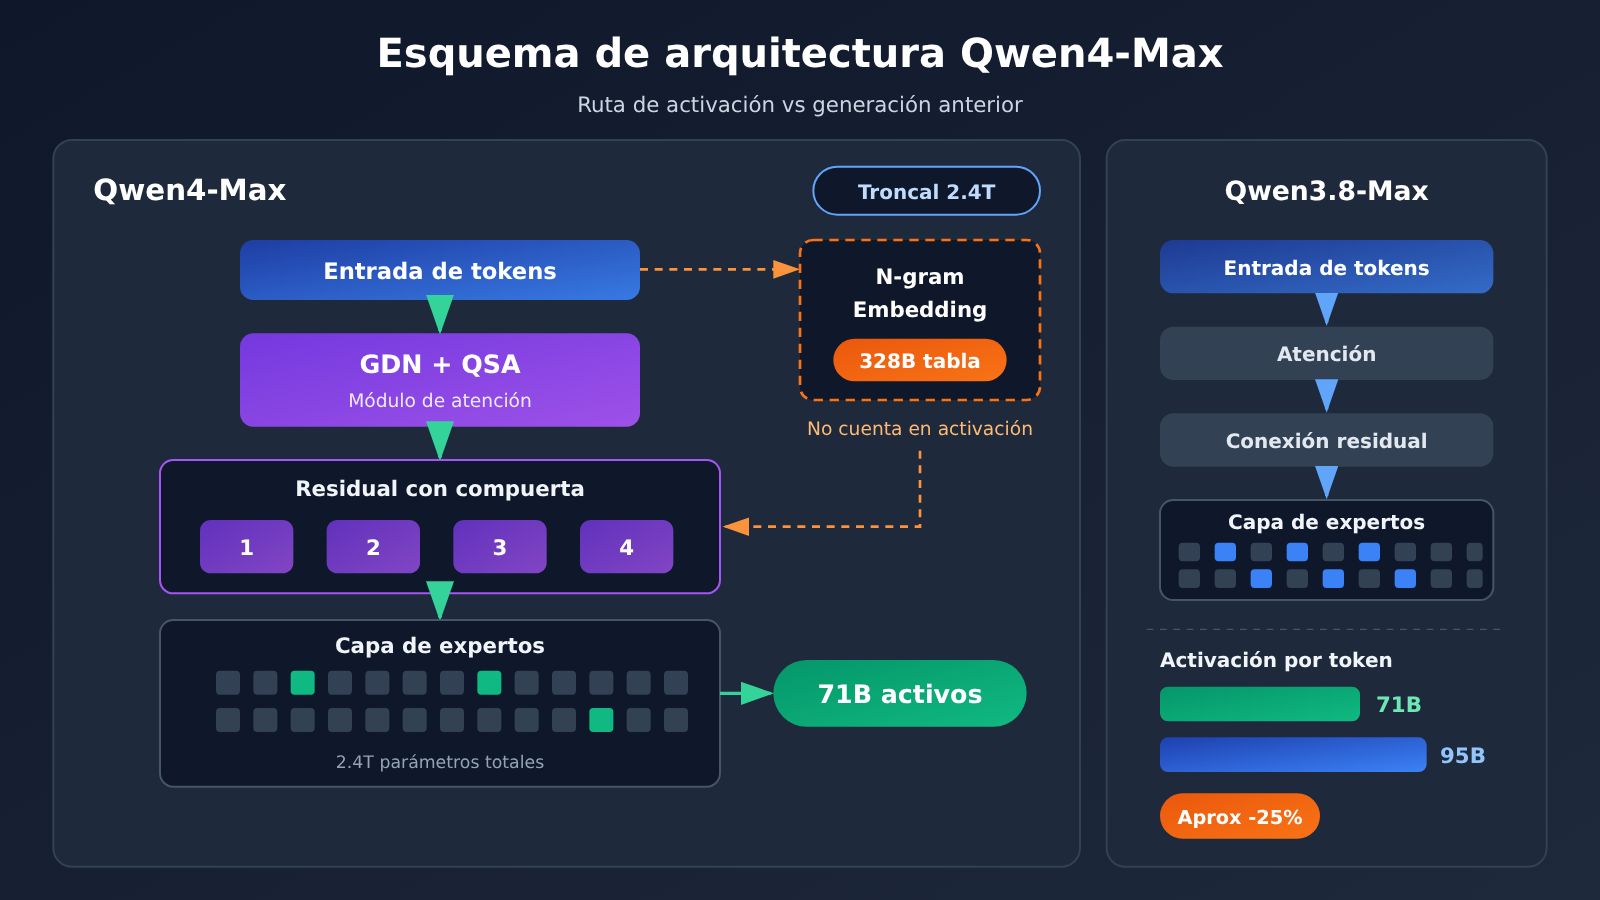
El blog oficial resume los cambios de arquitectura de Qwen4-Max en tres puntos: GDN + QSA, las cuatro ramas de Gated Residual y el N-gram Embedding. Para quienes usan la API no hace falta entender la implementación capa por capa, pero sí conviene saber qué afecta cada uno de estos tres cambios.
GDN + QSA: cambios en la capa de atención
Se trata de un ajuste en la estructura de atención. La documentación oficial lo presenta junto con la ventana de contexto de 1M y la salida máxima de 393K, y nuestra lectura es que principalmente sirve a la eficiencia de cómputo en escenarios de secuencias largas. Para quien llama a la API, el resultado directamente perceptible es: con la misma ventana de contexto de 1M, Qwen4-Max puede generar salidas más largas y, aun así, el precio unitario es más bajo.
Las cuatro ramas de Gated Residual
Las conexiones residuales se ampliaron a cuatro ramas con compuertas. Este tipo de cambios suele afectar a la estabilidad del entrenamiento y al flujo de información entre distintas capacidades, y al final se refleja en el comportamiento del modelo. El impacto práctico es que, incluso si la indicación no cambia en absoluto, el estilo de salida de Qwen4-Max y la longitud de sus pasos de razonamiento pueden diferir de la generación anterior, así que las indicaciones ajustadas finamente para Qwen3.8-Max necesitan pruebas de regresión.
N-gram Embedding: 328B de parámetros no equivale a cómputo
Los parámetros de Qwen4-Max se escriben como «tronco de 2.4T / 71B activos + 328B de N-gram Embedding». Según el diseño habitual, este tipo de embeddings son parámetros de tipo tabla de búsqueda y no se cuentan en el cómputo de activación del tronco por token, así que no se puede sumar directamente 328B a la cantidad de activación para hacer comparaciones. Lo que realmente se relaciona con el costo de inferencia es 71B frente a 95B, es decir, alrededor de un 25% menos de activación en cada paso.
En el plano del preentrenamiento, la documentación oficial indica que Qwen4-Max-Base obtiene el valor más bajo de BPB (bits por byte, cuanto más bajo mejor) en las cuatro categorías de evaluación interna: conocimiento, código, preguntas y respuestas, y STEM, alrededor de un 5–13% por debajo de Qwen3.8-Max-Base. Son evaluaciones internas de la propia empresa, pero al menos muestran que la base en sí ha mejorado y que las mejoras posteriores en los benchmarks no dependen solo del postentrenamiento.
Comparativa de benchmarks de Qwen4-Max: en qué sube mucho y en qué casi no se mueve
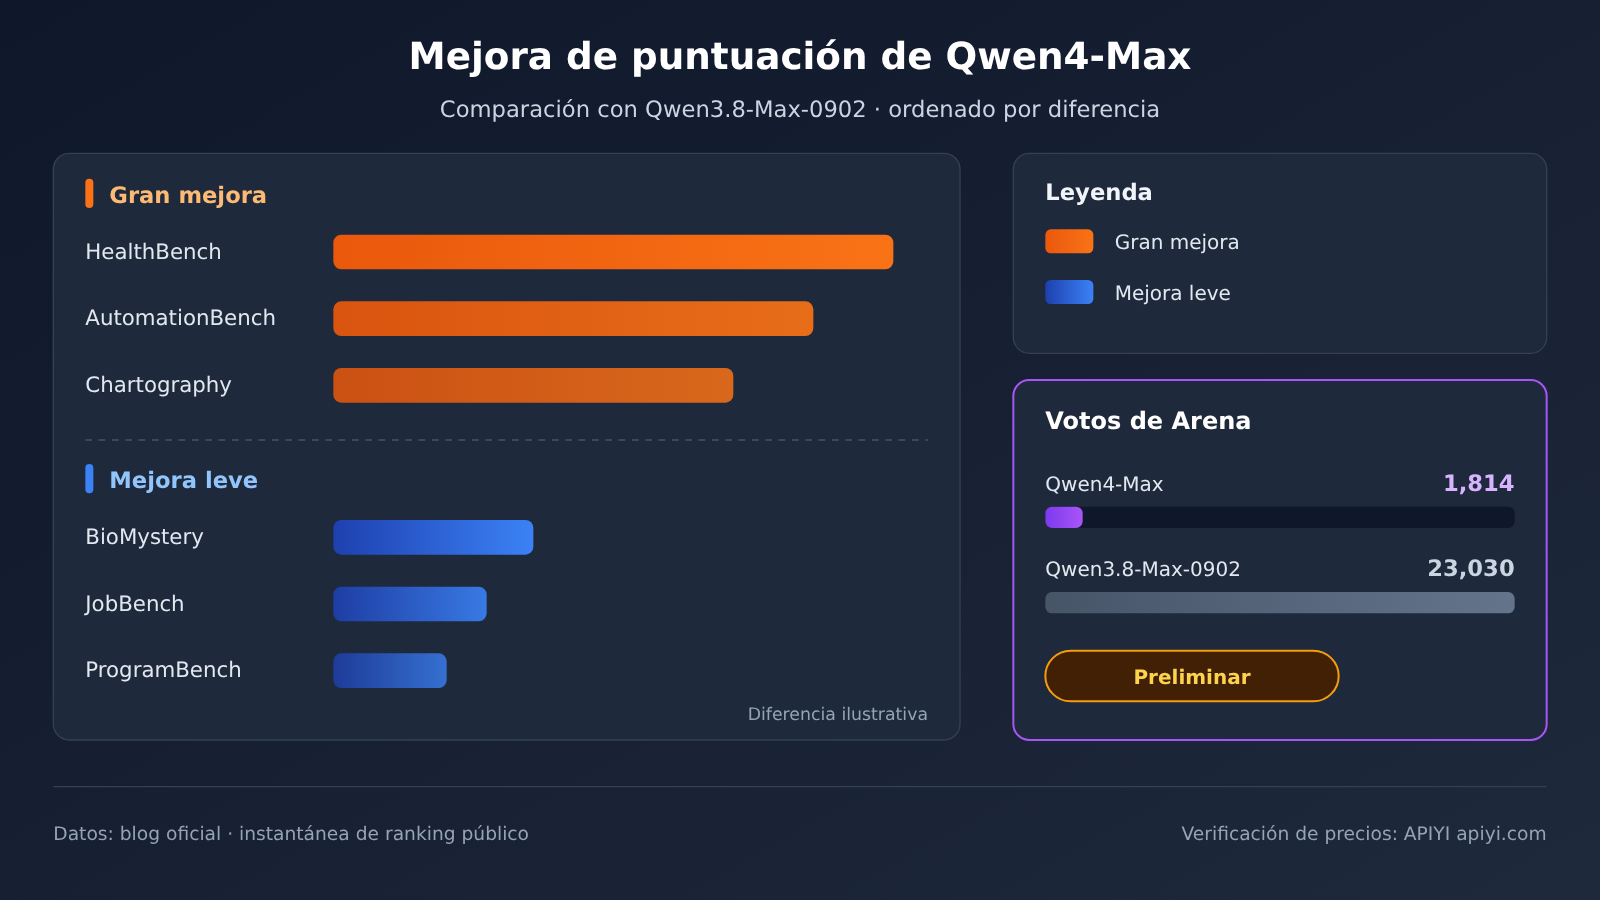
Todos los datos siguientes salen de la misma tabla comparativa de Alibaba y son autoinformados por la propia compañía; la referencia de comparación es Qwen3.8-Max-0902 (la versión actualizada de septiembre). Los hemos ordenado de mayor a menor mejora para que se vea de un vistazo dónde se concentra el beneficio de la actualización.
| Benchmark (autoinformado oficial) | Qwen3.8-Max-0902 | Qwen4-Max | Diferencia | Valoración de la mejora |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | Notable |
| CodeArena | 1676 | 1750 | +74 | Notable |
| HealthBench | 39.6 | 60.0 | +20.4 | Muy notable |
| AutomationBench | 56.2 | 72.5 | +16.3 | Muy notable |
| Chartography | 42.0 | 54.2 | +12.2 | Notable |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | Notable |
| APEX-Agents | 63.3 | 72.1 | +8.8 | Notable |
| HLE | 43.9 | 51.7 | +7.8 | Notable |
| DeepSWE | 69.3 | 75.7 | +6.4 | Moderada |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | Moderada |
| Video-Index | 63.2 | 68.1 | +4.9 | Moderada |
| ProgramBench | 28.0 | 31.5 | +3.5 | Pequeña |
| JobBench | 65.3 | 68.5 | +3.2 | Pequeña |
| BioMystery | 84.1 | 85.0 | +0.9 | Casi sin cambios |
Donde más se concentra la mejora es en las tareas de tipo agente e invocación de herramientas: AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8. Si tu negocio se basa en invocaciones de herramientas de múltiples turnos, operaciones de terminal o flujos automatizados, esta es la dirección donde más se nota el beneficio de la actualización. HealthBench pasa de 39.6 a 60.0 y Chartography sube 12.2, lo que indica que las preguntas y respuestas médicas y la comprensión de gráficos también son focos importantes de esta generación.
En el otro extremo, BioMystery solo sube 0.9, y JobBench y ProgramBench suben poco más de 3 puntos. En estos tipos de tareas el beneficio marginal de la actualización es limitado; si tu escenario principal se parece justo a estos, los benchmarks por sí solos no bastan para justificar una decisión de actualización y convendría fijarse más en el coste. El Work360 que la compañía publica aparte marca 52.69 frente a 47.74, es decir, 4.95 más, lo que también entra en la categoría de mejora moderada.
En cuanto a seguridad, la compañía indica que la tasa de doble aprobación a nivel de función en Last Secure Code Bench sube del 22.0% al 31.8%, y que la seguridad simultánea en las tres granularidades pasa del 8% al 14.7%. En términos absolutos siguen siendo cifras bajas y el código generado sigue necesitando revisión de seguridad, pero la mejora relativa es clara.
Ranking de terceros de Arena: puesto preliminar con 1,814 votos
Los 1750 puntos oficiales de CodeArena también aparecen en el ranking de terceros arena.ai Code Arena WebDev. A continuación tienes una instantánea del ranking público, 2026-11-14:
- Qwen4-Max (xHigh): 1750 puntos, puesto 6, marcado como Preliminary, 1,814 votos, $4.18/tarea
- Qwen3.8-Max (0902): 1676 puntos, puesto 16, 23,030 votos, $1.91/tarea
- Qwen3.8-Max: 1670 puntos, puesto 18
Aquí está el segundo punto que se presta a exageraciones: Qwen4-Max tiene apenas 1,814 votos, mientras que la versión 0902 de la generación anterior acumula 23,030, una diferencia de unas 12 veces. La etiqueta Preliminary significa que el ranking todavía está convergiendo y que ese puesto 6 aún puede moverse; por ahora, lo mejor al citarlo es escribir «puesto 6 preliminar».
Hay otro detalle en la instantánea que vale la pena señalar: Qwen4-Max compite en el nivel xHigh, con un coste de $4.18 por tarea, superior a los $1.91 de Qwen3.8-Max 0902. Esto no contradice la afirmación oficial de «menor coste por tarea», porque los niveles medidos y los tipos de tarea son distintos, pero nos recuerda algo: en el nivel de razonamiento más alto, Qwen4-Max no necesariamente sale más económico.
Precios y costos de Qwen4-Max: ¿cuánto de lo que ahorras es real?
Al final, actualizar significa cambiar de modelo, y antes de decidir conviene revisar los precios. La tabla siguiente reúne los precios oficiales de lista de las dos generaciones y el precio al que APIYI vende hoy qwen3.8-max; todas las cifras son por cada 1M tokens y la fecha de referencia es 2026-11-16.
| Concepto de facturación (por 1M tokens) | Qwen3.8-Max oficial (región de Singapur) | Qwen4-Max oficial | Qwen4-Max oficial en CNY | APIYI qwen3.8-max precio actual |
|---|---|---|---|---|
| Entrada | $2 | $1.5 | ¥10 | $1.65 |
| Salida | $6 | $4.5 | ¥30 | $4.95 |
| Lectura de caché | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| Escritura de caché (5 minutos) | No indicado en el blog oficial | $1.875 | ¥12.5 | No desglosado en la documentación |
| Escritura de caché (1 hora) | No indicado en el blog oficial | $3 | ¥20 | No desglosado en la documentación |
La entrada y la salida bajan un 25% cada una, y la lectura de caché pasa de $0.25 a $0.075, una caída de aproximadamente el 70%, que es el ajuste más grande de esta rebaja de precios. Por otro lado, Qwen4-Max detalla dos tarifas de escritura de caché, una de 5 minutos y otra de 1 hora, así que las aplicaciones que reutilizan con frecuencia prefijos largos deben incluir ese costo de escritura en su presupuesto.
Ahorro de tokens: entre un 20% y un 30% según Work360, entre un 40% y un 50% según Terminal-Bench
Los datos oficiales sobre ahorro de tokens vienen en dos grupos. En Work360, el nivel Xhigh reduce el consumo en un 24% y el nivel High en un 35%, de ahí la cifra de “entre un 20% y un 30%”. En Terminal-Bench 4.0 la diferencia es aún más marcada: un 48% y un 49%, respectivamente.
El ahorro en tareas de terminal es claramente mayor, lo que podría estar relacionado con la reducción del número de rondas de herramientas en este tipo de tareas. A la hora de hacer presupuestos, para tareas de oficina generales es más prudente calcular entre un 20% y un 30%; el 40% a 50% solo aplica a escenarios de operación de terminal similares a Terminal-Bench.
Los 11 puntos que no cuadran entre el 62% y el 51%
Este es el primer punto que se presta a exageración. Los datos oficiales indican que el coste por tarea baja de $4.43 a $1.67, lo que supone una reducción de aproximadamente el 62% en dólares; la cifra en yuanes dice que baja de ¥26.58 a ¥11.16, alrededor del 58%. Ya de por sí hay diferencias entre ambas bases de cálculo.
Si hacemos el cálculo con los propios datos oficiales: 35% menos tokens y 25% menos precio unitario; multiplicando ambos factores solo se obtiene una reducción de alrededor del 51%, es decir, 0.65 × 0.75 ≈ 0.49. Los aproximadamente 11 puntos restantes no tienen explicación oficial. Nuestra hipótesis es que podrían venir del beneficio de los aciertos de caché gracias a la fuerte bajada del precio de lectura de caché (aproximadamente −70%), y de la reducción del número de rondas de invocación de herramientas, pero esto es solo una inferencia, no una explicación oficial.
Lo prudente es tomar el 51% como límite superior de referencia “con la misma tasa de aciertos de caché”; el 62% solo podría alcanzarse en escenarios con una tasa de aciertos de caché alta y muchas rondas de herramientas. En tu caso concreto, la referencia más fiable es hacer una comparación del coste por tarea con tráfico real.
Precio actual y estado de disponibilidad en APIYI
APIYI vende actualmente qwen3.8-max, con entrada a $1.65, salida a $4.95 y lectura de caché a $0.20625; según la documentación, está un 17.5% por debajo de los $2 / $6 de Alibaba Cloud. Al mismo precio también está qwen3.8-max-0902, y la versión de pesos abiertos qwen3.8-2.4t-a95b cuesta $1.72 / $5.16 / $0.215.
En la revisión del 2026-11-16 a las 11:00, qwen4-max todavía no aparecía ni en la documentación de modelos ni en la lista de precios de APIYI (284 modelos en total), así que aún no está publicado. Vamos a publicar este modelo lo antes posible; los nombres de modelo y los precios se rigen por la lista de modelos de la plataforma APIYI apiyi.com. Sinceramente, el precio unitario oficial de Qwen4-Max ya está por debajo del precio actual de qwen3.8-max en la plataforma, así que cuando esté publicado merece la pena volver a revisar los números.
Lista de verificación para migrar de Qwen3.8-Max a Qwen4-Max
Mucha gente cree que una actualización consiste solo en cambiar el ID del modelo, pero en realidad también cambian los parámetros predeterminados, los límites de contexto y la facturación de caché. La siguiente lista está ordenada por prioridad: primero lo que, si no se toca, puede causar problemas.
| Elemento de verificación | Estado actual en Qwen3.8-Max | Después de migrar a Qwen4-Max | Acción recomendada |
|---|---|---|---|
| ID del modelo | qwen3.8-max / qwen3.8-max-0902 |
Según la lista de modelos de la plataforma | Cambiar cuando esté disponible; primero un despliegue gradual |
| Valor predeterminado de reasoning_effort | xhigh | high | Especificar el nivel de forma explícita para evitar cambios silenciosos de comportamiento |
| Límite de max_tokens | 128K | 393K | Revisar el truncamiento, el almacenamiento y la configuración de timeouts aguas abajo |
| Entrada máxima | 1M | 991K (983K en modo de razonamiento) | Las entradas ultra largas cercanas a 1M necesitan recorte |
| Facturación de caché | Lectura de caché $0.25 | Lectura de caché $0.075, más precios de escritura de 5 minutos / 1 hora | Reevaluar la estrategia de prefijo de caché y TTL |
| Entrada visual | Entrada de imágenes | Visión nativa | Volver a hacer regresión en los casos de uso con imágenes |
| Indicaciones y formato de salida | Optimizados para la generación anterior | Cambios de arquitectura; el comportamiento puede diferir | Hacer regresión con un conjunto de evaluación fijo |
| Monitoreo de costos | Facturado por token | Tanto el token como el precio unitario bajan | Pasar a mirar el costo por tarea en lugar del precio unitario |
Lo que más fácilmente se pasa por alto en la lista es reasoning_effort. Qwen3.8-Max usa xhigh por defecto y Qwen4-Max usa high; si el código no lo configura explícitamente, después del cambio puede que ahorres tokens, pero también puede que rindas por debajo de lo esperado en tareas de razonamiento complejo. Los datos oficiales de ahorro de tokens cubren tanto el nivel Xhigh como el High, así que conviene que pruebes ambos por separado y luego decidas cuál usar en producción.
El segundo punto es la longitud de salida. El límite de 393K significa que una sola respuesta puede ser mucho más larga que antes; si los sistemas de logs, los campos de base de datos o los timeouts del gateway están diseñados para salidas de 128K, hay que ampliarlos de antemano. La entrada máxima pasa de 1M a 991K (983K en modo de razonamiento): para los negocios que normalmente no se acercan al límite el impacto es menor, pero los escenarios que meten documentos justo hasta el tope van a fallar directamente.
Cómo llamar a través de APIYI en esta etapa
Si hoy te conectas a través de APIYI, con base_url https://api.apiyi.com/v1 y el protocolo compatible con OpenAI, basta con poner qwen3.8-max en el campo del modelo para seguir funcionando en producción. Si necesitas fijar el comportamiento de la versión actualizada de septiembre, puedes usar qwen3.8-max-0902, al mismo precio.
Cuando qwen4-max esté disponible en la plataforma, como el protocolo no cambia, a nivel de código la migración solo requiere cambiar el campo model y luego completar reasoning_effort y max_tokens según la lista de arriba. Se recomienda desviar primero entre 5% y 10% del tráfico para un despliegue gradual, comparar el costo por tarea y las métricas de negocio, y después hacer el cambio completo.
🚀 Recomendación de migración: los proyectos que hoy pasan por APIYI apiyi.com pueden seguir usando
qwen3.8-maxy, al mismo tiempo, preparar el conjunto de evaluación y el interruptor de despliegue gradual; cambia el ID cuandoqwen4-maxesté disponible. Así evitas el hueco operativo de “esperar al modelo nuevo”.
Recomendaciones de escenarios para Qwen4-Max y Qwen3.8-Max
Escenarios en los que conviene evaluar primero la actualización a Qwen4-Max
- Llamadas de herramientas multiturno y automatización: AutomationBench, Terminal-Bench y APEX-Agents muestran mejoras claras, y el ahorro de tokens también es mayor en las tareas de terminal.
- Tareas con salidas ultralargas: cuando necesitas generar en una sola vez informes, código o documentos de más de 128K, solo los 393K de Qwen4-Max pueden cubrirlo.
- Preguntas médicas y comprensión de gráficos: HealthBench +20.4 y Chartography +12.2 son los ámbitos con las mejoras más significativas de esta generación.
- Cuando hay requisitos de seguridad del código: la tasa de doble aprobación de seguridad sube del 22.0% al 31.8%, pero sigue siendo necesario combinarla con un proceso de revisión.
- Aplicaciones con alta reutilización de caché: el precio de lectura de caché baja cerca del 70%; los escenarios con indicaciones de sistema largas y prefijos fijos de bases de conocimiento son los más beneficiados.
Escenarios en los que conviene seguir usando Qwen3.8-Max
- Producción estable y indicaciones profundamente optimizadas: Qwen3.8-Max sigue siendo un modelo de producción fiable; no hace falta actualizar solo por actualizar.
- Tareas principales similares a BioMystery y JobBench: en estas direcciones las mejoras son limitadas y el coste de migración podría superar el beneficio.
- Necesitas pesos abiertos para autodespliegue: Qwen3.8-2.4T-A95B tiene pesos abiertos; la documentación no menciona una versión de pesos abiertos de Qwen4-Max.
- Llamas a través de APIYI y necesitas disponibilidad inmediata: mientras
qwen4-maxaún no está disponible,qwen3.8-maxes la opción existente.
| Tu situación | Recomendación |
|---|---|
| Agentes y llamadas de herramientas como eje, con objetivo de reducir costes | Evaluar primero Qwen4-Max y medir el coste real en el nivel High |
| Necesitas más de 128K en una sola salida | Solo puedes elegir Qwen4-Max |
| Producción estable, sobre todo preguntas y respuestas generales | Mantén Qwen3.8-Max y haz pruebas de regresión cuando haya tiempo libre |
| Necesitas autodesplegar pesos abiertos | Sigue usando Qwen3.8-2.4T-A95B |
| Actualmente accedes a través de APIYI | Sigue usando qwen3.8-max y, cuando esté disponible, realiza un cambio gradual |
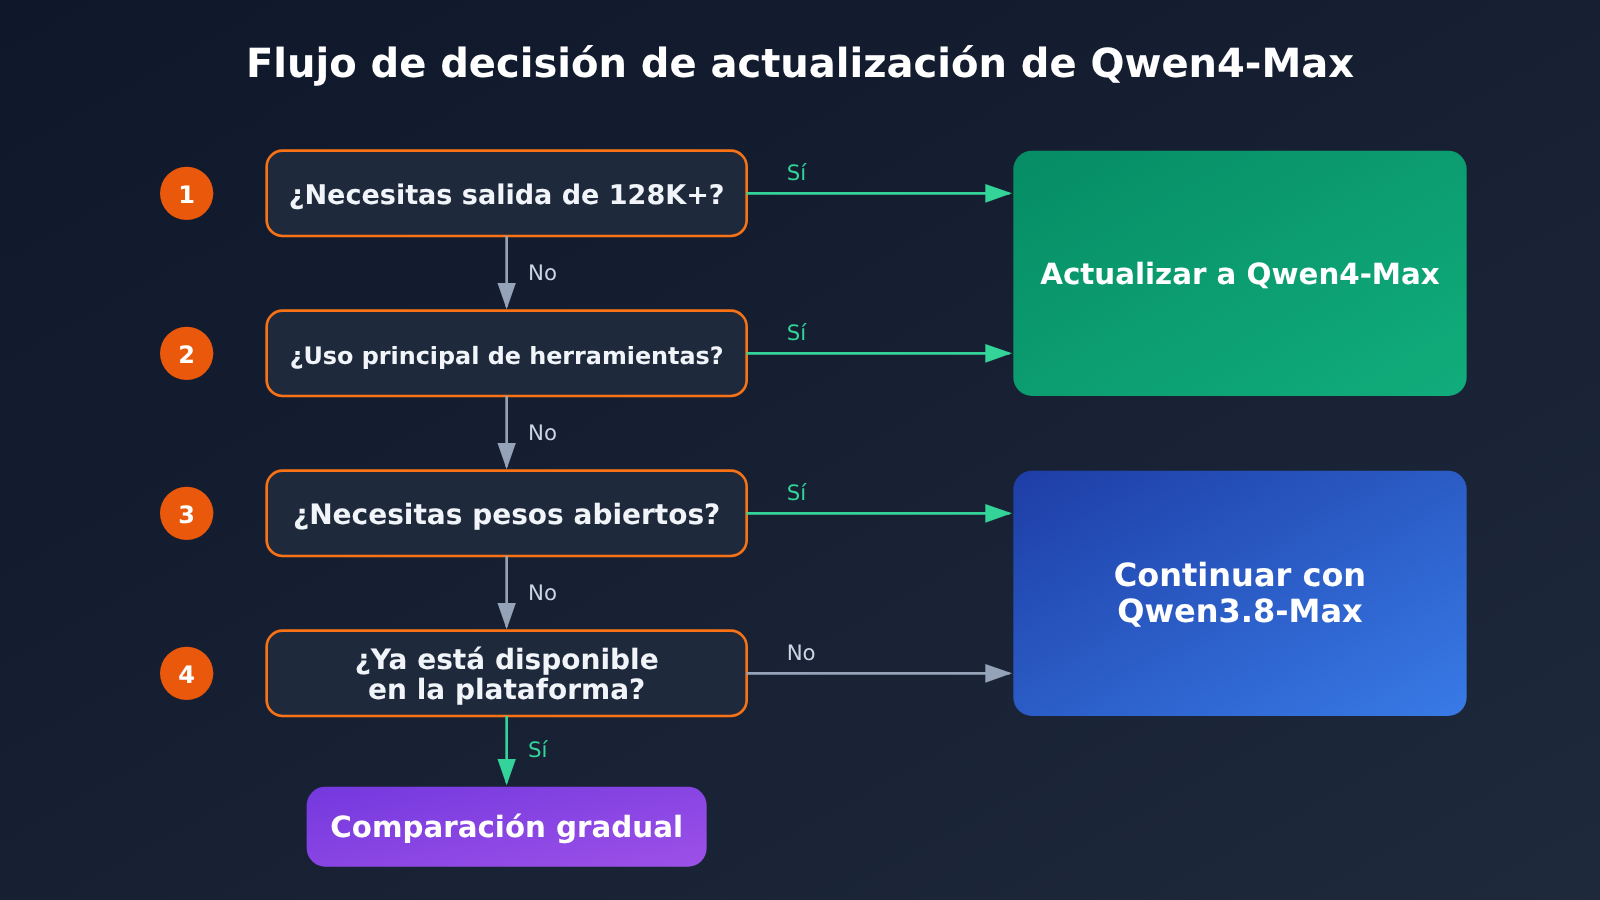
Recomendaciones de decisión: Qwen4-Max frente a Qwen3.8-Max
Si tuviera que resumirlo en una sola frase: los agentes inteligentes, las salidas largas y los negocios intensivos en caché merecen la pena actualizarse; los negocios generales y estables pueden esperar. De las tres ventajas de la actualización, la reducción del 25% en el precio unitario es un hecho; el ahorro de tokens de entre dos y tres décimas es un dato oficial de evaluaciones específicas; y la reducción del 62% por tarea solo se acercará a esa cifra si tus propias condiciones de caché y de rondas de herramientas acompañan.
💡 Recomendación de elección: antes de decidir, conviene ejecutar una tanda con tus tareas reales para comparar el coste por tarea y la calidad del resultado, en lugar de fijarse solo en la tabla de puntuaciones. A través de APIYI apiyi.com puedes usar la misma clave API para ejecutar primero la línea base de
qwen3.8-max, y cuandoqwen4-maxesté publicado, compararlo directamente dentro del mismo código.
Preguntas frecuentes (FAQ)
P1: ¿Qué relación hay entre Qwen4-Max y Qwen3.8-Max?
Ambos son los modelos insignia de nivel 2.4T de Tongyi Qianwen. Qwen3.8-Max se lanzó el 2026-08-03 y 0902 es la versión renovada de septiembre; Qwen4-Max se lanzó el 2026-11-16, cambió de arquitectura, redujo los parámetros activados por pasada de 95B a 71B, elevó el límite de salida a 393K y bajó el precio de lista un 25%.
P2: Si ahorro entre 20% y 30% en tokens, ¿la factura baja entre 20% y 30%?
Puede ser más, pero no siempre. El precio unitario ya baja un 25%; sumado a la reducción de tokens, en teoría el costo de una misma tarea podría bajar alrededor de 51%. Sin embargo, los datos de ahorro de tokens provienen del benchmark oficial Work360, y cuánto puedes ahorrar en tu negocio depende de tus pruebas. Si usas el nivel xhigh, como muestra la instantánea de Arena, el costo por tarea podría ser incluso mayor.
P3: Qwen4-Max ocupa el 6.º puesto en Arena, ¿es fiable esa posición?
Solo puede considerarse un resultado preliminar. En la instantánea de la clasificación pública (2026-11-14), Qwen4-Max tiene apenas 1,814 votos y está marcado como Preliminary; la generación anterior, 0902, tiene 23,030 votos, una diferencia de aproximadamente 12 veces. La puntuación de 1750 coincide con lo reportado oficialmente, pero la posición cambiará a medida que se acumulen votos.
P4: ¿Ya se puede invocar qwen4-max a través de APIYI?
Hasta el 2026-11-16 11:00, todavía no: `qwen4-max` aún no está disponible en el catálogo, pero lo pondremos disponible lo antes posible. Por ahora puedes usar `qwen3.8-max`, `qwen3.8-max-0902` y la versión de pesos abiertos `qwen3.8-2.4t-a95b`. Para conocer el modelo más reciente y los precios, consulta la lista de modelos de la plataforma APIYI apiyi.com. Los nuevos usuarios pueden usar la cuota de prueba gratuita para establecer primero una línea base.
P5: Al migrar, ¿basta con cambiar solo el ID del modelo?
No basta. Como mínimo, también hay que establecer explícitamente `reasoning_effort` (el valor predeterminado cambia de xhigh a high), ampliar según sea necesario `max_tokens` y los límites de almacenamiento de los sistemas posteriores, revisar entradas ultralargas cercanas a 1M y volver a evaluar el costo de escritura de caché. En cuanto al protocolo, si usas la interfaz compatible con OpenAI `https://api.apiyi.com/v1`, en el código solo hay que cambiar el campo `model`.
P6: ¿Sigue valiendo la pena usar Qwen3.8-Max?
Sí, vale la pena. Sigue siendo un modelo insignia de nivel 2.4T, con contexto de 1M, salida de 128K, modos con y sin razonamiento, además de una versión de pesos abiertos. Qwen4-Max mejora muy poco en benchmarks como BioMystery y JobBench; para este tipo de negocios, un Qwen3.8-Max que se ejecuta de forma estable puede seguir asumiendo perfectamente el tráfico de producción.
Qwen4-Max vs Qwen3.8-Max: puntos clave
- Misma escala, menos parámetros activos: el backbone de 2.4T no cambia; los parámetros activos por invocación bajan de 95B a 71B, alrededor de un 25% menos.
- Precio unitario un 25% menor: entrada de $2→$1.5, salida de $6→$4.5, la lectura de caché baja cerca del 70% y se añade cobro por escritura en caché.
- Salida casi triplicada: la salida máxima pasa de 128K→393K y la entrada máxima se limita a 991K.
- Las mejoras se concentran en los agentes: AutomationBench, Terminal-Bench y HealthBench suben claramente; BioMystery apenas cambia.
- Dos puntos que no conviene exagerar: una reducción de costes del 62% solo respalda alrededor del 51%; el 6.º puesto en Arena tiene solo 1,814 votos y es Preliminary.
- Migrar no es solo cambiar el ID: ojo con el valor predeterminado de
reasoning_effort, el límite demax_tokensy la estrategia de caché. - Estado actual en APIYI:
qwen4-maxaún no está disponible; sigue usandoqwen3.8-maxy, cuando se publique, cambia de forma gradual.
Resumen
Conclusiones clave de Qwen4-Max frente a Qwen3.8-Max:
- Coste: la bajada del 25% en el precio unitario es una ganancia segura; el ahorro de tokens de entre el 20% y el 30% debe validarse con tus datos reales; del recorte del 62%, unos 11 puntos no tienen un origen claro.
- Capacidades: agentes, llamada a herramientas, salud y gráficos mejoran claramente; algunos benchmarks apenas cambian; todas las puntuaciones son autodeclaradas por el fabricante.
- Migración: el protocolo no cambia, pero sí el nivel de razonamiento predeterminado, el límite de salida y el cobro de caché; conviene revisar cada punto de la lista.
Qwen3.8-Max sigue siendo un modelo de producción fiable; la actualización debería ser una decisión gradual respaldada por datos, no un cambio total en cuanto aparece la nueva versión. Recomendamos crear primero, a través de APIYI apiyi.com, una línea base de coste y calidad con qwen3.8-max; cuando qwen4-max esté disponible, compáralo directamente en la misma interfaz.
📚 Referencias
- Blog oficial de Qwen3.8: notas de lanzamiento de Qwen3.8-Max, con parámetros, contexto y precios oficiales
- Enlace:
qwen.ai/blog?id=qwen3.8 -
Nota: origen de las especificaciones de la generación anterior y de los precios de la región de Singapur
-
Hugging Face – Qwen3.8-2.4T-A95B: versión de pesos abiertos de Qwen3.8
- Enlace:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
Nota: tarjeta del modelo y descarga de pesos cuando se necesita autoalojamiento
-
Blog oficial de Qwen: artículo de lanzamiento de Qwen4-Max y comparación de resultados de benchmark en una misma gráfica
- Enlace:
qwen.ai/blog -
Nota: origen de los cambios de arquitectura, las puntuaciones autodeclaradas por el fabricante y los datos de tokens y coste por tarea
-
arena.ai Code Arena WebDev: tabla de enfrentamientos de modelos de terceros
- Enlace:
arena.ai - Nota: este artículo cita una instantánea del 2026-11-14; las posiciones cambian según el número de votos
Autor: equipo técnico de APIYI
Contacto técnico: puedes ponerte en contacto con nosotros desde la página de inicio del sitio web de APIYI; los modelos y precios se pueden consultar en el centro de documentación docs.apiyi.com


