
작성자 주: 동일하게 2.4T급 플래그십인 Qwen4-Max는 정가가 25% 인하되고, 출력 상한이 약 세 배로 늘어나며, 동일 작업에서 토큰 사용량이 20~30% 줄었습니다. 이 글에서는 아키텍처, 공식 자체 보고 벤치마크, 두 세대의 정가를 분석하고, qwen3.8-max에서 마이그레이션하기 위한 체크리스트를 제시합니다.
2026-11-16, 알리바바가 Qwen4-Max를 발표했습니다. 먼저 결론부터 말하자면, Qwen3.8-Max와 비교해 신세대는 입력·출력 정가가 각각 25% 인하되었고, 최대 출력이 128K에서 393K로 늘어 약 세 배가 되었으며, 공식 Work360 평가에서 동일 작업 토큰 사용량이 20~30% 감소했습니다. 이미 운영 환경에서 qwen3.8-max를 돌리고 있는 팀이라면 이번 업그레이드는 진지하게 검토할 만하지만, 전면 재작성이 필요하지는 않습니다.
이 글은 “신세대가 모든 면에서 압도한다”는 식의 홍보 글이 아닙니다. 아래 벤치마크 점수는 모두 공식 자체 보고로 표기하고, 제3자 리더보드는 공개 리더보드 스냅샷(2026-11-14)으로 표기합니다. 과장되기 쉬운 두 가지 수치, 즉 단일 작업 비용 62% 절감과 Arena 6위는 별도로 나눠서 설명합니다.
핵심 가치: 이 글을 읽고 나면 세 가지를 판단할 수 있습니다. 절감된 비용 중 얼마가 실제인지, 어떤 벤치마크가 뚜렷하게 올랐고 어떤 것이 거의 변동이 없는지, 그리고 마이그레이션할 때 모델 ID 교체 외에 무엇을 손대야 하는지입니다. 참고로 APIYI(apiyi.com)를 통해 호출하신다면 2026-11-16 11:00 기준 플랫폼에 아직 qwen4-max가 등록되지 않았으므로, 현 단계에서는 계속 qwen3.8-max를 사용하시면 됩니다. 이 모델은 최대한 빨리 등록하겠습니다.
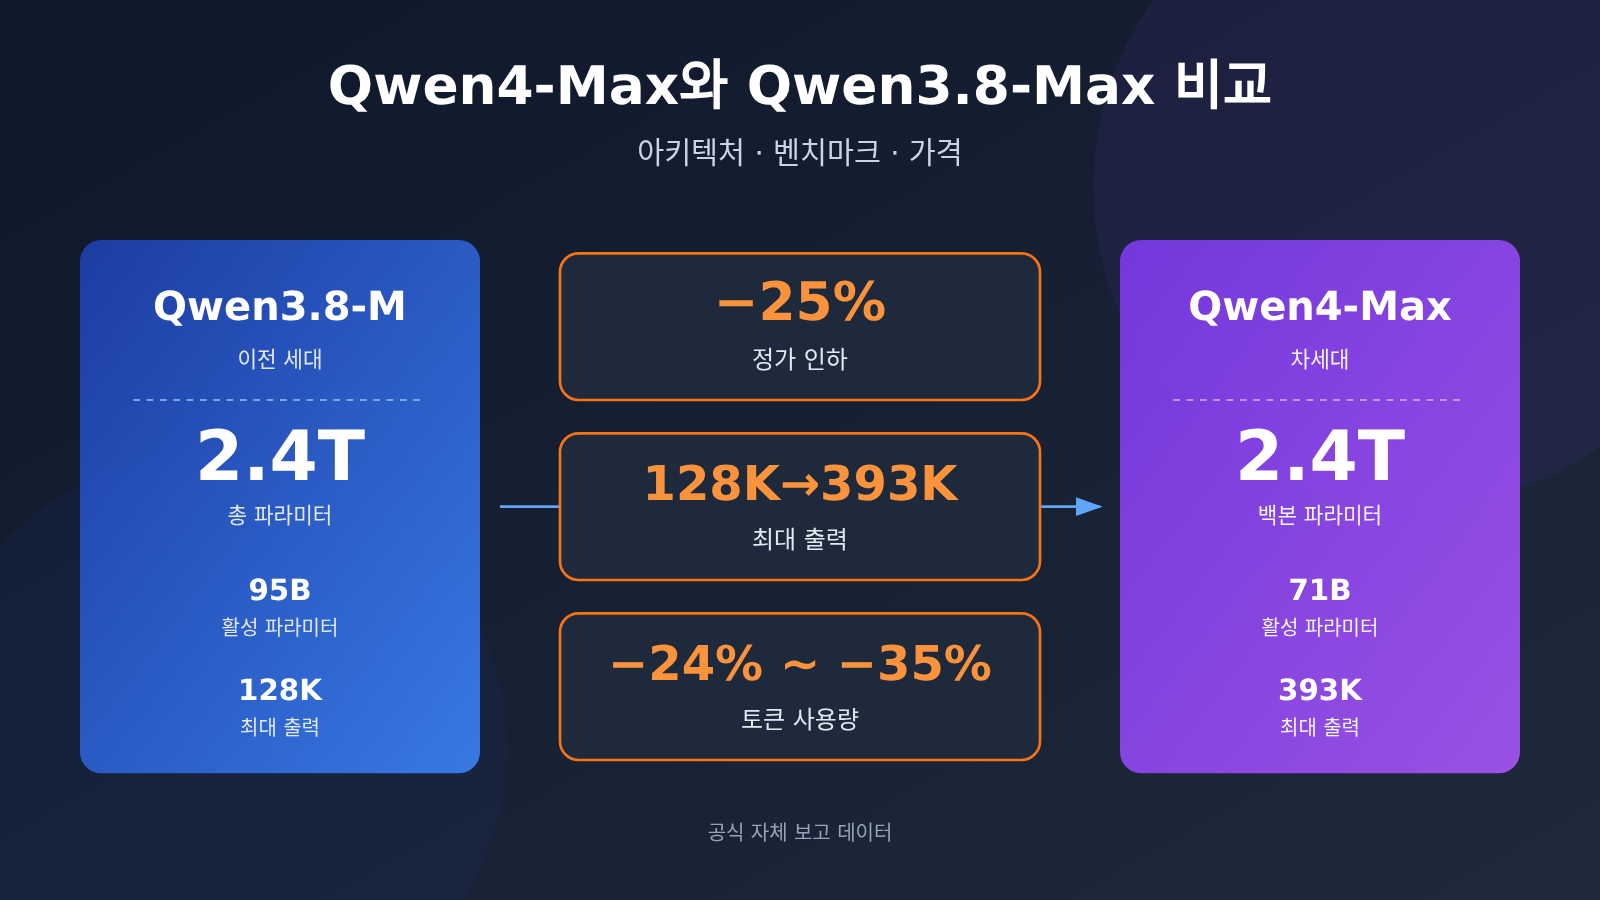
Qwen4-Max와 Qwen3.8-Max 핵심 차이 한눈에 보기
두 세대 모델의 전체 규모는 같은 등급에 있지만, Qwen4-Max는 활성화 파라미터, 출력 상한, 기본 추론 레벨에서 조정이 이루어졌어요. 아래 표에서 먼저 사양 측면의 차이를 모아 두고, 가격은 뒤의 비용 장에서 따로 다룰게요.
| 비교 항목 | Qwen3.8-Max | Qwen4-Max | 변화 |
|---|---|---|---|
| 파라미터 규모 | 2.4T 총 파라미터 | 2.4T 백본 + 328B N-gram 임베딩 | 백본은 같은 등급, 임베딩 테이블 추가 |
| 회당 활성화 | 95B | 71B | 약 25% 감소 |
| 컨텍스트 | 1M | 1M(최대 입력 991K, 사고 모드 983K) | 입력 상한이 다소 축소 |
| 최대 출력 | 128K | 393K | 약 3배 |
| 최대 사고 연쇄 | 공식적으로 별도 표기 없음 | 262K | 명확한 상한 추가 |
| 기본 reasoning_effort | xhigh | high | 기본 레벨 한 단계 하향 |
| 비전 능력 | 이미지 입력 지원 | 네이티브 비전 | 비전이 네이티브 기능이 됨 |
| 공개 가중치 | Qwen3.8-2.4T-A95B | 자료에 언급 없음 | — |
이 표에서 이번 업그레이드의 방향을 볼 수 있어요. 전체 규모는 그대로인데 1회 계산량은 더 적고, 출력 공간은 더 넓어졌다는 거예요. 활성화 파라미터가 95B에서 71B로 줄어든 것은 표시 가격을 낮출 수 있는 근본 전제이고, 최대 출력을 393K로 늘린 것은 긴 보고서나 대량 코드 생성 같은 작업의 실현 가능성을 곧바로 바꿔 놓았어요.
주의할 점은 기본 reasoning_effort가 xhigh에서 high로 바뀌었다는 거예요. 코드에서 이 파라미터를 명시적으로 설정하지 않았다면, 모델 ID를 바꾼 뒤 실제로 실행되는 추론 레벨이 달라질 수 있어요. 이 점은 마이그레이션 체크리스트에서 다시 강조할게요.
Qwen4-Max 아키텍처 변경: 세 가지 변화가 사용에 미치는 영향
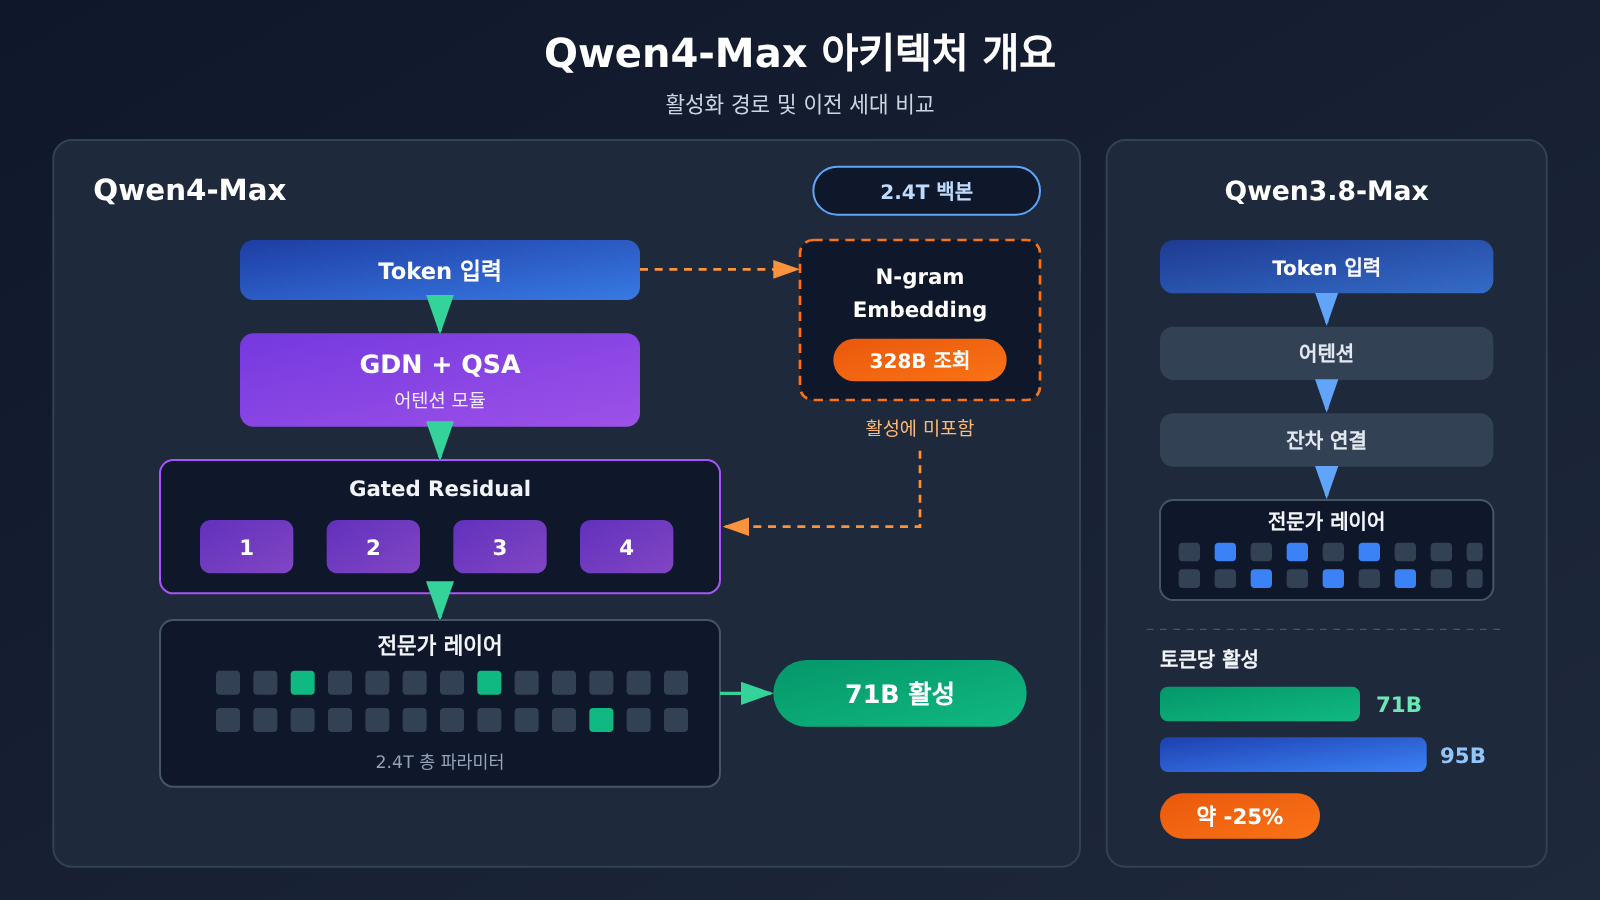
공식 블로그에서는 Qwen4-Max의 아키텍처 변경을 세 가지로 정리했어요. GDN + QSA, Gated Residual의 네 갈래, N-gram Embedding이에요. API 사용자 입장에서는 구현 세부 사항을 하나하나 이해할 필요는 없지만, 이 세 가지 변경이 각각 무엇에 영향을 주는지는 알아 둘 만해요.
GDN + QSA: 어텐션 레이어의 변경
이건 어텐션 구조를 조정한 변화예요. 공식 블로그에서는 이를 1M 컨텍스트 윈도우, 393K 최대 출력과 함께 소개했는데, 저희가 이해하기로는 주로 긴 시퀀스 상황에서의 연산 효율을 겨냥한 변경이에요. 호출하는 쪽에서 바로 체감할 수 있는 결과는 이렇습니다. 같은 1M 컨텍스트 윈도우에서 Qwen4-Max가 더 긴 출력을 내놓을 수 있고, 단가는 오히려 더 낮아졌어요.
Gated Residual의 네 갈래
잔차 연결(residual connection)이 게이트를 갖춘 네 갈래로 확장됐어요. 이런 변경은 보통 학습 안정성과 서로 다른 능력 사이의 정보 흐름에 영향을 주고, 최종적으로는 모델 동작에 드러나요. 실제 영향은 이렇습니다. 프롬프트를 완전히 그대로 두더라도 Qwen4-Max의 출력 스타일이나 추론 단계의 길이가 이전 모델과 달라질 수 있어요. 그래서 Qwen3.8-Max에 맞춰 정교하게 다듬은 프롬프트는 회귀 테스트를 해 볼 필요가 있어요.
N-gram Embedding: 328B 파라미터가 곧 연산량은 아니에요
Qwen4-Max의 파라미터 표기는 “2.4T 백본 / 71B 활성화 + 328B N-gram Embedding”이에요. 일반적인 설계를 보면 이런 임베딩은 테이블 조회형 파라미터라서 토큰마다 계산되는 백본 활성화 연산에는 포함되지 않아요. 따라서 328B를 그대로 활성화량에 더해서 비교할 수는 없어요. 추론 비용과 실제로 관련이 있는 건 71B 대 95B예요. 즉, 매번 활성화되는 양이 약 25% 적다는 뜻이죠.
사전 학습 측면에서 공식 블로그는 Qwen4-Max-Base가 지식, 코드, 질의응답, STEM 네 가지 내부 평가에서 BPB(바이트당 비트 수, 낮을수록 좋음)가 모두 가장 낮았다고 밝혔어요. Qwen3.8-Max-Base보다 약 5–13% 낮은 수준이었죠. 물론 공식 내부 평가이긴 하지만, 적어도 베이스 모델 자체가 개선됐다는 점은 보여 줘요. 이후 벤치마크 점수 향상이 후속 학습(post-training)에만 힘입은 것은 아니라는 뜻이죠.
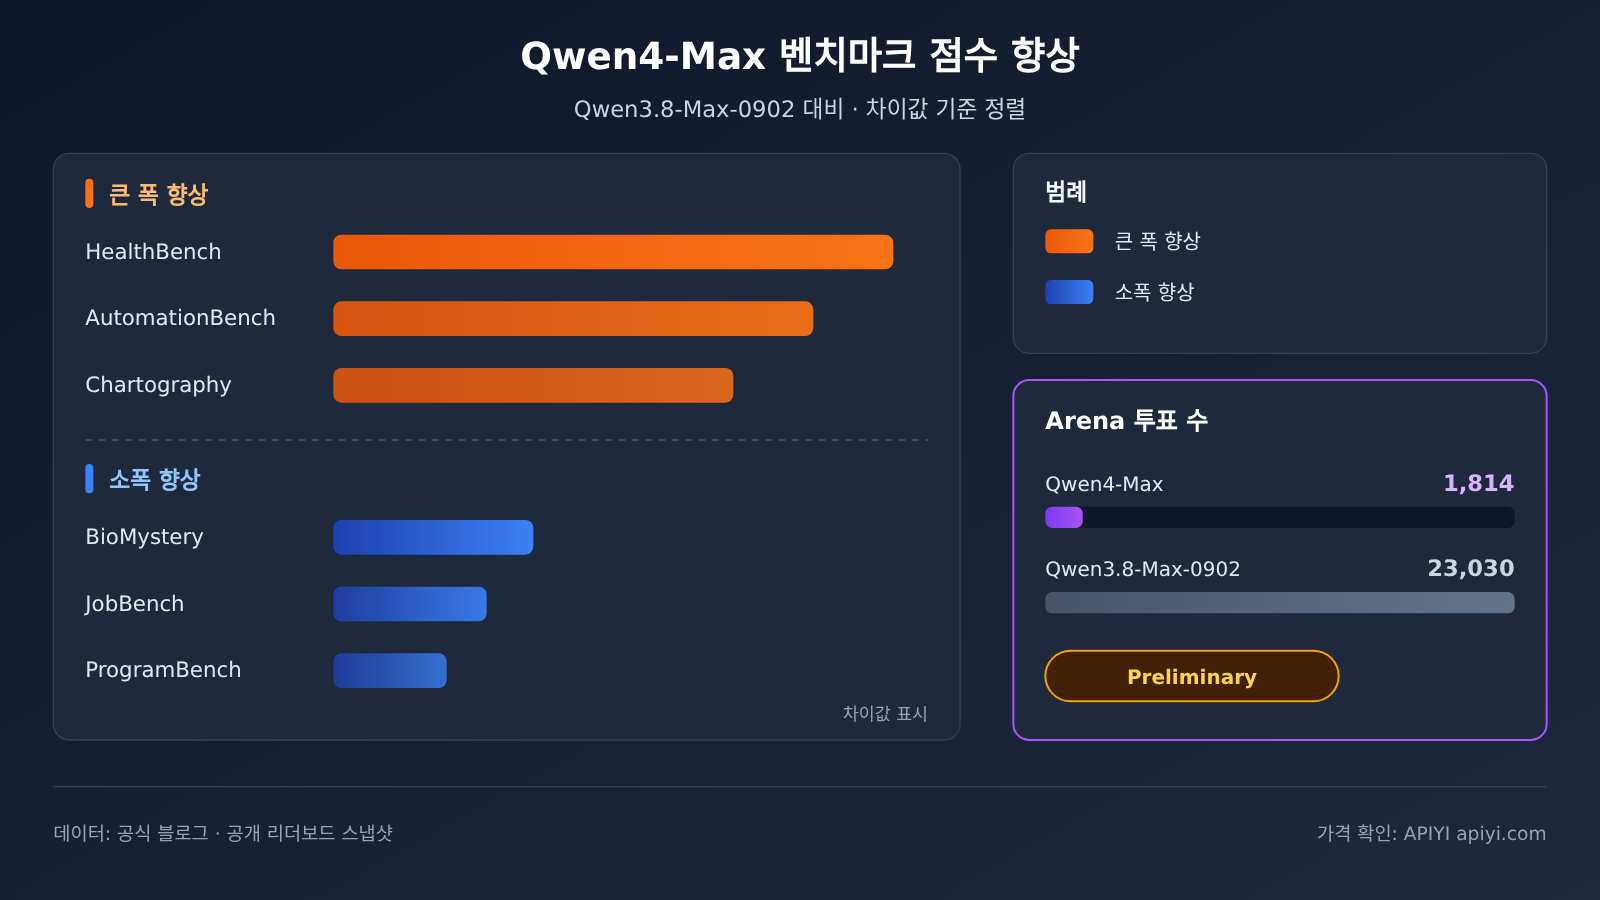
Qwen4-Max 벤치마크 비교: 많이 오른 항목, 거의 그대로인 항목
아래 데이터는 모두 알리의 동일한 비교표에서 가져온 공식 자체 보고 수치이며, 비교 대상은 Qwen3.8-Max-0902(9월 갱신 버전)예요. 향상 폭이 큰 순서대로 정리했으니, 업그레이드 효과가 어디에 집중되는지 한눈에 볼 수 있어요.
| 벤치마크(공식 자체 보고) | Qwen3.8-Max-0902 | Qwen4-Max | 차이 | 향상 폭 판단 |
|---|---|---|---|---|
| AA-Briefcase | 1605 | 1686 | +81 | 뚜렷함 |
| CodeArena | 1676 | 1750 | +74 | 뚜렷함 |
| HealthBench | 39.6 | 60.0 | +20.4 | 매우 뚜렷함 |
| AutomationBench | 56.2 | 72.5 | +16.3 | 매우 뚜렷함 |
| Chartography | 42.0 | 54.2 | +12.2 | 뚜렷함 |
| Terminal-Bench | 38.9 | 48.5 | +9.6 | 뚜렷함 |
| APEX-Agents | 63.3 | 72.1 | +8.8 | 뚜렷함 |
| HLE | 43.9 | 51.7 | +7.8 | 뚜렷함 |
| DeepSWE | 69.3 | 75.7 | +6.4 | 중간 |
| HLAB-Vals | 15.4 | 21.3 | +5.9 | 중간 |
| Video-Index | 63.2 | 68.1 | +4.9 | 중간 |
| ProgramBench | 28.0 | 31.5 | +3.5 | 작음 |
| JobBench | 65.3 | 68.5 | +3.2 | 작음 |
| BioMystery | 84.1 | 85.0 | +0.9 | 거의 변화 없음 |
향상이 가장 집중된 곳은 에이전트와 도구 호출 계열 작업이에요. AutomationBench +16.3, Terminal-Bench +9.6, APEX-Agents +8.8이죠. 여러분의 업무가 다중 턴 도구 호출, 터미널 조작, 자동화 파이프라인이라면 업그레이드 효과가 가장 큰 방향이에요. HealthBench는 39.6에서 60.0으로 올랐고 Chartography는 12.2 올랐으니, 의료 질의응답과 차트 이해도 이번 세대의 핵심 포인트라는 걸 알 수 있어요.
반대편에서는 BioMystery가 0.9밖에 오르지 않았고, JobBench와 ProgramBench는 3점대 초반 상승에 그쳤어요. 이런 작업군에서는 업그레이드의 한계 효용이 제한적이라, 여러분의 주력 시나리오가 여기에 가깝다면 벤치마크 점수만으로 업그레이드를 결정하기 어렵고 비용을 더 따져봐야 해요. 공식이 별도로 제시한 Work360은 52.69 대 47.74로 4.95 높아, 이것도 중간 정도 향상에 속해요.
보안 측면에서 공식은 Last Secure Code Bench의 함수 단위 이중 통과율이 22.0%에서 31.8%로 올랐고, 세 가지 세분화 기준을 동시에 만족하는 비율은 8%에서 14.7%로 올랐다고 밝혔어요. 절대값은 여전히 높지 않아서 생성된 코드에는 보안 검토가 필요하지만, 상대적인 향상은 뚜렷해요.
Arena 서드파티 리더보드: 1,814표의 Preliminary 순위
공식 CodeArena 1750점은 서드파티 arena.ai Code Arena WebDev 리더보드에서도 확인할 수 있어요. 아래는 공개 리더보드 스냅샷, 2026-11-14예요:
- Qwen4-Max(xHigh): 1750점, 6위, Preliminary 표기, 1,814표, 작업당 $4.18
- Qwen3.8-Max(0902): 1676점, 16위, 23,030표, 작업당 $1.91
- Qwen3.8-Max: 1670점, 18위
여기서 두 번째로 과장되기 쉬운 부분은 Qwen4-Max가 1,814표에 불과하다는 점이에요. 이전 세대인 0902 버전은 23,030표로, 약 12배 차이가 나요. Preliminary 표시가 붙어 있다는 건 순위가 아직 수렴 중이라는 뜻이라서 6위는 바뀔 수 있어요. 지금 인용할 때는 “잠정 6위”라고 쓰는 게 좋아요.
스냅샷에서 주목할 만한 디테일이 하나 더 있어요. Qwen4-Max는 xHigh 티어로 참가했고, 작업당 비용이 $4.18로 Qwen3.8-Max 0902의 $1.91보다 높아요. 이는 공식 발표의 “작업당 비용 하락”과 모순되지 않아요. 측정한 티어와 작업 유형이 모두 다르기 때문이죠. 다만 최고 추론 티어에서는 Qwen4-Max가 반드시 더 저렴하지만은 않다는 점을 알려줘요.
Qwen4-Max 가격과 비용: 절약되는 돈 중 얼마가 진짜일까
업그레이드는 결국 모델을 바꾸는 일이에요. 결정하기 전에 먼저 가격을 따져봐야 하죠. 아래 표는 두 세대의 공식 정가와 APIYI에서 현재 판매 중인 qwen3.8-max 가격을 정리한 거예요. 단위는 모두 1M tokens당이며, 기준일은 2026-11-16이에요.
| 과금 항목(1M tokens당) | Qwen3.8-Max 공식(싱가포르 리전) | Qwen4-Max 공식 | Qwen4-Max 공식 위안화 | APIYI qwen3.8-max 현재 가격 |
|---|---|---|---|---|
| 입력 | $2 | $1.5 | ¥10 | $1.65 |
| 출력 | $6 | $4.5 | ¥30 | $4.95 |
| 캐시 읽기 | $0.25 | $0.075 | ¥0.5 | $0.20625 |
| 캐시 쓰기(5분) | 공식 블로그 미기재 | $1.875 | ¥12.5 | 문서에 별도 기재 없음 |
| 캐시 쓰기(1시간) | 공식 블로그 미기재 | $3 | ¥20 | 문서에 별도 기재 없음 |
입력과 출력은 각각 25% 인하됐고, 캐시 읽기는 $0.25에서 $0.075로 약 70% 떨어졌어요. 이번 가격 조정에서 가장 큰 인하 폭이에요. 한편 Qwen4-Max는 5분과 1시간 두 가지 캐시 쓰기 가격을 명시했기 때문에, 긴 프리픽스를 자주 재사용하는 애플리케이션은 이 쓰기 비용을 예산에 반드시 포함해야 해요.
토큰 절감: 20~30%는 Work360, 40~50%는 Terminal-Bench로 판단하세요
공식적으로 제시된 토큰 절감 수치는 두 그룹입니다. Work360에서는 Xhigh 등급이 24% 적고, High 등급이 35% 적습니다. 이것이 “20~30% 절감”이라는 수치의 출처입니다. Terminal-Bench 4.0에서는 더 극적이어서 각각 48%와 49%가 적습니다.
터미널 유형 작업의 절감 폭이 확실히 더 큰데, 이런 작업에서 도구 호출 라운드가 줄어든 것과 관련이 있을 수 있습니다. 예산을 잡을 때는 일반 사무 작업 기준으로는 20~30%로 추정하는 것이 더 안정적이고, 40~50%는 Terminal-Bench와 유사한 터미널 조작 시나리오에만 적용됩니다.
62%와 51%가 맞지 않는 그 11포인트
이것이 첫 번째로 쉽게 과장되기 쉬운 부분입니다. 공식 발표는 단일 작업 비용이 $4.43에서 $1.67로 내려갔다고 하는데, 달러 기준으로 약 62% 감소입니다. 중국어 표기로는 ¥26.58에서 ¥11.16으로 내려가 약 58% 감소로 적혀 있어서, 두 가지 기준 자체가 차이가 있습니다.
공식 데이터 자체로 계산해보면: 토큰이 35% 적고 단가가 25% 내려가면, 두 값을 곱하면 약 51% 감소에 불과합니다. 즉 0.65 × 0.75 ≈ 0.49입니다. 남은 약 11포인트는 공식 문서에서 설명하지 않습니다. 우리는 캐시 읽기 가격의 대폭 인하(약 −70%)에서 오는 캐시 히트 이익과, 도구 호출 라운드 감소에서 기인했을 것이라 추정하지만, 이는 추정일 뿐 공식 설명이 아닙니다.
안정적인 접근은 51%를 “동일한 캐시 히트율 기준”의 참고 상한으로 보고, 62%는 캐시 히트율이 높고 도구 라운드가 많은 시나리오에서만 근접할 수 있다고 보는 것입니다. 구체적인 비즈니스에 적용하려면, 가장 신뢰할 수 있는 근거는 실제 트래픽으로 단일 작업 비용을 비교해보는 것입니다.
APIYI 현재 가격과 판매 상태
APIYI는 현재 qwen3.8-max를 판매 중이며, 입력 $1.65, 출력 $4.95, 캐시 읽기 $0.20625입니다. 문서 기준으로 알리바바 클라우드의 $2 / $6보다 17.5% 낮은 수준이에요. 같은 가격대에는 qwen3.8-max-0902도 있고, 개방 가중치 버전인 qwen3.8-2.4t-a95b는 $1.72 / $5.16 / $0.215입니다.
2026-11-16 11:00에 재확인한 결과, qwen4-max는 APIYI 모델 문서와 가격 목록(총 284개 모델) 어디에도 아직 없어서, 아직 판매되지 않고 있어요. 이 모델은 최대한 빨리 판매를 시작할 예정이며, 모델명과 가격은 APIYI apiyi.com 플랫폼의 모델 목록을 기준으로 합니다. 솔직히 말하면, Qwen4-Max의 공식 책정 단가가 이미 현재 qwen3.8-max의 플랫폼 가격보다 낮아서, 판매가 시작되면 다시 한번 가격을 대조해볼 만해요.
Qwen3.8-Max에서 Qwen4-Max로 마이그레이션: 체크리스트
많은 분들이 업그레이드를 모델 ID 하나 바꾸는 일로 생각하지만, 실제로는 기본 파라미터, 컨텍스트 경계, 캐시 과금 방식이 모두 바뀌어요. 아래 체크리스트는 “바꾸지 않으면 문제가 생길 수 있는” 순서, 즉 우선순위대로 정리했어요.
| 점검 항목 | Qwen3.8-Max 현황 | Qwen4-Max로 마이그레이션 후 | 권장 조치 |
|---|---|---|---|
| 모델 ID | qwen3.8-max / qwen3.8-max-0902 |
플랫폼 모델 목록 기준 | 출시 후 전환, 우선 카나리 배포 |
| reasoning_effort 기본값 | xhigh | high | 등급을 명시적으로 지정해 동작이 조용히 바뀌는 것 방지 |
| max_tokens 상한 | 128K | 393K | 다운스트림 잘림, 저장, 타임아웃 설정 점검 |
| 최대 입력 | 1M | 991K(사고 모드 983K) | 1M에 근접한 초장문 입력은 잘라내기 필요 |
| 캐시 과금 | 캐시 읽기 $0.25 | 캐시 읽기 $0.075, 5분/1시간 쓰기 요금 별도 | 캐시 프리픽스와 TTL 전략 재평가 |
| 비전 입력 | 이미지 입력 | 네이티브 비전 | 이미지 관련 유스케이스 재회귀 테스트 |
| 프롬프트와 출력 형식 | 이전 세대에 맞춰 튜닝됨 | 아키텍처 변경, 동작이 다를 수 있음 | 고정 평가 세트로 회귀 테스트 |
| 비용 모니터링 | 토큰 기준 과금 | 토큰과 단가가 동시에 하락 | 단가 대신 작업당 비용 기준으로 전환 |
체크리스트에서 가장 많이 간과되는 항목은 reasoning_effort예요. Qwen3.8-Max의 기본값은 xhigh이고 Qwen4-Max의 기본값은 high라서, 코드에 명시적으로 설정하지 않으면 전환 후 토큰을 더 아낄 수도 있고, 복잡한 추론 작업에서는 기대만큼 성능이 나오지 않을 수도 있어요. 공식 토큰 절감 데이터가 Xhigh와 High 두 등급을 모두 제시하니, 두 등급으로 각각 테스트해본 뒤 온라인에 어느 등급을 쓸지 결정하는 걸 권장해요.
두 번째는 출력 길이예요. 393K 상한이라는 건 단일 응답이 예전보다 훨씬 길어질 수 있다는 뜻이라서, 로그 시스템, 데이터베이스 필드, 게이트웨이 타임아웃이 128K 출력 기준으로 설계되어 있다면 미리 여유를 넓혀야 해요. 최대 입력은 1M에서 991K로(사고 모드는 983K로) 좁혀졌는데, 평소에 한도를 꽉 채우지 않는 업무라면 영향이 크지 않지만, 한도에 딱 맞춰 문서를 밀어넣는 시나리오에서는 바로 오류가 나요.
APIYI를 통해 호출하는 현시점 방법
지금 APIYI로 연동하고 있다면 base_url은 https://api.apiyi.com/v1이고, OpenAI 호환 프로토콜을 쓰니까 모델 필드에 qwen3.8-max를 넣으면 그대로 프로덕션에서 계속 돌릴 수 있어요. 9월 갱신 버전의 동작을 고정하고 싶다면 qwen3.8-max-0902로 바꿔도 되고, 가격은 같아요.
qwen4-max가 플랫폼에 출시되고 나면 프로토콜은 그대로이기 때문에 코드 레벨에서는 model 필드만 바꾸고, 위 체크리스트에 따라 reasoning_effort와 max_tokens를 채워 넣으면 돼요. 먼저 트래픽의 5%–10%로 카나리 배포를 하고, 작업당 비용과 비즈니스 지표를 비교한 뒤에 전체로 확대하는 걸 권장해요.
🚀 마이그레이션 제안: 지금 APIYI apiyi.com으로 운영 중인 프로젝트는 계속
qwen3.8-max를 쓰면서 평가 세트와 카나리 스위치를 준비해두고,qwen4-max가 출시된 뒤에 ID를 바꾸세요. 이렇게 하면 “새 모델을 기다리다” 비즈니스 공백이 생기는 일을 피할 수 있어요.
Qwen4-Max와 Qwen3.8-Max, 어떤 상황에 추천할까요
Qwen4-Max로의 업그레이드를 먼저 검토할 만한 상황
- 다중 턴 도구 호출과 자동화: AutomationBench, Terminal-Bench, APEX-Agents 모두에서 뚜렷한 향상이 있었고, 터미널 계열 작업에서 토큰 절감 효과도 가장 컸어요.
- 초장문 출력 작업: 한 번에 128K를 넘는 보고서, 코드, 문서를 생성해야 한다면 393K를 지원하는 Qwen4-Max만이 답이에요.
- 의료 질의응답과 차트 이해: HealthBench +20.4, Chartography +12.2로, 이번 세대에서 가장 눈에 띄게 좋아진 분야예요.
- 코드 보안이 중요한 경우: 보안 이중 통과율이 22.0%에서 31.8%로 올랐지만, 여전히 리뷰 프로세스와 함께 쓰셔야 해요.
- 캐시 재사용률이 높은 애플리케이션: 캐시 읽기 가격이 약 70% 내렸기 때문에, 시스템 프롬프트가 길거나 고정된 지식베이스 프리픽스를 쓰는 시나리오에서 가장 이득이 커요.
Qwen3.8-Max를 계속 쓰는 게 나은 상황
- 이미 안정적으로 운영 중이고 프롬프트를 깊게 튜닝해 둔 경우: Qwen3.8-Max는 여전히 믿을 만한 프로덕션 모델이에요. 업그레이드를 위한 업그레이드는 하지 않아도 돼요.
- 주력 작업이 BioMystery, JobBench와 비슷한 경우: 이 방향은 향상 폭이 제한적이라, 마이그레이션 비용이 이득보다 클 수 있어요.
- 오픈 웨이트로 직접 배포해야 하는 경우: Qwen3.8-2.4T-A95B는 오픈 웨이트를 제공하지만, 자료에는 Qwen4-Max의 오픈 웨이트 버전이 언급되지 않았어요.
- APIYI를 통해 호출하면서 바로 써야 하는 경우:
qwen4-max가 아직 출시되지 않은 시점에서는qwen3.8-max가 바로 쓸 수 있는 선택이에요.
| 상황 | 권장 |
|---|---|
| 에이전트, 도구 호출이 중심이고 비용 절감을 노린다 | Qwen4-Max를 우선 검토하고, High 등급 기준으로 실제 비용을 측정 |
| 한 번에 128K를 넘는 출력이 필요하다 | Qwen4-Max만 선택 가능 |
| 이미 안정적이고 주로 범용 질의응답을 한다 | Qwen3.8-Max를 유지하고, 한가할 때 회귀 평가 진행 |
| 오픈 웨이트로 직접 배포해야 한다 | Qwen3.8-2.4T-A95B를 계속 사용 |
| 현재 APIYI로 접속 중이다 | qwen3.8-max를 계속 쓰고, 출시 후 카나리 방식으로 전환 |
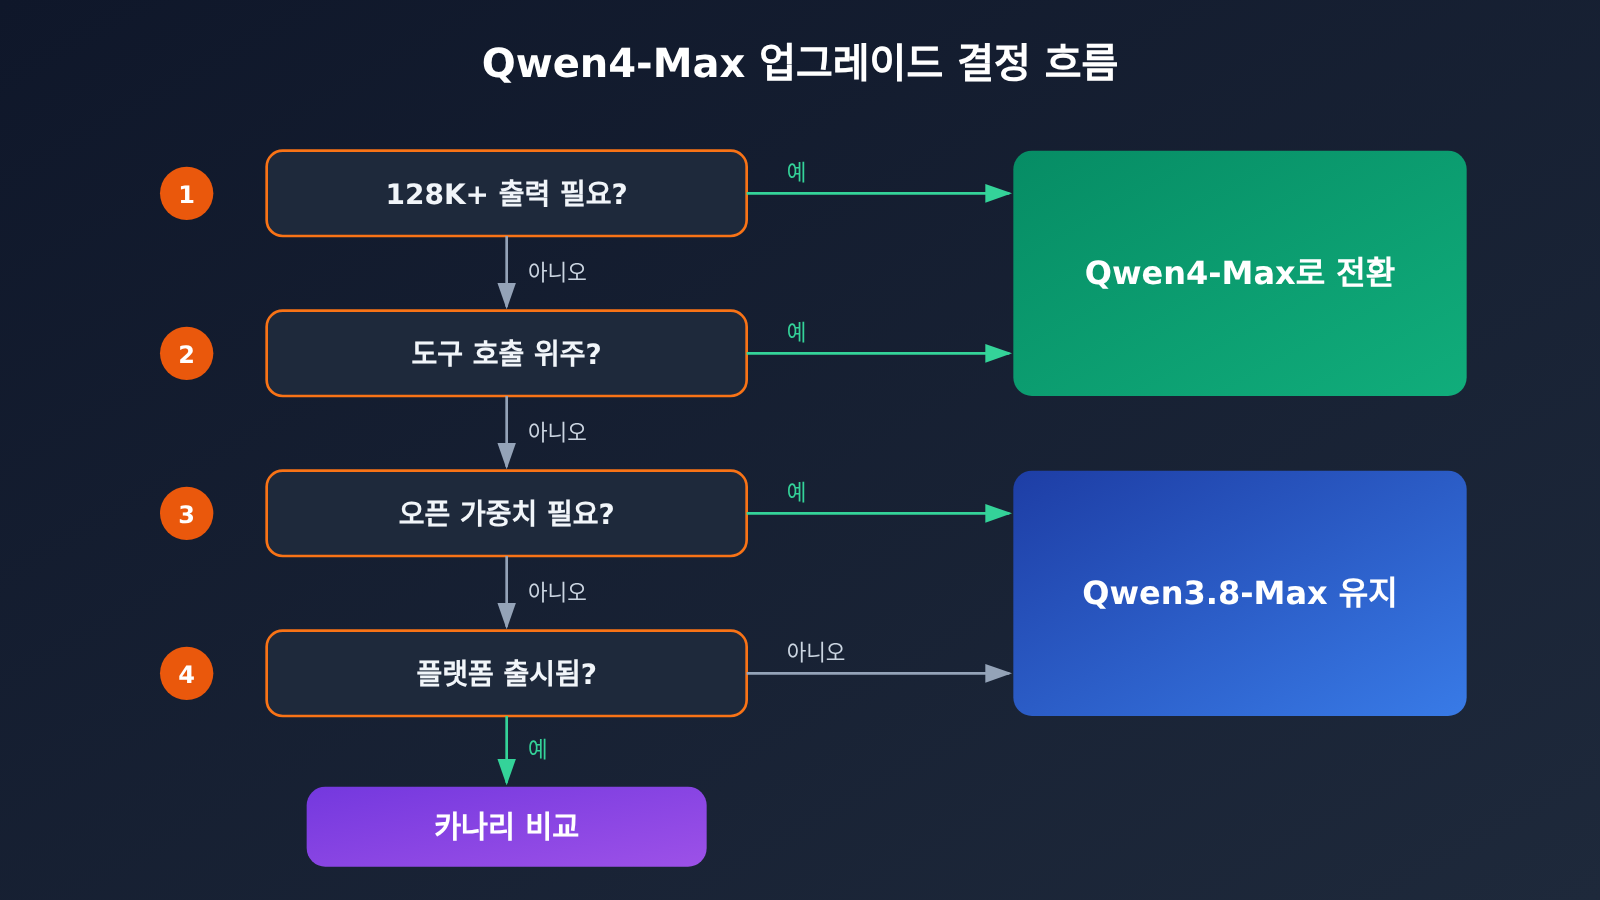
Qwen4-Max와 Qwen3.8-Max, 업그레이드 판단 가이드
한 문장으로만 정리하면 이래요. 에이전트, 긴 출력, 캐시를 많이 쓰는 업무라면 업그레이드할 만하고, 범용적이고 안정적인 업무라면 서두를 필요는 없어요. 업그레이드로 얻는 세 가지 이익 가운데 단가 25% 인하는 확정된 사실이고, 토큰 20~30% 절감은 공식이 특정 평가에서 얻은 수치예요. 작업당 62% 감소라는 숫자는 여러분 쪽의 캐시 조건과 도구 호출 횟수가 받쳐줘야 그 근처까지 갈 수 있어요.
💡 선택 가이드: 결정하기 전에 실제 업무로 각각 한 세트씩 돌려보고, 벤치마크 점수표만 보지 말고 작업당 비용과 결과 품질을 비교해 보시길 권해요. APIYI(apiyi.com)에서는 같은 API 키로
qwen3.8-max기준선을 먼저 돌려볼 수 있고,qwen4-max가 출시된 뒤에는 같은 코드 안에서 바로 비교할 수 있어요.
자주 묻는 질문(FAQ)
Q1: Qwen4-Max와 Qwen3.8-Max는 어떤 관계인가요?
둘 다 Qwen의 2.4T급 플래그십 모델이에요. Qwen3.8-Max는 2026-08-03에 공개됐고, 0902는 9월 리프레시 버전이에요. Qwen4-Max는 2026-11-16에 공개됐는데, 아키텍처를 바꿔서 호출 때마다 활성화되는 파라미터가 95B에서 71B로 줄었고, 출력 상한은 393K로 올라갔으며, 정가는 25% 내려갔어요.
Q2: 토큰이 20~30% 절약되면 청구서도 20~30% 내려가나요?
그 이상일 수도 있고, 꼭 그렇지도 않아요. 단가 자체가 25% 내려간 데다 토큰 감소까지 겹치면 이론상 같은 작업의 비용은 약 51%까지 내려갈 수 있어요. 다만 토큰 절감 수치는 공식 Work360 평가에서 나온 값이라, 여러분 업무에서 얼마나 줄어들지는 직접 측정해 봐야 해요. xhigh 단계를 쓰면 Arena 스냅샷에서 보듯 작업당 비용이 오히려 더 높아질 수도 있고요.
Q3: Qwen4-Max가 Arena에서 6위인데, 이 순위를 믿어도 될까요?
아직은 초기 결과로 봐야 해요. 공개 리더보드 스냅샷(2026-11-14)에서 Qwen4-Max는 1,814표에 그쳤고 Preliminary 표시가 붙어 있어요. 반면 이전 세대인 0902는 23,030표로, 약 12배 차이예요. 점수 1750은 공식 자체 발표와 일치하지만, 순위는 표가 더 쌓이면 달라질 수 있어요.
Q4: 지금 APIYI로 qwen4-max를 호출할 수 있나요?
2026-11-16 11:00 기준으로 아직 안 돼요. `qwen4-max`는 아직 등록되지 않았고, 최대한 빨리 등록할 예정이에요. 현재는 `qwen3.8-max`, `qwen3.8-max-0902`, 그리고 오픈 가중치 버전인 `qwen3.8-2.4t-a95b`를 쓸 수 있어요. 최신 모델과 가격은 APIYI(apiyi.com) 플랫폼의 모델 목록을 기준으로 확인하시고, 신규 사용자는 무료 테스트 크레딧으로 기준선을 먼저 돌려볼 수 있어요.
Q5: 마이그레이션할 때 모델 ID만 바꾸면 충분할까요?
충분하지 않아요. 최소한 `reasoning_effort`를 명시적으로 설정해야 하고(기본값이 xhigh에서 high로 바뀌었어요), 필요에 따라 `max_tokens`와 다운스트림 저장 제한을 넉넉하게 풀어야 해요. 1M에 가까운 초장문 입력도 점검하고, 캐시 쓰기 비용도 다시 따져 봐야 하고요. 프로토콜 측면에서는 OpenAI 호환 인터페이스 `https://api.apiyi.com/v1`를 쓴다면 코드에서 `model` 필드만 바꾸면 돼요.
Q6: Qwen3.8-Max를 계속 써도 괜찮을까요?
괜찮아요. 여전히 2.4T급 플래그십이고, 1M 컨텍스트, 128K 출력, 사고 모드와 비사고 모드를 모두 갖추고 있으며 오픈 가중치 버전도 있어요. Qwen4-Max는 BioMystery, JobBench 같은 벤치마크에서 향상 폭이 아주 작아서, 이런 업무라면 안정적으로 돌아가는 Qwen3.8-Max가 계속 프로덕션 트래픽을 맡아도 충분해요.
Qwen4-Max vs Qwen3.8-Max 핵심 포인트 Key Takeaways
- 규모는 동급, 활성화 파라미터는 더 적어요: 2.4T 백본은 그대로인데, 호출 시 활성화되는 파라미터가 95B에서 71B로 줄어 약 25% 감소했어요.
- 단가 25% 인하: 입력 $2→$1.5, 출력 $6→$4.5, 캐시 읽기는 약 70% 인하됐고, 캐시 쓰기 과금이 새로 추가됐어요.
- 출력은 약 3배: 최대 출력이 128K→393K로 늘었고, 최대 입력은 991K로 오히려 축소됐어요.
- 상승 폭은 에이전트에 집중: AutomationBench, Terminal-Bench, HealthBench는 향상이 뚜렷한 반면 BioMystery는 거의 변동이 없어요.
- 과장하면 안 되는 두 가지: 62% 비용 절감 폭으로는 약 51%만 설명할 수 있고, Arena 6위는 단 1,814표에 Preliminary 상태예요.
- 이전은 ID 교체만으로 끝나지 않아요: reasoning_effort 기본값, max_tokens 상한, 캐시 전략을 주의하세요.
- APIYI 현황:
qwen4-max는 아직 출시되지 않았으니 계속qwen3.8-max를 쓰고, 출시된 뒤 점진적으로(카나리 방식으로) 전환하세요.
정리
Qwen4-Max와 Qwen3.8-Max를 비교한 핵심 결론은 이래요:
- 비용: 단가 25% 인하는 확정적인 이득이에요. 토큰 절감 20~30%는 여러분 업무에서 직접 측정한 값을 기준으로 삼아야 하고, 62%라는 절감 폭 가운데 약 11%포인트는 출처가 불분명해요.
- 성능: 에이전트, 도구 호출, 의료, 차트 영역의 향상이 뚜렷하고 일부 벤치마크는 거의 같은 수준이에요. 점수는 모두 공식 자체 보고 값이에요.
- 이전: 프로토콜은 그대로지만 기본 추론 단계, 출력 상한, 캐시 과금이 모두 바뀌었으니 체크리스트대로 항목별로 확인해야 해요.
Qwen3.8-Max는 여전히 신뢰할 수 있는 프로덕션 모델이에요. 업그레이드는 새 버전이 나왔다고 바로 전면 전환하는 게 아니라, 데이터에 근거한 점진적 의사결정이어야 해요. 먼저 APIYI apiyi.com에서 qwen3.8-max로 비용과 품질 기준선을 만들어 두고, qwen4-max가 출시되면 같은 인터페이스에서 직접 비교해 보시길 권해요.
📚 참고 자료
- Qwen3.8 공식 블로그: Qwen3.8-Max 출시 안내로, 파라미터·컨텍스트·공식 가격 정보를 담고 있어요
- 링크:
qwen.ai/blog?id=qwen3.8 -
설명: 이전 세대 사양과 싱가포르 리전 가격의 출처
-
Hugging Face – Qwen3.8-2.4T-A95B: Qwen3.8 오픈 웨이트 버전
- 링크:
huggingface.co/Qwen/Qwen3.8-2.4T-A95B -
설명: 직접 배포할 때 필요한 모델 카드와 웨이트 다운로드
-
Qwen 공식 블로그: Qwen4-Max 출시 글과 동일 도표 기준 벤치마크 비교
- 링크:
qwen.ai/blog -
설명: 아키텍처 변경 사항, 공식 자체 보고 벤치마크, 토큰 및 단일 작업 비용 데이터의 출처
-
arena.ai Code Arena WebDev: 서드파티 모델 대전 리더보드
- 링크:
arena.ai - 설명: 본문은 2026-11-14 스냅샷을 인용했으며, 순위는 투표 수에 따라 달라져요
작성자: APIYI 기술팀
기술 문의: APIYI 웹사이트 첫 화면에서 문의해 주세요. 모델과 가격은 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


