
Note de l’auteur : les poids open source de 文心5.5 Flash Base sont désormais disponibles au téléchargement. Cet article examine quatre aspects — les paramètres de l’architecture, les exigences matérielles, les usages et les coûts — pour vous aider à choisir entre déployer vous-même le modèle de base et appeler une API à la demande.
Le 5 novembre 2026, Baidu a officiellement lancé et publié en open source 文心5.5 Flash Base(ERNIE-5.5-Flash-Base). Ce modèle de base MoE parcimonieux compte 280B de paramètres au total, dont 14B sont activés pour chaque token. Il atteint l’état de l’art (SOTA) parmi les modèles de taille comparable sur plusieurs benchmarks. Ses poids sont disponibles sur Hugging Face en versions FP8 et BF16, et un plugin vLLM ainsi qu’un Cookbook SGLang ont également été publiés : cette fois, Baidu ne s’est pas contenté de publier un article sans les poids.
Il ne s’agit pas d’un énième résumé de benchmarks. Beaucoup d’équipes voient « open source + SOTA » et s’apprêtent à télécharger les poids pour une mise en production, en oubliant un point essentiel : il s’agit d’un modèle de base qui n’a subi ni entraînement intermédiaire ni post-entraînement. Il constitue un excellent point de départ pour l’entraînement, mais ne peut pas être utilisé directement comme chatbot.
L’essentiel : à la fin de cet article, vous saurez à quels usages 文心5.5 Flash Base convient, quelle quantité de mémoire GPU prévoir pour le déployer vous-même et dans quelles conditions l’appel à une API à la demande est plus rentable.
Les points clés de 文心5.5 Flash Base
Voici les informations essentielles sur ce modèle. Elles aideront à déterminer s’il vaut mieux le déployer ou l’utiliser via une API.
| Point clé | Description | Impact sur le choix |
|---|---|---|
| Positionnement du modèle | Checkpoint issu du préentraînement, sans entraînement intermédiaire ni post-entraînement | Ne permet pas de dialoguer directement ; adapté à la poursuite de l’entraînement |
| Taille du modèle | 280B de paramètres au total, dont 14B activés par token | Calcul d’inférence réduit, mais mémoire GPU nécessaire pour les poids calculée sur 280B |
| Contexte | Contexte d’entraînement de 128K ; jusqu’à 1M tokens pour le fine-tuning et l’inférence | Adapté aux documents longs et à l’adaptation à des domaines comme le code à l’échelle d’un dépôt |
| Format des poids | FP8 et BF16 disponibles sur Hugging Face | FP8 réduit considérablement les exigences de déploiement |
| Prise en charge par l’écosystème | Plugin vLLM, Cookbook SGLang | Intégration directe aux principaux frameworks d’inférence |
Que signifie « Base » dans 文心5.5 Flash Base ?
Un modèle Base a uniquement appris à « prédire le prochain token », pas à « comprendre une instruction et y répondre ». Si vous lui posez une question, il risque de générer d’autres questions à la suite plutôt que de fournir une réponse. Baidu est d’ailleurs clair sur ce point : les développeurs peuvent partir de cette base commune pour poursuivre l’adaptation à un domaine, le fine-tuning sur instructions, le renforcement des capacités de raisonnement et l’entraînement d’agents.
Le premier critère de décision est donc simple : si votre objectif est d’« utiliser un modèle », Base n’est pas ce qu’il vous faut ; si vous cherchez à « entraîner un modèle », c’est un bon point de départ. Baidu a également indiqué que la version finale de 文心5.5 Flash sortira prochainement. Les équipes qui souhaitent l’utiliser directement pour dialoguer peuvent attendre cette version.
Les concurrents de taille comparable à 文心5.5 Flash Base
Dans les évaluations publiées par Baidu, les modèles comparés comprennent DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) et MiMo-V2.5-Base (310B-A15B). 文心5.5 Flash Base se distingue sur les tâches de raisonnement, de code, les compétences disciplinaires et les tâches à contexte long. Pour les équipes qui souhaitent réaliser un fine-tuning destiné aux agents de code ou à la compréhension de documents longs, ce modèle mérite de figurer parmi les candidats.
Comment fonctionne Wenxin 5.5 Flash Base : trois optimisations pour plus d’efficacité
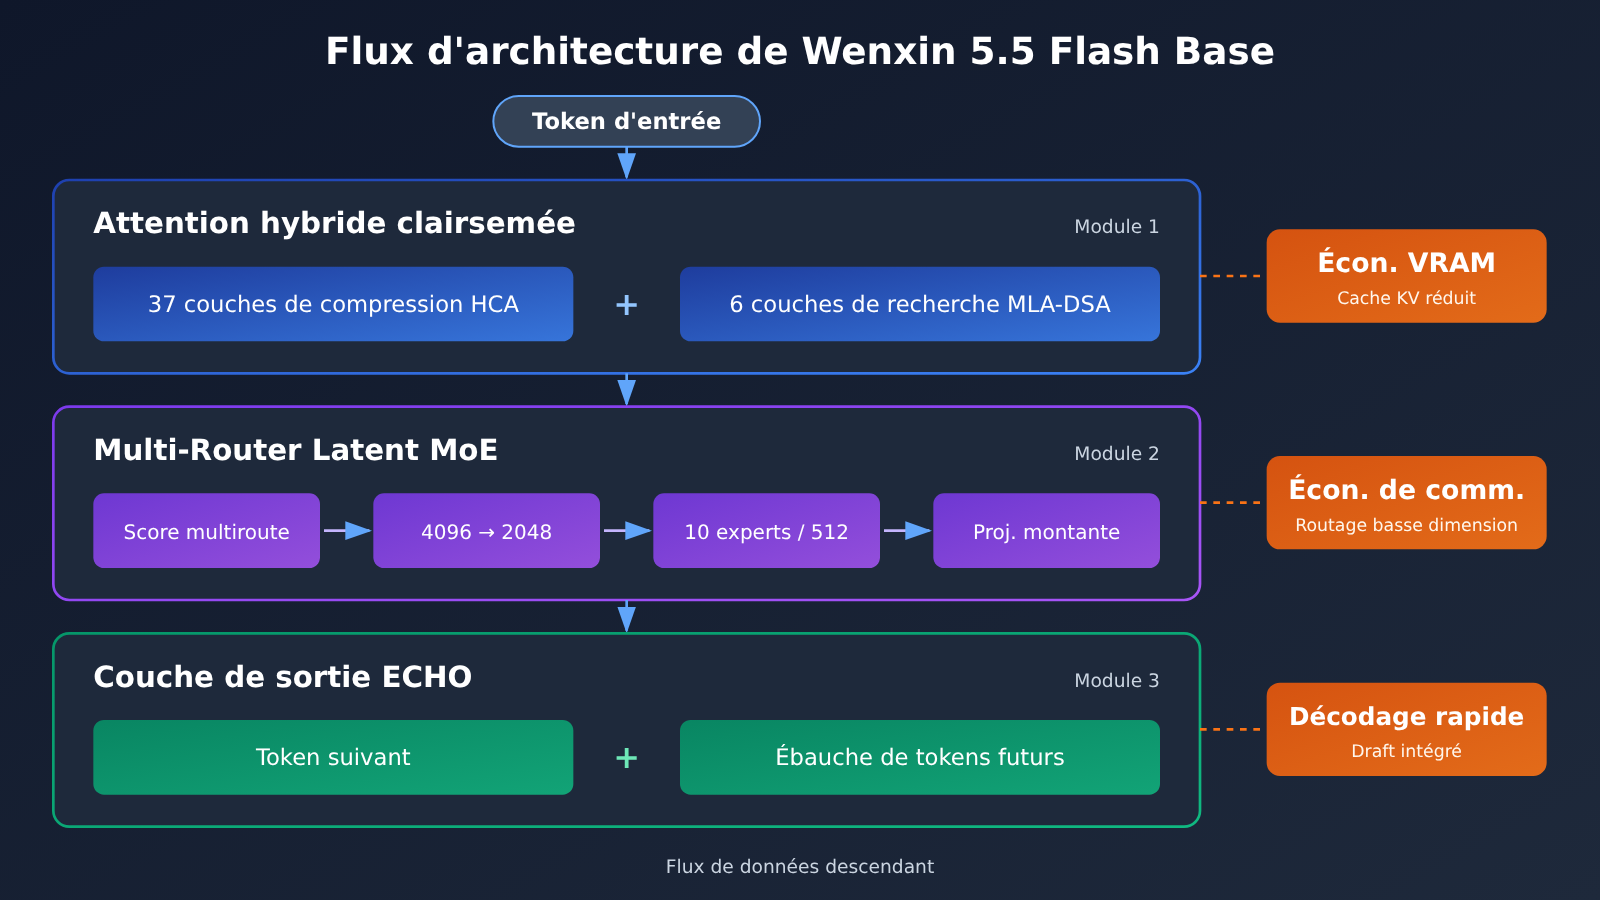
Comprendre son architecture aide à estimer les coûts de déploiement. L’équipe Wenxin a fait de l’efficacité un critère de conception dès le préentraînement, en concentrant ses optimisations sur trois aspects : l’attention, le routage des experts et la prédiction des tokens futurs.
| Module | Conception | Avantage au déploiement |
|---|---|---|
| Attention creuse hybride | 37 des 43 couches utilisent HCA (compression de chaque groupe de 128 tokens en une entrée de cache), et 6 couches utilisent MLA + la recherche creuse DSA | KV Cache nettement réduit, donc moins de mémoire GPU nécessaire pour les longs contextes |
| Multi-Router Latent MoE | Plusieurs routeurs Sigmoid calculent les scores ensemble ; 10 experts sont sélectionnés parmi 512 experts routés, en plus d’un expert partagé ; les experts effectuent leurs calculs dans un espace latent à 2048 dimensions | Les FLOPs des experts et le volume de communication lié à la distribution sont réduits d’environ moitié |
| ECHO | Réutilise la dernière couche du réseau principal pour prédire les tokens futurs | Peut servir directement de modèle draft intégré pour le décodage spéculatif, sans ajouter de paramètres |
| Conception complémentaire | Tête de sortie MultiMax et tokeniseur R2L avec un vocabulaire d’environ 200 000 entrées | Traitement plus fiable des nombres et des calculs arithmétiques |
Pourquoi le KV Cache de Wenxin 5.5 Flash Base est-il moins gourmand ?
Dans un modèle traditionnel, chaque couche doit conserver un KV Cache complet : plus le contexte s’allonge, plus la mémoire GPU est sollicitée. Wenxin 5.5 Flash Base permet à 37 couches de ne consulter qu’un « résumé » compressé ; seules 6 couches accèdent à l’historique token par token. Ces 6 couches utilisent ensuite un Indexer léger pour sélectionner les positions Top-K et effectuer des calculs plus précis. Résultat : avec un contexte de 128K ou plus, le KV Cache occupe bien moins de mémoire que dans un modèle à attention complète de taille comparable. Pour les équipes qui hébergent elles-mêmes le modèle, l’économie de mémoire GPU est réelle.
Ce qu’ECHO apporte à l’accélération de l’inférence
Pendant le préentraînement, ECHO ne prédit qu’un token supplémentaire. Mais lorsqu’il sert de modèle draft, il peut proposer plusieurs tokens successifs, avec un taux d’acceptation supérieur à celui d’un module MTP externe entraîné de la même façon. En auto-hébergement, si le framework d’inférence prend en charge ce mode de décodage spéculatif, le débit peut augmenter sensiblement. C’est aussi un avantage des poids open source par rapport à une API : vous gardez le contrôle sur ce type d’optimisation de l’inférence.
Prise en main de Wenxin 5.5 Flash Base : déploiement autonome
Si vous avez décidé d’entraîner ce modèle de base ou de l’utiliser pour l’inférence en environnement privé, voici le chemin le plus direct. Pas de code dans cet article : les paramètres essentiels sont expliqués en toutes lettres.
Première étape : estimer les besoins en mémoire GPU
Pour un modèle MoE, le volume de calcul dépend du nombre de paramètres activés, mais tous les poids doivent être chargés : les besoins en mémoire GPU se calculent donc sur les 280 milliards de paramètres au total. Le tableau ci-dessous donne une estimation approximative selon la formule « nombre d’octets par paramètre × nombre de paramètres ». Il ne tient pas compte du cache KV, des activations ni de la surcharge du framework. Référez-vous à la documentation officielle et à vos propres tests pour les besoins réels.
| Version des poids | Mémoire GPU estimée pour les poids | Déploiement conseillé (estimation) | Usages adaptés |
|---|---|---|---|
| FP8 | Environ 280 Go | Une machine avec 8 GPU de 80 Go, avec de l’espace pour le cache KV | Évaluation de l’inférence, services légers |
| BF16 | Environ 560 Go | Une machine avec 8 GPU à grande capacité mémoire ou parallélisme tensoriel sur plusieurs machines | Évaluations sensibles à la précision et point de départ pour le fine-tuning |
| Fine-tuning de tous les paramètres | Bien supérieure à l’inférence (états de l’optimiseur et gradients à prévoir) | Cluster de plusieurs machines avec un framework d’entraînement distribué | Adaptation approfondie à un domaine |
| Fine-tuning de type LoRA | Entre l’inférence et le fine-tuning de tous les paramètres | Selon le rang et la longueur des séquences | Adaptation à un domaine pour les petites et moyennes équipes |
Deuxième étape : choisir un framework d’inférence et charger les poids
Un plugin vLLM officiel et un cookbook SGLang sont également disponibles. Il est recommandé de commencer par ces deux ressources. Voici les étapes :
- Téléchargez les poids FP8 ou BF16 depuis Hugging Face. Prévoyez un espace disque comparable à la mémoire GPU nécessaire pour les poids.
- Installez vLLM et chargez le plugin officiel, ou configurez les paramètres de lancement selon le cookbook SGLang.
- Faites correspondre le degré de parallélisme tensoriel au nombre de GPU (paramètre
tensor-parallel-sizedans vLLM). - Commencez avec une longueur de contexte d’environ 32K, puis augmentez-la progressivement en surveillant l’utilisation du cache KV.
- Effectuez un test rapide avec une invite de continuation : par exemple, donnez-lui le début d’un extrait de code à compléter plutôt que de lui poser directement une question.
Troisième étape : définir l’objectif d’entraînement
Une fois les poids Base disponibles, le véritable travail commence. Trois approches sont courantes : poursuivre le préentraînement avec un corpus spécialisé, utiliser des données d’instructions pour le SFT, ou partir du SFT pour renforcer le raisonnement ou entraîner le modèle sur des trajectoires d’agent. Pendant le préentraînement, Wenxin a déjà utilisé des données de code comprenant des commits, des issues, des PR et des validations de correctifs par CI, ainsi que des documents longs avec des questions-réponses à plusieurs étapes. Le fine-tuning semble donc particulièrement prometteur pour l’ingénierie logicielle et les documents longs.
🎯 Conseil technique : avant de mobiliser des GPU pour le fine-tuning, évaluez d’abord un modèle d’instructions existant sur votre jeu de tests métier afin d’établir un « score de référence ». APIYI apiyi.com propose une interface unifiée pour les principaux modèles de plusieurs fournisseurs. Vous pouvez ainsi obtenir une base de comparaison à faible coût, puis déterminer si l’entraînement de votre propre modèle de base vaut l’investissement.
Prise en main de Wenxin 5.5 Flash Base : choisir une solution API selon vos besoins
Précisons d’abord un point : APIYI ne propose pas encore les modèles de la série Wenxin ERNIE, dont Wenxin 5.5 Flash Base. Ils seront disponibles dès que possible. Par ailleurs, un modèle Base n’est pas conçu pour être utilisé directement comme API conversationnelle : la plupart des applications ont plutôt besoin d’une version entraînée à suivre des instructions ou spécialisée dans le raisonnement.
Si vous souhaitez intégrer ces capacités à votre produit dès maintenant, vous pouvez d’abord construire votre application avec un modèle éprouvé déjà disponible, puis le remplacer par la version officielle de Wenxin 5.5 Flash pour comparer les résultats une fois celle-ci lancée. APIYI prend en charge les formats d’interface OpenAI et Anthropic : pour changer de modèle, il suffit de modifier le paramètre model, sans réécrire la logique d’appel.
Prix des modèles alternatifs disponibles sur APIYI
Les prix ci-dessous proviennent de la page tarifaire d’APIYI, docs.apiyi.com/models. Ils sont indiqués en dollars par million de tokens. Consultez la page pour connaître les tarifs à jour avant toute invocation.
| Modèle | Entrée | Sortie | Cache | Cas d’usage | Plateforme |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Tâches à forte concurrence et sensibles aux coûts | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Contextes longs, applications en chinois | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Modèle principal pour la programmation et les agents | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Raisonnement complexe et tâches difficiles | APIYI apiyi.com |
| Wenxin 5.5 Flash Base / version officielle | — | — | — | Ce modèle n’est pas encore disponible sur APIYI | Disponible prochainement |
APIYI propose aussi d’autres modèles chinois, comme la série qwen3.8, ainsi que les modèles de génération d’images gpt-image-2.6-flare et gpt-image-2.6-sunburst (entrée texte : $5, entrée image : $8, sortie : $30 ; consultez également la page tarifaire pour les prix à jour). À noter : deepseek-v4.1-flash, présenté dans le tableau, est un modèle d’instructions directement utilisable. Ce n’est pas le même modèle que DeepSeek-V4-Flash-Base, utilisé dans les comparaisons d’évaluation.
Comment intégrer l’API
Pour utiliser le format OpenAI, définissez le base_url du SDK avec l’adresse d’interface fournie dans la documentation d’APIYI, puis renseignez dans api_key la clé générée depuis la console. Les projets utilisant le SDK Anthropic peuvent également se connecter directement. Pour l’adresse complète de l’interface, les paramètres et les exemples, consultez le centre de documentation APIYI à l’adresse docs.apiyi.com.
🚀 Pour démarrer rapidement : nous vous recommandons de tester votre prototype sur APIYI apiyi.com avec deepseek-v4.1-flash ou claude-sonnet-5-5. Lorsque la version officielle de Wenxin 5.5 Flash sera disponible sur la plateforme, il suffira de changer le nom du modèle pour effectuer une comparaison A/B.
Wenxin 5.5 Flash Base : auto-hébergement ou appel API ? Tableau de décision
Voici des recommandations selon cinq critères pour vous aider à déterminer quelle approche convient à votre équipe.
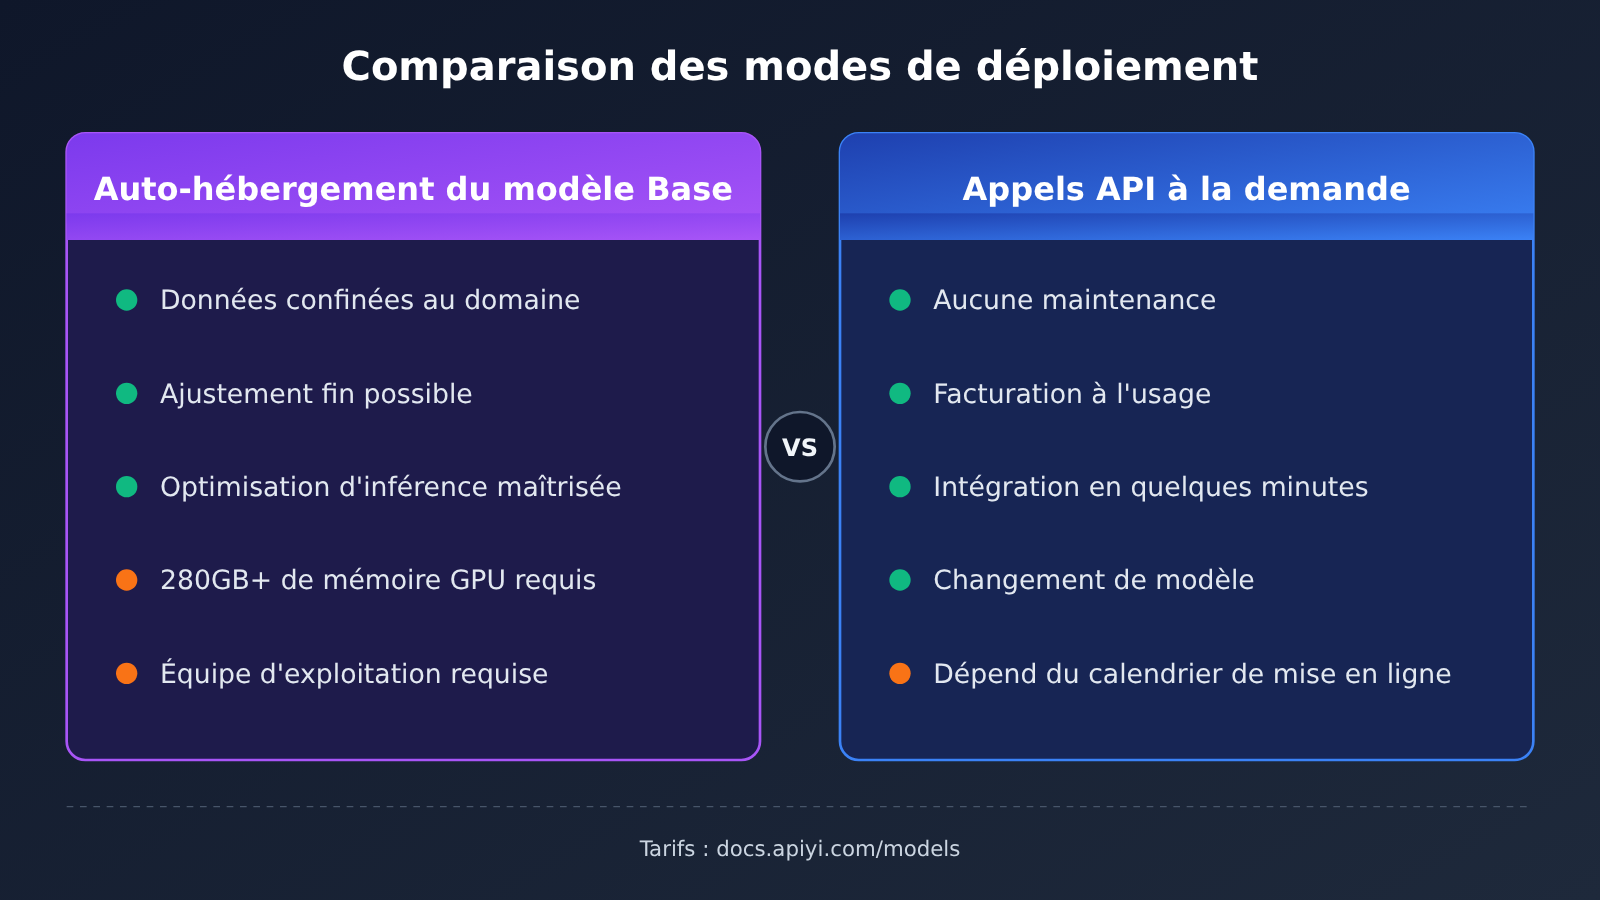
| Critère | Choisir l’auto-hébergement de Base | Choisir l’appel API à la demande |
|---|---|---|
| Objectif | Poursuivre le préentraînement sur un domaine, réaliser du SFT, du RL ou des expériences comparatives | Créer directement des applications de questions-réponses, de rédaction ou d’assistance à la programmation |
| Conformité des données | Les données ne peuvent pas quitter le réseau interne : un déploiement privé est obligatoire | Les données peuvent passer par le cloud et les conditions de conformité du fournisseur sont acceptables |
| Volume d’appels | Charge élevée et stable à long terme, avec un taux d’utilisation des GPU durablement élevé | Trafic très variable ou nombre d’appels quotidiens limité |
| Compétences de l’équipe | Présence d’ingénieurs chargés de l’entraînement et de l’exploitation de l’inférence | Équipe principalement axée sur le développement d’applications, sans volonté de maintenir un cluster |
| Délai de mise en production | Un cycle d’entraînement de plusieurs semaines à plusieurs mois est acceptable | Une mise en production est nécessaire dès cette semaine |
Deux profils d’utilisateurs typiques de Wenxin 5.5 Flash Base
Les équipes adaptées à l’auto-hébergement : par exemple, les équipes de la finance, de la santé ou du secteur public qui ont besoin d’un déploiement privé, disposent d’importants corpus spécialisés et souhaitent entraîner leur propre modèle. Pour elles, l’intérêt de Wenxin 5.5 Flash Base réside dans ses acquis de préentraînement en code et en contexte long, ainsi que dans les économies de cache KV offertes par son architecture HCA.
Les équipes adaptées aux appels API : par exemple, les équipes qui développent des applications SaaS, des outils de création de contenu ou des systèmes de service client et recherchent avant tout la stabilité, la rapidité et une facturation à l’usage. Pour elles, partir directement d’un modèle Base impose une étape d’entraînement supplémentaire. Il est plus judicieux de lancer d’abord le produit avec un modèle d’instruction éprouvé et de concentrer les efforts sur le produit.
Les deux approches peuvent avancer en parallèle
Beaucoup d’équipes adoptent en réalité un « mode hybride » : elles utilisent une API pour garantir la stabilité de leurs services en production, tout en expérimentant en interne avec les poids du modèle Base. Une fois que leur modèle entraîné en interne dépasse la référence API sur les jeux d’évaluation, elles redirigent progressivement le trafic. Cette approche limite les risques et permet de garder un point de comparaison clair pour les investissements en développement interne.
💡 Conseil pour choisir : si vous hésitez encore, commencez par faire le calcul. Estimez les frais mensuels à partir de votre volume d’appels prévu et des tarifs unitaires de la page APIYI, puis comparez-les au coût de location ou d’amortissement des GPU. Un essai à petite échelle pendant une semaine via l’interface unifiée d’APIYI sur apiyi.com vous donnera votre consommation réelle de tokens et une base de décision bien plus fiable qu’une estimation au jugé.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce qu’ERNIE 5.5 Flash Base ?
C’est un modèle de base publié en open source par Baidu le 5 novembre 2026. Il utilise une architecture MoE à activation parcimonieuse, avec 280B de paramètres au total et 14B activés par token. Il a été préentraîné à partir de zéro sur 33,5T de tokens. Les poids publiés correspondent à la fin du préentraînement : ils sont surtout destinés à poursuivre l’entraînement, pas à dialoguer directement avec le modèle.
Q2 : Quelle est la différence entre ERNIE 5.5 Flash Base et DeepSeek-V4-Flash-Base ?
Les deux modèles sont de taille comparable : DeepSeek-V4-Flash-Base compte 284B de paramètres, dont 13B sont activés. C’est lui aussi un modèle de base performant, mais selon les évaluations publiées par Baidu, ERNIE 5.5 Flash Base prend l’avantage en raisonnement, en code, dans les disciplines spécialisées et sur les longs contextes. Côté architecture, ERNIE combine les mécanismes d’attention HCA et MLA avec un MoE à plusieurs routeurs, en mettant l’accent sur la compression du cache KV et la robustesse du routage.
Q3 : Quand la version finale d’ERNIE 5.5 Flash sera-t-elle publiée ?
Baidu indique que la version finale sera publiée prochainement, mais aucune date précise n’avait été annoncée au moment de la rédaction de cet article, le 6 novembre 2026. Elle bénéficiera d’un post-entraînement à partir de la version Base et sera donc mieux adaptée à une intégration directe dans les applications.
Q4 : À quels usages ERNIE 5.5 Flash Base convient-il le mieux ?
Il convient principalement aux usages suivants :
– **Entraînement de modèles de code à l’échelle d’un dépôt** : le préentraînement inclut déjà des données d’ingénierie comme les commits, les PR et les corrections de CI.
– **Modèles spécialisés dans les documents longs** : par exemple, pour comprendre de longs dossiers juridiques ou rapports de recherche. Le fine-tuning et l’inférence prennent en charge jusqu’à 1M de tokens.
– **Recherche sur les méthodes d’entraînement** : comme point de départ commun pour comparer les résultats de différentes stratégies de SFT et de RL.
Q5 : Peut-on déjà appeler ERNIE 5.5 Flash Base via une API ?
APIYI ne propose pas encore ce modèle, ni la série ERNIE dans son ensemble, mais nous prévoyons de les rendre disponibles dès que possible. En attendant, vous pouvez appeler sur APIYI, via apiyi.com, des modèles déjà disponibles comme deepseek-v4.1-flash, kimi-k3.1-pro et claude-sonnet-5-5. La plateforme est compatible avec les formats d’interface OpenAI et Anthropic. Les tarifs en vigueur sont indiqués sur docs.apiyi.com/models.
Q6 : Quelles sont les limites d’un déploiement autonome d’ERNIE 5.5 Flash Base ?
D’abord, les besoins en mémoire GPU sont élevés : même en FP8, les poids seuls nécessitent environ 280 Go. Ensuite, le modèle Base n’est pas prêt à l’emploi : il faut investir dans son entraînement. Enfin, l’inférence sur de longs contextes exige encore de réserver de l’espace pour le cache KV. Si votre équipe manque d’expérience en entraînement et en exploitation, mieux vaut commencer par une API.
Q7 : Que peuvent faire les petites et moyennes équipes avec ERNIE 5.5 Flash Base ?
Elles peuvent louer des GPU dans le cloud pour évaluer ses capacités en inférence FP8, ou utiliser des méthodes comme LoRA pour une adaptation légère à leur domaine. Pour le trafic en production, il reste conseillé de passer par une API et d’utiliser les résultats métier obtenus avec APIYI sur apiyi.com comme référence pour comparer le modèle entraîné en interne.
Wenxin 5.5 Flash Base : points clés
- Un point de départ pour l’entraînement : Base n’a pas fait l’objet d’un post-entraînement. Il convient à la recherche et à l’ajustement fin, mais pas à une utilisation directe en conversation.
- Calcul selon les paramètres activés, mémoire selon le total : seuls 14 milliards de paramètres sont activés, mais les poids en FP8 nécessitent tout de même environ 280 Go de mémoire GPU.
- Un cache réduit pour les longs contextes : 37 couches HCA avec compression et 6 couches MLA-DSA réduisent sensiblement la taille du cache KV.
- De solides bases en code et en textes longs : le modèle convient à la création de modèles spécialisés dans le code à l’échelle d’un dépôt ou dans les documents longs.
- Un écosystème déjà prêt : un plugin vLLM et un Cookbook SGLang ont été publiés en même temps, ce qui facilite l’intégration pour l’inférence.
- Pas encore disponible par API : APIYI ne propose pas encore la série Wenxin. Vous pouvez toutefois utiliser les modèles déjà disponibles pour établir une base de référence.
Bilan
Pour choisir Wenxin 5.5 Flash Base, retenez trois points :
- Commencez par définir l’objectif : pour entraîner un modèle, déployez vous-même Base ; pour utiliser un modèle, choisissez une API ou attendez la version officielle.
- Évaluez les prérequis : les poids nécessitent environ 280 Go de mémoire GPU en FP8 et 560 Go en BF16. C’est une contrainte incontournable.
- Comparez les coûts : à partir de votre volume réel d’appels, comparez les frais mensuels de l’API au coût des GPU. Une approche hybride limite les risques.
Pour la plupart des équipes applicatives, la voie la plus pragmatique consiste à lancer d’abord leur service via une API, puis à expérimenter en interne avec Base en open source. Vous pouvez utiliser les modèles déjà disponibles sur APIYI apiyi.com pour établir rapidement une base de référence. La documentation des interfaces est disponible sur docs.apiyi.com et les tarifs de référence sur docs.apiyi.com/models. Une fois la série Wenxin disponible, il suffira de changer le nom du modèle dans le même code pour effectuer la comparaison.
📚 Ressources
- QbitAI – Article sur la publication en open source de ERNIE 5.5 Flash Base par Baidu : présentation du lancement et des évaluations du modèle
- Lien :
qbitai.com/2026/11/507787.html -
Contenu : comparaison avec des modèles de base de taille similaire et présentation des principales technologies
-
Centre de documentation APIYI : adresses des interfaces et instructions d’invocation compatibles avec OpenAI et Anthropic
- Lien :
docs.apiyi.com -
Contenu : paramètres et exemples à consulter avant l’intégration
-
Page des tarifs des modèles APIYI : prix unitaires des entrées, des sorties et du cache pour les modèles disponibles
- Lien :
docs.apiyi.com/models - Remarque : les prix indiqués sur cette page font référence pour l’ensemble de l’article
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI sur apiyi.com. Pour plus de ressources sur l’intégration, consultez le centre de documentation docs.apiyi.com


