
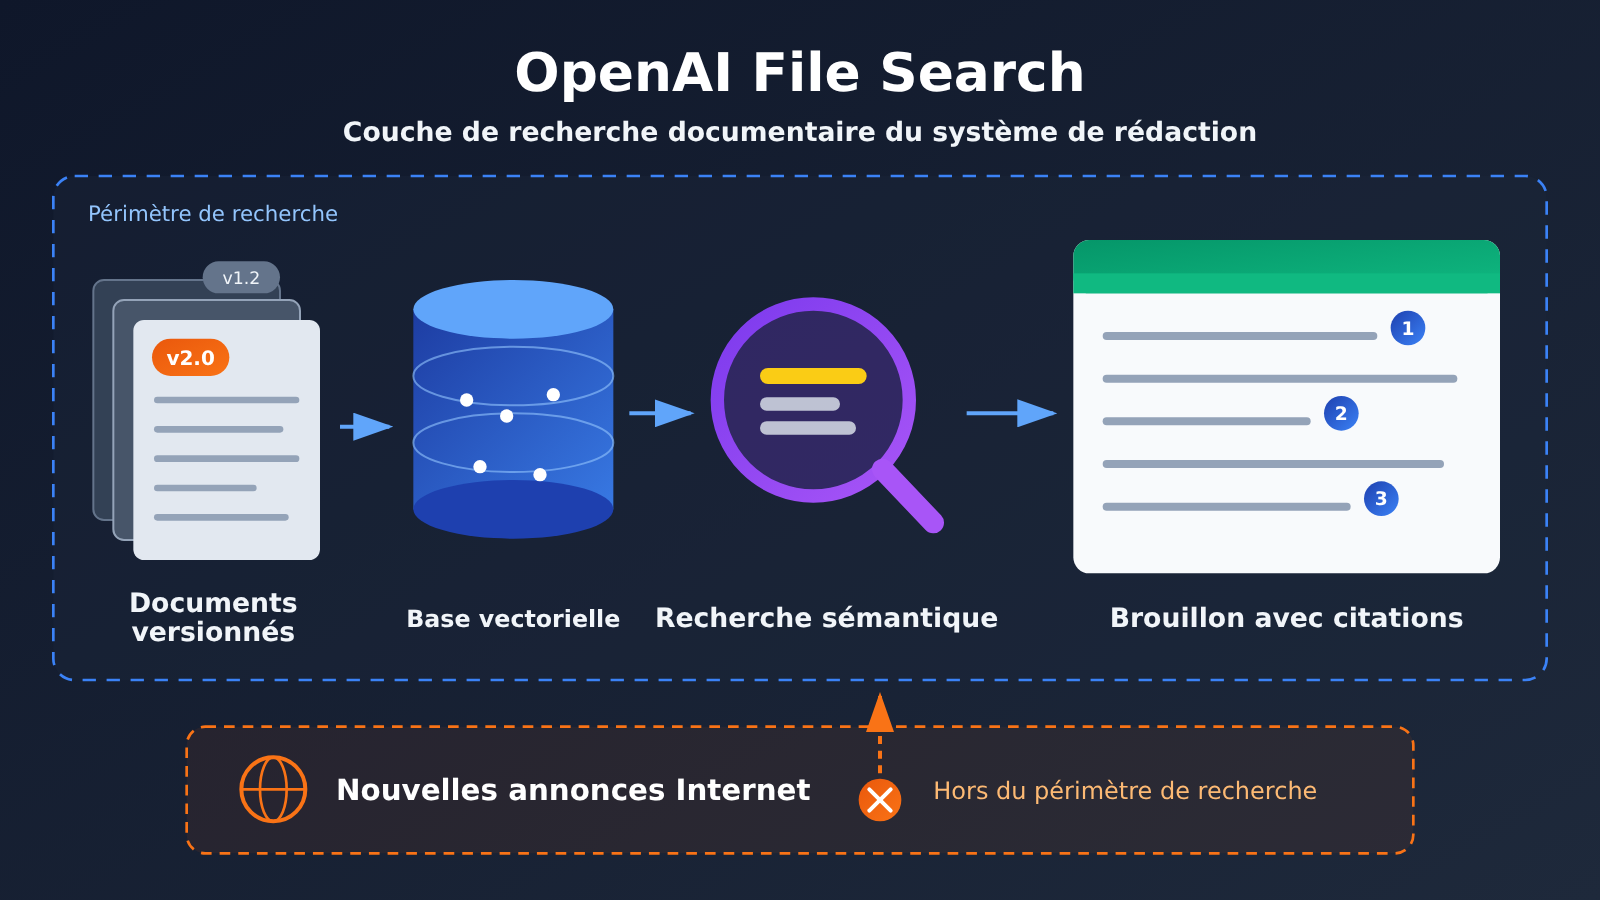
Il peut en combler une partie, mais pas la totalité. OpenAI File Search s’attaque au problème « les documents existants ne sont pas retrouvés avec précision et les citations ne sont pas claires ». Il sait retrouver des fichiers par similarité sémantique dans une base vectorielle et joindre des références de fichiers à la réponse — très utile pour un système de rédaction. En revanche, il ne résout pas le problème « la documentation elle-même est absente ou obsolète » : l’outil se contente de chercher dans les fichiers que vous avez déjà déposés, il ne découvre pas tout seul les nouvelles annonces publiées sur Internet. Les marqueurs de citation indiquent seulement de quel fichier provient un contenu, ils ne garantissent pas que la conclusion est juste.
Le jugement le plus exact est donc celui-ci : File Search peut constituer la « couche de récupération documentaire » d’un système de rédaction ; la collecte des sources, la gestion des versions et la vérification des faits restent à faire séparément.
Ce que vous apprendrez en lisant cet article
- La place de File Search dans l’API Responses, et les capacités qu’il apporte au processus de rédaction
- Comment ajuster le nombre de résultats récupérés, et comment faire renvoyer par la réponse le contenu réellement récupéré, pour faciliter le diagnostic
- Pourquoi un fichier supprimé peut encore être récupéré pendant un certain temps, et comment un système de rédaction doit gérer ce cas
- Les trois familles de problèmes — documentation manquante, échec de récupération, erreur de génération — et à quel niveau les corriger
- Quelles métadonnées il est conseillé de conserver lors de l’indexation, pour éviter d’inscrire des limites obsolètes comme règles en vigueur
Index : Le préambule explique d’abord quelques concepts clés et détaille les impacts par type de public. La partie « faits objectifs » s’appuie sur la documentation officielle d’OpenAI pour décrire le fonctionnement de File Search, ses paramètres ajustables et ses comportements connus. La partie « analyse et jugement » traite de la répartition des rôles une fois l’outil intégré à un système de rédaction, du chemin de dépannage et des règles d’indexation, avant de conclure sur quelques idées fausses à surveiller.
Concepts à connaître sur OpenAI File Search
| Concept | Brève explication |
|---|---|
| API Responses | L’interface de génération de réponses d’OpenAI, qui permet de monter des outils dans une seule requête ; File Search en fait partie |
| File Search | Outil intégré de l’API Responses, qui récupère des extraits pertinents parmi les fichiers d’une base vectorielle pour aider à générer la réponse |
| Base vectorielle (Vector Store) | Bibliothèque qui stocke les fichiers téléversés et leurs représentations vectorielles ; c’est le périmètre de recherche de File Search |
| Recherche sémantique | Recherche par similarité de sens : des passages dont les mots diffèrent mais dont le sens est proche peuvent aussi être trouvés |
| Citation de fichier (Citation) | Indique dans la réponse de quel fichier provient un passage, pour faciliter la vérification par le lecteur et le réviseur |
max_num_results |
Paramètre qui contrôle le nombre maximum de résultats renvoyés par une recherche |
include |
Paramètre de requête : en passant file_search_call.results, la réponse inclut le contenu réellement récupéré |
| Cohérence à terme | Les opérations d’écriture ou de suppression ne prennent pas effet immédiatement partout ; on peut voir un état ancien pendant un court instant |
Aperçu des impacts d’OpenAI File Search
| Public | Principaux impacts |
|---|---|
| Développeurs de systèmes de rédaction | Peuvent obtenir une recherche sémantique et des citations de fichiers sans construire leur propre service de recherche. Doivent concevoir leurs propres règles d’ingestion et leur processus de dépannage |
| Rédacteurs de contenu / réviseurs | Les citations facilitent la vérification, mais il faut toujours contrôler chaque conclusion : on ne valide pas directement sous prétexte qu’« il y a une citation » |
| Mainteneurs de documentation technique | Il faut bien indiquer la version et la date des documents anciens et nouveaux, sinon d’anciennes limites risquent d’être récupérées et intégrées dans un nouvel article |
| Responsables des coûts | Le stockage de la base vectorielle et les appels d’outils sont facturés ; se référer à la page de tarifs actuelle d’OpenAI, et anticiper lorsque le volume de documents est important |
Faits objectifs sur OpenAI File Search
Le contenu ci-dessous repose sur les deux guides File Search et Retrieval de la documentation pour développeurs d’OpenAI ; la vérification a été effectuée le 2026-11-17. Ces deux documents sont maintenus à jour. Cet article n’a pas vérifié la date de première publication de cette fonctionnalité.
Qu’est-ce que File Search : un outil de recherche dans l’API Responses
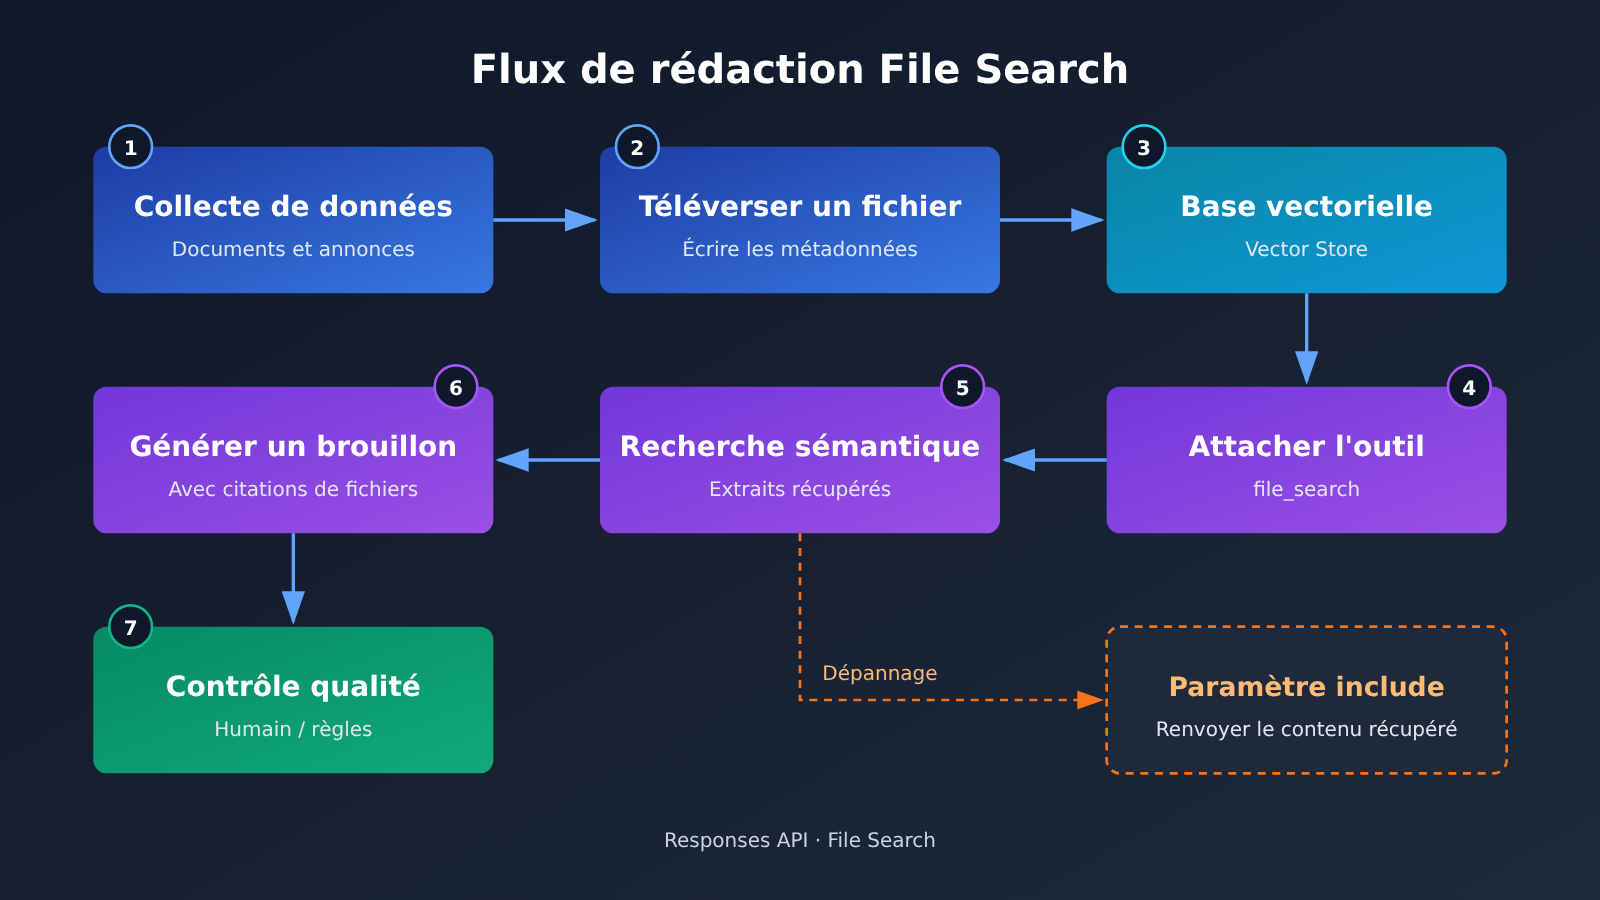
File Search est un outil proposé par l’API Responses. Le développeur téléverse d’abord des fichiers dans une base vectorielle, puis, au moment d’envoyer la requête, déclare File Search dans tools et indique la base vectorielle à utiliser. Lorsque le modèle génère une réponse, il récupère le contenu pertinent dans ces fichiers ; la réponse peut inclure des références aux fichiers pour indiquer la provenance de l’information.
Il s’appuie sur la recherche sémantique, ce qui permet de retrouver du contenu dont le sens est proche même si les mots ne correspondent pas exactement. Par exemple, pour une requête sur la « limitation de débit de l’interface », un document qui parle de « plafond de fréquence des requêtes » peut aussi être remonté. Pour un système de rédaction, cela signifie qu’il n’est pas nécessaire de reproduire mot pour mot la formulation originale lorsqu’on pose la question.
Les paramètres ajustables et les interrupteurs de dépannage de File Search
Deux paramètres de la documentation sont directement liés au système d’écriture :
| Paramètre / comportement | Rôle | Signification pour le flux d’écriture |
|---|---|---|
max_num_results |
Ajuste le nombre de résultats renvoyés par une recherche | Un petit nombre économise le contexte, mais les preuves peuvent être incomplètes ; un grand nombre couvre davantage, mais le bruit augmente aussi |
| Contenu renvoyé par défaut | Par défaut, l’appel de l’outil ne renvoie pas les résultats de recherche complets | En ne regardant que la réponse finale, impossible de déterminer ce que le modèle a réellement lu |
include: ["file_search_call.results"] |
Fait inclure dans la réponse le contenu réellement récupéré | Permet de distinguer « rien n’a été récupéré » de « récupéré mais mal rédigé », indispensable pour le dépannage |
| Références de fichiers | Indique les fichiers sources dans la réponse | Pratique pour vérifier, mais ne garantit pas que la conclusion est correcte |
Voici un exemple d’appel minimal, qui montre comment monter une base vectorielle, limiter le nombre de résultats récupérés et demander que la réponse renvoie les résultats de recherche. Remplacez le nom du modèle et l’ID de la base vectorielle par votre propre configuration :
from openai import OpenAI

client = OpenAI()  # lit la clé depuis la variable d'environnement OPENAI_API_KEY

response = client.responses.create(
    model="YOUR_MODEL",
    input="根据资料库,总结该接口目前的调用限制,并标明出处。",
    tools=[{
        "type": "file_search",
        "vector_store_ids": ["YOUR_VECTOR_STORE_ID"],
        "max_num_results": 8,   # nombre de résultats : compromis entre couverture des preuves et bruit
    }],
    include=["file_search_call.results"],  # renvoie le contenu réellement récupéré, utile pour le dépannage
)

# parcourt la sortie : on obtient à la fois le texte final et les fragments récupérés
for item in response.output:
    if item.type == "file_search_call":
        for r in (item.results or []):
            print("召回:", r.filename, r.score)
    elif item.type == "message":
        print(item.content[0].text)
Cohérence à terme de la suppression de fichiers avec File Search
La documentation indique que la suppression d’un fichier dans la base vectorielle est à terme cohérente : pendant un certain temps après la suppression, ce fichier peut encore être retrouvé lors d’une recherche. Il ne faut donc pas affirmer publiquement qu’« un fichier supprimé n’est plus consultable immédiatement ». Si un document doit être retiré pour cause d’erreur ou d’obsolescence, le système de rédaction a tout intérêt à filtrer également à son propre niveau, plutôt que de se reposer uniquement sur l’opération de suppression.
Ce que File Search ne fait pas
D’après la description de la documentation officielle et le mécanisme de l’outil lui-même, plusieurs points méritent d’être précisés :
- File Search ne recherche que les fichiers déjà présents dans la base vectorielle ; il ne découvre pas automatiquement les nouvelles annonces ou mises à jour de documents sur Internet.
- Les marqueurs de citation indiquent de quel fichier provient le contenu, mais ne garantissent pas que la conclusion tirée de ce fichier soit correcte.
- Le stockage dans la base vectorielle et les appels à l’outil sont tous deux payants, le coût étant celui actuellement publié par OpenAI ; cet article ne donne pas de chiffres précis.
- Cet article n’a pas vérifié si APIYI ou d’autres plateformes tierces sont compatibles avec les interfaces liées à File Search ; pour les questions de prise en charge, référez-vous aux indications officielles de chaque plateforme.
Analyse et évaluation de File Search d’OpenAI
Premier point : File Search complète la « couche de recherche », pas la « couche documentaire »
Dans un système de rédaction, les faiblesses côté documentation sont généralement de deux ordres. D’un côté, on a les documents sous la main mais on ne sait pas les retrouver : le modèle écrit au feeling, et impossible de dire d’où vient l’information. De l’autre, on n’a carrément pas de documents, ou ils sont déjà obsolètes. File Search est très efficace pour le premier cas : la recherche sémantique rend le rappel plus souple, et les références aux fichiers permettent de vérifier chaque passage.
Pour le second cas, il ne peut rien faire. L’outil ne va pas chercher de lui-même les nouvelles annonces : ce qui est dans la base vectorielle, c’est tout ce qu’il pourra retrouver. Par exemple, si le prix ou les limites d’un modèle viennent d’être modifiés et que la base ne contient que les anciens documents, File Search va retrouver « avec précision » une information périmée, en l’accompagnant d’une citation qui paraît fiable. C’est plus dangereux que l’absence de citation, parce que ça trompe plus facilement une relecture.
File Search doit donc être vu comme une couche du système de rédaction, et non comme la solution documentaire dans son ensemble. La collecte des documents, la mise à jour régulière et l’élimination des versions obsolètes doivent toujours être confiées à un processus séparé.
Diagnostic 2 : utiliser la tripartition pour localiser les problèmes de rédaction avec File Search
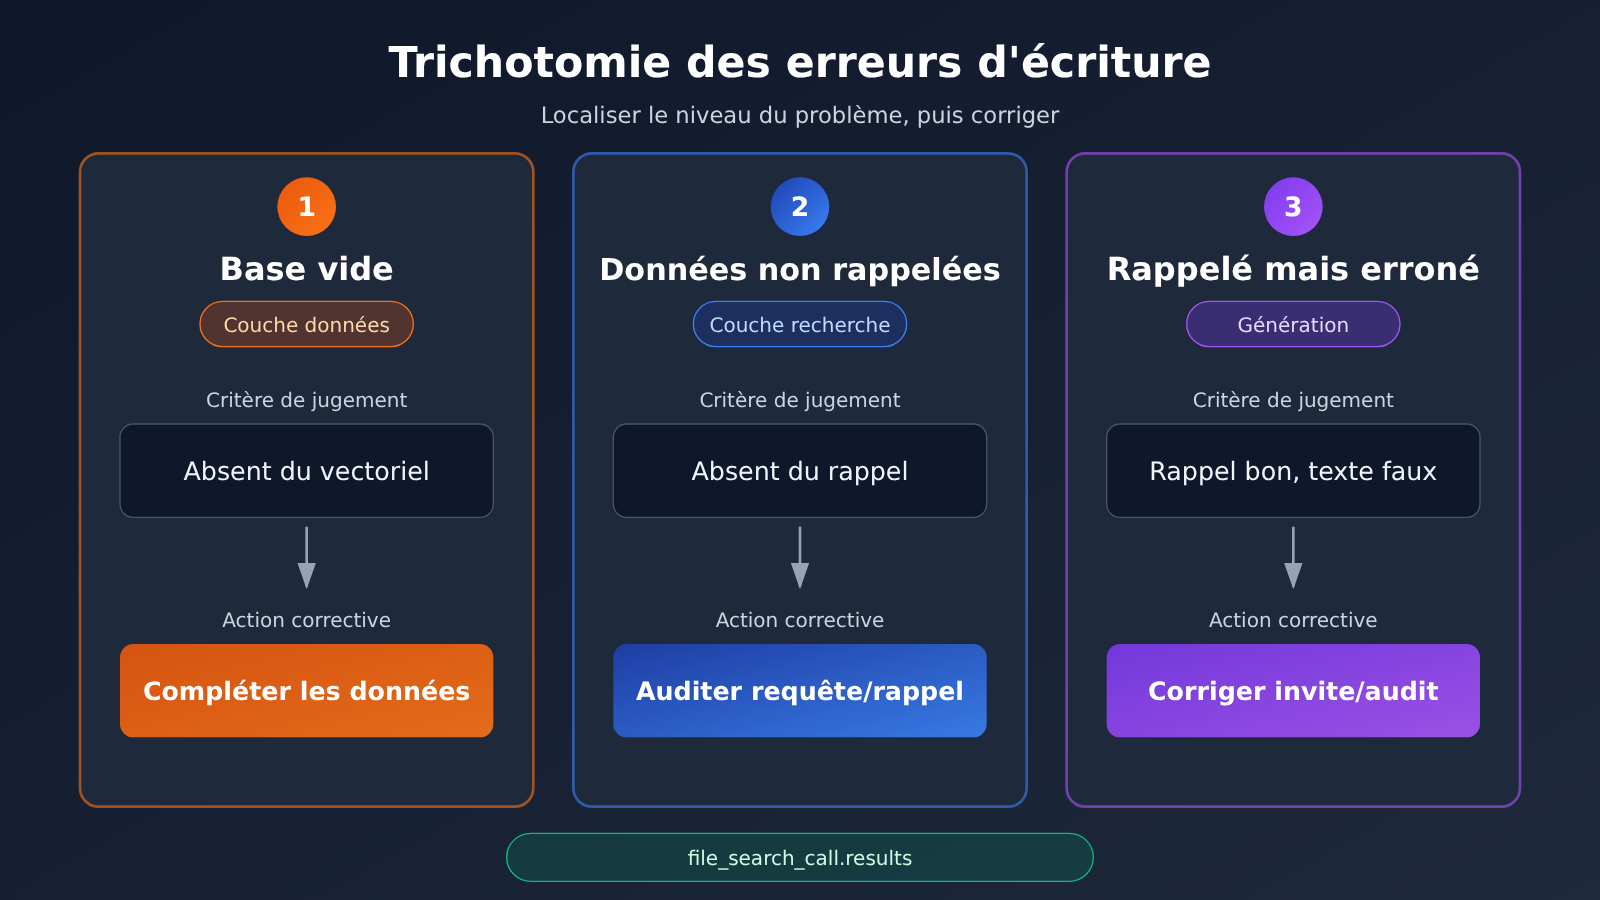
Quand un article contient des erreurs, le problème peut se situer à trois étapes différentes. L’intérêt de include: ["file_search_call.results"] est de permettre, pour la première fois, de distinguer ces trois types de problèmes.
| Type de problème | Critère de diagnostic | Axe de correction |
|---|---|---|
| Aucun matériau dans la base | Impossible de trouver un fichier pertinent dans la base vectorielle | Compléter les sources ; il s’agit d’un problème au niveau des données |
| Matériaux présents mais non récupérés | Le fichier est dans la base, mais absent de file_search_call.results |
Ajuster la formulation de la requête, découper la question, ou augmenter légèrement max_num_results |
| Récupérés mais mal rédigés | Les résultats de récupération sont corrects, mais le texte final ne leur correspond pas | Modifier l’invite de génération et les règles de vérification ; il s’agit d’un problème au niveau de la génération |
Si aucun contenu récupéré n’est renvoyé, l’équipe ne peut souvent que dire vaguement « l’IA a encore halluciné », puis aller modifier l’invite. Or, bien souvent, la vraie raison est que cette source n’existe pas dans la base, ou que la requête ne l’a pas atteinte. Commencer par déterminer à quel niveau se situe le problème permet d’éviter bien des détours.
Critère 3 : avec OpenAI File Search, les métadonnées d’ingestion déterminent le plafond de qualité de rédaction
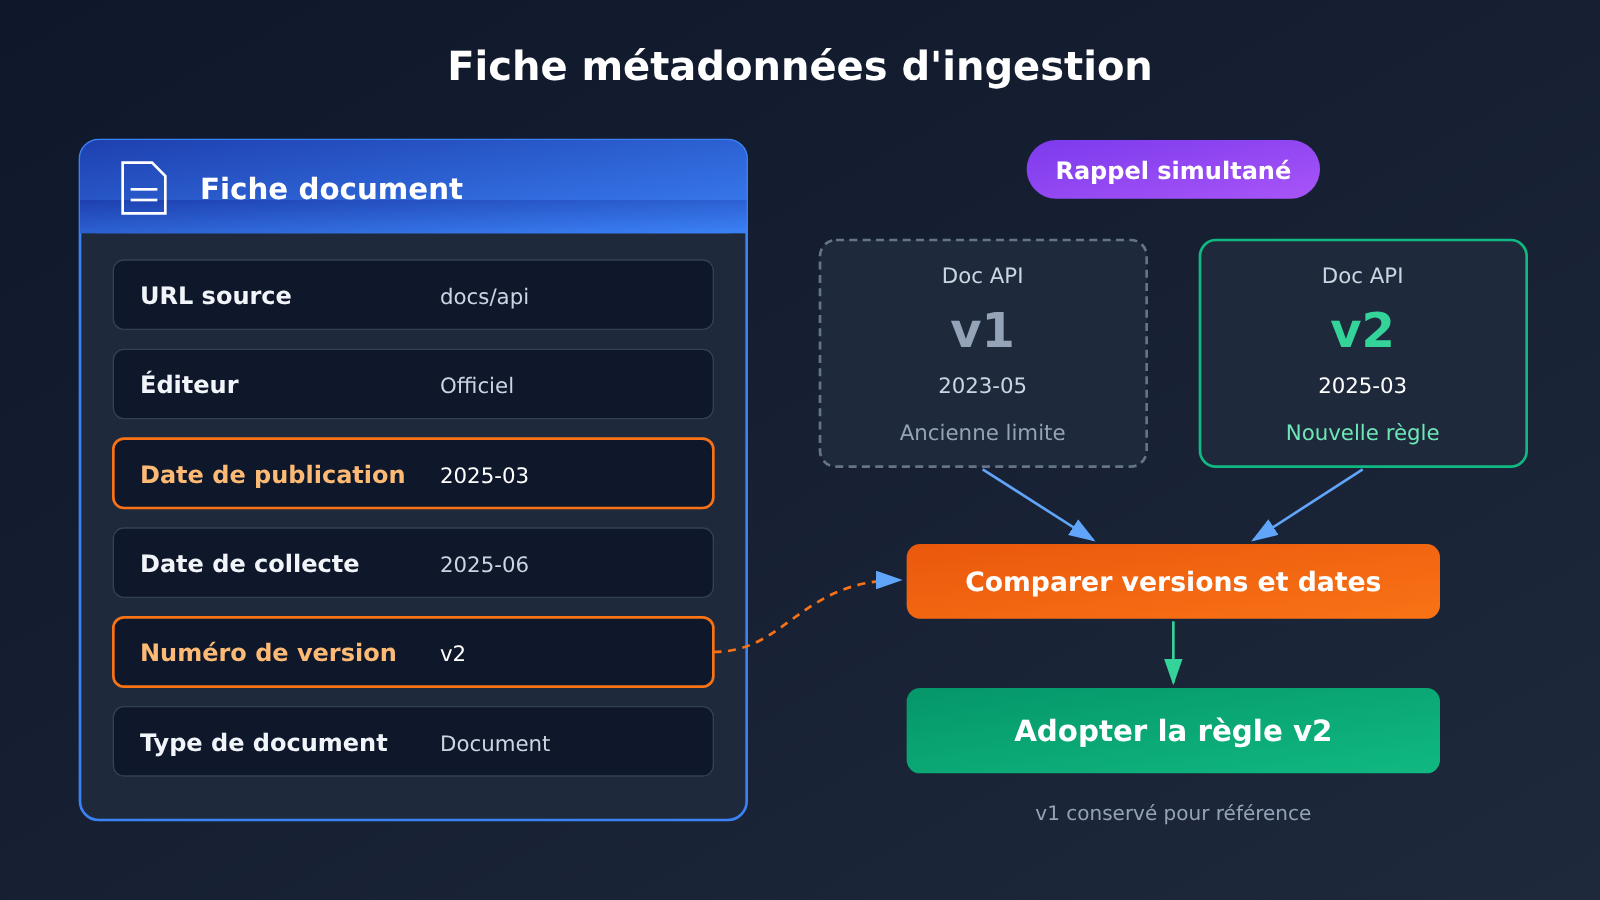
La recherche ne peut renvoyer que le contenu présent dans la base, et la qualité de ce contenu dépend de ce qui a été enregistré au moment de l’ingestion. Pour un système de rédaction, il ne suffit pas de téléverser le contenu brut d’un document : je recommande d’ajouter au minimum les informations suivantes à chaque source :
| Champ de métadonnées | Utilisation |
|---|---|
| URL d’origine | Permet de revenir à la source pour vérifier, et de la citer dans les références |
| Émetteur | Distinguer les propos officiels, les interprétations de tiers et les rumeurs de la communauté |
| Date de publication | Déterminer si l’information est encore valable |
| Date de collecte | Savoir depuis combien de temps le document n’a pas été mis à jour |
| Numéro de version | Éviter de prendre d’anciennes limites pour des règles en vigueur lorsque anciens et nouveaux documents coexistent |
| Type de document | Distinguer annonces, documentation, billets de blog et messages de forum, afin de définir le niveau de confiance |
Les informations de version sont souvent celles que l’on néglige le plus. Les anciens et les nouveaux documents d’une même interface peuvent tous se trouver dans la base ; comme ils sont très proches sur le plan sémantique, il est fort probable qu’ils soient récupérés en même temps lors de la recherche. Sans version ni date, le modèle a du mal à déterminer quelle limitation a été supprimée. Il est plus prudent de conserver les informations de version que de supprimer directement les anciens documents : d’une part, elles restent utiles pour rédiger des comparaisons historiques ; d’autre part, la suppression est elle-même soumise à une cohérence à terme, et un document supprimé ne disparaît pas forcément immédiatement.
Quatrième point : le nombre de résultats rappelés n’a pas de réponse unique
Réduire max_num_results rend le contexte plus propre, avec moins de coûts et moins de bruit, mais risque de laisser échapper des preuves essentielles — surtout pour les sujets où plusieurs sources doivent se recouper, par exemple quand il faut croiser prix, limites et différences entre versions. À l’inverse, augmenter la valeur couvre plus large, mais les fragments hors sujet diluent l’attention et le modèle a davantage tendance à mélanger des informations issues de versions différentes.
L’approche la plus réaliste consiste à régler la valeur séparément selon le type d’article. Pour les analyses d’actualité, qui demandent une validation croisée entre plusieurs sources, on peut élargir raisonnablement. Pour la documentation d’une interface unique, on peut resserrer. Il n’existe pas de valeur optimale universelle : mieux vaut ajuster après avoir observé concrètement le contenu rappelé, plutôt que de fixer un chiffre au feeling.
Évolutions à surveiller
Les points suivants sont des pistes à observer, et non des faits confirmés : File Search proposera-t-il un filtrage par métadonnées plus fin, permettant de trier directement par version ou par date ? Le délai de prise en effet des suppressions sera-t-il documenté plus clairement ? Le mode de facturation sera-t-il ajusté ? Ces évolutions influencent directement les choix d’architecture du système de rédaction ; avant toute intégration, il est conseillé de reconulter la documentation officielle et la page des tarifs.
Quand on intègre File Search dans un système de rédaction, l’erreur d’appréciation la plus fréquente est de croire que « avec la recherche et les citations, le problème des sources est réglé ». En réalité, cela permet simplement de mieux exploiter les documents existants ; leur fraîcheur et leur exactitude continuent de dépendre de la collecte, de la gestion des versions et de la relecture.
Comment l’eau de ce bassin peut-elle être si claire ? C’est qu’une source vive l’alimente sans cesse. — Zhu Xi, Réflexions sur la lecture


