
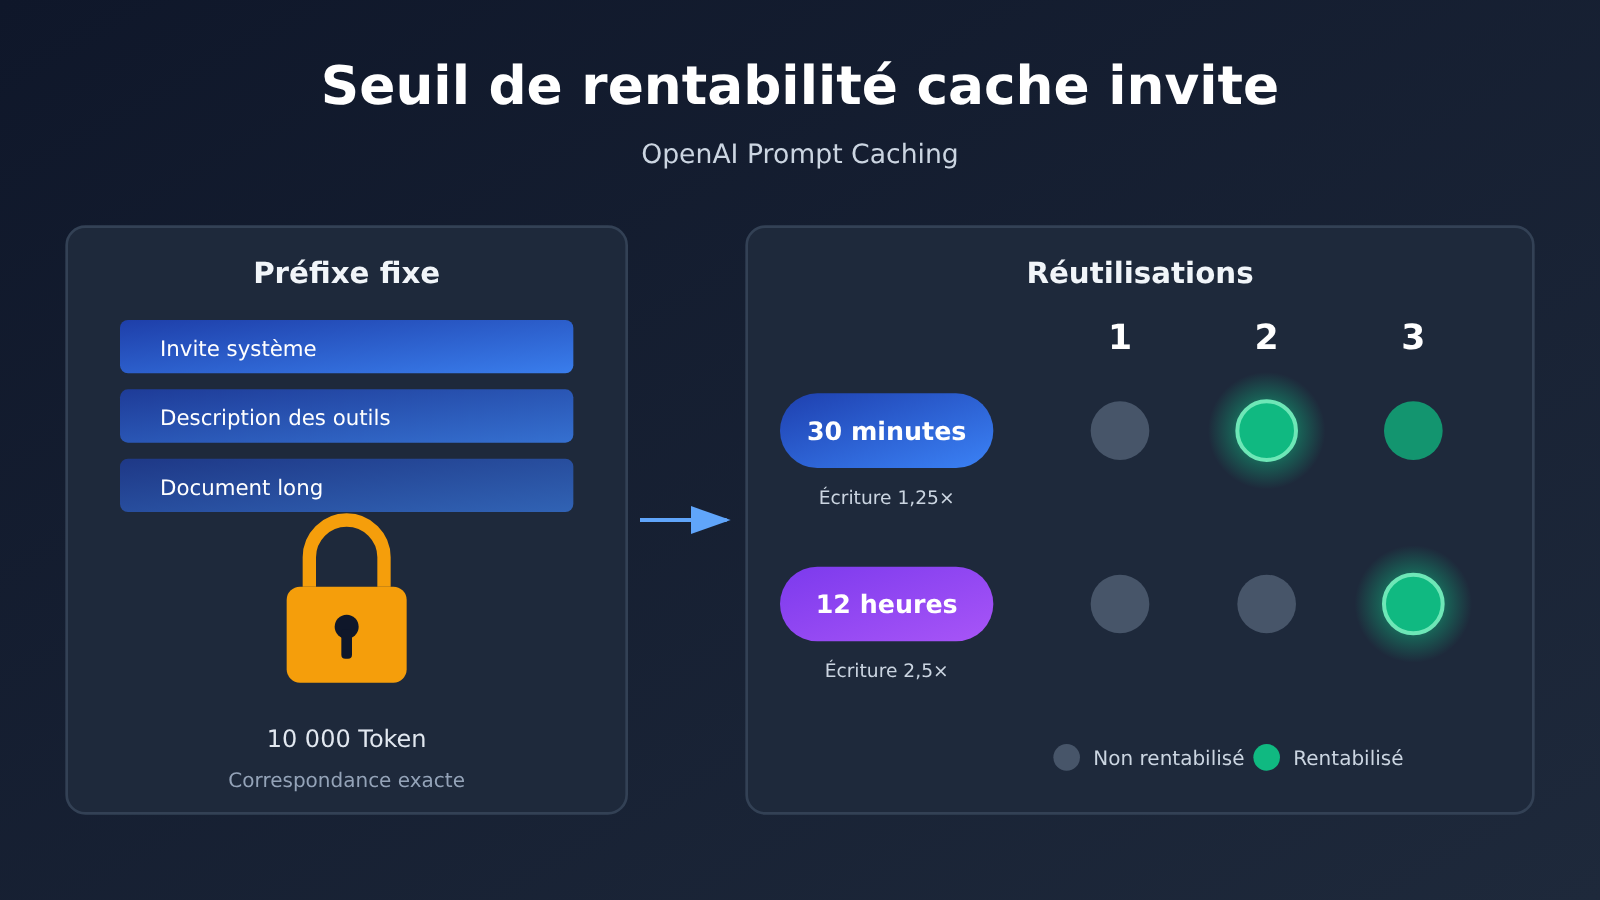
Réponse directe : dans des conditions idéales, le cache d’invites de 30 minutes activé par défaut chez OpenAI devient moins coûteux que l’absence de cache dès la 2ᵉ utilisation, tandis que le cache de 12 heures ne commence à être rentable qu’à la 3ᵉ utilisation. Les conditions idéales en question : un même préfixe fixe est d’abord écrit une fois en entier dans le cache, toutes les requêtes suivantes touchent ce cache, et aucune réécriture n’intervient entre-temps. D’après les tarifs officiels de gpt-6-luna pour les contextes courts standard, pour un préfixe fixe de 10000 Token utilisé 10 fois au total, le cache de 30 minutes fait économiser environ 78,5 % par rapport à l’absence de cache, et le cache de 12 heures environ 66 %. Mais cela ne concerne que la partie « préfixe fixe » : cela ne veut pas dire que toute la requête bénéficie d’une remise.
Ce que vous apprendrez en lisant cet article
- Les conditions réelles pour qu’un cache d’invites soit touché, et en quoi elles diffèrent de la « similarité sémantique ».
- Comment sont facturés les deux tarifs d’écriture, 30 minutes et 12 heures, et pourquoi le tarif d’entrée normal ne peut pas s’y ajouter.
- Une série d’exemples vérifiables pour 1, 2, 3 et 10 utilisations, ainsi qu’une formule de rentabilité valable pour n’importe quelle longueur de préfixe.
- Ce que ces règles impliquent pour les développeurs, aussi bien dans la conception de la structure des invites que dans l’organisation des tâches par lots.
Sommaire : on commence par un tableau conceptuel et un aperçu des impacts pour aligner la terminologie et identifier les personnes concernées ; la partie « Faits objectifs » rassemble les règles de cache, les prix et les données d’exemples issus de la documentation officielle ; la partie « Analyse et interprétation » explique la relation mathématique derrière le seuil de rentabilité, puis aborde la structure des invites, l’organisation des lots et les erreurs d’appréciation fréquentes.
OpenAI Prompt Caching To Know : explication des concepts
| Concept | Brève explication |
|---|---|
| Cache d’invite (Prompt Caching) | OpenAI met en cache les préfixes d’invite récurrents ; les requêtes suivantes qui touchent le cache sont facturées au tarif réduit de « lecture du cache » |
| Préfixe d’invite | Contenu contigu depuis le début de l’entrée d’une requête ; le cache correspond à un préfixe strictement identique, et non à un contenu au sens proche |
| Tokens d’entrée visibles | Tokens d’entrée pris en compte pour le seuil de cache ; les modèles GPT-5.6 et ultérieurs exigent au moins 1024 tokens pour pouvoir utiliser le cache |
| Écriture dans le cache | Facturation lors du premier stockage du préfixe dans le cache, calculée comme un multiple du prix d’entrée standard ; il s’agit d’un taux forfaitaire d’écriture |
| Lecture du cache | Facturation lorsqu’une requête ultérieure touche le cache, à un prix bien inférieur à celui de l’entrée standard |
| Cache de 30 minutes / 12 heures | Deux niveaux de durée de validité du cache, 30 minutes par défaut ; le niveau 12 heures est proposé dans l’API Responses, l’écriture y est plus chère |
| Niveau de traitement Standard | Niveau de traitement standard dans la grille tarifaire officielle ; les différents niveaux de traitement ont des prix différents et ne peuvent pas être mélangés |
| Niveau Short context | La grille tarifaire officielle distingue des niveaux selon la longueur du contexte ; cet article n’utilise que les prix du niveau à contexte court |
Aperçu rapide de l’impact du cache d’invites OpenAI
- Développeurs d’API : savoir si le cache permet d’économiser dépend du nombre de réutilisations et du taux de hits pendant sa durée de validité, pas du simple fait de « l’activer ». Avec l’option 30 minutes, deux utilisations au total (une première écriture suivie d’un hit) suffisent à coûter moins cher que sans cache ; l’option 12 heures a un coût d’écriture plus élevé et demande plus de réutilisations pour être amortie.
- Équipes qui développent des agents ou utilisent de longues invites système : placez les règles fixes, les descriptions d’outils et les longs documents en tête, et le contenu variable ensuite, pour que le préfixe soit réutilisé de manière stable par le cache. C’est un choix de conception de la structure, pas un réglage de paramètres.
- Équipes qui traitent des tâches par lots : regrouper les requêtes partageant le même préfixe et les envoyer pendant la durée de validité du cache permet d’augmenter nettement le taux de hits ; si les tâches sont étalées sur toute la journée, il faut évaluer si l’option 12 heures en vaut la peine.
- Responsables du calcul des coûts : le cache ne touche que la part des coûts d’entrée correspondant au préfixe fixe ; les sorties, les nouveaux éléments ajoutés, les appels d’outils et les nouvelles tentatives n’en font pas partie. Dans un tableau budgétaire, on ne peut donc pas appliquer directement le taux d’économie du cache à la facture totale.
Faits objectifs concernant le cache d’invites OpenAI
Source des informations et période de validité
Les données de cet article ont été vérifiées le 2026-11-17. Elles proviennent de la documentation officielle maintenue en continu par OpenAI : le guide sur la mise en cache des invites developers.openai.com/api/docs/guides/prompt-caching, ainsi que la page tarifaire developers.openai.com/api/docs/pricing.md. Ces documents étant mis à jour à tout moment et nous n’ayant pas vérifié la date de première publication des règles concernées, cet article n’est pas une actualité du jour : il s’agit d’une synthèse et d’une estimation basées sur les règles actuellement en vigueur.
Les règles de correspondance du cache d’invites
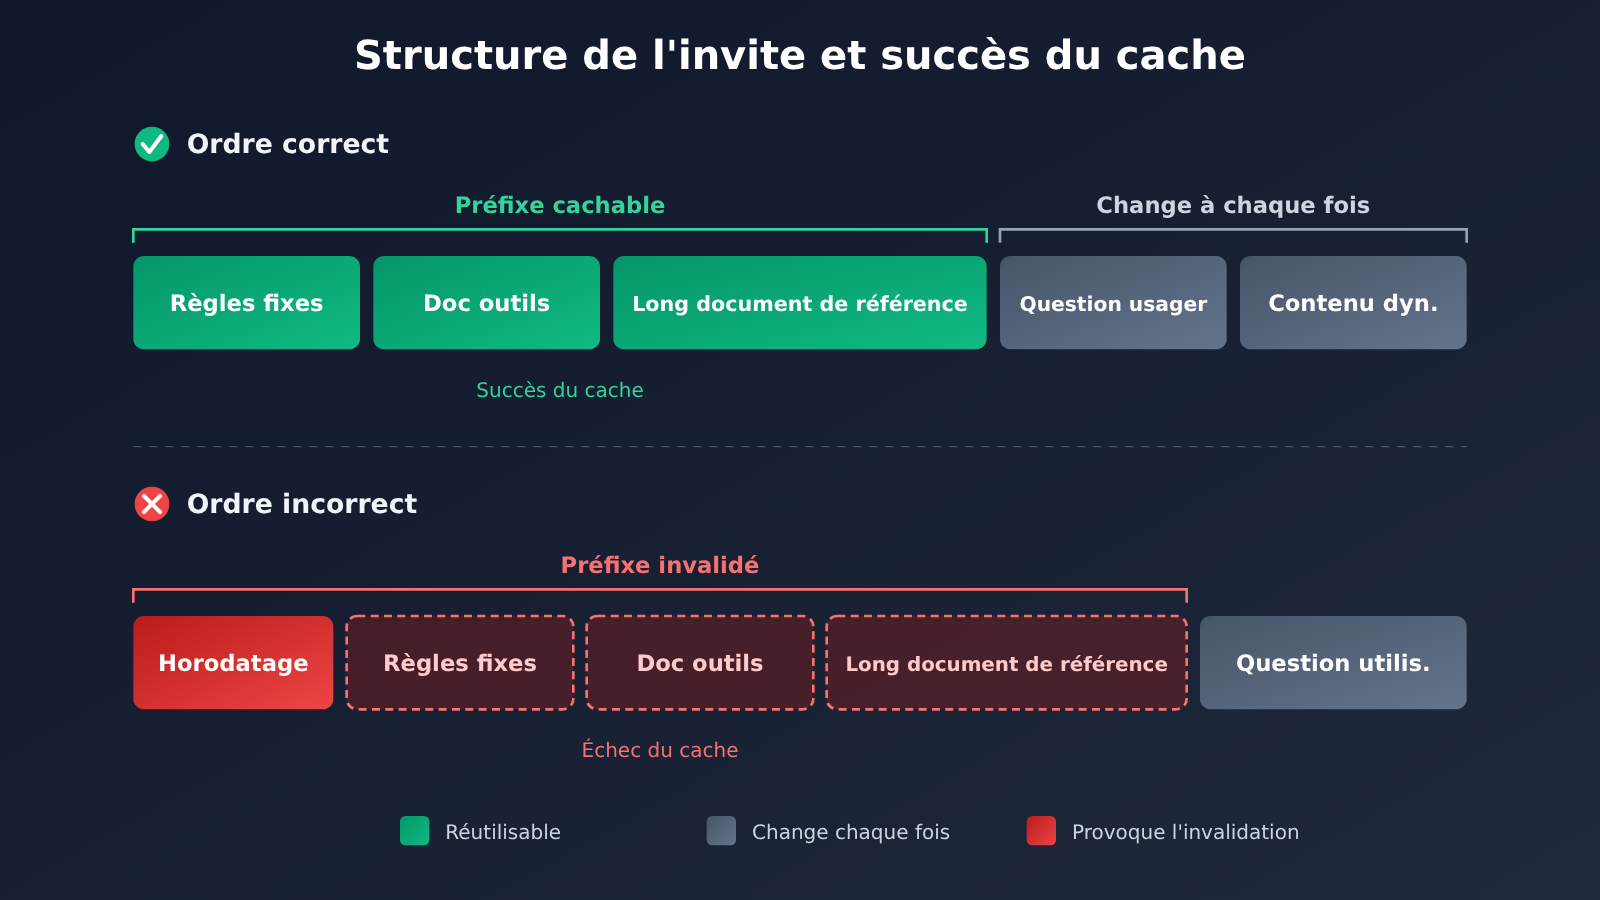
Ce à quoi correspond le cache d’invites d’OpenAI, c’est un préfixe d’invite identique. Deux invites peuvent avoir un sens presque identique : si le début de leur contenu diffère, il n’y aura pas de correspondance. Il ne s’agit pas d’une recherche par similarité sémantique. Autrement dit, la modification d’un seul caractère dans le préfixe — par exemple l’insertion de l’heure actuelle au début de l’invite système — peut faire perdre à tout le contenu qui suit la moindre chance de correspondance.
Pour les modèles GPT-5.6 et ultérieurs, le seuil de mise en cache est d’au moins 1024 jetons d’entrée visibles. Les règles applicables aux anciens modèles sont différentes : les conclusions de cet article sur la tarification et le seuil ne valent que pour les nouvelles règles décrites dans la documentation officielle, et ne peuvent pas être transposées directement aux anciens modèles.
Deux tarifs d’écriture de cache
| Niveau de cache | Tarif d’écriture (par rapport à l’entrée normale) | Remarque |
|---|---|---|
| 30 minutes (par défaut) | 1,25 fois | Durée de validité du cache par défaut |
| 12 heures | 2,5 fois | Proposé dans l’API Responses |
La documentation officielle est claire : ces deux multiplicateurs représentent bien le tarif d’écriture total. La première écriture est facturée à ce tarif, sans qu’on ajoute une deuxième fois le prix de l’entrée normale. Autre point à garder en tête : les 12 heures désignent la durée de validité du cache, pas le délai de suppression des données — les deux ne doivent pas être confondus.
Tarifs officiels de gpt-6-luna
Voici les prix de gpt-6-luna affichés sur la page de tarification officielle d’OpenAI, pour le niveau de traitement Standard et le niveau Short context, exprimés en dollars par million de tokens. Ces prix ne s’appliquent ni au niveau long contexte ni à d’autres niveaux de traitement, et ne correspondent pas non plus aux tarifs d’une plateforme tierce.
| Élément de facturation | Prix (USD / million de tokens) |
|---|---|
| Entrée normale | $0.10 |
| Sortie | $0.50 |
| Lecture de cache | $0.01 |
| Écriture de cache 30 minutes | $0.125 |
| Écriture de cache 12 heures | $0.25 |
On le voit : le prix d’écriture 30 minutes, $0.125, correspond exactement à 1,25 fois l’entrée normale, et le prix d’écriture 12 heures, $0.25, à 2,5 fois — ce qui colle aux règles de multiplicateurs décrites dans la documentation. Quant à la lecture de cache, elle ne coûte qu’un dixième de l’entrée normale.
Exemple de calcul selon le nombre de réutilisations
Les calculs ci-dessous sont des calculs théoriques dérivés des prix officiels, et non des mesures réelles. Les hypothèses sont les suivantes : un préfixe fixe de 10 000 tokens facturables, écrit intégralement dans le cache lors de la première utilisation, puis retrouvé dans le cache à chaque utilisation suivante, sans réécriture répétée.
| Nombre total d’utilisations | Sans cache | Cache 30 minutes | Cache 12 heures |
|---|---|---|---|
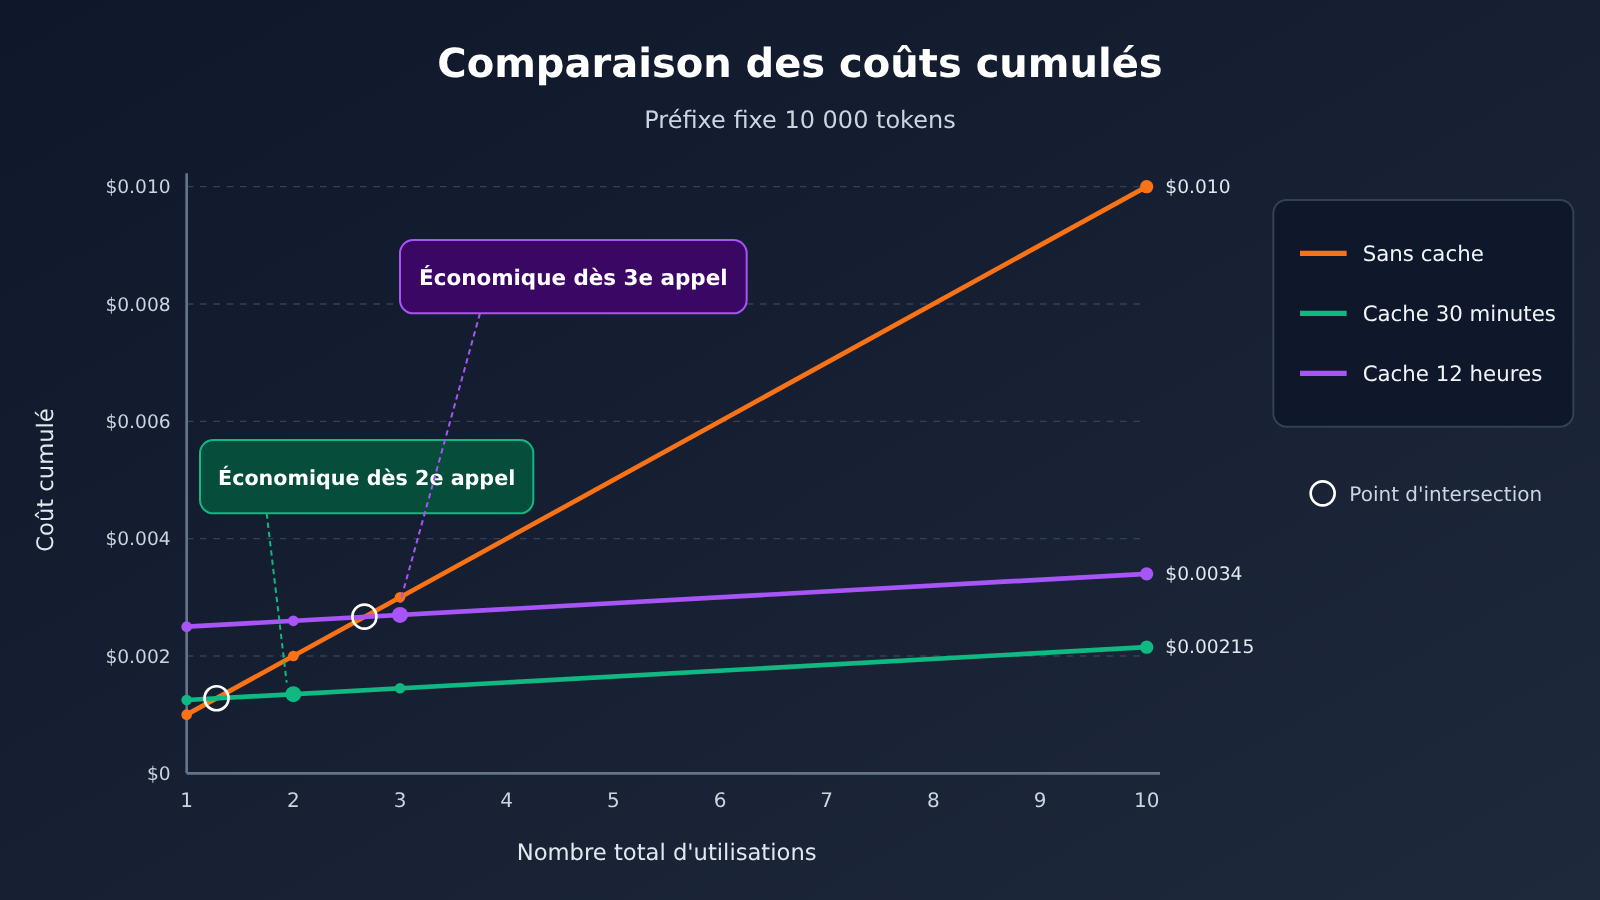
| 1 utilisation | $0.001 | $0.00125 | $0.0025 |
| 2 utilisations | $0.002 | $0.00135 | $0.0026 |
| 3 utilisations | $0.003 | $0.00145 | $0.0027 |
| 10 utilisations | $0.010 | $0.00215 | $0.0034 |
Dans ces hypothèses, le cache de 30 minutes devient moins cher que l’absence de cache à partir de la 2e utilisation cumulée, et le cache de 12 heures à partir de la 3e. Pour une seule utilisation, les deux caches coûtent plus cher que l’absence de cache, car vous payez le surcoût d’écriture sans bénéficier de la remise de lecture.
Limites d’application de l’exemple de calcul
Cette série de chiffres ne prend en compte que la partie correspondant au préfixe fixe. Les éléments ajoutés à chaque requête — nouveaux matériaux, sorties du modèle, appels d’outils et nouvelles tentatives en cas d’échec — n’entrent pas dans le calcul. Il ne s’agit donc pas d’une remise sur l’ensemble de la requête. Si l’intervalle entre deux utilisations dépasse la durée de validité du cache, les requêtes suivantes ne peuvent plus être comptabilisées comme « entièrement en cache » : il faut rajouter le coût de la réécriture.
Analyse et évaluation du cache d’invites d’OpenAI
Pourquoi les seuils de rentabilité sont-ils de 2 et 3 utilisations ?
En généralisant l’exemple à un nombre d’utilisations N quelconque, on peut écrire trois droites de coût (en dollars par million de tokens de préfixe) :
- Sans cache : 0,10 × N
- Cache 30 minutes : 0,125 + 0,01 × (N − 1)
- Cache 12 heures : 0,25 + 0,01 × (N − 1)
En posant que le coût avec cache doit être inférieur au coût sans cache, le palier 30 minutes exige N supérieur à environ 1,28, autrement dit il devient rentable dès la 2e utilisation ; le palier 12 heures exige N supérieur à environ 2,67, soit rentable à partir de la 3e. Cette conclusion est indépendante de la longueur du préfixe, car les trois droites de coût sont proportionnelles au nombre de tokens : que le préfixe passe de 2 000 à 50 000 tokens, le nombre d’utilisations nécessaires à l’amortissement ne change pas, seule change la somme absolue économisée. La condition reste que le préfixe atteigne le seuil de 1 024 tokens et que le palier tarifaire soit identique.
Structurellement, la surprime d’écriture est un coût unique, tandis que l’économie apportée par chaque succès du cache correspond à la différence entre le prix d’entrée normal et le prix de lecture du cache, soit 0,09 $ économisé par million de tokens. La surprime du palier 30 minutes n’est que de 0,025 $, couverte dès un seul succès ; celle du palier 12 heures atteint 0,15 $, et il faut deux succès pour la couvrir. Voilà pourquoi les deux seuils de rentabilité diffèrent d’une utilisation.
Un script de calcul de rentabilité réutilisable
Le script ci-dessous reproduit les exemples de calcul selon les hypothèses de cet article. Vous pouvez remplacer les prix et le nombre d’utilisations pour évaluer rapidement votre propre scénario. Pour les paramètres de prix, référez-vous aux valeurs les plus récentes de la page tarifaire officielle.
# Selon les prix officiels de gpt-6-luna Standard / Short context (USD / million de tokens)
INPUT = 0.10
CACHE_READ = 0.01
WRITE = {"30min": 0.125, "12h": 0.25}

def prefix_cost(prefix_tokens: int, uses: int, mode: str | None) -> float:
    """Calcule uniquement le coût du préfixe fixe ; suppose une première écriture complète, puis uniquement des lectures en cache, sans réécriture"""
    m = prefix_tokens / 1_000_000
    if mode is None:
        return INPUT * uses * m
    return (WRITE[mode] + CACHE_READ * (uses - 1)) * m

for n in (1, 2, 3, 10):
    base = prefix_cost(10_000, n, None)
    c30 = prefix_cost(10_000, n, "30min")
    c12 = prefix_cost(10_000, n, "12h")
    print(f"{n:>2} 次  不缓存 ${base:.5f}  30分钟 ${c30:.5f}  12小时 ${c12:.5f}")
Le résultat d’exécution correspond au tableau d’exemples ci-dessus. Si, dans votre cas réel, certaines requêtes ne profitent pas du cache, vous pouvez traiter ces occurrences comme des « réécritures » ; le seuil de rentabilité se décalera d’autant.
La structure de l’invite compte plus que l’interrupteur
Comme le cache ne reconnaît qu’un préfixe strictement identique, l’ordre des éléments dans l’invite détermine directement le taux de réussite du cache. L’approche la plus sûre consiste à placer en tout premier les règles système fixes, la définition du rôle, les définitions d’outils et les documents de référence, puis à reléguer en fin d’invite tout ce qui change à chaque appel : question de l’utilisateur, résultats de recherche, horodatage, etc. Dès qu’un champ variable se glisse au début du préfixe, tout le contenu fixe qui suit, aussi long soit-il, ne peut plus être réutilisé.
Il y a aussi une idée fausse fréquente qui mérite d’être signalée à part : bourrer l’invite de contenu sans rapport uniquement pour atteindre le seuil de 1024 tokens n’est pas rentable. Les tokens de remplissage sont facturés la première fois au tarif d’écriture en cache, puis à chaque appel au tarif de lecture du cache, et ils risquent en plus de brouiller la compréhension des véritables instructions par le modèle. Le seuil sert à rappeler qu’une invite courte n’a de toute façon pas besoin de cache, pas à encourager à rallonger une invite courte.
Le regroupement en lots détermine si tous les appels touchent le cache
L’autre hypothèse clé de l’exemple de calcul, c’est que toutes les requêtes suivantes touchent le cache. Dans la réalité, si les requêtes partageant le même préfixe sont éparpillées sur toute une journée, le palier de 30 minutes aura fort probablement expiré entre deux requêtes : on réécrit à chaque fois, et cela coûte plus cher que de ne pas cacher du tout. Deux approches sont alors possibles : d’une part, regrouper les tâches du même type en lots et les envoyer à la suite dans un intervalle de 30 minutes ; d’autre part, évaluer le palier de 12 heures, en payant une écriture initiale plus élevée pour obtenir une durée de validité plus longue.
On peut réduire le choix à un jugement empirique : si les requêtes sont denses et rapprochées, on prend le palier par défaut de 30 minutes, et il suffit de 2 utilisations au total pour devenir moins cher que sans cache ; si les requêtes sont clairsemées mais qu’un même préfixe est réutilisé plusieurs fois dans la même journée, et que le nombre total d’utilisations atteint régulièrement 3 ou plus, alors le palier de 12 heures devient pertinent. Si un segment de préfixe n’a très probablement qu’une seule utilisation pendant sa durée de validité, ne pas cacher est l’option la moins chère.
Les éléments souvent surestimés dans le calcul des coûts
Le chiffre d’environ 78.5 % d’économie sur 10 utilisations est frappant, mais il ne concerne que le coût d’entrée du préfixe fixe. Dans la structure tarifaire de gpt-6-luna, le prix de sortie vaut 5 fois celui d’une entrée ordinaire : si les sorties d’une application sont longues, ou si chaque requête s’accompagne d’une grande quantité de nouveaux documents récupérés, l’argent économisé grâce au cache de préfixe peut ne représenter qu’une part modeste de la facture totale. Pour établir un budget, la démarche plus raisonnable consiste à découper la requête en plusieurs blocs — « préfixe fixe », « entrée dynamique », « sortie », « outils et nouvelles tentatives » — et à les estimer séparément, en n’appliquant la formule du cache qu’au premier bloc.
Par ailleurs, la règle du multiplicateur d’écriture décrite ici s’applique aux modèles GPT-5.6 et ultérieurs ; les prix concrets de l’exemple de calcul ne correspondent qu’au palier de traitement Standard et au palier contexte court de gpt-6-luna. Si l’on passe à un modèle plus ancien, à un palier de contexte long ou à un autre palier de traitement, il faut consulter à nouveau les tarifs et refaire le calcul, ce qui peut aussi modifier le nombre d’utilisations nécessaires pour rentabiliser. La documentation officielle est mise à jour en continu : si les règles évoluent par la suite, il faudra s’en remettre à la documentation du moment. Ce point relève des variables à surveiller en permanence, et non de changements déjà survenus.
Xunzi écrivait dans Exhortation à l’étude : « Entassez la terre pour former une montagne, et voilà que vents et pluies s’y déchaînent ; accumulez l’eau pour former un gouffre, et voilà que dragons et serpents y prennent vie. » Il en va de même pour les comptes du cache d’invites : une écriture n’est qu’une dépense, et la véritable économie vient de la réutilisation stable, encore et encore, pendant la durée de validité.


