
Le 9 novembre 2026, Anthropic a présenté Claude Fable 5.2 et dévoilé une expérience menée en interne. Tout est parti d’un dossier vide : Fable 5.2 a coordonné plus de 1 000 sous-agents pendant 8 jours sans interruption pour créer un prototype de système d’exploitation capable de démarrer sur un ordinateur portable.
L’intérêt de cet article : plutôt que de reprendre le discours promotionnel, nous nous appuyons sur les ressources publiques d’Anthropic consacrées à l’ingénierie multi-agents pour expliquer les rôles respectifs de l’Orchestrator, des Subagents, de l’Advisor et des Workflows. Nous verrons comment découper les tâches, pourquoi les coûts augmentent et comment concevoir un système fiable. En conclusion, vous trouverez une liste de pratiques directement applicables par les développeurs.
Les informations essentielles sur l’expérience de création d’un système d’exploitation avec Claude Fable 5.2
Commençons par distinguer les faits confirmés des éléments qui n’ont pas été dévoilés. C’est indispensable pour comprendre les défis de la collaboration multi-agents.
| Élément | Détails |
|---|---|
| Date de publication | 9 novembre 2026, lors de la présentation de Claude Fable 5.2 |
| Éditeur | Anthropic |
| Point de départ | Un dossier vide ; la tâche consistait à concevoir et à réaliser un prototype de système d’exploitation |
| Ampleur de l’exécution | Plus de 1 000 sous-agents pendant 8 jours, travaillant en continu à écrire, tester, examiner et modifier du code |
| Résultat final | Un système prototype comprenant un noyau, des pilotes de disque, de clavier et de réseau, un stockage permanent des fichiers, un système de fenêtrage, une interface de connexion, un programme d’installation et des fonctionnalités Claude intégrées. Il peut démarrer sur un véritable ordinateur portable. |
| Informations non communiquées | Structure de répartition des tâches entre les agents, harness, protocole de communication, volume de code, langages de programmation, consommation totale de tokens, coût de l’expérience et audit de sécurité indépendant |
Anthropic parle d’un working prototype operating system, autrement dit d’un « prototype de système d’exploitation fonctionnel », et non d’un système d’exploitation commercial abouti. Il faut également noter qu’Anthropic a présenté d’autres expériences à la même période. Celle sur le dernier théorème de Fermat, par exemple, faisait état d’une structure composée d’un responsable et de 999 assistants. Mais il s’agissait d’une expérience distincte : on ne peut pas transposer directement cette organisation au projet de système d’exploitation.
L’intérêt de cette expérience ne tient pas tant à la quantité de code produite qu’à la capacité du modèle à piloter un projet logiciel de longue durée pendant huit jours : découper les tâches, mener plusieurs travaux en parallèle, regrouper les résultats, repérer les erreurs et organiser les corrections. D’où la question centrale de cet article : avec 1 000 agents, le véritable défi, c’est l’organisation.
Comment fonctionne la collaboration multi-agent : la répartition des rôles derrière Claude Fable 5.2
Avant de se demander s’il faut utiliser plusieurs agents, clarifions quelques notions souvent confondues. Le tableau ci-dessous résume les concepts présentés dans la documentation Anthropic Managed Agents.
| Concept | Rôle | Exemple typique |
|---|---|---|
| Agent | Agent capable d’exécuter des tâches et d’utiliser des outils | Un assistant de programmation capable de lire du code et de lancer des tests |
| Orchestrateur | Responsable de la répartition des tâches et de la synthèse des résultats | Décomposer « créer un système de blog » en plusieurs modules, puis en faire la synthèse |
| Sous-agent | Agent chargé d’une sous-tâche déléguée, avec son propre contexte | Implémenter le module de commentaires et écrire les tests correspondants |
| Conseiller | N’exécute pas la tâche lui-même, mais fournit des conseils spécialisés aux étapes clés | Demander conseil à un modèle plus puissant lorsque l’agent principal est bloqué |
| Workflow | Processus qui organise l’ordre des tâches, leur exécution en parallèle et la transmission des résultats | Programme en plusieurs étapes : « recherche → implémentation → revue → recommencer en cas de refus » |
| Harness | Système externe qui appelle le modèle et les outils, et gère l’exécution | Votre propre code d’orchestration ou une plateforme d’agents hébergée |
Les trois modes de collaboration multi-agent
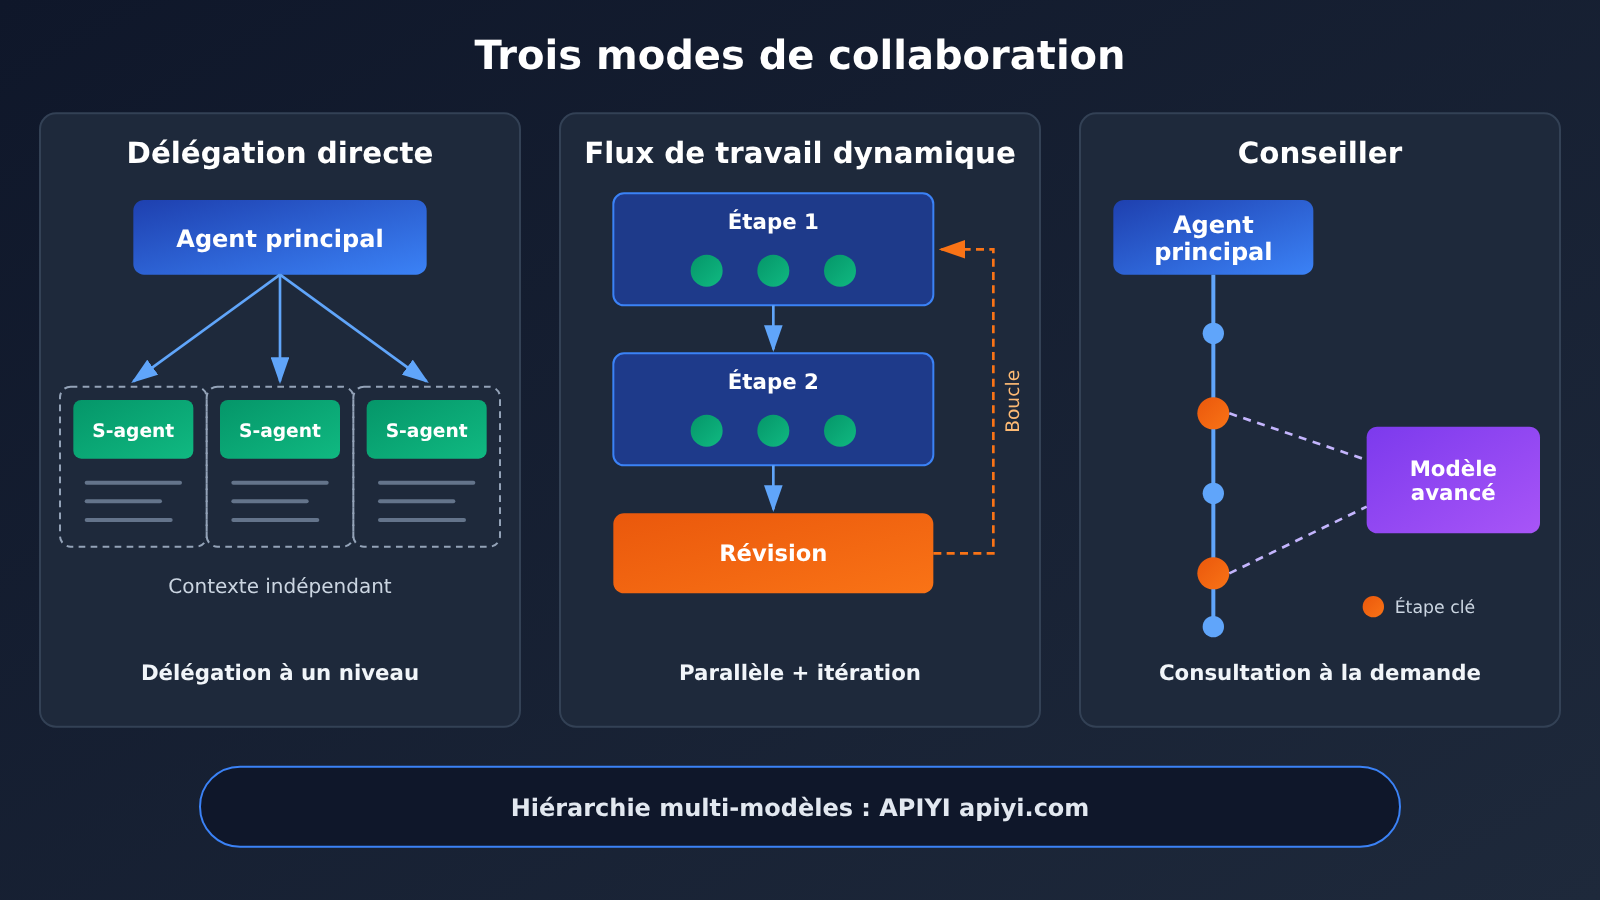
La documentation Anthropic Managed Agents distingue trois modes de collaboration multi-agent, chacun adapté à des situations différentes.
- Délégation directe à des sous-agents : l’agent principal décide lui-même quels sous-agents créer, quelles tâches leur confier, quand consulter leurs résultats et s’il faut leur demander des précisions. Chaque sous-agent dispose de son propre fil de session, mais la délégation ne comporte qu’un seul niveau : une session peut compter jusqu’à 25 fils directs. Ce mode convient à quelques tâches spécialisées qui nécessitent un suivi continu.
- Workflows dynamiques : au lieu de gérer les sous-agents un par un, l’agent principal génère un programme de workflow. Celui-ci peut définir des étapes, exécuter plusieurs agents en parallèle, transmettre les résultats, choisir l’étape suivante en fonction de ces résultats et répéter l’exécution si la revue n’est pas concluante, jusqu’à atteindre le nombre maximal de cycles. Ce mode convient à des tâches comme la revue d’un grand nombre de fichiers ou la migration de code réparti entre plusieurs modules.
- Mode conseiller : l’agent principal continue d’effectuer la tâche lui-même et ne consulte un modèle plus puissant qu’aux étapes difficiles ou décisives. Ce mode évite de fragmenter le travail et réduit au minimum les coûts de coordination.
Un exemple concret permet de mieux comprendre la différence. Imaginons qu’il faille migrer de Python vers Go le back-office d’un site de commerce en ligne : pour ne migrer que les modules de paiement et de gestion des stocks, la délégation directe suffit ; pour migrer 200 interfaces indépendantes et les examiner une par une, mieux vaut un workflow dynamique ; si un agent de niveau ingénieur travaille seul et a seulement besoin, à l’occasion, qu’un modèle senior examine la conception des transactions de la base de données, le mode conseiller est le plus avantageux.
Quand ajouter des agents : la bonne façon de répartir les tâches entre plusieurs agents
Dans son article du 23 janvier 2026, « Building multi-agent systems: When and how to use them », Anthropic décrit un phénomène bien réel : certaines équipes passent des mois à créer des systèmes multi-agents complexes, avant de découvrir qu’améliorer l’invite d’un agent unique suffit à obtenir des résultats comparables. La première question à se poser est donc toujours « faut-il répartir la tâche ? », et non « en combien d’agents ? ».
Trois situations où les agents multiples apportent une réelle valeur
D’après cet article, les agents multiples créent une valeur constante dans trois grands types de situations :
- Isolation du contexte : un agent de service client peut, par exemple, commencer par consulter un historique détaillé des commandes avant de diagnostiquer un problème technique. Les données sur les commandes encombrent alors le contexte et risquent de fausser son jugement. En confiant la recherche des commandes à un agent distinct, qui ne transmet qu’un résumé essentiel, l’agent principal conserve toute sa lucidité.
- Traitement en parallèle : étudier séparément les marchés de différentes régions, examiner plusieurs documents en parallèle ou contrôler simultanément différents modules de code. Anthropic souligne que, dans ce type d’architecture, le principal avantage consiste souvent à couvrir davantage d’aspects et à rendre le travail plus complet, plutôt qu’à garantir un temps total plus court.
- Répartition spécialisée des rôles : configurer les agents avec des prompts système, des outils, des serveurs MCP, des Skills et des modèles différents permet d’éviter qu’un seul agent ait trop de responsabilités à assumer.
Répartir les tâches selon les limites du contexte, pas selon les rôles
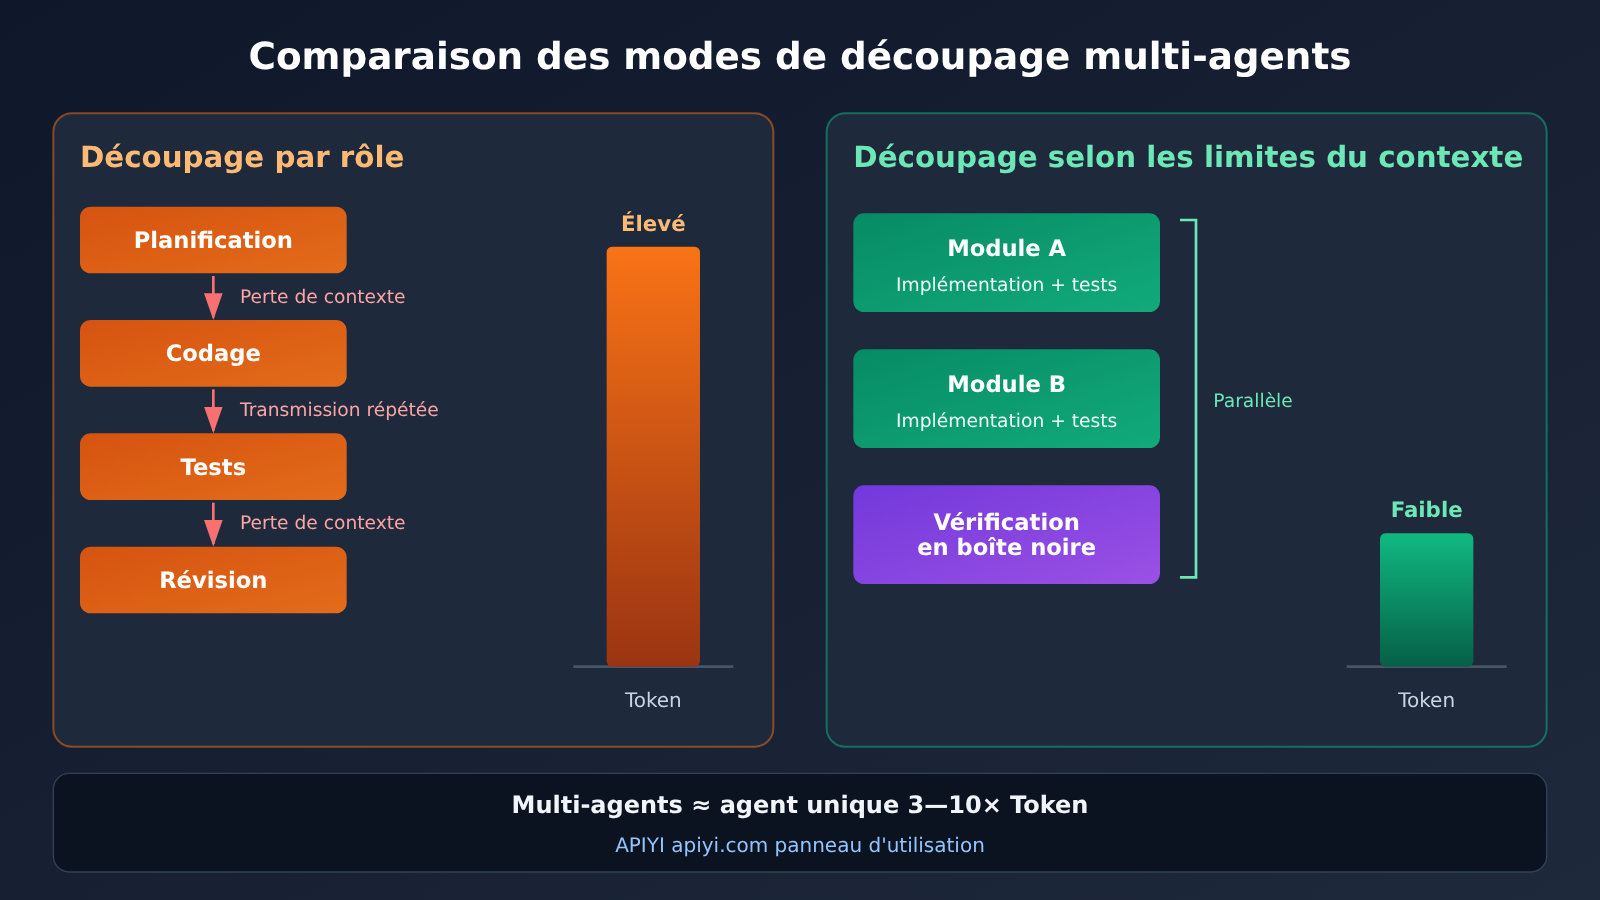
Le principe de conception proposé par Anthropic est la décomposition centrée sur le contexte (Context-centric decomposition) : il faut répartir les tâches selon les limites du contexte, plutôt que de les découper mécaniquement selon les étapes d’un problème. La première idée de nombreuses équipes est de créer un « agent de planification + un agent de codage + un agent de test + un agent de révision ». Cela ressemble à une équipe de développement bien organisée, mais pose en réalité plusieurs problèmes.
L’agent de test ignore les raisons qui ont guidé la conception du code, l’agent de révision ne connaît pas les explorations menées en amont, et les informations transmises d’un agent à l’autre risquent de se déformer, comme dans le jeu du téléphone arabe. Une approche plus pertinente consiste à confier à un agent un module fonctionnel complet, avec son implémentation et les tests associés ; à un autre, un module doté d’une interface indépendante ; et à un troisième, une vérification en boîte noire, à partir du résultat à tester, de critères de validation explicites et des outils de test.
| Type de tâche | Pertinence des agents multiples | Raison |
|---|---|---|
| Études de marché indépendantes dans plusieurs régions | Élevée | Les sous-tâches partagent très peu d’informations |
| Révision en parallèle d’un grand nombre de documents | Élevée | Chaque document peut être traité indépendamment, puis les résultats sont regroupés |
| Développement indépendant de différents modules | Élevée | Lorsque les interfaces sont claires, les limites du contexte sont naturelles |
| Tests et validation indépendants | Élevée | Une vérification en boîte noire ne nécessite que le résultat et les critères |
| Modifications de code fortement interdépendantes | Faible | Une modification en entraîne plusieurs autres, et le coût de coordination est élevé |
| Tâches nécessitant le partage d’un grand volume d’informations en temps réel | Faible | La synchronisation de l’état peut coûter plus que ce que le parallélisme permet de gagner |
| Recherche de faits simples | Généralement inutile | Un agent unique peut répondre en un seul appel |
Pour revenir aux travaux pratiques sur les systèmes d’exploitation, le noyau, les pilotes, le système de fichiers et le système de fenêtres ont des limites de modules relativement claires. C’est aussi l’une des raisons pour lesquelles ces travaux se prêtent davantage au parallélisme à grande échelle qu’une « refonte majeure d’un système métier complexe ». Bien sûr, Anthropic n’a pas révélé la répartition précise des tâches : il s’agit donc d’une hypothèse raisonnable, et non d’un fait avéré.
Pourquoi les systèmes multi-agents coûtent plus cher : le bilan des tokens à l’ère de Claude Fable 5.2
On pourrait penser que répartir une tâche entre davantage d’agents travaillant en parallèle permet de réduire les coûts. En pratique, c’est souvent l’inverse. Dans un article publié en janvier 2026, Anthropic indique clairement que, pour une même tâche, une architecture multi-agents utilise généralement 3 à 10 fois plus de tokens qu’un agent unique.
Ces tokens supplémentaires proviennent principalement de cinq sources : chaque agent doit créer son propre contexte ; les agents échangent des descriptions de tâches et des résultats ; l’agent principal doit lire et synthétiser les sorties de plusieurs sous-agents ; la décomposition des tâches entraîne des appels supplémentaires ; enfin, plusieurs agents peuvent refaire une partie du même travail.
Deux ensembles de données, deux références différentes
Quand on parle du coût des systèmes multi-agents, on mélange souvent des données qui proviennent de sources différentes. Le tableau ci-dessous les distingue :
| Source des données | Indicateur | Référence de comparaison |
|---|---|---|
| « Building multi-agent systems », janvier 2026 | La consommation de tokens d’un système multi-agents est de 3 à 10 fois celle d’un agent unique | Un agent unique pour une même tâche |
| Système Anthropic Research, juin 2025 | Environ 15 fois la consommation de tokens d’une conversation classique | Une conversation classique |
| Système Anthropic Research, juin 2025 | Sur l’Anthropic Research Eval interne, le résultat dépasse de 90,2 % celui d’Opus 4 avec un agent unique | Opus 4 avec un agent unique, sur une évaluation interne spécifique |
| Système Anthropic Research, juin 2025 | Le temps consacré à la recherche sur les requêtes complexes diminue jusqu’à environ 90 % ; au début, 3 à 5 sous-agents travaillaient généralement en parallèle | La recherche menée en série par le même système |
Il faut souligner que les chiffres de 90,2 % et de 15 fois proviennent tous deux du système Research de 2025. Le premier correspond uniquement à une performance relative sur une évaluation interne spécifique : cela ne signifie pas que la précision augmente de 90,2 % pour toutes les tâches. Ces chiffres n’ont aucun lien avec les expériences sur les systèmes d’exploitation de 2026 et ne peuvent pas être comparés directement au facteur de 3 à 10.
La charge de calcul totale, le temps d’exécution et la couverture sont trois choses distinctes
Pour comprendre le coût des systèmes multi-agents, il faut distinguer trois indicateurs. La charge de calcul totale augmente généralement, car le contexte est dupliqué et les résultats lus plusieurs fois. Le temps d’exécution peut diminuer, à condition que les sous-tâches soient réellement indépendantes. Quant à la couverture des tâches, elle tend à s’améliorer, puisque plusieurs agents peuvent explorer davantage de pistes en même temps.
D’après les tarifs officiels de l’API, le mode standard de Fable 5.2 coûte 8 dollars par million de tokens en entrée et 40 dollars par million en sortie. L’API Batch donne droit à une réduction de 50 %, et la lecture du cache coûte 0,20 dollar par million de tokens. Si une tâche réalisée par un seul agent consomme déjà beaucoup de tokens, multiplier cette consommation par 3 à 10 peut creuser considérablement l’écart. Anthropic n’a pas publié la facture réelle de l’expérience sur les systèmes d’exploitation. Toute affirmation sur « le coût de huit jours de travail » est donc sans fondement.
Comment concevoir un système multi-agent fiable : les méthodes d’ingénierie à retenir de Claude Fable 5.2
Hiérarchiser les modèles : tous les agents n’ont pas besoin du modèle le plus puissant
Managed Agents propose deux façons de définir un agent. Un Predefined Agent est configuré à l’avance et peut avoir son propre modèle, son propre System Prompt, ses outils, ses serveurs MCP et ses Skills. Un Inline Agent est défini dynamiquement au moment de l’exécution et reprend par défaut la configuration du modèle et des outils de l’agent principal.
Cela permet de répartir les coûts et les capacités : réserver un modèle puissant comme Fable 5.2 à la coordination et aux vérifications complexes, utiliser un modèle de niveau Sonnet pour les recherches documentaires courantes et un modèle de niveau Haiku pour les classifications simples. Il s’agit d’un exemple de conception, et non d’une architecture imposée par Anthropic. Il faut la tester et l’ajuster en fonction des tâches réelles.
Vérification : un agent de revue ne remplace pas une vraie validation
Dans sa documentation sur le prompting de Fable 5.2, Anthropic évoque un changement récent : avec des niveaux d’effort élevés, comme xhigh ou max, Fable 5.2 fait désormais appel de lui-même à un sous-agent pour vérifier son travail. Fable 5.1 n’adoptait pas ce comportement sur les mêmes tâches de test. C’est un progrès en matière d’orchestration, mais il ne faut pas y voir une garantie de qualité.
Un agent de revue se fie, au fond, au jugement d’un modèle. Pour obtenir une validation vraiment fiable, il faut trois éléments : des critères d’acceptation clairement définis, des tests en boîte noire exécutables et une vérification concrète du code et des modifications apportées aux systèmes externes — par exemple, lancer réellement les tests et démarrer le service. L’expérience menée sur le système d’exploitation est convaincante précisément parce qu’elle repose sur un résultat concret — « pouvoir démarrer sur un véritable ordinateur portable » — et non sur un agent qui affirme que « tout semble en ordre ».
Éviter la délégation excessive et l’accumulation de règles
La décision d’un agent de déléguer une tâche dépend non seulement des capacités du modèle, mais aussi du Harness et des instructions données aux outils. Lors de ses tests, Anthropic a constaté que, lorsque les instructions de l’outil Subagent précisent « le coût supplémentaire de chaque sous-agent, les tâches qui méritent d’être déléguées, celles qui ne le méritent pas et comment décrire une tâche », le modèle délègue environ un tiers moins souvent sur les tâches courtes que dans la version qui se contente d’insister sur les raisons de déléguer. Le taux de réussite reste, lui, inchangé.
L’accumulation de règles est un autre problème facile à négliger. Fable 5.2 suit assez strictement les consignes restrictives accumulées dans le contexte. Si les fichiers historiques, les avis des réviseurs et le System Prompt multiplient les interdictions, le modèle risque de ne plus oser effectuer certaines actions pourtant autorisées dans son travail quotidien. Il faut donc nettoyer régulièrement la mémoire de l’agent, ses règles et ses exigences d’approbation.
Limites d’exécution : les véritables plafonds des produits publics
Les « 1 000 agents » ont aussi des limites bien définies dans les produits publics. Voici les restrictions indiquées dans la documentation de Managed Agents. Elles concernent les produits publics et ne signifient pas que les expériences menées avec le système d’exploitation interne utilisent le même ordonnanceur :
| Indicateur | Limite |
|---|---|
| Sous-agents directs | 25 au maximum |
| Agents de travail simultanés dans un Dynamic Workflow | 64 |
| Agents lancés au cours du cycle de vie d’un seul Workflow | 1 000 |
| Durée de vie par défaut d’un Workflow | 24 heures |
| Workflows ouverts simultanément par Session, par défaut | 10 |
De plus, les agents d’un Workflow ne peuvent pas créer de Workflow imbriqué. Une fois le budget atteint, le Workflow en cours est suspendu. Lorsqu’un agent échoue, le système réessaie généralement une fois ; en cas de nouvel échec, le Workflow détermine la suite à donner. Autrement dit, les 1 000 agents correspondent au nombre cumulé d’agents lancés pendant le cycle de vie : à un instant donné, le nombre d’agents réellement actifs est bien inférieur.
Les longues tâches posent aussi un problème d’expérience utilisateur : pendant les appels prolongés à des outils, Fable 5.2 peut n’envoyer que très peu de messages à l’utilisateur, qui risque alors de croire que la tâche est bloquée. La documentation recommande d’activer thinking.display: "updates" ou de demander au Harness de rappeler au modèle de communiquer sa progression après plusieurs appels d’outils consécutifs. Lors des tests officiels, les rappels de progression ont réduit d’environ moitié la plus longue période sans retour.
Prise en main rapide du multi-agent : créer un orchestrateur minimal avec Claude Fable 5.2
L’exemple ci-dessous ne dépend d’aucune plateforme hébergée. Il utilise une interface compatible avec OpenAI pour montrer le principe de base : le modèle coordinateur répartit les tâches selon les frontières du contexte.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface compatible avec OpenAI d’APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",  # Utilisez le nom réellement indiqué dans la liste des modèles de la plateforme
    messages=[{"role": "user", "content": "把“为博客增加评论功能”按上下文边界拆成子任务,每个子任务包含实现和测试,输出 JSON"}]
)
print(resp.choices[0].message.content)
La version complète ajoute une hiérarchie de modèles, l’exécution en parallèle, un budget de jetons, une nouvelle tentative en cas d’échec et une validation en boîte noire. Sa structure reprend les méthodes d’ingénierie présentées plus haut :
Afficher le code complet de l’exemple d’orchestration multi-agent
import json
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé pour appeler plusieurs modèles
)

ORCHESTRATOR_MODEL = "claude-fable-5-2"   # Modèle puissant pour la coordination et la validation
WORKER_MODEL = "your-fast-model"          # Modèle plus rapide et moins coûteux pour les sous-tâches, à remplacer selon les besoins
TOKEN_BUDGET = 200_000                     # Budget de jetons pour l’ensemble de la tâche
used_tokens = 0


def call(model, system, user):
    global used_tokens
    if used_tokens >= TOKEN_BUDGET:
        raise RuntimeError("超出预算,暂停工作流")
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "system", "content": system},
                  {"role": "user", "content": user}],
    )
    used_tokens += r.usage.total_tokens
    return r.choices[0].message.content


def plan(goal):
    text = call(ORCHESTRATOR_MODEL,
                "你是协调者。按上下文边界拆分任务,简单任务不要拆。"
                "只输出 JSON 数组,每项含 name、spec、acceptance 字段。",
                goal)
    return json.loads(text)


def run_subagent(task):
    # Chaque sous-agent ne reçoit que le contexte dont il a besoin ; en cas d’échec, réessayez une fois
    for _ in range(2):
        try:
            return call(WORKER_MODEL,
                        "你负责一个完整模块,同时给出实现和测试。",
                        f"任务:{task['spec']}\n验收标准:{task['acceptance']}")
        except Exception:
            continue
    return "FAILED"


def review(task, output):
    # Validation en boîte noire : ne fournir que le résultat et les critères, pas le processus d’exploration
    return call(ORCHESTRATOR_MODEL,
                "你是审核者,只依据验收标准判断,输出 PASS 或 FAIL 及理由。",
                f"验收标准:{task['acceptance']}\n成果:{output}")


if __name__ == "__main__":
    tasks = plan("为博客系统增加评论功能,含后端接口与前端组件")
    with ThreadPoolExecutor(max_workers=4) as pool:  # Limiter le nombre de tâches exécutées en parallèle
        outputs = list(pool.map(run_subagent, tasks))
    for t, o in zip(tasks, outputs):
        print(t["name"], "->", review(t, o)[:80])
    print("累计 Token:", used_tokens)
Ce code illustre uniquement la structure : l’étape de validation repose encore sur le jugement du modèle. En production, remplacez review par de vrais tests, ou complétez-la avec leur exécution, par exemple en lançant des tests unitaires ou en démarrant le service pour vérifier ses interfaces.
🚀 Conseil pour bien démarrer : avec plusieurs agents, l’essentiel est d’attribuer des modèles différents aux différents rôles et de pouvoir comparer leur consommation à tout moment. Nous vous conseillons de passer par APIYI (apiyi.com) pour connecter Claude, OpenAI, Gemini et d’autres modèles avec une seule clé API. Commencez par établir une référence avec un agent unique, en utilisant le crédit d’essai gratuit réservé aux nouveaux utilisateurs, puis ajoutez progressivement une couche de collaboration.
Analyse de l’impact de la collaboration entre agents sur les développeurs
Impact sur les développeurs
- Commencer par un agent unique : établissez d’abord une référence avec un agent unique et une invite bien conçue. N’ajoutez une couche de collaboration que si vous rencontrez l’un de ces trois obstacles : le contexte est pollué, les sous-tâches peuvent être exécutées en parallèle de façon indépendante ou une configuration spécialisée est nécessaire.
- Considérer l’infrastructure comme un élément essentiel : les API des modèles et des outils, les plafonds budgétaires, le contrôle de la concurrence et les journaux d’appels déterminent la capacité d’un système multi-agents à fonctionner de manière fiable. Sans journaux, impossible de savoir quel agent secondaire répète inutilement le travail.
- La répartition entre plusieurs modèles devient la norme : faire appel à des modèles différents pour la coordination, l’exécution et la vérification est l’un des principaux moyens de maîtriser la multiplication des coûts, qui peut atteindre 3 à 10 fois le montant initial.
Impact sur le secteur
- Les limites des capacités de l’IA s’élargissent : on passe de « réaliser une tâche de programmation » à « organiser un projet d’ingénierie logicielle de longue durée ». Les retours des premiers partenaires de test, comme Vercel, Shopify et Datadog, vont dans ce sens. Un ingénieur de Datadog a notamment décrit le système comme un « commandant des incidents » capable de déléguer des tâches à des modèles plus rapides. Il faut toutefois garder à l’esprit qu’il s’agit de retours de partenaires publiés lors du lancement, et non de résultats issus de tests indépendants en aveugle.
- L’orchestration compte plus que le nombre d’agents : le degré de parallélisation des tâches, le coût de la coordination, l’état partagé, les conflits de code, la couverture des tests et le coût des appels déterminent ensemble l’efficacité réelle d’un système multi-agents.
FAQ
Q1 : Qu’a réellement accompli l’expérience des 1 000 agents de Claude Fable 5.2 ?
Anthropic indique que Fable 5.2 est parti d’un dossier vide et a coordonné plus de 1 000 agents secondaires pendant 8 jours consécutifs pour créer un prototype de système d’exploitation capable de démarrer sur un véritable ordinateur portable. Celui-ci comprend un noyau, des pilotes, un système de stockage de fichiers, un gestionnaire de fenêtres, une interface de connexion et un programme d’installation. Anthropic le présente comme un « prototype fonctionnel ». Le code source, le volume de code, le nombre total de jetons et le coût n’ont pas été rendus publics, et aucun audit indépendant n’a été réalisé.
Q2 : Les systèmes multi-agents sont-ils toujours meilleurs qu’un agent unique ?
Pas nécessairement. Anthropic précise que les systèmes multi-agents ne sont pas toujours supérieurs à un agent unique. Certaines équipes ont passé plusieurs mois à construire un système multi-agents avant de découvrir qu’optimiser l’invite d’un agent unique donnait des résultats similaires. Pour une même tâche, les systèmes multi-agents consomment généralement 3 à 10 fois plus de jetons qu’un agent unique. Leurs avantages sont relativement constants dans trois cas : l’isolation du contexte, le traitement en parallèle et la spécialisation des rôles.
Q3 : Peut-on utiliser les gains de 90,2 % et les 15 fois plus de jetons pour évaluer Fable 5.2 ?
Non. Ces deux chiffres proviennent du système Anthropic Research publié en juin 2025 : les 90,2 % correspondent aux résultats d’une évaluation interne spécifique, Research Eval, par rapport à un agent unique utilisant Opus 4 ; le chiffre de 15 fois plus de jetons est comparé à une conversation ordinaire. Ils n’ont aucun lien avec l’expérience de système d’exploitation menée avec Fable 5.2 en 2026 et ne doivent pas être confondus avec les données indiquant une consommation de 3 à 10 fois supérieure pour une même tâche.
Q4 : Comment créer rapidement son propre prototype multi-agents avec une API ?
Voici les étapes recommandées :
1. Inscrivez-vous sur APIYI, à l’adresse apiyi.com, puis récupérez une clé API et un crédit d’essai gratuit.
2. Dans le code de cet article, définissez `base_url` sur `https://api.apiyi.com/v1`.
3. Commencez par exécuter une version de référence avec un agent unique et notez le nombre de jetons utilisés ainsi que le taux de réussite.
4. Attribuez ensuite des modèles différents au coordinateur et aux agents secondaires, puis comparez les coûts et la qualité des résultats.
Q5 : Comment maîtriser le coût d’un système multi-agents ?
Quatre principes sont essentiels : découpez les tâches selon les limites du contexte pour réduire les échanges d’informations ; utilisez des modèles plus rapides et moins coûteux pour les sous-tâches, et réservez les modèles les plus performants à la planification et aux vérifications critiques ; précisez dans la documentation des outils le coût de la délégation et les tâches qu’il ne vaut pas la peine de déléguer, afin d’éviter les délégations excessives ; enfin, fixez un budget global de jetons et une limite de tâches simultanées. Pour les traitements hors ligne par lots, vous pouvez envisager la remise de l’API Batch. Pour les appels courants, la facturation à l’usage et le suivi de la consommation proposés par APIYI, sur apiyi.com, permettent aussi un calcul précis des coûts.
Q6 : Quelles sont les limites connues des systèmes multi-agents à ce jour ?
Première limite : le coût, car le nombre de jetons utilisés pour une même tâche est généralement multiplié par 3 à 10. Deuxième limite : les plafonds d’orchestration. Dans Managed Agents, le nombre maximal de fils directs est de 25 ; un Workflow peut faire travailler jusqu’à 64 fils simultanément, avec une limite cumulée de 1 000 lancements sur toute sa durée de vie. Troisième limite : la validation. Un agent chargé de la vérification ne remplace pas de véritables tests. Enfin, l’accumulation de règles et les longues périodes sans retour nuisent à l’expérience : il faut nettoyer régulièrement les règles et activer les mises à jour de progression.
Points clés de la collaboration multi-agents avec Claude Fable 5.2
- Le nombre ne fait pas l’efficacité : la valeur de 1 000 agents tient à leur organisation, pas à leur nombre en soi.
- Les rôles doivent être clairement définis : l’Orchestrator coordonne, le Subagent exécute, l’Advisor conseille et le Workflow gère les processus.
- Répartissez le travail selon les limites du contexte : confiez un module complet et ses tests à un même agent, plutôt que de faire circuler les tâches d’un rôle à l’autre au risque de déformer les informations.
- Maîtrisez les coûts : pour une même tâche, plusieurs agents consomment généralement 3 à 10 fois plus de tokens qu’un seul agent.
- Mettez la validation en pratique : en plus d’un agent chargé de la revue, définissez des critères d’acceptation et prévoyez de vrais tests.
- Commencez avec un seul agent : ajoutez une couche de collaboration uniquement lorsqu’un véritable goulot d’étranglement apparaît. Vous pouvez effectuer des tests par niveaux en connectant plusieurs modèles via APIYI, apiyi.com.
Conclusion
L’expérience du système d’exploitation menée avec Claude Fable 5.2 nous apprend plusieurs choses :
- La capacité d’orchestration devient un critère déterminant : Fable 5.2 progresse dans le rôle de coordinateur, notamment en faisant appel de lui-même à des agents secondaires pour vérifier son travail lorsque le niveau d’Effort est élevé.
- La collaboration multi-agents a des limites bien définies : l’isolation des contextes, le traitement en parallèle et la spécialisation des tâches méritent une répartition entre agents. En revanche, les tâches étroitement liées et les requêtes simples n’y gagnent pas.
- Coûts, concurrence et validation sont trois contraintes incontournables : l’augmentation du nombre de tokens, les limites de planification et les tests réels déterminent si un système peut fonctionner durablement.
Pour la plupart des développeurs, la bonne approche consiste à établir d’abord une référence avec un agent unique, puis à introduire des Subagents, des Workflows ou des Advisors en fonction des goulots d’étranglement observés. Il faut aussi soigner les API des modèles, le budget, la concurrence et les journaux. L’infrastructure API est le véritable socle des applications multi-agents.
Pour tester rapidement votre approche multi-agents, nous vous recommandons APIYI, apiyi.com. La plateforme propose une interface unifiée compatible avec OpenAI et un crédit d’essai gratuit pour les nouveaux utilisateurs, afin de comparer la répartition des tâches entre différents modèles.
📚 Références
- Annonce officielle d’Anthropic : Claude Fable 5.2 and Mythos 5.2 (2026-11-09)
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 -
À retenir : source primaire sur les expériences liées aux systèmes d’exploitation, les évaluations de programmation et les tarifs
-
Building multi-agent systems: When and how to use them : cas d’usage et coûts des systèmes multi-agents (2026-01-23)
- Lien :
claude.com/resources/articles/building-multi-agent-systems-when-and-how-to-use-them -
À retenir : données indiquant une consommation de 3 à 10 fois plus de tokens et principe de découpage selon les limites de contexte
-
How we built our multi-agent research system : le système de recherche d’Anthropic (2025-06-13)
- Lien :
anthropic.com/research/multi-agent-research-system -
À retenir : architecture orchestrateur-agents de travail, résultat de 90,2 % lors des évaluations internes et consommation de tokens multipliée par 15
-
Documentation sur Managed Agents, l’orchestration multi-agents et les workflows : modes de collaboration et limites d’exécution
- Lien :
platform.claude.com/docs/en/managed-agents/multiagent-orchestration -
À retenir : définitions de Subagents, Dynamic Workflows et Advisor, ainsi que les limites de concurrence
-
Prompting Claude Fable 5.2 : guide officiel d’ingénierie des invites
- Lien :
platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-fable-5-2 -
À retenir : comportement d’auto-évaluation, expériences sur la délégation excessive et recommandations concernant les retours d’avancement
-
Documentation sur les spécifications du modèle Fable 5.2 : fenêtre de contexte, limite de sortie et tarification
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - À retenir : fenêtre de contexte de 1 M, sortie maximale de 128 K et identifiant du modèle API
Auteur : l’équipe technique d’APIYI
Échanges techniques : rendez-vous sur la page d’accueil d’APIYI, à l’adresse apiyi.com, pour nous contacter et échanger sur les architectures multi-agents et les pratiques d’intégration de plusieurs modèles.


