
Note de l’auteur : décryptage du score de 64,9 % obtenu par Claude Fable 5.2 sur RoboDojo Sim : dans quelles conditions a-t-il été mesuré, quel écart le sépare d’Opus 5.5 et de GPT-6 Astra, ce qu’il ne permet pas de démontrer, et quels coûts et limites prendre en compte avant de l’intégrer.
Commençons par le résultat. Lors d’un test interne à Anthropic sur RoboDojo Sim, avec le niveau d’effort maximal, Claude Fable 5.2 obtient 64,9 %, Opus 5.5 39,4 %, GPT-6 Astra 29,8 % et Fable 5.1 27,6 %. Il s’agit des performances d’un modèle qui analyse des images de caméra et commande un robot simulé à deux bras, pas d’un bilan de déploiement en usine.
Cet article n’est pas un texte promotionnel annonçant « l’ère des robots ». Nous allons distinguer les scores en simulation, les vidéos de démonstration et les déploiements réels. Si vous envisagez d’intégrer une API ou de calculer les coûts, cette analyse vous aidera à déterminer si ces 64,9 % justifient de revoir votre architecture technique.
L’essentiel : comprendre ce que les 64,9 % de Fable 5.2 démontrent — et ne démontrent pas —, et savoir quel modèle vous pouvez appeler aujourd’hui pour effectuer des essais préliminaires.
Que signifie vraiment le score de 64,9 % de Claude Fable 5.2 ?
On peut résumer ce chiffre en trois phrases. RoboDojo est un benchmark public qui évalue la capacité d’un modèle à contrôler un robot bimoteur dans un environnement simulé à partir d’images de caméra. La note de bas de page de l’annonce précise que les 64,9 % ont été obtenus lors d’un test interne d’Anthropic, avec le niveau d’effort maximal disponible. Au 10 novembre 2026, nous n’avons pas pu vérifier ce même chiffre sur le classement public de RoboDojo. Il ne faut donc pas le présenter comme « premier du classement public », et encore moins comme le « modèle robotique le plus performant au monde ».
Voici les résultats comparatifs de RoboDojo Sim publiés par Anthropic le 9 novembre 2026 :
| Modèle | RoboDojo Sim | Écart avec Fable 5.2 | Remarque |
|---|---|---|---|
| Claude Fable 5.2 | 64,9 % | — | Test interne, niveau d’effort maximal |
| Claude Opus 5.5 | 39,4 % | 25,5 points de moins | Dans le même tableau |
| GPT-6 Astra | 29,8 % | 35,1 points de moins | Résultat obtenu par Anthropic, et non communiqué par OpenAI |
| Claude Fable 5.1 | 27,6 % | 37,3 points de moins | Génération précédente |
| Gemini 4 Carbon | Champ vide dans le tableau | Comparaison impossible | Aucune valeur : cela ne signifie pas un score de 0 |
Le score passe de 27,6 % à 64,9 %, soit une amélioration de plus du double d’une génération à l’autre. L’écart saute aux yeux dans l’ensemble du tableau. Mais ce score repose sur trois conditions : un environnement simulé, un test interne et le niveau d’effort maximal. Si l’une d’elles change — par exemple en passant à un robot réel, à une évaluation indépendante ou au niveau d’effort par défaut — on ne peut pas reprendre ce chiffre tel quel.
Quel est le lien entre Fable 5.2 et Mythos 5.2 ?
L’annonce est explicite : Claude Fable 5.2 et Claude Mythos 5.2 reposent sur le même modèle de base. Fable dispose de garde-fous renforcés en matière de cybersécurité et de biosécurité ; il est donc accessible à tous les utilisateurs. Mythos est réservé aux organisations ayant passé les contrôles requis dans le cadre de programmes liés aux sciences de la vie ou à la cybersécurité. Mythos n’est pas « un autre modèle plus puissant ». Pour évaluer les capacités en robotique, Claude Fable 5.2 suffit.
Voici les identifiants officiels des modèles :
- Claude API, Google Cloud, Microsoft Foundry, Claude Platform on AWS :
claude-fable-5-2 - Amazon Bedrock :
anthropic.claude-fable-5-2 - Pour Mythos :
claude-mythos-5-2etanthropic.claude-mythos-5-2
Fonctionnalités clés de Fable 5.2 pour contrôler des robots : que montre la démonstration ?
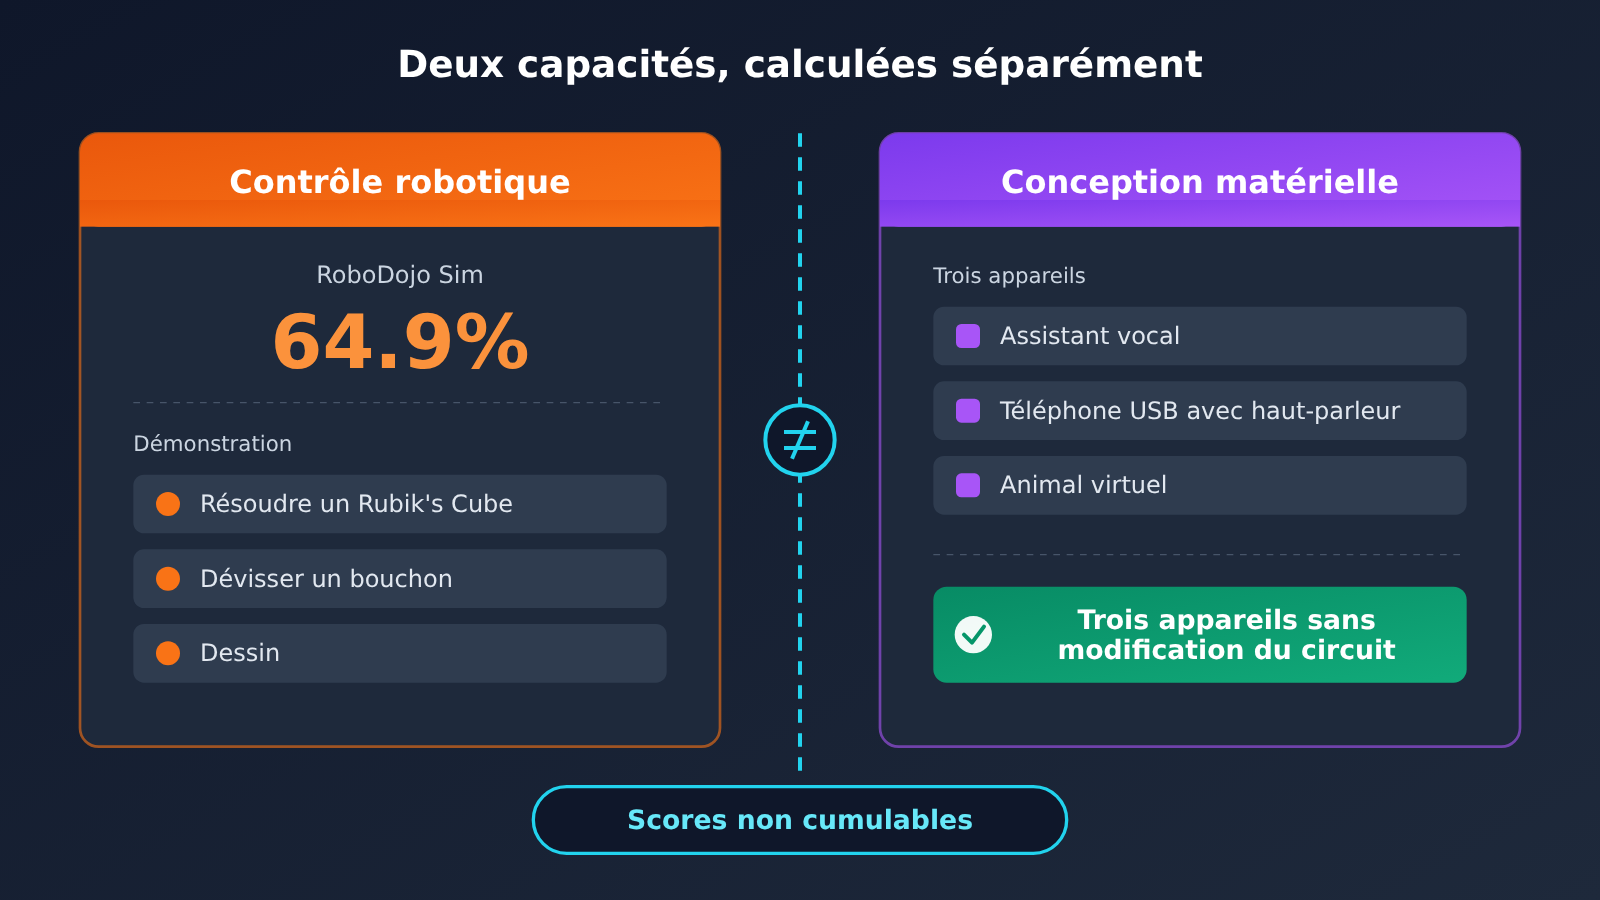
Selon l’annonce, Fable 5.2 contrôle des robots physiques bien mieux que les versions précédentes de Claude, y compris pour des tâches qui n’ont pas fait l’objet d’un entraînement spécifique. La vidéo de démonstration présente trois situations : résoudre un Rubik’s Cube, dévisser un bouchon et dessiner un robot.
Il faut voir ces séquences pour ce qu’elles sont : des démonstrations présentées dans l’annonce. Elles montrent que le modèle a réussi ces actions dans un contexte donné, mais ne renseignent ni sur le taux de réussite, ni sur le nombre de tentatives, ni sur la proportion d’échecs. Elles ne signifient pas non plus qu’Anthropic a lancé un ensemble de compétences robotiques qu’on peut installer directement. L’affirmation selon laquelle certaines tâches n’ont pas fait l’objet d’un entraînement spécifique mérite l’attention, mais elle vient d’Anthropic et n’est pas étayée par des données reproduites de façon indépendante.
L’annonce indique aussi que Fable 5.2 a surpassé d’autres modèles de pointe sur la même suite de tests, ainsi que la plupart des systèmes spécialement conçus pour contrôler des robots. Cette dernière affirmation ne s’accompagne d’aucune liste : impossible de savoir quels systèmes ont été comparés ni quelles versions ont été utilisées. On peut y voir un indice de tendance, mais pas une conclusion.
Le modèle produit du texte ; le contrôle repose sur un kit externe
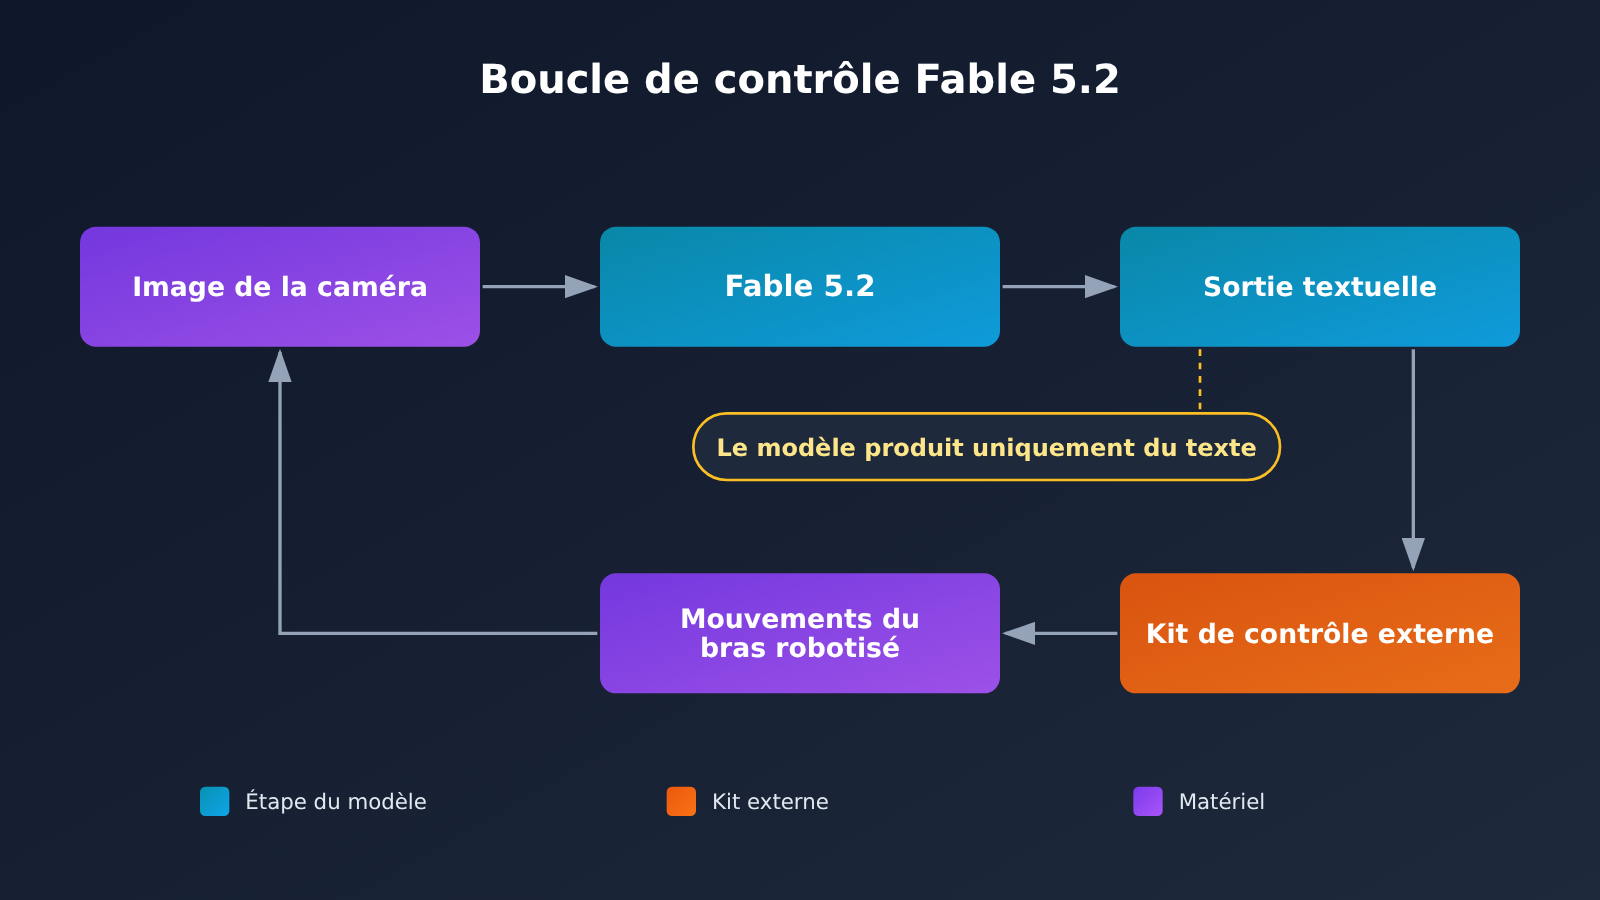
C’est le point que la vidéo de démonstration risque le plus facilement de masquer. La page du modèle précise que Fable 5.2 prend en entrée du texte et des images, et ne produit que du texte. Il n’envoie pas directement de commandes aux moteurs. À chaque étape, un kit externe doit interpréter le texte pour le convertir en action, puis renvoyer au modèle une nouvelle image de la caméra.
Dans une situation réelle, les performances de contrôle dépendent donc autant du modèle que de votre kit : de la façon dont l’espace d’action est défini, des solutions prévues en cas d’échec de l’analyse, et de la latence acceptable à chaque étape. Le score de 64,9 % obtenu sur RoboDojo l’a été avec le kit d’Anthropic. On ne sait pas encore comment ce score évoluerait avec un autre kit.
Données mesurées de Fable 5.2 : l’écart en robotique et celui lié aux opérations sur ordinateur, ce n’est pas la même chose
Quand on entend « Fable 5.2 est très performant », on a vite fait de mélanger les scores en robotique avec ceux d’autres catégories. Le tableau ci-dessous reprend les données de la publication d’Anthropic du 9 novembre 2026 et compare l’ampleur des écarts sur plusieurs tests liés à la « manipulation » :
| Test | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Avance de Fable 5.2 sur Opus 5.5 |
|---|---|---|---|---|
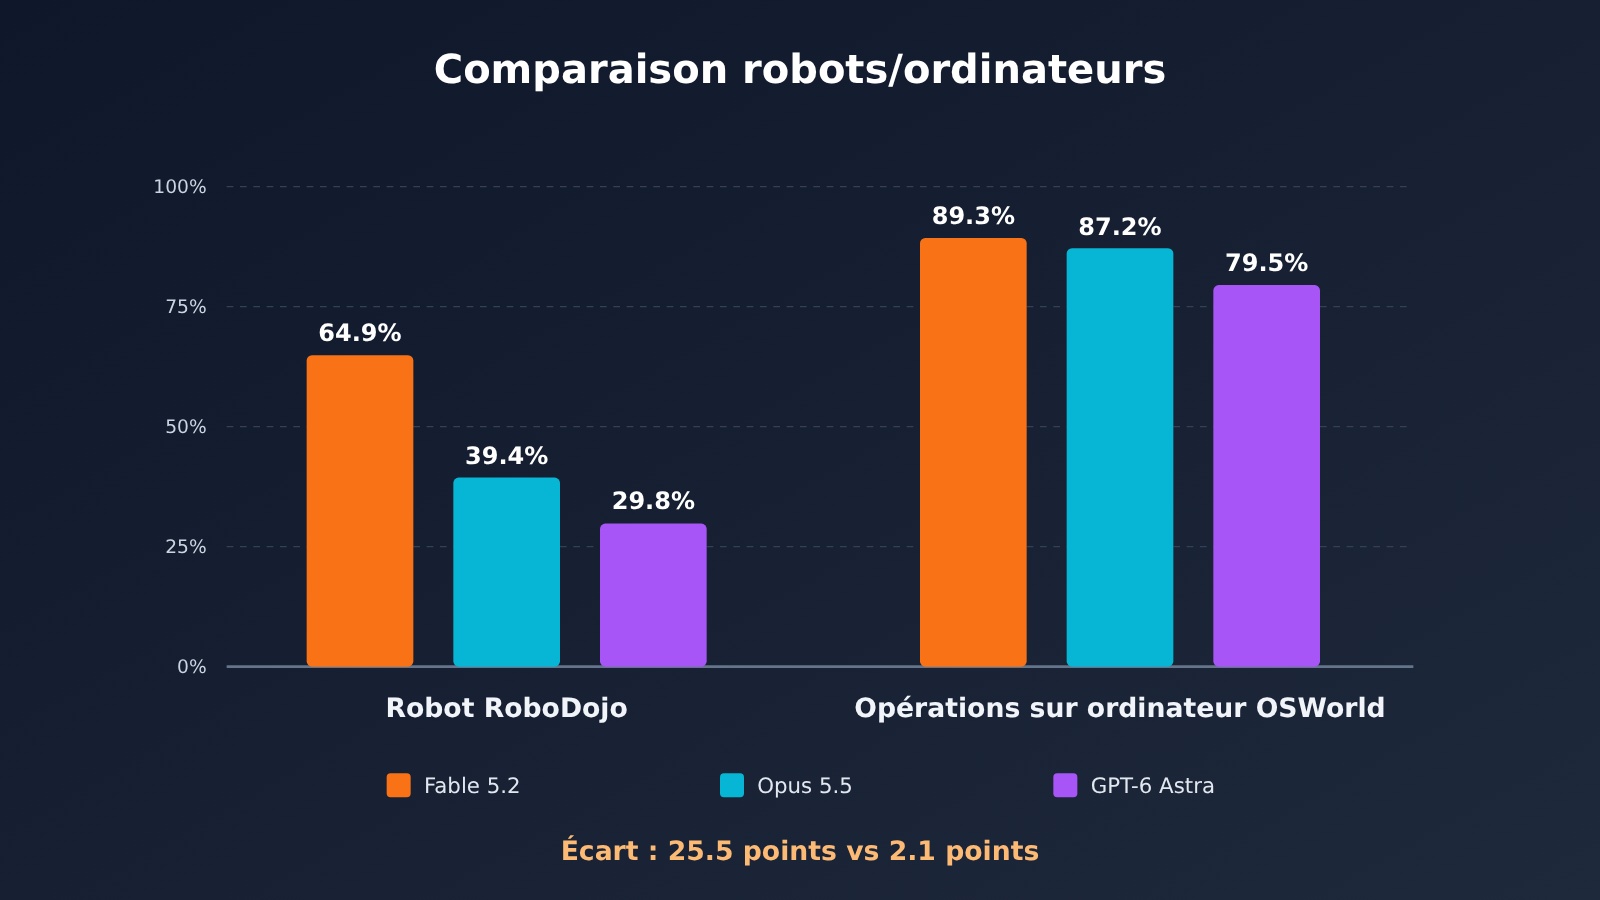
| RoboDojo Sim (simulation bimanuelle) | 64,9 % | 39,4 % | 29,8 % | 25,5 points |
| OSWorld 2.1 (opérations sur ordinateur, sous-ensemble hors ligne) | 89,3 % | 87,2 % | 79,5 % | 2,1 points |
| AutomationBench | 51,4 % | 42,5 % | 41,4 % | 8,9 points (Carbon fait mieux avec 53,9 %) |
| Remote Labor Index (niveau High) | 41,3 % | 21,3 % | 20,8 % | 20,0 points |
Sur OSWorld 2.1, Fable 5.2 ne devance Opus 5.5 que de 2,1 points. Rien à voir avec l’écart observé sur RoboDojo, où le score passe de 39,4 % à 64,9 %. Si vous cherchez un agent pour effectuer des tâches sur ordinateur, la différence entre Opus 5.5 et Fable 5.2 est bien moins marquée que dans les tests de robotique.
Niveau d’effort : 64,9 % n’est pas un résultat obtenu avec le réglage par défaut
Sauf indication contraire, les résultats du tableau publié ont été obtenus avec le niveau d’effort maximal disponible pour chaque modèle à ce moment-là. Dans l’API Claude, le niveau d’effort par défaut de Fable 5.2 est high, tandis qu’il est réglé sur Medium dans l’application Claude et Claude Code. Autrement dit, avec les paramètres par défaut, vous n’obtiendrez pas forcément la configuration qui a permis d’atteindre les 64,9 %.
Le niveau maximal implique une réflexion plus longue et davantage de jetons. Dans une boucle de robotique qui exige des décisions répétées, raisonner au niveau maximal à chaque étape augmente à la fois la latence et le coût. L’article d’annonce ne précise pas à quel niveau les 64,9 % tomberaient avec les réglages high ou medium.
Comparaison des caractéristiques : Fable 5.2, Opus 5.5 et GPT-6 Astra
| Caractéristique | Claude Fable 5.2 | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Fenêtre de contexte | 1M | 1M | 1,050,000 |
| Sortie maximale | 128K | 128K | 128,000 |
| Modalités d’entrée / de sortie | Texte + images / texte | Texte + images / texte | Texte + images / texte |
| Niveau d’effort par défaut dans l’API | high | medium | low à max |
| Niveau de latence | Moderate | Moderate | La page officielle n’utilise pas la même échelle |
| Date limite des connaissances | juin 2026 | 2026-06 | 2026-04-30 |
Les trois modèles produisent du texte : c’est une contrainte commune incontournable pour le contrôle robotique.
Les éléments qui ne comptent pas dans le score robotique de Fable 5.2
Trois appareils électroniques : une expérience de conception matérielle
L’annonce présente aussi un autre projet : à partir d’une seule invite, Fable 5.2 a conçu trois appareils électroniques fonctionnels : un assistant vocal domestique, un téléphone avec haut-parleur USB et un animal de compagnie virtuel portable. Réalisé en collaboration avec Diode, le projet a permis de fabriquer chaque carte électronique en moins d’une journée. Les trois appareils ont fonctionné sans aucune modification des circuits.
Ce projet démontre des capacités de conception matérielle, sans rapport avec RoboDojo. Les appareils eux-mêmes ne sont pas des robots. Présenter ce résultat aux côtés du score de 64,9 % peut donner l’impression que le modèle maîtrise tout, de la conception au contrôle, alors que ces deux projets n’ont rien en commun.
Limites de Fable 5.2 : les restrictions qui influent sur la boucle de contrôle
Les éléments ci-dessous proviennent de la page du modèle et des notes de mise à jour. Chacun a une incidence directe sur la boucle de contrôle que vous mettez en place :
- L’appel forcé d’un outil provoque une erreur : définir
tool_choicesuranyoutoolrenvoie une erreur 400. Si votre système repose sur l’obligation d’appeler un outil d’action, laissez plutôt le modèle choisir lui-même, puis prévoyez une solution de repli pour l’analyse de sa réponse. - Les paramètres d’échantillonnage ne sont pas configurables : transmettre
temperature,top_poutop_krenvoie une erreur 400. - La réflexion ne peut pas être désactivée : la réflexion adaptative est toujours active. Vous pouvez uniquement en régler l’intensité avec
effort. Les notes de mise à jour précisent qu’à partir du niveau medium, même la consigne « ne réfléchis pas, réponds directement » ne permet pas de l’arrêter. - Le modèle parle peu pendant les longues chaînes d’outils : lors d’appels successifs à des outils, ses réponses destinées à l’utilisateur peuvent être rares. Il peut aussi appeler directement un outil sans expliquer ce qu’il fait. Votre interface de supervision ne peut donc pas compter sur lui pour signaler spontanément l’avancement.
- Le modèle peut s’arrêter trop tôt : il arrive qu’il mette fin à un tour en laissant une liste de tâches en suspens, ou qu’il reste bloqué face à un obstacle ordinaire. C’est plus fréquent au niveau low.
- Les refus consomment aussi du quota : en cas de refus, la réponse renvoie le code HTTP 200 avec
stop_reasondéfini surrefusal. Elle consomme tout de même du quota de requêtes. - Conservation des données : les données sont conservées pendant 30 jours. La conservation zéro donnée n’est possible qu’avec l’autorisation explicite d’Anthropic.
Une boucle robotique exige que chaque étape fournisse une action exécutable. Ensemble, ces limites signifient qu’avant d’intégrer le modèle à une boucle de contrôle, vous devez prévoir des mécanismes de reprise en cas de délai d’attente, d’action vide, de refus ou d’arrêt en cours de route.
Prix de Fable 5.2 : faites vos calculs avant de l’intégrer
Les tarifs officiels sont exprimés par million de tokens. Ils proviennent de la page du modèle, des notes de mise à jour et de la page du mode rapide :
| Poste de facturation | Fable 5.2 | Opus 5.5 | GPT-6 Astra (contexte court) |
|---|---|---|---|
| Entrée / sortie standard | $8 / $40 | $4 / $20 | $10 / $50 |
| Lecture du cache | $0.20 | $0.20 | $1 (entrée mise en cache) |
| Écriture dans le cache | 5 minutes : $10, 1 heure : $16 | Indiquée sur la page officielle, non détaillée ici | $12.5 |
| Traitement par lots | Tarif réduit de moitié, soit $4 / $20 | Même réduction de moitié | Non détaillé ici |
| Mode rapide | $16 / $80 | $8 / $40 | — |
Quelques points à noter. Fable 5.2 coûte 20 % de moins que Fable 5.1 ($10 / $50). Les capacités du mode rapide restent inchangées, et sa vitesse de sortie peut atteindre 2,5 fois celle du mode standard. L’éditeur ne donne toutefois pas de tarif distinct pour le cache en mode rapide. En appliquant le même multiplicateur, on obtient environ $0.40 pour la lecture du cache, $20 pour une écriture dans le cache de 5 minutes et $32 pour une écriture dans celui d’une heure. Les différents modes de vitesse ne partagent pas leur cache d’invite : repasser du mode rapide au mode standard entraîne donc un défaut de cache. Pour GPT-6 Astra, au-delà de 272K tokens d’entrée, le coût de l’ensemble de la requête est calculé avec un multiplicateur de 2 pour l’entrée et de 1.5 pour la sortie.
Dans une boucle robotique, une nouvelle image doit être transmise à chaque étape, tandis que l’invite système et les instructions relatives aux actions restent presque inchangées. Cette structure se prête bien à l’utilisation du cache pour réduire les coûts, mais les images fournies à chaque étape et les tokens de réflexion restent incompressibles.
Peut-on déjà appeler Fable 5.2 ? Disponibilité sur APIYI
Au 10 novembre 2026, claude-fable-5-2 ne figure toujours ni dans le catalogue des modèles d’APIYI (apiyi.com), ni dans son interface publique de tarification. Aucun modèle Mythos n’y apparaît non plus. Nous lancerons ce modèle dès que possible. Le modèle et son prix de référence sont ceux indiqués dans la liste des modèles de la plateforme. Tant qu’il n’est pas disponible, cet article ne donne pas de prix pour Fable 5.2 sur APIYI et ne convertit pas le prix officiel à partir des multiplicateurs de groupe.
Voici les modèles associés disponibles dans le catalogue d’APIYI ce jour-là (prix affichés, en dollars par million de jetons) :
| ID du modèle | Entrée / sortie | Lecture du cache | Points de terminaison | Utilisation recommandée |
|---|---|---|---|---|
claude-opus-5-5, claude-opus-5-5-thinking |
$4 / $20 | $0.2 | chat, messages | Mettre d’abord en place une boucle d’appel d’outils et de contrôle de l’ordinateur |
claude-fable-5-1, claude-fable-5-1-thinking |
$10 / $50 | $0.25 | chat, messages | Servir de référence pour comparer avec la génération précédente |
claude-fable-5, claude-fable-5-thinking |
$10 / $50 | $1 | chat, messages | Comparer avec les versions précédentes |
gpt-6-astra |
$10 / $50 | $1 | responses (principal), chat | Comparer avec un autre fournisseur |
Les prix du catalogue sont des prix affichés. Le montant réellement facturé dépend aussi du multiplicateur de groupe de jetons ; fiez-vous à votre facture. La note de bas de page de gpt-6-astra ne précise que les paliers tarifaires en entrée : $10 jusqu’à 272 000 jetons, puis $20 de 272 001 à 1 050 000. Le prix de sortie pour les longs contextes n’est pas indiqué ; consultez la facture dans la console. Pour l’intégration, utilisez l’interface compatible avec OpenAI et renseignez https://api.apiyi.com/v1 dans base_url.
En pratique, commencez par utiliser claude-opus-5-5 pour valider l’entrée d’images, l’interprétation des actions et la récupération après échec. Vous pourrez ensuite remplacer l’ID du modèle par celui de Fable 5.2 dès qu’il sera disponible sur APIYI, puis comparer les résultats. L’écart sur la tâche de robotique (25,5 points) est bien plus important que celui sur le contrôle de l’ordinateur (2,1 points) : attendre Fable 5.2 peut donc se justifier, mais une vidéo de démonstration ne suffit pas à elle seule pour prendre une décision.
Analyse des points forts et des limites de Fable 5.2 en robotique
Points forts
- Un bond générationnel important : le score de RoboDojo Sim passe de 27,6 % à 64,9 %, ce qui en fait l’une des progressions les plus marquées du tableau.
- Une nette avance sur les modèles comparables : 25,5 points de plus qu’Opus 5.5 et 35,1 points de plus que GPT-6 Astra (d’après l’article publié par Anthropic).
- Un prix en baisse : le tarif standard est inférieur de 20 % à celui de la version 5.1, et la lecture du cache coûte 0,20 $.
- Une entrée visuelle cohérente : le modèle accepte des images et dispose d’une fenêtre de contexte de 1M, ce qui permet de traiter de longs historiques visuels en plusieurs étapes.
Limites
- Des preuves peu solides : le résultat provient d’un test interne effectué avec le niveau d’effort maximal. Aucun classement public ne confirme le même score et aucune évaluation indépendante ne l’a reproduit.
- Uniquement des données de simulation : les vidéos de démonstration ne donnent pas de taux de réussite, et l’affirmation selon laquelle le modèle « dépasse la plupart des systèmes robotiques spécialisés » ne s’accompagne d’aucune liste de systèmes comparés.
- De nombreuses contraintes dans la boucle : le modèle ne produit que du texte, ne permet pas d’imposer l’appel d’outils, ne permet pas de désactiver la réflexion et explique rarement ses actions au cours de longues séquences.
- Un coût élevé au niveau maximal : le score repose sur le niveau d’effort maximal. En conditions réelles, il faut mesurer soi-même la latence et la consommation de jetons.
Dans quels cas il ne faut pas changer de modèle sur cette base
Sans environnement de simulation ni boucle robotique réelle, le score de 64,9 % n’a aucune valeur vérifiable pour vous : impossible de savoir s’il se confirme dans votre configuration. Et si vos besoins concernent la cybersécurité, la biologie ou le développement logiciel au quotidien, ce score ne prouve rien non plus ; mieux vaut consulter les évaluations propres à ces domaines. Dans son article, Anthropic recommande de commencer par Opus 5.5 pour la plupart des tâches de programmation et de connaissance, puis de choisir un modèle plus puissant ou plus léger selon la difficulté.
FAQ : questions fréquentes
Q1 : Les 64,9 % de Fable 5.2 correspondent-ils à un résultat publié dans le classement public ?
Non. La note de bas de page de l’annonce précise qu’il s’agit d’un résultat obtenu lors d’un test interne à Anthropic. RoboDojo est bien un benchmark public, mais au 10 novembre 2026, nous n’avons pas pu vérifier ce même chiffre sur la page publique du classement.
Q2 : Les 64,9 % ont-ils été obtenus avec le niveau d’effort par défaut ?
Non, ils correspondent au niveau d’effort maximal disponible. Le niveau par défaut de l’API Claude est high, tandis que celui de l’application Claude et de Claude Code est Medium. L’annonce ne précise pas le score obtenu avec le niveau par défaut.
Q3 : Fable 5.2 a-t-il dépassé les systèmes spécialement conçus pour la robotique ?
L’annonce affirme qu’il a dépassé « la plupart des systèmes spécialement conçus pour contrôler des robots », mais ne fournit aucune liste. On ne sait donc pas exactement quels systèmes ont été dépassés.
Q4 : Pourquoi Gemini 4 Carbon n’a-t-il pas de score sur RoboDojo ?
La case correspondante du tableau de l’annonce est vide, sans explication. Cette absence ne signifie pas que le score est de 0 et ne permet pas de tirer de conclusion sur ses performances.
Q5 : Comment se préparer dès maintenant à utiliser l’API ?
Au 10 novembre 2026, APIYI (apiyi.com) ne propose pas encore `claude-fable-5-2`. Nous comptons ajouter ce modèle dès que possible ; référez-vous à la liste des modèles de la plateforme pour connaître son nom et son prix. En attendant, vous pouvez tester les entrées d’images et le cycle d’appels aux outils avec `claude-opus-5-5`, déjà disponible, puis changer de modèle pour comparer dès que Fable 5.2 sera ajouté.
Q6 : Les trois appareils électroniques prouvent-ils que le modèle sait contrôler un robot ?
Non. L’assistant vocal, le téléphone équipé d’un haut-parleur USB et l’animal virtuel sont des expériences de conception matérielle menées en collaboration avec Diode. Elles évaluent des compétences en conception de circuits et n’ont aucun lien avec le score de Fable 5.2 en commande bimanuelle sur RoboDojo.
Q7 : Les agents qui pilotent un ordinateur doivent-ils attendre Fable 5.2 ?
Ce n’est probablement pas nécessaire. Sur OSWorld 2.1, Fable 5.2 obtient 89,3 %, contre 87,2 % pour Opus 5.5, soit un écart de seulement 2,1 points. Or, le tarif standard d’Opus 5.5 est deux fois moins élevé que celui de Fable 5.2.
Points clés sur les capacités robotiques de Fable 5.2
- Ce que signifie le score : 64,9 % correspond au résultat obtenu en simulation avec deux bras, en interne et au niveau d’effort maximal.
- L’ampleur de l’écart : 25,5 points de plus qu’Opus 5.5 et 35,1 points de plus que GPT-6 Astra.
- Un autre point de comparaison : l’avance sur OSWorld n’est que de 2,1 points. Il ne faut pas confondre ces deux types d’écart.
- La portée des démonstrations : résoudre un Rubik’s Cube, dévisser un bouchon et dessiner sont des démonstrations présentées lors du lancement, pas des compétences prêtes à être commercialisées.
- Les contraintes de la boucle : le modèle ne renvoie que du texte ; forcer
tool_choiceprovoque une erreur 400, et il est impossible de désactiver la réflexion. - Disponibilité : au 2026-11-10, Fable 5.2 n’est pas encore disponible sur APIYI. En attendant, vous pouvez utiliser
claude-opus-5-5pour mettre en place votre boucle.
En résumé
Les progrès de Claude Fable 5.2 en matière de contrôle robotique sont bien réels : le score sur RoboDojo Sim passe de 27,6 % pour la génération précédente à 64,9 %, ce qui le place nettement en tête des comparaisons présentées par Anthropic. Mais ce chiffre s’applique à un périmètre très restreint : il concerne uniquement la simulation, les essais internes et le niveau d’effort maximal. Il ne renseigne ni sur le taux de réussite sur des robots réels, ni sur la capacité à assurer des livraisons en usine.
Si vous disposez déjà de votre propre boucle de simulation ou de contrôle sur robot réel, cela vaut la peine de comparer les résultats avec Fable 5.2 lorsqu’il sera disponible. Pensez toutefois à intégrer dès le départ les contraintes liées à l’analyse des réponses textuelles, à l’impossibilité de forcer les appels d’outils et à l’impossibilité de désactiver la réflexion. Si vous n’avez pas de boucle ou que vous cherchez à résoudre des tâches de programmation ou d’utilisation d’un ordinateur, inutile de revoir votre solution actuelle pour ces 64,9 %.
Auteur : l’équipe technique d’APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI, apiyi.com. La disponibilité des modèles est indiquée dans la liste des modèles de la plateforme.


