
Nota del autor: análisis detallado de Qwen4-Max, 6.º en el ranking Code Arena WebDev: el panorama de los seis primeros, la brecha interna entre los modelos chinos, la diferencia frente a los modelos líderes y la forma correcta de leer los votos y el coste por tarea.
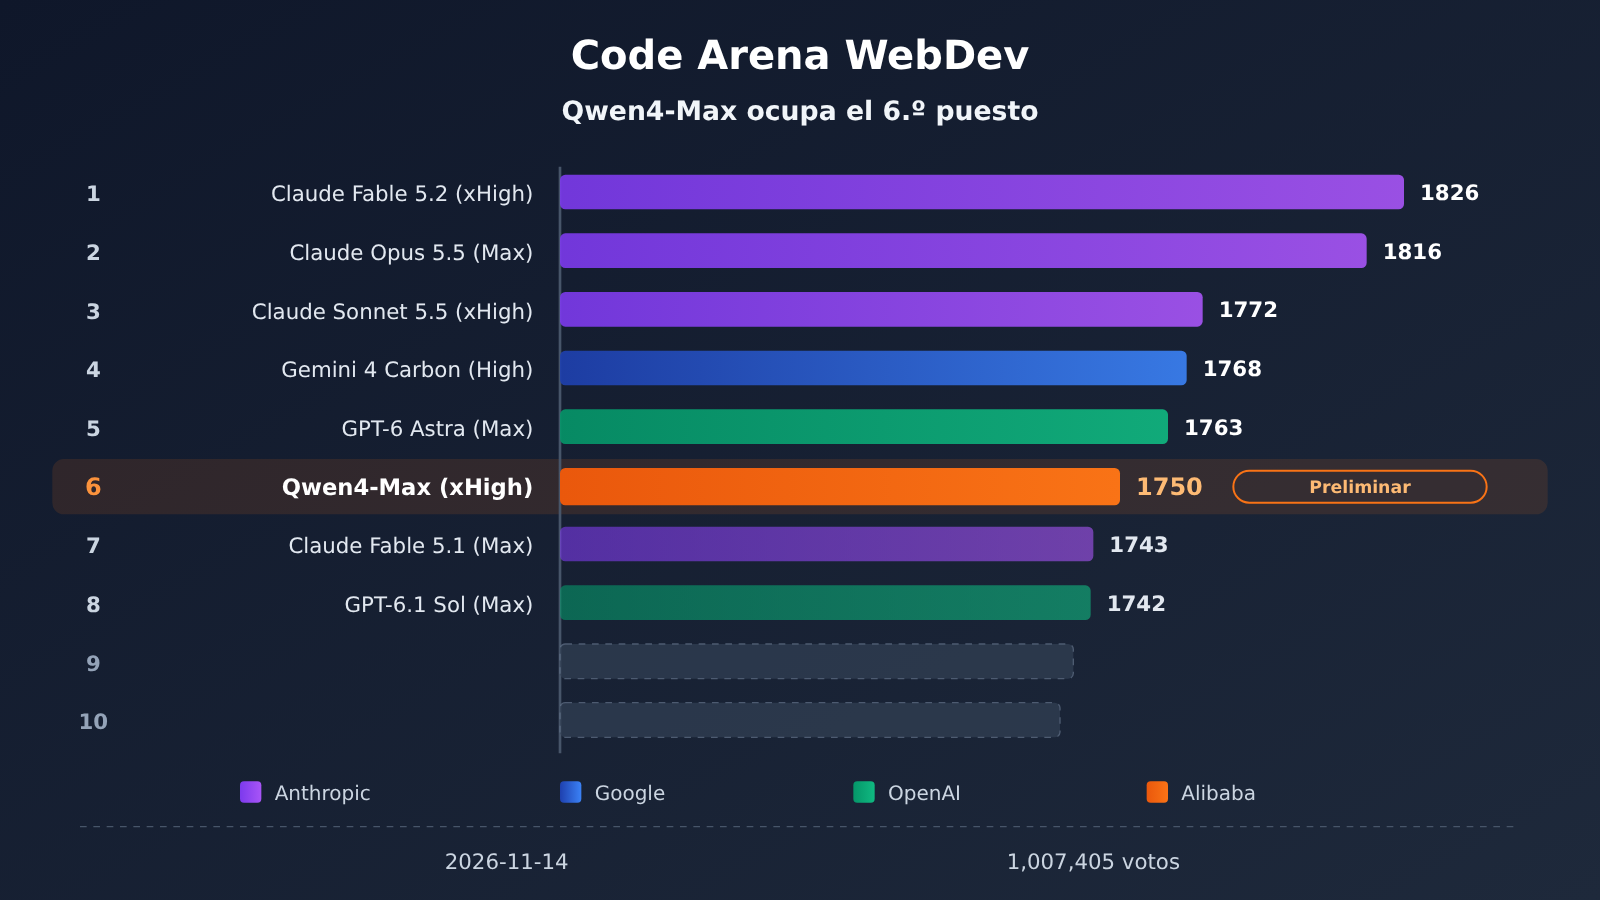
Primero, la conclusión: en el ranking Code Arena WebDev de arena.ai (categoría Overall, con fecha indicada en la página: 2026-11-14), Qwen4-Max (xHigh) ocupa el 6.º puesto con 1750 puntos. Es la primera vez que un modelo chino entra en los seis primeros de esta tabla, y también es el único modelo de los seis primeros que no viene de un laboratorio estadounidense.
Esto no es un artículo promocional que convierte un 6.º puesto en un 1.º. Qwen4-Max aparece en el ranking con la etiqueta Preliminary, tiene solo 1,814 votos y su posición todavía puede cambiar. En la misma gráfica oficial de Alibaba, Qwen4-Max sigue claramente por detrás de Opus 5.5 y GPT-6 Astra en Terminal-Bench y ProgramBench.
Valor clave: al terminar este artículo, tendrás unos metadatos del ranking que podrás abrir y verificar por tu cuenta, y sabrás cómo usar —y cómo no usar— el 6.º puesto de Qwen4-Max.
Puntos clave del puesto 6 de Qwen4-Max en Code Arena WebDev
Antes de discutir la posición, conviene poner sobre la mesa los metadatos de la clasificación. Cualquier afirmación sobre «qué puesto ocupa» debería contrastarse primero con la fecha, los votos y el número de modelos participantes; de lo contrario, es difícil saber si la posición se sostiene.
| Punto | Dato (datos públicos de la misma clasificación) | Cómo leerlo |
|---|---|---|
| Clasificación y categoría | arena.ai Code Arena WebDev, Overall | Solo representa la preferencia en pruebas ciegas de desarrollo web |
| Fecha de la página | 2026-11-14 | La posición cambia continuamente con los votos |
| Votos totales / número de modelos | 1,007,405 votos / 159 modelos | El tamaño de la muestra es grande, pero el número de votos por modelo varía mucho |
| Puesto y puntuación de Qwen4-Max | 6.º, 1750 puntos | Único modelo de un laboratorio no estadounidense entre los seis primeros |
| Votos y marca de Qwen4-Max | 1,814 votos, Preliminary | Sigue en fase de evaluación preliminar |
| Costo por tarea P50 | $4.18 | Mediana estadística de la clasificación, no el precio unitario del modelo |
Detalle del criterio de Qwen4-Max en la clasificación
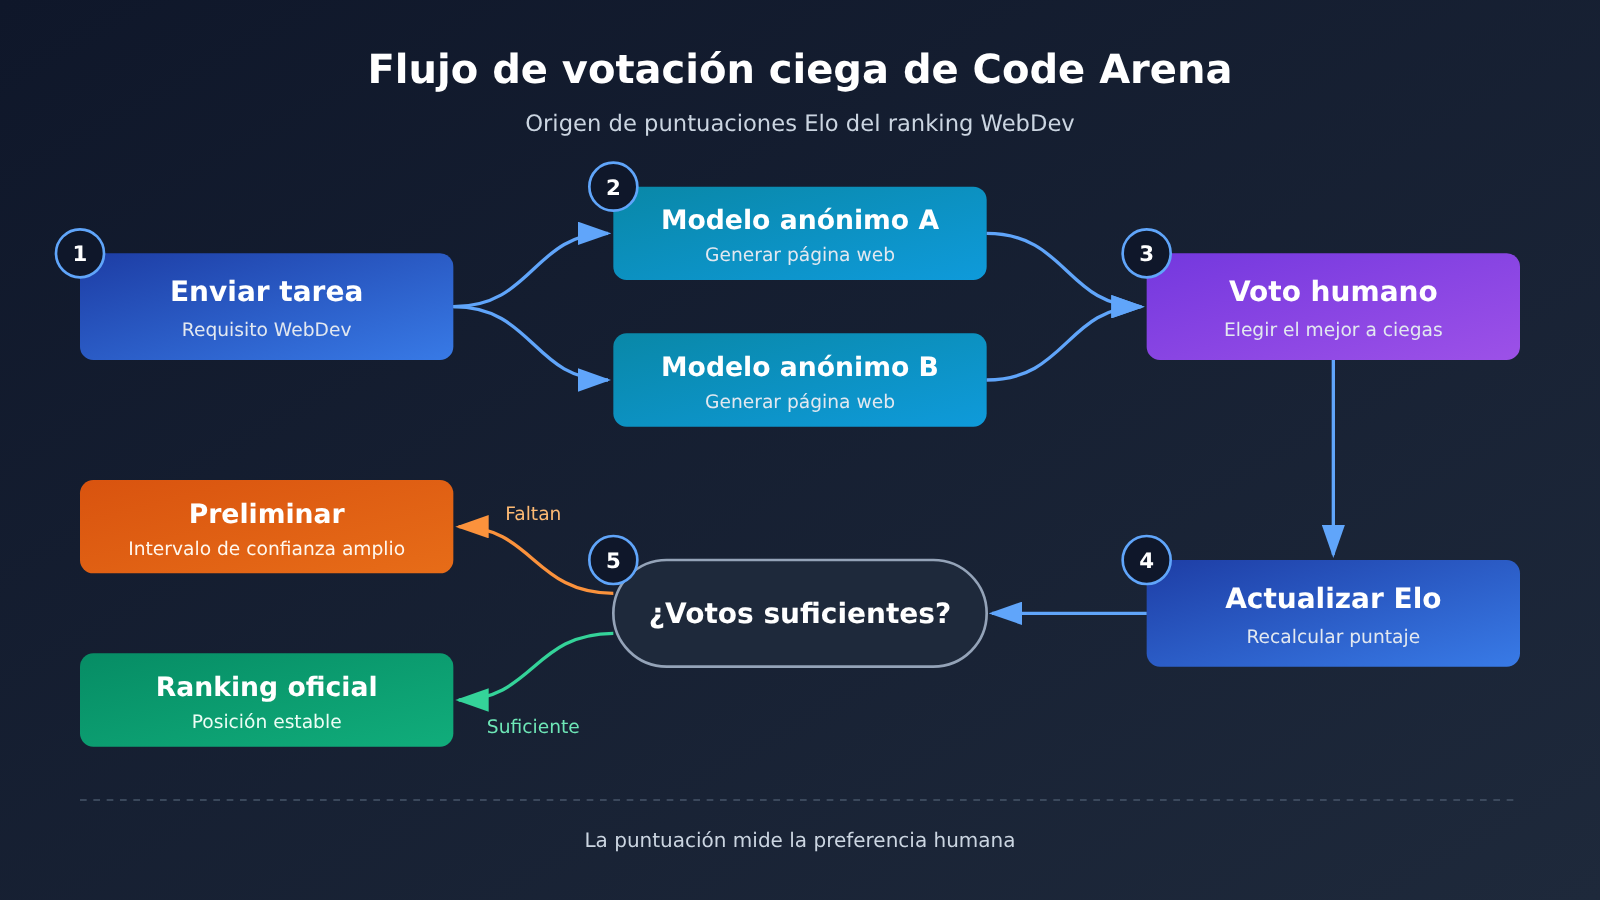
La puntuación Elo de Code Arena proviene de votaciones humanas a ciegas: el usuario plantea una misma tarea de desarrollo web, observa la producción de dos modelos anónimos y luego vota por la que considera mejor. La puntuación refleja «quién hace mejores páginas web a ojos de los evaluadores humanos»; mide preferencias, no una puntuación global de productividad.
También hay que entender qué significa la marca Preliminary. Indica que el modelo aún no ha participado en suficientes enfrentamientos y que su intervalo de confianza es amplio. Gemini 4 Carbon (High), que ocupa el 4.º puesto en la misma clasificación, también lleva esta marca; por eso no sería sorprendente que, en las próximas semanas, se intercambien posiciones dentro del tramo del 4.º al 6.º puesto.
¿Quiénes ocupan los seis primeros puestos en Code Arena WebDev? El panorama de rivales de Qwen4-Max
Enumerar los diez primeros completos permite ver de forma más directa en qué posición se encuentra Qwen4-Max. Los cinco primeros puestos están copados por tres laboratorios estadounidenses; Anthropic, por sí sola, ocupa tres de ellos.
| Posición | Modelo | Puntuación | Laboratorio | Notas |
|---|---|---|---|---|
| 1 | Claude Fable 5.2 (xHigh) | 1826 | Anthropic | Líder |
| 2 | Claude Opus 5.5 (Max) | 1816 | Anthropic | P50 por tarea: $8.99 |
| 3 | Claude Sonnet 5.5 (xHigh) | 1772 | Anthropic | — |
| 4 | Gemini 4 Carbon (High) | 1768 | Preliminar | |
| 5 | GPT-6 Astra (Max) | 1763 | OpenAI | P50 por tarea: $9.43 |
| 6 | Qwen4-Max (xHigh) | 1750 | Alibaba | Preliminar, 1,814 votos |
| 7 | Claude Fable 5.1 (Max) | 1743 | Anthropic | — |
| 8 | GPT-6.1 Sol (Max) | 1742 | OpenAI | — |
| 9 | Muse Wonder Full (Max) | 1724 | — | — |
| 10 | Claude Sonnet 5.5 (High) | 1716 | Anthropic | — |
Qué significa para Qwen4-Max el panorama de los cinco primeros
Entre los seis primeros, Anthropic ocupa 3 puestos (Fable 5.2, Opus 5.5 y Sonnet 5.5), Google y OpenAI 1 cada uno, y Alibaba 1. En otras palabras, Qwen4-Max se ha hecho un hueco entre los modelos insignia de tres laboratorios líderes, en lugar de haber conseguido un puesto en una clasificación poco competida.
Otro detalle digno de mención es que los puestos 6 a 8 están muy apretados: 1750, 1743 y 1742, con menos de 10 puntos de diferencia entre los tres. La ventaja de Qwen4-Max sobre Claude Fable 5.1 y GPT-6.1 Sol es menor que los 13 puntos que lo separan de GPT-6 Astra. Habrá que esperar a que aumente el número de votos para comprobar la estabilidad de la posición.
La posición de Qwen4-Max entre los modelos nacionales
Si nos fijamos solo en el panorama de modelos nacionales chinos, la ventaja de Qwen4-Max es bastante clara. Es el único modelo nacional que entra en el top 10; el segundo modelo nacional no aparece hasta el puesto 13.
| Ranking nacional | Modelo | Puntuación | Puesto en la clasificación | Diferencia con Qwen4-Max |
|---|---|---|---|---|
| 1 | Qwen4-Max (xHigh) | 1750 | 6.º | — |
| 2 | Kimi K3.1 Pro (Max) | 1686 | 13.º | −64 |
| 3 | Qwen3.8-Max (0902) | 1676 | 16.º | −74 |
| 4 | Qwen3.8-Max | 1670 | 18.º | −80 |
| 5 | Ernie 5.5 Flash Preview | 1668 | 18.º | −82 |
| 6 | DeepSeek-V4.1-Flash-20261017 (Max) | 1661 | 19.º | −89 |
| 7 | Kimi K3 (Max) | 1658 | 20.º | −92 |
| 8 | MiMo-V2.6-Flash | 1639 | 26.º | −111 |
| 9 | Hy4 preview | 1632 | 27.º | −118 |
| 10 | GLM-5.3 (Max) | 1622 | 31.º | −128 |
| 11 | DeepSeek-V4.1-Flash-20260910 | 1621 | 33.º | −129 |
Dos formas de leer la brecha entre los modelos nacionales
La primera es el salto generacional. Qwen4-Max supera a su propia generación anterior, Qwen3.8-Max (0902), por 74 puntos, y salta del puesto 16 al 6. Dentro de la misma clasificación y con el mismo mecanismo de votación, esta mejora es considerable.
La segunda tiene que ver con la distancia al segundo modelo nacional. Qwen4-Max está 64 puntos por encima de Kimi K3.1 Pro, una diferencia similar a los 66 puntos en los que Opus 5.5 está por delante de Qwen4-Max. Dicho de otro modo, Qwen4-Max se sitúa hoy en un punto intermedio entre los modelos nacionales y la élite global: por abajo ya marca distancia con sus rivales nacionales, pero por arriba todavía le queda camino hasta la cima.
Conviene tener en cuenta que los modelos nacionales del puesto 2 al 7 se apiñan entre 1686 y 1658, con diferencias muy pequeñas. Usar esta clasificación para establecer un orden entre ellos tiene poco sentido.
¿Cuánto le falta a Qwen4-Max para los líderes globales?
Diferencias de puntuación en Code Arena WebDev
Enumerar las diferencias entre Qwen4-Max y los modelos líderes, y estimar de forma aproximada la «probabilidad de victoria en enfrentamiento» con la fórmula Elo estándar (escala de 400 puntos), ayuda a entender qué significan realmente esas diferencias. El método estadístico concreto de la arena puede no coincidir exactamente con el Elo estándar, así que las probabilidades siguientes sirven solo como referencia intuitiva:
- Frente al 5.º puesto, GPT-6 Astra: 1750 vs 1763, 13 puntos de diferencia, probabilidad de victoria estimada en torno al 48%, prácticamente parejos.
- Frente al 2.º puesto, Opus 5.5: 66 puntos de diferencia, probabilidad de victoria estimada en torno al 41%.
- Frente al 1.er puesto, Fable 5.2: 76 puntos de diferencia, probabilidad de victoria estimada en torno al 39%.
- Frente al segundo modelo chino, Kimi K3.1 Pro: 64 puntos de ventaja, probabilidad de victoria estimada en torno al 59%.
El rango de puntuaciones de toda la tabla va de 1071 a 1826. En esta escala, los 76 puntos que separan a Qwen4-Max del primer puesto no son una barbaridad, pero también confirman que, en cuanto a preferencias de desarrollo web, el modelo líder de Anthropic sigue siendo el favorito de los evaluadores.
Otros benchmarks de la misma gráfica: un Elo alto no implica fortaleza en tareas de terminal
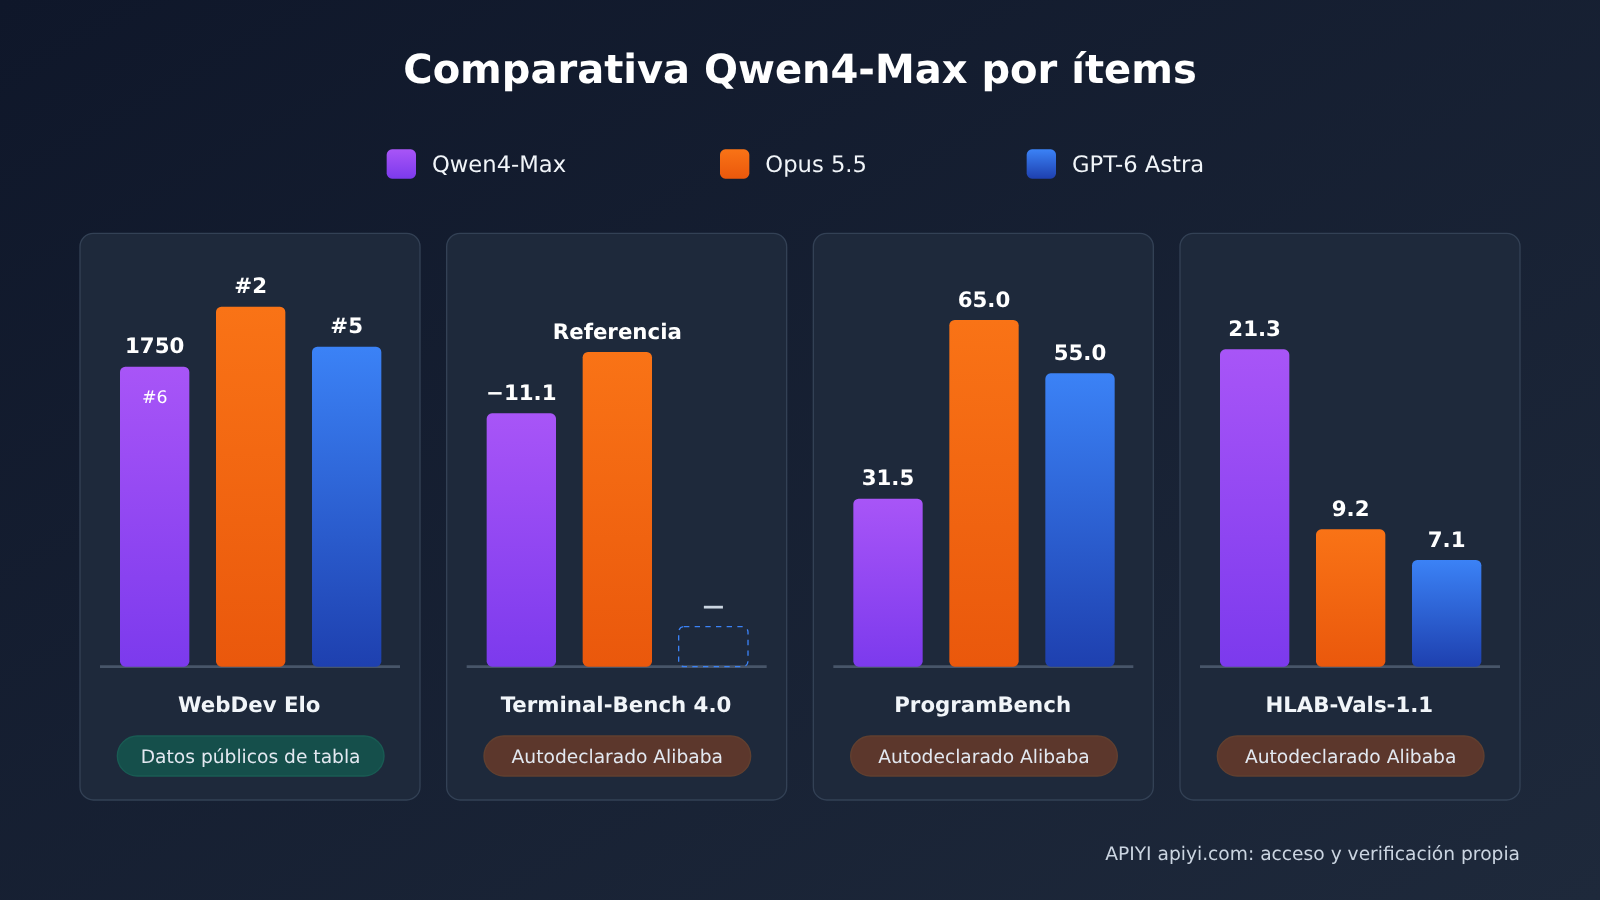
Cuando Alibaba presentó Qwen4-Max, lo acompañó con una única gráfica que reunía varios benchmarks. Los datos a continuación están reportados oficialmente por Alibaba; no son datos de la tabla de la arena ni resultados replicados por terceros.
| Benchmark (reporte oficial) | Qwen4-Max | Opus 5.5 | GPT-6 Astra | Otros |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 48.5 | 59.6 | 59.1 | Kimi 67.2 |
| ProgramBench | 31.5 | 65.0 | 55.0 | — |
| JobBench | 68.5 | 75.4 | — | — |
| HLAB-Vals-1.1 | 21.3 | 9.2 | 7.1 | — |
| AA-Briefcase v1.1 Elo | 1686 | 1801 | 1569 | — |
Esta tabla deja clara una cosa fundamental: Qwen4-Max obtiene puntuaciones muy altas en la prueba ciega de desarrollo web, pero en benchmarks de operación de terminal y de programación de ingeniería las diferencias siguen siendo evidentes. En Terminal-Bench 4.0 está 11.1 puntos por debajo de Opus 5.5, y el modelo Kimi de la gráfica alcanza incluso 67.2; en ProgramBench, su 31.5 no llega ni a la mitad de Opus 5.5.
También tiene apartados en los que lidera con claridad. En HLAB-Vals-1.1, Qwen4-Max consigue 21.3, muy por encima del 9.2 de Opus 5.5 y del 7.1 de GPT-6 Astra; en AA-Briefcase también supera a GPT-6 Astra. Por eso, la descripción más acertada es esta: el perfil de capacidades de Qwen4-Max es distinto al de los modelos líderes, y no que se haya «acercado en todos los frentes».
Cómo interpretar los votos y el costo de Qwen4-Max
Votos: qué significan 1,814 votos
Que un puesto se mantenga firme depende, en gran medida, del número de votos. Los 1,814 votos de Qwen4-Max representan menos del 0.2% de un total de aproximadamente 1 millón de votos, y además son bastantes menos que los de otros modelos chinos de la misma tabla.
| Modelo | Puesto | Votos | Costo por tarea P50 | Estado |
|---|---|---|---|---|
| Qwen4-Max (xHigh) | 6 | 1,814 | $4.18 | Preliminary |
| Kimi K3.1 Pro (Max) | 13 | 5,215 | $0.89 | — |
| Qwen3.8-Max (0902) | 16 | 23,030 | $1.91 | — |
| Claude Opus 5.5 (Max) | 2 | Datos públicos de la misma tabla | $8.99 | — |
| GPT-6 Astra (Max) | 5 | Datos públicos de la misma tabla | $9.43 | — |
Los votos de Qwen3.8-Max son unas 12.7 veces los de Qwen4-Max, y su puntuación se acerca más a un «valor estable». Los 1750 puntos de Qwen4-Max se parecen hoy más bien a una lectura temprana: pueden subir o bajar más adelante. A la hora de citar este puesto, conviene incluir siempre las tres salvedades: «Preliminary, 1,814 votos, 2026-11-14».
Costo P50 por tarea: no es el precio unitario del modelo
El costo P50 por tarea que aparece en el ranking se refiere a la mediana del gasto de una sola ejecución en las tareas de ese ranking. Se ve muy influenciado por la longitud de salida del modelo y por el nivel de intensidad de razonamiento (como xHigh, Max), así que no debe compararse como si fuera el precio por millón de tokens del modelo.
Con este criterio, los $4.18 de Qwen4-Max representan aproximadamente el 46 % de los $8.99 de Opus 5.5 y el 44 % de los $9.43 de GPT-6 Astra, pero equivalen a alrededor de 4.7 veces los $0.89 de Kimi K3.1 Pro y a 2.2 veces los $1.91 de Qwen3.8-Max, de la generación anterior. Si tu caso de uso es sensible al costo por ejecución, Kimi K3.1 Pro obtuvo 1686 puntos con aproximadamente una quinta parte del costo; también vale la pena incluirlo en la evaluación.
Precio oficial de Qwen4-Max y precio actual en APIYI
A continuación, los precios por cada 1M tokens, con fecha de consulta 2026-11-16:
- Precio oficial de Qwen4-Max: entrada $1.5, salida $4.5, lectura de caché $0.075.
- Qwen insignia a la venta en APIYI
qwen3.8-max: entrada $1.65, salida $4.95, lectura de caché $0.20625.
Cabe aclarar que APIYI todavía no tiene qwen4-max disponible; publicaremos este modelo lo antes posible. Son modelos diferentes, por lo que los precios anteriores no pueden compararse directamente entre sí. Para conocer los modelos realmente disponibles y sus precios, consulta la lista de modelos de la plataforma APIYI apiyi.com.
Los tres pasos: revisar el ranking, comparar precios y cambiar el endpoint
Después de leer un ranking, los desarrolladores suelen hacer tres cosas: verificar las posiciones, comprobar los precios y conectar el modelo a su propio proyecto para probarlo. Se recomienda seguir este orden:
- Revisar el ranking: abre la página Code Arena WebDev de arena.ai y confirma si cambiaron la fecha, los votos y la etiqueta Preliminary.
- Comparar precios: consulta en la lista de modelos de APIYI apiyi.com los modelos Qwen disponibles actualmente y sus precios en tiempo real; confirma si
qwen4-maxya está publicado. - Cambiar el endpoint: en el SDK compatible con OpenAI que ya usas, cambia
base_urlahttps://api.apiyi.com/v1; en el ID del modelo, pon primeroqwen3.8-max; cuando el nuevo modelo esté disponible, cámbialo aqwen4-maxpara comparar.
🚀 Consejo para empezar rápido: Si quieres comprobar la diferencia entre la serie Qwen y Claude, GPT y Gemini en tus propias tareas de WebDev, puedes usar APIYI apiyi.com para invocar varios modelos con una sola clave API. Los usuarios nuevos tienen una cuota de prueba gratuita, ideal para ejecutar primero un lote de muestras pequeñas y luego decidir qué modelo elegir.
Análisis de ventajas y desventajas de Qwen4-Max
Ventajas de Qwen4-Max
- Puntuación de preferencia en desarrollo web líder entre los modelos nacionales: 1750 puntos, 64 puntos por encima del segundo modelo nacional y 74 puntos por encima de la generación anterior.
- Algunas diferencias con los líderes ya son mínimas: solo 13 puntos del quinto clasificado, GPT-6 Astra, y prácticamente empatado con los puestos 7 y 8.
- Costo por tarea inferior al de los modelos insignia de la cabeza: P50: $4.18, menos de la mitad de lo que cuestan Opus 5.5 y GPT-6 Astra.
- Algunos benchmarks tienen una ventaja especial: la puntuación autodeclarada oficialmente en HLAB-Vals-1.1 supera claramente a Opus 5.5 y GPT-6 Astra.
Limitaciones de Qwen4-Max
- La posición aún no es estable: lleva la etiqueta Preliminary y suma 1,814 votos; al citarla, hay que indicar esas condiciones.
- Va por detrás en benchmarks de terminal y programación de ingeniería: en Terminal-Bench 4.0 y ProgramBench está claramente por debajo de Opus 5.5 y GPT-6 Astra; para tareas de agentes o automatización de línea de comandos, hay que evaluarlo por separado.
- Costo por tarea superior al de algunos modelos nacionales: es bastante más caro que Kimi K3.1 Pro y Qwen3.8-Max; en escenarios sensibles al costo puede no compensar.
Cuándo no conviene fijarse solo en el ranking Code Arena WebDev
Si tu escenario principal es la operación de terminal, la modificación de código en flujos largos o tareas de agentes de varios pasos, mirar solo el WebDev Elo te llevará a sobreestimar el rendimiento real de Qwen4-Max; en esos casos, benchmarks como Terminal-Bench se ajustan mejor a lo que necesitas. Del mismo modo, si el presupuesto es una limitación innegociable, conviene considerar el costo por tarea junto con la puntuación, en lugar de perseguir únicamente la posición. Este ranking responde mejor a una pregunta: «¿quién hace mejores páginas web a ojos de evaluadores humanos?».
Preguntas frecuentes (FAQ)
P1: ¿El puesto 6 de Qwen4-Max en Code Arena WebDev es real?
Sí, es la posición real que aparece en la página del ranking (2026-11-14, categoría Overall, 1750 puntos). Pero lleva la marca Preliminary y solo tiene 1.814 votos, así que la posición todavía puede moverse; al citarla, conviene aclarar estas condiciones.
P2: ¿Qué diferencia hay entre Qwen4-Max, GPT-6 Astra y Opus 5.5?
En Code Arena WebDev, Qwen4-Max está 13 puntos por debajo de GPT-6 Astra, 66 puntos por debajo de Opus 5.5 y 76 puntos por debajo de Fable 5.2, el líder de la tabla. Pero en Terminal-Bench 4.0 y ProgramBench, según las cifras que Alibaba reporta por su cuenta, la diferencia con esos dos modelos es bastante mayor.
P3: ¿Cuánta ventaja tiene Qwen4-Max frente a los demás modelos chinos?
Es el único modelo chino que entra en el top ten: le saca 64 puntos al segundo modelo nacional, Kimi K3.1 Pro (puesto 13, 1686 puntos), y 74 puntos a su propia generación anterior, Qwen3.8-Max (0902).
P4: ¿Para qué escenarios es más adecuado Qwen4-Max?
Según el criterio de este ranking, encaja mejor en tareas de WebDev como la generación de front-end web, las landing pages y los prototipos interactivos. Para escenarios como la automatización de terminal o las modificaciones de código a nivel de grandes proyectos, conviene consultar los benchmarks de terminal y validar con muestras propias.
P5: ¿Cómo llamo a los modelos de la familia Qwen vía API para hacer pruebas comparativas?
Puedes registrarte en APIYI apiyi.com y obtener una clave API; en el SDK compatible con OpenAI, configura base_url como `https://api.apiyi.com/v1` y usa `qwen3.8-max` como ID del modelo. `qwen4-max` todavía no está publicado, pero lo subiremos pronto; cuando esté disponible, basta cambiar el ID del modelo para alternar la comparación.
P6: ¿Los $4.18 por tarea son el precio de Qwen4-Max?
No. Los $4.18 son el costo medio por tarea que registra el ranking (P50), y dependen de la longitud de salida y del nivel de razonamiento. El precio unitario del modelo hay que mirarlo en las tarifas de entrada, salida y lectura de caché por cada 1M tokens; los precios en tiempo real puedes verificarlos en la lista de modelos de APIYI apiyi.com.
Qwen4-Max Code Arena WebDev: puntos clave
- Posición: puesto 6 en la clasificación del 2026-11-14, con 1750 puntos; es la primera vez que un modelo chino entra en el top seis.
- Panorama: los cinco primeros puestos están ocupados por tres modelos de Anthropic, uno de Google y uno de OpenAI.
- Estabilidad: la etiqueta Preliminary suma 1,814 votos, por lo que la posición aún puede cambiar.
- Diferencia entre modelos chinos: aventaja en 64 puntos a Kimi K3.1 Pro y en 74 puntos a la generación anterior.
- Límites de capacidad: en Terminal-Bench y ProgramBench, según los datos que la propia empresa reporta, aún está por detrás de los líderes.
- Criterio de coste: el P50 de $4.18 es la mediana por tarea, no el precio unitario del modelo.
- Cómo empezar: puedes montar primero el flujo de comparación con
qwen3.8-maxen APIYI y cambiar cuando el nuevo modelo esté disponible.
Resumen
El desempeño de Qwen4-Max en la clasificación Code Arena WebDev se puede resumir en tres puntos:
- Primera entrada en el top seis: 1750 puntos, el único modelo de un laboratorio no estadounidense en el top seis, a solo 13 puntos del quinto puesto.
- La posición aún es una lectura preliminar: Preliminary, 1,814 votos; al citarla, conviene indicar claramente la fecha y el número de votos.
- Elo no equivale a fortaleza integral: en los benchmarks de terminal y de programación de ingeniería que la propia empresa reporta, sigue por detrás de Opus 5.5 y GPT-6 Astra.
Si estás eligiendo entre modelos, te sugiero usar esta clasificación como una dimensión de referencia sobre la “preferencia en desarrollo web”, y luego combinarla con tus propias muestras de tareas y tu presupuesto para decidir. Recomiendo usar APIYI apiyi.com para poner los modelos candidatos en el mismo lote de tareas a través de una interfaz unificada y sacar conclusiones con tus propios datos.
📚 Referencias
- Clasificación Code Arena WebDev de arena.ai: fuente de las posiciones, puntuaciones, votos y coste por tarea de este artículo
- Enlace:
arena.ai -
Nota: la página indica 2026-11-14, categoría Overall; puedes verificar por tu cuenta las posiciones más recientes y la marca Preliminary
-
Imagen oficial de lanzamiento de Alibaba Qwen4-Max: fuente de las puntuaciones de benchmarks como Terminal-Bench 4.0 y ProgramBench
- Enlace: consulta los canales oficiales de publicación de Qwen
- Nota: los datos relevantes del artículo son autodeclarados por el fabricante, no reproducciones de terceros
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos en la página de inicio del sitio web de APIYI; para información sobre publicación de modelos e integración, visita el centro de documentación docs.apiyi.com


