
Nota del autor: los pesos de código abierto de Wenxin 5.5 Flash Base ya están disponibles para descargar. En este artículo analizamos la arquitectura y sus parámetros, los requisitos de hardware, el uso previsto y los costos para ayudarte a decidir si desplegar el modelo base por tu cuenta o invocarlo mediante una API según tus necesidades.
El 5 de noviembre de 2026, Baidu presentó oficialmente y publicó como código abierto Wenxin 5.5 Flash Base (ERNIE-5.5-Flash-Base). Es un modelo base MoE disperso con 280B de parámetros totales, de los cuales activa 14B por token, y ha alcanzado resultados de vanguardia (SOTA) en varios benchmarks para modelos de su tamaño. Los pesos ya están disponibles en Hugging Face en versiones FP8 y BF16, junto con un complemento para vLLM y un Cookbook de SGLang. Esta vez no se han limitado a publicar un artículo sin los pesos.
Este no es otro artículo que se limita a repetir resultados de benchmarks. Muchos equipos ven «código abierto + SOTA» y se preparan para descargar los pesos y poner el modelo en producción, pero pasan por alto un detalle clave: es un modelo base que no ha pasado por entrenamiento intermedio ni posentrenamiento. Es un buen punto de partida para entrenar, pero no se puede usar directamente como chatbot.
La idea principal: al terminar de leer, tendrás claro para qué casos sirve Wenxin 5.5 Flash Base, cuánta memoria de GPU necesitas aproximadamente para desplegarlo por tu cuenta y en qué condiciones sale más rentable invocarlo mediante una API según tus necesidades.
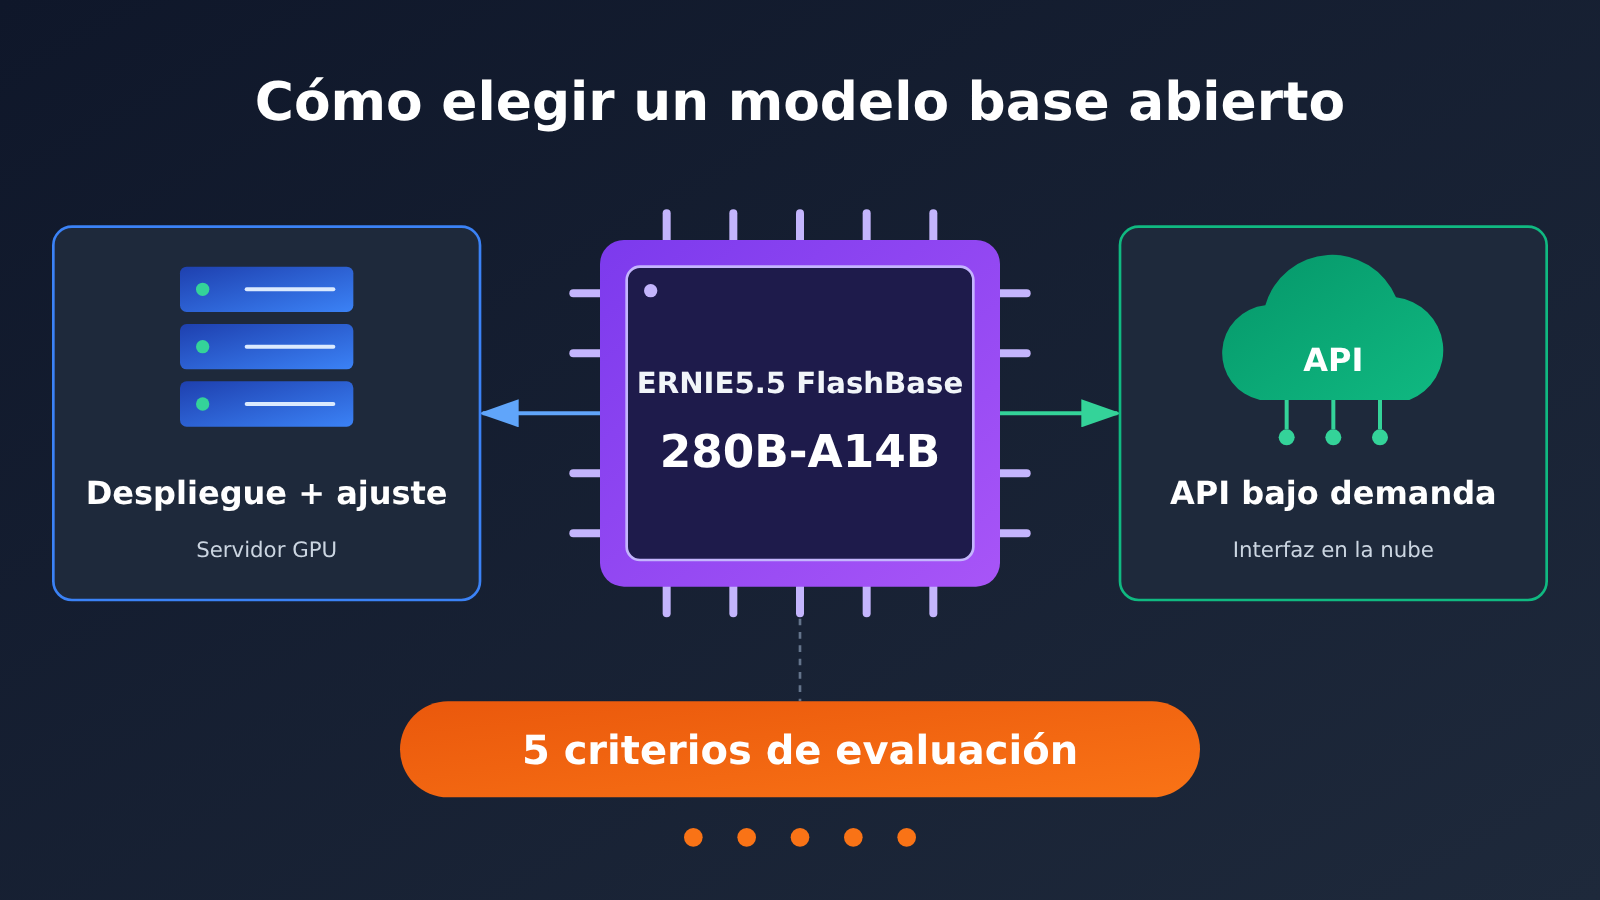
Puntos clave de Wenxin 5.5 Flash Base
Empecemos con una tabla que resume la información más importante del modelo. Estos datos serán determinantes para decidir si conviene desplegarlo o acceder a él mediante una API.
| Aspecto | Descripción | Influencia en la elección |
|---|---|---|
| Tipo de modelo | Checkpoint al final del preentrenamiento, sin entrenamiento intermedio ni posterior | No puede mantener una conversación directamente; está pensado para seguir entrenándolo |
| Tamaño | 280B de parámetros totales, con 14B activos por token | Requiere menos cómputo para la inferencia, pero la memoria de GPU necesaria para los pesos corresponde a 280B |
| Contexto | Ventana de contexto de entrenamiento de 128K; admite 1M de tokens en ajuste fino e inferencia | Adecuado para la adaptación a dominios como documentos extensos y código de repositorios completos |
| Formato de los pesos | Hugging Face ofrece versiones FP8 y BF16 | FP8 reduce considerablemente los requisitos de despliegue |
| Compatibilidad | Plugin de vLLM y Cookbook de SGLang | Puede integrarse directamente con los principales frameworks de inferencia |
Qué significa «Base» en Wenxin 5.5 Flash Base
Un modelo Base solo ha aprendido a «predecir el siguiente token»; no ha aprendido a «entender instrucciones y responder». Si le haces una pregunta, es probable que continúe escribiendo más preguntas en lugar de darte una respuesta. Baidu también lo explica claramente: los desarrolladores pueden usar este punto de partida común para seguir con la adaptación a dominios, el ajuste fino para instrucciones, el refuerzo del razonamiento y el entrenamiento de agentes.
Así que el primer criterio es sencillo: si tu objetivo es «usar un modelo», Base no es lo que buscas; si quieres «entrenar un modelo», sí puede ser un buen punto de partida. Baidu también ha adelantado que la versión definitiva de Wenxin 5.5 Flash llegará pronto. Los equipos que quieran usarlo directamente para conversar pueden esperar a esa versión.
Modelos de tamaño similar a Wenxin 5.5 Flash Base
En las evaluaciones publicadas por Baidu, los modelos comparados incluyen DeepSeek-V4-Flash-Base (284B-A13B), Hy3-preview-Base (295B-A21B) y MiMo-V2.5-Base (310B-A15B). Wenxin 5.5 Flash Base destaca en tareas de razonamiento, código, conocimiento de distintas disciplinas y contexto largo. Para los equipos que quieran ajustar un modelo en ámbitos como los agentes de programación o la comprensión de documentos extensos, merece la pena incluirlo entre los candidatos.
Cómo funciona ERNIE 5.5 Flash Base: tres mejoras de eficiencia
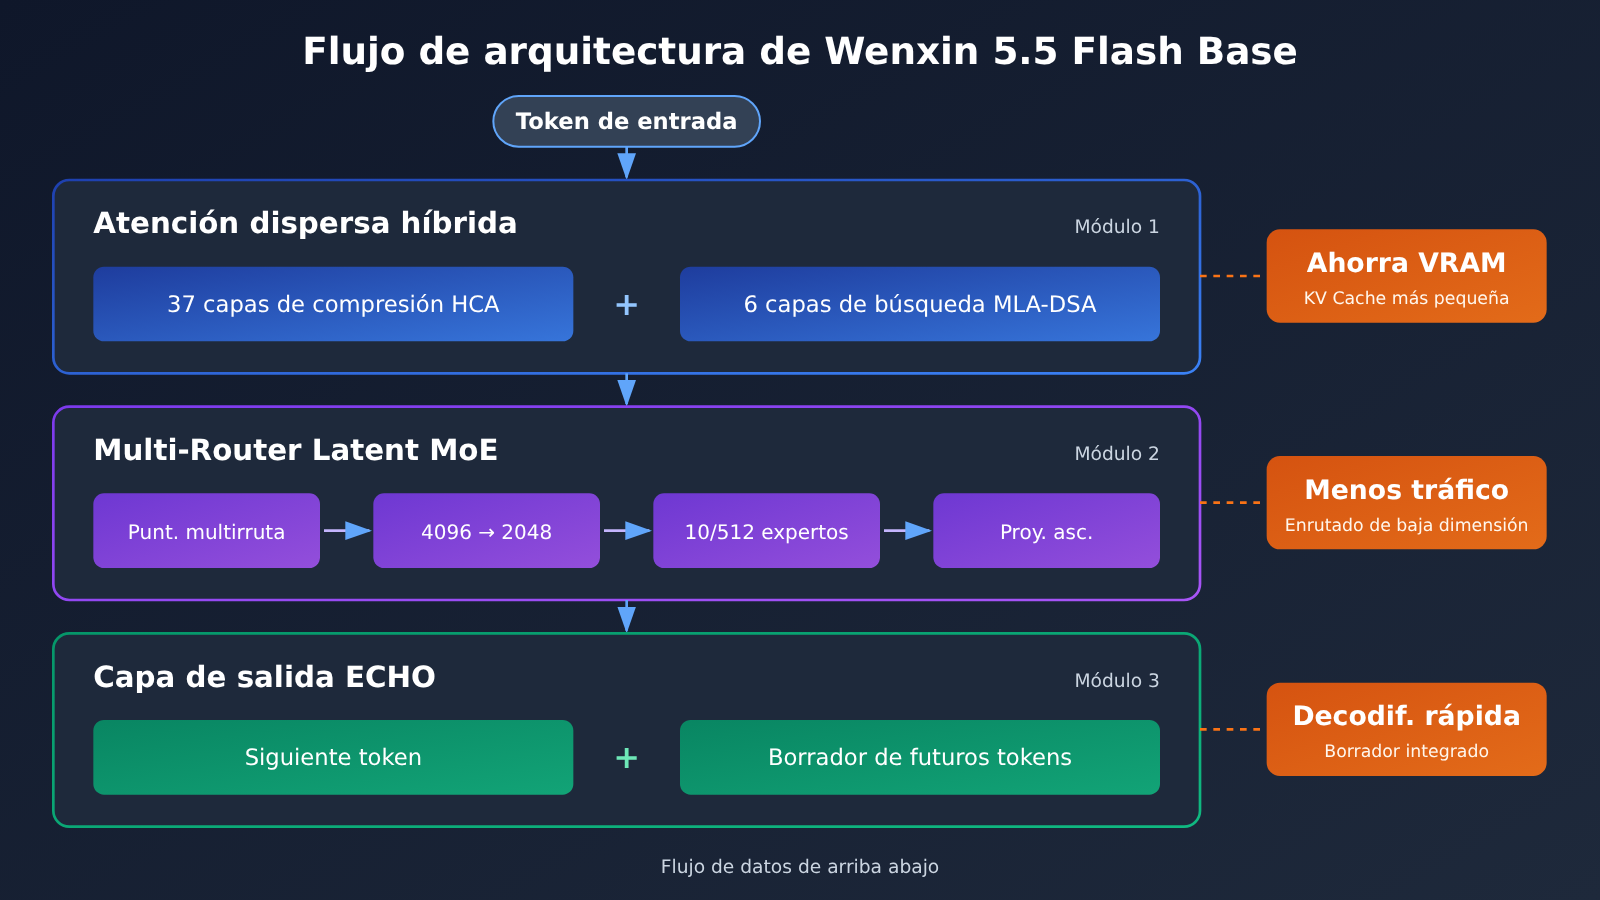
Entender la arquitectura ayuda a estimar los costos de despliegue. El equipo de ERNIE incorporó la eficiencia como variable de diseño durante el preentrenamiento y concentró las principales mejoras en tres áreas: atención, enrutamiento de expertos y predicción de tokens futuros.
| Módulo | Diseño clave | Ventaja para el despliegue |
|---|---|---|
| Atención dispersa híbrida | 37 de las 43 capas usan HCA (cada 128 tokens se comprimen en una entrada de caché) y 6 usan recuperación dispersa MLA + DSA | La caché KV se reduce considerablemente y los contextos largos consumen menos memoria de GPU |
| Multi-Router Latent MoE | Varios enrutadores Sigmoid puntúan conjuntamente; se seleccionan 10 de 512 expertos enrutados, más 1 experto compartido; los expertos calculan en un espacio latente de 2048 dimensiones | Los FLOPs de los expertos y el volumen de comunicación para distribuir las tareas se reducen aproximadamente a la mitad |
| ECHO | Reutiliza la última capa de la red principal para predecir tokens futuros | Puede funcionar directamente como modelo borrador integrado para decodificación especulativa, sin añadir parámetros |
| Diseños complementarios | Cabeza de salida MultiMax y tokenizador R2L con un vocabulario de unos 200 000 términos | Manejo más estable de números y operaciones aritméticas |
Por qué ERNIE 5.5 Flash Base ahorra memoria en la caché KV
En un modelo tradicional, cada capa debe guardar una caché KV completa, por lo que la memoria de GPU se vuelve cada vez más limitada a medida que crece el contexto. En ERNIE 5.5 Flash Base, 37 capas solo consultan «resúmenes» comprimidos y únicamente 6 acceden al historial token por token. Estas 6 capas usan además un indexador ligero para seleccionar las posiciones Top-K y realizar cálculos más detallados. Esto significa que, con contextos de 128K o incluso más largos, la caché KV ocupa mucho menos que en un modelo de atención completa de tamaño similar. Para los equipos que despliegan el modelo por su cuenta, el ahorro de memoria de GPU es considerable.
Qué aporta ECHO a la aceleración de la inferencia
Durante el preentrenamiento, ECHO predice solo 1 token adicional. Sin embargo, cuando actúa como modelo borrador, puede generar varios tokens consecutivos y alcanza una tasa de aceptación mayor que la de un módulo MTP externo entrenado de la misma manera. Al desplegar el modelo por cuenta propia, si el framework de inferencia admite esta vía de decodificación especulativa, el rendimiento puede aumentar de forma considerable. Esta es también una ventaja de los pesos abiertos frente a una API: puedes controlar por completo este tipo de optimizaciones de inferencia.
Primeros pasos con Wenxin 5.5 Flash Base: despliegue propio
Si tienes claro que quieres usar este modelo base para entrenarlo o ejecutar inferencia en un entorno privado, esta es la ruta más corta. No incluimos código; explicamos los parámetros clave en el texto.
Primer paso: estimar la memoria de GPU necesaria
El cálculo de un modelo MoE depende de los parámetros activados, pero todos los pesos deben cargarse. Por eso, la memoria de GPU se calcula a partir de los 280B de parámetros totales. La siguiente tabla ofrece estimaciones aproximadas basadas en «bytes por parámetro × número de parámetros». No incluye la caché KV, los valores de activación ni la sobrecarga del framework; consulta la documentación oficial y haz tus propias pruebas para conocer los requisitos reales.
| Versión de pesos | Memoria de GPU estimada para los pesos | Recomendación de despliegue (estimada) | Uso adecuado |
|---|---|---|---|
| FP8 | Unos 280GB | Una máquina con 8 GPU de 80GB, con espacio disponible para la caché KV | Evaluación de inferencia y servicios ligeros |
| BF16 | Unos 560GB | Una máquina con 8 GPU de gran memoria o paralelismo de tensores en varias máquinas | Evaluaciones sensibles a la precisión y punto de partida para el ajuste fino |
| Ajuste fino de todos los parámetros | Muy superior a la inferencia (también requiere estados del optimizador y gradientes) | Clúster de varias máquinas; requiere un framework de entrenamiento distribuido | Adaptación profunda a un dominio |
| Ajuste fino tipo LoRA | Entre la inferencia y el ajuste de todos los parámetros | Depende del rango y la longitud de la secuencia | Adaptación a un dominio para equipos pequeños y medianos |
Segundo paso: elegir un framework de inferencia y cargar los pesos
El equipo oficial también proporciona un complemento para vLLM y el SGLang Cookbook. Lo recomendable es seguir primero uno de estos dos recursos:
- Descarga los pesos FP8 o BF16 desde Hugging Face y reserva en disco un espacio similar al que ocuparán en la memoria de GPU.
- Instala vLLM y carga el complemento oficial, o configura los parámetros de arranque siguiendo el SGLang Cookbook.
- Ajusta el grado de paralelismo de tensores al número de GPU (en vLLM corresponde al parámetro
tensor-parallel-size). - Empieza con una longitud de contexto de alrededor de 32K para comprobar que todo funciona. Después, auméntala gradualmente y observa el uso de la caché KV.
- Haz una prueba rápida con una indicación de continuación: por ejemplo, dale el inicio de un fragmento de código para que lo complete, en lugar de hacerle una pregunta directa.
Tercer paso: definir el objetivo del entrenamiento
Una vez disponibles los pesos Base, empieza el verdadero trabajo. Hay tres caminos habituales: continuar el preentrenamiento con un corpus especializado, hacer SFT con datos de instrucciones y, a partir de ese SFT, reforzar el razonamiento o entrenar trayectorias de agentes. Durante el preentrenamiento, Wenxin ya incorporó datos de código, como commits, issues, PR y correcciones verificadas mediante CI, además de textos largos con preguntas y respuestas de varios saltos. Por eso, la ingeniería de código y los documentos extensos son las áreas con mayor potencial para el ajuste fino.
🎯 Consejo técnico: antes de invertir en GPU para el ajuste fino, conviene evaluar primero un modelo de instrucciones ya disponible con tu conjunto de evaluación de negocio y obtener una «puntuación de referencia». APIYI apiyi.com ofrece una interfaz unificada para modelos de varios proveedores principales, con la que puedes obtener una referencia comparativa a bajo costo y decidir después si vale la pena invertir en entrenar el modelo base por tu cuenta.
Inicio rápido con Wenxin 5.5 Flash Base: acceso a la API según tus necesidades
Primero, hay que aclarar algo: APIYI todavía no ofrece los modelos de la serie Wenxin ERNIE, incluido Wenxin 5.5 Flash Base, pero trabajamos para incorporarlos cuanto antes. Además, un modelo Base no es adecuado para usarse directamente como API de chat: la mayoría de los proyectos necesitan una versión de instrucciones o de razonamiento.
Si necesitas integrar estas capacidades en tu producto de inmediato, puedes empezar con modelos maduros que ya están disponibles y, cuando se publique la versión definitiva de Wenxin 5.5 Flash, sustituirlos y comparar los resultados. APIYI es compatible con los formatos de interfaz de OpenAI y Anthropic, así que para cambiar de modelo solo tienes que modificar el parámetro model, sin reescribir la lógica de invocación.
Precios de los modelos alternativos disponibles en APIYI
Los siguientes precios proceden de la página de precios de APIYI, docs.apiyi.com/models, y se expresan en dólares por millón de tokens. Consulta los datos más recientes en la página antes de realizar una invocación.
| Modelo | Entrada | Salida | Caché | Casos de uso | Plataforma disponible |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Tareas de alta concurrencia y sensibles al costo | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Contextos largos y casos de uso en chino | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Modelo principal para programación y agentes | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Razonamiento complejo y tareas difíciles | APIYI apiyi.com |
| Wenxin 5.5 Flash Base / versión definitiva | — | — | — | APIYI aún no ofrece este modelo | Disponible próximamente |
APIYI también ofrece otros modelos chinos, como la serie qwen3.8, además de los modelos de imagen gpt-image-2.6-flare y gpt-image-2.6-sunburst (entrada de texto $5, entrada de imágenes $8 y salida $30; consulta la página de precios para conocer las tarifas vigentes). Ten en cuenta que deepseek-v4.1-flash, incluido en la tabla, es un modelo de instrucciones que se puede invocar directamente; no es el mismo que DeepSeek-V4-Flash-Base, utilizado en la comparación de las evaluaciones.
Cómo integrar la API
Con el formato de OpenAI, configura base_url en el SDK con la dirección de la interfaz proporcionada en la documentación de APIYI e introduce en api_key la clave generada en la consola. Los proyectos que utilizan el SDK de Anthropic también pueden integrarse directamente. Para consultar la dirección completa de la interfaz, los parámetros y los ejemplos, visita el centro de documentación de APIYI en docs.apiyi.com.
🚀 Inicio rápido: te recomendamos empezar con deepseek-v4.1-flash o claude-sonnet-5-5 en APIYI apiyi.com para poner en marcha un prototipo. Cuando la versión definitiva de Wenxin 5.5 Flash esté disponible en la plataforma, solo tendrás que cambiar el nombre del modelo para hacer una comparación A/B.
Autodespliegue de 文心5.5 Flash Base frente a llamadas a la API: tabla de decisión
Estas recomendaciones cubren cinco aspectos para ayudarte a identificar qué opción encaja mejor con tu equipo.
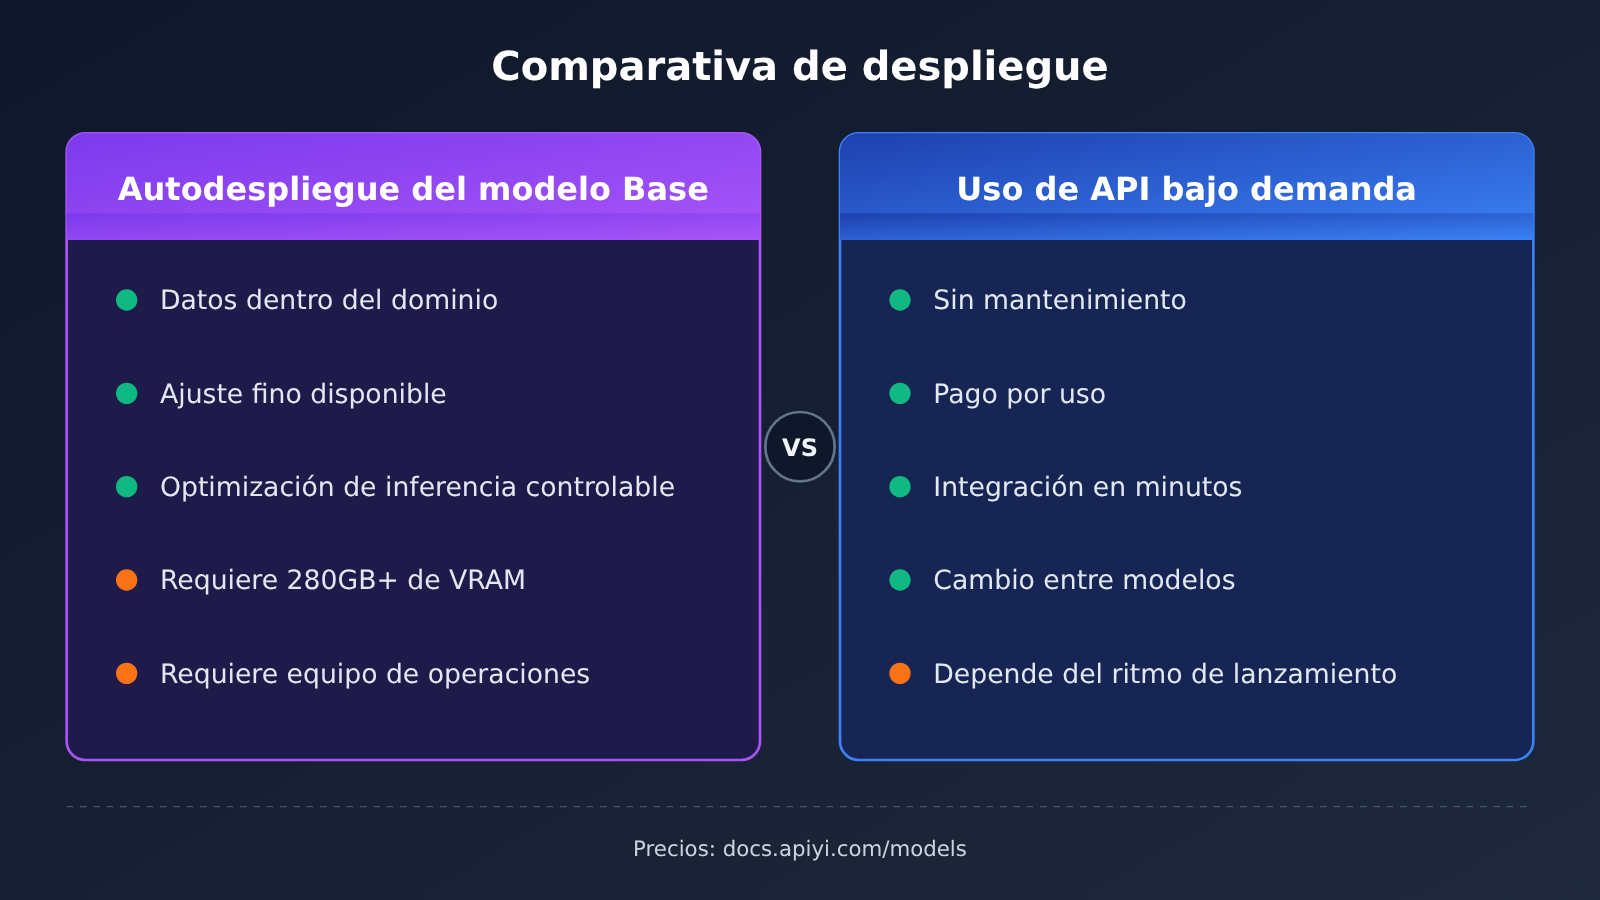
| Aspecto | Autodespliegue de Base | Llamadas a la API bajo demanda |
|---|---|---|
| Objetivo | Continuar el preentrenamiento en un dominio, aplicar SFT o RL, o realizar experimentos comparativos de investigación | Crear directamente aplicaciones de preguntas y respuestas, redacción o asistencia para programación |
| Cumplimiento de datos | Los datos no pueden salir de la red interna y se requiere un despliegue privado | Los datos pueden procesarse en la nube y se aceptan las condiciones de cumplimiento del proveedor |
| Volumen de llamadas | Carga alta y estable a largo plazo, con un uso sostenido de las GPU | Tráfico muy variable o volumen diario de llamadas limitado |
| Capacidades del equipo | Cuenta con ingenieros de entrenamiento y operación de inferencia | Se dedica principalmente al desarrollo de aplicaciones y no quiere mantener un clúster |
| Tiempo de puesta en producción | Puede asumir ciclos de entrenamiento de varias semanas o meses | Necesita lanzar esta misma semana |
Dos perfiles típicos de usuarios de 文心5.5 Flash Base
Equipos a los que les conviene el autodespliegue: por ejemplo, equipos de finanzas, salud o administraciones públicas con requisitos de despliegue privado, abundantes corpus de dominio y el objetivo de entrenar un modelo propio. Estos equipos eligen 文心5.5 Flash Base por su base de preentrenamiento en código y contextos largos, así como por el ahorro de KV Cache que ofrece la arquitectura HCA.
Equipos a los que les conviene llamar a la API: por ejemplo, equipos que desarrollan SaaS, herramientas de contenido o sistemas de atención al cliente y buscan, ante todo, estabilidad, rapidez y pago por uso. Para ellos, partir directamente de un modelo Base supone añadir una etapa de entrenamiento. Una opción más razonable es lanzar primero con un modelo de instrucciones maduro y centrar los esfuerzos en el producto.
Las dos opciones pueden avanzar en paralelo
Muchos equipos usan un «modelo híbrido»: las aplicaciones en producción llaman a la API para garantizar la estabilidad, mientras el equipo experimenta internamente con los pesos de Base. Cuando el modelo entrenado internamente supera en el conjunto de evaluación la línea base de la API, el tráfico se transfiere de forma gradual. Este enfoque minimiza el riesgo y mantiene una referencia clara para evaluar la inversión en desarrollo propio.
💡 Recomendación: si aún tienes dudas, empieza por hacer cuentas: calcula el costo mensual a partir del volumen estimado de llamadas y los precios unitarios de la página de APIYI, y compáralo con el costo de alquiler o depreciación de las GPU. Hacer una prueba a pequeña escala durante una semana mediante la interfaz unificada de APIYI en apiyi.com te dará un consumo real de tokens con el que decidir, mucho más preciso que una estimación intuitiva.
Preguntas frecuentes (FAQ)
P1: ¿Qué es Wenxin 5.5 Flash Base?
Es un modelo base de código abierto publicado por Baidu el 5 de noviembre de 2026. Usa una arquitectura MoE dispersa, tiene 280B de parámetros totales, activa 14B por token y fue preentrenado desde cero con 33.5T de tokens. Los pesos publicados corresponden al final del preentrenamiento y están pensados principalmente para continuar el entrenamiento, no para conversar directamente con el modelo.
P2: ¿Qué diferencia hay entre Wenxin 5.5 Flash Base y DeepSeek-V4-Flash-Base?
Ambos tienen una escala similar: DeepSeek-V4-Flash-Base cuenta con 284B-A13B. También es un modelo base potente, pero, según las evaluaciones publicadas por Baidu, Wenxin 5.5 Flash Base obtiene mejores resultados en razonamiento, código, conocimientos especializados y contexto largo. En cuanto a la arquitectura, Wenxin combina mecanismos de atención HCA y MLA con un MoE de múltiples enrutadores, y pone más énfasis en comprimir la caché KV y mejorar la robustez del enrutamiento.
P3: ¿Cuándo se publicará la versión final de Wenxin 5.5 Flash?
Baidu ha indicado que la versión final llegará próximamente, pero al momento de escribir este artículo (6 de noviembre de 2026) no había dado una fecha concreta. La versión final completará el posentrenamiento a partir de Base y será más adecuada para integrarla directamente en aplicaciones.
P4: ¿Para qué casos de uso es más adecuado Wenxin 5.5 Flash Base?
Es especialmente útil para los siguientes casos:
– **Entrenamiento de modelos de código a escala de repositorio**: el preentrenamiento ya incluye datos de ingeniería como commits, PR y correcciones de CI.
– **Modelos especializados para documentos largos**: por ejemplo, para comprender expedientes legales o informes de investigación en contextos largos. El ajuste fino y la inferencia admiten 1M de tokens.
– **Investigación de métodos de entrenamiento**: sirve como punto de partida común para comparar los resultados de distintas estrategias de SFT y RL.
P5: ¿Ya se puede acceder a Wenxin 5.5 Flash Base mediante API?
Por ahora, APIYI no ofrece este modelo ni el resto de la serie ERNIE, pero trabajamos para incorporarlos lo antes posible. Actualmente puedes usar en APIYI, apiyi.com, modelos ya disponibles como deepseek-v4.1-flash, kimi-k3.1-pro y claude-sonnet-5-5. La plataforma es compatible con los formatos de interfaz de OpenAI y Anthropic; consulta los precios vigentes en docs.apiyi.com/models.
P6: ¿Qué limitaciones tiene desplegar Wenxin 5.5 Flash Base por cuenta propia?
La primera es el alto requisito de memoria de GPU: incluso con pesos FP8, solo los pesos necesitan unos 280GB. La segunda es que el modelo Base no está listo para usar de inmediato: hay que invertir en su entrenamiento. La tercera es que la inferencia con contexto largo también requiere reservar espacio para la caché KV. Si el equipo no tiene experiencia en entrenamiento y operación, conviene empezar con una API.
P7: ¿Qué pueden hacer los equipos pequeños y medianos con Wenxin 5.5 Flash Base?
Pueden alquilar GPU en la nube para ejecutar inferencia FP8 y evaluar sus capacidades, o usar métodos como LoRA para una adaptación ligera a un dominio específico. Para el tráfico de producción, sigue siendo recomendable usar una API y tomar como referencia los resultados obtenidos con APIYI, apiyi.com, para compararlos con el modelo entrenado por el equipo.
Puntos clave de Wenxin 5.5 Flash Base
- Un punto de partida para entrenar: Base no ha pasado por posentrenamiento. Es adecuado para ajuste fino e investigación, pero no para conversar directamente.
- Cómputo según parámetros activos, memoria según el total: solo se activan 14B de parámetros, pero los pesos en FP8 siguen requiriendo unos 280 GB de memoria GPU.
- Menos caché para contextos largos: la compresión de 37 capas HCA, junto con 6 capas MLA-DSA, reduce considerablemente la caché KV.
- Una base sólida para código y textos largos: sirve para crear modelos especializados en código a escala de repositorio y documentos extensos.
- El ecosistema está listo: el complemento de vLLM y el Cookbook de SGLang se publicaron al mismo tiempo, lo que facilita la integración para inferencia.
- La API aún no lo ofrece: APIYI todavía no ha incorporado la serie Wenxin, pero puedes crear una línea base con los modelos ya disponibles.
Resumen
Las claves para decidir si Wenxin 5.5 Flash Base es para ti:
- Define el objetivo: si quieres entrenar un modelo, despliega Base en tu propia infraestructura; si quieres usarlo, elige una API o espera a la versión oficial.
- Calcula los requisitos: los pesos requieren unos 280 GB de memoria GPU en FP8 o 560 GB en BF16. Es una limitación que no puedes pasar por alto.
- Compara los costos: usa tu volumen real de invocaciones para contrastar el gasto mensual de la API con el costo de las GPU. El modelo híbrido es el de menor riesgo.
Para la mayoría de los equipos de desarrollo, lo más práctico es poner primero el producto en marcha mediante una API y después experimentar internamente con el modelo Base de código abierto. Puedes usar los modelos disponibles en APIYI apiyi.com para crear rápidamente una línea base. La documentación de la interfaz está en docs.apiyi.com y los precios, en docs.apiyi.com/models. Cuando la serie Wenxin esté disponible, bastará con cambiar el nombre del modelo en el mismo código para hacer la comparación.
📚 Referencias
- 量子位 – Artículo sobre la publicación de ERNIE 5.5 Flash Base de Baidu como modelo de código abierto: resumen del lanzamiento y las evaluaciones del modelo
- Enlace:
qbitai.com/2026/11/507787.html -
Nota: incluye comparativas con modelos base del mismo tamaño y una presentación de las tecnologías principales
-
Centro de documentación de APIYI: direcciones de las interfaces e instrucciones para invocaciones compatibles con OpenAI y Anthropic
- Enlace:
docs.apiyi.com -
Nota: lectura recomendada antes de la integración; incluye parámetros y ejemplos
-
Página de precios de modelos de APIYI: precios unitarios de entrada, salida y caché de los modelos disponibles
- Enlace:
docs.apiyi.com/models - Nota: los precios de este artículo se basan en los datos actuales de esta página
Autor: equipo técnico de APIYI
Consultas técnicas: contáctanos a través de la página principal de APIYI en apiyi.com. Para más información sobre la integración, visita el centro de documentación en docs.apiyi.com.


