
Nota del autor: Analizamos tres problemas de «Exploring Super-agent Design», el artículo sobre el diseño de superagentes de DeepSeek Harness: la comunicación full-duplex, la memoria y las credenciales. Veremos qué prácticas se pueden aplicar ya, cuáles siguen siendo «problemas abiertos» y qué contratos de interfaz y pasos de implementación conviene tener en cuenta.
Un agente de larga duración suele encontrarse con tres obstáculos a la vez. Durante los 6 minutos que tardan en ejecutarse las pruebas, las nuevas preguntas del usuario quedan en espera; los eventos de hoy desplazan el contexto de ayer fuera de la ventana; y, mientras depura, el agente abre .env y las claves acaban en el historial de la conversación. El 2026-11-01, el equipo de DeepSeek Harness publicó un extenso artículo de diseño, “Exploring Super-agent Design”, que resume estos problemas como comunicación full-duplex, memoria (Chain of Recall) y «usar credenciales sin verlas».
Este artículo no analiza el lanzamiento de un producto. El texto original describe una arquitectura, no una función que pueda activarse sin más: la comunicación full-duplex ya está implementada en DeepSeek Harness, pero viene desactivada por defecto; parte del trabajo está en el plugin experimental dsh-superagent-prototype, que, según aclaran sus autores, «no es un producto oficial de DeepSeek». La memoria a largo plazo y las credenciales también aparecen en el texto original como problemas abiertos.
Qué te llevarás: al terminar de leer, sabrás qué soluciones puedes adoptar para estos tres problemas, qué contratos deben cumplir las API que las sustentan y cuál es el primer paso para aplicarlas en tu propio proyecto de agentes.
Puntos clave del diseño del súper agente DeepSeek Harness
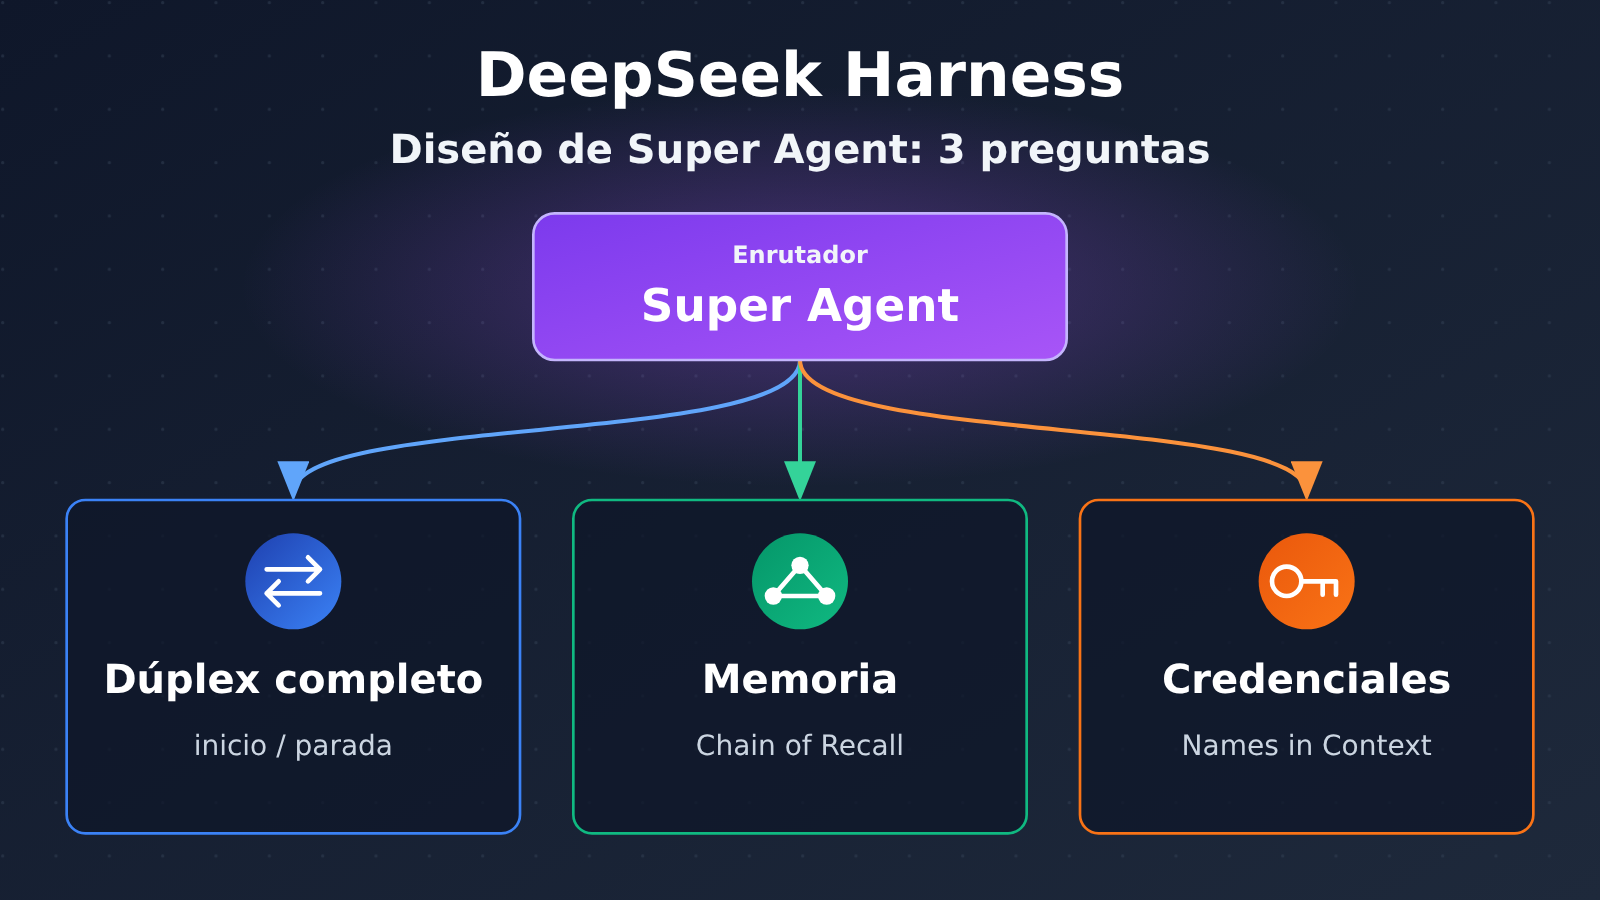
Esta tabla resume cómo plantea el artículo original los tres problemas y qué ideas se pueden aprovechar desde ahora.
| Problema de diseño | Idea central del artículo original | Estado en el artículo original | Qué se puede aprovechar directamente |
|---|---|---|---|
| Dúplex completo | Dividir el run() bloqueante en start() y stop(), para que el agente pueda recibir instrucciones mientras trabaja |
Implementado, pero desactivado por defecto | Contratos de herramientas asíncronas, reinyección de eventos y procesamiento por lotes |
| Memoria | Guardar en el contexto solo ID estables, resúmenes breves y mensajes cercanos; el resto se almacena fuera con punteros y se recupera mediante enlaces de ID en varios saltos | La memoria a largo plazo sigue siendo un problema abierto | ID estables, inline/spill y recuperación precisa por ID |
| Credenciales | El agente debe poder usar credenciales, pero estas no deben entrar en su contexto | Se plantea como un problema abierto | Patrones de ingeniería que ponen los nombres en el contexto y mantienen los valores fuera |
Arquitectura general del súper agente DeepSeek Harness
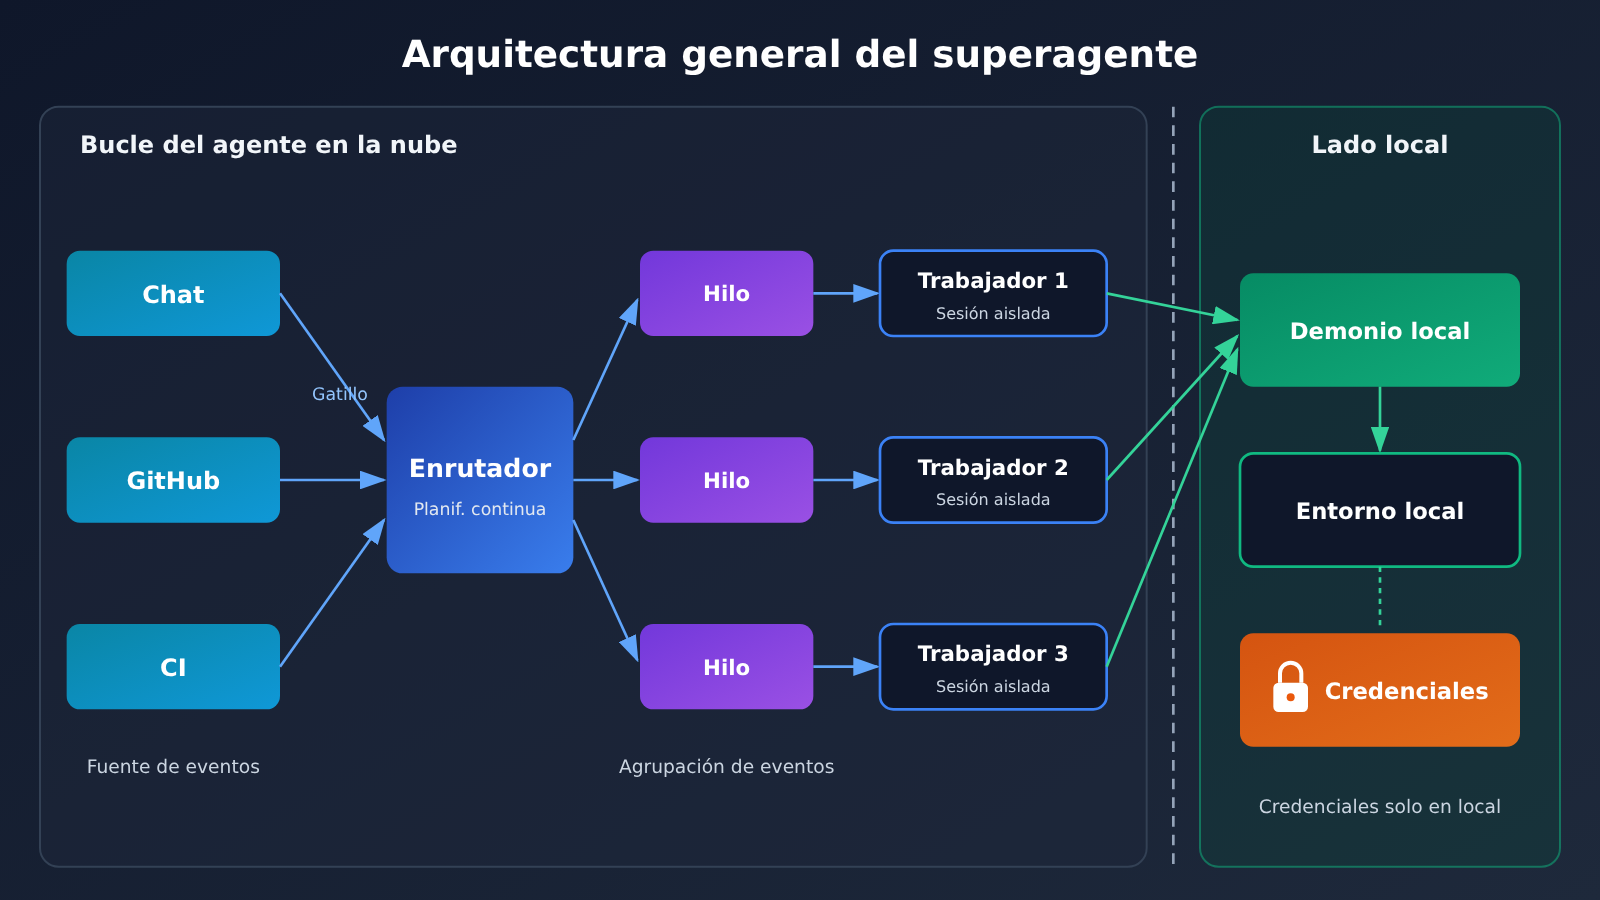
El súper agente del artículo original se compone de un Router y varios Worker. El Router es el punto de entrada de planificación, permanece activo y escucha eventos de fuentes como el chat, GitHub y CI. Cada Worker es una sesión de agente aislada que se ocupa de una sola tarea. Cada evento que entra en el sistema se llama Trigger, y una serie de eventos relacionados con el mismo PR, tema de mensajería instantánea o cadena de correo se agrupa en un Thread.
La arquitectura también tiene una particularidad de despliegue: el bucle del agente se ejecuta en la nube, mientras que el entorno de ejecución del usuario permanece en su equipo local y se conecta mediante un pequeño proceso daemon. Las credenciales también se mantienen en el entorno local. Los tres problemas de diseño parten de esta premisa. Una vez entendidos los conceptos de Router, Worker, Trigger y Thread, resulta más fácil seguir los diseños de dúplex completo y memoria.
Cómo aprovechar el diseño full dúplex de DeepSeek Harness
El modo full dúplex busca resolver un problema: «una herramienta lenta congela todo el agente». En el enfoque tradicional, el agente llama a una herramienta y espera de forma síncrona. Una consulta de 200 ms no supone un problema, pero una ejecución de pruebas de 6 minutos trae tres: las solicitudes posteriores acumulan retrasos; el agente no escucha si el usuario dice a mitad de camino «omite las pruebas e2e»; y la pasarela puede cerrar una conexión que permanece abierta demasiado tiempo, de modo que la tarea termina correctamente, pero la llamada devuelve un error de tiempo de espera.
El texto original llama «productive» al estado ideal: el agente puede recibir la siguiente instrucción aunque la anterior todavía no haya terminado. Para lograrlo, se divide un run() bloqueante en varios contratos pequeños: start() devuelve de inmediato un identificador de tarea, status() informa del progreso y stop() solicita la cancelación. El resultado vuelve después a la conversación en forma de evento. La diferencia está en quién espera: con run() espera el modelo; con start(), espera el entorno de ejecución.
El contrato de herramientas asíncronas del modo full dúplex de DeepSeek Harness
En la definición de herramientas, cada operación de larga duración expone tres herramientas en lugar de una. Por ejemplo, para las pruebas, start_test_run solo devuelve job_id y el estado queued, sin datos de la operación; get_job_status devuelve uno de los estados queued, running, done o failed, junto con una breve descripción del progreso; y stop_job solicita la cancelación y devuelve el estado real alcanzado.
Hay dos reglas que ayudan a evitar que el modelo se desvíe. Primero, la descripción de la herramienta debe indicar «no esperes el resultado»; de lo contrario, el modelo consultará get_job_status con demasiada frecuencia. Segundo, start nunca debe devolver datos, para que el modelo no tenga que adivinar qué estructura ha recibido. La API de tareas que hay detrás de las herramientas puede diseñarse siguiendo la tabla. La definición de 202 Accepted en RFC 9110 encaja: «la solicitud se ha aceptado para su procesamiento, pero este aún no ha terminado».
| Llamada | Respuesta | Herramienta correspondiente |
|---|---|---|
POST /jobs (con el encabezado Idempotency-Key) |
202, devuelve job_id y el estado queued; Location apunta a /jobs/{id} |
start |
GET /jobs/{id} |
200, devuelve queued / running / done / failed | status, monitor de tareas |
GET /jobs/{id}/result |
200 con el resultado si ha terminado; 409 si no | Herramienta de obtención de resultados |
DELETE /jobs/{id} |
202 indica que se ha aceptado la solicitud de cancelación; las llamadas posteriores devuelven 404 o 409 | stop |
| URL de callback opcional | Envía un POST al cliente cuando termina la tarea | Monitor de tareas |
Reincorporación dúplex de resultados y procesamiento por lotes en DeepSeek Harness
El sondeo es solo una solución de respaldo. Un diseño mejor es que el entorno de ejecución supervise las tareas y, cuando terminen, envíe a la conversación un breve evento de finalización con el job_id, el estado y un resumen de una línea, por ejemplo: «412 pruebas superadas, 3 fallidas». El registro completo queda disponible mediante la herramienta de obtención de resultados, de modo que sus 40.000 líneas no entren directamente en el contexto.
El artículo original también describe el procesamiento por lotes del Router: los Trigger que llegan durante una ronda de generación se ponen en cola y se agrupan en la siguiente invocación del modelo. Estas llamadas tienen entradas largas y salidas cortas, por lo que la mayor parte del costo recae en la fase de prefill. En el experimento original, al aumentar la frecuencia de los Trigger de 1 a 40 por minuto, el tamaño medio del lote subió de 1,0 a 2,8 y el tiempo por decisión bajó de 6,4 s a 1,6 s. Son datos de las pruebas del artículo, no un benchmark universal, pero la idea se puede aplicar directamente: mientras el modelo genera, los eventos y mensajes del usuario se ponen en cola y, al terminar la ronda, se envían juntos en orden de llegada.
Detalles de implementación: orden, cancelación e idempotencia
Estos detalles son fáciles de pasar por alto en la fase de prototipo y pueden causar problemas una vez en producción:
- Orden: las tareas no siempre terminan en el mismo orden. Si B depende de A, hay que expresar esa dependencia de forma explícita: esperar a que llegue el evento de finalización de A antes de iniciar B, o hacer que la API admita
depends_on. - Cancelación:
stopes solo una solicitud y no garantiza que la cancelación se haga efectiva. Hay que devolver el estado final real; si la tarea ya había terminado antes de la cancelación, se debe devolverdonepara que el modelo informe al usuario con precisión. - Clave de idempotencia: el modelo puede reintentar una operación, y la pérdida de una respuesta puede provocar un segundo
start. Cadastartdebe incluir unaidempotency_key; si la clave se repite, se devuelve la tarea existente. De lo contrario, una instrucción como «ejecuta la migración» podría ejecutarse dos veces. - Resultados parciales y tiempos de espera: ofrece la salida preliminar mediante una interfaz de resultados con cursor; establece también un plazo para cada tarea y emite un evento
job_timed_outsi se agota.
Si tus herramientas usan MCP, vale la pena revisar Tasks, una extensión opcional de la versión 2026-07-28 de la especificación MCP. El servidor puede responder a la llamada de una herramienta con un resultado que incluya taskId; el cliente puede consultar el estado mediante tasks/get, escuchar notifications/tasks o solicitar la cancelación con tasks/cancel. Tanto el cliente como el servidor deben habilitar esta extensión de forma explícita, y su compatibilidad varía según el entorno. Conviene comprobarlo antes de usarla.
Cuándo no hace falta usar operaciones asíncronas: cuando la llamada devuelve el resultado en uno o dos segundos, cuando el siguiente paso necesita obligatoriamente ese resultado para empezar o cuando no existe una API de tareas real detrás. Si la herramienta es bloqueante internamente, envolverla en una interfaz asíncrona solo añade complejidad. Una división práctica es mantener las operaciones de lectura como bloqueantes y hacer asíncronas las operaciones de escritura y los cálculos que tardan más.
Cómo aplicar el diseño de memoria de DeepSeek Harness: Chain of Recall
Los agentes de larga duración acaban por alcanzar el límite de contexto, porque el trabajo nuevo no deja de llegar. Las tres soluciones habituales tienen sus inconvenientes: conservarlo todo llena la ventana y aumenta el costo con cada turno; generar resúmenes periódicos puede hacer que se pierdan errores concretos o números de PR que se necesiten después; y la búsqueda por similitud falla cuando los hechos necesarios no se parecen literalmente a la consulta.
La idea del artículo original es tratar el contexto como una caché y usar solo dos operaciones. Inline mantiene el contenido que el agente tiene más probabilidades de necesitar en ese momento, incluidos ID, resúmenes breves y mensajes cercanos. Spill se ocupa del resto: lo trunca y deja un puntero para recuperarlo cuando haga falta. El contenido desplazado no se elimina; simplemente, en el prompt solo queda el puntero. Por ejemplo, de un evento de fallo en CI, el contexto conserva una línea como «Falló la CI del PR #412: 3 de los 118 tests del directorio payments fallaron», mientras que de los 41 KB del registro completo solo mantiene la ruta de recuperación. Si el resumen basta, el agente no tiene que pagar por procesar esos 41 KB.
ID estables y grafo de referencias en el diseño de memoria de DeepSeek Harness
Chain of Recall se basa en que los ID nunca cambian. En el artículo original hay tres tipos de objetos con ID:
| Objeto | Significado | ID de ejemplo | Relación |
|---|---|---|---|
| Trigger | Un evento que entra en el sistema: un mensaje de chat, un Webhook o un callback de CI | trg_8f21 |
Pertenece a un Thread |
| Thread | Una serie de eventos relacionados con un mismo PR, tema de mensajería instantánea o hilo de correo | thr_pr_412 |
Está asignado a uno o varios Worker |
| Worker | Una sesión aislada de agente que gestiona una sola tarea | wkr_77a0 |
En su informe hace referencia a los Trigger que ha procesado |
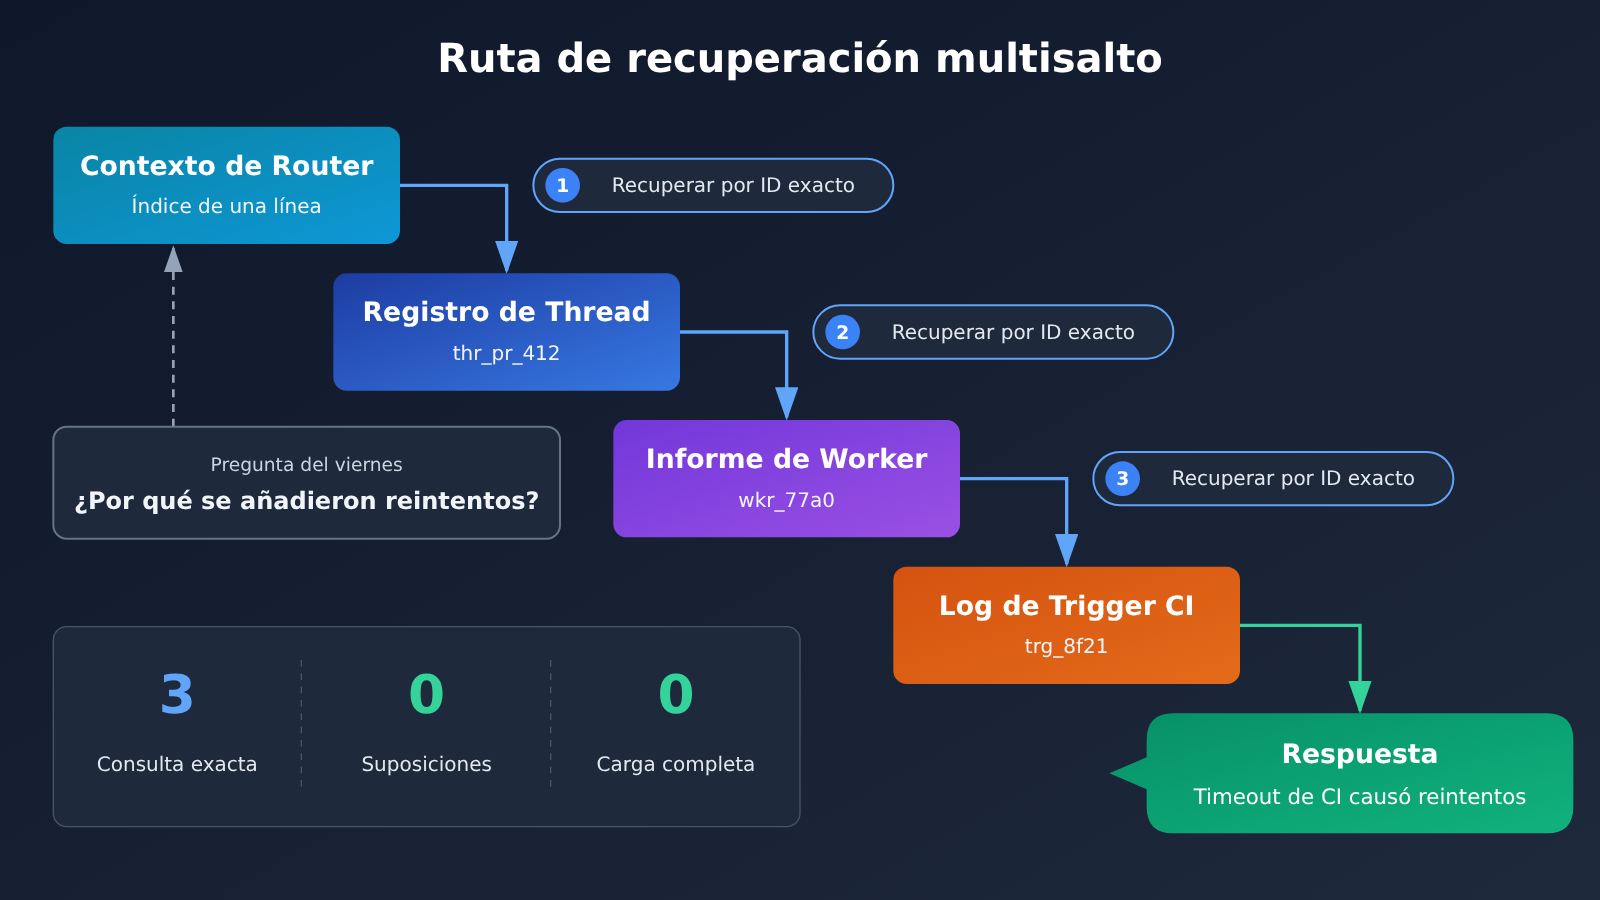
Estos enlaces forman un grafo de referencias que funciona como la memoria del agente. Para recuperar información, el agente sigue los enlaces salto a salto, sin cargar todo el historial ni buscar textos similares. Por ejemplo: el viernes alguien le pregunta al Router «por qué se añadieron reintentos al cliente de pagos», pero la conversación correspondiente tuvo lugar el martes y ya se desplazó fuera del contexto. En el primer salto, el Router usa una línea de índice que aún se conserva en el contexto para recuperar thr_pr_412. En el segundo, lee en el registro del Thread qué Worker lo tiene asignado y recupera el informe final de ese Worker. En el tercero, sigue la referencia del informe al Trigger del fallo de CI, recupera su registro y encuentra un error de tiempo de espera. Tres consultas pequeñas y precisas bastan para obtener la respuesta, sin necesidad de hacer suposiciones.
Las cuatro condiciones que debe cumplir la API de memoria de DeepSeek Harness
Cada salto de la cadena de recuperación es una llamada a la API. Si alguna devuelve un registro diferente o no devuelve nada, la cadena se rompe y el agente se queda bloqueado o responde basándose en conjeturas. Por eso, la API subyacente debe cumplir cuatro condiciones:
- Los ID nunca cambian: un ID devuelto hoy debe seguir apuntando al mismo objeto el mes que viene. No se reutiliza tras una eliminación ni se reasigna durante una migración.
- La recuperación por ID debe ser barata y precisa:
GET /threads/{id}solo devuelve ese registro. No realiza búsquedas ni devuelve «la coincidencia más cercana». - Los ID desconocidos deben producir un error explícito: se debe devolver un 404 con un cuerpo de error claro. Si se devuelve un 200 con un objeto vacío, el agente creerá que esa memoria existe.
- La paginación por cursor no debe dejar huecos: un Thread largo se pagina en orden, cada evento aparece una sola vez y el cursor sigue siendo válido cuando se añaden nuevos eventos.
Estas condiciones pueden romperse sin que nadie lo note durante una refactorización. Por eso conviene convertirlas en pruebas automatizadas y ejecutarlas en cada integración de cambios.
También hay que tener presentes dos limitaciones. En primer lugar, Chain of Recall no sustituye la búsqueda vectorial: la búsqueda vectorial responde a «¿qué se parece a esto?», mientras que Chain of Recall responde a «¿qué está enlazado con esto?». En proyectos reales es habitual combinarlas: primero se usa un índice vectorial para encontrar el ID del Thread inicial y después se siguen los enlaces hasta llegar al dato exacto.
En segundo lugar, la cifra del «37 %» del texto original se refiere a la transmisión directa de Threads: al eliminarla, los tokens leídos de la caché en cada ejecución aumentaron de 23.2M a 31.8M. Ese es el coste de no contar con una función, no un ahorro que aporte Chain of Recall en sí. Conviene no confundir ambas cosas al citar la cifra.
Cómo aplicar el diseño de credenciales de DeepSeek Harness: usarlas sin verlas
El artículo original plantea esta cuestión como un problema abierto: si las credenciales entran en el contexto del agente, pueden filtrarse. Por eso, el agente debería poder usarlas sin verlas. Hay cuatro vías de filtración habituales: leer el archivo .env para diagnosticar un problema; incluir encabezados de solicitud en texto plano en comandos de depuración o ejecutar echo para «confirmar que la variable está definida»; escribir valores reales en la descripción de una PR, en comentarios de un Issue o en datos de prueba; y dejarse llevar por una inyección de indicaciones en una página web o en la respuesta de una API que lo induzca a imprimir las variables de entorno. OWASP considera la inyección de indicaciones el principal riesgo de las aplicaciones con LLM y clasifica la exposición de credenciales como una filtración de información sensible.
Todas las medidas de protección siguen la misma regla: en el contexto solo van los nombres; los valores permanecen fuera del modelo. En el contexto pueden aparecer nombres de variables como STRIPE_KEY, referencias a gestores de secretos, marcadores como {{token}} o valores enmascarados. Lo que no puede aparecer son claves reales, valores resueltos ni líneas de registro sin anonimizar. Si un valor real aparece en la conversación, hay que rotar esa clave ese mismo día: las conversaciones se registran, almacenan en caché y exportan, y un token que ya se ha enviado no se puede recuperar.
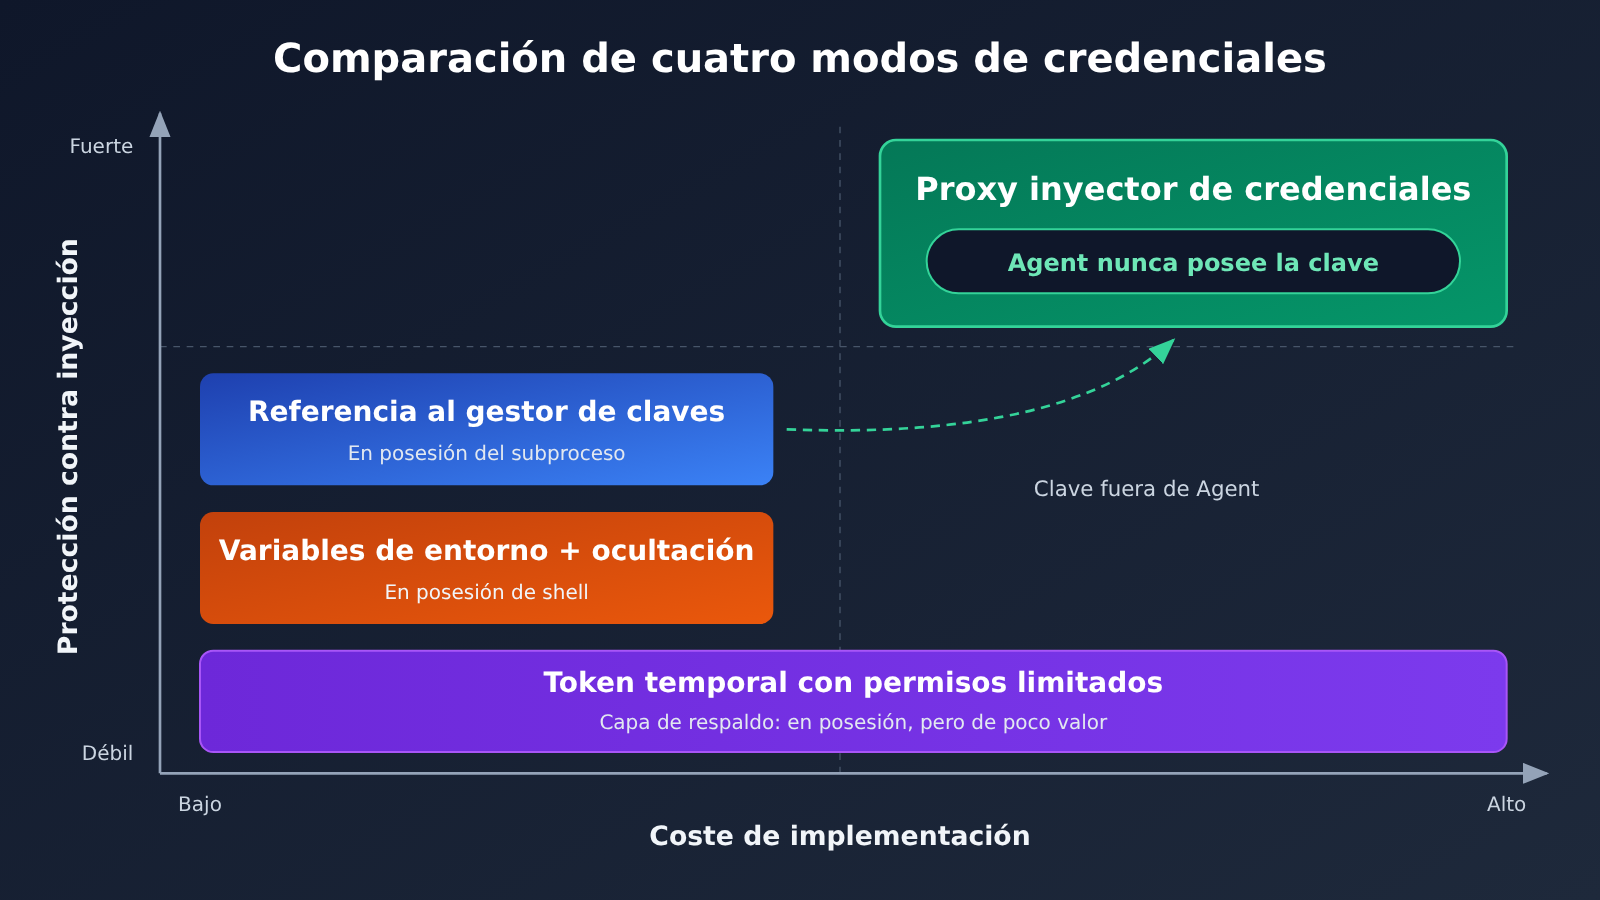
Cuatro formas de gestionar credenciales en DeepSeek Harness
| Patrón | Cómo funciona | ¿El Agent posee la credencial? | Principal limitación |
|---|---|---|---|
| Variables de entorno + enmascaramiento | Se escribe $NAME en el comando y el shell lo expande; se prohíbe leer .env; se enmascara la salida antes de devolverla |
La posee el shell | Evita errores accidentales, pero no impide que el Agent la imprima deliberadamente tras una inyección |
| Referencias a un gestor de secretos | La configuración solo contiene referencias como op://vault/item/field, que la CLI resuelve en tiempo de ejecución y pasa al subproceso |
La posee el subproceso | Tiene las mismas limitaciones que las variables de entorno |
| Proxy de inyección de credenciales | El Agent envía solicitudes sin clave a un proxy local, que añade la cabecera de autenticación y las reenvía según una lista de permitidos | Nunca la posee | Hay que desplegar y mantener el proxy por separado |
| Tokens de corta duración y permisos limitados | Se emite para cada sesión un token que vence en unos minutos y solo permite hacer una cosa | Sí, pero su valor es muy limitado | Es solo una última línea de defensa: aún puede usarse indebidamente mientras sea válido |
De estos cuatro patrones, solo el proxy de inyección de credenciales consigue que el Agent nunca tenga la clave. La lista de permitidos del proxy es tan importante como la inyección de credenciales: por ejemplo, permite GET /v1/charges y rechaza DELETE /v1/customers. Incluso si el Agent sufre una inyección, solo podrá ejecutar las llamadas que hayas aprobado y no podrá llevarse la clave. El proxy debe ejecutarse con un usuario o en un contenedor independiente para evitar que el Agent lea su configuración. Esto coincide con el enfoque de despliegue del artículo original: las credenciales permanecen en el entorno local.
Si tu Agent usa APIYI para invocar el modelo, puedes aplicar la misma idea a la clave del modelo: deja que el proxy inyecte la clave al reenviar las solicitudes a APIYI, de modo que el Agent solo sepa que debe usar el proxy local. Así, aunque se exporte el historial de conversación, no contendrá ninguna clave API de APIYI que se pueda utilizar. Consulta la documentación de APIYI en docs.apiyi.com para conocer la dirección de acceso y el método de autenticación.
La última capa es el enmascaramiento. Hay que enmascarar los prefijos conocidos en las salidas de las herramientas, los registros de CI y las sesiones guardadas. Esto incluye sk_live_, ghp_, github_pat_, AKIA y xoxb-, así como los valores de todas las cabeceras Authorization y X-API-Key, y los valores concretos que se hayan inyectado durante la sesión. Basta con que una sola línea quede sin enmascarar para que todas las protecciones anteriores sean en vano.
Primeros pasos con el diseño de DeepSeek Harness: lista de implementación y selección de modelos
No hace falta resolver los tres problemas de diseño de una sola vez. En función de la relación entre esfuerzo y beneficio, este es el orden de implementación recomendado:
- Empieza por la higiene de credenciales: prohíbe que el Agent lea
.env, especifica enCLAUDE.mdoAGENTS.mdque «no se debe imprimir ninguna variable que termine en_KEY,_TOKENo_SECRET» y añade un filtro para ocultar datos sensibles en la salida. Se puede hacer en medio día y los beneficios son inmediatos. - Convierte las herramientas lentas en asíncronas: empieza por las de pruebas, compilación y despliegue que suelen tardar más de unos segundos. Divide su funcionamiento en start / status / stop y añade claves de idempotencia y plazos límite.
- Establece ID estables: asigna ID inmutables a eventos, hilos de sesión y subtareas. Conserva en el contexto solo el ID y un resumen de una línea; guarda los contenidos extensos fuera del contexto y deja un puntero.
- Implementa por último un proxy de inyección y tokens de corta duración: despliega un proxy para las API de terceros, configura una lista de permitidos y emite un token independiente para cada sesión del Agent.
En cuanto a la selección de modelos, el Router se caracteriza por recibir entradas largas, producir salidas cortas y tomar decisiones por lotes con frecuencia. Por eso, le conviene un modelo económico y rápido, con un precio bajo para las lecturas desde caché. El Worker se encarga de escribir código y realizar razonamientos complejos, por lo que necesita un modelo más capaz. Los precios de la siguiente tabla proceden de la página de precios de APIYI, docs.apiyi.com/models. Consulta los criterios de facturación y los precios actualizados en esa página; este artículo no garantiza ninguna otra tarifa.
| Modelo (nombre en APIYI) | Precio de entrada | Precio de salida | Precio de caché | Rol recomendado | Plataforma disponible |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Decisiones por lotes y resúmenes de eventos para el Router | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Worker para programación cotidiana | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Worker para contextos largos y tareas con documentos | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Worker para refactorizaciones complejas y decisiones críticas | APIYI apiyi.com |
Cabe señalar que tanto los experimentos de procesamiento por lotes como los de transmisión de Thread del texto original destacan el volumen de tokens leídos desde caché. La mayor parte del costo del Router se concentra en el prefill y las lecturas desde caché, así que, al elegir modelo, el precio de caché suele ser más importante que el precio de salida.
🚀 Inicio rápido: APIYI ofrece acceso mediante API a los modelos de la tabla y es compatible tanto con el formato de interfaz de OpenAI como con el de Anthropic. Puedes conectar el Router a deepseek-v4.1-flash con el formato de OpenAI y el Worker a claude-sonnet-5-5 con el de Anthropic, y gestionar ambos desde una misma cuenta. Consulta las instrucciones de integración en la documentación de APIYI, docs.apiyi.com, y los precios en docs.apiyi.com/models.
Preguntas frecuentes (FAQ)
P1: ¿Qué es «Diseño de un súper agente» de DeepSeek Harness?
Es un artículo de diseño publicado el 2026-11-01 por el equipo de DeepSeek Harness, titulado “Exploring Super-agent Design”. Analiza cómo diseñar un súper agente que permanezca activo y escuche varias fuentes de eventos al mismo tiempo. Describe una arquitectura, no una función lanzada oficialmente. Parte del contenido está en el plugin prototipo `dsh-superagent-prototype`, que, según sus autores, no es un producto oficial de DeepSeek.
P2: ¿Qué diferencia hay entre el dúplex completo y la llamada paralela a herramientas?
La llamada paralela ejecuta varias herramientas a la vez en un mismo turno, pero el modelo sigue teniendo que esperar a que todas devuelvan sus resultados. En cambio, con el dúplex completo, una llamada asíncrona a una herramienta devuelve un identificador de inmediato y el resultado llega como un evento en turnos posteriores. Mientras espera, el modelo puede seguir conversando, recibir nuevas instrucciones e iniciar nuevas tareas.
P3: ¿Se puede activar Chain of Recall directamente? ¿Puede sustituir a RAG?
Ninguna de las dos cosas. Chain of Recall es un patrón de diseño descrito en el artículo original: no hay ningún interruptor para activarlo. Hay que implementar identificadores estables y una interfaz para recuperar información por ID. Además, resuelve un problema distinto al de RAG: RAG busca contenido similar, mientras que Chain of Recall recupera información siguiendo enlaces exactos. En proyectos reales, lo habitual es usar primero la búsqueda vectorial para encontrar un punto de partida y luego seguir los enlaces por ID hasta llegar a los datos concretos. El artículo original también señala la memoria a largo plazo como una cuestión abierta; no afirma que Chain of Recall ya la haya resuelto.
P4: ¿Para qué aplicaciones son más adecuados estos tres diseños?
– **Dúplex completo**: tareas como pruebas, compilación, rastreo, renderizado y despliegue, que suelen tardar más de unos segundos y durante las cuales el usuario sigue conversando con el agente.
– **Memoria**: historiales compuestos por eventos discretos que pueden enlazarse entre sí, como PR, tickets, registros de ejecución de CI, conversaciones de atención al cliente y registros de lanzamientos.
– **Credenciales**: agentes de programación y operaciones que necesitan llamar a API de terceros de pago o sensibles.
P5: ¿Cómo integrar rápidamente distintos modelos para Router y Worker?
Una opción sencilla es usar una plataforma compatible tanto con el formato de interfaz de OpenAI como con el de Anthropic. Tras registrarte en APIYI, en apiyi.com, obtén una clave API y configura el nombre del modelo correspondiente en Router y Worker para cambiar entre ellos. Consulta la documentación de APIYI en docs.apiyi.com para conocer la dirección de conexión. Antes de ponerlo en producción, conviene probar la calidad de las decisiones de deepseek-v4.1-flash y claude-sonnet-5-5 con el mismo conjunto de eventos reales y, después, definir cómo repartir las tareas.
P6: ¿Dónde se pueden verificar los modelos o precios mencionados en el artículo original?
Para todos los precios de los modelos mencionados en este artículo, consulta los datos actualizados de la página de precios de APIYI, docs.apiyi.com/models. Las cifras del artículo original y de fuentes externas se incluyen solo como referencia para comparar. Si no encuentras un modelo en esa página, significa que APIYI aún no lo ofrece. Procuraremos incorporarlo pronto; cuando esté disponible, consulta la página de precios.
P7: ¿Qué limitaciones conocidas tienen estos enfoques?
El modo full-duplex necesita el respaldo de una API de tareas real; la «pseudoasincronía» construida sobre implementaciones bloqueantes solo añade complejidad. Chain of Recall no puede encontrar contenido para el que no se hayan creado enlaces, y es fácil romper el contrato de los ID durante migraciones y refactorizaciones. En cuanto a las credenciales, ni las variables de entorno ni las referencias a secretos impiden que se impriman deliberadamente después de una inyección. Solo un proxy de inyección permite que el Agent no tenga acceso al valor; los tokens de corta duración sirven únicamente como medida de respaldo. El propio artículo original también señala la memoria y las credenciales como cuestiones abiertas.
DeepSeek Harness: puntos clave del diseño de un Super Agent
- Enfoque del artículo original: es un artículo de diseño de arquitectura; el modo full-duplex está desactivado por defecto y el plugin prototipo no es un producto oficial.
- Full-duplex: sustituye el
runbloqueante por start / status / stop; los resultados se incorporan de nuevo como eventos y se agrupan por lotes. - Contrato de la API de tareas: aceptación con 202, deduplicación mediante claves de idempotencia, cancelación que devuelve el estado real y un plazo límite para cada tarea.
- Diseño de la memoria: el contexto solo contiene ID estables y resúmenes breves; para el resto se dejan punteros y, al recuperar información, se siguen los enlaces entre ID en varios saltos.
- Contrato de la API de memoria: ID inmutables, recuperación exacta, respuesta 404 para ID desconocidos y paginación por cursor sin omisiones.
- Principio para las credenciales: los nombres entran en el contexto, los valores permanecen fuera. Se prioriza un proxy de inyección, con tokens de corta duración como respaldo y anonimización completa de los registros.
- Reparto entre modelos: Router elige un modelo económico y con bajo costo de caché; Worker elige uno más potente. En APIYI puedes compararlos y probarlos con una sola cuenta.
Resumen
DeepSeek Harness, en «Diseño de un superagente», ofrece más ideas que se pueden aplicar directamente de lo que su condición de «prototipo» podría sugerir:
- Dúplex completo: los contratos de herramientas asíncronas y la reinyección de eventos son prácticas de ingeniería consolidadas. La API de tareas subyacente se puede probar antes de integrarla con el agente.
- Memoria: los ID estables combinados con inline/spill son la forma menos costosa de dotar de memoria precisa a un agente basado en eventos, aunque no sustituyen la búsqueda vectorial.
- Credenciales: la regla «el nombre entra en el contexto; el valor permanece fuera» se puede aplicar desde hoy. El proxy de inyección es la única solución que evita por completo que el agente tenga acceso a las claves.
Conviene empezar por la higiene de credenciales y la conversión de herramientas lentas a operaciones asíncronas, y dejar los ID estables y el proxy de inyección para una segunda etapa. Si necesitas asignar distintos modelos al Router y al Worker, puedes hacer pruebas con APIYI apiyi.com mediante una interfaz unificada compatible con los formatos de OpenAI y Anthropic. Consulta los precios en docs.apiyi.com/models.
📚 Referencias
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory: análisis del diseño de memoria de Chain of Recall
- Enlace:
apidog.com/blog/chain-of-recall-ai-agent-memory -
Descripción: incluye ID estables, inline/spill, ejemplos de recuperación en varios pasos y cuatro contratos de API
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run(): análisis del diseño de herramientas asíncronas en dúplex completo
- Enlace:
apidog.com/blog/async-tool-calls-ai-agents -
Descripción: incluye el contrato start/status/stop, datos experimentales de procesamiento por lotes y una explicación de la extensión MCP Tasks
-
How to Let AI Agents Use API Keys Without Seeing Them: prácticas de seguridad para las credenciales de los agentes
- Enlace:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
Descripción: incluye cuatro patrones de gestión de credenciales, vías de filtración y una lista de comprobación para ocultar datos sensibles
-
Documentación y precios de APIYI: instrucciones de integración y datos de facturación de los modelos mencionados en este artículo
- Enlaces:
docs.apiyi.comydocs.apiyi.com/models - Descripción: consulta aquí los nombres de los modelos, los formatos de las interfaces y los precios actualizados
Autor: equipo técnico de APIYI
Consultas técnicas: si tienes preguntas sobre la elección de una arquitectura de agentes o la integración de varios modelos, puedes contactarnos desde la página principal de APIYI apiyi.com. Encontrarás más recursos en el centro de documentación docs.apiyi.com


