
작성자 주: DeepSeek Harness의 「슈퍼 에이전트 설계」에서 전이중, 기억, 자격 증명이라는 세 가지 설계 문제를 살펴봐요. 지금 바로 참고할 수 있는 방법과 여전히 ‘열린 문제’로 남은 부분을 구분하고, 인터페이스 계약과 구현 체크리스트도 제시해요.
오랫동안 실행되는 에이전트는 세 가지 문제에 동시에 부딪히곤 해요. 테스트가 돌아가는 6분 동안 사용자의 새 질문은 대기열에서 기다려야 해요. 어제의 컨텍스트는 오늘의 이벤트에 밀려 컨텍스트 윈도우 밖으로 사라져요. 디버깅 중 무심코 .env를 열었다가 키가 대화 기록에 남기도 해요. 2026-11-01, DeepSeek Harness 팀은 설계 문서 “Exploring Super-agent Design”을 공개하고 이 세 가지 문제를 각각 전이중(full-duplex), 기억(Chain of Recall), 그리고 ‘자격 증명을 볼 수는 없지만 사용할 수 있게 하기’로 정리했어요.
이 글은 제품 출시 해설이 아니에요. 원문이 설명하는 것은 바로 켜서 사용할 수 있는 기능이 아니라 아키텍처예요. 전이중은 DeepSeek Harness에 구현되어 있지만 기본적으로 비활성화되어 있고, 일부 기능은 프로토타입 플러그인 dsh-superagent-prototype에 담겨 있어요. 작성자는 이 플러그인이 “DeepSeek 공식 제품이 아니다”라고 명시했어요. 장기 기억과 자격 증명 문제 역시 원문에서 열린 문제로 분류했어요.
핵심 내용: 이 글을 읽으면 세 가지 설계 문제 중 어떤 방법을 바로 적용할 수 있는지, 각 방법의 API가 어떤 계약을 충족해야 하는지, 그리고 자신의 에이전트 프로젝트에서 무엇부터 시작해야 하는지 알 수 있어요.
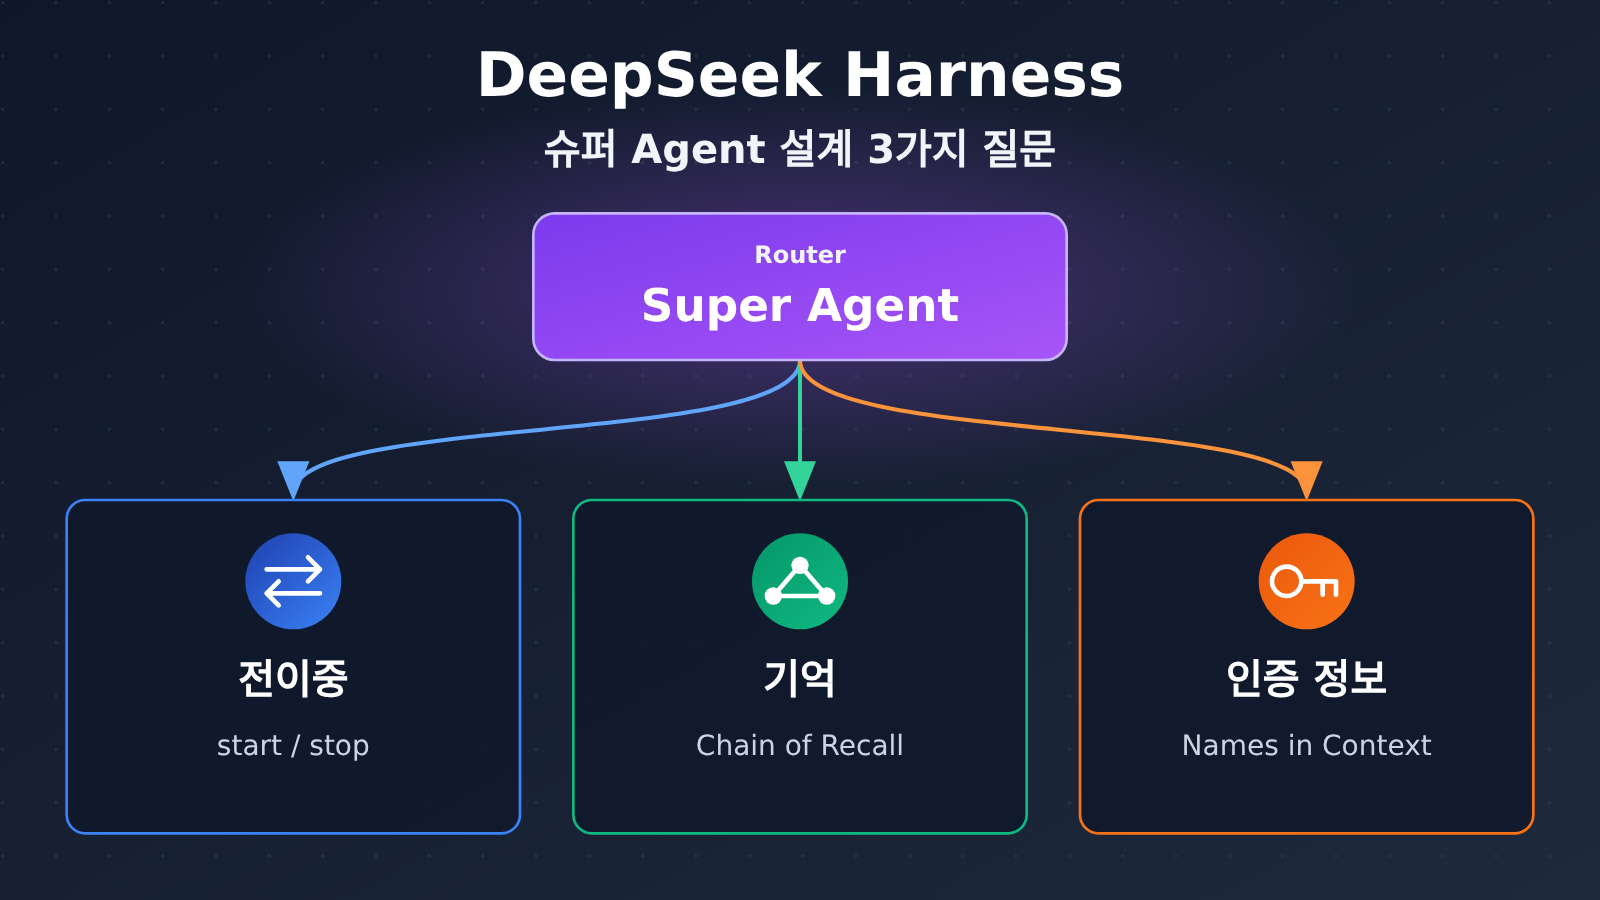
DeepSeek Harness 슈퍼 에이전트 설계 핵심
먼저 세 가지 설계 문제가 원문에서 어떻게 다뤄지는지, 지금 바로 참고할 수 있는 부분은 무엇인지 표로 살펴볼게요.
| 설계 문제 | 원문의 핵심 아이디어 | 원문의 구현 상태 | 바로 참고할 수 있는 부분 |
|---|---|---|---|
| 전이중 | 블로킹 방식의 run()을 start()와 stop()으로 나눠 에이전트가 작업 중에도 명령을 받도록 함 |
구현됐지만 기본적으로 비활성화 | 비동기 도구 계약, 이벤트 재주입, 일괄 처리 |
| 기억 | 컨텍스트에는 안정적인 ID, 짧은 요약, 인접 메시지만 넣고 나머지는 외부에 저장한 뒤 포인터를 남김. ID 연결을 따라 여러 단계를 거쳐 내용을 불러옴 | 장기 기억은 미해결 과제 | 안정적인 ID, inline/spill, ID로 정확하게 검색하기 |
| 자격 증명 | 에이전트가 자격 증명을 사용할 수 있어야 하지만, 자격 증명은 컨텍스트에 들어가지 않아야 함 | 미해결 과제 | 이름은 컨텍스트에 넣고 값은 외부에 보관하는 엔지니어링 패턴 |
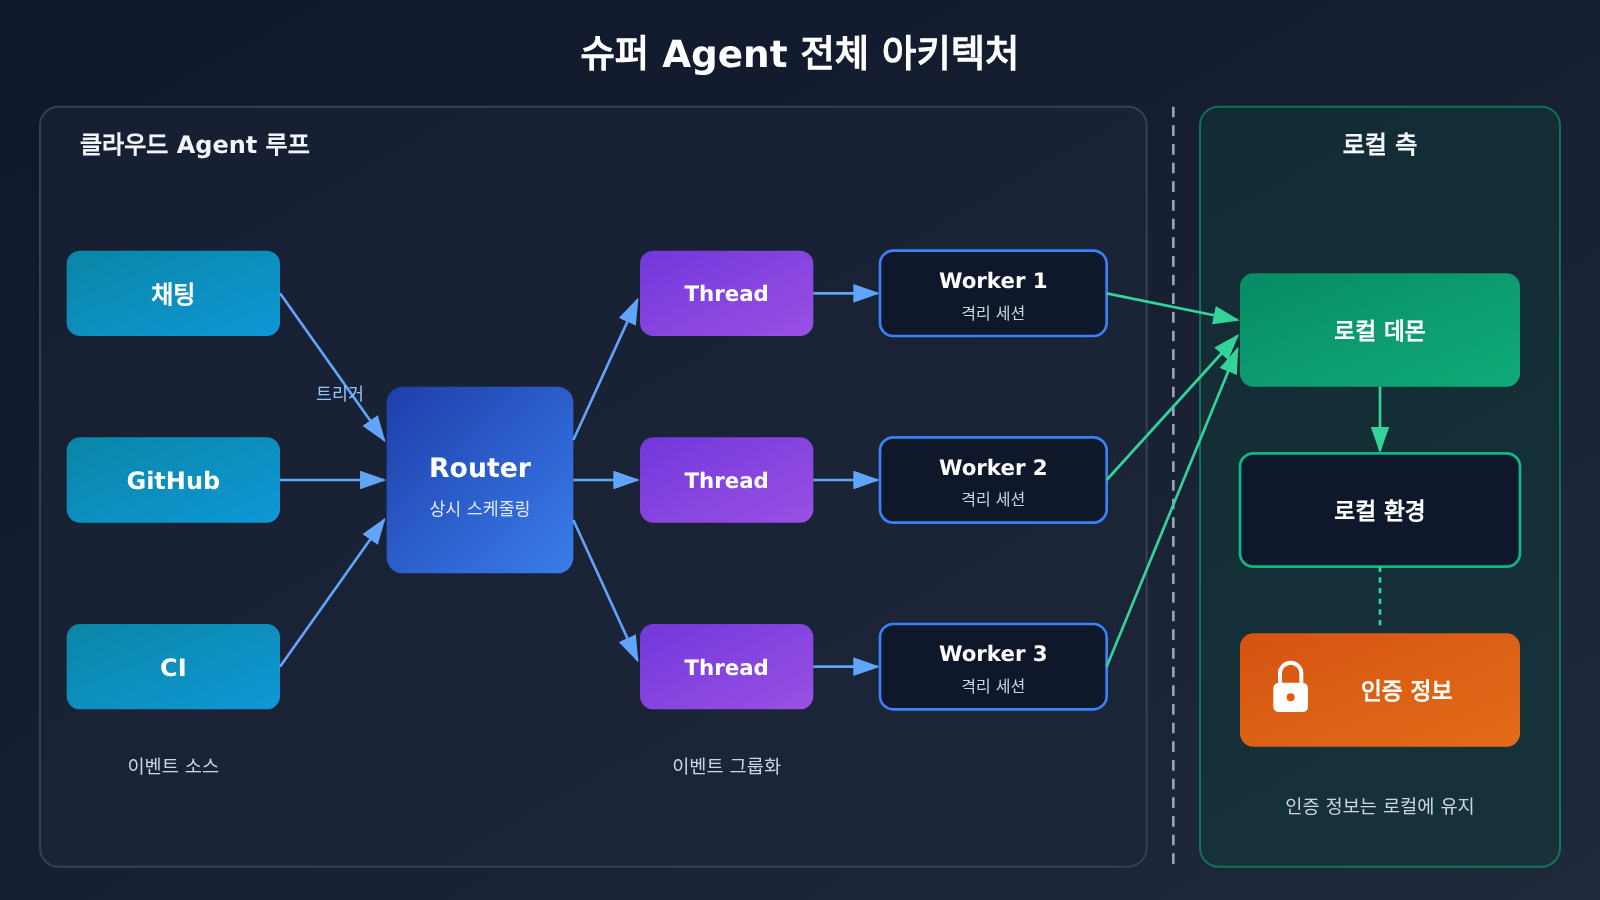
DeepSeek Harness 슈퍼 에이전트의 전체 아키텍처
원문의 슈퍼 에이전트는 Router와 Worker로 구성돼요. Router는 상시 실행되는 작업 분배 진입점으로, 채팅, GitHub, CI 등에서 발생하는 이벤트를 동시에 수신해요. Worker는 격리된 에이전트 세션이며, 하나의 Worker는 하나의 작업만 처리해요. 시스템에 들어오는 각 이벤트를 Trigger라고 하고, 같은 PR, IM 대화 주제, 이메일 스레드에 속한 일련의 관련 이벤트를 하나의 Thread로 묶어요.
이 아키텍처에는 배포 방식상의 특징도 있어요. 에이전트 루프는 클라우드에서 실행되지만, 사용자의 실행 환경은 로컬에 남고 소형 데몬이 둘을 연결해요. 자격 증명도 실행 환경과 함께 로컬에 보관돼요. 세 가지 설계 문제는 모두 이 전제를 바탕으로 해요. Router, Worker, Trigger, Thread라는 네 가지 개념을 이해하면 뒤이어 나오는 전이중과 기억 설계도 더 쉽게 읽을 수 있어요.
DeepSeek Harness의 전이중 설계 활용하기
전이중이 해결하려는 문제는 “느린 도구 하나가 전체 Agent를 멈추게 하는 상황”이에요. 기존 방식에서는 도구를 호출한 뒤 결과를 동기적으로 기다려요. 200ms짜리 조회라면 괜찮지만, 6분짜리 테스트 실행이라면 세 가지 문제가 생겨요. 후속 요청의 지연이 계속 누적되고, 사용자가 중간에 “e2e 테스트는 건너뛰어”라고 말해도 Agent가 듣지 못해요. 또 게이트웨이가 오래 대기 중인 연결을 끊으면 작업은 성공했는데도 호출은 타임아웃으로 실패할 수 있어요.
원문에서는 이전 지시가 끝나기 전에 Agent가 다음 지시를 받을 수 있는 이상적인 상태를 “productive”라고 불러요. 이를 구현하려면 블로킹 방식의 run()을 작은 계약으로 나눠요. start()는 작업 핸들을 즉시 반환하고, status()는 진행 상황을 알리며, stop()은 취소를 요청해요. 결과는 나중에 이벤트 형태로 대화에 전달돼요. 핵심 차이는 누가 기다리느냐예요. run()에서는 모델이 기다리고, start()에서는 런타임이 기다려요.
DeepSeek Harness 전이중의 비동기 도구 계약
도구를 정의할 때는 오래 걸리는 기능마다 도구 하나가 아니라 세 개를 제공해요. 테스트를 예로 들면, start_test_run은 job_id와 queued 상태만 반환하고 실제 작업 데이터는 반환하지 않아요. get_job_status는 queued, running, done, failed 중 하나와 짧은 진행 상황 설명을 반환해요. stop_job은 취소를 요청하고 실제로 도달한 상태를 반환해요.
모델이 엉뚱하게 동작하지 않도록 두 가지 규칙을 지켜야 해요. 첫째, 도구 설명에 “결과를 기다리지 마세요”라고 명시하세요. 그렇지 않으면 모델이 get_job_status를 자주 폴링할 수 있어요. 둘째, start는 데이터를 반환하지 않아야 해요. 그렇지 않으면 모델이 이번에 받은 구조가 무엇인지 추측해야 해요. 도구 뒤에서 동작하는 작업 API는 아래 표를 참고해 설계할 수 있어요. RFC 9110에서 정의한 202 Accepted는 “요청이 처리 대상으로 수락됐지만 처리는 아직 완료되지 않았다”는 뜻이에요.
| 호출 | 응답 | 대응하는 도구 |
|---|---|---|
POST /jobs(Idempotency-Key 요청 헤더 포함) |
202, job_id와 queued 상태 반환, Location은 /jobs/{id}를 가리킴 |
start |
GET /jobs/{id} |
200, queued / running / done / failed 반환 | status, 작업 리스너 |
GET /jobs/{id}/result |
완료 시 200과 함께 결과 반환, 미완료 시 409 | 결과 조회 도구 |
DELETE /jobs/{id} |
202는 취소 요청이 접수됐음을 의미하며, 이후 다시 호출하면 404 또는 409 반환 | stop |
| 선택적 콜백 URL | 작업 완료 시 호출자에게 POST | 작업 리스너 |
DeepSeek Harness의 전이중 결과 재주입과 배치 처리
폴링은 어디까지나 대비책이에요. 더 나은 설계는 런타임이 작업을 감시하다가 완료되면 job_id, 상태, “412개 통과, 3개 실패” 같은 한 줄 요약을 담은 짧은 완료 이벤트를 대화에 전달하는 거예요. 전체 로그는 결과 조회 도구를 통해 가져오도록 하면 4만 줄짜리 로그가 컨텍스트에 그대로 들어가지 않아요.
원문에서는 Router의 배치 처리도 설명해요. 한 번의 생성 중에 도착한 Trigger는 대기열에 넣었다가 다음 모델 호출에 합쳐서 전달해요. 이런 호출은 입력이 길고 출력이 짧아 비용 대부분이 prefill 단계에서 발생해요. 원문의 실험에서는 Trigger 빈도를 분당 1개에서 40개로 높였을 때 평균 배치 크기가 1.0에서 2.8로 늘었고, 결정 한 건당 소요 시간은 6.4 s에서 1.6 s로 줄었어요. 이는 원문 자체 테스트 결과이지 일반적인 벤치마크는 아니에요. 다만 모델이 생성하는 동안 이벤트와 사용자 메시지를 대기열에 넣고, 현재 생성이 끝나면 도착 순서대로 함께 전달하는 방식은 바로 활용할 수 있어요.
순서, 취소, 멱등성의 엔지니어링 세부 사항
이런 세부 사항은 프로토타입 단계에서 놓치기 쉽고, 출시 후에는 사고로 이어지기 쉬워요.
- 순서: 작업 완료 순서는 일정하지 않아요. B가 A에 의존한다면 의존 관계를 명시해야 해요. A의 완료 이벤트가 도착한 뒤 B를 시작하거나, API에서
depends_on을 지원하도록 하세요. - 취소:
stop은 요청일 뿐, 반드시 적용된다는 보장은 없어요. 실제 종료 상태를 반환해야 해요. 취소 전에 작업이 이미 완료됐다면done을 반환해 모델이 사용자에게 사실대로 전달하도록 하세요. - 멱등성 키: 모델은 재시도할 수 있고, 응답이 유실되면
start가 다시 호출될 수 있어요. 매번start에idempotency_key를 포함하도록 하고, 중복된 키에는 기존 작업을 반환하세요. 그렇지 않으면 “마이그레이션 실행”이라는 한마디로 작업이 두 번 실행될 수 있어요. - 부분 결과와 타임아웃: 커서가 있는 결과 조회 인터페이스로 초기 출력을 제공하세요. 모든 작업에 기한을 설정하고, 시간이 초과되면
job_timed_out이벤트를 발생시키세요.
도구에서 MCP를 사용한다면 MCP 사양 2026-07-28 버전의 선택적 확장인 Tasks를 살펴보세요. 서버는 도구 호출에 taskId가 포함된 결과로 응답할 수 있어요. 클라이언트는 tasks/get으로 폴링하거나 notifications/tasks를 수신하고, tasks/cancel로 취소를 요청할 수 있어요. 이 확장은 클라이언트와 서버 모두에서 명시적으로 활성화해야 해요. 호스트마다 지원 수준도 다르므로 사용 전에 확인하세요.
비동기가 필요 없는 경우: 호출이 1~2초 안에 반환되거나, 다음 단계를 시작하려면 반드시 결과가 필요하거나, 실제 작업 API가 없는 경우예요. 도구 내부가 실제로 블로킹 방식이라면 외부에 비동기로 포장해도 복잡성만 늘어나요. 실용적인 기준은 읽기 작업은 블로킹으로 유지하고, 시간이 오래 걸리는 쓰기 작업과 계산은 비동기로 바꾸는 거예요.
DeepSeek Harness의 메모리 설계에서 배우는 Chain of Recall
오랫동안 실행되는 Agent는 새로운 작업이 계속 들어오기 때문에 언젠가는 컨텍스트 한도에 도달해요. 흔히 쓰는 세 가지 대응 방식에는 각각 비용이 따릅니다. 모든 내용을 보관하면 윈도우가 가득 차고 대화가 이어질수록 비용이 늘어나요. 내용을 계속 요약하면 나중에 필요한 구체적인 오류 메시지나 PR 번호가 사라질 수 있어요. 유사도 검색은 필요한 사실과 검색어의 표현이 다르면 결과를 찾지 못할 수 있습니다.
원문의 아이디어는 컨텍스트를 캐시로 보고 두 가지 작업만 수행하는 거예요. Inline은 ID, 짧은 요약, 인접 메시지 등 Agent가 지금 당장 사용할 가능성이 높은 내용을 넣는 방식입니다. Spill은 나머지 내용을 잘라내고 포인터를 남겨, 나중에 필요할 때 해당 포인터로 다시 가져오는 방식이에요. Spill된 내용은 삭제되는 게 아니라 프롬프트에 포인터만 남습니다. 예를 들어 CI 실패 이벤트는 컨텍스트에 “PR #412의 CI 실패, payments 디렉터리의 테스트 118개 중 3개 실패”라는 한 줄 요약만 남기고, 41 KB짜리 전체 로그는 가져올 수 있는 경로만 보관해요. 요약만으로 충분하다면 Agent는 이 41 KB에 대한 비용을 내지 않아도 됩니다.
DeepSeek Harness 메모리 설계의 안정적인 ID와 참조 그래프
Chain of Recall이 작동하려면 ID가 절대 바뀌지 않아야 해요. 원문에서는 세 종류의 객체에 ID를 부여합니다.
| 객체 | 의미 | ID 예시 | 연결 관계 |
|---|---|---|---|
| Trigger | 시스템에 들어온 이벤트 하나: 채팅 메시지, Webhook, CI 콜백 | trg_8f21 |
특정 Thread에 속함 |
| Thread | 같은 PR, IM 주제 또는 이메일 스레드에 속한 관련 이벤트 모음 | thr_pr_412 |
하나 이상의 Worker가 보유 |
| Worker | 단일 작업을 처리하는 격리된 Agent 세션 | wkr_77a0 |
보고서에서 처리한 Trigger를 참조 |
이 연결들이 참조 그래프를 이루고, 이 그래프가 바로 Agent의 메모리예요. 내용을 다시 찾을 때는 링크를 한 단계씩 따라가므로 전체 기록을 불러오거나 유사한 텍스트를 검색할 필요가 없습니다. 예를 들어 금요일에 누군가 Router에게 “왜 결제 클라이언트에 재시도를 추가했나요?”라고 물었는데, 관련 논의는 화요일에 이루어져 이미 Spill된 상태라고 해볼게요. 첫 번째 단계에서 Router는 컨텍스트에 남아 있는 한 줄짜리 인덱스를 이용해 thr_pr_412를 가져옵니다. 두 번째 단계에서는 Thread 기록에서 이를 보유한 Worker를 확인하고 해당 Worker의 최종 보고서를 가져와요. 세 번째 단계에서는 보고서가 참조하는 CI 실패 Trigger의 로그를 가져와 타임아웃 오류를 확인합니다. 세 번의 작은 정밀 조회만으로 추측 없이 답을 찾은 거예요.
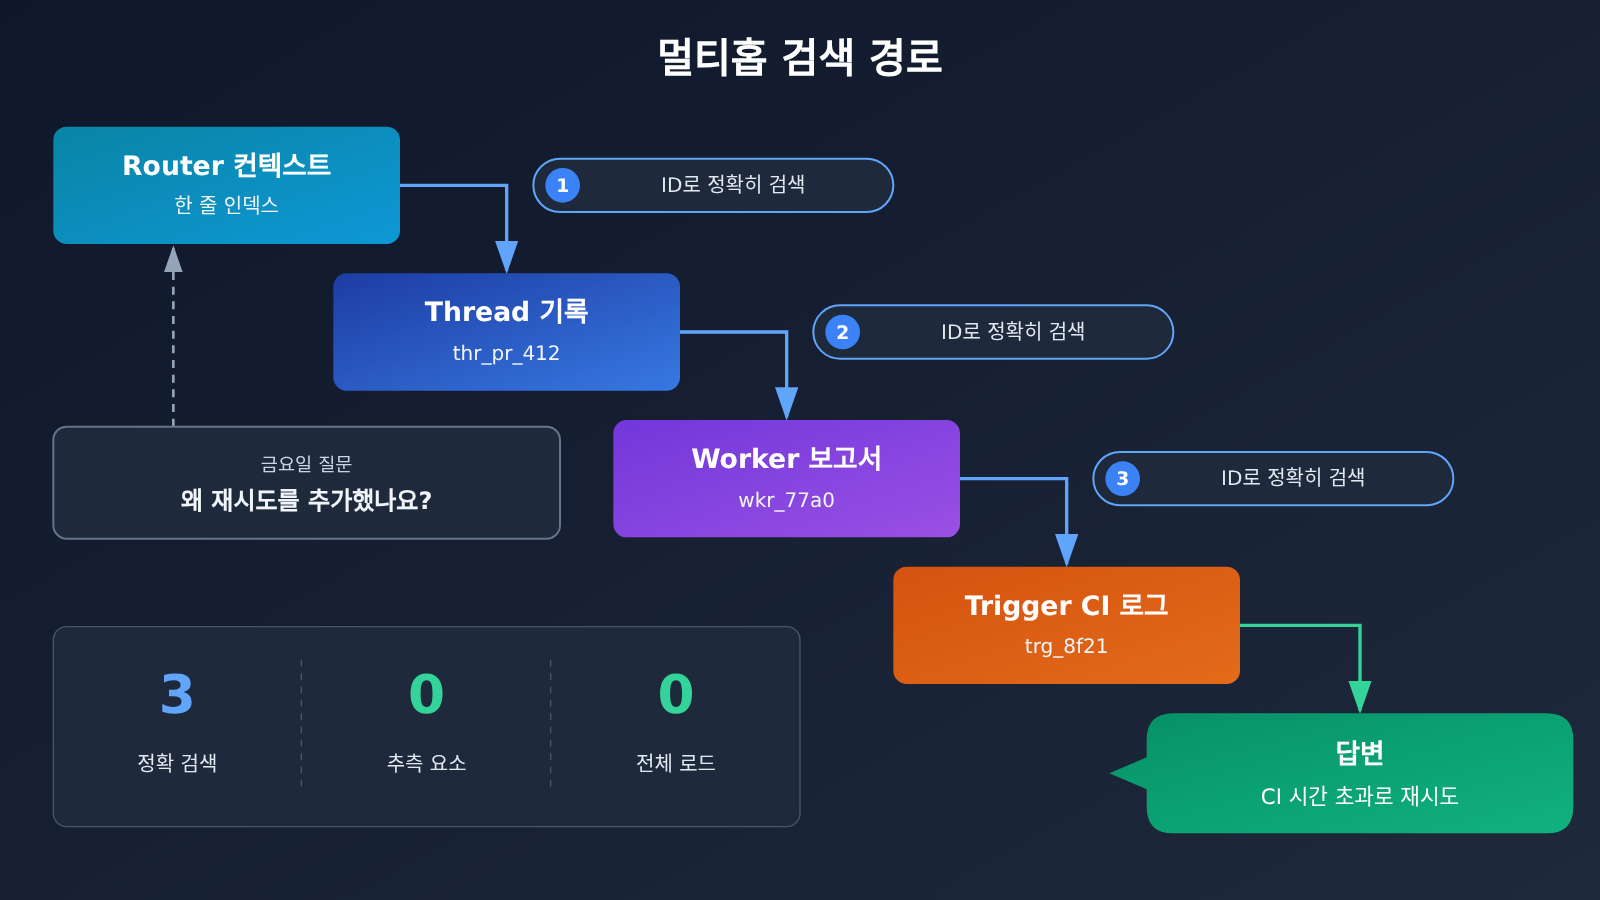
DeepSeek Harness 메모리 API가 반드시 지켜야 할 네 가지 계약
회상 체인의 각 단계는 API 호출 한 번에 해당해요. 어느 단계에서든 다른 레코드가 반환되거나 응답이 없으면 체인이 끊어져요. 그러면 Agent는 멈추거나 추측에 의존해 답변하게 됩니다. 따라서 기반 API는 다음 네 가지 계약을 지켜야 해요.
- ID는 절대 변하지 않아야 해요: 오늘 반환된 ID는 다음 달에도 같은 객체를 가리켜야 해요. 삭제 후 재사용하거나 마이그레이션 후 다시 번호를 매겨서도 안 됩니다.
- ID 조회는 저비용으로 정확하게 수행해야 해요:
GET /threads/{id}는 해당 레코드 하나만 반환해야 해요. 검색을 수행하거나 “가장 가까운 일치 항목”을 반환해서는 안 됩니다. - 알 수 없는 ID에는 명확하게 실패를 알려야 해요: 404와 명확한 오류 본문을 반환해야 해요. 200과 빈 객체를 반환하면 Agent는 해당 메모리가 존재한다고 생각하게 됩니다.
- 커서 기반 페이지네이션에 누락이 없어야 해요: 긴 Thread는 순서대로 페이지를 나누고, 각 이벤트는 한 번만 나타나야 해요. 새 이벤트가 기록되어도 커서는 유효해야 합니다.
이 계약은 리팩터링 과정에서 의도치 않게 깨지기 쉬워요. 자동화 테스트로 작성해 매번 병합할 때마다 실행하는 것이 좋습니다.
두 가지 한계도 객관적으로 살펴봐야 해요. 첫째, Chain of Recall은 벡터 검색을 대체할 수 없어요. 벡터 검색이 “이것과 비슷한 것은 무엇인가”에 답한다면, Chain of Recall은 “이것과 연결된 것은 무엇인가”에 답해요. 실제 프로젝트에서는 벡터 인덱스로 시작 Thread ID를 찾은 다음, 링크를 따라가 정확한 사실을 찾아내는 방식을 흔히 사용합니다.
둘째, 원문의 “37%”는 Thread 패스스루에 관한 수치예요. 패스스루를 제거하자 실행당 캐시 읽기 토큰이 23.2M에서 31.8M으로 늘어났어요. 이는 특정 기능이 없을 때 발생하는 비용이지, Chain of Recall 자체가 가져온 절감 효과가 아니므로 인용할 때 혼동하지 않도록 주의하세요.
DeepSeek Harness의 자격 증명 설계에서 배우기: 자격 증명은 사용하되 값은 보지 못하게 하기
원문은 이 문제를 아직 해결되지 않은 과제로 다뤄요. 자격 증명이 Agent의 컨텍스트에 들어가면 유출될 수 있으므로, Agent가 자격 증명을 사용하되 그 값은 볼 수 없어야 해요. 흔한 유출 경로는 네 가지예요.
- 문제를 해결하려고
.env파일을 읽는 경우 - 디버깅 명령에 요청 헤더를 평문으로 쓰거나, “변수가 설정됐는지 확인”하려고 echo를 실행하는 경우
- PR 설명, Issue 댓글 또는 테스트 픽스처에 실제 값을 쓰는 경우
- 웹페이지나 API 응답에 담긴 프롬프트 인젝션에 속아 환경 변수를 출력하는 경우
OWASP는 프롬프트 인젝션을 LLM 애플리케이션의 가장 큰 위험으로 꼽고, 자격 증명 노출을 민감 정보 유출에 포함해요.
모든 방어 수단은 같은 규칙을 따라요. 컨텍스트에는 이름만 넣고, 값은 모델 외부에 보관하세요. 컨텍스트에는 변수명 STRIPE_KEY, 비밀 관리 서비스 참조, {{token}} 같은 플레이스홀더 또는 마스킹된 값을 넣을 수 있어요. 하지만 실제 키, 참조를 해석해 얻은 값, 마스킹되지 않은 로그 행은 넣으면 안 돼요. 실제 값이 대화에 노출됐다면 당일에 해당 키를 교체해야 해요. 대화 기록은 저장·캐시·내보내기될 수 있고, 한 번 발송한 토큰은 되돌릴 수 없기 때문이에요.
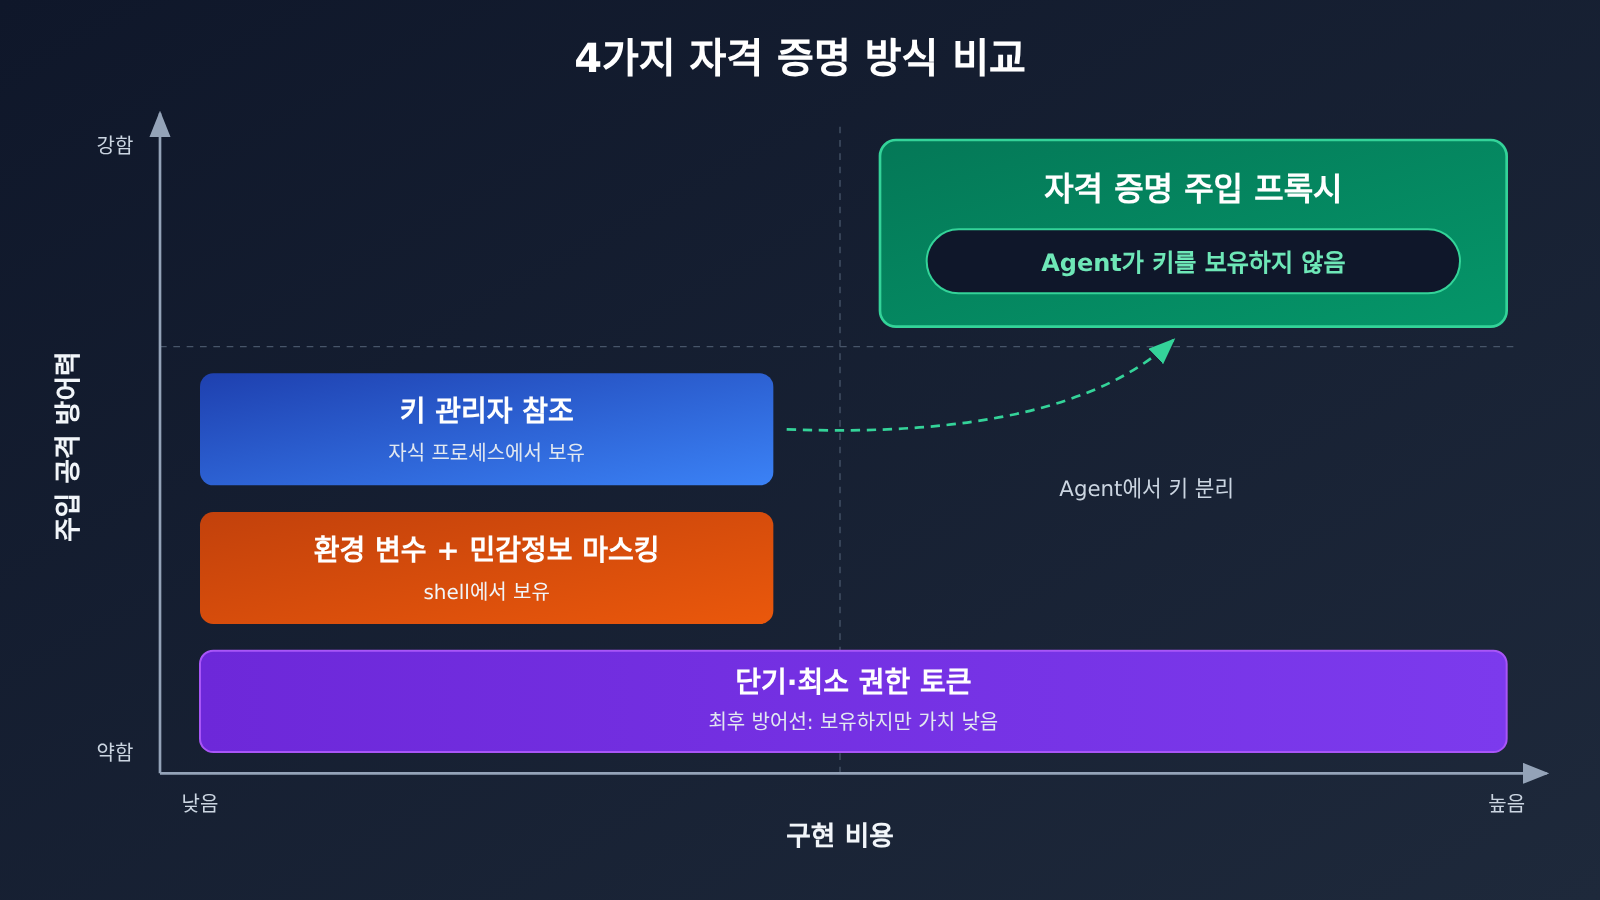
DeepSeek Harness의 자격 증명 문제를 해결하는 네 가지 적용 방식
| 방식 | 구현 방법 | Agent의 값 보유 여부 | 주요 한계 |
|---|---|---|---|
| 환경 변수 + 마스킹 | 명령어에 $NAME을 쓰고 shell이 확장하도록 함. .env 읽기를 금지하고 출력을 반환하기 전에 마스킹 |
shell에서 보유 | 실수는 막을 수 있지만, 프롬프트 주입 후 의도적으로 값을 출력하는 행위는 막지 못함 |
| 시크릿 매니저 참조 | 설정에는 op://vault/item/field 같은 참조만 넣고, 실행 시 CLI가 이를 해석해 하위 프로세스에 전달 |
하위 프로세스에서 보유 | 환경 변수 방식과 한계가 같음 |
| 자격 증명 주입 프록시 | Agent가 키 없이 로컬 프록시에 요청하면, 프록시가 인증 헤더를 추가하고 허용 목록에 따라 전달 | 보유하지 않음 | 프록시를 별도로 배포하고 유지보수해야 함 |
| 단기·최소 권한 토큰 | 세션마다 몇 분 후 만료되고 한 가지 작업만 할 수 있는 토큰을 발급 | 보유하지만 악용 가치는 낮음 | 최후의 안전장치일 뿐이며, 유효 기간 안에는 악용될 수 있음 |
이 네 가지 방식 중 Agent가 키를 보유하지 않도록 확실히 막을 수 있는 방법은 자격 증명 주입 프록시뿐이에요. 프록시의 허용 목록과 자격 증명 주입은 둘 다 중요해요. 예를 들어 GET /v1/charges는 허용하고 DELETE /v1/customers는 거부할 수 있어요. Agent가 프롬프트 주입 공격을 받아도 승인된 호출만 실행할 수 있고, 키를 빼낼 수도 없어요. Agent가 프록시 설정을 읽지 못하도록 프록시는 별도 사용자 계정이나 컨테이너에서 실행해야 해요. 이는 자격 증명을 환경과 함께 로컬에 두는 원문의 배포 방식과도 일치해요.
Agent가 APIYI를 통해 모델을 호출한다면, 모델 API 키에도 같은 방식을 적용할 수 있어요. 프록시가 APIYI로 요청을 전달할 때 키를 주입하고, Agent에는 로컬 프록시를 사용한다는 사실만 알려주는 거예요. 그러면 대화 기록을 내보내더라도 사용할 수 있는 APIYI 키가 기록에 남지 않아요. 구체적인 접속 주소와 인증 방식은 APIYI 문서 docs.apiyi.com을 참고하세요.
마지막 방어선은 마스킹이에요. 도구 출력, CI 로그, 저장된 세션에서 sk_live_, ghp_, github_pat_, AKIA, xoxb-처럼 알려진 접두사와 모든 Authorization, X-API-Key 요청 헤더의 값을 마스킹해야 해요. 이번 세션에 주입한 실제 값도 모두 마스킹해야 하고요. 단 한 줄이라도 빠뜨리면 앞서 마련한 방어책이 모두 무용지물이 될 수 있어요.
DeepSeek Harness 설계 빠른 시작: 실전 체크리스트와 모델 선택
세 가지 설계 과제를 한 번에 해결할 필요는 없어요. 투입 대비 효과를 고려하면 다음 순서로 적용하는 것이 좋아요.
- 먼저 자격 증명을 안전하게 관리하세요: Agent가
.env를 읽지 못하게 하고,CLAUDE.md또는AGENTS.md에 “_KEY,_TOKEN,_SECRET으로 끝나는 변수는 출력하지 않는다”라고 명시하세요. 출력에는 민감 정보 마스킹 필터를 추가하세요. 반나절이면 마칠 수 있고 효과도 바로 확인할 수 있어요. - 다음으로 느린 도구를 비동기로 바꾸세요: 테스트, 빌드, 배포처럼 자주 몇 초 이상 걸리는 도구부터 start / status / stop으로 나누고, 멱등성 키와 마감 시간을 추가하세요.
- 그다음 안정적인 ID를 도입하세요: 이벤트, 세션 스레드, 하위 작업에 변경되지 않는 ID를 일관되게 할당하세요. 컨텍스트에는 ID와 한 줄 요약만 남기고, 긴 내용은 외부에 저장한 뒤 포인터를 남기세요.
- 마지막으로 주입 프록시와 단기 토큰을 도입하세요: 서드파티 API용 프록시를 배포하고 허용 목록을 설정한 뒤, Agent 세션마다 별도의 토큰을 발급하세요.
모델 선택 시 Router는 입력이 길고 출력이 짧으며, 일괄 결정을 자주 내려야 해요. 따라서 저렴하고 빠르면서 캐시 히트 가격이 낮은 모델이 적합해요. Worker는 코드 작성과 복잡한 추론을 담당하므로 성능이 더 뛰어난 모델이 좋아요. 아래 가격은 APIYI 가격 페이지 docs.apiyi.com/models에서 가져왔어요. 과금 기준과 최신 단가는 해당 페이지의 실시간 데이터를 확인해 주세요.
| 모델(APIYI 모델명) | 입력 단가 | 출력 단가 | 캐시 가격 | 권장 역할 | 사용 가능 플랫폼 |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Router 일괄 결정, 이벤트 요약 | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | 일상적인 코딩 Worker | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 긴 컨텍스트 Worker, 문서 작업 | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | 복잡한 리팩터링, 핵심 결정 Worker | APIYI apiyi.com |
원문의 일괄 처리와 Thread 전달 실험은 모두 캐시 읽기 토큰의 규모를 강조해요. Router 측 비용의 대부분은 prefill과 캐시 읽기에서 발생하므로, 모델을 고를 때 출력 단가보다 캐시 가격을 눈여겨볼 필요가 있어요.
🚀 빠른 시작: APIYI는 위 모델의 API 호출을 제공하며 OpenAI와 Anthropic 인터페이스 형식을 모두 지원해요. Router는 OpenAI 형식으로 deepseek-v4.1-flash에 연결하고, Worker는 Anthropic 형식으로 claude-sonnet-5-5에 연결해 하나의 계정으로 통합 관리할 수 있어요. 연동 방법은 APIYI 문서 docs.apiyi.com을, 가격은 docs.apiyi.com/models를 참고하세요.
자주 묻는 질문 FAQ
Q1: DeepSeek Harness의 《슈퍼 Agent 설계》란 무엇인가요?
DeepSeek Harness 팀이 2026-11-01에 발표한 장문의 설계 글 “Exploring Super-agent Design”이에요. 상시 실행되면서 여러 이벤트 소스를 동시에 감시하는 슈퍼 Agent의 설계 방식을 다뤄요. 정식 출시된 기능이 아닌 아키텍처를 설명하며, 일부 내용은 프로토타입 플러그인 `dsh-superagent-prototype`에 담겨 있어요. 저자는 이 플러그인이 DeepSeek 공식 제품이 아니라고 밝혔어요.
Q2: 전이중과 병렬 도구 호출은 어떻게 다른가요?
병렬 도구 호출은 한 차례에 여러 도구를 동시에 실행하지만, 모델은 여전히 모든 결과가 돌아올 때까지 기다려야 해요. 전이중 환경의 비동기 도구 호출은 핸들을 즉시 반환하고, 결과는 이후 차례에 이벤트로 전달돼요. 모델은 기다리는 동안 대화를 이어가거나 새 지시를 받고, 새 작업을 시작할 수 있어요.
Q3: Chain of Recall을 바로 켤 수 있나요? RAG를 대체할 수 있나요?
둘 다 불가능해요. Chain of Recall은 원문에서 제시한 설계 패턴이라 켜고 끄는 스위치가 없어요. 안정적인 ID와 ID로 데이터를 가져오는 인터페이스를 직접 구현해야 해요. RAG는 유사한 내용을 찾고, Chain of Recall은 정확한 링크를 따라 내용을 가져오므로 해결하는 문제도 달라요. 실제 프로젝트에서는 보통 벡터 검색으로 시작점을 찾은 뒤 ID 링크를 따라 구체적인 사실에 도달해요. 원문에서도 장기 기억을 미해결 문제로 제시했으며, Chain of Recall이 이를 해결했다고 말하지 않았어요.
Q4: 이 세 가지 설계 문제는 어떤 활용 사례에 가장 적합한가요?
– **전이중**: 테스트, 빌드, 크롤링, 렌더링, 배포처럼 몇 초 이상 걸리는 경우가 많고, 작업 중에도 사용자가 Agent와 계속 대화하는 작업.
– **기억**: PR, 이슈 티켓, CI 실행 기록, 고객 상담 대화, 릴리스 기록처럼 개별적으로 구분되고 서로 연결할 수 있는 이벤트로 구성된 이력.
– **인증 정보**: 유료 또는 민감한 서드파티 API를 호출해야 하는 코딩 Agent와 운영 Agent.
Q5: Router와 Worker에 서로 다른 모델을 빠르게 연결하려면 어떻게 하나요?
OpenAI와 Anthropic의 인터페이스 형식을 모두 지원하는 플랫폼으로 통합 연결하면 편리해요. APIYI apiyi.com에 가입해 API 키를 발급받은 뒤, Router와 Worker에 각각 원하는 모델명을 입력하면 모델을 전환할 수 있어요. 연결 주소는 APIYI 문서 docs.apiyi.com을 참고하세요. 운영에 적용하기 전에는 동일한 실제 이벤트로 deepseek-v4.1-flash와 claude-sonnet-5-5의 의사결정 품질을 각각 테스트한 뒤 역할을 정하는 것이 좋아요.
Q6: 원문에 언급된 모델이나 가격은 어디서 확인하나요?
이 글에 나온 모델 가격은 모두 APIYI 가격 페이지 docs.apiyi.com/models의 실시간 데이터를 기준으로 확인하세요. 원문과 서드파티 자료의 숫자는 비교용 참고 자료예요. 가격 페이지에서 특정 모델을 찾을 수 없다면 APIYI에 아직 출시되지 않은 모델이에요. 최대한 빨리 출시할 예정이며, 출시 후에는 가격 페이지를 기준으로 확인해 주세요.
Q7: 이 방법들에 알려진 한계는 무엇인가요?
전이중에는 실제 작업 API가 필요해요. 블로킹 방식의 구현을 감싼 ‘유사 비동기’는 복잡도만 높여요. Chain of Recall은 링크가 없는 내용을 찾을 수 없고, ID 계약은 마이그레이션이나 리팩터링 과정에서 쉽게 깨질 수 있어요. 인증 정보의 경우 환경 변수와 키 참조 모두 인젝션 공격 후 의도적으로 값을 출력하는 상황을 막지 못해요. 주입 프록시만이 Agent가 값을 전혀 보유하지 않도록 할 수 있으며, 단기 토큰은 최후의 안전장치로만 쓸 수 있어요. 원문에서도 기억과 인증 정보를 미해결 문제로 제시했어요.
DeepSeek Harness 슈퍼 Agent 설계 핵심 요약 Key Takeaways
- 원문의 성격: 아키텍처 설계 글이며, 전이중은 기본적으로 꺼져 있고 프로토타입 플러그인은 공식 제품이 아니에요.
- 전이중: 블로킹 방식의 run 대신 start / status / stop을 사용하고, 결과를 이벤트로 다시 전달해 배치 단위로 병합해요.
- 작업 API 계약: 202로 요청을 접수하고, 멱등성 키로 중복을 제거하며, 취소 시 실제 상태를 반환하고 각 작업에 기한을 설정해요.
- 메모리 설계: 컨텍스트에는 안정적인 ID와 짧은 요약만 넣고, 나머지 초과 데이터는 포인터로 남겨요. 검색할 때는 ID를 따라 여러 단계에 걸쳐 가져와요.
- 메모리 API 계약: ID는 변하지 않고, 정확하게 가져올 수 있어야 해요. 알 수 없는 ID에는 404를 반환하고, 커서 기반 페이지네이션에는 누락이 없어야 해요.
- 인증 정보 원칙: 이름은 컨텍스트에 넣고 값은 외부에 보관해요. 주입 프록시를 우선 사용하고, 여의치 않으면 단기 토큰을 사용하며, 로그 전체에서 민감 정보를 마스킹해요.
- 모델 역할 분담: Router에는 가격과 캐시 사용료가 저렴한 모델을, Worker에는 성능이 뛰어난 모델을 선택해요. APIYI에서 계정 하나로 비교 테스트할 수 있어요.
정리
DeepSeek Harness의 《슈퍼 Agent 설계》에서는 ‘프로토타입’이라는 성격을 감안하더라도 바로 참고할 만한 내용이 많아요.
- 전이중: 비동기 도구 계약과 이벤트 재전달은 검증된 엔지니어링 방식이에요. Agent에 연결하기 전에 기반 작업 API부터 테스트를 작성할 수 있어요.
- 메모리: 안정적인 ID와 inline/spill을 결합하면 이벤트 기반 Agent에서 정확한 메모리를 가장 저렴하게 구현할 수 있어요. 다만 벡터 검색을 대체할 수는 없어요.
- 인증 정보: “이름은 컨텍스트에, 값은 외부에”라는 규칙은 지금 바로 적용할 수 있어요. 주입 프록시는 Agent가 키를 전혀 보유하지 않도록 하는 유일한 방식이에요.
먼저 인증 정보 관리와 느린 도구의 비동기화부터 시작하고, 안정적인 ID와 주입 프록시는 두 번째 단계에서 도입하는 것을 권장해요. Router와 Worker에 서로 다른 모델을 조합해야 한다면 APIYI apiyi.com의 OpenAI 및 Anthropic 호환 통합 인터페이스로 직접 테스트할 수 있어요. 가격은 docs.apiyi.com/models를 참고하세요.
📚 참고 자료
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory: Chain of Recall 메모리 설계 해설
- 링크:
apidog.com/blog/chain-of-recall-ai-agent-memory -
설명: 안정적인 ID, inline/spill, 멀티홉 검색 예시와 네 가지 API 계약을 다뤄요.
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run(): 전이중 비동기 도구 설계 해설
- 링크:
apidog.com/blog/async-tool-calls-ai-agents -
설명: start/status/stop 계약, 배치 처리 실험 데이터와 MCP Tasks 확장을 다뤄요.
-
How to Let AI Agents Use API Keys Without Seeing Them: 에이전트 자격 증명 보안 가이드
- 링크:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
설명: 네 가지 자격 증명 패턴, 유출 경로와 민감 정보 마스킹 체크리스트를 다뤄요.
-
APIYI 문서 및 가격 페이지: 이 글에서 다룬 모델의 연동 방법과 요금 정보
- 링크:
docs.apiyi.com및docs.apiyi.com/models - 설명: 모델명, 인터페이스 형식과 실시간 가격은 이 페이지를 기준으로 확인하세요.
작성자: APIYI 기술팀
기술 문의: 에이전트 아키텍처 선택이나 다중 모델 연동에 관해 궁금한 점이 있다면 APIYI 홈페이지 apiyi.com을 통해 문의해 주세요. 더 많은 자료는 docs.apiyi.com 문서 센터에서 확인할 수 있어요.


