
著者注:DeepSeek Harness の「スーパーエージェント設計」から、全二重通信、記憶、認証情報という3つの設計課題を読み解きます。今すぐ参考にできる手法と、まだ「未解決の課題」として残る点を整理し、インターフェース契約と実装チェックリストを紹介します。
長時間動作するエージェントは、しばしば3つの問題に同時に直面します。テストの実行に6分かかる間、ユーザーからの新しい質問は待たされる。昨日のコンテキストは今日のイベントに押し出され、ウィンドウから消える。デバッグ中にエージェントが .env を開き、秘密鍵が会話履歴に残ってしまう。2026-11-01、DeepSeek Harness チームは設計に関する長文記事 “Exploring Super-agent Design” を公開し、これらの問題をそれぞれ 全二重通信(full-duplex)、記憶(Chain of Recall)、「認証情報の中身を見ずに使用する」というテーマにまとめました。
これは製品リリースの解説記事ではありません。原文が説明しているのはアーキテクチャであり、すぐに有効化できる機能ではありません。全二重通信は DeepSeek Harness に実装済みですが、デフォルトではオフになっています。一部の機能はプロトタイププラグイン dsh-superagent-prototype に含まれており、著者はこれが「DeepSeek の公式製品ではない」と明言しています。長期記憶と認証情報についても、原文では未解決の課題として挙げられています。
この記事でわかること:3つの設計課題のうち、どの手法をそのまま参考にできるのか。それぞれの API が満たすべき契約は何か。そして、自分のエージェントプロジェクトで何から着手すべきかを整理します。
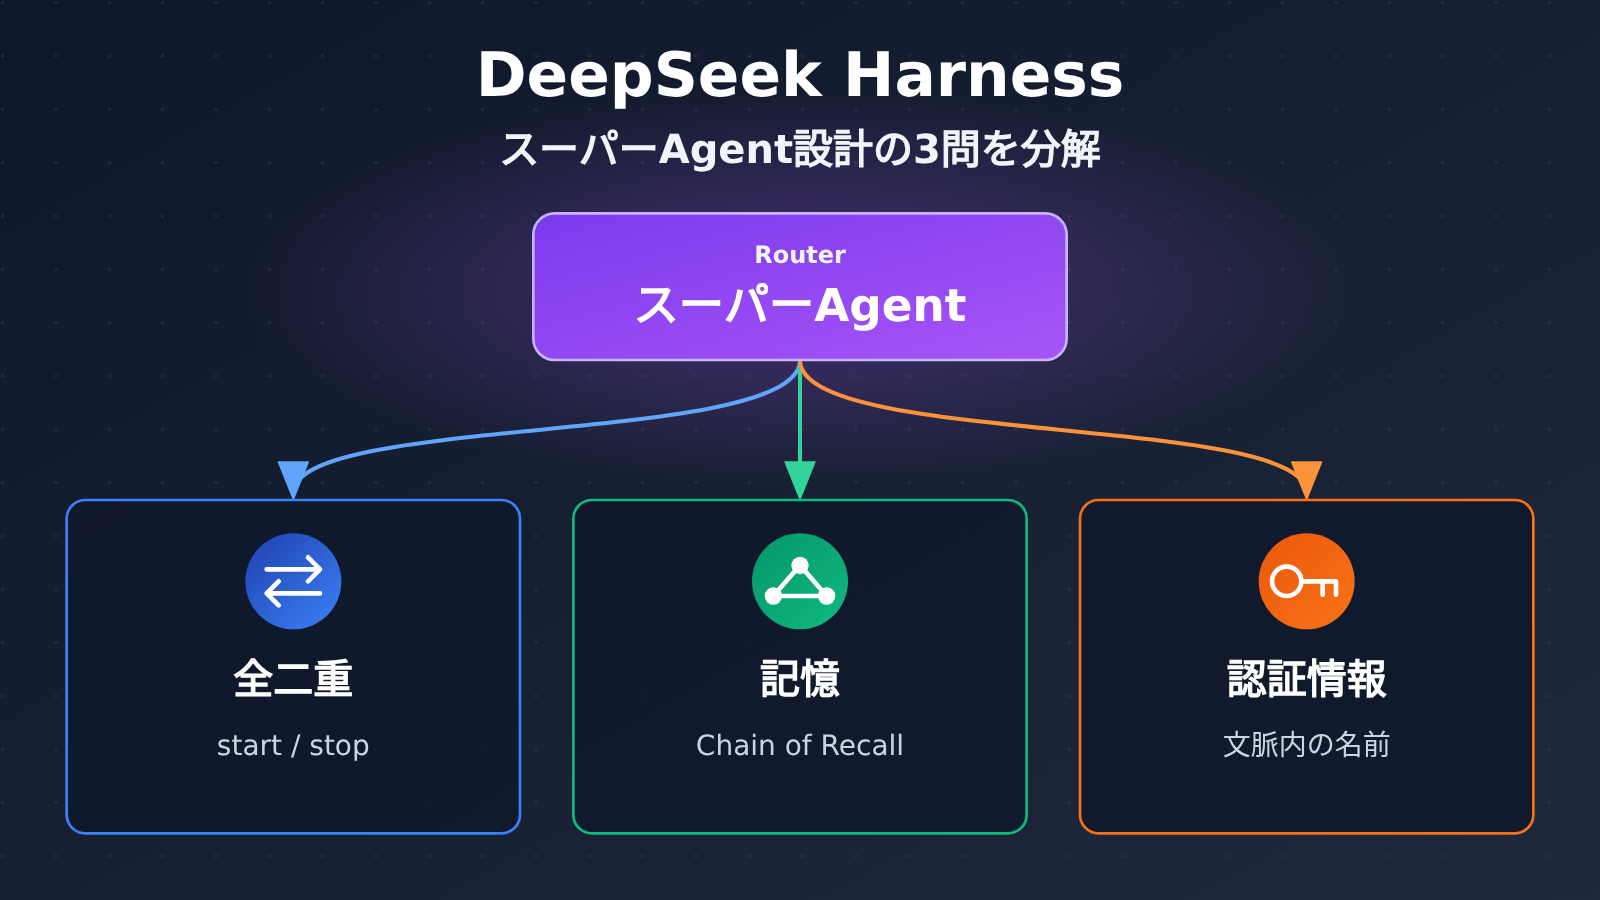
DeepSeek Harness スーパーエージェントの設計上のポイント
まずは、原文で3つの課題がどう位置づけられているか、そして今すぐ参考にできる部分はどこかを表で見てみましょう。
| 設計課題 | 原文の基本的な考え方 | 原文での状況 | 直接参考にできる部分 |
|---|---|---|---|
| 全二重 | ブロッキングする run() を start() と stop() に分割し、Agent が作業中も指示を受け取れるようにする |
実装済みだが、デフォルトでは無効 | 非同期ツールの契約、イベントのフィードバック、バッチ処理 |
| 記憶 | コンテキストには安定した ID、短い要約、前後のメッセージだけを置き、それ以外は外部に退避してポインタを残す。ID で関連情報をたどり、複数ステップで呼び戻す | 長期記憶は未解決の課題 | 安定した ID、インライン/退避、ID による正確な取得 |
| 認証情報 | Agent は認証情報を使えるが、認証情報自体はコンテキストに入らないようにする | 未解決の課題 | 名前をコンテキストに入れ、値を外部に保持するためのエンジニアリングパターン |
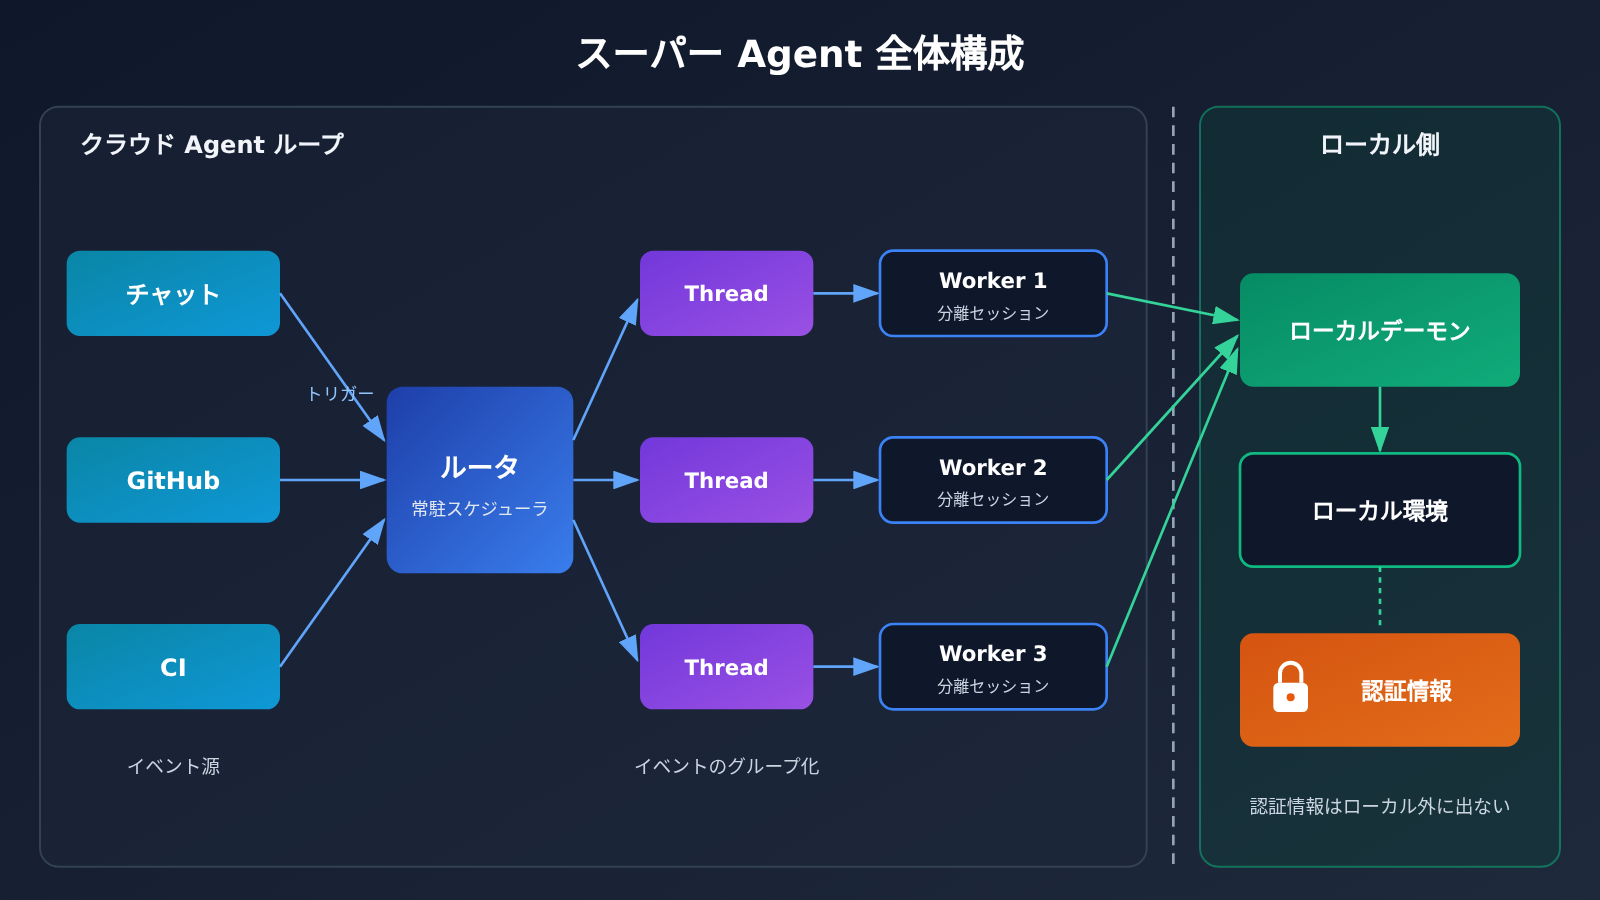
DeepSeek Harness スーパーエージェントの全体アーキテクチャ
原文のスーパーエージェントは、Router と Worker で構成されています。Router は常駐するスケジューリングの窓口で、チャット、GitHub、CI などからのイベントを同時に監視します。Worker は隔離された Agent セッションで、1つの Worker が1つのタスクだけを処理します。システムに入る各イベントを Trigger と呼び、同じ PR、同じ IM の話題、または同じメールスレッドに関する一連のイベントを1つの Thread にまとめます。
このアーキテクチャには、デプロイ面でも特徴があります。Agent のループはクラウド上で動作し、ユーザー自身の実行環境はローカルに置かれます。両者の接続は小さなデーモンが担い、認証情報も実行環境とともにローカルに保持されます。3つの設計課題はいずれも、この前提に基づいています。Router、Worker、Trigger、Thread の4つの概念を理解すると、後に続く全二重と記憶の設計も読み進めやすくなります。
DeepSeek Harness の全二重設計をどう取り入れるか
全二重が解決するのは、「遅いツールによって Agent 全体が止まってしまう」という問題です。従来の方式では、ツールを呼び出した後、結果が返るまで同期的に待ちます。200 ms のクエリなら問題ありませんが、6分かかるテストでは、3つの問題が生じます。後続のリクエストの遅延が積み重なり、ユーザーが途中で「e2e テストをスキップして」と伝えても Agent は受け取れません。さらに、ゲートウェイが長時間待機中の接続を切断すると、処理自体は成功していても、呼び出しはタイムアウトになります。
原文では、前の指示が完了する前に Agent が次の指示を受け付けられる理想的な状態を「productive」と呼んでいます。その実現方法は、ブロッキングする run() を一連の小さな契約に分けることです。start() はタスクのハンドルを即座に返し、status() は進捗を報告し、stop() はキャンセルを要求します。結果は後からイベントとして対話に返されます。違いは、誰が待つかです。run() ではモデルが待ち、start() ではランタイムが待ちます。
DeepSeek Harness の全二重における非同期ツール契約
ツールの定義では、時間のかかる各機能に対して、1つではなく3つのツールを公開します。テストを例にすると、start_test_run は job_id と queued ステータスだけを返し、処理結果のデータは返しません。get_job_status は queued、running、done、failed のいずれかと、簡単な進捗説明を返します。stop_job はキャンセルを要求し、実際に到達したステータスを返します。
モデルの振る舞いが想定から外れるのを防ぐには、2つのルールが役立ちます。1つ目は、ツールの説明に「結果を待たない」と明記することです。そうしないと、モデルが get_job_status を頻繁にポーリングしてしまいます。2つ目は、start がデータを返さないことです。データを返すと、モデルは今回受け取ったものがどの構造なのか推測しなければなりません。ツールの背後にあるタスク API は、次の表を参考に設計できます。RFC 9110 における 202 Accepted の定義は、まさに「リクエストは処理のために受理されたが、処理はまだ完了していない」というものです。
| 呼び出し | レスポンス | 対応するツール |
|---|---|---|
POST /jobs(Idempotency-Key リクエストヘッダー付き) |
202、job_id と queued ステータスを返し、Location は /jobs/{id} を指す |
start |
GET /jobs/{id} |
200、queued / running / done / failed を返す | status、タスクリスナー |
GET /jobs/{id}/result |
完了時は 200 で結果を返し、未完了時は 409 | 結果取得ツール |
DELETE /jobs/{id} |
202 はキャンセル要求の受理を示し、その後の呼び出しでは 404 または 409 を返す | stop |
| 任意のコールバック URL | タスク完了時に呼び出し元へ POST | タスクリスナー |
DeepSeek Harness:全二重通信での結果の返却とバッチ処理
ポーリングはあくまでフォールバック策です。よりよい設計は、ランタイムがタスクを監視し、完了時に短い完了イベントを会話へ送ることです。イベントには job_id、ステータス、「412件成功、3件失敗」といった1行の要約を含めます。完全なログは結果取得ツールから取り出せるようにしておけば、4万行のログが直接コンテキストに入ることはありません。
原文では、Router のバッチ処理についても説明しています。1回の生成中に届いた Trigger はいったんキューに入れ、次のモデル呼び出しにまとめて渡します。この種の呼び出しは入力が長く、出力が短いため、コストの大半は prefill 段階にかかります。原文の実験では、Trigger の頻度を1分あたり1回から40回に上げると、平均バッチサイズは1.0から2.8に増え、1回の判断にかかる時間は6.4 sから1.6 sに短縮されました。これは原文独自のテストデータであり、一般的なベンチマークではありませんが、考え方はそのまま活用できます。モデルの生成中はイベントとユーザーメッセージをキューに入れ、その生成が終わったら到着順にまとめて渡します。
順序制御、キャンセル、冪等性に関する実装の詳細
次の点は、プロトタイプの段階では見落としやすく、リリース後には問題を引き起こしやすい箇所です。
- 順序制御:タスクが完了する順序は一定ではありません。B が A に依存する場合は、その依存関係を明示する必要があります。A の完了イベントが届いてから B を開始するか、API で
depends_onをサポートします。 - キャンセル:
stopはあくまでリクエストであり、必ず成功するとは限りません。実際の終了状態を返す必要があります。キャンセル前にタスクが完了していた場合はdoneを返し、モデルがユーザーにそのまま伝えられるようにします。 - 冪等キー:モデルはリトライを行うため、レスポンスが失われると2回目の
startが発生することがあります。毎回のstartにidempotency_keyを必須とし、同じキーには既存のタスクを返します。そうしなければ、「マイグレーションを実行して」という一言で処理が2回実行されかねません。 - 部分結果とタイムアウト:カーソル付きの結果取得 API で途中の出力を提供します。また、各タスクに期限を設定し、タイムアウトしたら
job_timed_outイベントを発行します。
ツールに MCP を使っている場合は、MCP 仕様の2026-07-28版に含まれるオプション拡張 Tasks に注目するとよいでしょう。サーバーはツール呼び出しに対して taskId を含む結果を返せます。クライアントは tasks/get でポーリングするか、notifications/tasks を監視し、tasks/cancel でキャンセルを要求できます。この拡張はクライアントとサーバーの両方で明示的に有効にする必要があります。また、ホストごとにサポート状況が異なるため、使用前に確認してください。
非同期にする必要がない場合:呼び出しが1〜2秒で返る場合、次のステップを始めるために必ず結果が必要な場合、または背後に実際のタスク API がない場合です。ツール内部がブロッキング処理なのに、外部向けに非同期として包んでも、複雑さが増すだけです。実用的な切り分けとしては、読み取り操作はブロッキングのままにし、時間のかかる書き込み操作や計算を非同期にします。
DeepSeek Harness の記憶設計に学ぶ:Chain of Recall
長時間稼働する Agent は、新しい作業が次々と入ってくるため、いずれコンテキストの上限に突き当たります。よくある3つの対処法には、それぞれ代償があります。すべてを保持すればウィンドウが埋まり、やり取りを重ねるほどコストが上がります。要約を更新し続ける方法では、後から必要になる具体的なエラーや PR 番号が失われることがあります。類似度による検索では、必要な事実と検索文の表現が似ていなければ、見つけられません。
原文では、コンテキストをキャッシュとして扱い、2種類の操作だけを行います。Inline には、ID、短い要約、直近のメッセージなど、Agent が今もっとも使いそうな内容を入れます。Spill では、それ以外の内容を切り詰めてポインタを残し、必要になったときにポインタを使って取得します。溢れた内容は削除されるのではなく、プロンプト内にはポインタだけが残ります。たとえば CI の失敗イベントなら、コンテキストには「PR #412 の CI が失敗。payments ディレクトリ内のテスト 118 件のうち 3 件が失敗」という1行の要約だけを残し、41 KB の完全なログについては取得先だけを保持します。要約で足りるなら、Agent はこの 41 KB 分のコストを払わずに済みます。
DeepSeek Harness の記憶設計における不変の ID と参照グラフ
Chain of Recall が成り立つ前提は、ID が変わらないことです。原文では、3種類のオブジェクトに ID が付いています。
| オブジェクト | 意味 | ID の例 | リンク関係 |
|---|---|---|---|
| Trigger | システムに入ってくるイベント:チャットメッセージ、Webhook、CI コールバック | trg_8f21 |
いずれかの Thread に属する |
| Thread | 同じ PR、IM のトピック、メールスレッドに関する一連のイベント | thr_pr_412 |
1つ以上の Worker が保持する |
| Worker | 単一のタスクを処理する、隔離された Agent セッション | wkr_77a0 |
レポート内で処理した Trigger を参照する |
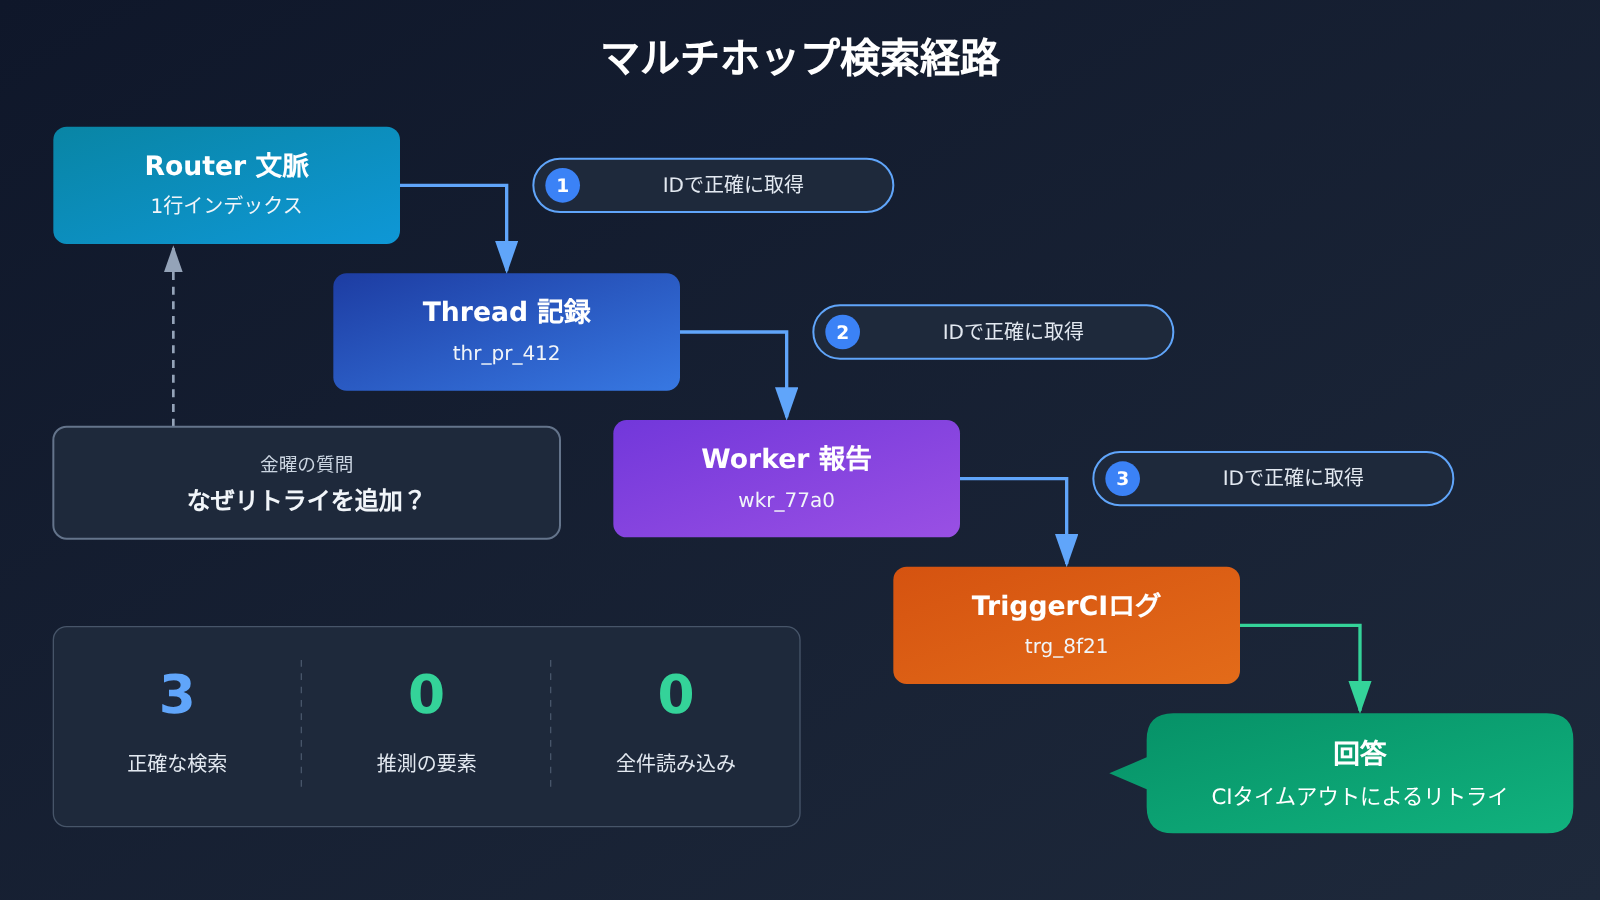
これらのリンクが参照グラフを構成し、このグラフが Agent の記憶になります。情報を呼び戻すときはリンクを1つずつたどり、履歴全体を読み込むことも、類似テキストを検索することもありません。
たとえば、金曜日に誰かが Router に「なぜ決済クライアントにリトライを追加したのか」と尋ねたとします。関連する議論は火曜日に行われ、すでに Spill されています。まず Router は、コンテキストに残った1行のインデックスを使って thr_pr_412 を取得します。次に、Thread の記録からそれを保持する Worker を確認し、その Worker の最終レポートを取得します。最後に、レポートで参照されている CI 失敗の Trigger をたどってログを取得し、タイムアウトエラーを確認します。3回の小さな精密クエリだけで、推測を交えずに答えが得られます。
DeepSeek Harness の記憶 API が満たすべき4つの契約
記憶をたどるチェーンの各ステップは、それぞれ1回の API 呼び出しです。どこかで異なるレコードが返されたり、何も返らなかったりすると、チェーンは途切れ、Agent は行き詰まるか、推測で回答することになります。そのため、基盤となる API は次の4つの契約を満たす必要があります。
- ID は決して変わらない:今日返された ID は、来月も同じオブジェクトを参照できなければなりません。削除後に再利用せず、移行後も採番し直しません。
- ID による取得は低コストかつ正確:
GET /threads/{id}は指定されたレコードだけを返し、検索や「最も近い一致」の返却は行いません。 - 未知の ID は明確に失敗させる:404 と分かりやすいエラーボディを返します。200 と空のオブジェクトを返すと、Agent はその記憶が存在すると誤解します。
- カーソルページネーションに抜けがない:長い Thread は順序どおりにページ分割し、各イベントが一度だけ現れるようにします。新しいイベントが書き込まれても、カーソルは引き続き有効です。
これらの契約はリファクタリング時に気づかないうちに破られやすいため、自動テストに組み込み、マージのたびに実行すべきです。
また、2つの制約を客観的に捉える必要があります。第一に、Chain of Recall はベクトル検索の代わりにはなりません。ベクトル検索が「これに似ているものは何か」に答えるのに対し、Chain of Recall は「これとリンクしているものは何か」に答えます。実際のプロジェクトでは、まずベクトルインデックスで起点となる Thread ID を見つけ、そこからリンクをたどって正確な事実に到達する組み合わせがよく使われます。第二に、原文の「37%」という数字は Thread のパススルーに関するものです。パススルーを取り除くと、実行あたりのキャッシュ読み取りトークン数は 23.2M から 31.8M に増加しました。これは特定の機能がないことによるコストであり、Chain of Recall 自体による節約量ではありません。引用する際は混同しないようにしましょう。
DeepSeek Harness の認証情報設計に学ぶ:認証情報を見せずに使わせる
元の記事では、この問題を未解決の課題として挙げています。認証情報がエージェントのコンテキストに入ると漏洩するおそれがあるため、エージェントが認証情報を見られないまま使用できるようにする必要があります。よくある漏洩経路は4つです。トラブルシューティングのために .env を読み取る、デバッグコマンドに平文のリクエストヘッダーを書いたり「変数が設定されていることを確認する」ために echo を実行したりする、実際の値を PR の説明・Issue のコメント・テストフィクスチャに書き込む、そして Web ページや API レスポンス内のプロンプトインジェクションに誘導されて環境変数を出力するケースです。OWASP はプロンプトインジェクションを LLM アプリケーションの最も重大なリスクに挙げ、認証情報の露出を機密情報漏洩の一種に分類しています。
すべての防御策に共通するルールは、コンテキストには名前だけを置き、値はモデルの外に残すことです。コンテキストに含めてよいのは、変数名 STRIPE_KEY、シークレットマネージャーへの参照、{{token}} のようなプレースホルダー、またはマスクされた値です。実際のキー、参照から解決された値、マスク処理されていないログ行を含めてはいけません。実際の値が会話に現れた場合は、その日のうちにキーをローテーションしてください。会話履歴は記録、キャッシュ、エクスポートされるため、一度送信したトークンは取り戻せません。
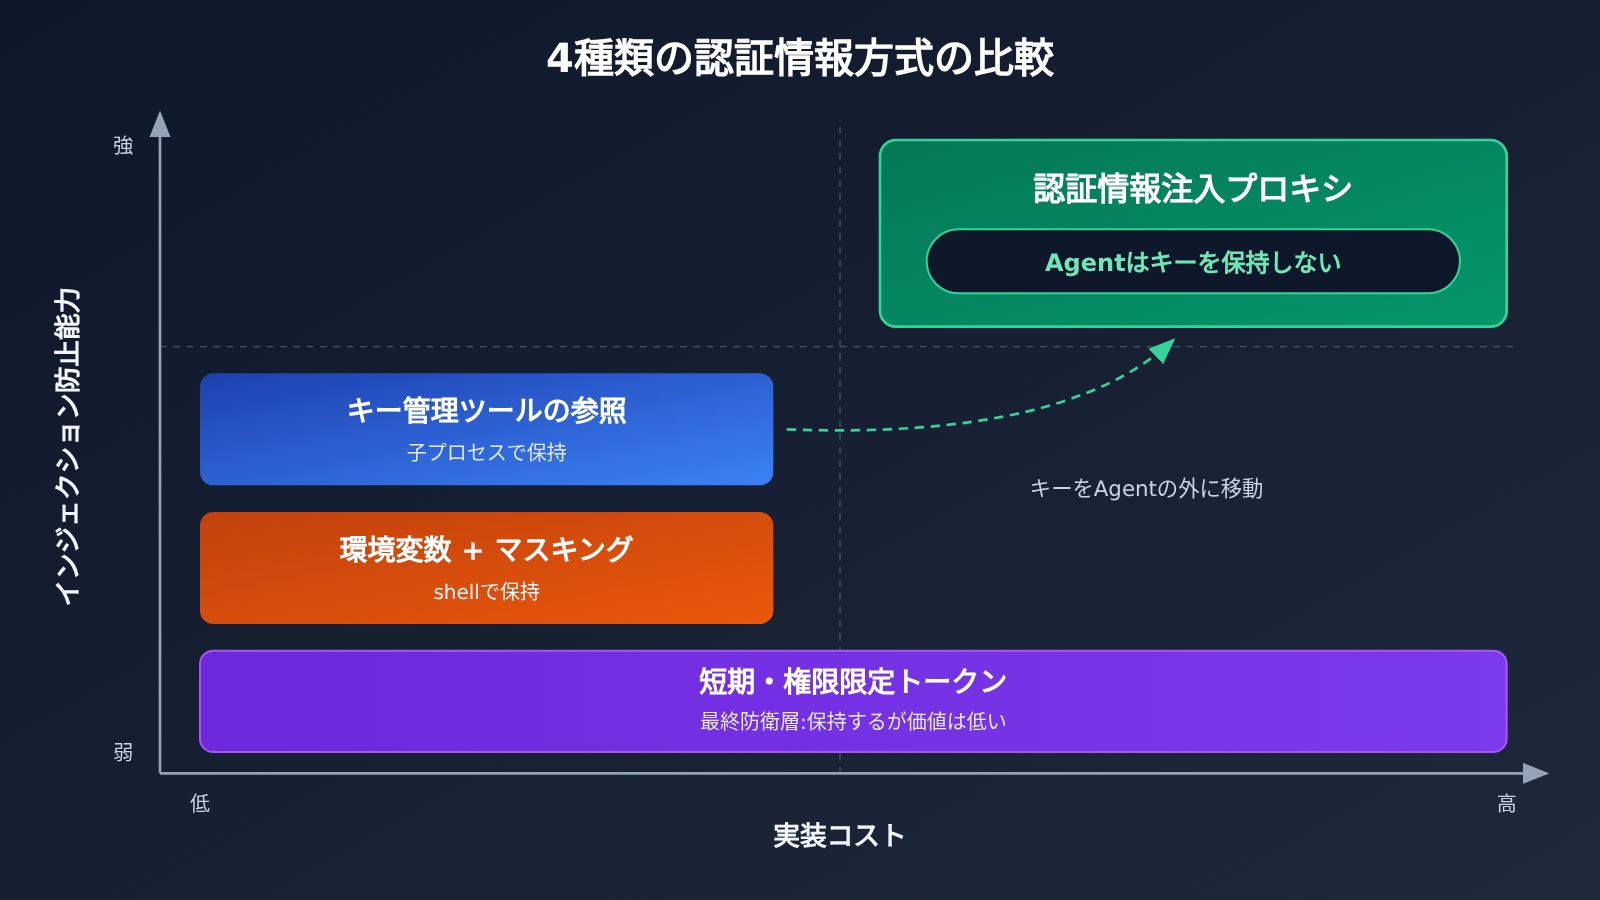
DeepSeek Harness の認証情報を扱う4つの実装パターン
| パターン | 方法 | Agent が値を保持するか | 主な制約 |
|---|---|---|---|
| 環境変数 + マスキング | コマンドに $NAME を記述してシェルで展開する。.env の読み取りを禁止し、出力を返す前にマスキングする |
シェル内で保持する | 誤操作は防げるが、インジェクションを受けた後の意図的な出力は防げない |
| シークレットマネージャーの参照 | 設定には op://vault/item/field のような参照だけを置き、実行時に CLI が解決して子プロセスに渡す |
子プロセス内で保持する | 環境変数と同じ制約がある |
| 認証情報を注入するプロキシ | Agent はキーを持たずにローカルプロキシへリクエストし、プロキシが認証ヘッダーを付与して許可リストに従って転送する | 保持しない | プロキシを別途デプロイし、保守する必要がある |
| 短期・限定権限のトークン | セッションごとに、数分で期限が切れ、用途を1つに限定したトークンを発行する | 保持するが、価値は低い | あくまで最後の備えであり、有効期間内は悪用される可能性がある |
この4つのパターンのうち、Agent にキーを持たせずに済むのは、認証情報を注入するプロキシだけです。プロキシでは、認証情報の注入と同様に許可リストも重要です。たとえば、GET /v1/charges は許可し、DELETE /v1/customers は拒否します。Agent がインジェクションを受けても、承認済みの呼び出ししか実行できず、キーを持ち出すこともできません。Agent がプロキシの設定を読み取れないよう、プロキシは別のユーザーまたは別のコンテナで実行します。これは、認証情報を環境とともにローカルに残すという、原文のデプロイ方針にも沿っています。
Agent が APIYI 経由でモデルを呼び出す場合は、同じ考え方をモデルのキーにも適用できます。APIYI への転送時にプロキシがキーを注入し、Agent 側には「ローカルプロキシを使う」ことだけを知らせます。こうすれば、会話記録がエクスポートされても、そこに有効な APIYI の APIキーが含まれることはありません。具体的な接続先と認証方法は、APIYI のドキュメント docs.apiyi.com を確認してください。
最後の防御層がマスキングです。ツールの出力、CI ログ、保存されたセッションでは、sk_live_、ghp_、github_pat_、AKIA、xoxb- といった既知のプレフィックスを持つ値をマスキングします。すべての Authorization および X-API-Key リクエストヘッダーの値と、そのセッションで注入した具体的な値も対象です。1行でもマスキングされていなければ、それまでの防御がすべて無駄になってしまいます。
DeepSeek Harness 設計のクイックスタート:導入チェックリストとモデル選定
3つの設計課題を一度に片付ける必要はありません。費用対効果を踏まえると、次の順番で進めるのがおすすめです。
- まずは認証情報を適切に管理する:Agent による
.envの読み取りを禁止し、CLAUDE.mdまたはAGENTS.mdに「_KEY、_TOKEN、_SECRETで終わる変数は一切出力しない」と明記します。さらに、出力に機密情報のマスキングフィルターを追加します。この作業は半日で完了し、すぐに効果を実感できます。 - 次に、時間のかかるツールを非同期化する:テスト、ビルド、デプロイなど、数秒以上かかることの多いツールから着手します。操作を start / status / stop に分け、冪等性キーと実行期限を追加します。
- 続いて、安定した ID を導入する:イベント、セッションスレッド、サブタスクに不変の ID を統一的に割り当てます。コンテキストには ID と1行の要約だけを残し、長い内容はすべて外部に退避して参照先を記録します。
- 最後に、注入プロキシと短期トークンを導入する:サードパーティの API 向けにプロキシを配置してホワイトリストを設定し、Agent セッションごとに専用のトークンを発行します。
モデル選定では、Router は入力が長く出力が短いうえ、頻繁に一括判断を行うため、安価で高速、かつキャッシュヒット時の料金が低いモデルが適しています。一方、Worker はコードの記述や複雑な推論を担当するため、より高性能なモデルが向いています。下表の価格は APIYI の価格ページ docs.apiyi.com/models から引用しています。課金基準と最新の単価はページのリアルタイム情報を確認してください。この記事では、それ以外の価格を保証するものではありません。
| モデル(APIYI のモデル名) | 入力単価 | 出力単価 | キャッシュ価格 | 推奨される役割 | 利用可能なプラットフォーム |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Router の一括判断、イベント要約 | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | 日常的なコーディングを担う Worker | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 長いコンテキストを扱う Worker、文書関連タスク | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | 複雑なリファクタリング、重要な判断を担う Worker | APIYI apiyi.com |
なお、原文のバッチ処理と Thread の透過的な受け渡しに関する実験では、どちらもキャッシュ読み取りトークンの規模が強調されています。Router 側のコストの大部分は prefill とキャッシュ読み取りにかかるため、モデル選定では出力単価よりもキャッシュ価格を重視する価値があります。
🚀 クイックスタート:APIYI では上表のモデルを API で呼び出せるほか、OpenAI と Anthropic の両方のインターフェース形式に対応しています。Router は OpenAI 形式で deepseek-v4.1-flash に、Worker は Anthropic 形式で claude-sonnet-5-5 に接続でき、両者を1つのアカウントでまとめて管理できます。接続方法は APIYI のドキュメント docs.apiyi.com を参照してください。価格は docs.apiyi.com/models をご確認ください。
よくある質問 FAQ
Q1: DeepSeek Harnessの「スーパーAgent設計」とは何ですか?
DeepSeek Harnessチームが2026-11-01に公開した設計記事「Exploring Super-agent Design」です。常駐し、複数のイベントソースを同時に監視するスーパーAgentをどう設計するかを論じています。説明されているのはアーキテクチャであり、正式にリリースされた機能ではありません。一部の内容はプロトタイププラグイン `dsh-superagent-prototype` に含まれていますが、著者はDeepSeekの公式製品ではないと説明しています。
Q2: 全二重と並列ツール呼び出しの違いは何ですか?
並列ツール呼び出しでは、1回のターンで複数のツールを同時に実行しますが、モデルはすべての結果が返るまで待つ必要があります。全二重での非同期ツール呼び出しでは、ハンドルがすぐに返され、結果は後のターンでイベントとして届きます。モデルは待機中も会話を続けたり、新しい指示を受け取ったり、新しいタスクを開始したりできます。
Q3: Chain of Recallはすぐに有効化できますか? RAGの代わりになりますか?
どちらもできません。Chain of Recallは原文で紹介されている設計パターンで、有効化するためのスイッチはありません。安定したIDと、IDを指定して取得するインターフェースを自分で実装する必要があります。また、RAGとは解決する問題が異なります。RAGは類似する内容を探し、Chain of Recallは正確なリンクをたどって内容を取得します。実際のプロジェクトでは、まずベクトル検索で出発点を見つけ、そこからIDのリンクをたどって具体的な事実に到達する方法が一般的です。原文でも長期記憶は未解決の課題として挙げられており、Chain of Recallですでに解決されたとは述べていません。
Q4: この3つの設計課題は、どのような用途に適していますか?
– **全二重**:テスト、ビルド、クロール、レンダリング、デプロイなど、数秒以上かかることが多く、実行中もユーザーがAgentと対話するタスク。
– **記憶**:PR、チケット、CIの実行記録、カスタマーサポートの会話、リリース記録など、個別にリンクできるイベントで構成される履歴。
– **認証情報**:有料または機密性の高いサードパーティAPIを呼び出す必要があるコーディングAgentや運用Agent。
Q5: RouterとWorkerに異なるモデルを手早く接続するにはどうすればよいですか?
手軽な方法は、OpenAIとAnthropicの両方のインターフェース形式に対応したプラットフォームを使い、接続先を統一することです。APIYI apiyi.com に登録してAPIキーを取得したら、RouterとWorkerにそれぞれ対応するモデル名を設定するだけで切り替えられます。接続先のアドレスはAPIYIのドキュメント docs.apiyi.com を確認してください。本番導入前には、同じ実際のイベント群を使って deepseek-v4.1-flash と claude-sonnet-5-5 の判断品質をそれぞれテストし、役割分担を決めることをおすすめします。
Q6: 原文で言及されているモデルや価格はどこで確認できますか?
本記事で扱うモデルの価格は、すべてAPIYIの価格ページ docs.apiyi.com/models の最新情報を確認してください。原文や第三者の資料に記載された数値は、比較用の引用にすぎません。価格ページに見つからないモデルは、現在APIYIではまだ提供されていません。できるだけ早く提供を開始する予定ですので、提供開始後は価格ページをご確認ください。
Q7: これらの方法にはどのような既知の制限がありますか?
全二重には、実際に非同期タスクをサポートするAPIが必要です。ブロッキング実装を包んだだけの「疑似非同期」は、複雑さを増すだけです。Chain of Recallではリンクが作られていない内容を見つけられず、IDの取り決めは移行やリファクタリングの際に壊れやすいという問題があります。認証情報については、環境変数もキー参照も、インジェクションを受けて意図的に値を出力されるケースは防げません。Agentに値を一切持たせずに済むのは注入プロキシだけで、短期トークンは最後の防御策にとどまります。原文でも記憶と認証情報は未解決の課題として挙げられています。
DeepSeek Harness スーパーAgent設計の要点 Key Takeaways
- 原文の位置づけ:これはアーキテクチャ設計に関する記事です。全二重はデフォルトでオフになっており、プロトタイプのプラグインは公式製品ではありません。
- 全二重:処理をブロックする run を start / status / stop に置き換え、結果をイベントとして戻し、バッチ単位でまとめます。
- タスク API の契約:202 で受け付け、冪等キーで重複を排除し、キャンセル時には実際の状態を返し、各タスクに期限を設けます。
- メモリ設計:コンテキストには安定した ID と短い要約だけを置き、収まりきらない内容はポインターを残します。想起時には ID のリンクを複数回たどって取得します。
- メモリ API の契約:ID は不変、正確な取得が可能、未知の ID には 404 を返し、カーソルページネーションで欠落なく取得できます。
- 認証情報の原則:名前はコンテキストに入れ、値は外部に保持します。注入プロキシを優先し、代替手段として短期トークンを使い、ログはすべてマスキングします。
- モデルの役割分担:Router には安価でキャッシュ料金も低いモデルを、Worker には高性能なモデルを選びます。APIYI では、1つのアカウントで比較テストできます。
まとめ
DeepSeek Harness の「スーパーAgent設計」には、「プロトタイプ」という位置づけから想像する以上に、すぐに参考にできる内容があります。
- 全二重:非同期ツールの契約とイベントの返却は、実績のあるエンジニアリング手法です。基盤となるタスク API は、先にテストを書いてから Agent に接続できます。
- メモリ:安定した ID と inline/spill の組み合わせは、イベント駆動型 Agent に正確なメモリを持たせるための、最も低コストな方法です。ただし、ベクトル検索の代わりにはなりません。
- 認証情報:「名前はコンテキストに入れ、値は外部に保持する」というルールは、今日から実践できます。注入プロキシは、Agent にキーを一切持たせずに済む唯一の方法です。
まずは認証情報の適切な管理と、処理に時間のかかるツールの非同期化から始め、安定した ID と注入プロキシは第2段階に進めることをおすすめします。Router と Worker に異なるモデルを組み合わせる場合は、APIYI apiyi.com の OpenAI および Anthropic 形式と互換性のある統一インターフェースで実際にテストできます。料金は docs.apiyi.com/models をご確認ください。
📚 参考資料
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory:Chain of Recall のメモリ設計の解説
- リンク:
apidog.com/blog/chain-of-recall-ai-agent-memory -
内容:安定した ID、inline/spill、複数ステップの検索例、4つの API 契約を紹介
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run():全二重の非同期ツール設計の解説
- リンク:
apidog.com/blog/async-tool-calls-ai-agents -
内容:start/status/stop の契約、バッチ処理の実験データ、MCP Tasks 拡張を紹介
-
How to Let AI Agents Use API Keys Without Seeing Them:エージェントの認証情報を安全に扱うための実践
- リンク:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
内容:4種類の認証情報管理パターン、漏洩経路、マスキングのチェックリストを紹介
-
APIYI のドキュメントと料金ページ:本記事で取り上げたモデルの接続方法と料金データ
- リンク:
docs.apiyi.comとdocs.apiyi.com/models - 内容:モデル名、インターフェースの形式、最新の料金はこちらをご確認ください
著者:APIYI 技術チーム
技術に関するお問い合わせ:エージェントのアーキテクチャ選定や複数モデルの接続については、APIYI の apiyi.com トップページからお気軽にお問い合わせください。詳しい資料は docs.apiyi.com のドキュメントセンターをご覧ください。


