
Note de l’auteur : cet article analyse trois questions soulevées dans « Super-agent Design » de DeepSeek Harness : le full-duplex, la mémoire et les identifiants secrets. Il distingue les pratiques applicables dès aujourd’hui des questions encore ouvertes, puis propose des contrats d’interface et une liste de mise en œuvre.
Un agent qui fonctionne pendant de longues périodes se heurte souvent à trois problèmes à la fois. Pendant les six minutes d’exécution des tests, les nouvelles questions de l’utilisateur restent en attente ; les événements du jour repoussent le contexte de la veille hors de la fenêtre de contexte ; et, en déboguant, l’agent ouvre .env, faisant entrer les clés dans l’historique de conversation. Le 1er novembre 2026, l’équipe DeepSeek Harness a publié un long article de conception, « Exploring Super-agent Design », qui résume ces trois problèmes ainsi : full-duplex, mémoire (Chain of Recall) et « utiliser des identifiants secrets sans les voir ».
Il ne s’agit pas d’une analyse de lancement de produit. L’article original décrit une architecture, pas une fonctionnalité qu’il suffit d’activer : le full-duplex est implémenté dans DeepSeek Harness, mais désactivé par défaut ; une partie du travail se trouve dans le plug-in prototype dsh-superagent-prototype, que les auteurs présentent clairement comme « n’étant pas un produit officiel DeepSeek ». La mémoire à long terme et les identifiants secrets figurent également parmi les questions ouvertes.
L’essentiel : à la fin de cet article, vous saurez quelles approches reprendre pour chacun de ces trois problèmes, quels contrats les API correspondantes doivent respecter et par quoi commencer dans votre propre projet d’agent.
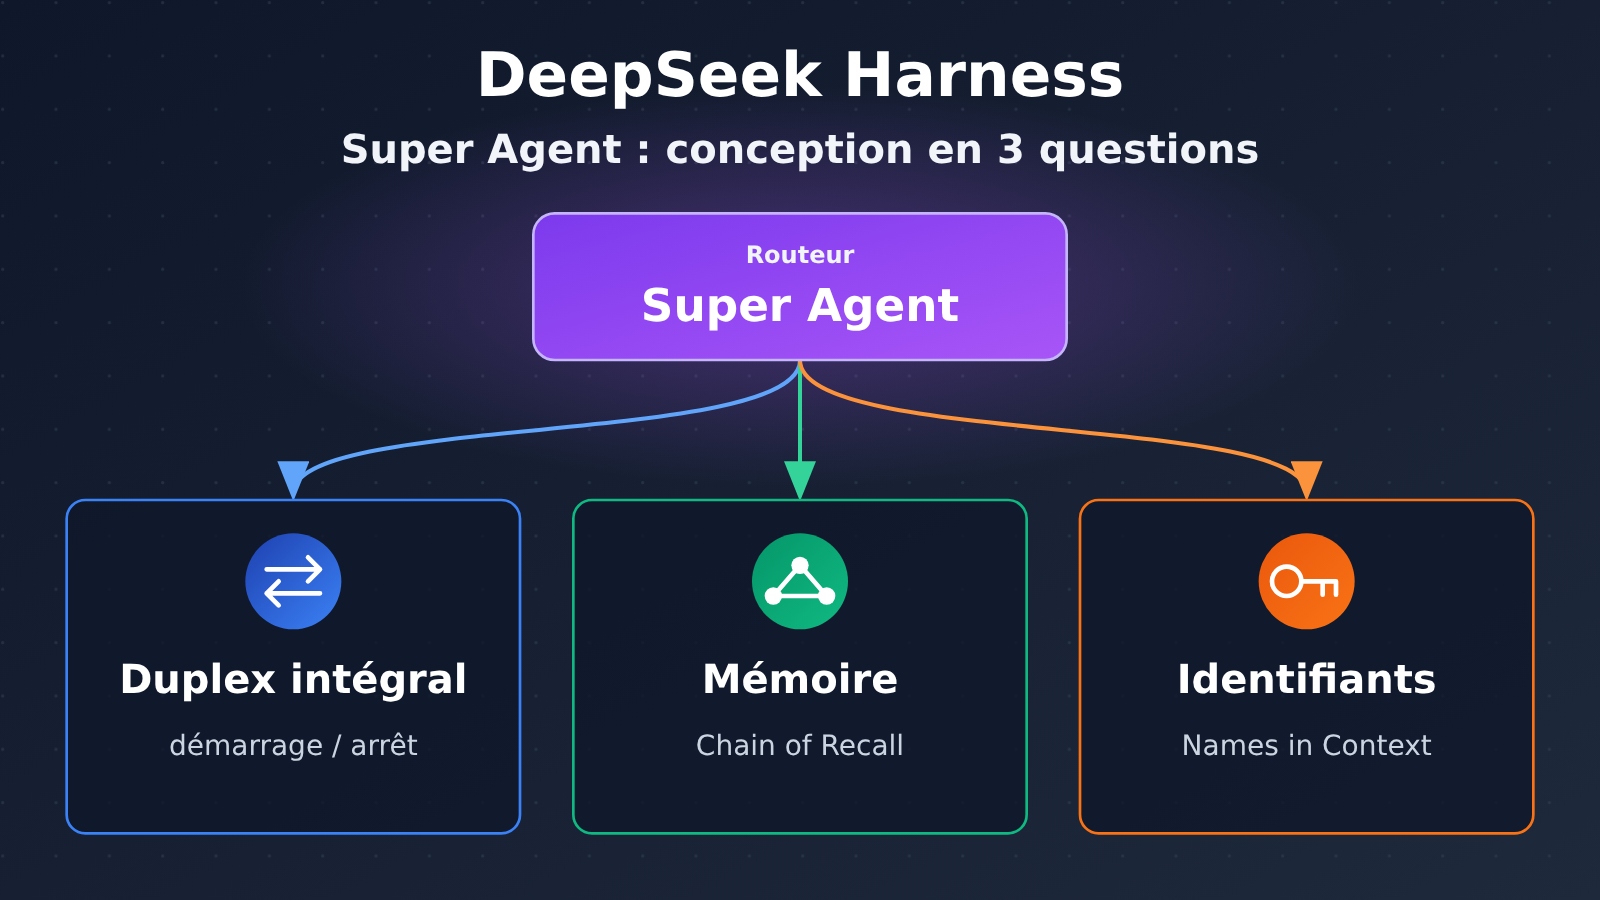
Les points clés de la conception du super agent DeepSeek Harness
Ce tableau situe les trois questions de conception dans l’article original et résume ce qu’on peut en retenir dès maintenant.
| Question de conception | Idée centrale de l’article original | Statut dans l’article original | Ce qu’on peut reprendre directement |
|---|---|---|---|
| Full-duplex | Scinder l’appel bloquant run() en start() et stop() pour que l’agent puisse recevoir des instructions pendant qu’il travaille |
Implémenté, mais désactivé par défaut | Contrat d’outil asynchrone, réinjection d’événements, traitement par lots |
| Mémoire | Ne garder dans le contexte que des ID stables, de courts résumés et les messages voisins ; stocker le reste ailleurs avec des pointeurs, puis le retrouver par associations successives entre ID | La mémoire à long terme reste une question ouverte | ID stables, stockage inline/spill, récupération précise par ID |
| Identifiants secrets | L’agent doit pouvoir utiliser les identifiants sans qu’ils entrent dans son contexte | Question ouverte | Des méthodes d’ingénierie qui placent les noms dans le contexte et gardent les valeurs à l’extérieur |
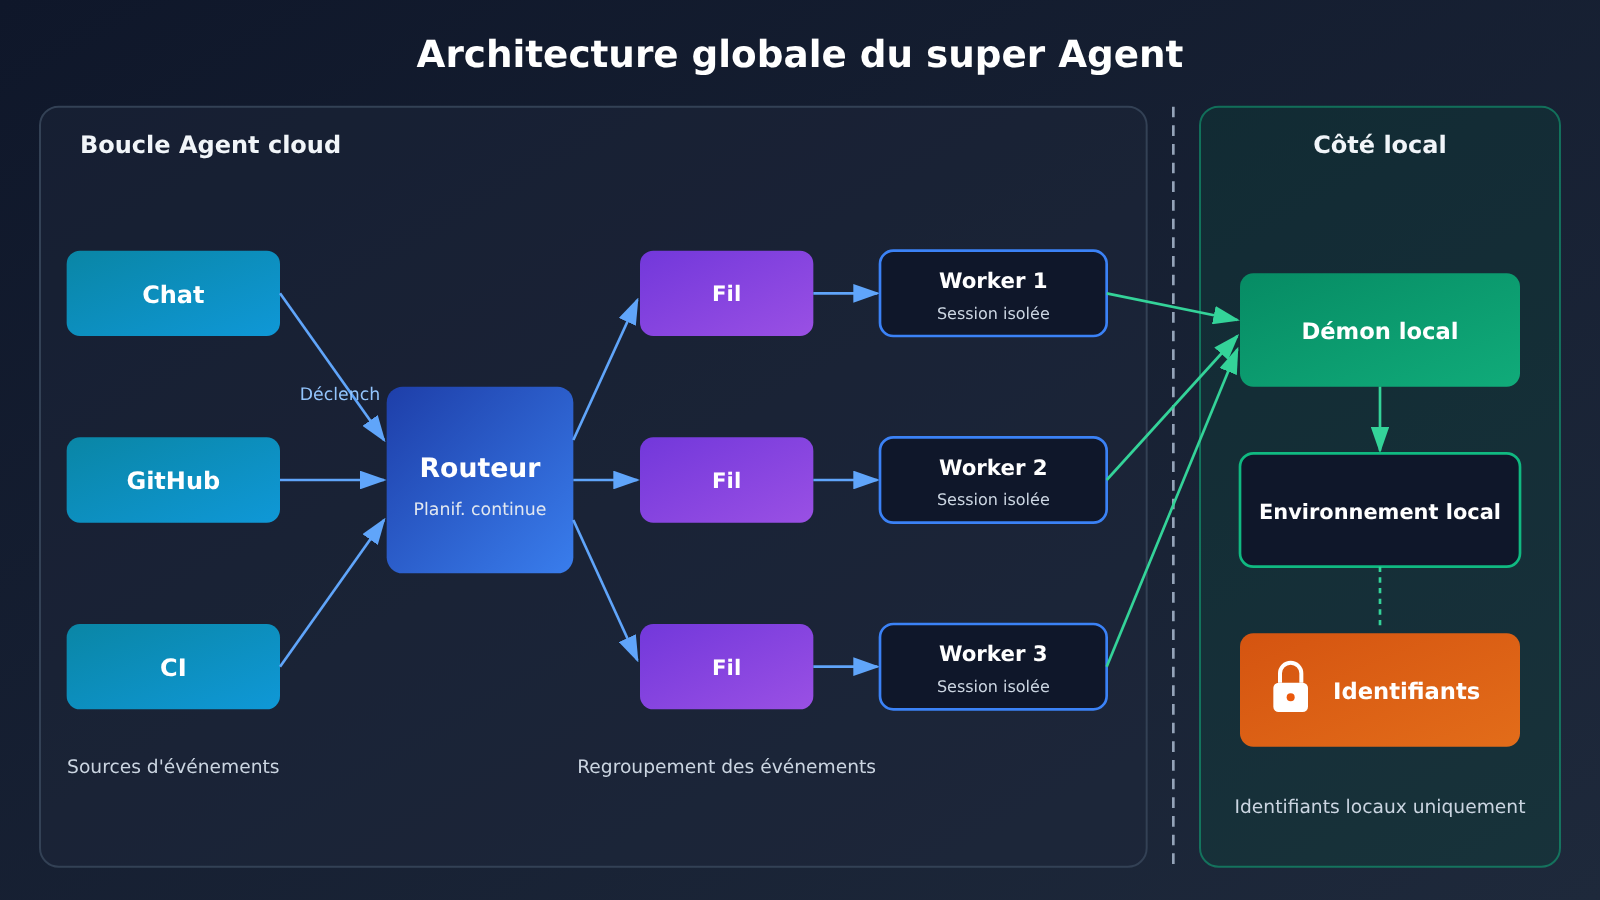
Architecture générale du super agent DeepSeek Harness
Dans l’article original, le super agent se compose d’un Router et de Workers. Le Router est le point d’entrée permanent chargé de l’orchestration : il écoute simultanément les événements provenant du chat, de GitHub, de la CI et d’autres sources. Un Worker est une session d’agent isolée qui ne traite qu’une seule tâche. Chaque événement entrant dans le système est appelé un Trigger. Une série d’événements liés à une même PR, à un même sujet de messagerie instantanée ou à une même chaîne d’e-mails est regroupée dans un Thread.
Cette architecture présente aussi une particularité de déploiement : la boucle de l’agent tourne dans le cloud, tandis que l’environnement d’exécution de l’utilisateur reste sur sa machine. Un petit processus en arrière-plan assure la liaison, et les identifiants secrets restent eux aussi en local. Les trois questions de conception reposent sur ce principe. Une fois les quatre notions de Router, Worker, Trigger et Thread comprises, les choix concernant le full-duplex et la mémoire deviennent plus faciles à suivre.
Comment s’inspirer de la conception full-duplex de DeepSeek Harness
Le full-duplex vise à résoudre un problème : un outil lent peut bloquer tout l’Agent. Dans l’approche traditionnelle, l’Agent attend la réponse après chaque appel d’outil. Pour une requête de 200 ms, ce n’est pas grave. Mais un test qui dure 6 minutes pose trois problèmes : les délais des requêtes suivantes s’accumulent ; si l’utilisateur dit en cours de route « ignore les tests e2e », l’Agent ne l’entend pas ; et la passerelle peut couper une connexion restée ouverte trop longtemps, provoquant un timeout alors que le travail a bien été effectué.
L’article original qualifie l’état idéal de « productive » : l’Agent peut recevoir l’instruction suivante alors que la précédente n’est pas encore terminée. Pour y arriver, on découpe un run() bloquant en plusieurs petits contrats : start() renvoie immédiatement un identifiant de tâche, status() indique la progression, stop() demande l’annulation et le résultat revient plus tard dans la conversation sous forme d’événement. La différence tient à qui attend : avec run(), c’est le modèle ; avec start(), c’est l’environnement d’exécution.
Le contrat asynchrone des outils full-duplex de DeepSeek Harness
Concrètement, chaque opération de longue durée expose trois outils au lieu d’un seul. Pour les tests, par exemple, start_test_run renvoie uniquement le job_id et l’état queued, sans données métier ; get_job_status renvoie l’un des états queued, running, done ou failed, accompagné d’une brève indication de progression ; stop_job demande l’annulation et renvoie l’état effectivement atteint.
Deux règles permettent d’éviter les comportements indésirables du modèle. Premièrement, la description de l’outil doit préciser « ne pas attendre le résultat », sinon le modèle risque d’interroger fréquemment get_job_status. Deuxièmement, start ne renvoie jamais de données : le modèle n’a ainsi pas à deviner quelle structure il reçoit. L’API de tâches sous-jacente peut suivre le tableau ci-dessous. La RFC 9110 définit justement 202 Accepted comme une requête acceptée pour traitement, mais dont le traitement n’est pas encore terminé.
| Appel | Réponse | Outil correspondant |
|---|---|---|
POST /jobs (avec l’en-tête Idempotency-Key) |
202, renvoie le job_id et l’état queued, Location pointe vers /jobs/{id} |
start |
GET /jobs/{id} |
200, renvoie queued / running / done / failed | status, écouteur de tâches |
GET /jobs/{id}/result |
200 avec le résultat si la tâche est terminée, 409 sinon | Outil de récupération du résultat |
DELETE /jobs/{id} |
202 indique que la demande d’annulation a été acceptée ; un appel ultérieur renvoie 404 ou 409 | stop |
| URL de callback facultative | POST envoyé à l’appelant à la fin de la tâche | Écouteur de tâches |
Réinjection des résultats en duplex intégral et traitement par lots dans DeepSeek Harness
Le polling n’est qu’une solution de secours. Une meilleure approche consiste à laisser le runtime surveiller les tâches et, lorsqu’une tâche se termine, à envoyer dans la conversation un bref événement de fin contenant le job_id, le statut et un résumé sur une ligne, par exemple « 412 réussites, 3 échecs ». Les journaux complets restent accessibles via l’outil de récupération des résultats : leurs quarante mille lignes n’entrent donc pas directement dans le contexte.
L’article original décrit aussi le traitement par lots du Router : les Trigger reçus pendant une génération sont mis en file d’attente, puis regroupés dans la prochaine invocation du modèle. Ces appels ont une entrée longue et une sortie courte ; l’essentiel du coût se situe donc dans la phase de prefill. Dans les tests de l’article, lorsque la fréquence des Trigger est passée de 1 à 40 par minute, la taille moyenne des lots est passée de 1,0 à 2,8 et le temps par décision est passé de 6,4 s à 1,6 s. Ce sont les résultats propres à ces tests, pas une référence universelle, mais le principe est directement applicable : pendant que le modèle génère sa réponse, les événements et les messages utilisateur sont mis en file d’attente, puis transmis ensemble dans leur ordre d’arrivée à la fin du tour.
Ordre d’exécution, annulation et idempotence : les détails techniques
Ces détails sont faciles à négliger au stade du prototype, mais peuvent provoquer des incidents une fois en production :
- Ordre d’exécution : les tâches ne se terminent pas forcément dans un ordre prévisible. Si B dépend de A, il faut exprimer cette dépendance explicitement : attendre l’événement de fin de A avant de lancer B, ou utiliser une API qui prend en charge
depends_on. - Annulation :
stopn’est qu’une demande, sans garantie qu’elle aboutisse. Il faut renvoyer l’état réel à la fin de l’opération. Si la tâche s’est déjà terminée avant son annulation, renvoyezdonepour que le modèle puisse en informer correctement l’utilisateur. - Clé d’idempotence : le modèle peut réessayer, et la perte d’une réponse peut déclencher un deuxième
start. Exigez uneidempotency_keypour chaquestartet renvoyez la tâche existante si la clé a déjà été utilisée. Sinon, une simple demande comme « exécute la migration » pourrait être exécutée deux fois. - Résultats partiels et délais d’expiration : donnez accès aux premières sorties via une interface de résultats avec curseur. Fixez aussi une échéance pour chaque tâche et émettez un événement
job_timed_outen cas de dépassement.
Si votre outil utilise MCP, l’extension facultative Tasks de la version 2026-07-28 de la spécification MCP mérite votre attention. Le serveur peut répondre à un appel d’outil avec un résultat contenant un taskId. Le client peut ensuite interroger régulièrement tasks/get ou écouter notifications/tasks, et demander une annulation avec tasks/cancel. Le client et le serveur doivent tous deux activer explicitement cette extension. Sa prise en charge varie aussi selon les applications hôtes : vérifiez-la avant de l’utiliser.
Quand l’asynchrone n’est pas nécessaire : lorsque l’appel revient en une ou deux secondes, que l’étape suivante a impérativement besoin du résultat pour commencer, ou qu’aucune véritable API de tâches n’existe en arrière-plan. Si l’outil est bloquant en interne, lui ajouter une interface asynchrone ne fait qu’accroître la complexité. Une règle pratique consiste à garder les opérations de lecture bloquantes et à rendre asynchrones les opérations d’écriture longues et les calculs.
Comment s’inspirer de la mémoire de DeepSeek Harness : Chain of Recall
Un Agent qui fonctionne longtemps finit tôt ou tard par atteindre la limite de son contexte, car de nouvelles tâches arrivent en permanence. Les trois approches courantes ont chacune un coût : tout conserver finit par remplir la fenêtre et augmenter les coûts à chaque tour ; les résumés successifs font perdre des détails utiles plus tard, comme un message d’erreur précis ou un numéro de PR ; la recherche par similarité échoue lorsque les faits recherchés et la requête ne se ressemblent pas assez sur le plan littéral.
L’idée présentée dans l’article d’origine consiste à traiter le contexte comme un cache, avec seulement deux opérations. Inline conserve les éléments dont l’Agent a le plus de chances d’avoir besoin immédiatement : les ID, les résumés courts et les messages voisins. Spill traite le reste : le contenu est tronqué et remplacé par un pointeur qui permet de le récupérer plus tard. Les données ainsi mises de côté ne sont pas supprimées : seul leur pointeur reste dans l’invite. Par exemple, pour un événement d’échec CI, le contexte ne conserve qu’une ligne de résumé : « Échec CI de la PR #412 : 3 des 118 tests du répertoire payments ont échoué ». Seul le chemin de récupération des 41 KB de journaux complets est conservé. Si le résumé suffit, l’Agent n’a pas à payer pour ces 41 KB.
ID stables et graphe de références dans la mémoire de DeepSeek Harness
Chain of Recall repose sur une condition : les ID ne changent jamais. Dans l’article d’origine, trois types d’objets possèdent un ID :
| Objet | Signification | Exemple d’ID | Relations |
|---|---|---|---|
| Trigger | Un événement entrant dans le système : message de chat, Webhook ou retour CI | trg_8f21 |
Appartient à un Thread |
| Thread | Une série d’événements liés à une même PR, à une discussion de messagerie instantanée ou à un fil de courriels | thr_pr_412 |
Détenu par un ou plusieurs Worker |
| Worker | Une session d’Agent isolée qui traite une seule tâche | wkr_77a0 |
Son rapport fait référence aux Trigger qu’il a traités |
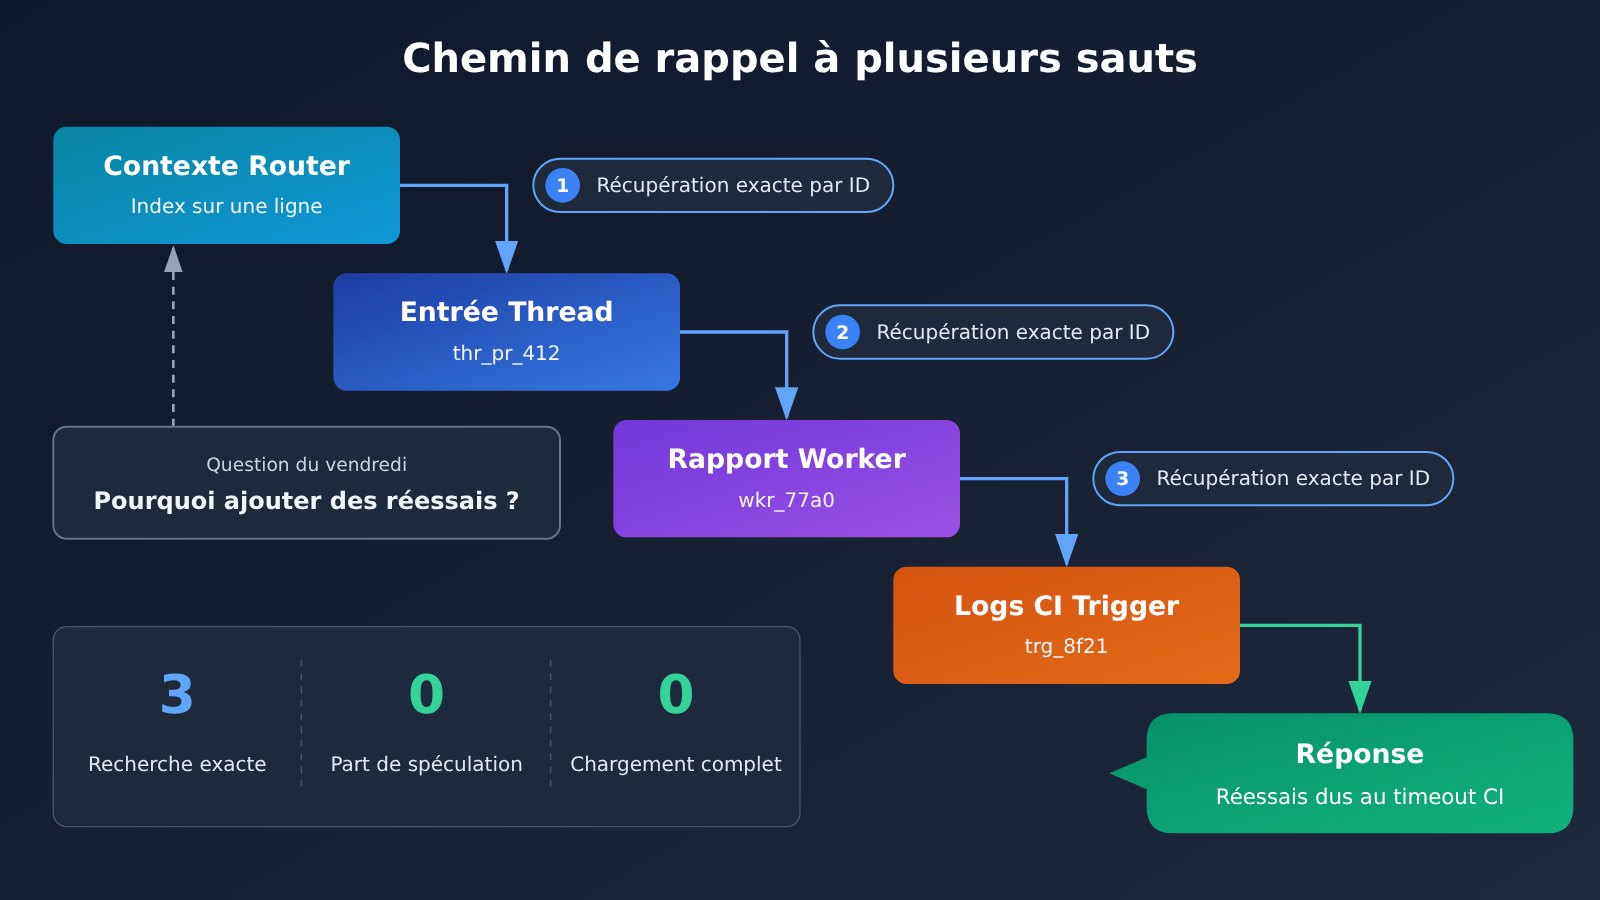
Ces liens forment un graphe de références : c’est la mémoire de l’Agent. Pour retrouver une information, il suit les liens étape par étape, sans charger tout l’historique ni rechercher des textes similaires. Prenons un exemple : vendredi, quelqu’un demande au Router « pourquoi a-t-on ajouté des tentatives au client de paiement ? », alors que la discussion correspondante a eu lieu mardi et a déjà été mise de côté. Première étape : le Router récupère thr_pr_412 grâce à la ligne d’index encore présente dans son contexte. Deuxième étape : il lit dans l’enregistrement du Thread quel Worker le détient, puis récupère le rapport final de ce Worker. Troisième étape : le rapport fait référence au Trigger de l’échec CI ; le Router récupère ses journaux et y trouve une erreur de délai d’attente. Trois petites requêtes précises suffisent, sans aucune supposition.
Les quatre contrats que doit respecter l’API mémoire de DeepSeek Harness
Chaque étape de la chaîne de rappel correspond à un appel API. Si l’un de ces appels renvoie un enregistrement différent ou ne renvoie rien, la chaîne se brise : l’agent reste bloqué ou répond en se basant sur des suppositions. L’API sous-jacente doit donc respecter quatre contrats :
- Les ID ne changent jamais : un ID renvoyé aujourd’hui doit désigner le même objet le mois prochain. Il n’est pas réutilisé après une suppression ni renuméroté après une migration.
- La récupération par ID est peu coûteuse et précise :
GET /threads/{id}renvoie uniquement l’enregistrement demandé, sans recherche ni retour de la « correspondance la plus proche ». - Un ID inconnu produit une erreur explicite : l’API renvoie un code 404 et un corps d’erreur clair. Si elle renvoie un code 200 avec un objet vide, l’agent croira que ce souvenir existe.
- La pagination par curseur ne laisse aucune lacune : les longs Threads sont paginés dans l’ordre, chaque événement apparaît une seule fois et le curseur reste valide lorsque de nouveaux événements sont ajoutés.
Ces contrats peuvent facilement être rompus sans qu’on s’en aperçoive lors d’une refonte. Il faut donc les intégrer à des tests automatisés exécutés à chaque fusion de code.
Il faut aussi garder deux limites à l’esprit. Premièrement, Chain of Recall ne remplace pas la recherche vectorielle : la recherche vectorielle répond à la question « qu’est-ce qui ressemble à ceci ? », tandis que Chain of Recall répond à « qu’est-ce qui est lié à ceci ? ». Dans les projets concrets, on combine souvent les deux : un index vectoriel permet de trouver l’ID du Thread de départ, puis on suit les liens jusqu’aux faits précis. Deuxièmement, le chiffre de « 37 % » dans l’article d’origine concerne la transmission directe du Thread : sans cette transmission, le nombre de tokens lus depuis le cache à chaque exécution passe de 23,2 M à 31,8 M. C’est le coût de l’absence d’une fonctionnalité, pas une économie attribuable à Chain of Recall en lui-même. Il ne faut pas confondre les deux lorsqu’on cite ce chiffre.
S’inspirer de la gestion des identifiants de DeepSeek Harness : les utiliser sans les voir
L’article original présente cette question comme un problème ouvert : dès qu’un identifiant entre dans le contexte d’un agent, il risque de fuiter. L’agent devrait donc pouvoir l’utiliser sans jamais le voir. Il existe quatre voies de fuite courantes : lire .env pour résoudre un problème ; écrire un en-tête de requête en clair dans une commande de débogage ou exécuter echo pour « vérifier que la variable est définie » ; inscrire une valeur réelle dans la description d’une PR, un commentaire d’Issue ou des données de test ; ou encore être amené par une injection d’invite dans une page web ou une réponse d’API à afficher les variables d’environnement. L’OWASP classe l’injection d’invite comme le principal risque des applications LLM et l’exposition d’identifiants dans la catégorie des fuites d’informations sensibles.
Toutes les mesures de protection suivent la même règle : seuls les noms figurent dans le contexte ; les valeurs restent à l’extérieur du modèle. Le contexte peut contenir le nom d’une variable comme STRIPE_KEY, une référence à un gestionnaire de secrets, un espace réservé comme {{token}} ou une valeur masquée. En revanche, il ne doit contenir ni clés réelles, ni valeurs résolues, ni lignes de journal non expurgées. Si une valeur réelle apparaît dans la conversation, il faut renouveler la clé le jour même : les conversations sont enregistrées, mises en cache et exportées, et un jeton déjà transmis ne peut pas être récupéré.
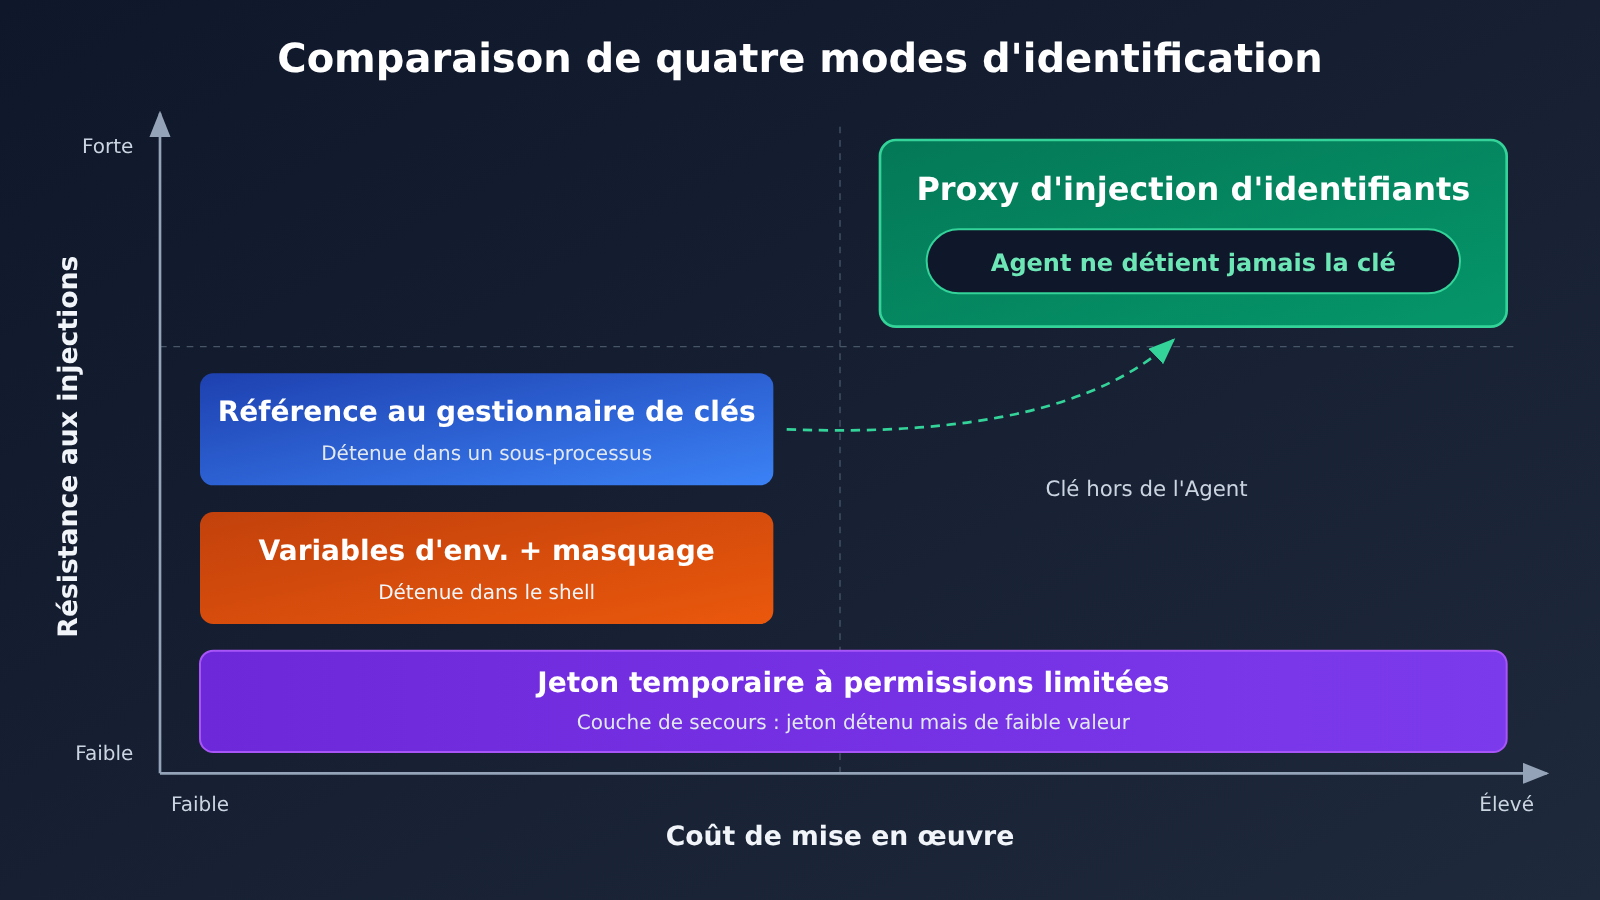
Quatre approches concrètes pour gérer les identifiants dans DeepSeek Harness
| Approche | Mise en œuvre | L’Agent détient-il la valeur ? | Principale limite |
|---|---|---|---|
| Variables d’environnement + masquage | Écrire $NAME dans la commande et laisser le shell le développer ; interdire la lecture de .env ; masquer les valeurs avant de renvoyer les résultats |
Oui, dans le shell | Évite les erreurs de manipulation, mais pas l’affichage volontaire après une injection |
| Référence à un gestionnaire de secrets | Ne placer dans la configuration qu’une référence comme op://vault/item/field, résolue à l’exécution par la CLI dans le sous-processus |
Oui, dans le sous-processus | Mêmes limites que les variables d’environnement |
| Proxy d’injection des identifiants | L’Agent envoie ses requêtes sans clé à un proxy local, qui ajoute l’en-tête d’authentification et transmet selon une liste d’autorisation | Jamais | Nécessite le déploiement et la maintenance d’un proxy distinct |
| Jeton à courte durée de vie et à permissions limitées | Délivrer pour chaque session un jeton qui expire après quelques minutes et ne permet qu’une seule action | Oui, mais sa valeur est très limitée | Simple filet de sécurité : il peut encore être utilisé abusivement tant qu’il est valide |
Parmi ces quatre approches, seul le proxy d’injection des identifiants permet réellement à l’Agent de ne pas détenir la clé. La liste d’autorisation du proxy est aussi importante que l’injection : elle peut par exemple autoriser GET /v1/charges et refuser DELETE /v1/customers. Même si l’Agent subit une injection, il ne peut alors exécuter que les appels approuvés et ne peut pas emporter la clé. Le proxy doit tourner sous un utilisateur ou dans un conteneur distinct pour empêcher l’Agent de lire sa configuration. C’est conforme à l’approche de déploiement de l’article original : les identifiants restent en local, avec l’environnement.
Si votre Agent utilise APIYI pour l’invocation du modèle, le même principe s’applique à la clé du modèle : le proxy injecte la clé lorsqu’il transmet la requête à APIYI, et l’Agent sait seulement qu’il doit passer par le proxy local. Ainsi, même si l’historique des conversations est exporté, il ne contient aucune clé APIYI exploitable. Pour l’adresse de connexion et la méthode d’authentification, consultez la documentation APIYI sur docs.apiyi.com.
La dernière couche est le masquage. Dans les sorties des outils, les journaux CI et les sessions enregistrées, masquez les valeurs portant des préfixes connus, notamment sk_live_, ghp_, github_pat_, AKIA et xoxb-, ainsi que les valeurs de tous les en-têtes de requête Authorization et X-API-Key, sans oublier les valeurs précises injectées pendant la session. Une seule ligne non masquée suffit à réduire à néant toutes les protections précédentes.
Bien démarrer avec la conception d’un harness DeepSeek : liste de mise en œuvre et choix des modèles
Il n’est pas nécessaire de régler les trois questions de conception en une seule fois. Voici l’ordre de mise en œuvre recommandé, selon le rapport effort-bénéfice :
- Commencer par sécuriser les identifiants : interdisez aux agents de lire
.env, précisez dansCLAUDE.mdouAGENTS.mdde « ne jamais afficher les variables dont le nom se termine par_KEY,_TOKENou_SECRET», puis ajoutez un filtre de masquage aux sorties. Cette étape prend une demi-journée et ses bénéfices sont immédiats. - Passer ensuite les outils lents en mode asynchrone : ciblez d’abord les outils de test, de compilation et de déploiement qui prennent souvent plus de quelques secondes. Séparez leurs opérations en start / status / stop et ajoutez des clés d’idempotence ainsi que des délais limites.
- Créer ensuite des ID stables : attribuez des ID immuables aux événements, aux fils de conversation et aux sous-tâches. Dans le contexte, ne conservez que l’ID et un résumé d’une ligne ; stockez les contenus volumineux séparément en gardant un pointeur.
- Terminer par un proxy d’injection et des jetons de courte durée : déployez un proxy pour les API tierces, configurez une liste d’autorisation et émettez un jeton distinct pour chaque session d’agent.
Pour le choix des modèles, le Router reçoit de longues entrées, produit des sorties courtes et prend fréquemment des décisions par lots. Un modèle économique, rapide et dont la lecture du cache coûte peu cher lui convient donc bien. Le Worker, chargé d’écrire du code et de mener des raisonnements complexes, a besoin d’un modèle plus performant. Les prix ci-dessous proviennent de la page tarifaire d’APIYI, docs.apiyi.com/models. Consultez cette page pour connaître les modalités de facturation et les tarifs à jour ; cet article ne garantit pas d’autres prix.
| Modèle (nom du modèle APIYI) | Prix en entrée | Prix en sortie | Prix du cache | Rôle recommandé | Plateforme disponible |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Décisions par lots et résumés d’événements du Router | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Worker pour le développement courant | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Worker pour les contextes longs et les tâches documentaires | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Worker pour les refactorisations complexes et les décisions critiques | APIYI apiyi.com |
À noter : les expériences de traitement par lots et de transmission des fils de conversation dans l’article d’origine soulignent toutes deux le volume de tokens lus depuis le cache. Côté Router, l’essentiel des coûts provient du préremplissage (prefill) et de la lecture du cache. Le prix du cache mérite donc souvent plus d’attention que le prix en sortie.
🚀 Pour démarrer rapidement : APIYI permet d’appeler par API les modèles du tableau et prend en charge les formats d’interface OpenAI et Anthropic. Le Router peut utiliser le format OpenAI avec deepseek-v4.1-flash, et le Worker le format Anthropic avec claude-sonnet-5-5. Les deux peuvent être gérés depuis un même compte. Pour les instructions d’intégration, consultez la documentation APIYI à docs.apiyi.com ; les tarifs sont disponibles sur docs.apiyi.com/models.
Questions fréquentes FAQ
Q1 : Qu’est-ce que « Super-agent Design » de DeepSeek Harness ?
Il s’agit d’un article de fond sur la conception, intitulé « Exploring Super-agent Design », publié le 2026-11-01 par l’équipe DeepSeek Harness. Il explore la conception d’un super-agent actif en permanence et à l’écoute de plusieurs sources d’événements. L’article décrit une architecture, pas une fonctionnalité officiellement lancée. Certains éléments figurent dans le plugin prototype `dsh-superagent-prototype`, que son auteur précise ne pas être un produit officiel de DeepSeek.
Q2 : Quelle est la différence entre le full-duplex et les appels d’outils en parallèle ?
Les appels d’outils en parallèle exécutent plusieurs outils simultanément pendant un même tour, mais le modèle doit toujours attendre tous leurs résultats. En full-duplex, un appel d’outil asynchrone renvoie immédiatement une poignée, puis son résultat arrive sous forme d’événement lors d’un tour ultérieur. Entre-temps, le modèle peut poursuivre la conversation, recevoir de nouvelles instructions et lancer d’autres tâches.
Q3 : Peut-on activer directement Chain of Recall ? Peut-il remplacer le RAG ?
Dans les deux cas, non. Chain of Recall est un modèle de conception présenté dans l’article original : il n’existe pas d’option à activer. Il faut implémenter soi-même des identifiants stables et une interface de récupération par identifiant. Chain of Recall et le RAG répondent à des besoins différents : le RAG recherche des contenus similaires, tandis que Chain of Recall récupère des informations en suivant des liens précis. Dans un projet réel, on utilise généralement d’abord une recherche vectorielle pour trouver un point de départ, puis on suit les liens entre identifiants jusqu’aux faits recherchés. L’article original présente aussi la mémoire à long terme comme une question ouverte : il ne prétend pas que Chain of Recall l’a résolue.
Q4 : À quels cas d’usage ces trois questions de conception conviennent-elles le mieux ?
– **Full-duplex** : les tâches qui prennent souvent plus de quelques secondes, comme les tests, les builds, l’exploration web, le rendu ou le déploiement, lorsque l’utilisateur continue à dialoguer avec l’agent pendant leur exécution.
– **Mémoire** : les historiques composés d’événements distincts et reliables entre eux, comme les PR, les tickets, les exécutions CI, les conversations avec le service client ou les publications.
– **Identifiants d’accès** : les agents de programmation et d’exploitation qui doivent appeler des API tierces payantes ou sensibles.
Q5 : Comment connecter rapidement différents modèles au Router et au Worker ?
Une solution simple consiste à utiliser une plateforme compatible avec les formats d’API d’OpenAI et d’Anthropic pour centraliser l’accès. Après inscription sur APIYI apiyi.com, récupérez une clé API, puis indiquez le nom du modèle souhaité pour le Router et pour le Worker. Pour l’adresse de connexion, consultez la documentation APIYI sur docs.apiyi.com. Avant la mise en production, il est conseillé de tester la qualité des décisions de deepseek-v4.1-flash et de claude-sonnet-5-5 sur le même ensemble d’événements réels, puis de définir leur répartition des rôles.
Q6 : Où vérifier les modèles et les prix mentionnés dans l’article original ?
Pour tous les modèles abordés ici, les données en temps réel de la page des tarifs APIYI, docs.apiyi.com/models, font référence. Les chiffres de l’article original et des sources tierces ne sont cités qu’à titre de comparaison. Si un modèle ne figure pas sur cette page, cela signifie qu’APIYI ne le propose pas encore. Nous le rendrons disponible dès que possible ; ses tarifs figureront alors sur cette page.
Q7 : Quelles sont les limites connues de ces approches ?
Le mode full-duplex nécessite une véritable API de tâches. Un « pseudo-asynchrone » construit autour d’une implémentation bloquante ne ferait qu’ajouter de la complexité. Chain of Recall ne retrouve pas les contenus qui n’ont pas été reliés entre eux, et le contrat des ID peut facilement être rompu lors d’une migration ou d’une refonte. Côté identifiants, ni les variables d’environnement ni les références aux secrets ne protègent contre leur affichage délibéré après une injection. Seul un proxy d’injection permet à l’agent de ne jamais détenir les valeurs ; les jetons de courte durée ne servent que de solution de repli. L’article original classe d’ailleurs lui-même la mémoire et les identifiants parmi les questions ouvertes.
DeepSeek Harness : les points clés de l’architecture du super-agent
- Nature de l’article : il s’agit d’un article sur une architecture ; le mode full-duplex est désactivé par défaut et le plugin prototype n’est pas un produit officiel.
- Full-duplex : remplacer la commande bloquante run par start / status / stop ; les résultats sont réinjectés sous forme d’événements et regroupés par lots.
- Contrat de l’API de tâches : acceptation avec un code 202, déduplication par clé d’idempotence, retour de l’état réel lors d’une annulation et délai limite pour chaque tâche.
- Conception de la mémoire : ne conserver dans le contexte que des ID stables et de courts résumés ; laisser des pointeurs vers le reste et le récupérer, au moment du rappel, en suivant les liens entre ID sur plusieurs étapes.
- Contrat de l’API mémoire : ID immuables, récupération exacte, code 404 pour un ID inconnu et pagination par curseur sans éléments manquants.
- Principe pour les identifiants : les noms vont dans le contexte, les valeurs restent à l’extérieur. Privilégier un proxy d’injection, utiliser des jetons de courte durée en solution de repli et masquer toutes les données sensibles dans les journaux.
- Répartition des rôles entre modèles : le Router choisit un modèle économique, avec un faible coût d’utilisation du cache ; le Worker utilise un modèle plus performant. Vous pouvez les comparer sur APIYI avec un seul compte.
Conclusion
Le document « Super Agent Design » de DeepSeek Harness offre plus d’enseignements directement applicables que son statut de prototype ne le laisse penser :
- Full-duplex : les contrats d’outils asynchrones et la réinjection d’événements sont des pratiques d’ingénierie éprouvées. L’API de tâches sous-jacente peut être testée avant son intégration à l’agent.
- Mémoire : associer des identifiants stables à inline/spill est le moyen le moins coûteux de doter un agent événementiel d’une mémoire précise, mais cela ne remplace pas la recherche vectorielle.
- Identifiants : la règle « le nom dans le contexte, la valeur à l’extérieur » peut être appliquée dès aujourd’hui. Un proxy d’injection est la seule solution permettant à l’agent de ne jamais détenir les clés.
Commencez par l’hygiène des identifiants et le passage en mode asynchrone des outils lents, puis introduisez les identifiants stables et le proxy d’injection dans un second temps. Si vous devez associer différents modèles au Router et au Worker, vous pouvez les tester via APIYI apiyi.com, grâce à une interface unifiée compatible avec les formats OpenAI et Anthropic. Les tarifs de référence sont disponibles sur docs.apiyi.com/models.
📚 Références
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory : analyse de la conception de la mémoire Chain of Recall
- Lien :
apidog.com/blog/chain-of-recall-ai-agent-memory -
Détails : identifiants stables, inline/spill, exemples de rappel en plusieurs étapes et quatre contrats d’API
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run() : analyse de la conception d’outils asynchrones full-duplex
- Lien :
apidog.com/blog/async-tool-calls-ai-agents -
Détails : contrat start/status/stop, données expérimentales sur le traitement par lots et explications sur l’extension MCP Tasks
-
How to Let AI Agents Use API Keys Without Seeing Them : bonnes pratiques de sécurité des identifiants pour les agents
- Lien :
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
Détails : quatre modes de gestion des identifiants, voies de fuite et liste de contrôle pour le masquage des données sensibles
-
Documentation et tarifs APIYI : informations d’accès et données de tarification des modèles mentionnés dans cet article
- Liens :
docs.apiyi.cometdocs.apiyi.com/models - Détails : référence pour les noms de modèles, les formats d’interface et les prix actualisés
Auteur : équipe technique APIYI
Échanges techniques : pour toute question sur le choix d’une architecture d’agent ou l’intégration de plusieurs modèles, contactez-nous depuis la page d’accueil d’APIYI apiyi.com. Retrouvez plus de ressources dans le centre de documentation docs.apiyi.com.


