
Nota do autor: uma análise de três desafios de design apresentados em “Super-agent Design”, do DeepSeek Harness — comunicação full-duplex, memória e credenciais —, com práticas que já podem ser aproveitadas, questões que continuam em aberto, contratos de interface e um checklist de implementação.
Um Agent de longa duração costuma enfrentar três problemas ao mesmo tempo. Durante os 6 minutos de execução dos testes, uma nova pergunta do usuário precisa esperar na fila; os eventos de hoje empurram o contexto de ontem para fora da janela; e, ao depurar, o Agent abre o arquivo .env e acaba colocando as chaves no histórico da conversa. Em 2026-11-01, a equipe do DeepSeek Harness publicou o artigo “Exploring Super-agent Design”, resumindo esses desafios em comunicação full-duplex, memória (Chain of Recall) e “usar credenciais sem vê-las”.
Esta não é uma análise de lançamento de produto. O artigo original descreve uma arquitetura, não uma funcionalidade que basta ativar: o modo full-duplex já foi implementado no DeepSeek Harness, mas vem desativado por padrão. Parte do conteúdo está no plugin de protótipo dsh-superagent-prototype, que o autor define explicitamente como “não sendo um produto oficial da DeepSeek”. A memória de longo prazo e o uso de credenciais também aparecem no artigo como questões em aberto.
O que você vai aprender: ao terminar a leitura, você saberá quais soluções para esses três desafios podem ser adotadas, quais contratos as APIs de cada uma precisam cumprir e por onde começar no seu próprio projeto de Agent.
Pontos centrais do design do superagente DeepSeek Harness
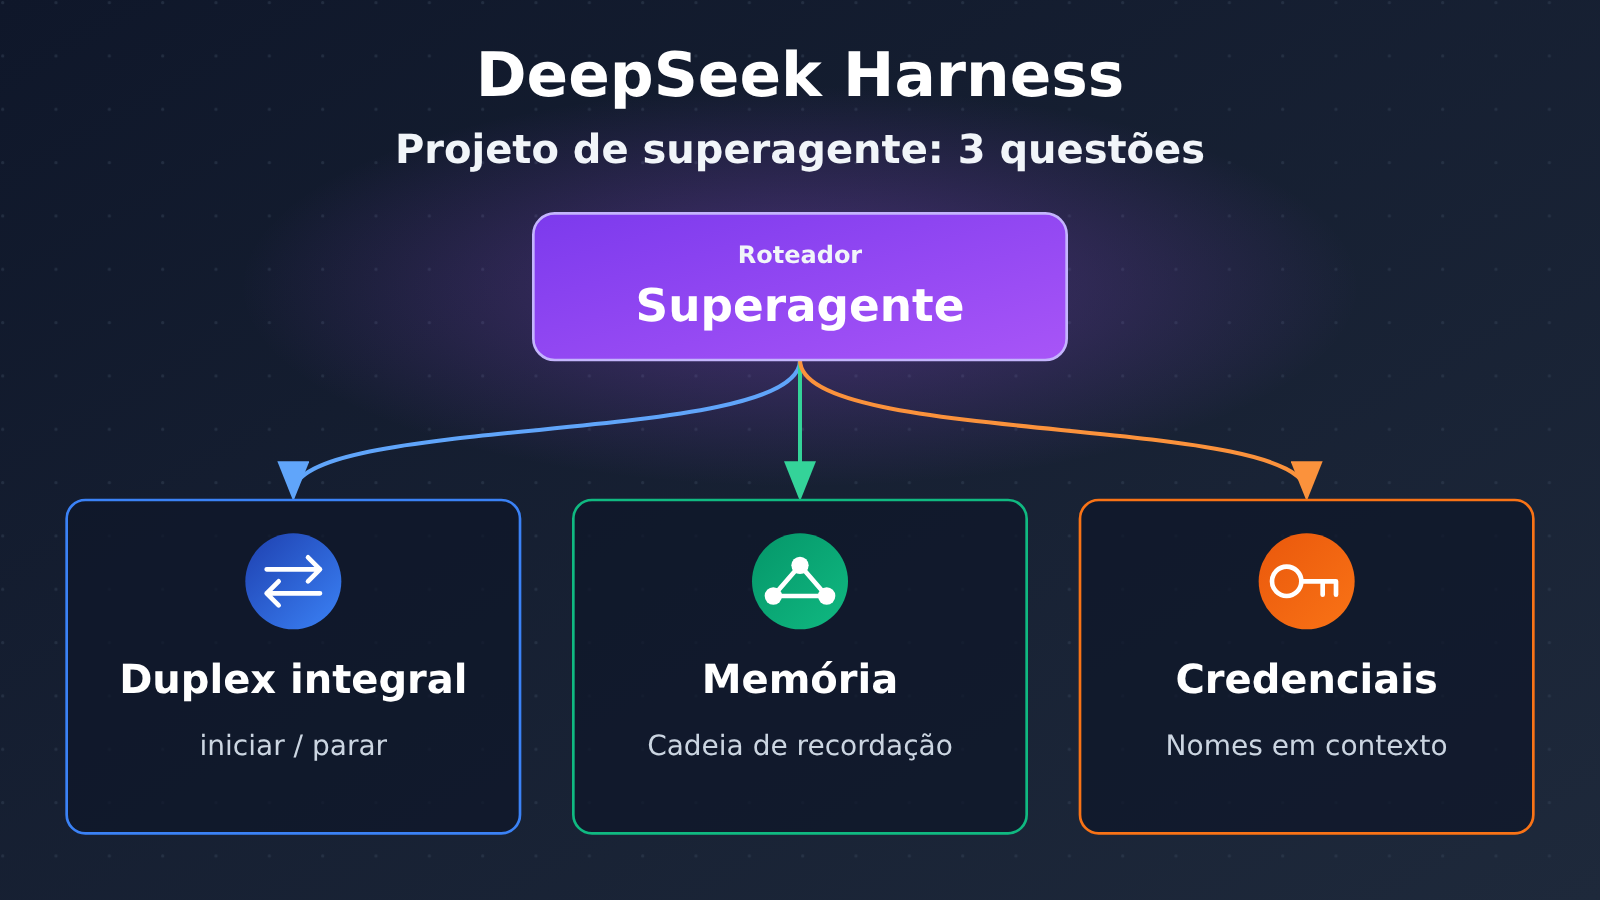
Primeiro, veja na tabela como os três problemas são tratados no texto original e o que já pode ser aproveitado.
| Problema de design | Ideia central no texto original | Status no original | O que pode ser aproveitado |
|---|---|---|---|
| Full-duplex | Dividir o run() bloqueante em start() e stop(), permitindo que o agente receba instruções enquanto trabalha |
Implementado, mas desativado por padrão | Contratos de ferramentas assíncronas, reinjeção de eventos e processamento em lote |
| Memória | Manter no contexto apenas IDs estáveis, resumos curtos e mensagens próximas; armazenar o restante fora do contexto com ponteiros e usar IDs para recuperação em múltiplas etapas | Memória de longo prazo listada como questão em aberto | IDs estáveis, inline/spill e recuperação exata por ID |
| Credenciais | O agente deve poder usar credenciais sem que elas entrem no seu contexto | Listado como questão em aberto | Padrões de engenharia que colocam os nomes no contexto e mantêm os valores fora dele |
Arquitetura geral do superagente DeepSeek Harness
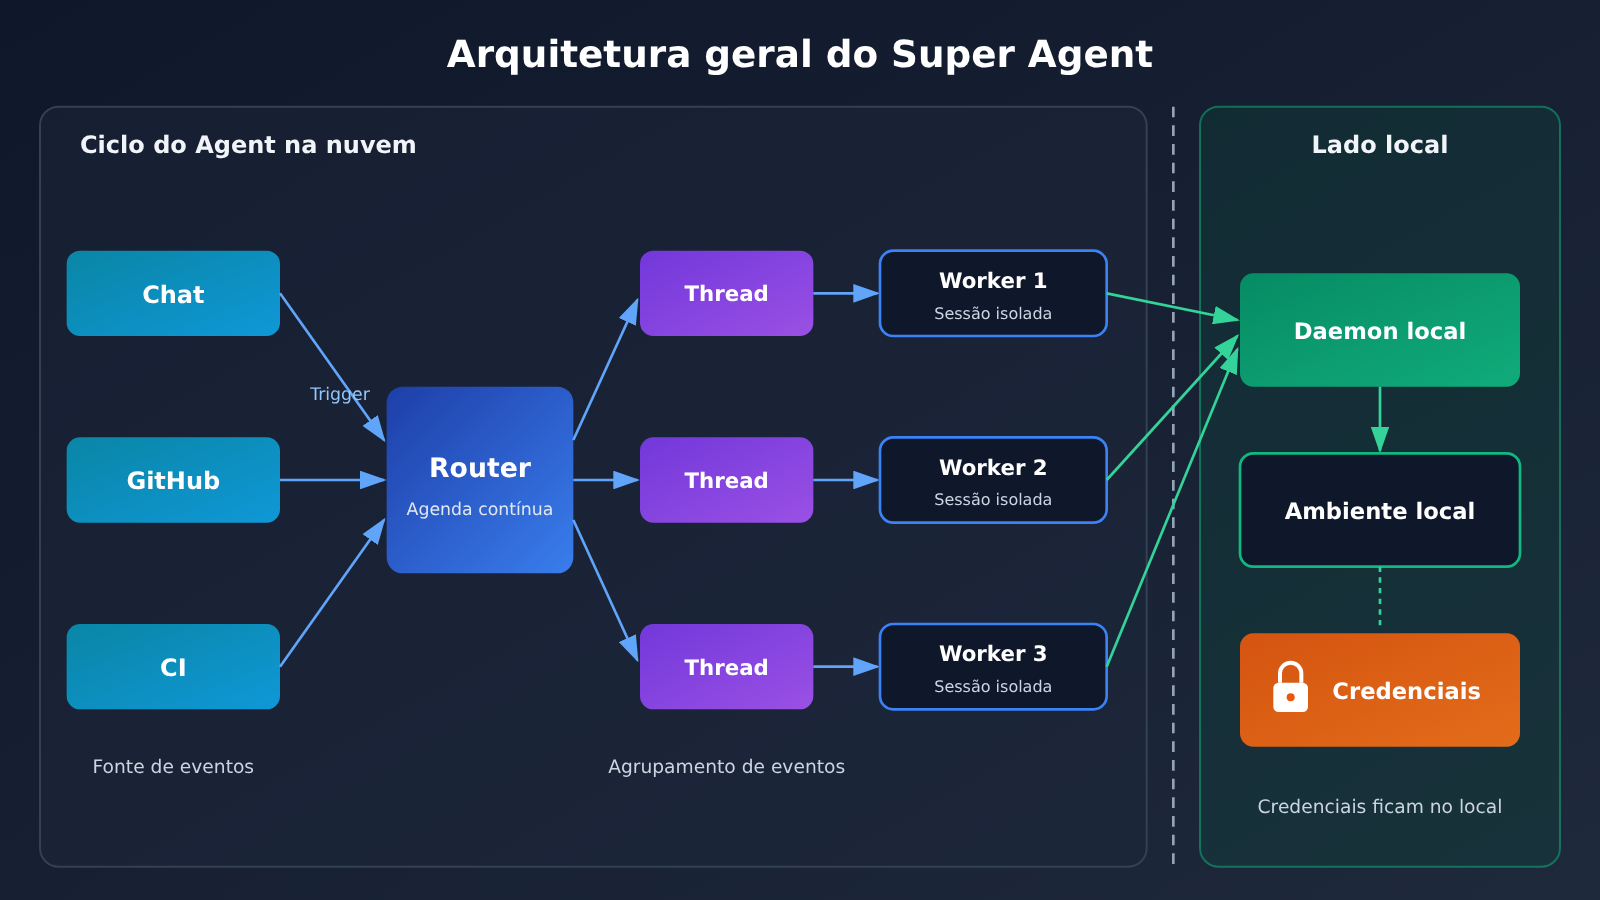
No texto original, o superagente é composto por Router e Worker. O Router é o ponto de entrada permanente para o encaminhamento de tarefas e monitora eventos de fontes como chat, GitHub e CI. Já o Worker é uma sessão isolada de agente, e cada Worker cuida de apenas uma tarefa. Cada evento que entra no sistema é chamado de Trigger. Uma sequência de eventos relacionados ao mesmo PR, tópico de mensagens instantâneas ou cadeia de e-mails é agrupada em uma Thread.
Essa arquitetura também tem uma característica importante de implantação: o ciclo do agente roda na nuvem, enquanto o ambiente de execução do usuário permanece na máquina local, conectado por um pequeno daemon. As credenciais também ficam no ambiente local. Os três problemas de design partem dessa premissa. Entendendo os quatro conceitos — Router, Worker, Trigger e Thread —, fica mais fácil acompanhar o design de full-duplex e memória.
Como aproveitar o design full-duplex do DeepSeek Harness
O full-duplex resolve o problema de “uma ferramenta lenta congelar o Agent inteiro”. Na abordagem tradicional, o Agent chama uma ferramenta e espera a resposta de forma síncrona. Uma consulta de 200 ms não é problema, mas uma execução de testes de 6 minutos traz três complicações: as latências das solicitações seguintes se acumulam; o Agent não consegue ouvir o usuário dizer “pule os testes e2e” no meio do processo; e o gateway pode encerrar conexões que ficam abertas por muito tempo, fazendo a chamada retornar um timeout mesmo quando o trabalho foi concluído.
O texto original chama o estado ideal de “productive”: o Agent já consegue receber a próxima instrução antes de concluir a anterior. Para isso, uma chamada bloqueante a run() é dividida em um conjunto de contratos menores: start() retorna imediatamente uma referência à tarefa, status() informa o progresso, stop() solicita o cancelamento e o resultado volta à conversa depois, na forma de um evento. A diferença está em quem espera: com run(), é o modelo; com start(), é o runtime.
O contrato assíncrono de ferramentas do full-duplex no DeepSeek Harness
Na definição das ferramentas, cada operação demorada oferece três ferramentas em vez de uma. No caso de testes, start_test_run retorna apenas job_id e o estado queued, sem dados da operação; get_job_status retorna um dos estados queued, running, done ou failed, junto de uma breve descrição do progresso; e stop_job solicita o cancelamento e retorna o estado efetivamente alcançado.
Duas regras ajudam a evitar que o modelo se desvie do comportamento esperado. Primeiro, a descrição da ferramenta deve deixar claro que ele não deve esperar pelo resultado; caso contrário, o modelo consultará get_job_status com frequência. Segundo, start nunca retorna dados da operação, para que o modelo não precise adivinhar qual estrutura recebeu. A API de tarefas por trás das ferramentas pode seguir o desenho da tabela abaixo. A RFC 9110 define 202 Accepted justamente como “a solicitação foi aceita para processamento, mas o processamento ainda não foi concluído”.
| Chamada | Resposta | Ferramenta correspondente |
|---|---|---|
POST /jobs (com o cabeçalho Idempotency-Key) |
202, retorna job_id e o estado queued, com Location apontando para /jobs/{id} |
start |
GET /jobs/{id} |
200, retorna queued / running / done / failed | status, listener de tarefas |
GET /jobs/{id}/result |
200 com o resultado quando concluída; 409 quando ainda não concluída | Ferramenta de obtenção de resultado |
DELETE /jobs/{id} |
202 indica que a solicitação de cancelamento foi aceita; chamadas posteriores retornam 404 ou 409 | stop |
| URL de callback opcional | Envia um POST ao chamador quando a tarefa é concluída | Listener de tarefas |
Retorno de resultados full-duplex e processamento em lote no DeepSeek Harness
O polling é apenas uma solução de contingência. Um projeto melhor é fazer com que o runtime monitore as tarefas e, quando elas terminarem, envie à conversa um breve evento de conclusão com o job_id, o status e um resumo de uma linha, como “412 passaram, 3 falharam”. O log completo fica disponível por meio da ferramenta de recuperação de resultados, evitando que um log de 40 mil linhas entre diretamente no contexto.
O texto original também descreve o processamento em lote do Router: os Triggers que chegam durante uma rodada de geração entram em uma fila e são combinados na próxima invocação do modelo. Essas chamadas têm entradas longas e saídas curtas, e a maior parte do custo está na etapa de prefill. Nos testes do texto original, quando a frequência de Triggers aumentou de 1 para 40 por minuto, o tamanho médio do lote subiu de 1,0 para 2,8, e o tempo por decisão caiu de 6,4 s para 1,6 s. São dados desses testes, não um benchmark universal, mas a ideia pode ser aplicada diretamente: durante a geração do modelo, eventos e mensagens do usuário entram na fila e, ao fim da rodada, são enviados juntos na ordem de chegada.
Detalhes de engenharia: ordenação, cancelamento e idempotência
Esses detalhes são fáceis de ignorar na fase de protótipo, mas também estão entre os que mais causam problemas em produção:
- Ordenação: a ordem de conclusão das tarefas não é fixa. Quando B depende de A, é preciso declarar essa dependência explicitamente: espere o evento de conclusão de A antes de iniciar B ou faça a API oferecer suporte a
depends_on. - Cancelamento:
stopé apenas uma solicitação e não garante que a tarefa será interrompida. Retorne o status real de encerramento: se a tarefa já tiver terminado antes do cancelamento, retornedonepara que o modelo informe o usuário corretamente. - Chave de idempotência: o modelo pode tentar novamente, e uma resposta perdida pode disparar um segundo
start. Exija umidempotency_keyem cadastarte retorne a tarefa existente quando a chave for repetida. Caso contrário, uma instrução como “executar a migração” pode ser executada duas vezes. - Resultados parciais e tempo limite: disponibilize a saída inicial por uma interface de resultados com cursor; defina um prazo para cada tarefa e emita um evento
job_timed_outquando ele for excedido.
Se sua ferramenta usa MCP, vale conhecer Tasks, uma extensão opcional da versão de 2026-07-28 da especificação MCP. O servidor pode responder à chamada da ferramenta com um resultado que contenha taskId; o cliente pode consultar o status via tasks/get ou escutar notifications/tasks e solicitar o cancelamento com tasks/cancel. A extensão precisa ser habilitada tanto no cliente quanto no servidor, e o suporte varia entre os hosts. Verifique a compatibilidade antes de usá-la.
Quando não é necessário usar operações assíncronas: quando a chamada retorna em um ou dois segundos, quando a próxima etapa precisa obrigatoriamente do resultado para começar ou quando não há uma API de tarefas de fato por trás. Se a ferramenta for bloqueante internamente, apenas apresentá-la como assíncrona vai aumentar a complexidade. Uma divisão prática é manter as operações de leitura bloqueantes e tornar assíncronos os cálculos e as operações de escrita mais demorados.
Como aproveitar o design de memória do DeepSeek Harness: Chain of Recall
Um Agent que executa tarefas por muito tempo acaba esbarrando no limite de contexto, já que novas demandas continuam chegando. As três soluções mais comuns têm seus custos: manter tudo enche a janela e aumenta o custo a cada rodada; usar resumos progressivos pode fazer o Agent perder erros específicos ou números de PR que serão necessários depois; e buscar por similaridade pode falhar quando o fato necessário e a consulta não se parecem na forma como foram escritos.
A ideia do artigo original é tratar o contexto como um cache, com apenas duas operações. Inline mantém o que o Agent provavelmente precisa naquele momento, incluindo IDs, resumos curtos e mensagens próximas. Spill cuida do restante: trunca o conteúdo e deixa um ponteiro para recuperá-lo quando necessário. O conteúdo movido para fora do contexto não é apagado; apenas deixa de aparecer por completo no comando, onde fica só o ponteiro. Por exemplo, para uma falha de CI, o contexto guarda apenas uma linha: “Falha de CI no PR #412: 3 dos 118 testes no diretório payments falharam”. Do log completo de 41 KB, fica apenas o caminho para recuperá-lo. Se o resumo for suficiente, o Agent não precisa pagar pelo processamento desses 41 KB.
IDs estáveis e grafo de referências no design de memória do DeepSeek Harness
Para o Chain of Recall funcionar, os IDs precisam ser permanentes. No artigo original, três tipos de objeto têm IDs:
| Objeto | Significado | Exemplo de ID | Relação |
|---|---|---|---|
| Trigger | Um evento que entra no sistema: mensagem de chat, Webhook ou callback de CI | trg_8f21 |
Pertence a uma Thread |
| Thread | Uma sequência de eventos relacionados ao mesmo PR, tópico de mensagens ou cadeia de e-mails | thr_pr_412 |
É atribuída a um ou mais Workers |
| Worker | Uma sessão isolada de Agent que cuida de uma única tarefa | wkr_77a0 |
Cita no relatório os Triggers que processou |
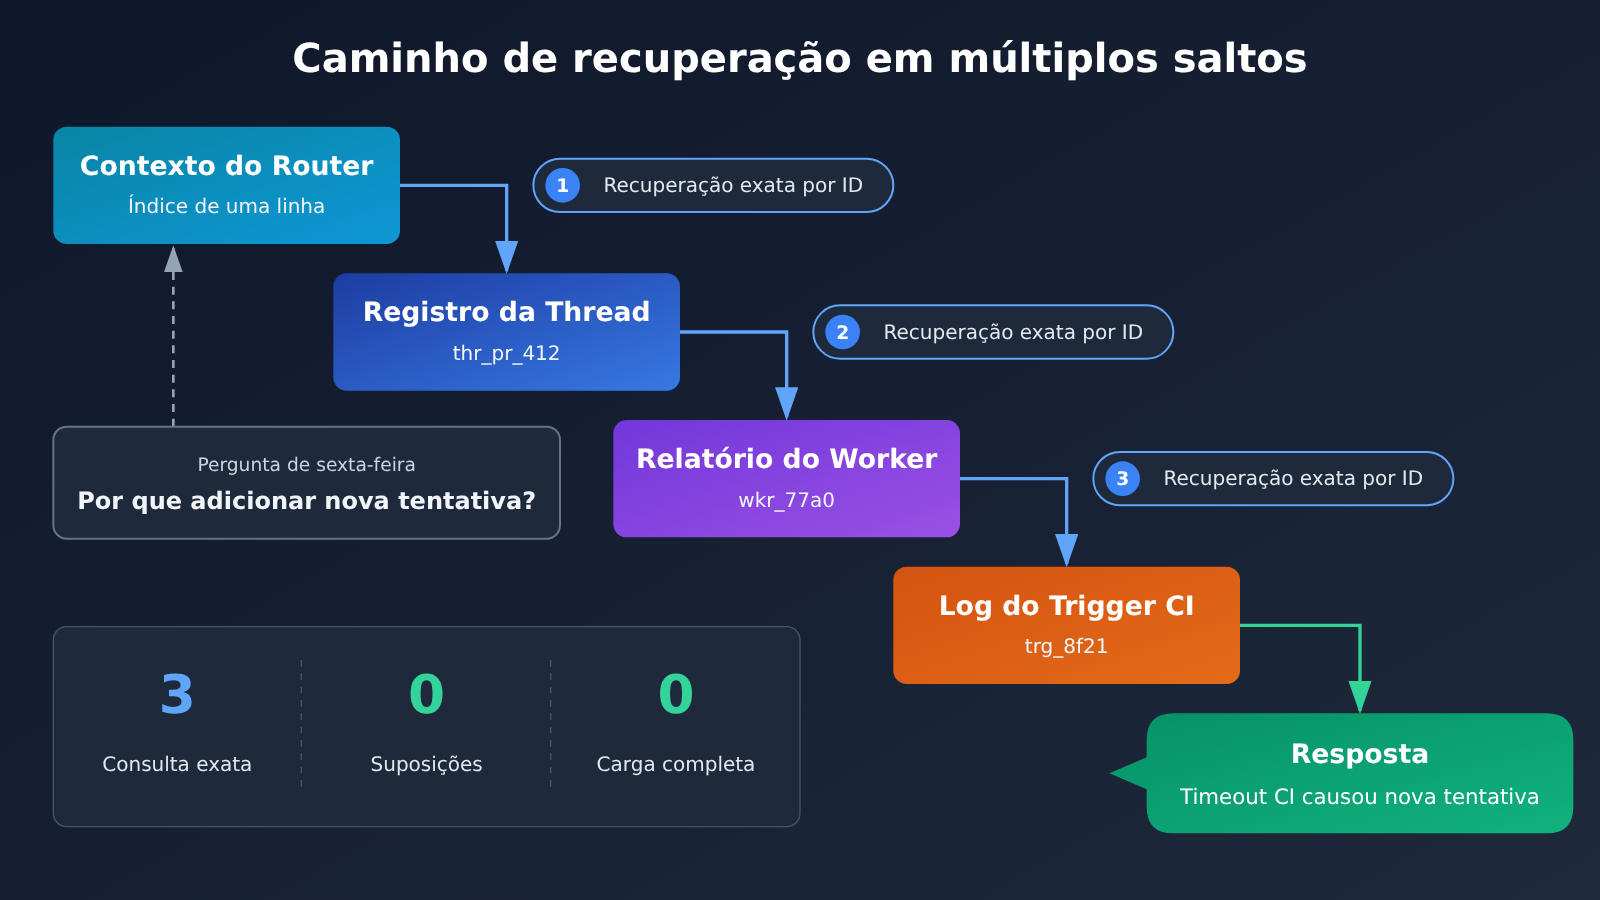
Essas relações formam um grafo de referências, que funciona como a memória do Agent. Na recuperação, ele percorre os links passo a passo, sem carregar todo o histórico nem buscar textos semelhantes. Por exemplo: na sexta-feira, alguém pergunta ao Router “por que adicionamos retentativas ao cliente de pagamentos?”, mas a discussão relevante aconteceu na terça-feira e já foi movida para fora do contexto. No primeiro passo, o Router usa uma linha de índice que ainda está no contexto para recuperar thr_pr_412. No segundo, lê no registro da Thread qual Worker era responsável por ela e recupera o relatório final desse Worker. No terceiro, encontra no relatório uma referência ao Trigger da falha de CI, recupera o log e identifica o erro de timeout. Com três consultas pequenas e precisas, chega à resposta sem precisar adivinhar.
As quatro garantias que a API de memória do DeepSeek Harness precisa cumprir
Cada etapa da cadeia de recuperação é uma chamada de API. Se alguma delas retornar um registro diferente ou não retornar nada, a cadeia se rompe: o agente fica travado ou tenta responder por conta própria. Por isso, a API precisa cumprir quatro garantias:
- IDs nunca mudam: um ID retornado hoje deve apontar para o mesmo objeto no mês que vem. Ele não pode ser reutilizado após a exclusão nem renumerado após uma migração.
- A recuperação por ID deve ser barata e exata:
GET /threads/{id}retorna apenas o registro solicitado, sem fazer buscas nem devolver a “correspondência mais próxima”. - IDs desconhecidos devem retornar uma falha explícita: a resposta deve ser 404, com um corpo de erro claro. Se retornar 200 com um objeto vazio, o agente vai achar que a memória existe.
- Paginação por cursor sem lacunas: Threads longas são paginadas em ordem, cada evento aparece uma única vez e o cursor continua válido mesmo quando novos eventos são adicionados.
Essas garantias podem ser quebradas sem que ninguém perceba durante uma refatoração. Por isso, vale transformá-las em testes automatizados e executá-los a cada merge.
Também é importante considerar duas limitações. Primeiro, Chain of Recall não substitui a busca vetorial: a busca vetorial responde “o que é semelhante a isto?”, enquanto Chain of Recall responde “o que está conectado a isto?”. Na prática, uma combinação comum é usar um índice vetorial para encontrar o ID da Thread inicial e, depois, seguir os links até chegar ao fato exato. Segundo, o número de “37%” no texto original se refere à passagem direta de Threads: ao remover esse recurso, os tokens de leitura de cache por execução aumentaram de 23.2M para 31.8M. Esse é o custo da ausência de um recurso, não uma economia proporcionada pelo próprio Chain of Recall. Não confunda os dois ao citar o dado.
Como aproveitar o design de credenciais do DeepSeek Harness: usar credenciais sem vê-las
O artigo original apresenta essa questão como um problema em aberto: se as credenciais entrarem no contexto do Agent, elas poderão vazar. Por isso, o Agent deve conseguir usá-las sem vê-las. Há quatro caminhos comuns de vazamento: ler o arquivo .env para investigar um problema; incluir cabeçalhos de requisição em texto puro em comandos de depuração ou executar echo para “confirmar que a variável está definida”; inserir valores reais na descrição de um PR, em comentários de Issues ou em fixtures de teste; e ser induzido por uma injeção de comando em uma página ou resposta de API a exibir variáveis de ambiente. A OWASP classifica a injeção de comando como o principal risco para aplicações com LLM e enquadra a exposição de credenciais como vazamento de informações sensíveis.
Todas as medidas de proteção seguem a mesma regra: no contexto entram apenas os nomes; os valores ficam fora do modelo. O contexto pode conter nomes de variáveis como STRIPE_KEY, referências a gerenciadores de segredos, placeholders como {{token}} ou valores mascarados. Não pode conter chaves reais, valores resolvidos nem linhas de log sem mascaramento. Se um valor real aparecer na conversa, faça a rotação da chave no mesmo dia: as conversas são registradas, armazenadas em cache e exportadas, e não há como recolher um token que já foi enviado.
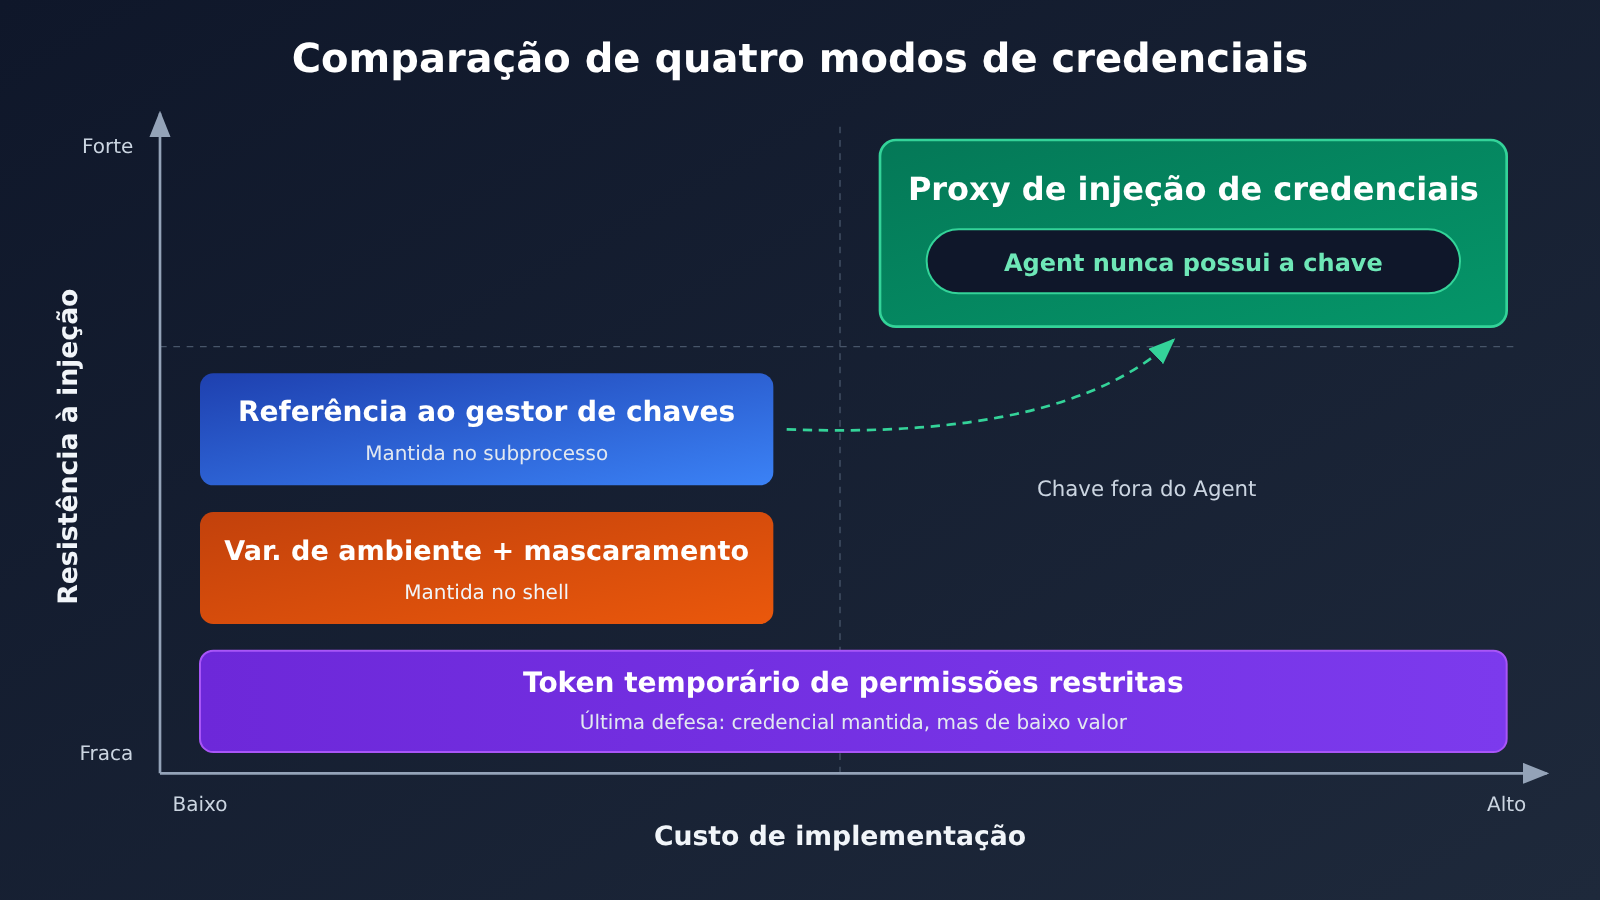
Quatro formas de lidar com credenciais no DeepSeek Harness
| Modelo | Como funciona | O agente tem acesso ao valor? | Principal limitação |
|---|---|---|---|
| Variáveis de ambiente + mascaramento | Use $NAME nos comandos para que o shell faça a expansão; proíba a leitura de .env; masque a saída antes de retorná-la |
O shell tem acesso | Evita erros acidentais, mas não impede a impressão deliberada após uma injeção |
| Referência a gerenciador de segredos | A configuração contém apenas uma referência como op://vault/item/field, resolvida pela CLI para o subprocesso em tempo de execução |
O subprocesso tem acesso | Mesmas limitações das variáveis de ambiente |
| Proxy de injeção de credenciais | O agente envia uma solicitação sem chave ao proxy local, que adiciona o cabeçalho de autenticação e encaminha a chamada conforme uma lista de permissões | Nunca tem acesso | É preciso implantar e manter o proxy separadamente |
| Tokens de curta duração e permissões restritas | Cada sessão recebe um token que expira em poucos minutos e permite executar apenas uma tarefa | Tem acesso, mas o token tem pouco valor | É apenas uma medida de contenção; o token ainda pode ser usado indevidamente enquanto estiver válido |
Dos quatro modelos, só o proxy de injeção de credenciais garante que o agente não tenha acesso à chave. A lista de permissões do proxy é tão importante quanto a injeção: por exemplo, permita GET /v1/charges e rejeite DELETE /v1/customers. Mesmo que o agente sofra uma injeção, ele só poderá executar as chamadas aprovadas e não conseguirá levar a chave. Execute o proxy com um usuário ou contêiner separado para impedir que o agente leia sua configuração. Isso segue a abordagem de implantação do texto original: as credenciais permanecem no ambiente local.
Se o agente invoca o modelo pela APIYI, a mesma abordagem pode ser aplicada à chave do modelo: o proxy injeta a chave ao encaminhar a solicitação para a APIYI, enquanto o agente só sabe que deve usar o proxy local. Assim, mesmo que o histórico da conversa seja exportado, ele não conterá uma chave APIYI utilizável. Consulte a documentação em docs.apiyi.com para saber o endereço de acesso e o método de autenticação.
A última camada é o mascaramento. Nas saídas das ferramentas, nos logs de CI e nas sessões salvas, masque os valores com prefixos conhecidos, incluindo sk_live_, ghp_, github_pat_, AKIA e xoxb-. Masque também os valores de todos os cabeçalhos Authorization e X-API-Key, além dos valores específicos injetados na sessão. Basta uma linha sem mascaramento para comprometer todas as proteções anteriores.
Primeiros passos com o design de Harness do DeepSeek: checklist de implementação e escolha de modelos
Você não precisa resolver os três problemas de design de uma só vez. Em ordem de custo-benefício, a sequência recomendada é:
- Comece pela proteção das credenciais: impeça que o Agent leia o arquivo
.env, registre emCLAUDE.mdouAGENTS.mdque “nenhuma variável terminada em_KEY,_TOKENou_SECRETdeve ser impressa” e adicione um filtro para ocultar dados sensíveis na saída. Essa etapa leva meio dia e traz benefícios imediatos. - Depois, torne as ferramentas lentas assíncronas: comece por ferramentas de teste, build e deploy que costumam levar mais de alguns segundos. Divida as operações em start / status / stop e adicione chaves de idempotência e prazos.
- Em seguida, estabeleça IDs estáveis: atribua IDs imutáveis a eventos, threads de sessão e subtarefas. Mantenha no contexto apenas o ID e um resumo de uma linha; armazene conteúdos extensos fora do contexto e deixe um ponteiro.
- Por último, implemente um proxy de injeção e tokens de curta duração: implante um proxy para APIs de terceiros, configure uma lista de permissões e emita um token independente para cada sessão do Agent.
Na escolha dos modelos, o Router recebe entradas longas, produz saídas curtas e precisa tomar decisões em lote com frequência. Por isso, modelos baratos, rápidos e com baixo custo de leitura de cache são uma boa opção. Já o Worker escreve código e faz raciocínios complexos, então precisa de um modelo mais capaz. Os preços da tabela foram extraídos da página de preços da APIYI, docs.apiyi.com/models. Para os critérios de cobrança e os valores mais recentes, consulte os dados atualizados na página; este artigo não faz outras promessas de preços.
| Modelo (nome na APIYI) | Preço de entrada | Preço de saída | Preço do cache | Papel recomendado | Plataforma disponível |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Decisões em lote e resumos de eventos do Router | APIYI apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | Worker para programação no dia a dia | APIYI apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | Worker para contextos longos e tarefas com documentos | APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | Worker para refatorações complexas e decisões críticas | APIYI apiyi.com |
Vale destacar que os experimentos do texto original com processamento em lote e passagem de Threads enfatizam o volume de tokens lidos do cache. Como a maior parte dos custos do Router está no prefill e na leitura do cache, o preço do cache costuma merecer mais atenção do que o preço de saída na escolha do modelo.
🚀 Comece rapidamente: a APIYI oferece acesso aos modelos da tabela via API e é compatível com os formatos de interface da OpenAI e da Anthropic. O Router pode usar o formato OpenAI para acessar o deepseek-v4.1-flash, enquanto o Worker usa o formato Anthropic para acessar o claude-sonnet-5-5. Ambos podem ser gerenciados pela mesma conta. Consulte as instruções de integração na documentação da APIYI, em docs.apiyi.com, e os preços em docs.apiyi.com/models.
Perguntas frequentes (FAQ)
Q1: O que é “Exploring Super-agent Design”, do DeepSeek Harness?
É um artigo detalhado sobre arquitetura publicado pela equipe do DeepSeek Harness em 2026-11-01. Ele discute como projetar um superagente que permanece ativo e monitora várias fontes de eventos ao mesmo tempo. O texto descreve uma arquitetura, não uma funcionalidade lançada oficialmente. Parte do conteúdo está no plugin de protótipo `dsh-superagent-prototype`, que, segundo o autor, não é um produto oficial da DeepSeek.
Q2: Qual é a diferença entre full-duplex e chamadas paralelas de ferramentas?
Nas chamadas paralelas, várias ferramentas são executadas ao mesmo tempo em uma rodada, mas o modelo ainda precisa esperar todas retornarem. Com full-duplex, as chamadas assíncronas retornam um identificador imediatamente, e os resultados chegam como eventos em rodadas posteriores. Enquanto espera, o modelo pode continuar a conversa, receber novas instruções e iniciar novas tarefas.
Q3: Dá para ativar o Chain of Recall diretamente? Ele substitui o RAG?
Não em ambos os casos. Chain of Recall é um padrão de projeto apresentado no texto original, sem uma opção pronta para ativá-lo. É preciso implementar IDs estáveis e uma interface para recuperar dados por ID. Ele e o RAG resolvem problemas diferentes: o RAG encontra conteúdo semelhante, enquanto o Chain of Recall recupera informações seguindo links exatos. Em projetos reais, normalmente se usa primeiro a busca vetorial para encontrar um ponto de partida e, depois, seguem-se os links por ID até os fatos específicos. O texto original também apresenta a memória de longo prazo como uma questão em aberto, sem afirmar que o Chain of Recall já a resolveu.
Q4: Para quais cenários esses três problemas de projeto são mais relevantes?
– **Full-duplex**: tarefas como testes, builds, rastreamento, renderização e deploy, que costumam levar mais de alguns segundos e durante as quais o usuário continua conversando com o agente.
– **Memória**: históricos formados por eventos distintos e vinculáveis, como PRs, tickets, registros de execução de CI, conversas de atendimento e registros de lançamentos.
– **Credenciais**: agentes de programação e de operações que precisam chamar APIs de terceiros pagas ou sensíveis.
Q5: Como integrar rapidamente modelos diferentes ao Router e ao Worker?
Uma opção mais prática é usar uma plataforma compatível com os formatos de API da OpenAI e da Anthropic para centralizar a integração. Depois de se cadastrar em APIYI apiyi.com, obtenha uma chave API e informe o nome do modelo correspondente no Router e no Worker para alternar entre eles. Consulte a documentação da APIYI em docs.apiyi.com para conferir o endereço de integração. Antes de entrar em produção, vale testar a qualidade das decisões de deepseek-v4.1-flash e claude-sonnet-5-5 usando o mesmo conjunto de eventos reais e, então, definir a divisão de tarefas.
Q6: Onde conferir os modelos ou preços mencionados no texto original?
Para os preços dos modelos abordados neste artigo, consulte sempre os dados atualizados na página de preços da APIYI, em docs.apiyi.com/models. Os valores do texto original e de materiais de terceiros servem apenas como referência para comparação. Se um modelo não aparecer nessa página, significa que a APIYI ainda não o disponibilizou. Ele será disponibilizado assim que possível e, quando isso acontecer, consulte a página de preços.
Q7: Quais são as limitações conhecidas dessas abordagens?
O modo full-duplex precisa de uma API de tarefas de verdade. Uma “pseudoassincronia” criada em torno de uma implementação bloqueante só aumenta a complexidade. O Chain of Recall não encontra conteúdo sem links estabelecidos, e o contrato de IDs pode ser comprometido durante migrações e refatorações. Quanto às credenciais, nem variáveis de ambiente nem referências a segredos impedem que um agente comprometido imprima seus valores deliberadamente. Só um proxy de injeção permite que o Agent não tenha acesso aos valores; tokens de curta duração servem apenas como alternativa de segurança. O próprio artigo original apresenta memória e credenciais como questões em aberto.
Principais pontos do design do Super Agent com DeepSeek Harness
- Proposta do artigo: é um artigo sobre design de arquitetura; o modo full-duplex vem desativado por padrão, e o plug-in protótipo não é um produto oficial.
- Full-duplex: usa start / status / stop no lugar de um run bloqueante. Os resultados retornam como eventos e são agrupados em lotes.
- Contrato da API de tarefas: aceite com status 202, deduplicação por chave de idempotência, cancelamento que retorna o estado real e prazo limite para cada tarefa.
- Design de memória: o contexto contém apenas IDs estáveis e resumos curtos; o restante fica fora dele, com ponteiros para acesso. Na recuperação, o sistema percorre os links entre IDs em múltiplas etapas.
- Contrato da API de memória: IDs imutáveis, recuperação exata, retorno de 404 para IDs desconhecidos e paginação por cursor sem lacunas.
- Princípio para credenciais: os nomes entram no contexto, mas os valores ficam fora. Prefira um proxy de injeção, use tokens de curta duração como alternativa e remova dados sensíveis de todos os logs.
- Divisão entre modelos: o Router usa um modelo barato e com baixo custo de cache; o Worker usa um modelo mais capaz. É possível comparar os dois com uma única conta na APIYI.
Resumo
Há mais ideias em Super Agent Design, do DeepSeek Harness, que podem ser aproveitadas diretamente do que sua condição de “protótipo” sugere:
- Full duplex: contratos de ferramentas assíncronas e reinserção de eventos são práticas de engenharia consolidadas. É possível testar a API de tarefas antes de integrá-la ao Agent.
- Memória: IDs estáveis combinados com inline/spill são a forma de menor custo para dar memória precisa a um Agent orientado a eventos, mas não substituem a busca vetorial.
- Credenciais: a regra “o nome entra no contexto, o valor fica de fora” já pode ser aplicada hoje. Um proxy de injeção é a única solução que impede o Agent de ter acesso às chaves.
Vale começar pela higiene das credenciais e pela execução assíncrona de ferramentas lentas, deixando os IDs estáveis e o proxy de injeção para uma segunda etapa. Quando for necessário combinar modelos diferentes para Router e Worker, você pode testá-los pela APIYI apiyi.com, usando uma interface unificada compatível com os formatos OpenAI e Anthropic. Consulte os preços em docs.apiyi.com/models.
📚 Referências
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory: explicação do projeto de memória Chain of Recall
- Link:
apidog.com/blog/chain-of-recall-ai-agent-memory -
Descrição: inclui IDs estáveis, inline/spill, exemplos de recuperação em múltiplas etapas e quatro contratos de API
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run(): explicação do projeto de ferramentas assíncronas full duplex
- Link:
apidog.com/blog/async-tool-calls-ai-agents -
Descrição: inclui o contrato start/status/stop, dados de experimentos em lote e uma explicação da extensão MCP Tasks
-
How to Let AI Agents Use API Keys Without Seeing Them: práticas de segurança de credenciais para Agents
- Link:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
Descrição: inclui quatro padrões de credenciais, caminhos de vazamento e uma lista de verificação para mascaramento de dados
-
Documentação e página de preços da APIYI: instruções de acesso e dados de cobrança dos modelos abordados neste artigo
- Links:
docs.apiyi.comedocs.apiyi.com/models - Descrição: consulte essas páginas para conferir nomes de modelos, formatos de interface e preços atualizados
Autor: Equipe técnica da APIYI
Discussões técnicas: para dúvidas sobre a escolha da arquitetura de Agents e a integração de vários modelos, entre em contato pela página inicial da APIYI em apiyi.com. Mais informações estão disponíveis na central de documentação em docs.apiyi.com.


