
作者注:拆解 DeepSeek Harness《超级 Agent 设计》中的全双工、记忆、凭据三个设计问题,说明哪些做法现在就能借鉴、哪些仍是“开放问题”,并给出接口契约与落地清单。
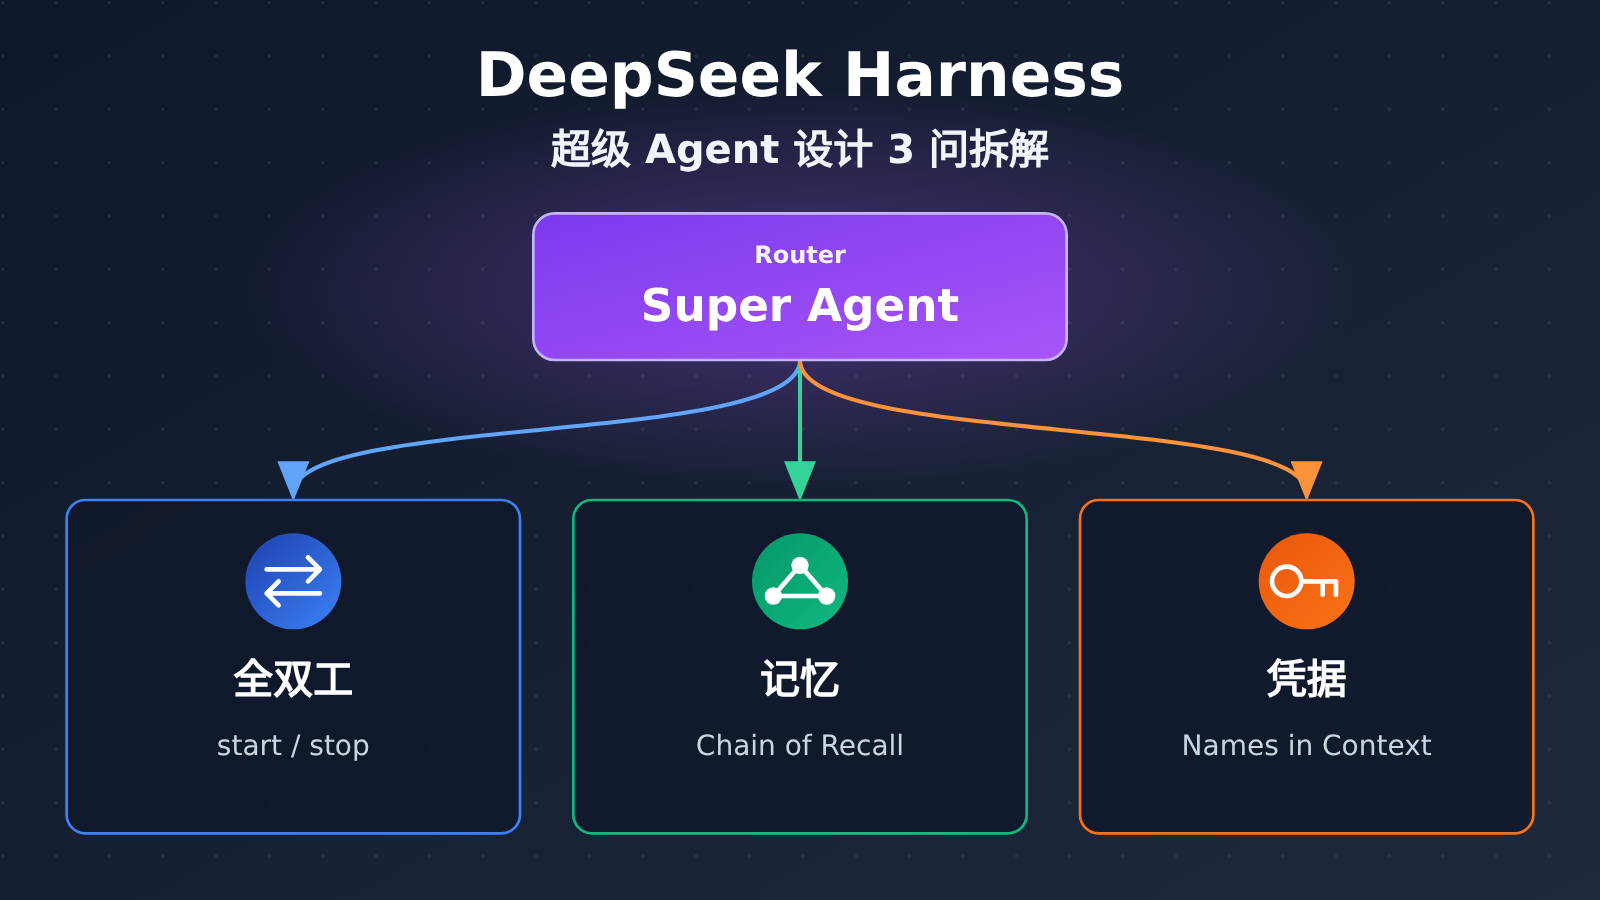
一个长时间运行的 Agent 往往会同时卡在三件事上。跑测试的 6 分钟里,用户的新问题只能排队;昨天的上下文被今天的事件挤出窗口;调试时它顺手打开了 .env,密钥就进了对话记录。2026-11-01,DeepSeek Harness 团队发布设计长文 “Exploring Super-agent Design”,把这三个问题分别概括为 全双工(full-duplex)、记忆(Chain of Recall)和“使用凭据但看不到凭据”。
这不是一篇产品发布解读。原文描述的是一套架构,不是可以直接打开的开关:全双工已在 DeepSeek Harness 中实现但默认关闭,部分内容放在原型插件 dsh-superagent-prototype 里,作者明确说明它“不是 DeepSeek 官方产品”。长期记忆和凭据问题,原文也列在开放问题里。
核心价值:读完本文,你会知道这三个设计问题里哪些可以照搬,每一项背后的 API 需要满足哪些契约,以及在自己的 Agent 项目里先做哪一步。
DeepSeek Harness 超级 Agent 设计核心要点
先用一张表看清三个问题在原文里的定位,以及哪些现在就能借鉴。
| 设计问题 | 原文的核心思路 | 原文状态 | 可直接借鉴的部分 |
|---|---|---|---|
| 全双工 | 把阻塞的 run() 拆成 start() 和 stop(),Agent 在工作期间仍能接收指令 |
已实现但默认关闭 | 异步工具契约、事件回注、批处理 |
| 记忆 | 上下文只放稳定 ID、短摘要和邻近消息,其余内容溢出并留指针,靠 ID 链接多跳召回 | 长期记忆列为开放问题 | 稳定 ID、inline/spill、按 ID 精确取回 |
| 凭据 | Agent 应该能使用凭据,但凭据不进入它的上下文 | 列为开放问题 | 名字进上下文、值留在外部的一组工程模式 |
DeepSeek Harness 超级 Agent 的整体架构
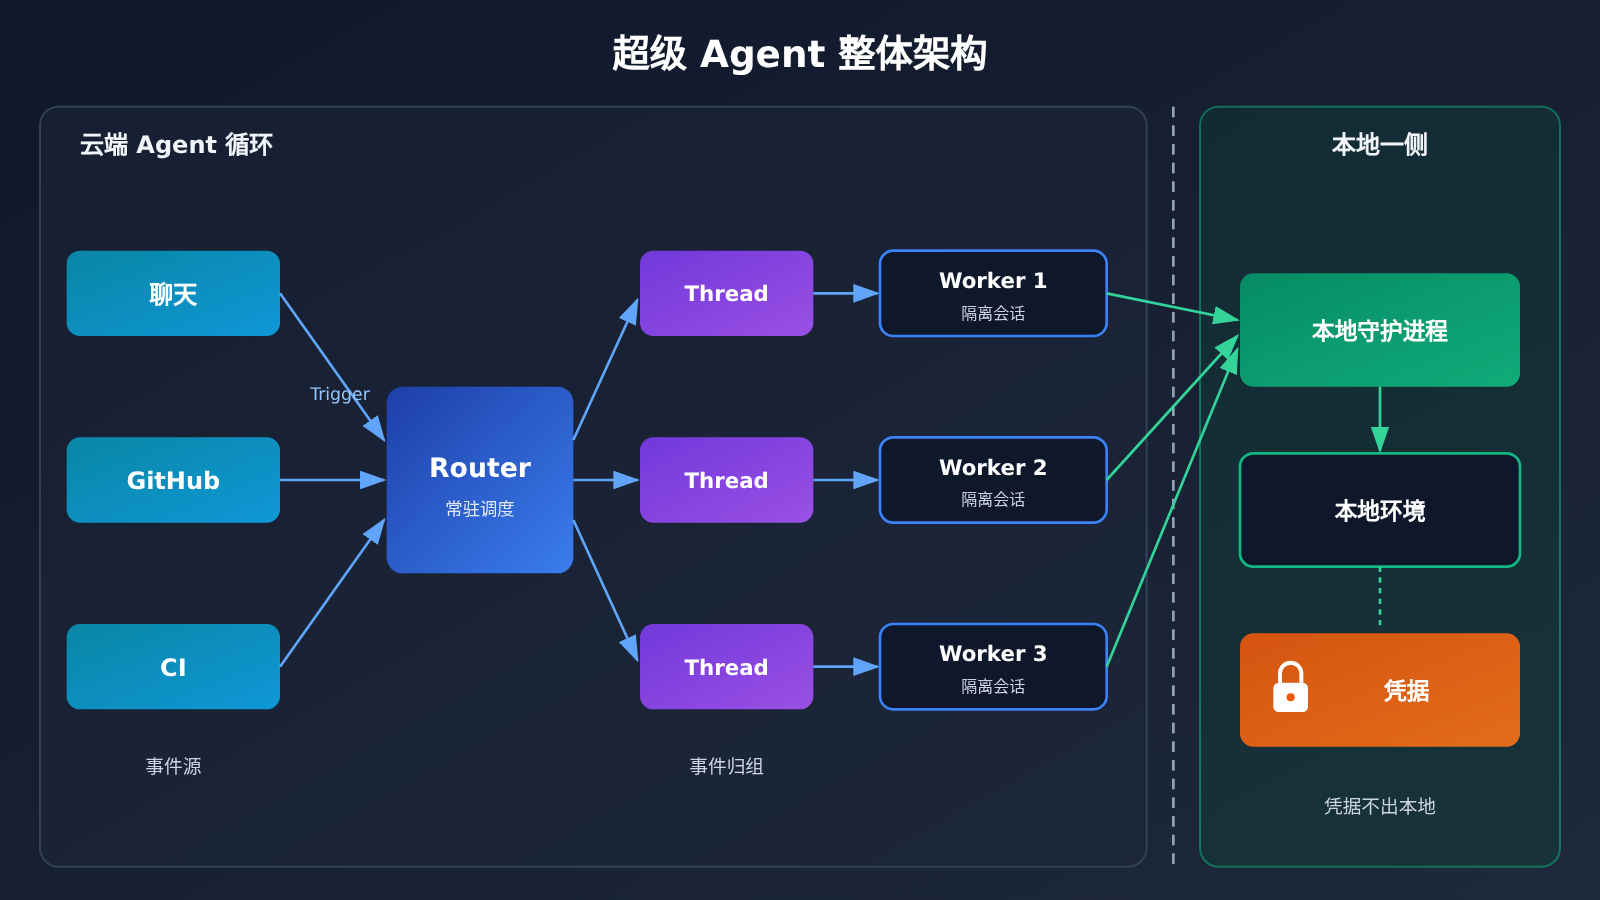
原文里的超级 Agent 由 Router 和 Worker 组成。Router 是常驻的调度入口,同时监听聊天、GitHub、CI 等来源的事件;Worker 是隔离的 Agent 会话,一个 Worker 只处理一个任务。每条进入系统的事件叫 Trigger,同一个 PR、同一个 IM 话题或同一封邮件链上的一串相关事件归为一个 Thread。
这套架构还有一个部署上的特点:Agent 循环跑在云端,用户自己的执行环境留在本机,由一个小型守护进程负责对接,凭据也跟着环境留在本地。三个设计问题都建立在这个前提上。理解了 Router、Worker、Trigger、Thread 这四个概念,后面的全双工和记忆设计就比较好读了。
如何借鉴 DeepSeek Harness 全双工设计
全双工要解决的是“一个慢工具冻结整个 Agent”。传统做法是调用工具后同步等待,一次 200 ms 的查询无所谓,一次 6 分钟的测试运行就会带来三个问题:后续请求的延迟层层叠加;用户中途说“跳过 e2e 测试”时 Agent 听不到;网关会断开长时间挂起的连接,工作明明成功了,调用却报超时。
原文把理想状态称为“productive”,也就是上一条指令还没完成,Agent 已经能接下一条。实现方式是把一个阻塞的 run() 拆成一组小契约:start() 立刻返回任务句柄,status() 汇报进度,stop() 发起取消,结果在之后以事件形式回到对话中。区别在于由谁等待:用 run() 时是模型在等,用 start() 时是运行时在等。
DeepSeek Harness 全双工的异步工具契约
落到工具定义上,每个长耗时能力对外提供三个工具,而不是一个。以测试为例,start_test_run 只返回 job_id 和 queued 状态,不返回任何业务数据;get_job_status 返回 queued、running、done、failed 之一和一句进度说明;stop_job 发起取消,并返回实际到达的状态。
有两条规则能避免模型行为跑偏。第一,工具描述里要写明“不要等待结果”,否则模型会频繁轮询 get_job_status。第二,start 永远不返回数据,否则模型需要猜这次拿到的是哪种结构。工具背后的任务 API 可以参考下表设计,RFC 9110 对 202 Accepted 的定义正好是“请求已接受处理,但处理尚未完成”。
| 调用 | 响应 | 对应的工具 |
|---|---|---|
POST /jobs(带 Idempotency-Key 请求头) |
202,返回 job_id 和 queued 状态,Location 指向 /jobs/{id} |
start |
GET /jobs/{id} |
200,返回 queued / running / done / failed | status、任务监听器 |
GET /jobs/{id}/result |
完成时 200 返回结果,未完成时 409 | 结果获取工具 |
DELETE /jobs/{id} |
202 表示取消请求已受理,之后再调用返回 404 或 409 | stop |
| 可选回调 URL | 任务完成时向调用方 POST | 任务监听器 |
DeepSeek Harness 全双工的结果回注与批处理
轮询只是兜底方案。更好的设计是由运行时监听任务,完成后往对话里推一条简短的完成事件,内容包括 job_id、状态和一行摘要,例如“412 通过,3 失败”。完整日志放在结果获取工具后面,这样四万行的日志不会直接进入上下文。
原文还描述了 Router 的批处理:一轮生成期间到达的 Trigger 先排队,合并进下一次模型调用。这类调用输入长、输出短,大部分开销落在 prefill 阶段。原文实验中,Trigger 频率从每分钟 1 个提高到 40 个时,平均批大小从 1.0 升到 2.8,单次决策耗时从 6.4 s 降到 1.6 s。这是原文自己的测试数据,不是通用基准,但思路可以直接用:模型生成期间,事件和用户消息先排队,本轮结束后按到达顺序一起送入。
排序、取消与幂等的工程细节
这几处细节在原型阶段最容易被忽略,上线后又最容易出事故:
- 排序:任务完成顺序不固定。B 依赖 A 时要显式表达依赖关系,要么等 A 的完成事件到达后再启动 B,要么让 API 支持
depends_on。 - 取消:
stop只是请求,不能保证一定生效。要返回真实的结束状态,如果任务在取消前已经完成,应如实返回done,让模型照实转告用户。 - 幂等键:模型会重试,响应丢失可能触发第二次
start。每次start都要求带idempotency_key,重复的键返回已存在的任务,否则一句“执行迁移”可能被执行两次。 - 部分结果与超时:通过带游标的结果接口提供早期输出;每个任务都设截止时间,超时后发出
job_timed_out事件。
如果你的工具走 MCP,可以关注 MCP 规范 2026-07-28 版本中的可选扩展 Tasks。服务端可以用带 taskId 的结果响应工具调用,客户端通过 tasks/get 轮询,或者监听 notifications/tasks,用 tasks/cancel 发起取消。这个扩展需要客户端和服务端都主动启用,各宿主的支持程度也不一样,使用前要先确认。
什么时候不必用异步:调用一两秒内就能返回、下一步必须拿到结果才能开始、或者背后没有真正的任务 API。如果工具内部其实是阻塞的,对外包装成异步只会增加复杂度。比较实用的划分是:读操作保持阻塞,耗时较长的写操作和计算改成异步。
如何借鉴 DeepSeek Harness 记忆设计:Chain of Recall
长时间运行的 Agent 迟早会撞上上下文上限,因为新的工作一直在进来。常见的三种应对各有代价:全部保留,窗口会满,成本随轮次上涨;滚动摘要,会丢掉之后需要的具体报错或 PR 编号;按相似度检索,一旦需要的事实和查询语句字面上不像,就找不到。
原文的思路是把上下文当作缓存,只做两种操作。Inline 放 Agent 眼下最可能用到的内容,包括 ID、短摘要和邻近消息。Spill 处理其余内容,截断后留一个指针,之后需要时按指针取回。被溢出的内容并没有删除,只是在 prompt 里只剩指针。比如一条 CI 失败事件,上下文里只留“PR #412 的 CI 失败,payments 目录下 118 个测试中 3 个变红”这样一行摘要,41 KB 的完整日志只保留取回路径。如果摘要够用,Agent 就不用为这 41 KB 付费。
DeepSeek Harness 记忆设计中的稳定 ID 与引用图
Chain of Recall 成立的前提是 ID 永远不变。原文中有三类对象带 ID:
| 对象 | 含义 | 示例 ID | 链接关系 |
|---|---|---|---|
| Trigger | 一条进入系统的事件:聊天消息、Webhook、CI 回调 | trg_8f21 |
属于某个 Thread |
| Thread | 同一 PR、IM 话题或邮件链上的一串相关事件 | thr_pr_412 |
由一个或多个 Worker 持有 |
| Worker | 一个处理单一任务的隔离 Agent 会话 | wkr_77a0 |
报告中引用它处理过的 Trigger |
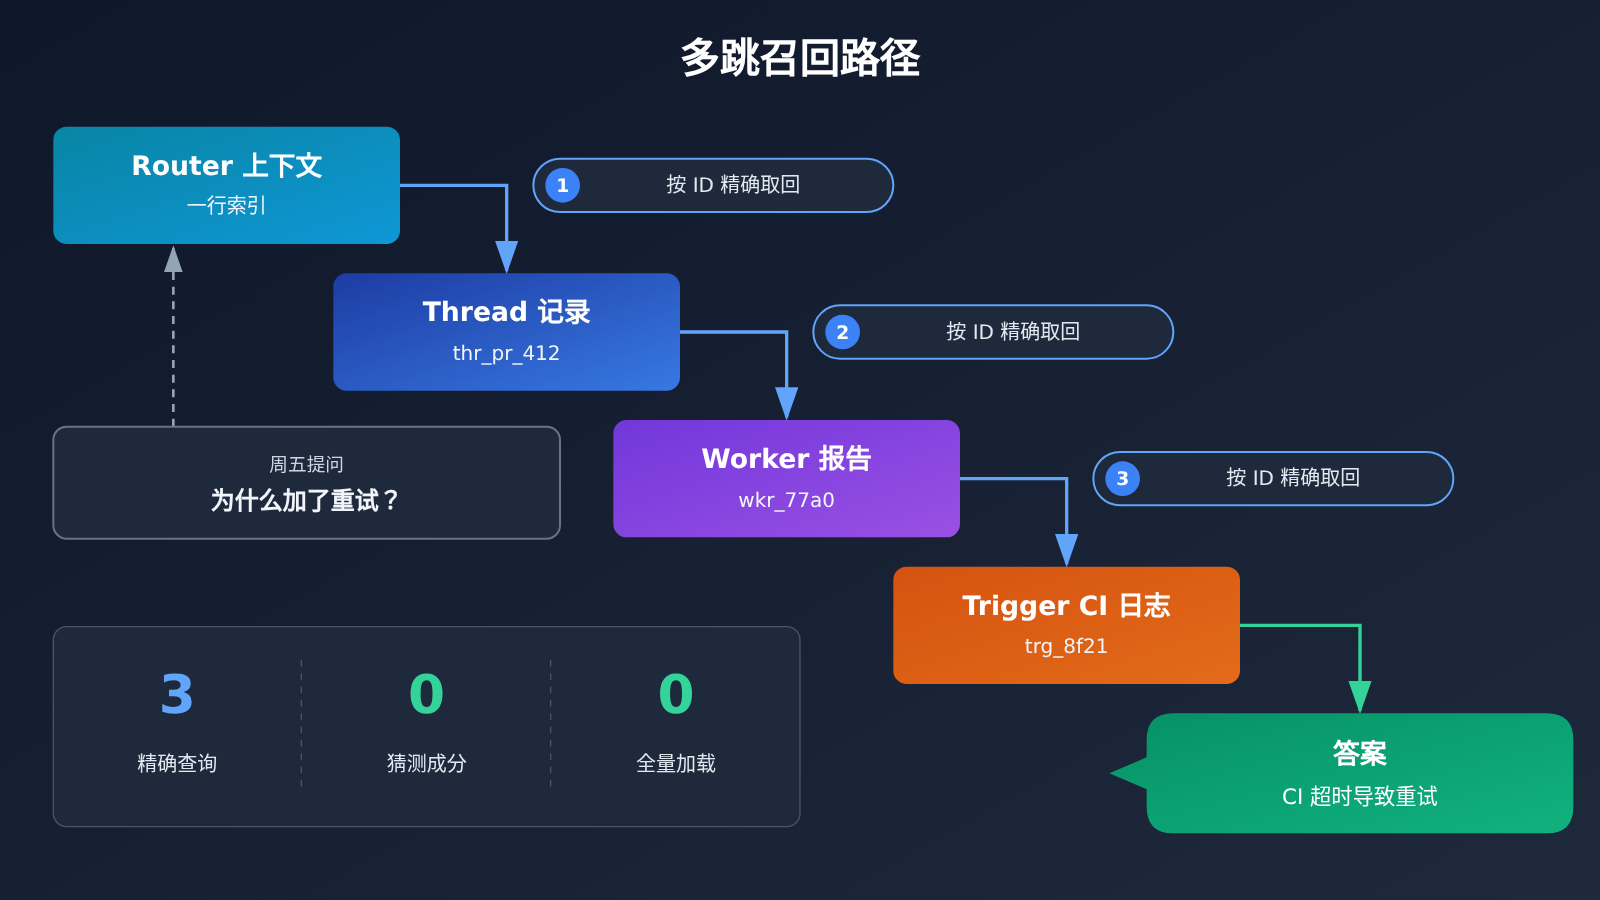
这些链接组成一张引用图,这张图就是 Agent 的记忆。召回时沿链接一跳一跳地走,不加载全部历史,也不做相似文本搜索。举个例子:周五有人问 Router“为什么给支付客户端加了重试”,而相关讨论发生在周二,早已溢出。第一跳,Router 用上下文里仍保留的一行索引取回 thr_pr_412;第二跳,从 Thread 记录里读到持有它的 Worker,取回该 Worker 的最终报告;第三跳,报告里引用了 CI 失败的 Trigger,取回其日志,看到超时报错。三次精确的小查询,答案没有任何猜测成分。
DeepSeek Harness 记忆 API 必须满足的四条契约
召回链里的每一跳都是一次 API 调用,任何一次返回了不同的记录或者没有返回,链条就会断,Agent 要么卡住,要么靠猜来回答。所以底层 API 必须满足四条契约:
- ID 永不变化:今天返回的 ID 下个月必须解析到同一个对象,删除后不复用,迁移后不重新编号。
- 按 ID 取回要便宜且精确:
GET /threads/{id}只返回这一条记录,不做搜索,也不返回“最接近的匹配”。 - 未知 ID 要明确失败:返回 404 和清晰的错误体。如果返回 200 加空对象,Agent 会以为这段记忆存在。
- 游标分页无缺口:长 Thread 按顺序分页,每个事件只出现一次,有新事件写入时游标依然有效。
这些契约在重构时很容易被悄悄破坏,应该写成自动化测试,在每次合并时运行。
要客观看待两点限制。第一,Chain of Recall 不能替代向量检索:向量检索回答“什么和这个相似”,Chain of Recall 回答“什么和这个有链接”,实际项目中常见的组合是先用向量索引找到起始 Thread ID,再沿链接走到精确事实。第二,原文中“37%”这个数字说的是 Thread 透传:去掉透传后,每次运行的缓存读取 token 从 23.2M 涨到 31.8M。这是缺少某个功能的代价,不是 Chain of Recall 本身带来的节省,引用时不要混淆。
如何借鉴 DeepSeek Harness 凭据设计:用凭据但看不到凭据
原文把这个问题列为开放问题:凭据进入 Agent 上下文就可能泄露,所以 Agent 应该能使用凭据,却看不到凭据。常见的泄露路径有四种:为了排查故障读取 .env;在调试命令里写出明文请求头,或者执行 echo 来“确认变量已设置”;把真实值写进 PR 描述、Issue 评论或测试夹具;被网页或接口响应里的提示注入诱导,打印出环境变量。OWASP 把提示注入列为 LLM 应用的首要风险,并把凭据暴露归在敏感信息泄露一类。
所有防护手段都遵循同一条规则:上下文里只放名字,值留在模型外部。上下文可以出现变量名 STRIPE_KEY、密钥管理器引用、{{token}} 这类占位符,或者打了掩码的值;不能出现真实密钥、解析后的值和未脱敏的日志行。一旦真实值出现在对话里,当天就要轮换这个密钥,因为对话记录会被记录、缓存和导出,发出去的 token 没法撤回。
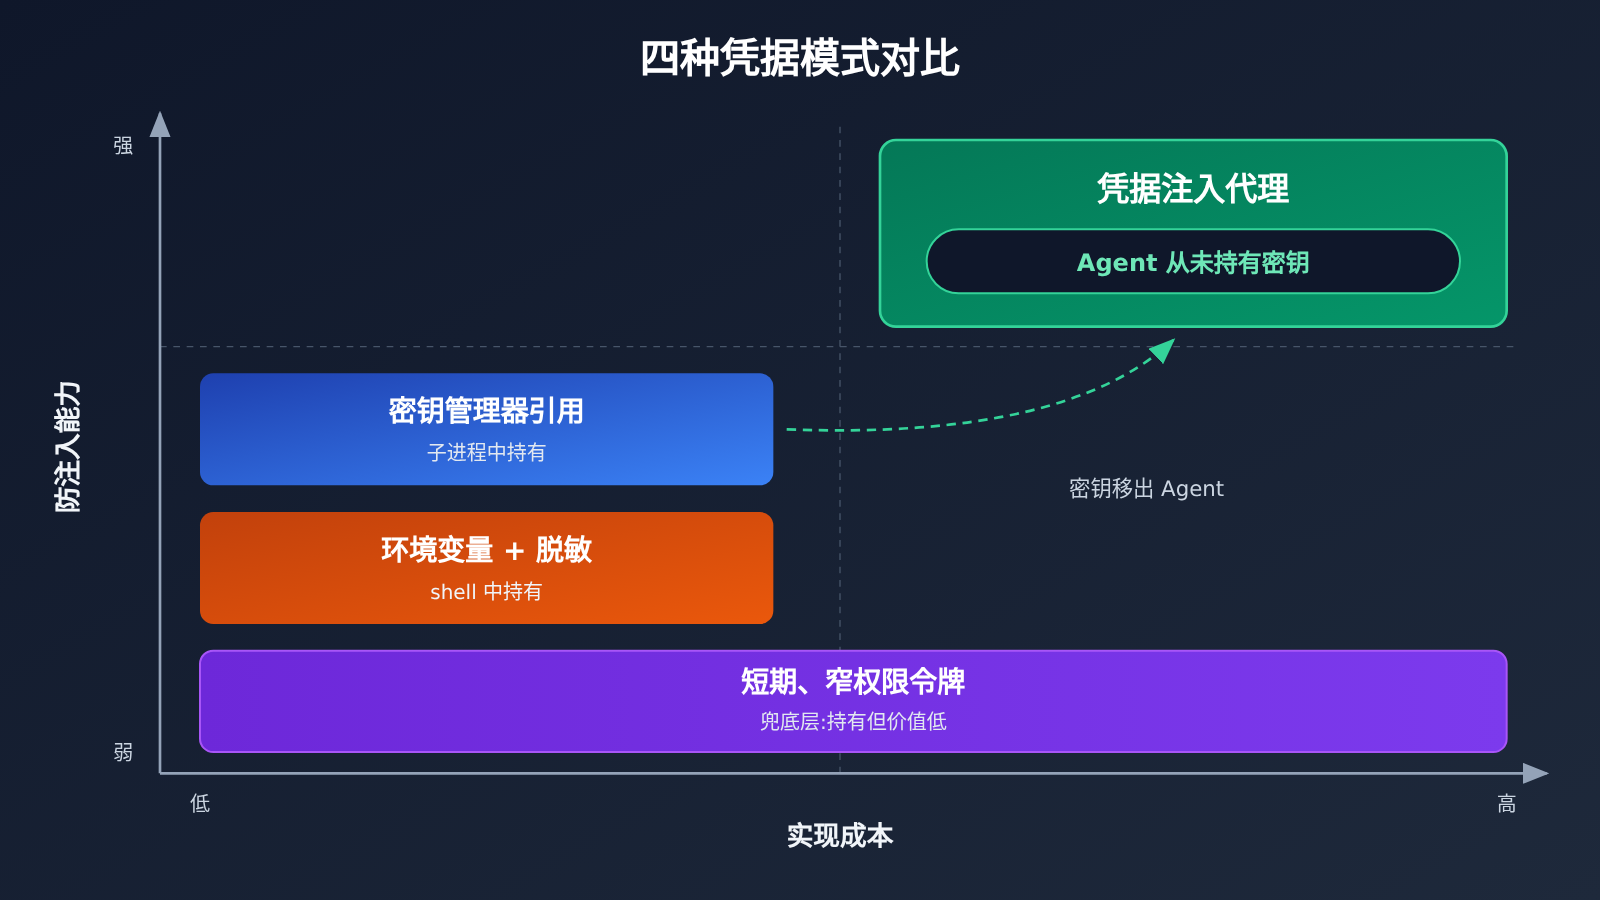
DeepSeek Harness 凭据问题的四种落地模式
| 模式 | 做法 | Agent 是否持有值 | 主要局限 |
|---|---|---|---|
| 环境变量 + 脱敏 | 命令里写 $NAME,由 shell 展开;禁止读取 .env;输出回传前做掩码 |
shell 中持有 | 能防误操作,防不住被注入后的主动打印 |
| 密钥管理器引用 | 配置里只放类似 op://vault/item/field 的引用,运行时由 CLI 解析进子进程 |
子进程中持有 | 局限与环境变量相同 |
| 凭据注入代理 | Agent 不带密钥请求本地代理,代理加上认证头,并按白名单转发 | 从不持有 | 需要单独部署和维护代理 |
| 短期、窄权限令牌 | 每个会话签发一个几分钟到期、只做一件事的令牌 | 持有,但价值很低 | 只是兜底,有效期内仍可能被滥用 |
在这四种模式中,只有凭据注入代理能真正让 Agent 不持有密钥。代理的白名单和注入同样重要:例如允许 GET /v1/charges,拒绝 DELETE /v1/customers。即使 Agent 被注入,它也只能执行你批准过的调用,而且没法把密钥带走。代理要以独立用户或独立容器运行,防止 Agent 读到它的配置。这和原文的部署思路一致:凭据跟环境一起留在本地。
如果你的 Agent 通过 API易 调用模型,同样的思路可以用在模型密钥上:让代理在转发到 API易 时注入密钥,Agent 一侧只知道“走本地代理”。这样即使对话记录被导出,里面也不会有可用的 API易 Key。具体的接入地址和认证方式请以 API易 文档 docs.apiyi.com 为准。
最后一层是脱敏。工具输出、CI 日志和保存下来的会话都要对已知前缀做掩码,包括 sk_live_、ghp_、github_pat_、AKIA、xoxb-,以及所有 Authorization 和 X-API-Key 请求头的值,还有本次会话中注入过的具体值。只要有一行没脱敏,前面所有防护都白做了。
DeepSeek Harness 设计快速上手:落地清单与模型选型
三个设计问题不必一次做完。按投入产出比排序,建议的落地顺序如下:
- 先做凭据卫生:禁止 Agent 读取
.env,在CLAUDE.md或AGENTS.md中写明“不打印任何以_KEY、_TOKEN、_SECRET结尾的变量”,给输出加脱敏过滤。这一步半天就能完成,收益立刻可见。 - 再给慢工具改异步:先挑测试、构建、部署这类经常超过几秒的工具,按 start / status / stop 拆分,补上幂等键和截止时间。
- 然后建立稳定 ID:给事件、会话线程、子任务统一分配不可变 ID,上下文中只保留 ID 加一行摘要,大段内容一律溢出并留指针。
- 最后上注入代理和短期令牌:针对第三方 API 部署代理并配置白名单,每个 Agent 会话签发一个独立令牌。
模型选型上,Router 的特点是输入长、输出短,并且要频繁做批量决策,适合便宜、快速、缓存命中价格低的模型;Worker 负责写代码、做复杂推理,适合能力更强的模型。下表价格摘自 API易 价格页 docs.apiyi.com/models,计费口径和最新单价以页面实时数据为准,本文不作其他报价承诺。
| 模型(API易 模型名) | 输入单价 | 输出单价 | 缓存价格 | 建议角色 | 可用平台 |
|---|---|---|---|---|---|
| deepseek-v4.1-flash | $0.3 | $1.2 | $0.006 | Router 批量决策、事件摘要 | API易 apiyi.com |
| claude-sonnet-5-5 | $2 | $10 | $0.1 | 日常编码 Worker | API易 apiyi.com |
| kimi-k3.1-pro | $2 | $10 | $0.2 | 长上下文 Worker、文档类任务 | API易 apiyi.com |
| claude-opus-5-5 | $4 | $20 | $0.2 | 复杂重构、关键决策 Worker | API易 apiyi.com |
需要说明的是,原文的批处理和 Thread 透传实验都强调缓存读取 token 的规模。Router 侧大部分开销落在 prefill 和缓存读取上,所以选型时,缓存价格往往比输出单价更值得看。
🚀 快速开始:API易 提供上表模型的 API 调用,同时兼容 OpenAI 与 Anthropic 两种接口格式。Router 用 OpenAI 格式接 deepseek-v4.1-flash,Worker 用 Anthropic 格式接 claude-sonnet-5-5,两边可以共用一个账号统一管理。接入说明见 API易 文档 docs.apiyi.com,价格以 docs.apiyi.com/models 为准。
常见问题 FAQ
Q1: DeepSeek Harness《超级 Agent 设计》是什么?
这是 DeepSeek Harness 团队在 2026-11-01 发布的设计长文 “Exploring Super-agent Design”,讨论一个常驻、同时监听多个事件源的超级 Agent 应该怎么设计。它描述的是架构,不是正式发布的功能,部分内容放在原型插件 `dsh-superagent-prototype` 中,作者说明它不是 DeepSeek 官方产品。
Q2: 全双工和并行工具调用有什么区别?
并行工具调用是在一轮里同时执行多个工具,模型仍然要等它们全部返回。全双工下的异步工具调用会立刻返回句柄,结果在之后的轮次中以事件形式到达,模型在等待期间可以继续对话、接收新指令、启动新任务。
Q3: Chain of Recall 可以直接开启吗?它能替代 RAG 吗?
都不能。Chain of Recall 是原文中的一个设计模式,没有开关可开,需要自己实现稳定 ID 和按 ID 取回的接口。它和 RAG 解决的问题不同:RAG 找相似内容,Chain of Recall 沿精确链接取回。实际项目中通常先用向量检索找到起点,再沿 ID 链接走到具体事实。原文也把长期记忆列为开放问题,没有说 Chain of Recall 已经解决了它。
Q4: 这三个设计问题最适合哪些应用场景?
– **全双工**:测试、构建、爬取、渲染、部署这类经常超过几秒的任务,并且用户会在任务运行时继续和 Agent 对话。
– **记忆**:由离散、可链接事件组成的历史,例如 PR、工单、CI 运行记录、客服会话、发布记录。
– **凭据**:需要调用付费或敏感第三方 API 的编码 Agent 和运维 Agent。
Q5: 如何快速为 Router 和 Worker 接入不同的模型?
比较省事的做法是用一个同时兼容 OpenAI 和 Anthropic 接口格式的平台统一接入。在 API易 apiyi.com 注册后获取 API Key,Router 和 Worker 分别填对应的模型名即可切换,接入地址以 API易 文档 docs.apiyi.com 为准。上线前建议用同一批真实事件分别测试 deepseek-v4.1-flash 和 claude-sonnet-5-5 的决策质量,再确定分工。
Q6: 原文提到的模型或价格在哪里核对?
本文涉及的模型价格一律以 API易 价格页 docs.apiyi.com/models 的实时数据为准,原文和第三方材料中的数字只作为对照引用。如果某个模型在该价格页查不到,就表示 API易 目前暂未上线该模型,我们会尽快上线,届时以价格页为准。
Q7: 这些做法有哪些已知限制?
全双工需要真正的任务 API 支撑,用阻塞实现包装出来的“伪异步”只会增加复杂度。Chain of Recall 找不到没有建立链接的内容,ID 契约在迁移和重构时容易被破坏。在凭据方面,环境变量和密钥引用都防不住被注入后主动打印的情况,只有注入代理能让 Agent 完全不持有值,短期令牌只能作为兜底。原文自己也把记忆和凭据列为开放问题。
DeepSeek Harness 超级 Agent 设计核心要点 Key Takeaways
- 原文定位:这是一篇架构设计文章,全双工默认关闭,原型插件不是官方产品。
- 全双工:用 start / status / stop 替代阻塞的 run,结果以事件形式回注,并按批次合并。
- 任务 API 契约:202 受理、幂等键去重、取消返回真实状态、给每个任务设截止时间。
- 记忆设计:上下文只放稳定 ID 和短摘要,其余溢出留指针,召回时沿 ID 链接多跳取回。
- 记忆 API 契约:ID 不变、精确取回、未知 ID 返回 404、游标分页无缺口。
- 凭据原则:名字进上下文、值留在外部,优先使用注入代理,短期令牌兜底,日志全量脱敏。
- 模型分工:Router 选便宜且缓存价低的模型,Worker 选能力强的模型,可在 API易 用一个账号对比测试。
总结
DeepSeek Harness《超级 Agent 设计》中可以直接借鉴的内容,比它的“原型”身份看上去要多:
- 全双工:异步工具契约和事件回注是成熟的工程做法,背后的任务 API 可以先写测试再接入 Agent。
- 记忆:稳定 ID 加 inline/spill,是给事件型 Agent 做精确记忆成本最低的方式,但它不能替代向量检索。
- 凭据:“名字进上下文、值留在外部”这条规则今天就能执行,注入代理是唯一让 Agent 完全不持有密钥的方案。
建议从凭据卫生和慢工具异步化做起,稳定 ID 和注入代理放到第二阶段。需要为 Router 和 Worker 搭配不同模型时,可以通过 API易 apiyi.com 用兼容 OpenAI 与 Anthropic 格式的统一接口做实测,价格以 docs.apiyi.com/models 为准。
📚 参考资料
- What Is Chain of Recall? How Stable IDs Give AI Agents Memory:Chain of Recall 记忆设计解读
- 链接:
apidog.com/blog/chain-of-recall-ai-agent-memory -
说明:包含稳定 ID、inline/spill、多跳召回示例和四条 API 契约
-
Async Tool Calls for AI Agents: Why start() Beats a Blocking run():全双工异步工具设计解读
- 链接:
apidog.com/blog/async-tool-calls-ai-agents -
说明:包含 start/status/stop 契约、批处理实验数据和 MCP Tasks 扩展说明
-
How to Let AI Agents Use API Keys Without Seeing Them:Agent 凭据安全实践
- 链接:
apidog.com/blog/ai-agents-use-api-keys-without-seeing-them -
说明:包含四种凭据模式、泄露路径和脱敏清单
-
API易 文档与价格页:本文涉及模型的接入说明与计费数据
- 链接:
docs.apiyi.com与docs.apiyi.com/models - 说明:模型名、接口格式和实时价格以此为准
作者:APIYI 技术团队
技术交流:Agent 架构选型和多模型接入的问题,欢迎通过 API易 apiyi.com 首页联系我们,更多资料见 docs.apiyi.com 文档中心


