
Autorhinweis: Dieser Artikel stützt sich auf den offiziellen Forschungsbeitrag, in dem mehrere Kopien von Claude Fable 5.2 zwei Aufgaben zur Physik Schwarzer Löcher gelöst haben, und fasst daraus praktische Vorgehensweisen für anspruchsvolle Agent-Aufgaben zusammen – bei der Modellauswahl, der Aufteilung von Rollen und dem Setzen von Stopplinien.
Am 17. November 2026 veröffentlichte Anthropic einen Forschungsbeitrag: Mehrere Kopien von Claude Fable 5.2 liefen rund sechs Wochen im Hintergrund und erledigten zwei Aufgaben zur Physik Schwarzer Löcher. Für Entwickler, die lang laufende Multi-Agent-Aufgaben ausführen, ist daran nicht die Physik interessant. Interessant ist vielmehr, dass hier eine Arbeitsweise gezeigt wird, die über lange Zeit läuft, mehrere Pfade parallel verfolgt und sich gegenseitig überprüft.
Dies ist kein populärwissenschaftlicher Physikartikel und er sagt dir auch nicht, welche API stabiler ist. Dieser Artikel tut nur eines: Er übersetzt die verwertbaren Engineering-Signale aus dem Forschungsbeitrag in Schritte, die du beim Ausführen anspruchsvoller Agent-Aufgaben selbst befolgen kannst.
Der Kernnutzen: Nach diesem Artikel weißt du, wie du Hauptinferenz und Überprüfung auf verschiedene Rollen aufteilst, für jeden Agentenpfad klare Stopplinien festlegst und nur unter Modellen mit klar ausgewiesenen Preisen in der Modelltabelle auswählst – sodass die Kosten langer Aufgaben vorhersehbar und nach oben begrenzt sind.
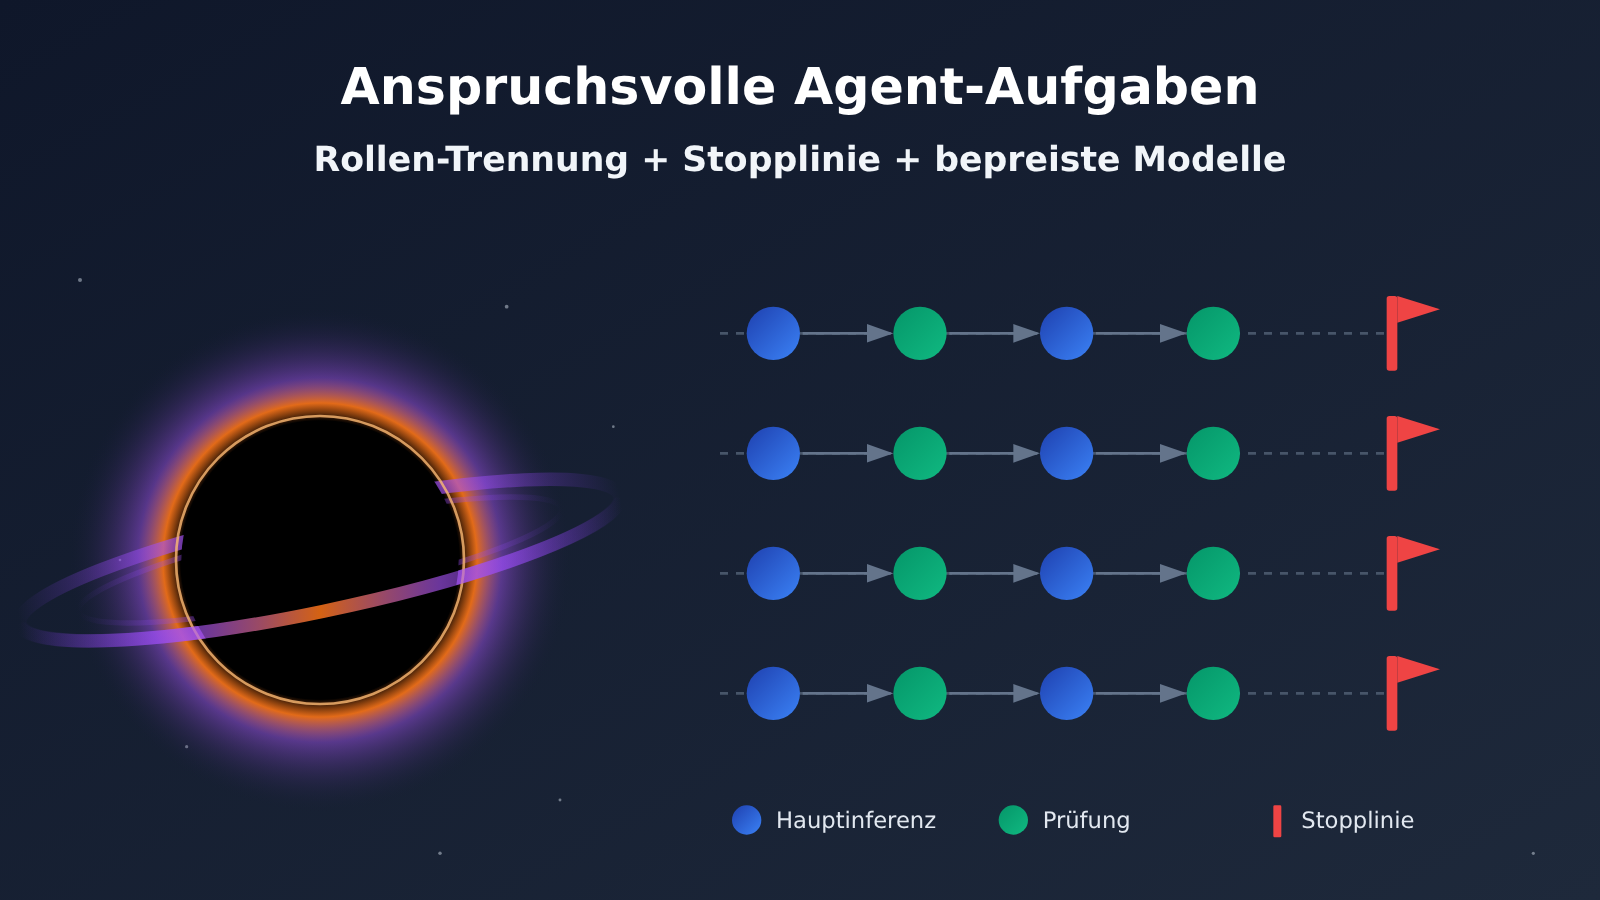
Was ein Research-Post zu Claude Fable 5.2 über die Kernpunkte schwerer Agent-Aufgaben verrät
Zuerst ein paar Sätze zum Hintergrund. Bei dem Post handelt es sich um eine offizielle Selbstbeschreibung von Anthropic; die beiden erwähnten Paper sind derzeit Preprints und noch keine peer-reviewten Arbeiten. Beide Aufgaben stammen aus der theoretischen Physik, beschreiben nicht unser Universum und haben keinen praktischen Nutzen – der Wert liegt also vor allem in der „Methode“, nicht darin, „wie wichtig die Ergebnisse sind“.
Laut Post bat der Forscher Hongbin Chen im August 2026 Claude, offene Fragen aus dem Bereich Schwarze Löcher und Bootstrap aufzulisten – nach wenigen Stunden kamen 22 Fragen zurück. Jeder Frage wurde ein eigener Agent zugewiesen, die Agenten konnten den Fortschritt der jeweils anderen lesen, und dann lief das Ganze etwa sechs Wochen im Hintergrund. Im Post heißt es wörtlich „ohne besondere Konfiguration“, aber das ist die offizielle Beschreibung des Aufbaus und bedeutet nicht, dass es nichts gekostet hat – eine Kostenaufstellung liefert der Post jedenfalls nicht.
| Fakt aus dem Research-Post | Implikation für schwere Agent-Aufgaben | Was du tun kannst |
|---|---|---|
| Ein Agent pro Frage, Agenten können den Fortschritt der anderen lesen | Die Granularität der Aufgabenzerlegung muss klar sein, der gemeinsame Zustand lesbar | Jede Teilaufgabe bekommt einen eigenen Agenten, der Fortschritt wird in einen gemeinsamen Speicher geschrieben |
| Fast jeder Schritt wird von zwei Agenten unabhängig ausgeführt und dann gegen die Literatur abgeglichen | Kritische Schritte brauchen eine unabhängige Gegenprüfung | Hauptschlussfolgerung und Prüfung auf zwei Rollen aufteilen |
| Frühe Agenten haben parallel 61 Versuche gemacht und es nicht hinbekommen | Scheitern ist normal, Scheitern braucht eine Obergrenze | Für jeden Pfad maximale Fehlversuche und Budget klar festlegen |
| Ergebnisse werden per Lean-Formalisierung verifiziert und von Physikern geprüft | Maschinelle Ergebnisse brauchen am Ende eine externe Validierung | Einen Schritt für manuelle oder toolgestützte Verifikation einplanen |
| Lief etwa sechs Wochen im Hintergrund | Bei langen Aufgaben summieren sich die Kosten | Anhand der Modellpreistabelle vorab schätzen und eine Kostenobergrenze setzen |
Was die beiden Aufgaben der aufwendigen Agent-Arbeit jeweils zeigen
Bei der ersten Aufgabe handelt es sich um die Berechnung des Hawking-Page-Phasenübergangs, die bereits 2003 vorgeschlagen wurde und bis heute nicht abgeschlossen werden konnte. Im Beitrag heißt es, dass nahezu jeder Schritt von zwei Agenten unabhängig durchgeführt und anschließend mit der Literatur abgeglichen wurde; das Ergebnis: Bei schwacher Kopplung bleibt der Übergang abrupt. Ein weiterer Physiker kam mit einer anderen Methode unabhängig zum selben Ergebnis – eine gegenseitige Bestätigung. Für die Ingenieurspraxis zeigt diese Aufgabe den Prüfansatz aus „unabhängiger Wiederholung + externem Abgleich“.
Bei der zweiten Aufgabe ging es um die Obergrenze der einfachsten Version des modularen Bootstrap. Eine frühere Gruppe von Claude-Agenten unternahm 61 parallele Versuche und kam nicht zum Ziel. Spätere Agenten erkannten ein Muster in den numerischen Ergebnissen, übernahmen die Methode aus einem anderen Kugelpackungsproblem und bewiesen, dass die Obergrenze für die Masse des leichtesten Schwarzen Lochs bei etwa c/9.1266 liegt; zugleich zeigten sie, dass sich diese Grenze mit dem Verfahren nicht weiter senken lässt. Im September 2026 wurde dieses Ergebnis mit Lean formal verifiziert; das Paper verfasste Claude, und Physiker prüften die zentralen Resultate. Die Lehre für die Praxis: Zahlreiche fehlgeschlagene Versuche gehören zum Prozess, deshalb braucht jeder Pfad ein Budget und Abbruchbedingungen.
Wichtig ist der Hinweis, dass es im Beitrag um „die gegenseitige Prüfung mehrerer Kopien desselben Modells“ geht – nicht um „Planung mit einem teuren Modell, Prüfung mit einem günstigen Modell“. Das im Folgenden beschriebene Verfahren, Rollen aufzuteilen und so Kosten zu sparen, ist eine Ingenieurpraxis, die Leser ausprobieren können – keine bereits in dieser Studie validierte Schlussfolgerung.
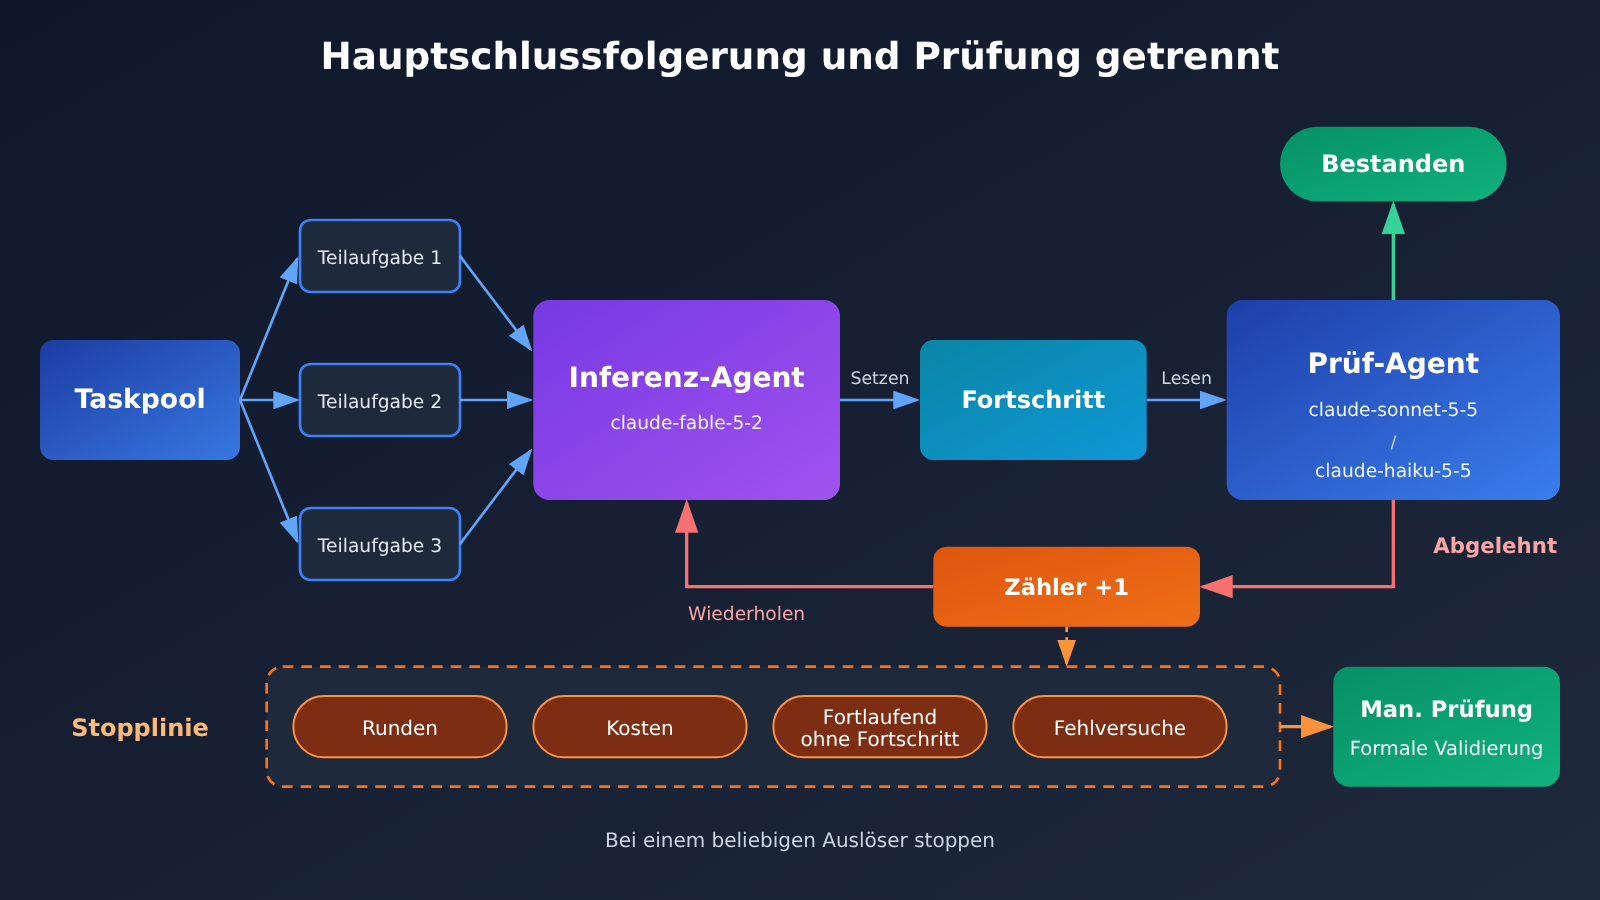
Wie man bei aufwändigen Agent-Aufgaben Rollen aufteilt: Hauptinferenz und Prüfung trennen
Bei aufwändigen Agent-Aufgaben ist der teuerste Pfad meist der, der tiefgehende Inferenz erfordert – am häufigsten fallen dagegen Prüfaktionen an: Kontrolle, Abgleich, Formatvalidierung. Laufen alle Aufrufe über dasselbe teuerste Modell, wachsen die Kosten linear oder sogar superlinear mit der Zahl der Runden. „Erst denken“ und „dann nachprüfen“ auf zwei Rollen zu verteilen, ist der direkteste Hebel zur Kostenkontrolle.
Das Aufteilungsprinzip lässt sich so zusammenfassen: Schritte, die offenes Schlussfolgern und langkettige Planung verlangen, gehen an die Hauptinferenz-Rolle. Prüfungen mit eindeutigem Kriterium – passt dieser Schritt zum vorherigen, ist das Ausgabeformat zulässig, kollidiert eine Schlussfolgerung mit bekannter Literatur – gehen an die Prüfrolle. Die Prüfrolle soll ein strukturiertes Urteil liefern, nicht die gesamte Ableitung noch einmal durchlaufen.
| Rolle | Zuständig für | Kandidaten-Modell-IDs | Ausgabeanforderung |
|---|---|---|---|
| Hauptinferenz | Offene Ableitung, Lösungsgenerierung, kritische Schritte | claude-fable-5-2, claude-fable-5-2-thinking |
vollständiger Inferenzverlauf und Zwischenergebnisse |
| Prüfung Stufe 1 | Logische Konsistenz, Schritt-Abgleich, Zitationsprüfung | claude-sonnet-5-5 |
PASS / FAIL plus Begründung |
| Leichtgewichtige Validierung | Formatprüfung, Feldvollständigkeit, einfacher Abgleich | claude-haiku-5-5 |
strukturiertes JSON-Ergebnis |
| Externe Validierung | Formaler Beweis, numerische Verifikation, manuelle Prüfung | Werkzeug oder Mensch | finale Bestätigung |
Nach dieser Aufteilung können alle Rollen denselben Aufrufeingang nutzen. Über APIYI apiyi.com lässt sich mit einem einzigen API-Schlüssel zwischen den Modellen aus der Tabelle wechseln; die Schnittstelle ist OpenAI-kompatibel, Hauptinferenz und Prüfung müssen lediglich den Parameter model ändern – mehrere SDKs und mehrere Schlüssel müssen nicht gepflegt werden. Bei langen Aufgaben mit vielen parallelen Pfaden bündelt ein einheitlicher Eingang außerdem die Nutzungsstatistik an einer Stelle, was die Abrechnung erleichtert.
Allerdings gilt: Ein günstigeres Prüfmodell ist nicht automatisch zuverlässiger. Ob die Prüfrolle taugt, hängt davon ab, wie eindeutig die Kriterien sind, die man ihr mitgibt. Empfehlenswert ist, zuerst einen kleinen Satz von Proben mit bekanntem Ergebnis durchlaufen zu lassen und zu prüfen, ob die PASS-/FAIL-Entscheidungen des Prüfmodells den Erwartungen entsprechen – erst dann in lange Aufgaben übernehmen.
Schwere Agent-Aufgaben: Wie man die API wählt – Preise und Modell-IDs abstimmen
Die Budgetkontrolle bei langen Aufgaben setzt voraus, dass der Stückpreis jedes einzelnen Aufrufs feststeht. Eine Grundregel sollte man durchhalten: Rufe nur Modelle auf, die im Modellkatalog einen klar ausgewiesenen Preis haben, und schreibe die Modell-ID samt zugehörigem Stückpreis fest in den Code, statt während des Laufs ad hoc zu wechseln.
Laut der offiziellen Anthropic-Modellseite wurde Claude Fable 5.2 am 9. November 2026 veröffentlicht. Die Modell-ID lautet claude-fable-5-2, das Kontextfenster umfasst 1 Million Tokens, die maximale Ausgabe 128.000 Tokens, und das Denken (Thinking) ist standardmäßig aktiviert. Die folgende Tabelle zeigt die Preise der für diesen Artikel relevanten Modelle aus dem Modellkatalog von APIYI apiyi.com zum Prüfdatum (19.11.2026), in US-Dollar pro Million Tokens.
| Modell-ID | Input | Cache-Lesen | Output | Empfohlene Rolle in diesem Artikel |
|---|---|---|---|---|
claude-fable-5-2 |
8 | 0,2 | 40 | Hauptinferenz |
claude-fable-5-2-thinking |
8 | 0,2 | 40 | Hauptinferenz (Thinking-Version) |
claude-fable-5-1 |
10 | 0,25 | 50 | Benachbarte Version, zum Vergleich |
claude-sonnet-5-5 |
2 | 0,1 | 10 | Erste Überprüfung |
claude-haiku-5-5 |
0,1 | 0,01 | 0,5 | Leichtgewichtige Validierung |
Aus der Tabelle lassen sich mehrere für lange Aufgaben entscheidende Informationen herauslesen. Erstens ist der Listenpreis von claude-fable-5-2 niedriger als der der benachbarten claude-fable-5-1; wenn Ihre Hauptinferenz bisher auf der alten Version lief, lohnt sich eine Prüfung der Migration. Zweitens beträgt der Cache-Lesepreis nur 2,5 % des Input-Preises. Bei langen Aufgaben liest der Agent wiederholt den gemeinsamen Fortschritt, die System-Prompts und Hintergrunddokumente – wenn dieser Teil den Cache trifft, ist der Kostenunterschied deutlich. Ob der Cache trifft, hängt von der Aufrufweise und den Plattformregeln ab; maßgeblich ist die Dokumentation. Drittens unterscheiden sich die Stückpreise von Überprüfungs- und Hauptinferenzmodell um Größenordnungen.
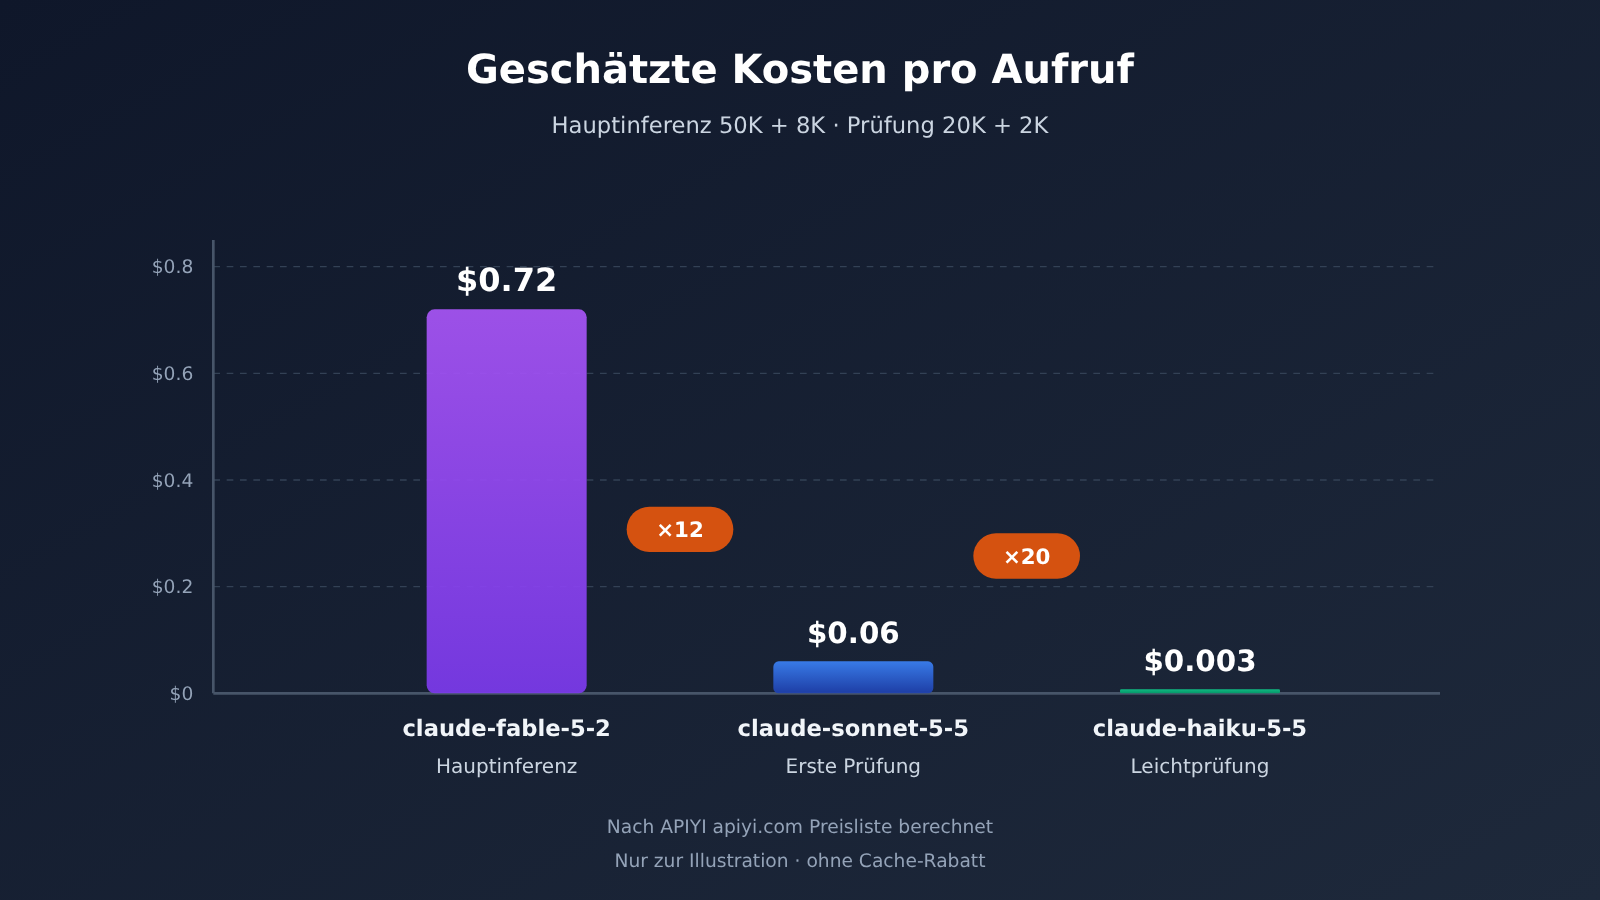
Ein Gefühl für die Größenordnungen vermitteln ein paar hypothetische Zahlen: Ein Hauptinferenz-Aufruf mit 50.000 Input-Tokens und 8.000 Output-Tokens kostet auf claude-fable-5-2 etwa 0,4 + 0,32 = 0,72 US-Dollar. Ein Überprüfungsaufruf mit 20.000 Input- und 2.000 Output-Tokens kostet auf claude-sonnet-5-5 etwa 0,04 + 0,02 = 0,06 US-Dollar und auf claude-haiku-5-5 etwa 0,003 US-Dollar. Würde man die Überprüfung ebenfalls mit dem Hauptinferenzmodell fahren, käme derselbe Überprüfungsaufruf auf etwa 0,16 + 0,08 = 0,24 US-Dollar. Das ist nur eine arithmetische Veranschaulichung; die tatsächliche Token-Anzahl hängt von Ihrer Aufgabe ab.
Außerdem liegen die offiziellen Listenpreise auf der Modellseite für Opus 5.5 bei 4 für den Input und 20 für den Output, für Sonnet 5.5 bei 2 und 10 und für Haiku 5.5 ab 0,10 und 0,50 – das kann als Referenz dienen, um die offizielle Preisstaffelung zu verstehen. Beim tatsächlichen Aufruf gelten die Modellbezeichnungen und Preise gemäß der Modellliste der Plattform; die claude-fable-5-2-Serie von APIYI unterstützt die beiden Endpunkte chat und messages, und der einheitliche Einstiegspunkt ist https://api.apiyi.com/v1.
Schneller Einstieg in anspruchsvolle Agent-Aufgaben: Scheduling-Code mit Stopplinie
Minimales Beispiel
Stellen Sie zunächst sicher, dass das Hauptinferenzmodell normal aufgerufen werden kann und das Feld usage zurückliefert – das ist die Grundlage für die spätere Kostenstatistik:
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="claude-fable-5-2",
    messages=[{"role": "user", "content": "列出这一步推导需要独立核对的三个关键假设"}],
    max_tokens=2000,
)
print(resp.choices[0].message.content)
print(resp.usage)  # Zur Erfassung der Tokens und Schätzung der Kosten
Klare Abbruchgrenzen für jeden Agenten festlegen
In dem Forschungsbeitrag haben frühe Agenten parallel 61 Versuche unternommen, ohne Erfolg – das erinnert uns daran: Bei intensiven Agent-Aufgaben wird es immer eine Vielzahl fehlgeschlagener Versuche geben, und auch das Scheitern selbst kostet Geld. Der Zweck von Abbruchgrenzen besteht darin, jeden Agenten automatisch anzuhalten, bevor er außer Kontrolle gerät, und die Entscheidung einem Menschen oder einem Werkzeug zu überlassen.
| Abbruchgrenze | Bedeutung | Empfohlener Startwert (je nach Aufgabe anpassen) |
|---|---|---|
| Maximale Runden | Obergrenze für das Hin und Her zwischen Hauptinferenz und Überprüfung | 10–30 Runden |
| Kostenobergrenze | Obergrenze der kumulierten geschätzten Kosten pro Agent | Nach dem Budget pro Aufgabe festlegen |
| Aufeinanderfolgende Fortschrittslosigkeit | Überprüfung lehnt wiederholt ab, ohne neue Schlussfolgerung | 3–5 Mal |
| Maximale Fehlversuche | Kumulierte Anzahl der von der Überprüfung abgelehnten Versuche | Etwa die Hälfte der Rundenzahl |
| Ausgabelänge | Obergrenze der Tokens pro Ausgabe | Deutlich unter der maximalen Ausgabe von 128.000 |
Vollständigen Implementierungscode ansehen
from dataclasses import dataclass, field
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # APIYI einheitlicher Einstiegspunkt, gemeinsam genutzt von Hauptinferenz und Review
)

# Stückpreis: USD / Million Tokens, fest nach der Modelltabelle der Plattform hinterlegt, bei Änderungen manuell aktualisieren
PRICES = {
    "claude-fable-5-2": (8.0, 40.0),
    "claude-sonnet-5-5": (2.0, 10.0),
    "claude-haiku-5-5": (0.1, 0.5),
}

SOLVER = "claude-fable-5-2"
REVIEWER = "claude-sonnet-5-5"


@dataclass
class StopLine:
    max_rounds: int = 20
    max_cost_usd: float = 5.0
    max_no_progress: int = 4
    max_failures: int = 10
    max_output_tokens: int = 8000


@dataclass
class RunState:
    rounds: int = 0
    cost_usd: float = 0.0
    failures: int = 0
    no_progress: int = 0
    notes: list = field(default_factory=list)


def estimate_cost(model: str, usage) -> float:
    """Schätzung nach Listenpreis, ohne Cache-Rabatt – das Ergebnis ist eher konservativ."""
    price_in, price_out = PRICES[model]
    return (usage.prompt_tokens * price_in + usage.completion_tokens * price_out) / 1_000_000


def call(model: str, messages: list, max_tokens: int, state: RunState) -> str:
    resp = client.chat.completions.create(
        model=model, messages=messages, max_tokens=max_tokens
    )
    state.cost_usd += estimate_cost(model, resp.usage)
    return resp.choices[0].message.content


def should_stop(state: RunState, line: StopLine) -> str | None:
    if state.rounds >= line.max_rounds:
        return "达到最大轮数"
    if state.cost_usd >= line.max_cost_usd:
        return "达到费用封顶"
    if state.no_progress >= line.max_no_progress:
        return "连续无进展"
    if state.failures >= line.max_failures:
        return "失败次数过多"
    return None


def run_task(task: str, line: StopLine = StopLine()) -> dict:
    state = RunState()
    progress = "(尚无进展)"

    while True:
        reason = should_stop(state, line)
        if reason:
            return {"status": "stopped", "reason": reason, "progress": progress,
                    "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}

        state.rounds += 1
        draft = call(SOLVER, [
            {"role": "system", "content": "你是主推理代理,只推进一步,写清依据。"},
            {"role": "user", "content": f"任务:{task}\n当前进展:{progress}\n请推进下一步。"},
        ], line.max_output_tokens, state)

        verdict = call(REVIEWER, [
            {"role": "system", "content": "你是复核代理,不重新推导,只判断。"
                                          "第一行只输出 PASS 或 FAIL,第二行给理由。"},
            {"role": "user", "content": f"已有进展:{progress}\n新的一步:{draft}"},
        ], 500, state)

        if verdict.strip().upper().startswith("PASS"):
            progress = draft
            state.no_progress = 0
            if "已完成" in draft:
                return {"status": "done", "progress": progress,
                        "cost_usd": round(state.cost_usd, 4), "rounds": state.rounds}
        else:
            state.failures += 1
            state.no_progress += 1
            state.notes.append(verdict)


if __name__ == "__main__":
    print(run_task("核对给定推导中每一步的符号约定是否一致,完成后写“已完成”"))
Dieser Code enthält drei bewusste Designentscheidungen. Erstens: Die Preistabelle ist fest im Code verankert – wer ein Modell austauscht, muss zwangsläufig auch den Einzelpreis anpassen. So wird verhindert, dass ein getauschtes Modell ohne hinterlegten Preis die Budgetrechnung verfälscht. Zweitens: Die Prüfrolle darf ausschließlich PASS oder FAIL samt Begründung ausgeben und keine eigene Herleitung anstellen – das begrenzt die Ausgabelänge der Prüfung. Drittens: Nach dem Stopp liefert der Agent den aktuellen Stand und die aufgelaufenen Kosten zurück, damit ein Mensch übernehmen kann, statt dass der Agent endlos weitere Versuche startet.
🚀 Schnellstart: Am besten nutzt man zuerst bei APIYI apiyi.com das kostenlose Testguthaben für neue Nutzer, schickt eine kleine Aufgabe, deren Lösung man bereits kennt, durch den oben beschriebenen Ablauf, prüft, ob Prüfentscheidung und Kostenschätzung den Erwartungen entsprechen, und erhöht erst dann schrittweise die Zahl der parallelen Pfade und Runden.
FAQ zur API-Auswahl für aufwändige Agent-Aufgaben
F1: Ist es glaubwürdig, dass Claude Fable 5.2 ein physikalisches Problem zu Schwarzen Löchern gelöst hat?
Dabei handelt es sich um eine offizielle Aussage aus dem Forschungsbeitrag von Anthropic vom 17. November 2026. Die beiden zugehörigen Papers sind Preprints und wurden noch nicht im Peer-Review-Verfahren begutachtet. Das Ergebnis der zweiten Frage wurde im September 2026 mit Lean formal verifiziert, und für die erste Frage kam ein anderer Physiker mit einer anderen Methode zum selben Ergebnis. Beim Lesen sollte man das auf der Ebene „offizielle Aussage + Preprint“ einordnen.
F2: Der Forschungsbeitrag sagt „keine besondere Konfiguration“ – heißt das, es ist sehr günstig?
Nein. „Keine besondere Konfiguration“ beschreibt den Aufbau; der Beitrag enthält keine Kostenaufstellung. 22 Aufgaben, pro Aufgabe ein Agent, im Hintergrund etwa sechs Wochen laufen lassen – die Zahl der Aufrufe ist an sich schon beträchtlich. Wenn Sie selbst Aufgaben ähnlichen Umfangs durchführen, sollten Sie die Kosten anhand der Preise in der Modelltabelle selbst schätzen und eine Kostenobergrenze festlegen.
F3: Ist der Einsatz eines günstigen Modells zur Überprüfung eine im Forschungsbeitrag verifizierte Vorgehensweise?
Nein. Die Vorgehensweise im Beitrag besteht darin, mehrere Kopien desselben Modells unabhängig die Aufgabe erneut lösen zu lassen und sie gegenseitig abzugleichen. „Hauptinferenz mit dem teuren Modell, Überprüfung mit dem günstigen Modell“ ist eine in diesem Artikel empfohlene Engineering-Praxis, deren Wirksamkeit Sie an Ihren eigenen Aufgaben überprüfen müssen. Für Schritte mit extrem hohen Anforderungen an die Korrektheit können Sie auch die Methode „zwei unabhängige Wiederholungen der Hauptinferenz“ beibehalten.
F4: Wie wählt man zwischen `claude-fable-5-2` und `claude-fable-5-2-thinking`?
Beide haben in der Modelltabelle von APIYI denselben Listenpreis, nämlich 8 US-Dollar für Input, 0,2 US-Dollar für Cache-Read und 40 US-Dollar für Output pro Million Tokens. Die offizielle Modellseite gibt an, dass das Denken bei Fable 5.2 standardmäßig aktiviert ist. Die konkreten Unterschiede im Aufrufverhalten der beiden IDs entnehmen Sie bitte der Modellbeschreibung der Plattform; es empfiehlt sich, dieselbe Aufgabe mehrmals mit beiden auszuführen, die Ausgabelänge und `usage` zu vergleichen und dann zu entscheiden, welches Sie für die Hauptinferenz verwenden.
F5: Wie ruft man Hauptinferenz- und Überprüfungsmodell gleichzeitig über eine Schnittstelle auf?
Nachdem Sie sich bei APIYI apiyi.com registriert und einen API-Schlüssel erhalten haben, setzen Sie die base_url des SDK auf `https://api.apiyi.com/v1`; für Hauptinferenz und Überprüfung müssen Sie lediglich den Parameter `model` wechseln, zum Beispiel `claude-fable-5-2` und `claude-sonnet-5-5`. Neue Nutzer erhalten ein kostenloses Testkontingent, das sich gut eignet, um zuerst die Stoppgrenze und die Überprüfungslogik zu verifizieren.
F6: Welche Bedeutung hat der Cache-Read-Preis bei langen Aufgaben?
Der Cache-Read-Preis von Fable 5.2 beträgt 2,5 % des Input-Preises, also 0,2 US-Dollar pro Million Tokens. Bei langen Multi-Agent-Aufgaben werden System-Prompts, Hintergrundmaterial und gemeinsamer Fortschritt wiederholt gelesen; wenn dieser Teil stabil bleibt und am Anfang des Prompts steht, erhöht sich die Chance auf einen Cache-Treffer. Ob ein Cache-Treffer erfolgt und wie abgerechnet wird, richtet sich nach der Plattformdokumentation.
F7: Wie hoch sollte man die Stoppgrenze setzen?
Es gibt keine allgemeingültigen Zahlen. Beginnen Sie mit konservativen Werten: 10–30 Runden, 3–5 aufeinanderfolgende Durchläufe ohne Fortschritt und pro Pfad eine Kostenobergrenze, die Sie am Wert der Aufgabe ausrichten. Wenn eine Charge durchgelaufen ist, sehen Sie sich die Verteilung der Stoppgründe an: Sind es überwiegend „Kostenobergrenze“, obwohl die Aufgabe fast fertig war, können Sie die Grenzen etwas lockerer setzen; sind es überwiegend „kein Fortschritt“, wurde die Aufgabe nicht fein genug zerlegt.
Q8: Welche Einschränkungen hat dieser Ansatz?
Erstens kann das Prüfmodell etwas übersehen oder falsch beurteilen – deshalb muss man es mit Stichproben bekannter Antworten kalibrieren. Zweitens beruht die Kostenschätzung auf den Listenpreisen; Cache-Rabatte und Schwankungen durch fehlgeschlagene Wiederholungsversuche sind nicht eingerechnet. Drittens braucht die endgültige Schlussfolgerung – wie bei einem solchen Research-Post – weiterhin eine externe Überprüfung, zum Beispiel einen formalen Beweis oder die Begutachtung durch Fachexperten. Dass die Agenten sich gegenseitig zustimmen, heißt nicht, dass das Ergebnis richtig ist.
Kernaussagen zur API-Auswahl bei aufwendigen Agent-Aufgaben
- Ausgangspunkt einordnen: Die Schwarzloch-Studie zu Fable 5.2 ist eine offizielle Eigendarstellung, das Paper ein Preprint – auf die Methode schauen, nicht auf die Schlussfolgerung
- Rollen trennen: Offenes Reasoning übernimmt das Haupt-Reasoning-Modell, Prüfungen mit klaren Kriterien übernimmt das Prüfmodell
- Prüfung muss unabhängig sein: Die Prüfung urteilt nur, statt neu zu argumentieren; Ausgabe PASS / FAIL plus Begründung
- Stopplinien festschreiben: Runden, Kosten, aufeinanderfolgende Stillstände ohne Fortschritt und Fehleranzahl – keine dieser vier Linien darf fehlen
- Nur Modelle mit Listenpreis einsetzen: Modell-ID und Stückpreis werden fest im Code verankert; bei einem Modellwechsel muss der Preis mitgeändert werden
- Cache-Lesevorgänge nutzen: Stabile Hintergrundinfos und Fortschritt an den Anfang stellen – ein Cache-Read kostet nur 2,5 % des Eingabepreises
- Über einen einheitlichen Zugang einsteigen: Bei APIYI mit einem einzigen Schlüssel zwischen Haupt-Reasoning- und Prüfmodell wechseln; zuerst mit dem kostenlosen Kontingent kleine Aufgaben testen
Zusammenfassung
Ausgehend davon, wie Claude Fable 5.2 ein schwieriges Problem der Schwarze-Loch-Physik geknackt hat, lassen sich für ressourcenintensive Agent-Aufgaben vor allem drei Lehren ziehen:
- Hauptschlussfolgerung und Prüfung trennen: Der Forschungsbeitrag setzt mehrere Kopien desselben Modells ein, die sich gegenseitig gegenprüfen. Darauf aufbauend können Sie versuchen, je nach Rolle Modelle unterschiedlicher Preisklasse zu wählen, und die Prüfqualität anhand von Stichproben zu verifizieren.
- Für jeden Pfad klare Abbruchkriterien definieren: 61 gescheiterte Versuche zeigen, dass Misserfolg der Normalfall ist. Runden, Kosten, fehlender Fortschritt und Fehleranzahl brauchen jeweils eine Obergrenze.
- Nur Modelle mit ausgewiesenem Preis in der Modelltabelle aufrufen: Schreiben Sie Modell-IDs wie
claude-fable-5-2,claude-sonnet-5-5undclaude-haiku-5-5samt Stückpreis in den Code – nur dann lassen sich Kosten vorhersagen und deckeln.
Ob eine lange Aufgabe gelingt, hängt oft weniger davon ab, wie klug ein einzelner Aufruf ist, als davon, ob der gesamte Ablauf innerhalb eines kontrollierbaren Budgets kontinuierlich vorankommt und überprüfbare Ergebnisse hinterlässt. Empfohlen: Starten Sie über APIYI apiyi.com mit dem kostenlosen Testguthaben zunächst mit einer kleinen Aufgabe, passen Sie dann die Parameter schrittweise anhand der Abbruchgründe an und skalieren Sie erst danach hoch.
📚 Referenzen
-
Anthropic-Forschungsbeitrag: offizielle Darstellung, wie Claude Fable 5.2 mit mehreren Agenten zwei Aufgaben zur Schwarze-Loch-Physik löst
- Link:
anthropic.com/research/claude-black-hole-physics - Erläuterung: eine aus erster Hand stammende Beschreibung von Agentenaufteilung, Dauer und Prüfverfahren
- Link:
-
Preprint eins: der zum Forschungsbeitrag gehörende Preprint, nicht peer-reviewed
- Link:
hexagonmath.org/2611.00175v1 - Erläuterung: geeignet für Leser, die die Originalergebnisse nachlesen möchten
- Link:
-
Preprint zwei: ein weiterer zum Forschungsbeitrag gehörender Preprint, nicht peer-reviewed
- Link:
hexagonmath.org/2611.00174v1 - Erläuterung: im Vergleich mit dem vorigen Beitrag lesen
- Link:
-
Offizielle Modellseite von Claude Fable 5.2: Modell-ID, Kontextfenster, maximale Ausgabe und offizielle Preisangaben
- Link:
platform.claude.com/docs/en/models/fable-5-2/overview - Erläuterung: Modellspezifikationen und offizielle Preisstaffel gegenprüfen
- Link:
Autor: Technikteam von APIYI
Technischer Austausch: Kontaktieren Sie uns gerne über die Startseite der APIYI-Website; Hinweise zu Modellen und Preisen finden Sie im Dokumentationszentrum unter docs.apiyi.com


